Cost Anomaly Detectionの使いどころを7つのユースケースで整理してみた(マルチアカウント編)

はじめに
おはようございます〜
クラウド事業統括本部/プロフェッショナルサービス事業本部/運用イノベーション部の三ツ口寛太です(╹◡╹)
AWS Cost Anomaly Detection(以下、CAD)は、機械学習で通常の支出パターンを学習し、そこから外れた支出を検知して通知してくれる機能です。機能自体の追加料金はありません。
ただ、AWS Organizationsでアカウントが増えてくると、こんな悩みが出てきます。
- どの単位でモニターを作ればよいか分からない
- 設定したものの、通知がメールに埋もれて誰も対応しない
- 開発・検証環境の「止め忘れ」を、月末の請求で初めて知ってしまう
この記事では、「請求が確定する前にコストの急増に気づく」ための使い方を、7つのユースケースに分けて整理します。特定の環境を前提にしない、汎用的な案です。取捨選択のたたき台として使ってください!🧑💻
この記事で分かること
- CADのユースケース7つと、それぞれの設定案
- ユースケースごとの「検知対象」「通知先」「頻度・しきい値」の考え方
- 最初に入れるべき1本と、あとから足す順番の目安
- 設定するときの注意点(前提・制約)
こだわりポイント
- 機能の説明ではなく、「どんな場面で困るか」から逆引きできるように整理する
- 各ユースケースを、同じ項目(場面・設定案・期待できる効果・注意点)でそろえて書く
- 公式ドキュメントで確認できていないことは、断定せずにそう書く
先に結論
- 最初に入れる基本の1本は、AWSサービス単位で全アカウントを見るモニター(ユースケース1)
- アカウントが多い環境では、システムごとではなく環境(本番・検証・開発など)ごとにまとめると、設定の数を抑えられる(ユースケース2)
- 開発・検証環境の消し忘れ検知(ユースケース5)は、効果が分かりやすく、優先度が高い
- 通知の出口(チャット・チケット)を作らないと、検知しても対応されない(ユースケース7)
- 検知は請求データに基づくため、最大で約24時間の遅れがある
ユースケース一覧
| No. | ユースケース | 概要 | 優先度(案) |
|---|---|---|---|
| 1 | 全体の安全網 | AWSサービス単位で、全アカウントの支出の急増を検知する。最初に入れる基本の1本 | 高 |
| 2 | 環境単位の検知 | システムごとではなく、環境ごとにアカウントをまとめて検知する | 高(対象を絞る) |
| 3 | 領域別・タグ別の検知 | コスト配分タグやコストカテゴリで、複数アカウントにまたがる領域をまとめて検知する | 中 |
| 4 | 移行期の想定外コストの検知 | マルチアカウントへの移行・組織の再編にともなう、想定外のコスト増を見張る | 移行がある場合 |
| 5 | 開発・検証環境の消し忘れの検知 | 起動しっぱなしや誤操作による急増を早期に見つける | 高 |
| 6 | 統制の緩いアカウントの検知 | 権限の制限を設けていない例外扱いのアカウントを、重点的に見る | 中 |
| 7 | 運用への組み込み | ユースケース1〜6の通知を、チャットとチケットに流し、検知から対処までの流れを作る | 中 |
前提:CADの設定は管理アカウントで行う
Organizationsを使っている場合、モニターは管理アカウントごとに設定する想定です。Organizationsが複数ある(たとえば本番用と開発用で分かれている)場合は、それぞれ別の設定になります。
どのユースケースも、基本の構成は同じです。
違うのは、モニターの「検知対象」の選び方と、通知の頻度・しきい値です。
ユースケース1:全体の安全網
AWSサービス単位で、全アカウントの支出の急増を検知します。最初に入れる基本の1本です。
想定される場面
特定サービスの利用が、想定外に増える場面です(例:データ転送量、ログの保存量、起動台数の増加)。アカウント数が多くても、サービス単位で気づけます。
構成イメージ
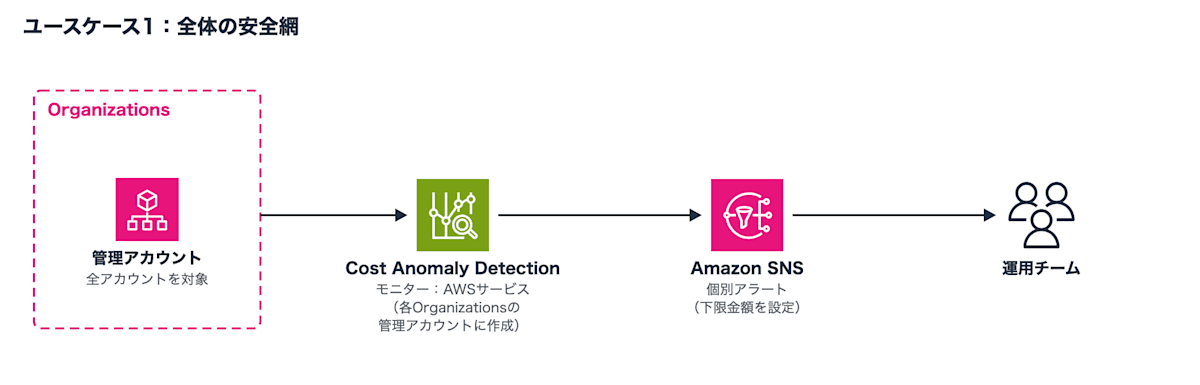
ユースケース1の構成イメージ
設定案
| 項目 | 内容 |
|---|---|
| 検知対象 | 「AWSサービス」。各Organizationsの管理アカウントに作成する |
| 通知先 | 運用チーム(担当チームを決める) |
| 頻度・しきい値 | 個別アラート。金額は過去の請求実績から設定し、少額の変動では通知しない下限を置く |
期待できる効果
タグやアカウントの整備状況に関係なく、全体の異常を拾えます。
先に決めておきたいのは、しきい値の金額、通知先の担当チーム、検証用のOrganizationsも対象にするかどうかです。
ユースケース2:環境単位の検知
システムごとではなく、環境(本番、検証、開発など)ごとにアカウントをまとめて検知します。
想定される場面
設定変更や構成の見直しの後に、特定の環境でコストが跳ね上がる場面です(例:通信料金の増加、想定外のリソースの追加)。
構成イメージ
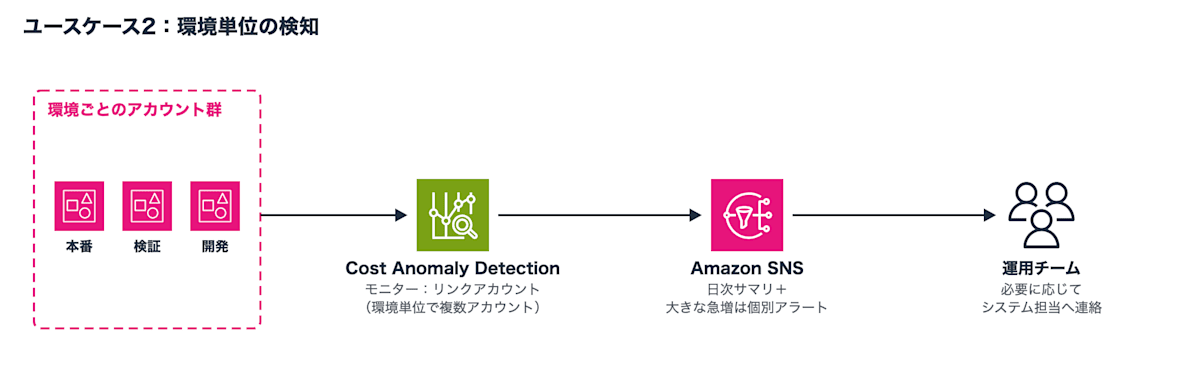
ユースケース2の構成イメージ
設定案
| 項目 | 内容 |
|---|---|
| 検知対象 | 「リンクアカウント」。1つの設定に複数アカウントを含められる |
| まとめ方(案) | 環境単位でまとめる。システムごとの個別設定は、コストの大きいシステムに絞る |
| 通知先 | 運用チーム。必要に応じて、システム担当へ連絡 |
| 頻度・しきい値 | 日次サマリを基本とし、大きな急増は個別アラート |
期待できる効果
アカウントを1つずつ設定するより少ない数の設定で、環境ごとの異常を見られます。
注意点
- システム単位でも作成できますが、システム数が多い環境では現実的ではありません
- アカウントの追加・削除時に、設定を更新する運用が必要です
- ユーザー管理のモニターで選べるのは、最大10アカウントまでです。1つの環境にアカウントが多い場合は、モニターを分けるか、AWS管理のリンクアカウント別モニターを使うかを検討します
- 作成できる設定数などの上限は、公式ドキュメントのクォータのページで確認してください
ユースケース3:領域別・タグ別の検知
コスト配分タグやコストカテゴリで、複数アカウントにまたがる領域をまとめて検知します。
想定される場面
1つの領域(事業部やプロダクトなど)が複数のアカウントに分かれていて、アカウント単位では全体の増え方が見えにくい場面です。
構成イメージ
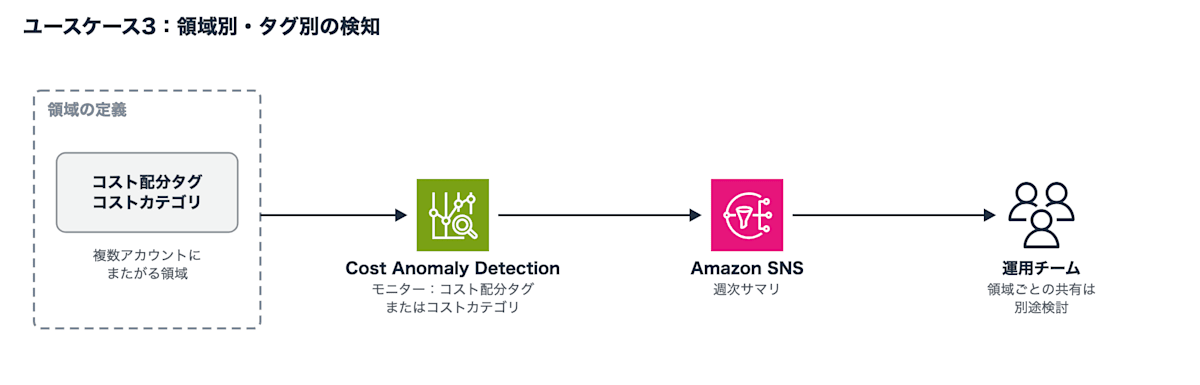
ユースケース3の構成イメージ
設定案
| 項目 | 内容 |
|---|---|
| 検知対象 | 「コスト配分タグ」または「コストカテゴリ」 |
| 通知先 | 運用チーム。領域ごとの共有は別途検討 |
| 頻度・しきい値 | 週次サマリを基本とする |
期待できる効果
コスト分析のダッシュボードで使っている領域のグルーピングと、同じ単位で異常を見られます。
注意点
- コスト配分タグは、有効化とタグ付けの整備が前提です
- Organizationsが分かれている場合、同じ領域でもOrganizationsをまたいでは見られません
- タグの整備状況と、領域グルーピングの定義を、先に決めておく必要があります
ユースケース4:移行期の想定外コストの検知
マルチアカウントへの移行や組織の再編にともなう、想定外のコスト増を見張ります。
想定される場面
- 移行中の二重稼働
- 一時的に作ったリソースの消し忘れ
- 移行後のデータ転送の増加
構成イメージ
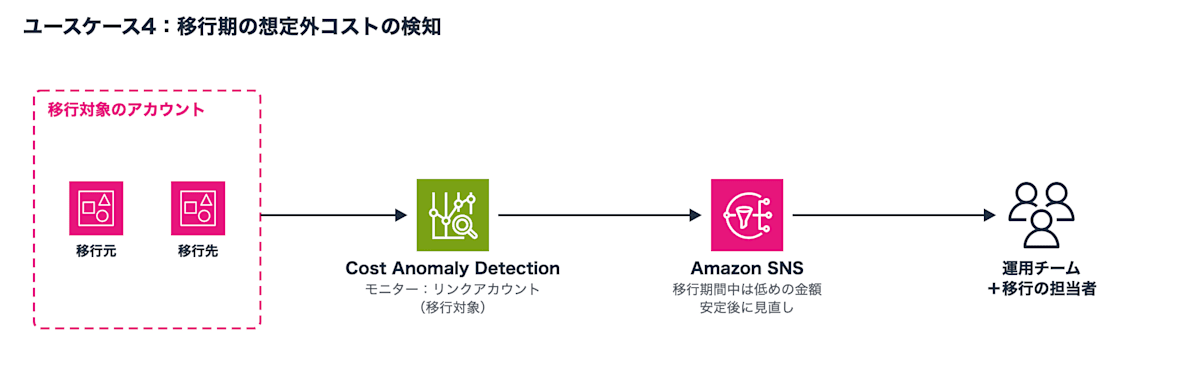
ユースケース4の構成イメージ
設定案
| 項目 | 内容 |
|---|---|
| 検知対象 | 「リンクアカウント」(移行対象) |
| 通知先 | 運用チーム、移行の担当者 |
| 頻度・しきい値 | 移行期間中は低めの金額で運用し、安定後に見直す |
期待できる効果
移行後の見込みとの差を、請求の確定を待たずに把握できます。
注意点
- 移行の範囲は、事前に確認が必要です
- 新しいアカウントや、Organizations間・組織内で移したアカウントが、検知にどう影響するかは、公式ドキュメントでは確認できていないため、実際に試して確認してください
ユースケース5:開発・検証環境の消し忘れの検知
開発・検証用のアカウントで、起動しっぱなしや誤操作による急増を早期に見つけます。
想定される場面
- 検証後にリソースを止め忘れる
- 休日や夜間に、大きな処理が動き続ける
- PoCなどの一時的な環境は、利用の終わりが曖昧になりやすい
構成イメージ
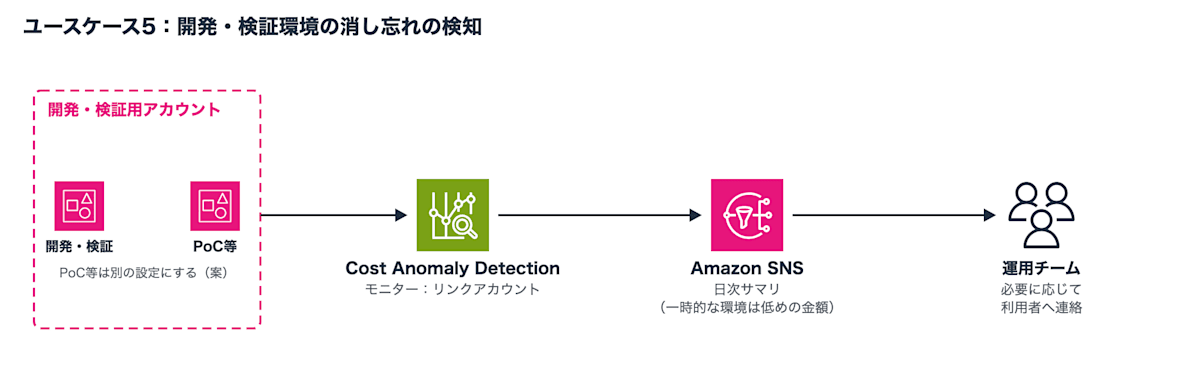
ユースケース5の構成イメージ
設定案
| 項目 | 内容 |
|---|---|
| 検知対象 | 「リンクアカウント」。PoCなどの一時的な環境は、通常の開発とは別の設定にする(案) |
| 通知先 | 運用チーム。必要に応じて、利用者へ連絡 |
| 頻度・しきい値 | 日次サマリ。一時的な環境は低めの金額で運用 |
期待できる効果
小さな消し忘れが、月末まで積み上がるのを防げます。
対象アカウントの範囲と、利用者への連絡の手順は、先に決めておくとスムーズです。
ユースケース6:統制の緩いアカウントの検知
権限の制限(SCPなど)を設けていない例外扱いのアカウントを、重点的に見ます。
想定される場面
権限の制限が少ないため、想定外のサービス利用や設定ミスによる急増が起きやすいと考えられます。
構成イメージ
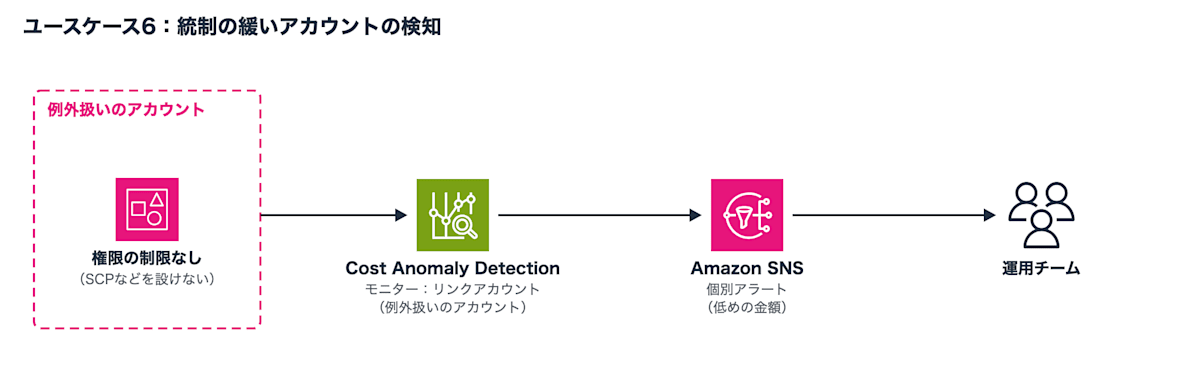
ユースケース6の構成イメージ
設定案
| 項目 | 内容 |
|---|---|
| 検知対象 | 「リンクアカウント」(例外扱いのアカウント) |
| 通知先 | 運用チーム |
| 頻度・しきい値 | 個別アラート。低めの金額で運用 |
期待できる効果
統制の例外としているアカウントのコストを、見落とさずに把握できます。
Organizationsが複数ある場合は、それぞれに対象のアカウントがあるか、どこまでを対象にするかを決めておきます。
ユースケース7:運用への組み込み
ユースケース1〜6の通知を、チャットとチケットに流し、検知から対処までの流れを作ります。
想定される場面
- アラートがメールに埋もれて、誰も対応しない
- 対応の記録が残らず、しきい値の見直しにも使えない
構成イメージ
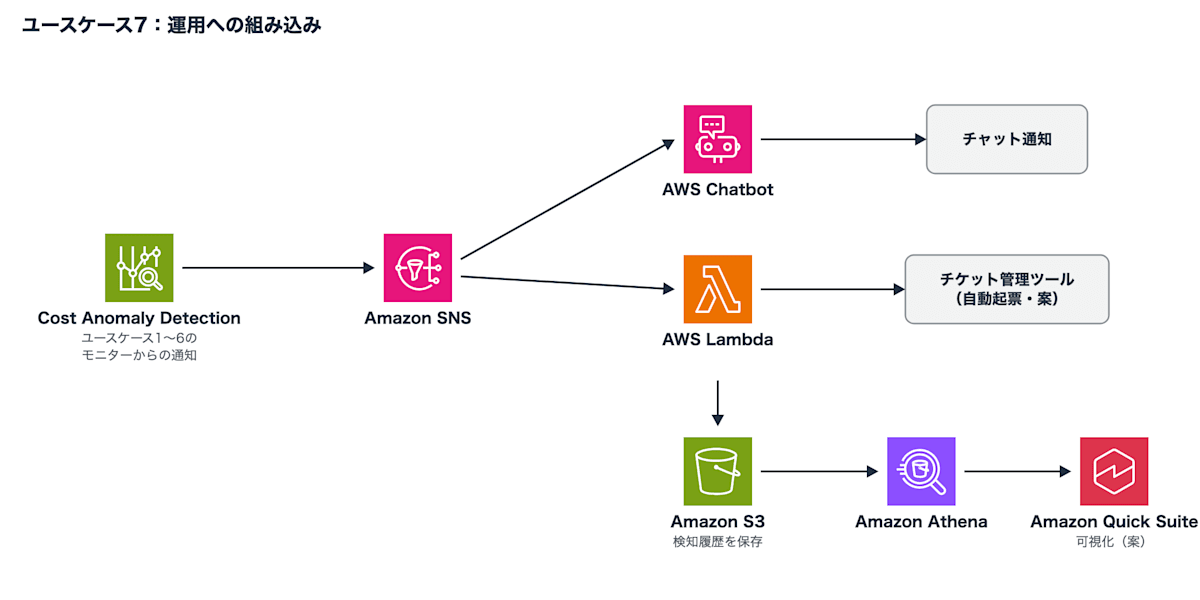
ユースケース7の構成イメージ
設定案
| 項目 | 内容 |
|---|---|
| 連携方法 | SNSから、チャット連携(AWS Chatbot)とLambdaに通知する |
| チケット | Lambdaから、チケット管理ツールへ自動起票(案) |
| 検知履歴 | S3に保存し、AthenaとAmazon Quick Suiteで可視化(案) |
| Organizationsごとの構成 | Organizationsごとに別々に作るか、通知を1か所に集めるかを、運用の手間を見て決める(案) |
期待できる効果
対応漏れを防ぎ、記録をもとに、モニターとしきい値を見直せます。
チャットツールとチケット管理ツールの選定、連携を入れるかどうか、Organizationsをまたいだ通知の集約方法は、運用に合わせて決めます。
導入の順番(案)
| 順番 | ユースケース | 理由 |
|---|---|---|
| 1 | ユースケース1(全体の安全網) | タグやアカウントの整備を待たずに、すぐ入れられる |
| 2 | ユースケース5(消し忘れ)、2(環境単位) | 効果が分かりやすく、少数の設定で済む |
| 3 | ユースケース7(運用への組み込み) | 検知が増える前に、通知の出口を作っておく |
| 4 | ユースケース3、6、4 | 前提の整備や、対象範囲の確認ができてから |
注意点
- 検知は請求データに基づくため、最大で約24時間の遅れがあります。リアルタイムの監視ではありません
- しきい値を低くしすぎると、通知が増えて見られなくなります。実績を見ながら見直す前提で始めてください
まとめ
CADは、「何を見たいか」から検知対象を選ぶと整理しやすくなります。
- まずは、AWSサービス単位の1本(ユースケース1)で全体の安全網を張る
- 次に、消し忘れ(ユースケース5)と環境単位(ユースケース2)で、よく起きる急増を拾う
- 通知の出口(ユースケース7)を作って、検知から対処までをつなぐ
自分たちの環境に合うものを選んで、試してみてください!
最後に
本日の写真はこちら!(ででん)
大分県の由布シルキーロードです!由布岳に行った時に通ったのですがめっちゃ気持ちよかったです〜!
由布岳の写真もまた載せたいと思います⛰️
最後まで読んでくださりありがとうございました〜〜
参考
- Getting started with AWS Cost Anomaly Detection - AWS Cost Management(モニターの種類、作成できるアカウント)
- Creating an Amazon SNS topic for anomaly notifications - AWS Cost Management(SNSトピックによる通知)
- Receiving anomaly alerts in chat applications - AWS Cost Management(チャットへの通知)
- Quotas and restrictions - AWS Cost Management(クォータ、検知までの時間)
- メンバーアカウントでのCost Anomaly Detection検証記事