[アップデート] Amazon DynamoDB で S3 から新規テーブルを作成せずに既存テーブルへ一括取り込みできる Bult Put Items が使えるようになりました

いわさです。
Amazon DynamoDB を使っていると S3 などへ吐き出したデータをテーブルに取り込みたい時があります。
これまでは独自処理で取り込むか、Import from S3 などを使って新規テーブルを作成する必要がありましたが、先日のアップデートで Bulk Put Items という API が追加され、S3 から既存テーブルにマネージドに一括取り込みできるようになりました。
また、単純に一括取り込みするだけでなく入力ファイルの行ごとに条件式を書くことで、既存データを上書きしない書き込み(insert-only)や、バージョンが新しい場合だけ書き込む指定などもできます。これはかなり良さそうだ。
今回は AWS CLI で実際に書き込みを実行してみたので紹介します。
使ってみる
今回の bulk put items の特徴はやはり既存テーブルに書き込める点です。S3 からの取り込みだと ImportTable API を使うことが多かったですが、新規テーブルが作成される形になるので、テーブル利用者側で新規テーブルへの切り替えなどが必要でした。
AWS CLI では、v2.39.4 で StartBulkPutItems、DescribeBulkOperation、ListBulkOperations、CancelBulkOperation が追加されてます。このあたりを使うっぽい。
では使ってみましょう。
リージョンは東京、検証テーブルに bulk-put-test(オンデマンド、パーティションキーは Artist)をSTANDARD で作成してます。
条件によるスキップを確認するため、先に既存の項目を 1 件書き込んでおきました。
aws dynamodb put-item --table-name bulk-put-test --item '{"Artist":{"S":"Acme Band"},"SongTitle":{"S":"Happy Day"},"Origin":{"S":"seed"},"Version":{"N":"5"}}'
入力ファイルは DynamoDB JSON 形式で、S3 にアップロードしました。こんな感じです。
{"Item": {"Artist": {"S": "No One You Know"}, "SongTitle": {"S": "Call Me Today"}}}
{"Item": {"Artist": {"S": "Acme Band"}, "SongTitle": {"S": "Happy Day"}, "Origin": {"S": "import"}}, "ConditionExpression": "attribute_not_exists(Artist)"}
{"Item": {"Artist": {"S": "The Ternaries"}, "SongTitle": {"S": "Blue"}, "Version": {"N": "12"}}, "ConditionExpression": "#v < :v", "ExpressionAttributeNames": {"#v": "Version"}, "ExpressionAttributeValues": {":v": {"N": "12"}}}
1 行目は条件なしの書き込み、2 行目は既存の項目を上書きしない insert-only、3 行目は Version を比較する書き込みです。
このように取り込みアイテム側に条件を含めちゃう書いちゃう感じです。エントリごとの特性に応じて条件を設定できそうです。
ではまず 1 回目の取り込みをしてみます。
使い方ですが、入力ファイルのバケットとプレフィックス、レポートの出力先を指定してStartBulkPutItemsを実行します。
レポートには、エラーと条件チェックの失敗の両方を出力するよう指定しています。
$ aws dynamodb start-bulk-put-items \
    --table-name bulk-put-test \
    --input-s3-configuration '{"S3Bucket":"hoge-input-bucket","S3KeyPrefix":"daily/","InputFormat":"DYNAMODB_JSON"}' \
    --output-s3-configuration '{"S3Bucket":"hoge-report-bucket","S3KeyPrefix":"reports/","OutputType":["ERROR","CONDITION_CHECK_FAILURE"]}' \
    --performance-tier STANDARD

"BulkOperationStatus": "IN_PROGRESS", "ProcessedItemCount": 0
最初 IN_PROGRESSと出ましたね。この後にDescribeBultOperationを使うことで状況確認が出来ます。
今回のケースだと 1 分くらいでCOMPLETEDになりました。
$ aws dynamodb describe-bulk-operation --bulk-operation-arn <ARN>

"BulkOperationStatus": "COMPLETED", "ProcessedItemCount": 3, "FailedItemCount": 0,
"ProcessedInputBytes": 468, "TotalInputBytes": 468, "PerformanceTier": "STANDARD"
エラーなさそうです。テーブルを scan して中身を確認してみます。
No One You Know / Call Me Today
Acme Band / Happy Day / Origin=seed / Version=5
良さそうです。
1 行目は新規の項目として書き込まれ、2 行目は既存の項目があるためスキップされて Origin=seed のままですね。更新されてない。
3 行目として S3 側では用意していた The Ternaries は既存の項目がなかったため、#v < :v が false でスキップされたっぽいです。アイテム存在していないと条件文判定されないっぽくて、存在しないキーも書き込みたい場合は、公式ドキュメントの例にある attribute_not_exists(#v) OR #v < :new のような条件にする形になりそうです。
なおCONDITION_CHECK_FAILURE を指定していたので、スキップされた項目は出力先の S3 にレポートとして保存されます。
{"itemLocation":{"inputSourceArn":"arn:aws:s3:::hoge-input-bucket/daily/input.jsonl","itemIndex":1},"errorMessages":["The conditional request failed"],"newImage":{"Item":{"Artist":{"S":"Acme Band"},"Origin":{"S":"import"},"SongTitle":{"S":"Happy Day"}}},"oldImage":{"Item":{"Artist":{"S":"Acme Band"},"Origin":{"S":"seed"},"SongTitle":{"S":"Happy Day"},"Version":{"N":"5"}}}}
{"itemLocation":{"inputSourceArn":"arn:aws:s3:::hoge-input-bucket/daily/input.jsonl","itemIndex":2},"errorMessages":["The conditional request failed"],"newImage":{"Item":{"Artist":{"S":"The Ternaries"},"SongTitle":{"S":"Blue"},"Version":{"N":"12"}}}}
レポートの 1 件目には、書き込もうとした項目の newImage と、すでにテーブルにあった項目の oldImage が含まれていました。
では今度は 3 行目と同じ条件式で、既存の項目がある場合の動作も確認してみます。
$ aws dynamodb describe-bulk-operation --bulk-operation-arn <ARN2>

"BulkOperationStatus": "COMPLETED", "ProcessedItemCount": 1, "FailedItemCount": 0, "ProcessedInputBytes": 228

$ aws dynamodb get-item --table-name bulk-put-test --key '{"Artist":{"S":"The Ternaries"}}'

Version = 12
既存の Version が 5 で更新対象条件に一致しているので、Version が 12 に更新されてますね。
今回の条件式では、既存の項目がないキーはスキップされました。
コンソールからの実行
なお、アナウンスによるとマネジメントコンソールからもこの機能は操作できるとのことです。
DynamoDB の書き込みをマネコン操作することはあまり多くないと思いますが、検証用に使う時があるかもしれない。見てみましょう。
You can start an operation from the AWS Management Console, the AWS Command Line Interface (AWS CLI), or the AWS SDKs.
(操作は、AWS マネジメントコンソール、AWS コマンドラインインターフェイス(AWS CLI)、または AWS SDK から開始できます。)
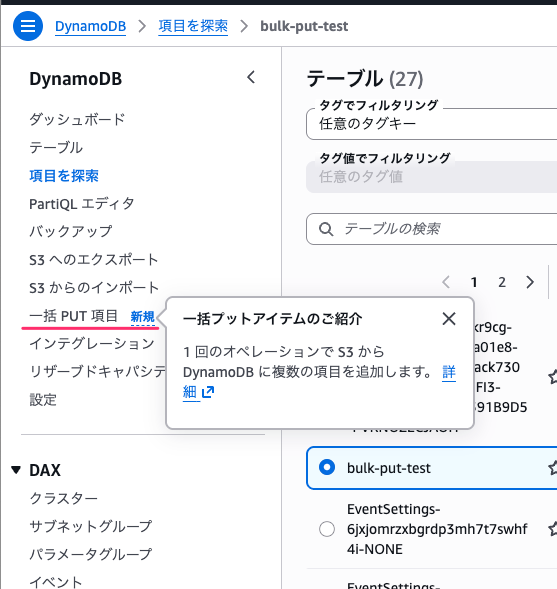
メニューに「一括 PUT 項目」というのが追加されてますね。これっぽい。
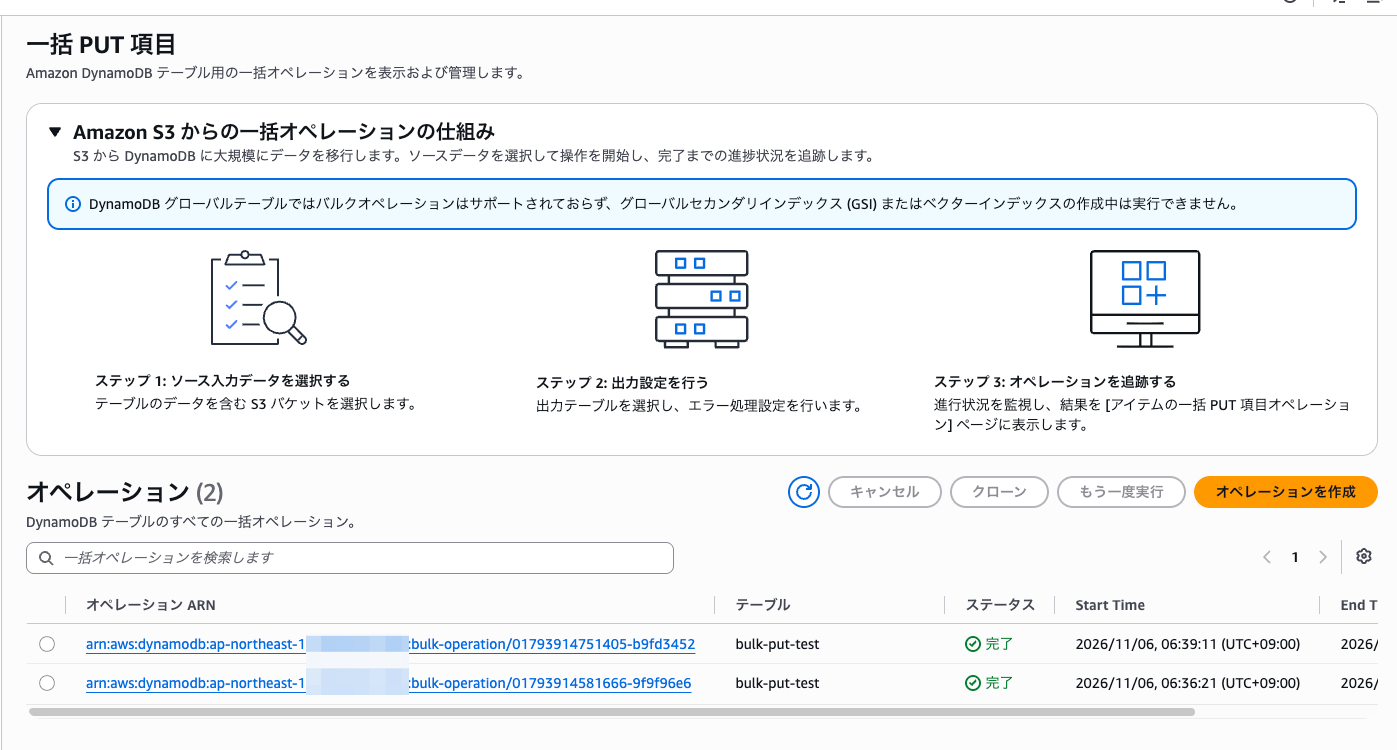
見てみると、先ほど取り込んだ履歴が確認できます。
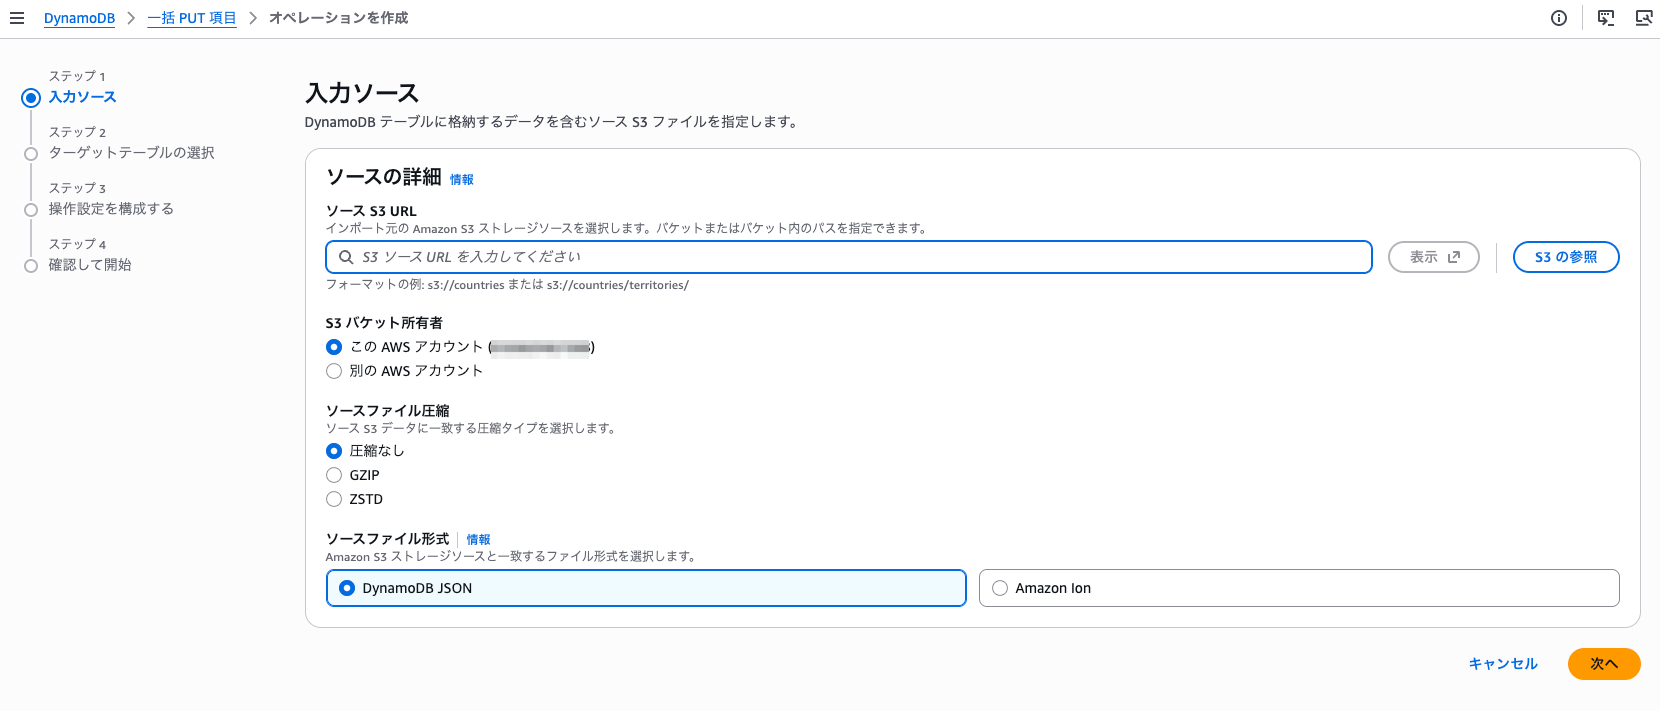
マネジメントコンソールから取り込む時も概ね指定内容は同じですね。
仕様と料金
BulkPutItems には、パフォーマンスティアのパラメータがあります。API の StartBulkPutItems で PerformanceTier に STANDARD か ACCELERATED を指定します。(省略すると STANDARD)
STANDARDよりもACCELERATEDのほうが処理が速かったり上限サイズが大きかったりしますが、1GB あたりの単価が倍になります。あとACCELERATEDは全リージョン使えるわけではありません。東京は使えた。
| Standard | Accelerated | |
|---|---|---|
| 処理の速さ | 標準 | 速い |
| 入力の上限 | 100 GB | 1 TB |
| 料金(バージニア北部) | 1 GB あたり $0.10 | 1 GB あたり $0.20 |
| 対象リージョン | すべての商用リージョン | 東京を含む一部のリージョン |
| ベクトルインデックス付きテーブル | 使える | 使えない |
公式ブログでは 1 GB 未満の小さい取り込みには Standard が推奨されていました。
さいごに
本日は Amazon DynamoDB で S3 から新規テーブルを作成せずに既存テーブルへ一括取り込みできる Bult Put Items が使えるようになったので使ってみました。
これまで新規テーブルになっちゃって悩んでいた方はぜひ使ってみてください。
独自の料金仕様になっているので大量データを取り込む時は注意してご利用ください。