AWS EC2インスタンスでDeepSeek V4 Flashをセルフホストして、性能とコストをFireworks AIと比較検証してみた

こんちには。製造ビジネステクノロジー部の中村(@nokomoro3)です。
オープンウェイトのLLMを自身が管理する環境へセルフホスティングする場合、デプロイしてレスポンスが返ることだけではなく、実用的な速度でテキスト生成ができるかどうかも重要なポイントです。
本記事では、AWSのECS on EC2環境へDeepSeek V4 Flash NVFP4を展開し、vLLMのOpenAI互換APIとして実行して性能を測定します。
性能は、1秒間に生成した出力トークン数(output tok/sec)と最初のトークンが届くまでの時間(TTFT)で測定します。
さらに、実測した処理トークン数とAWS利用費を基に、Fireworks AIとのコストパフォーマンスを比較します。
結論
今回、DeepSeek V4 Flash NVFP4をg7e.12xlarge(RTX PRO 6000 Blackwell ×2)へ展開し、vLLMを使ってOpenAI互換APIとして動作させることができました。
短い日本語入力では、Decode用CUDA Graphによって並列数1の生成速度が10.4 tok/secから約104 tok/secへ向上し、合成入力に対してMTP=1を適用した条件では135.6 tok/sec、4並列では合計358.4 tok/secを記録しました。
ただし、4並列の実測値を月間稼働へ換算した今回の条件では、AWSの月額費用はFireworks AIの約2.2倍から10.7倍となり、単純なコスト比較ではマネージドAPIが優位という結果になりました。
検証用コード
本記事では、Terraformで構築したAWS環境と、OpenAI互換APIを呼び出すベンチマークスクリプトを使用しています。
作成したものは以下のGitHubリポジトリにまとめています。
Terraformによる初回デプロイ、GPU環境の起動、疎通確認、ベンチマーク、停止、環境全体の削除までの手順は、公開リポジトリのREADME.mdを参照してください。
本記事では、AWS構成と性能改善に関係する実装だけを抜粋して説明します。
実行環境
検証対象のモデル
今回使用するモデルは、以下でNVIDIAが公開しているDeepSeek V4 Flash NVFP4です。
これはDeepSeek V4 FlashをNVIDIA ModelOptでNVFP4へ量子化したチェックポイントで、Blackwell GPU上での実行を想定しています。
Blackwell GPUはAWSのEC2インスタンスだとG7eインスタンス(RTX PRO 6000)などが該当します。
AWS構成
今回は以下のようなネットワーク構成上にECS on EC2の検証環境を構築しました。
VPC
├── Public Subnet ×1
│   ├── Internet Gatewayへのルート
│   └── NAT Gateway ×1
│
└── Private Subnet ×2(2 AZ)
    ├── Internal ALB
    ├── EC2
    └── ECS Task
          └── vLLM OpenAI互換API
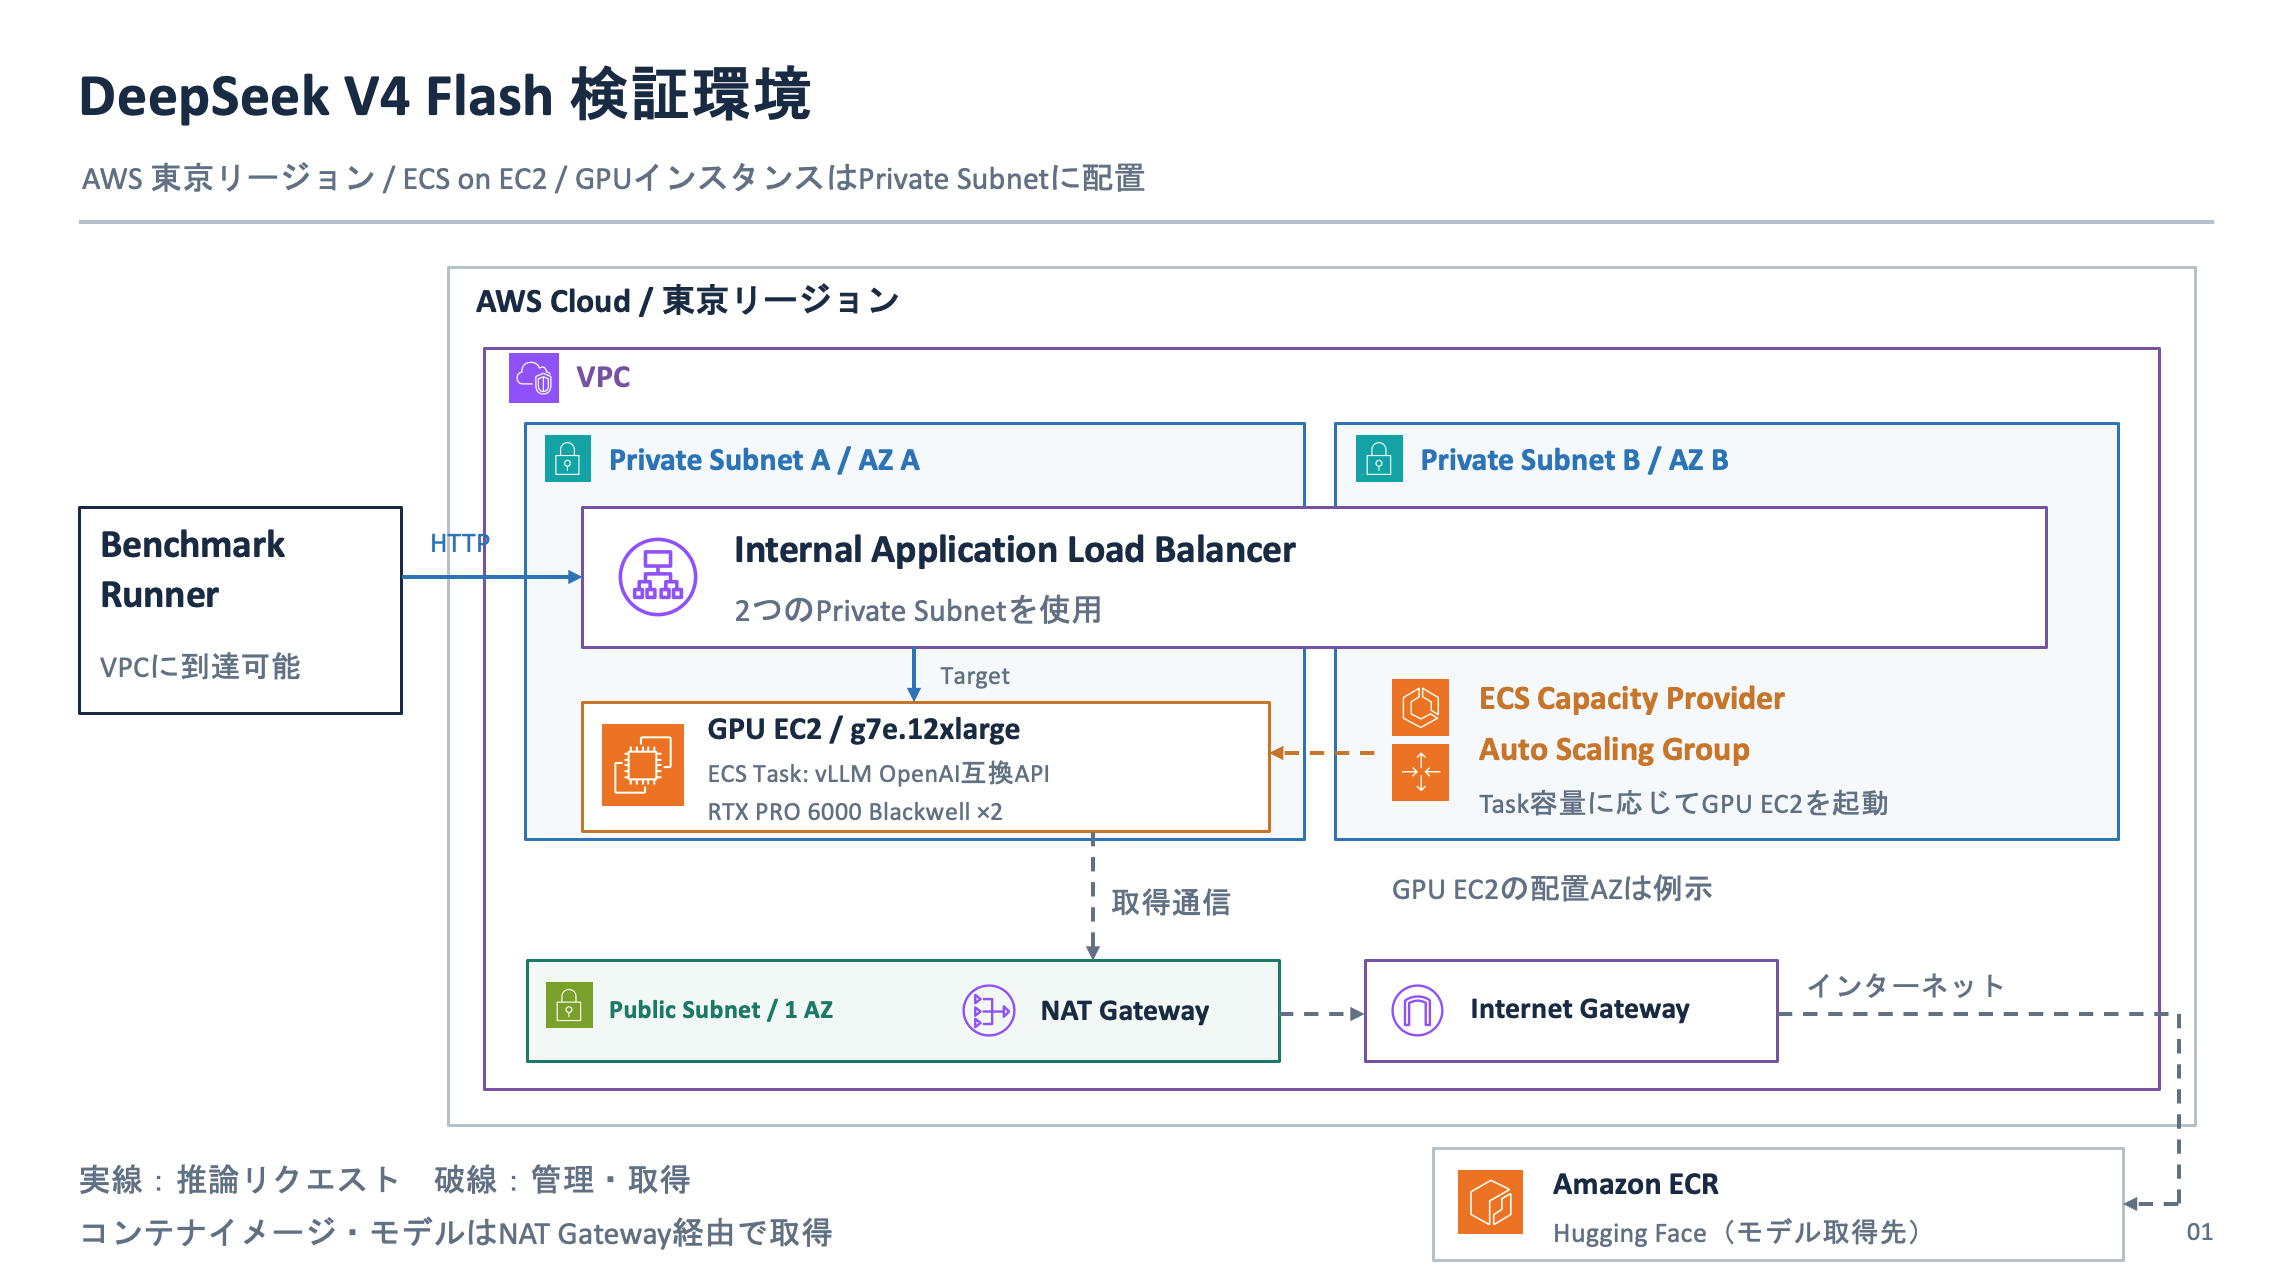
Public SubnetはNAT Gatewayを置くためだけに使用しています。GPU EC2やECS TaskにはPublic IPを付与せず、モデルやコンテナの取得はPrivate SubnetからNAT Gateway経由で行います。
ECSタスクの起動および停止
サーバーの起動および停止は、スクリプトを使ってローカルから行います。起動と停止それぞれ以下のような流れで実行されます。
-
起動(scripts/ecs-start.shを実行)
- ECS Serviceのdesired countを1にする
- ECS Taskが配置待ち(PENDING)になる
- ECS Capacity Providerが必要なEC2容量を検知し、ASG(Auto Scaling Group)をスケールアウトする
- ASGがGPU EC2を起動する
- EC2上のECS AgentがECS Clusterへ参加する
- ECSがEC2上へvLLMのECS Taskを配置する
- コンテナが起動し、モデルのダウンロード/ロードなどvLLMの起動処理が実行される
- ヘルスチェック成功後、ALB Targetがhealthyになる
-
停止(scripts/ecs-stop.shを実行)
- ECS Serviceのdesired countを0にする
- vLLMのECS Taskが停止し、ALB Targetから登録解除される
- 同じCompute Poolを利用する別のECS Serviceが稼働していないことを確認する
- ASGのdesired capacityを0にする(待てばCapacity ProviderがEC2を削除するが、待ちがあるため今回は明示的に削除)
- GPU EC2が終了する
- EC2のroot EBSとモデルキャッシュも削除される
なおスクリプトではServing ProfileとCompute Poolという概念を使っています。
./scripts/ecs-start.sh deepseek-v4-flash
./scripts/ecs-stop.sh deepseek-v4-flash
起動・停止スクリプトはServing Profileを指定すると対応するECS Serviceのdesired countを変更します。
profile_names() {
  echo "nemotron-nano deepseek-v4-flash"
}

profile_service_name() {
  case "$1" in
    nemotron-nano)
      echo "self-hosted-llm-poc-vllm"
      ;;
    deepseek-v4-flash)
      echo "self-hosted-llm-poc-deepseek-v4-flash"
      ;;
  esac
}

profile_pool_name() {
  case "$1" in
    nemotron-nano)
      echo "g7e-1gpu"
      ;;
    deepseek-v4-flash)
      echo "g7e-2gpu"
      ;;
  esac
}
EC2の構成
EC2のAMIには、ECS-optimized Amazon Linux 2023 GPU AMIを使用しました。
このAMIにはECS Agentに加え、NVIDIA GPUをECS Taskから利用するためのソフトウェア(NVIDIA GPUドライバーとNVIDIA Container Toolkitなど)が含まれています。
Launch Templateでは、AMI、インスタンスタイプ、EBS、IAM Instance Profile、Security Group、User Dataを定義しています。
主要な設定を抜粋すると、次のようになります。
resource "aws_launch_template" "this" {
  name_prefix   = "${var.name_prefix}-${var.resource_suffix}-"
  image_id      = var.ecs_gpu_ami_id
  instance_type = var.instance_type

  update_default_version = true

  iam_instance_profile {
    arn = var.instance_profile_arn
  }

  vpc_security_group_ids = var.security_group_ids

  block_device_mappings {
    device_name = "/dev/xvda"

    ebs {
      volume_type           = "gp3"
      volume_size           = var.root_volume_size_gib
      encrypted             = true
      delete_on_termination = true
    }
  }

  metadata_options {
    http_endpoint               = "enabled"
    http_tokens                 = "required"
    http_put_response_hop_limit = 2
    instance_metadata_tags      = "enabled"
  }

  user_data = base64encode(templatefile(
    "${path.module}/templates/ecs-user-data.sh.tftpl",
    { ecs_cluster_name = var.ecs_cluster_name }
  ))
}
User Dataで、起動したEC2をECS Clusterへ登録し、GPUサポートを有効にします。これによりECSは、Task Definitionの要求に基づいてGPUをコンテナへ割り当てます。
#!/bin/bash
set -euo pipefail

cat <<'ECS_CONFIG' >> /etc/ecs/ecs.config
ECS_CLUSTER=${ecs_cluster_name}
ECS_ENABLE_GPU_SUPPORT=true
ECS_ENABLE_TASK_IAM_ROLE=true
ECS_ENABLE_TASK_IAM_ROLE_NETWORK_HOST=true
ECS_CONFIG

mkdir -p /var/lib/llm-model-cache
chmod 0755 /var/lib/llm-model-cache
/var/lib/llm-model-cacheをECS Taskへマウントし、モデルダウンロードのキャッシュとして使用します。ただし、現在のASGはscale-in時にEC2とroot EBSを削除するため、次回起動時にはモデルを再取得します。
vLLM
vLLMは、大規模言語モデル(LLM)の推論(Inference)とサービング(API提供)を効率化するオープンソースライブラリです。LLMの本番運用で広く使われています。
OpenAI API(/v1/chat/completionsなど)と同じインターフェースを持つAPIサーバーを、コマンド1行で起動できます。
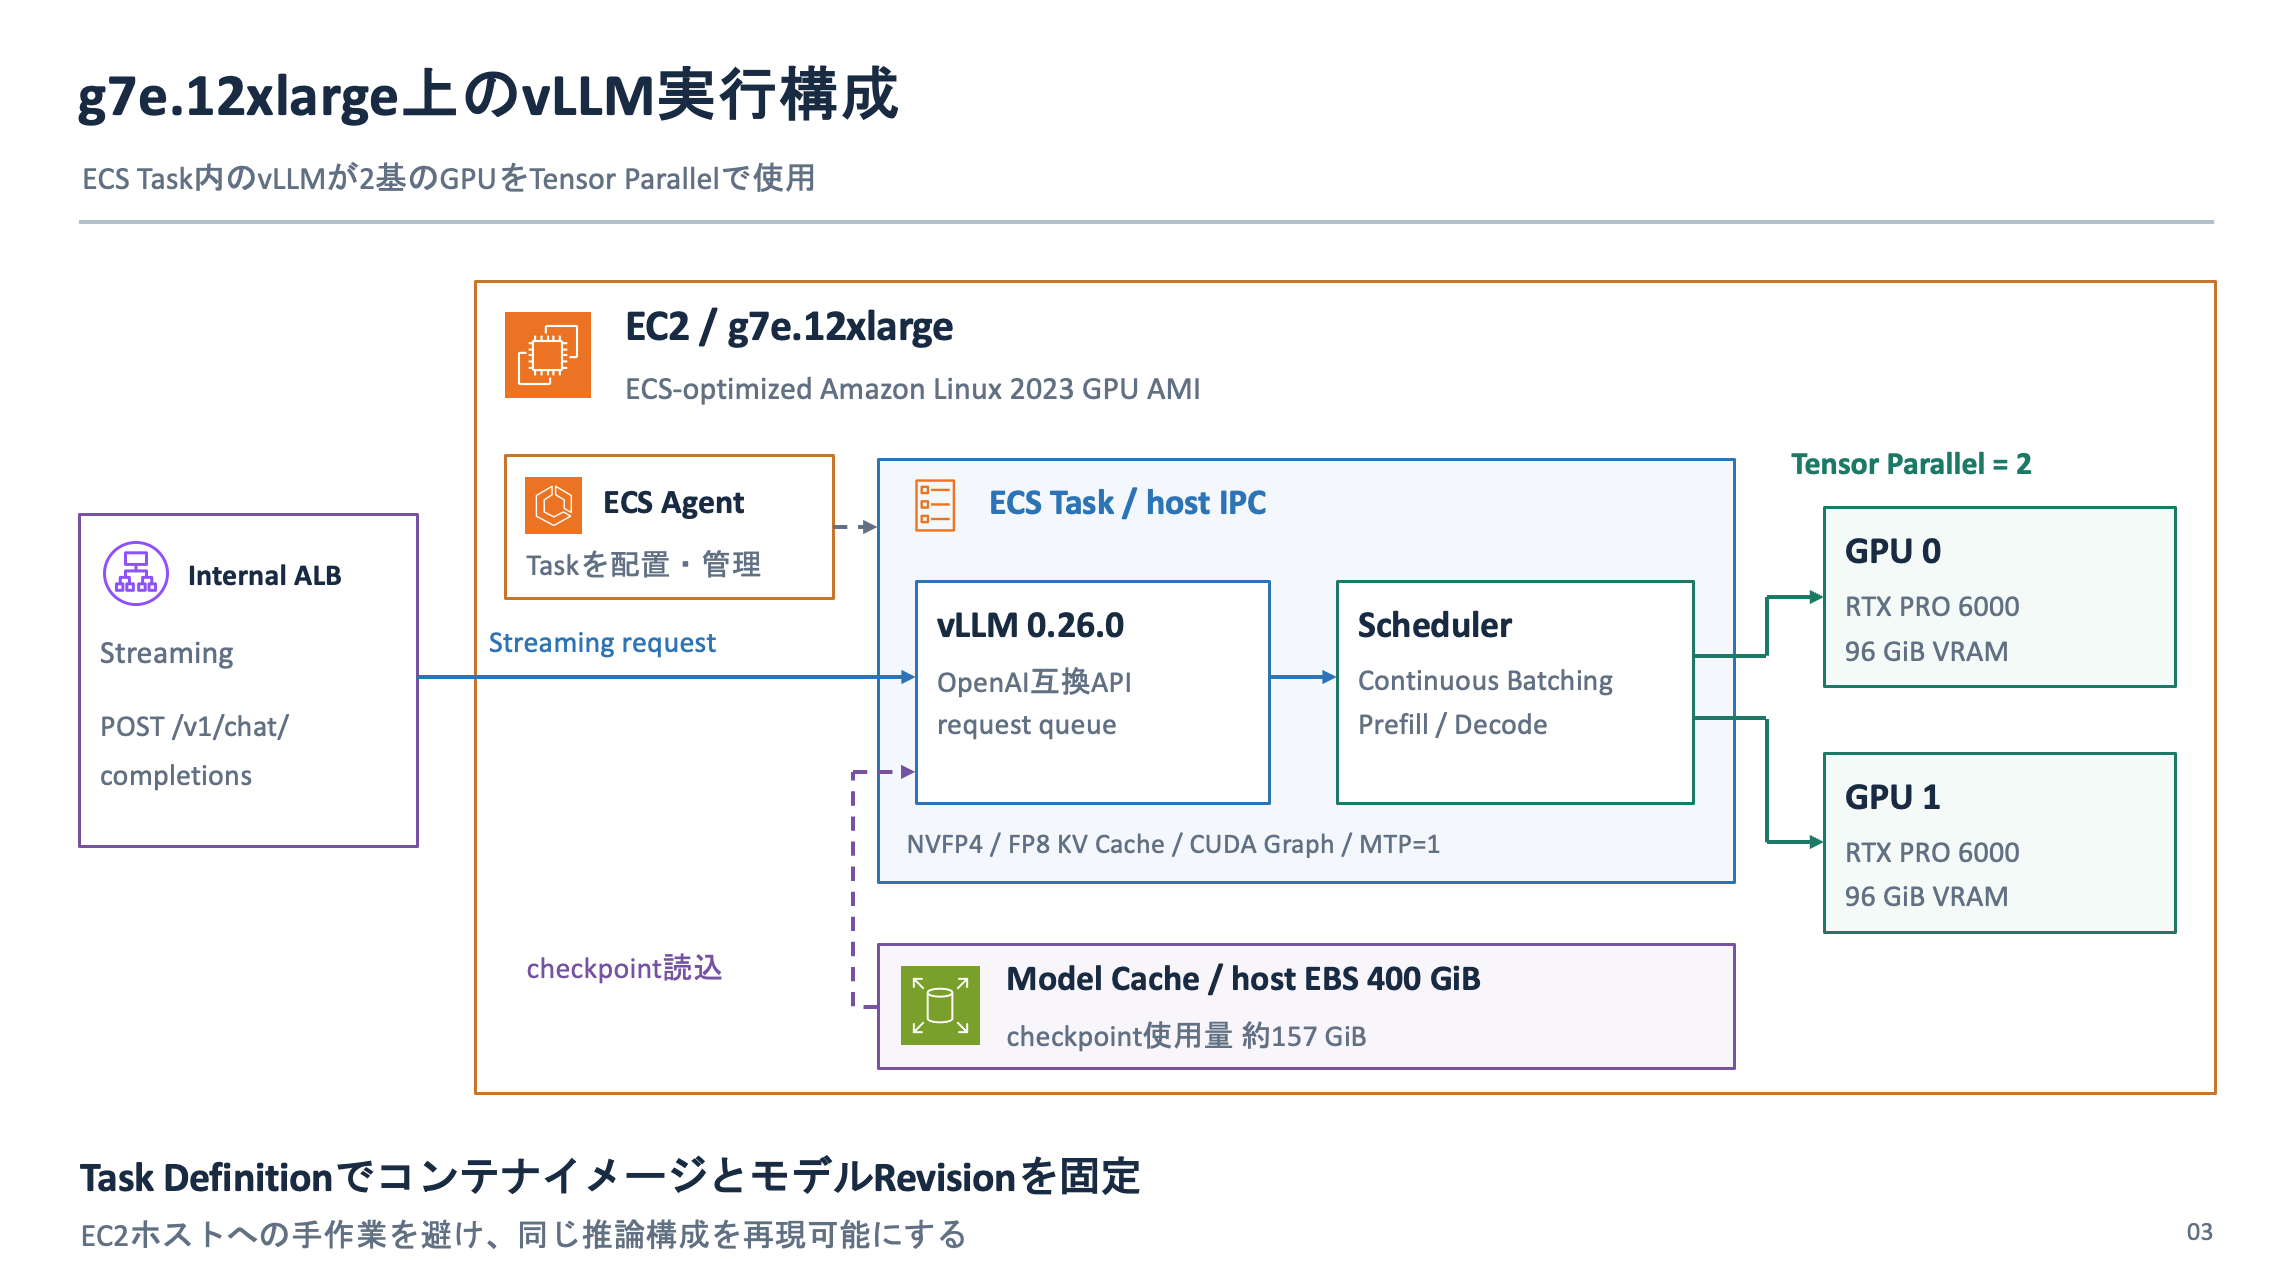
またContinuous Batching(継続的バッチング)という機能を持ち、トークン単位で動的にバッチを更新することで複数のリクエストを同時に処理することができます。
以下は、モデルロードとOpenAI互換APIの疎通を優先し、CUDA Graphを無効化した初期構成のコマンド例です。
vllm serve nvidia/DeepSeek-V4-Flash-NVFP4 \
  --revision 48bfe38c62be14e8d82f9e3be12fe5d30a2e38c8 \
  --host 0.0.0.0 \
  --port 8000 \
  --tensor-parallel-size 2 \
  --max-num-seqs 4 \
  --max-num-batched-tokens 2048 \
  --max-model-len 8192 \
  --gpu-memory-utilization 0.95 \
  --kv-cache-dtype fp8 \
  --tokenizer-mode deepseek_v4 \
  --reasoning-parser deepseek_v4 \
  --tool-call-parser deepseek_v4 \
  --enable-auto-tool-choice \
  --trust-remote-code \
  --enforce-eager
このコマンドはHugging Faceから指定したモデルを取得してロードし、OpenAI互換APIとしてサービングします。
実際にECS Taskへ渡す起動オプションは、infra/terraform/locals.tfで管理しています。
性能測定方法
測定には、公開リポジトリのbenchmark/streaming_benchmark.pyを使用しました。
測定に使用するデータ
今回の性能測定では、回答品質ではなく応答性能にフォーカスしました。
条件ごとに入力長を固定し、出力長を256 tokensに揃えてvLLMの推論性能を比較しました。
入力データについて
測定段階によって、次の2種類の入力データを使っています。
初期構成とCUDA Graphの比較では、同じ短い日本語プロンプトを使用しました。
日本の首都について簡潔に説明してください。
入力長の影響確認、並列数による比較、MTPの改善確認では、次の定型文を繰り返した合成プロンプトを使用しました。
This is deterministic benchmark input text.
ベンチマークツールは上記の合成プロンプトを繰り返しながら、vLLMの/tokenizeを使ってChat Template適用後のトークン数を確認します。
目標に最も近い長さになるまで定型文の繰り返し回数を調整した結果、実入力長は次の値になりました。
| 区分 | 目標入力tokens | 実入力tokens |
|---|---|---|
| 短文 | 256 | 254 |
| 2K入力 | 2,048 | 2,046 |
| 8K入力 | 8,192 | 8,185 |
出力データについて
出力長を固定するため、すべてのリクエストでmax_tokens=256とignore_eos=trueを指定し、モデルがEOSを生成しても256 tokensまで出力させました。
Prefix Cacheの再利用防止について
LLMの推論は、入力全体を処理してKV Cacheを作成するPrefillと、そのKV Cacheを参照しながら1 tokenずつ出力するDecodeに分かれます。Decodeでは、生成したtokenの情報が同じKV Cacheへ順次追加されます。
Prefix Cacheは異なるユーザのリクエストであっても冒頭部分が同じ入力であれば、Prefillで作成したKV Cacheをリクエスト間で再利用し、応答を素早くする仕組みです。
今回の測定では同じ合成プロンプトを繰り返すため、Prefix Cacheが再利用されると2回目以降のPrefillが短縮されてきちんとした測定ができなくなります。そこで各リクエストに異なるcache_saltを設定し、リクエスト間でPrefix Cacheを再利用しない条件に揃えました。
生成条件について
生成条件はtemperature=0、seed=42に固定しました。
各条件でwarm-upを2 rounds実行して集計から除外し、その後の5 roundsを本計測として集計しました。
測定する指標
性能は以下の4指標で評価します。
| 指標名 | 計算方法 | 示すもの・見方 |
|---|---|---|
| TTFT(Time to First Token) | 最初の非空の生成内容を受信した時刻 − リクエスト開始時刻 | 最初の1文字が出るまでの待ち時間 (ネットワーク、キュー待ち、Prefill処理を含む) |
| E2E output tok/sec | 256 tokens ÷ リクエスト開始から完了までの時間 | 1リクエスト全体の平均生成速度 (TTFTを含むためPrefillが長くなると低下する) |
| Decode output tok/sec | 255 tokens ÷ 最初の出力受信から完了までの時間 | 最初の文字が出た後の純粋な生成速度 (ストリーミング表示の体感速度に近い) |
| Aggregate output tok/sec | 全リクエストの出力tokens合計 ÷ round開始から全件完了までの時間 | GPU全体の総スループット (並列処理時にGPUが1秒あたりに吐き出した総トークン量) |
1並列時は「E2E output tok/sec」と「Aggregate output tok/sec」はほぼ同義となります。
複数リクエストを同時に処理する並列検証では、システム全体の処理能力として「Aggregate output tok/sec」に着目します。
初期構成の測定結果
最初はモデルのロードとOpenAI互換APIの疎通を優先し、CUDA Graphを使わないEager実行にしました。この構成では以下のような結果となっています。
| TTFT中央値 | E2E output tok/sec中央値 | Decode output tok/sec中央値 | Aggregate output tok/sec中央値 |
|---|---|---|---|
| 110.0ms | 10.39 tok/sec | 10.40 tok/sec | 10.39 tok/sec |
CUDA Graphによる性能改善
CUDA Graphとは
通常の実行方式(Eager実行)では、トークンを1つ生成するたびに、CPUがGPUへ「次の処理」を1回ずつ指示します。生成AIのDecode処理(文字を出し続ける処理)は、同じ計算をトークンごとに何度も繰り返すため、指示を出すCPU側の待ち時間(オーバーヘッド)が積み重なってしまいます。
CUDA Graphは、一連のGPU処理の手順(どの命令をどの順番でGPUメモリのどこを使って実行するか)をあらかじめ記録しておき、Decode時にまとめて呼び出す仕組みです。CPUからGPUへの呼び出し回数を大幅に減らせるため、1トークンずつ生成するDecodeの処理速度を大きく引き上げることができます。
CUDA Graphの設定方法
今回はCUDA Graph単体の効果を正確に測るため、torch.compileは無効にしたまま、Decode処理だけにCUDA Graphを適用しました。設定はvllm serveの--compilation-configに以下のJSONを指定します。
{
  "mode": 0,
  "cudagraph_mode": "FULL_DECODE_ONLY",
  "cudagraph_capture_sizes": [1, 2, 4]
}
mode: 0:torch.compileを無効化します。FULL_DECODE_ONLY: Decode処理のみをCUDA Graphの対象にします。cudagraph_capture_sizes: 事前にGPU処理の手順を記録しておく実行想定の並列数(バッチサイズ)です。今回は最大並列数に合わせて1, 2, 4を指定しました。
CUDA Graphを適用した結果(並列数1)
CUDA Graphを使用するためにvLLMを更新したため、Eager実行同士の比較も加えてバージョン差の影響を確認しました。
| 構成 | E2E output tok/sec | Decode output tok/sec | TTFT中央値 |
|---|---|---|---|
| vLLM 0.25.0 + Eager | 10.39 tok/sec | 10.40 tok/sec | 110.0ms |
| vLLM 0.26.0 + Eager | 9.77 tok/sec | 9.77 tok/sec | 115.8ms |
| vLLM 0.26.0 + Decode用CUDA Graph | 103.95 tok/sec | 108.59 tok/sec | 114.3ms |
バージョンアップの影響でEager実行時はvLLM 0.26.0の方がわずかに低下していますが、Decode用CUDA Graphを適用したことで、E2E output tok/sec、Decode output tok/sec ともに約10倍に高速化しました。CPUディスパッチのオーバーヘッドが劇的に解消されたことがわかります。
CUDA Graphの注意点
想定外のサイズが来ると通常実行に戻ってしまう
CUDA Graphは「事前に記録したバッチサイズ」でしか動かせません。記録にないサイズのリクエストが来ると、元の遅い通常実行(フォールバック)に戻ってしまいます。
GPUメモリを少し消費する
処理手順をGPU側に保持しておくため、GPUメモリを約0.17GiB追加で消費します。
これによりKV Cacheの容量が約1.8%減少しますが、約10倍という大幅な速度改善を考えれば十分に許容できる範囲です。
CUDA Graphの内部仕様について詳しく知りたい方は、vLLM CUDA Graphs 公式ドキュメントをご参照ください。
入力長と並列数による性能差
ここまでの比較では短い入力を並列数1で測定しましたが、Continuous Batchingでは複数のリクエストを同時に処理できるため、並列数を増やすとGPU全体のスループットも向上します。
Continuous Batchingとは
通常の固定バッチでは、同じバッチに含まれるすべてのリクエストが完了するまで、次のリクエストを処理へ追加できません。
vLLMのContinuous Batchingは、Decodeのiterationごとに処理対象を組み替えます。
完了したリクエストをバッチから外し、待機中のリクエストを空いた枠へ追加することで、GPUを継続的に利用します。
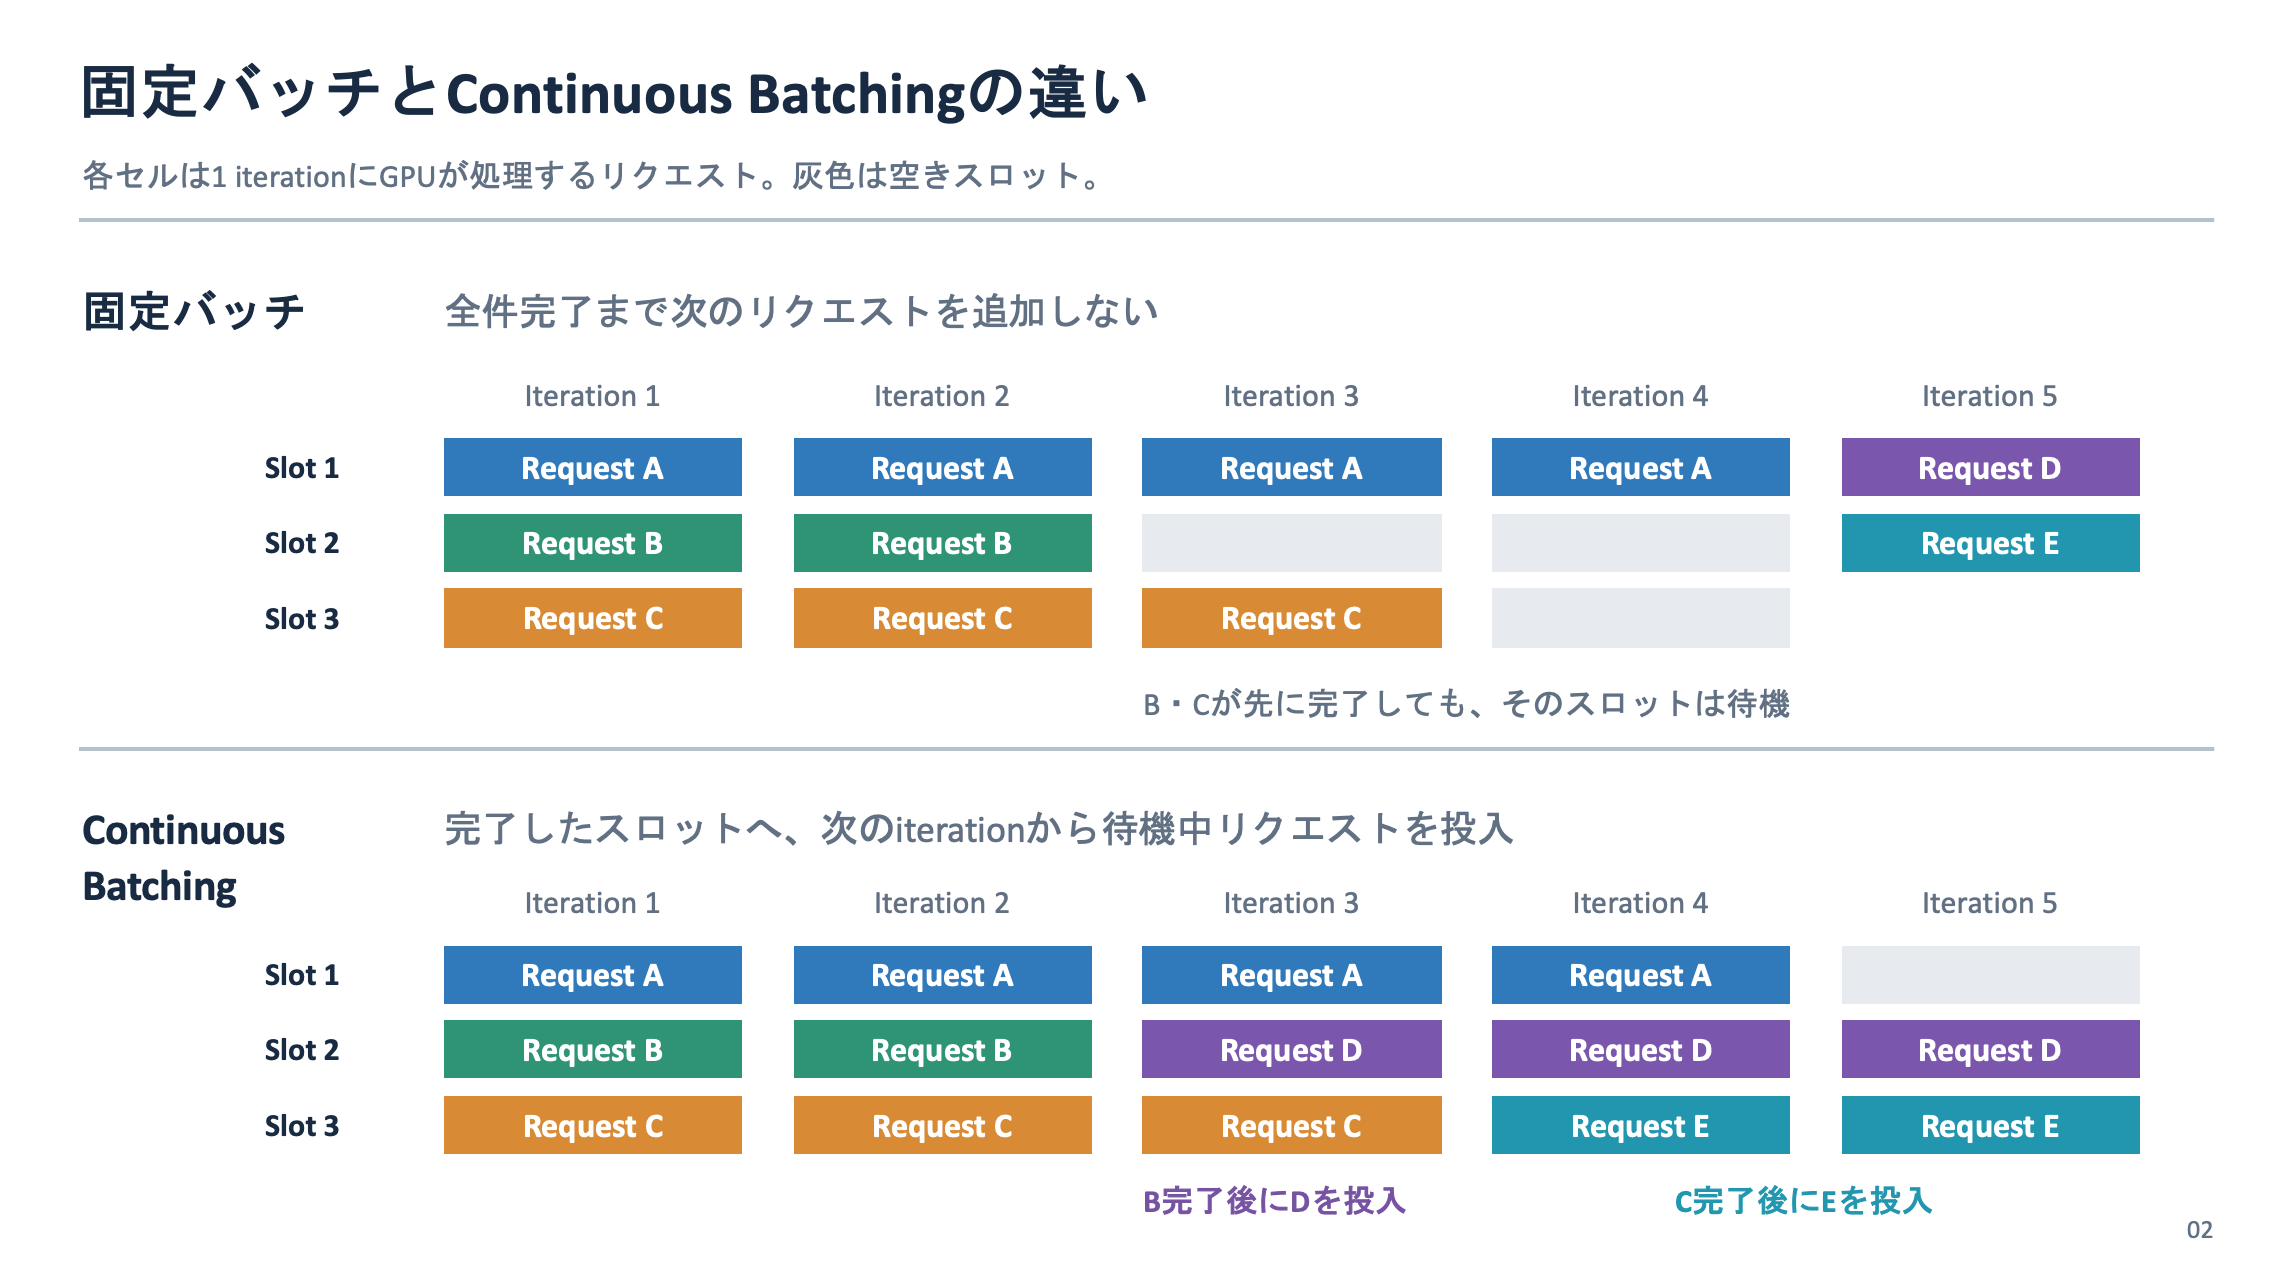
これによりGPU全体の総スループットを高められますが、複数のリクエストがGPUの計算リソースを共有するため、1リクエスト当たりの生成速度やTTFTが必ず改善するわけではありません。
入力長と並列数を変えた結果
入力長と並列数を変化させた場合の測定結果は以下のとおりです。
| 実入力tokens | 並列数 | Aggregate output tok/sec (GPU全体の総スループット) |
1リクエスト E2E output tok/sec (個別リクエストの平均速度) |
TTFT中央値 (最初の1文字の待ち時間) |
|---|---|---|---|---|
| 254 | 1 | 102.67 tok/sec | 102.69 tok/sec | 112.9ms |
| 254 | 2 | 169.88 tok/sec | 85.34 tok/sec | 171.6ms |
| 254 | 4 | 297.09 tok/sec | 74.62 tok/sec | 229.6ms |
| 2,046 | 1 | 98.82 tok/sec | 98.84 tok/sec | 182.6ms |
| 2,046 | 2 | 161.64 tok/sec | 81.08 tok/sec | 272.4ms |
| 2,046 | 4 | 261.72 tok/sec | 65.74 tok/sec | 444.5ms |
| 8,185 | 1 | 83.02 tok/sec | 83.03 tok/sec | 691.8ms |
| 8,185 | 2 | 123.73 tok/sec | 62.05 tok/sec | 1,029.2ms |
| 8,185 | 4 | 172.28 tok/sec | 43.46 tok/sec | 1,702.6ms |
短文(254 tokens)において並列数を1から4に増やすと、GPU全体の総スループット(Aggregate output tok/sec)は約2.89倍(102.67 → 297.09 tok/sec)に大きくスケールしました。一方でGPUリソースを分け合うため、1リクエスト当たりの生成速度(E2E output tok/sec)は約102.7 tok/secから約74.6 tok/secへ低下し、TTFTも約2倍になります。
また、1並列時のDecode output tok/sec(表中のE2EからTTFTを除いた純粋な生成速度)は入力長に関わらず約106〜107 tok/secで一定でした。長い入力でE2E output tok/secが低下した主因はDecode自体の遅延ではなく、最初のtokenを生成する前のPrefill時間の増大(TTFTの悪化)であることが確認できます。
Prefillのバッチ上限の調整
Prefillのバッチ上限を設定する
LLMが最初の1文字を出力する前に、入力されたプロンプト全体をまとめて読み込んで計算する処理を「Prefill(入力処理)」と呼びます。
このPrefillが完了するまで回答の生成は始まらないため、入力文章が長くなるほど、最初の1文字が出るまでの待ち時間(TTFT)も長くなります。max-num-batched-tokensは、vLLMのスケジューラーが1回の処理単位(iteration)でPrefillやDecodeに割り当てるトークン数の上限です。
今回の初期設定値は2,048です。変更する場合は、vllm serveの--max-num-batched-tokensに指定します。例えば以下のように指定します。
--max-num-batched-tokens 4096
バッチ上限を変更した結果
2,048を基準として、4,096 8,192 16,384の4パターンで「長文(8Kトークン)・4並列」の性能を比較しました。
| max-num-batched-tokens | 8K・4並列 TTFT中央値 (最初の1文字の待ち時間) |
8K・4並列 Aggregate output tok/sec (GPU全体の総スループット) |
|---|---|---|
| 2,048 | 1,702.6ms | 172.28 tok/sec |
| 4,096 | 1,568.4ms | 178.30 tok/sec |
| 8,192 | 1,537.7ms | 180.49 tok/sec |
| 16,384 | 1,812.1ms | 181.45 tok/sec |
上限を4,096に引き上げることで、初期設定値(2,048)と比べて8K入力の分割回数が減り、TTFT中央値を約7.9%短縮(約1.70秒 → 約1.57秒)できました。
また、GPU全体の総スループット(Aggregate output tok/sec)も約3.5%改善しています。
8,192にすると8K単体のTTFTはさらに縮みますが、後述するトレードオフが発生したため、最終的に全条件のバランスが良い4,096を採用値としました。以降はこの設定値(4,096)で測定を続けます。
Prefillのバッチ上限調整の注意点
数値を大きくしすぎると、逆に他のリクエストを待たせてしまう
1回に処理できるトークン枠を大きく広げすぎると、長文のPrefillがGPUの計算リソースを長時間占有してしまいます。
その結果、「並行して動いている他のユーザーの文字生成(Decode)や、後から来た別のリクエスト」が順番待ちになって遅くなるという現象が起きます(vLLMがわざわざ入力を小分けにして処理するのも、この占有を防ぐためです)。
実際に8,192に設定した際、8K入力単体はわずかに速くなったものの、中文(2Kトークン)・4並列のTTFT中央値が約640msまで大幅に悪化しました。さらに16,384では、GPUへの負荷が過密になりすぎて8K入力自体のTTFTも逆に悪化してしまいました。
モデルが扱える「最大コンテキスト長」の設定ではない
名前が似ていますが、max-num-batched-tokens はあくまで「1回のステップで同時に処理するトークン数」の上限であり、モデルが受け付けられる会話全体の長さ(コンテキスト長)ではありません。
コンテキスト長は --max-model-len で別途指定します。上限を超えた入力は自動で小分け処理されるため動作自体に問題はありませんが、想定されるプロンプト長や並列数に合わせて、TTFTと総スループットのバランスを見ながら値を決める必要があります。
MTPによる性能改善
本セクションで示す測定結果は、負荷試験としての再現性を揃えるために「定型文の繰り返し入力」「
temperature: 0」「256トークン強制出力」という極めて予測しやすい条件下で計測した参考値です。
MTPの効果はトークン予測の当たりやすさ(採択率)に強く依存するため、文脈が単純な定型文では性能向上が過大評価(上振れ)されている可能性があります。実運用の自然対話や複雑な推論タスクでは採択率が低下し、ここまでの改善幅が出ない可能性がある点にご留意ください。
MTPとは
MTP(Multi-Token Prediction)は、推論を高速化する「投機的サンプリング(Speculative Decoding)」の一種です。
通常の実行方式では、重たい本体モデルがトークンを1つずつ順番に生成します。
これに対してMTPは、モデルに付属する軽量な追加パーツ(MTP head)を使って「次に来そうなトークン」をあらかじめ1つ先回りして予測(下書き)します。本体モデルはその予測が合っているかをまとめて答え合わせするだけで済むため、本体モデルを実行する回数をスキップでき、生成速度を大きく引き上げることができます。
MTPの設定方法
設定はvllm serveの--speculative-configに以下のJSONを指定します。
{
  "method": "mtp",
  "num_speculative_tokens": 1
}
method: 投機的サンプリングの手法としてmtpを指定します。num_speculative_tokens: 先回りして予測するトークン数です。今回は最も効率が良かった1を指定しています。
今回の検証では、MTP=1の予測が当たる確率(採択率)は約65%〜67%と高い水準でした。
なお、3トークン先まで予測させる設定(MTP=3)も試しましたが、2トークン目以降の採択率が低く、手戻りが発生してMTP=1の速度を下回ったため採用していません。
MTPを適用した結果
入力長と並列数を変えた合計9パターンで、MTPなしの基準構成とMTP=1におけるGPU全体の総スループット(Aggregate output tok/sec)を比較しました。
| 実入力tokens | 並列数 | MTPなし (Aggregate output tok/sec) |
MTP=1 (Aggregate output tok/sec) |
改善率 |
|---|---|---|---|---|
| 254 | 1 | 102.58 tok/sec | 135.55 tok/sec | +32.1% |
| 254 | 2 | 171.37 tok/sec | 227.95 tok/sec | +33.0% |
| 254 | 4 | 298.69 tok/sec | 358.41 tok/sec | +20.0% |
| 2,046 | 1 | 98.87 tok/sec | 128.59 tok/sec | +30.1% |
| 2,046 | 2 | 163.54 tok/sec | 213.32 tok/sec | +30.4% |
| 2,046 | 4 | 264.94 tok/sec | 330.29 tok/sec | +24.7% |
| 8,185 | 1 | 85.04 tok/sec | 106.80 tok/sec | +25.6% |
| 8,185 | 2 | 126.60 tok/sec | 151.89 tok/sec | +20.0% |
| 8,185 | 4 | 178.91 tok/sec | 202.11 tok/sec | +13.0% |
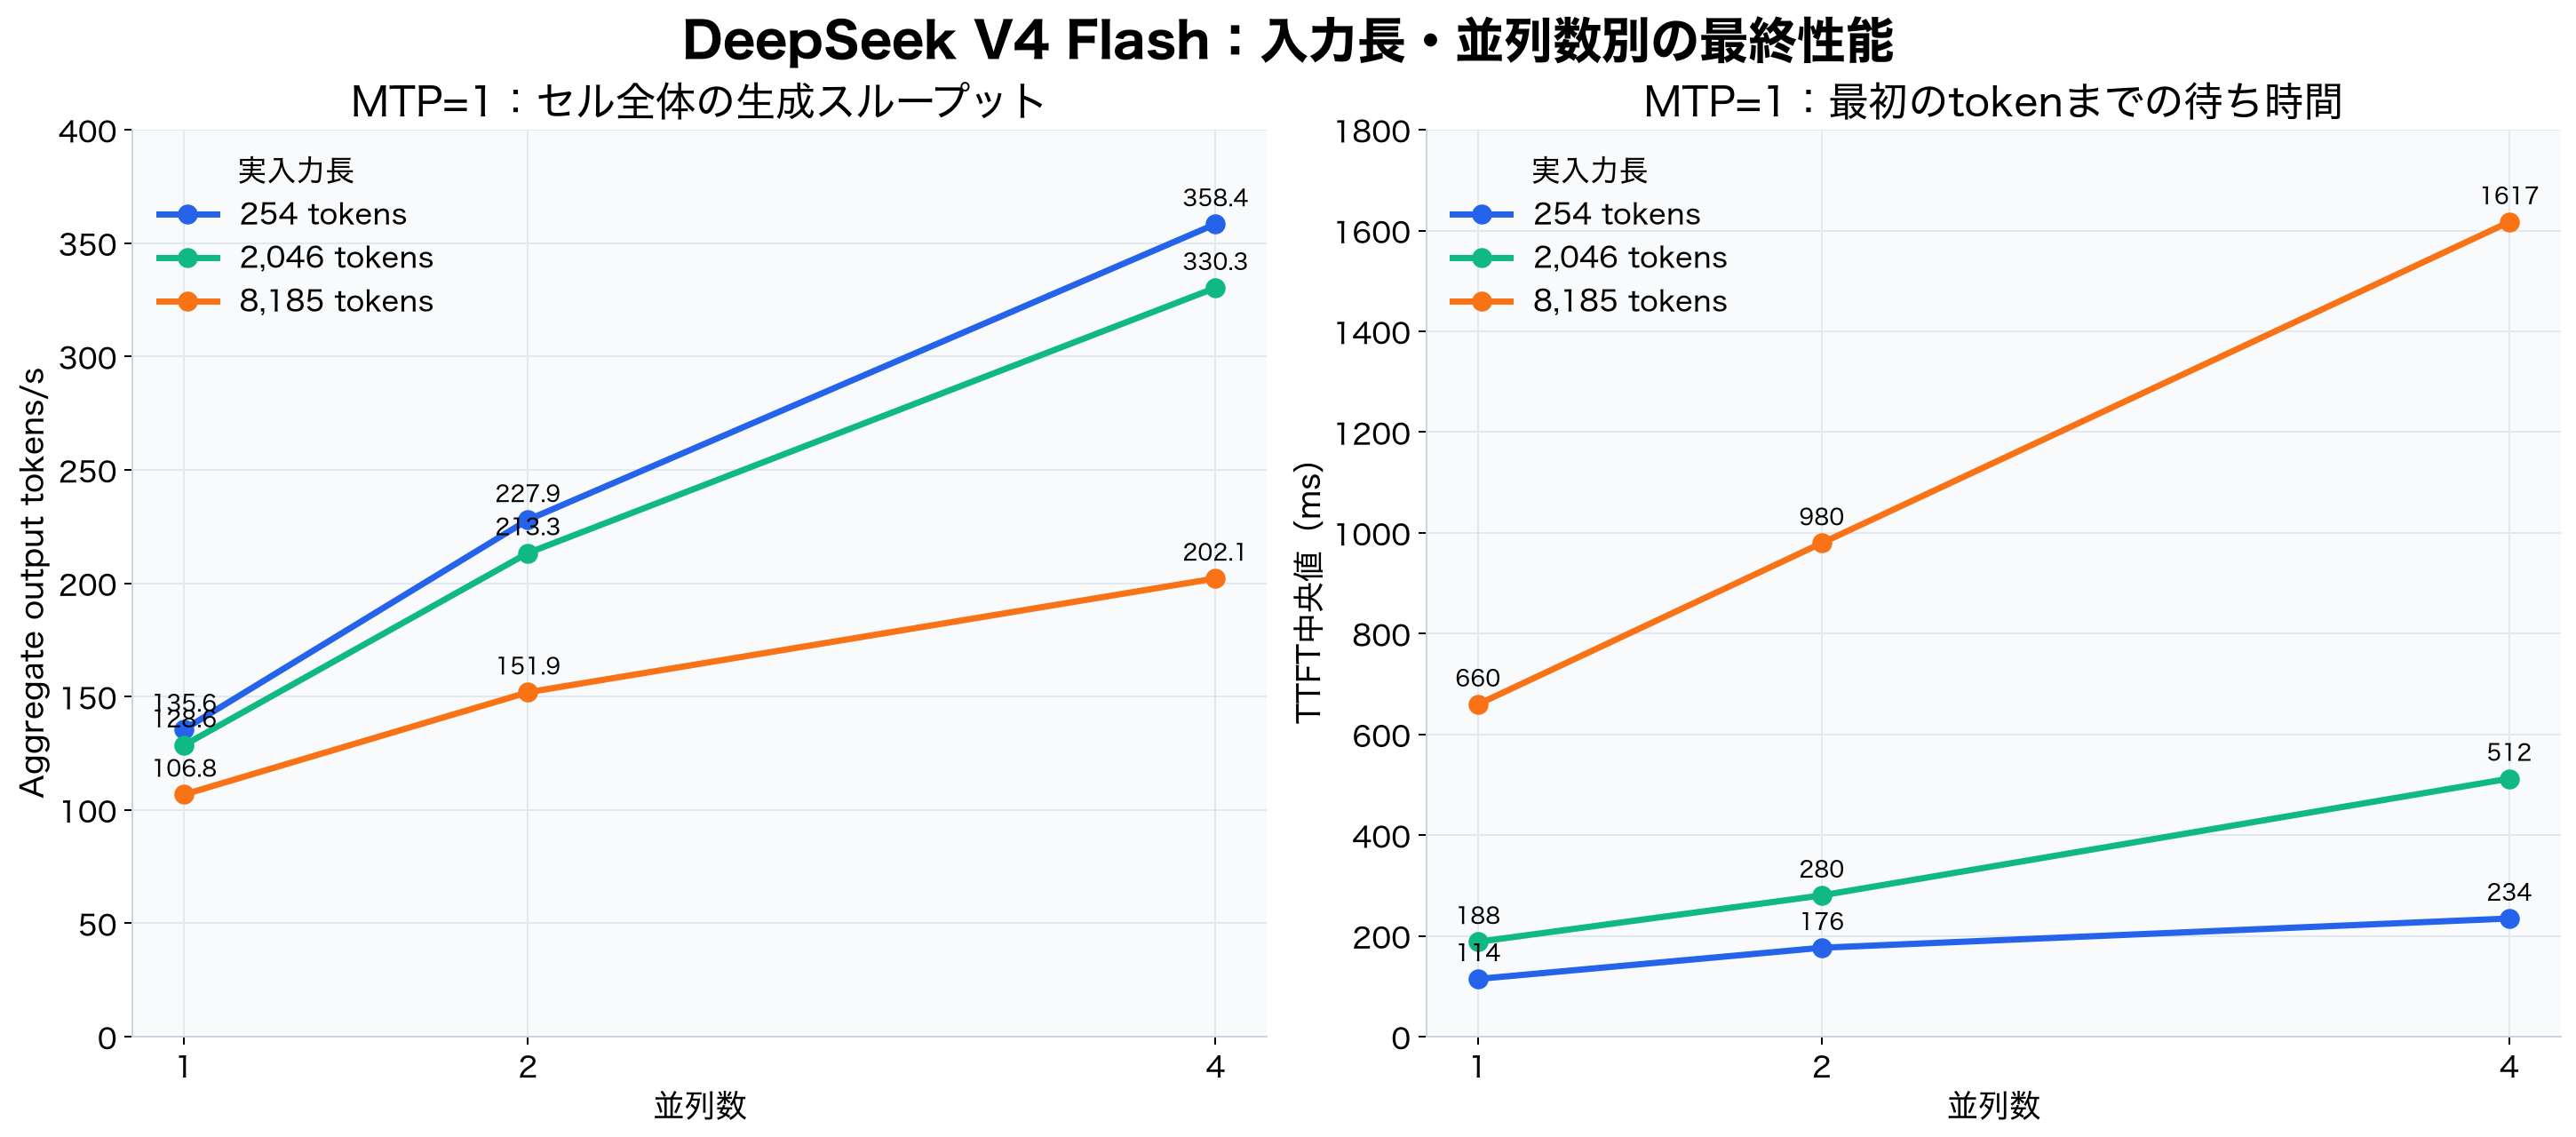
短文・並列数1では、生成速度が 102.58 tok/sec から 135.55 tok/sec へと約32.1%高速化しました。測定した9条件すべてにおいて、13.0%〜33.0%のスループット向上(Aggregate output tok/secの増加)が確認できています。入力が長くなるほど(8Kなど)本体側のPrefill計算負荷が増えるため改善率は小さくなりますが、全条件において安定したブースト効果が得られています。
MTPの注意点
CUDA Graphのcapture sizeを増やす必要がある
MTP=1では「本来の1トークン+予測の1トークン」の計2トークン分をまとめて処理します。そのため、4並列で動かすには 4リクエスト × 2トークン = サイズ8 の枠が必要になります。
CUDA Graph側の cudagraph_capture_sizes に 8 を含めておかないと、4並列の検証時だけ通常実行にフォールバックして大幅に低速化してしまうため注意が必要です。
最初の1文字が出るまでの時間(TTFT)がわずかに増加する
MTPはDecode処理を高速化しますが、先回り処理のオーバーヘッドによりTTFT中央値は0.6%〜3.8%増加しました。体感に影響するほどではないものの、TTFTの改善にはつながりません。
GPUメモリを消費する
MTP headをロードするため、GPU当たり約1.79GiBのモデルメモリを追加で消費します。
これによりKV Cacheの容量が約16.7%減少しました。今回の検証(16K context・最大4並列)ではOOMには至りませんでしたが、長文のコンテキストやさらに高い並列数を扱う場合はメモリの残量に注意が必要です。
MTPなどのSpeculative Decodingの内部仕様について詳しく知りたい方は、vLLM Speculative Decoding 公式ドキュメントをご参照ください。
段階別の性能推移(並列数1)
| 構成段階 | E2E output tok/sec (リクエスト全体の生成速度) |
Decode output tok/sec (初文字以降の生成速度) |
TTFT中央値 (初文字の待ち時間) |
改善のポイント |
|---|---|---|---|---|
| 初期構成(vLLM 0.25 / Eager) | 10.39 tok/sec | 10.40 tok/sec | 110.0ms | ベースライン |
| vLLM 0.26 / Eager | 9.77 tok/sec | 9.77 tok/sec | 115.8ms | バージョン単体では微減 |
| + Decode用 CUDA Graph | 103.95 tok/sec | 108.59 tok/sec | 114.3ms | Eager比 約10.6倍(最大のボトルネック解消) |
| + バッチ上限調整(4,096) | 102.58 tok/sec | - | 113.9ms | 長文・並列時のスループット安定化 |
| + MTP=1(最終構成) | 135.55 tok/sec | - | 114.5ms | 基準比 +32.1%(投機的サンプリングによる上乗せ) |
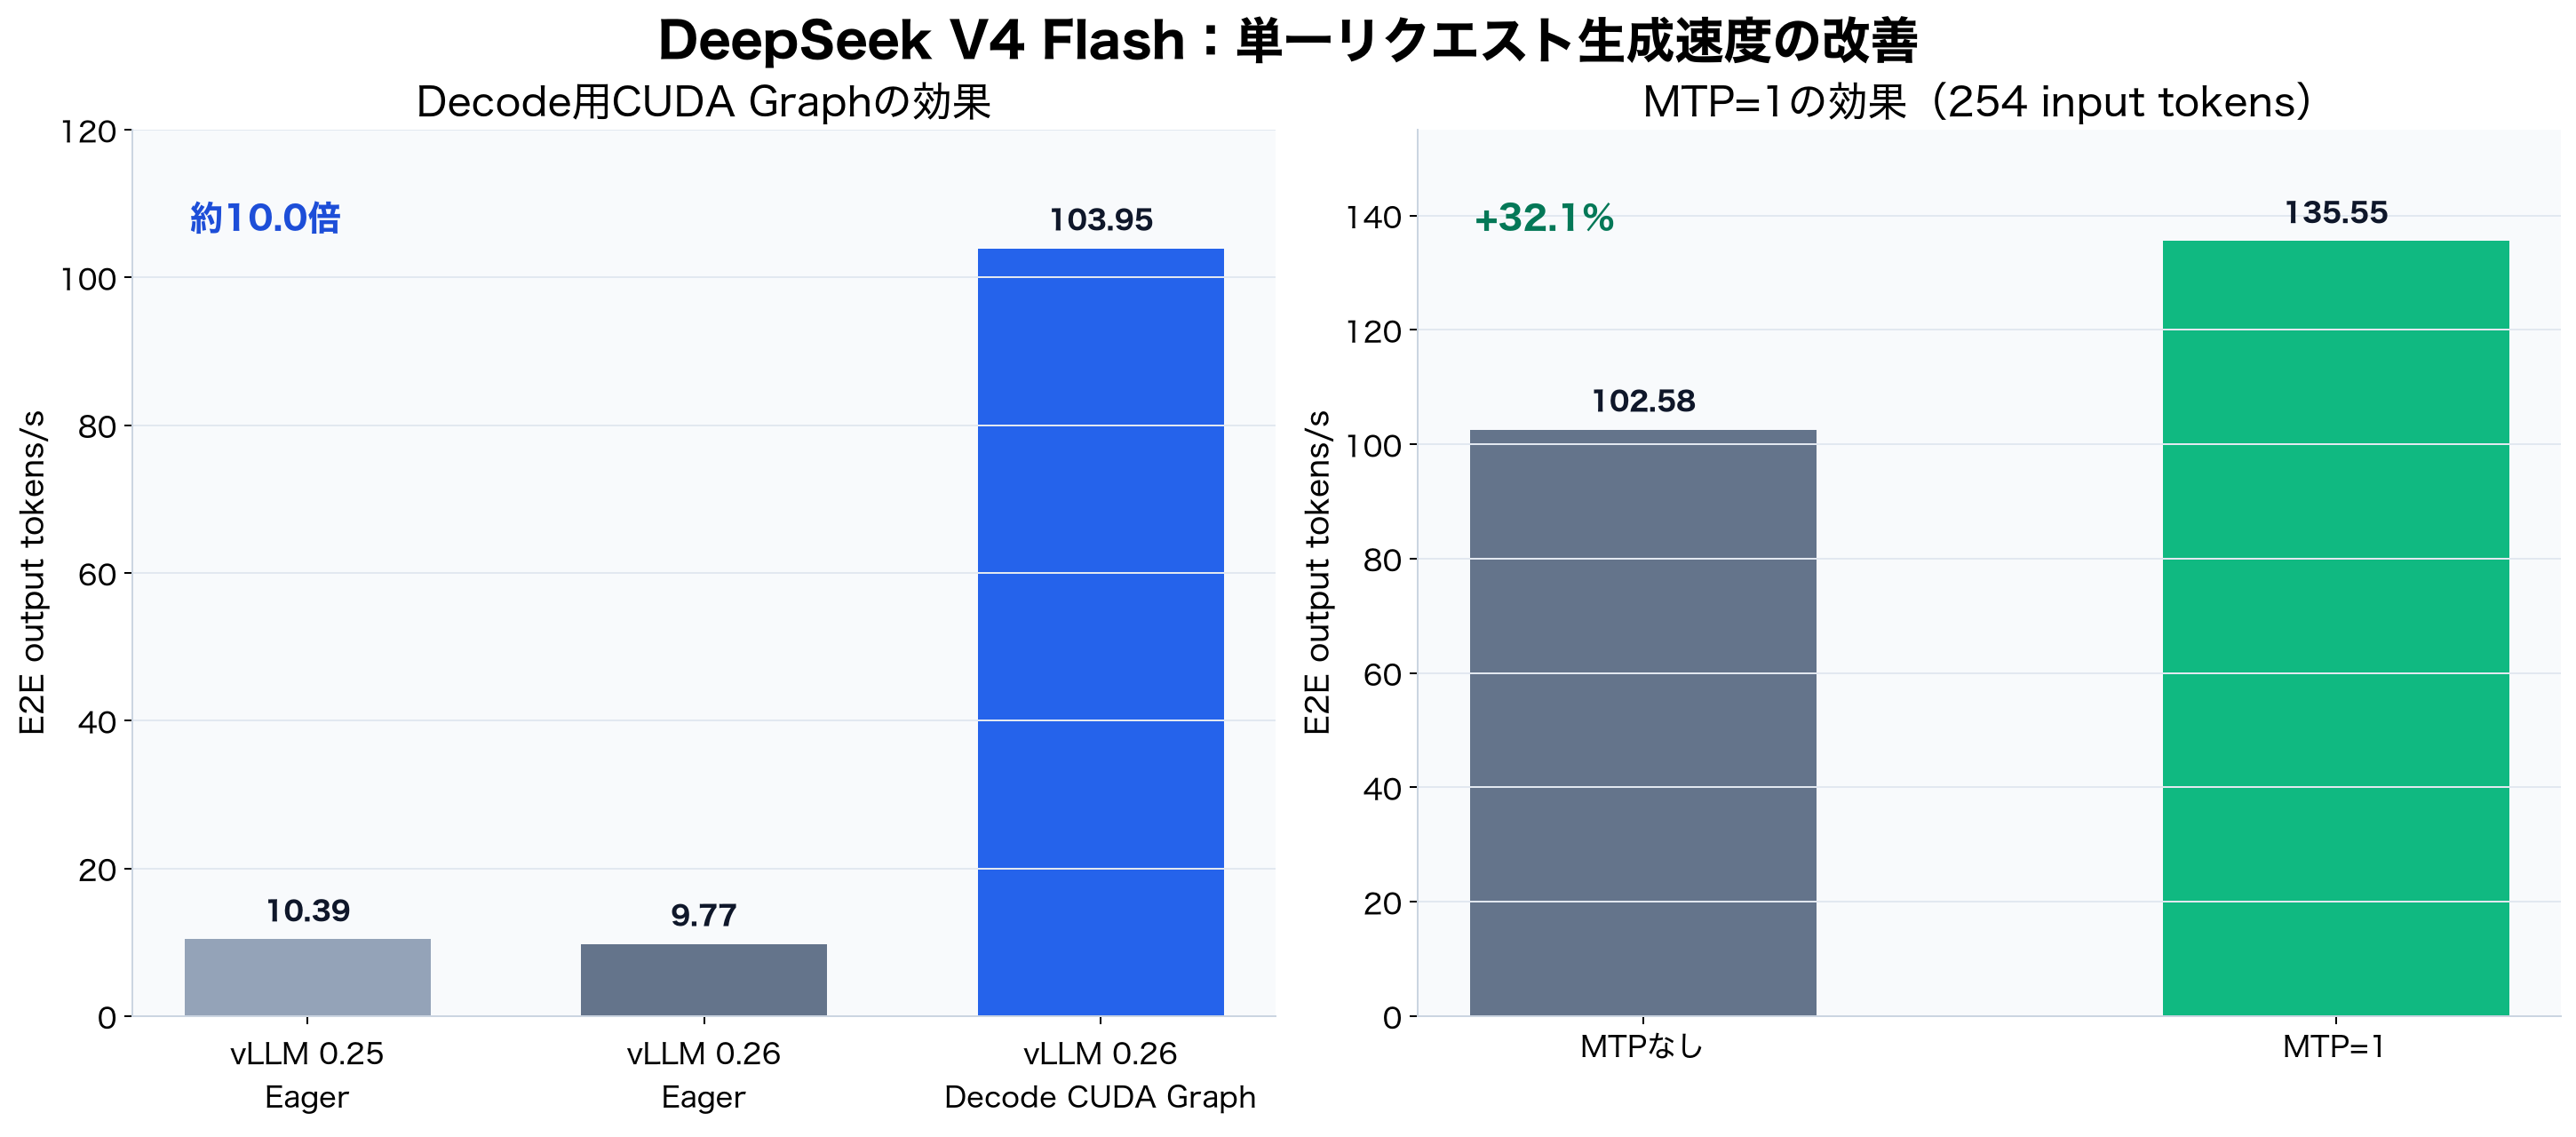
初期構成とCUDA Graphの比較では短い日本語プロンプトを使用し、バッチ上限調整とMTPの測定では254 tokensの合成プロンプトを使用しています。
この表は各段階で得た測定値の推移であり、すべての行を同一入力条件で直接比較したものではありません。
コスト比較:セルフホスト vs マネージドAPI
4並列の実測スループットを730時間維持したと仮定し、Fireworks AI(Serverless API)のトークン従量課金と比較しました。
- G7e(
g7e.12xlarge)月額: 約8,887USD(約133万円)(EC2 On-Demand 730h + ネットワーク・EBS等を含む) - Fireworks AI単価: Input $0.22 / Output $0.66(1M tokensあたり)
| プロンプト条件 | 4並列 Aggregate output tok/sec (GPU全体の総スループット) |
月間総出力トークン数 | Fireworks AI 月額換算 | コスト比(自前 / API) |
|---|---|---|---|---|
| 短文( 254 tokens) | 358.41 tok/sec | 約9.4億 tokens | 約 827USD | 自前が 約10.7倍 高い |
| 中文(2,046 tokens) | 330.29 tok/sec | 約8.7億 tokens | 約2,099USD | 自前が 約 4.2倍 高い |
| 長文(8,185 tokens) | 202.11 tok/sec | 約5.3億 tokens | 約4,087USD | 自前が 約 2.2倍 高い |
今回の4並列の実測条件では、Fireworks AIなどのマネージドAPIがセルフホストより安価になりました。
ただし、4並列は今回測定した最大並列数であり、このインスタンスで実現できる物理的な最大スループットではありません。
上の表は、測定したAggregate output tok/secを1か月維持できたと仮定した概算であり、より高い並列数、異なるバッチ構成、実運用の利用率は評価していません。
今回の測定範囲では単純なコスト削減をセルフホストの主目的にしにくく、選択する動機は主に以下のようなアーキテクチャ・セキュリティ要件となってきそうです。
- データ機密性: VPC閉域網内で推論を完結させ、社外SaaSにプロンプトや社内データを送信できない要件がある
- 帯域の専有: 外部SaaSのレートリミットや他ユーザー混雑による遅延ブレを避け、自社専用の推論パイプラインを担保したい
- 独自拡張: 前後処理のカスタムロジック追加や特定ライブラリとの深い統合を行いたい
セルフホストの導入やインスタンス選定を検討される際の参考になればと思います。
本記事が皆様のお役に立てば幸いです。