[DynamoDB] ネイティブベクトル検索で、外観検査の良品記録を業務データごと引いて、未知の不良を見つけてみました

1 はじめに
製造ビジネステクノロジー部の平内(SIN)です。
2026年8月、Amazon DynamoDB でネイティブのベクトル検索が使えるようになりました。テーブルにベクトルインデックスを作ると、SearchVectors API で類似検索ができます。
ベクトル専用のストアと違うのは、ベクトルと業務データを同じアイテムに置ける点です。検索結果に、業務データをそのまま一緒に返すことができます。
外観検査では、不良の種類をあらかじめ網羅しておくのが難しい場面がよくあります。そこで、「過去の良品の検査記録から遠いものを要確認にする」という使い方が考えられます。要確認にしたときは、どの良品記録と比べたのか(ロット・照明・検査日時・担当)も一緒に分かると便利です。
そこで今回は、DynamoDB に「画像ベクトル+検査記録」を良品の分だけ登録し、新しい検査画像から一番近い良品記録を SearchVectors で引いて、未知の不良を見つけてみました。
先に結論を述べると、以下のようになりました。
- 1 回の SearchVectors で、異常スコアと根拠になった良品記録(業務データ)を返すことができました
- 不良 10 枚はすべて要確認になりましたが、良品 30 枚のうち 4 枚も要確認になりました(埋め込みが、傷より個体の大きさに反応している可能性がありそうです)
- CDK の L1 オーバーライドで VectorIndexes を指定し、ベクトルインデックスを作成できました
- ベクトルインデックスの対象にした属性は、ベーステーブル側でも 1 次元あたり約 4 バイトで計算されていました(普通の数値リストだと約 7 バイト)
- Titan Multimodal Embeddings の出力は、EUCLIDEAN と COSINE で順位は完全に一致しました
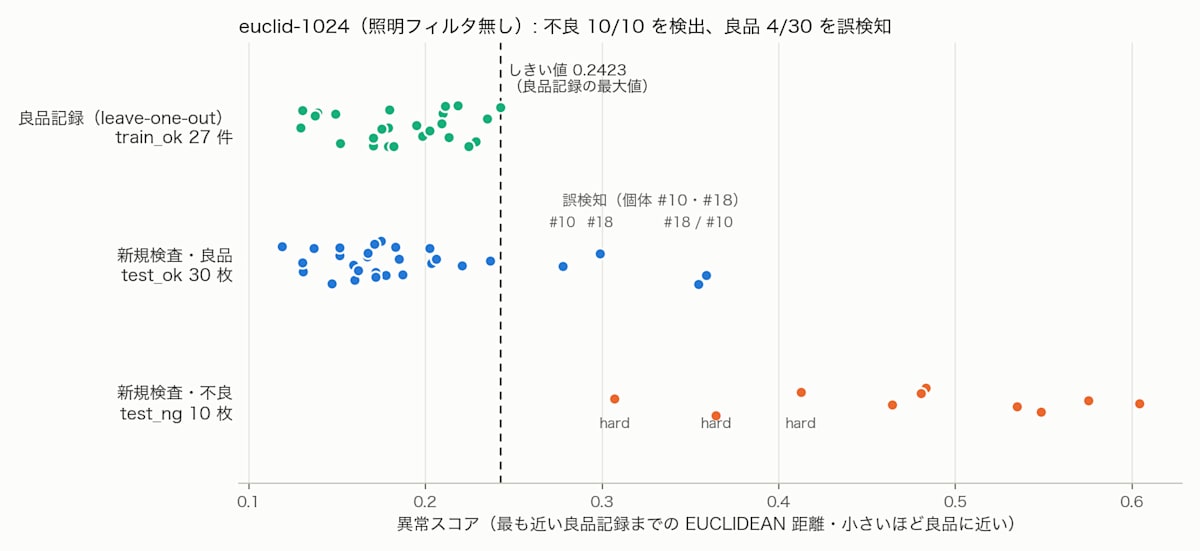
上の図が、今回の判定結果です。横軸は「一番近い良品記録までの距離」で、点線より右が要確認です。
2 題材と設計の考え方
(1) データセット
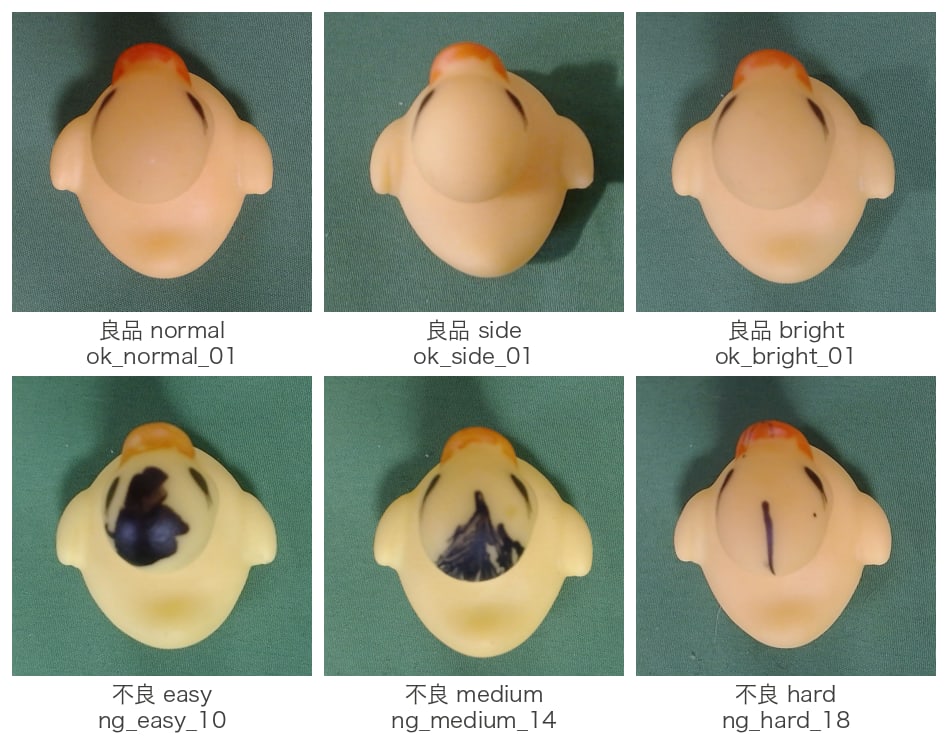
画像は、以前の記事で撮影したアヒル(全長 約 36mm)の外観検査用データセット(全 67 枚)を使用しました。前回の記事で使ったものと同じ内容で、本記事のリポジトリにもそのままコピーして置いています。
| フォルダ | 枚数 | 本記事での扱い |
|---|---|---|
| train_ok(9 個体 × 照明 3 条件) | 27 | 過去の良品検査記録として DynamoDB に登録 |
| test_ok(10 個体 × 照明 3 条件) | 30 | 新しい検査(良品)。要確認にならないことを期待 |
| test_ng(easy / medium / hard) | 10 | 新しい検査(不良)。要確認になることを期待 |
照明は normal(天井の蛍光灯)・side(横からのデスクライト)・bright(両方)の 3 条件で、影の向きが変わります。hard は幅 1mm 以下の線や 1〜2mm の点で、目視でも見落としそうな傷です。
埋め込みモデルごとの精度の比較は、以下の記事で行いました。。本記事では、精度の比較はやり直さず、DynamoDB にどう置いて、どう引くかを中心に確認します。
(2) 良品記録からの距離で判定する
判定の流れは、以下のとおりです。
- 良品画像を埋め込みベクトルにして、検査記録と一緒に DynamoDB に登録する
- 新しい検査画像も同じモデルでベクトルにする
- SearchVectors で、判定が OK の記録に絞って一番近い 1 件を引く
- その距離を異常スコアとし、しきい値を超えたら要確認とする
しきい値は、良品記録 27 件それぞれについて「自分自身を除いた一番近い良品記録」までの距離を求め(leave-one-out)、その最大値をしきい値としました。不良品は、参考にされていません。
(3) 業務データと同じアイテムに置く
1 件のアイテムが 1 件の検査記録です。ベクトルの横に、ロットや担当などの業務データをそのまま持たせます。
| 属性 | 内容 | ベクトルインデックスでの役割 |
|---|---|---|
| pk | 検査 ID | テーブルのパーティションキー |
| product | 品種(今回は duck のみ) | HASH(インデックスのパーティションキー) |
| verdict | 判定 OK / NG | INLINE_FILTER |
| lighting | 照明(検査台ごとに異なる想定) | INLINE_FILTER |
| lot / inspectedAt / inspector / imageKey | ロット・検査日時・担当・S3 の画像キー | INCLUDE で射影 |
| embedding | 1024 次元のベクトル | ベクトル属性 |
| embedding384 / embedding256 | 384 / 256 次元のベクトル(検証用) | ベクトル属性 |
product をインデックスのパーティションキーにしたのは、実際の現場では品種ごとに良品の見た目が違い、比べる相手も品種の中に限られるためです。公式ドキュメントでも、パーティションキーにはカテゴリのような「低〜中程度のカーディナリティ」の属性が推奨されています。
verdict をインラインフィルタにしたのは、「良品記録の中から」一番近いものを探すためです。今回は良品しか登録していませんが、運用では不良の記録も同じテーブルに入ってくるはずです。lighting は、同じ照明の記録とだけ比べた場合の違いを見るために加えました。
(4) 構成とリージョン
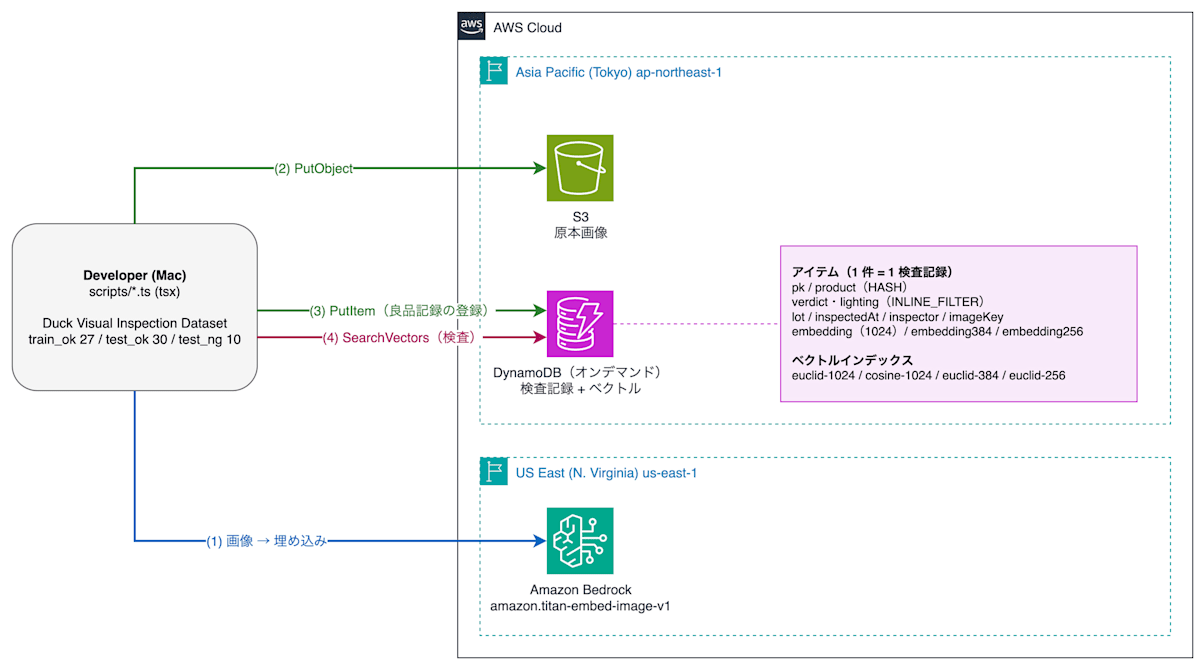
Titan Multimodal Embeddings(amazon.titan-embed-image-v1)は、2026年10月時点で東京リージョンでは提供されていませんでした。そこで、DynamoDB と S3 は東京に置き、Bedrock の呼び出しだけ us-east-1 にしています。
なお、東京で画像の埋め込みに使えるモデルとして Cohere Embed v4 もあります。今回は前回の記事で結果が出ている Titan Multimodal Embeddings を選びました。
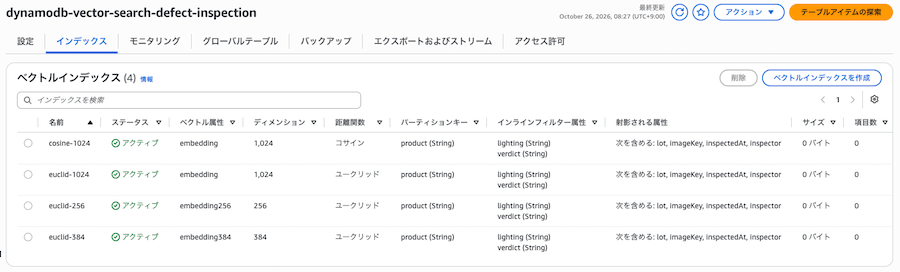
ベクトルインデックスは、検証用に 4 本作りました。
| インデックス名 | ベクトル属性 | 次元 | 距離関数 |
|---|---|---|---|
| euclid-1024 | embedding | 1024 | EUCLIDEAN |
| cosine-1024 | embedding | 1024 | COSINE |
| euclid-384 | embedding384 | 384 | EUCLIDEAN |
| euclid-256 | embedding256 | 256 | EUCLIDEAN |
次元ごとにベクトル属性を分けているのは、同じ属性を参照するインデックスは次元数をそろえる必要があるためです(CLI の create-table のヘルプに記載があります)。
3 種類の次元を持たせているのは、6 章で次元数による判定結果とアイテムサイズの違いを比べるためです。cosine-1024 は、距離関数の比較用です。実際に運用する場合は、次元を 1 つに決めて、ベクトル属性とインデックスを 1 本ずつにするのが自然です。
3 作業手順
詳細は、リポジトリの README.ja.md を参照してください。動作を確認した環境は以下のとおりです(2026年10月5日時点)。
| 項目 | バージョン |
|---|---|
| Node.js | 22.14.0 |
| pnpm | 10.24.0 |
| aws-cdk-lib / aws-cdk | 2.272.0 / 2.1144.0 |
| @aws-sdk/client-dynamodb | 3.1146.0 |
| AWS CLI | 2.36.40 |
| 埋め込みモデル | amazon.titan-embed-image-v1(us-east-1) |
(1) CDK のデプロイ
S3 バケットと DynamoDB テーブル(ベクトルインデックス 4 本を含む)を作成します。
$ git clone https://github.com/furuya02/dynamodb-vector-search-defect-inspection.git
$ cd dynamodb-vector-search-defect-inspection/cdk
$ pnpm install
$ pnpm exec cdk deploy
私の環境では、デプロイは 36.48 秒 で完了しました。
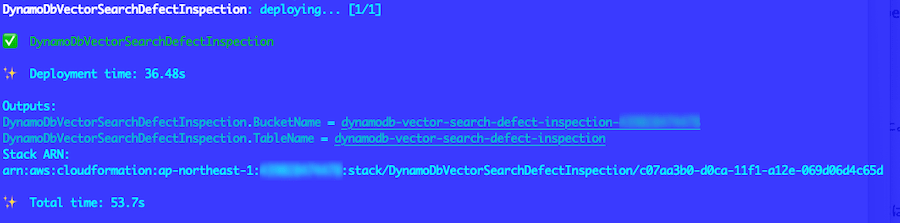
DynamoDB コンソールの「インデックス」タブでも、4 本のベクトルインデックスがアクティブになっていることが確認できます。パーティションキー(product)・インラインフィルター(lighting / verdict)・射影する属性も、CDK で指定したとおりになっています。
(2) 良品記録の登録
リポジトリに同梱した data/duck のうち、train_ok の 27 枚を良品記録として登録します。画像の原本は S3 に、ベクトルと検査記録は DynamoDB に入ります。
$ cd ../scripts
$ pnpm install
$ BUCKET_NAME=dynamodb-vector-search-defect-inspection-<ACCOUNT_ID> pnpm exec tsx register.ts
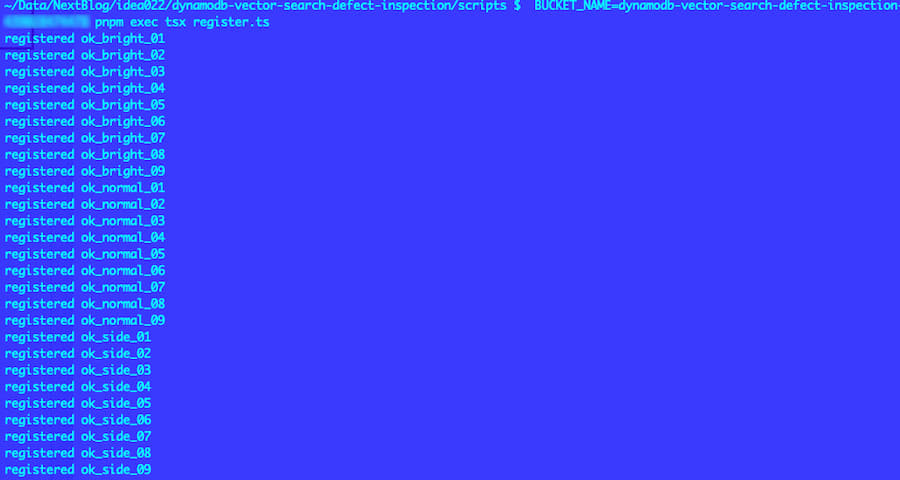
27 件それぞれについて registered と表示されれば、登録は完了です。
(3) しきい値の決定と判定
このステップは検査そのものではなく、検査を始める前の準備と性能確認です。まず、登録した良品記録 27 件だけを使って、leave-one-out でしきい値を決めます。次に、答えの分かっている test_ok(良品 30 枚)と test_ng(不良 10 枚)を判定し、不良を何枚拾えたか、良品を何枚間違えて要確認にしたかを集計します。決めたしきい値はファイルに保存され、(4) の 1 枚の検査ではその値を使います。
引数でインデックスを切り替えられます。same を付けると、同じ照明の良品記録とだけ比べます。
$ pnpm exec tsx evaluate.ts euclid-1024
$ pnpm exec tsx evaluate.ts euclid-1024 same
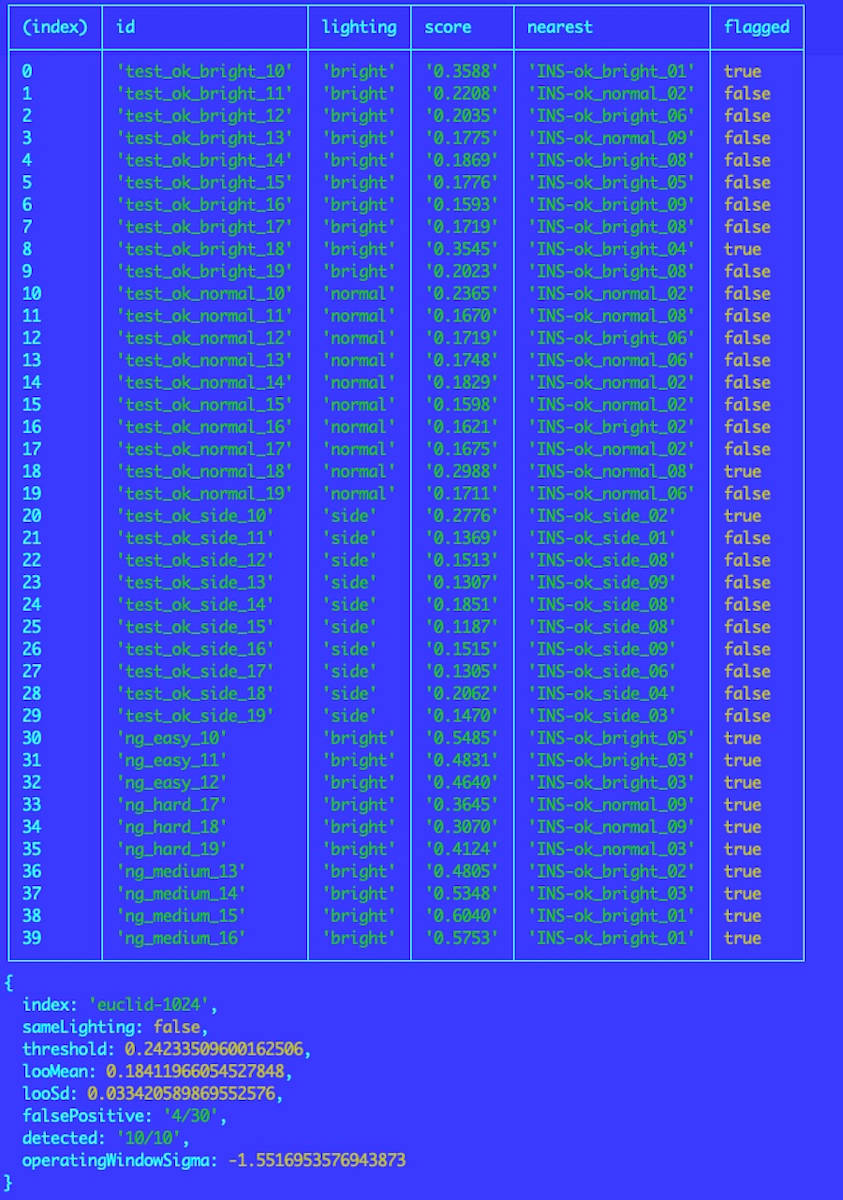
照明フィルタ無し(1 つ目のコマンド)の実行結果です。40 枚それぞれについて、異常スコア(score)、一番近い良品記録(nearest)、要確認かどうか(flagged)が表示されます。最後に、しきい値(threshold)や、良品の誤検知数(falsePositive)・不良の検出数(detected)がまとめて表示されます。
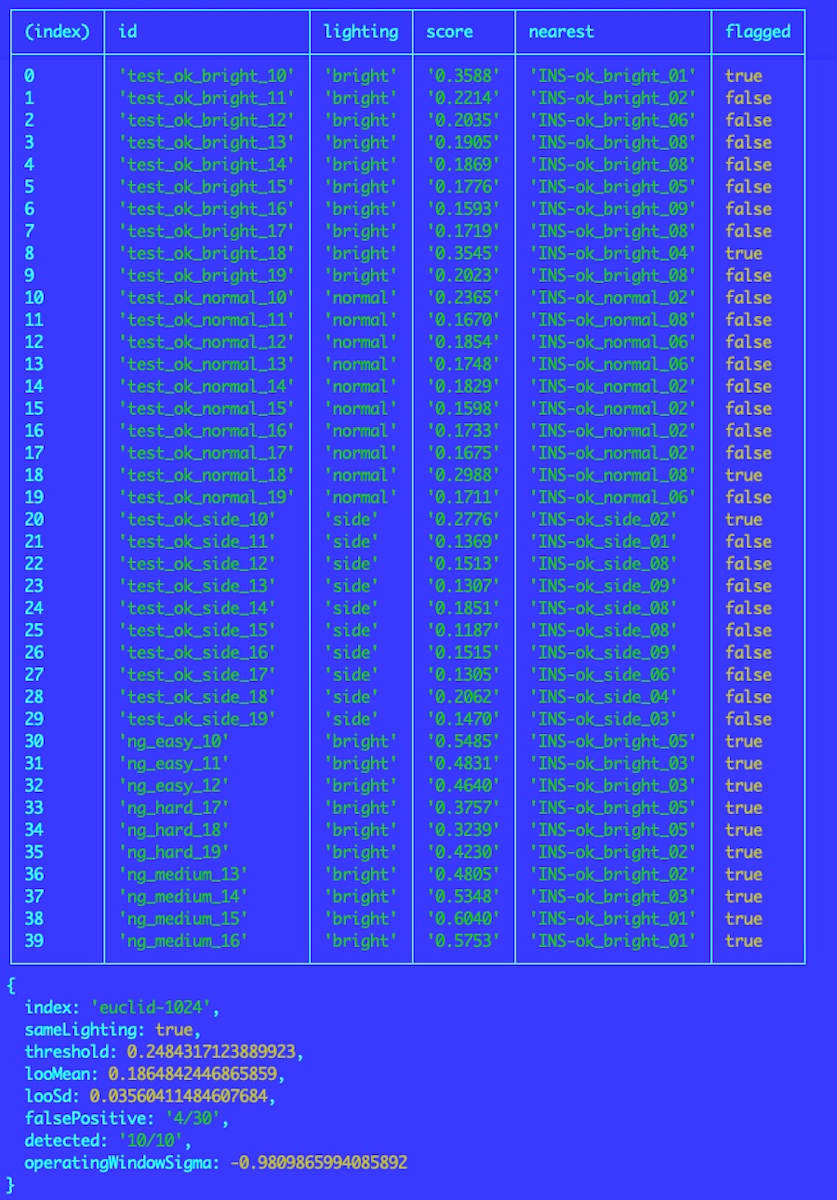
同じ照明に絞った場合(2 つ目のコマンド)の実行結果です。一番近い良品記録(nearest)が、すべて検査画像と同じ照明の記録になっています。しきい値は 0.2484 に変わりましたが、誤検知(4 / 30)と検出(10 / 10)は照明フィルタ無しと同じでした。
(4) 1 枚の検査
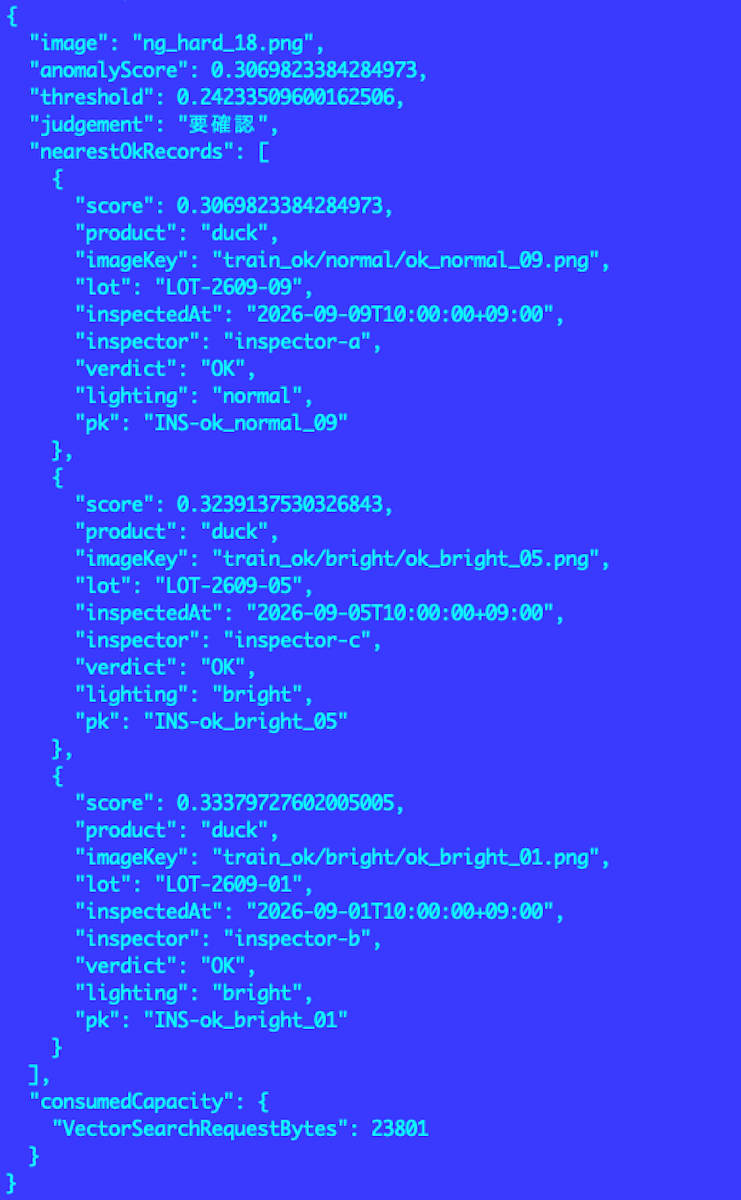
1 枚の画像について、異常スコアと一番近い良品記録 3 件を表示します。
$ pnpm exec tsx inspect.ts ../data/duck/test_ng/hard/ng_hard_18.png
(5) クリーンアップ
DynamoDB と S3 は、置いておくだけでもストレージ料金がかかります。確認が終わったら、必ず削除してください。
$ cd ../cdk
$ pnpm exec cdk destroy
4 実装解説
(1) CDK でベクトルインデックスを作る
Github cdk/lib/stack.ts
2026年10月時点では、CDK の L2(Table)にベクトルインデックス用のプロパティが無いため、L1(CfnTable)にプロパティを直接書く方法を試しました。3 回目で意図した形になりました。
| 試行 | 内容 | 結果 |
|---|---|---|
| 1 | VectorIndexes だけをオーバーライド | 失敗(SearchSchema の属性が AttributeDefinitions に無い) |
| 2 | SearchSchema の属性を AttributeDefinitions にも追加 | 成功(インデックスが ACTIVE) |
| 3 | 既存のテーブルに、残り 3 本を追加でデプロイ | 失敗(1 回の更新で作成できるインデックスは 1 本まで) |
1 回目のエラーは、以下のとおりです。
CREATE_FAILED | AWS::DynamoDB::Table | Resource handler returned message:
"An attribute referenced in a SearchSchema element is not defined in AttributeDefinitions"
(HandlerErrorCode: InvalidRequest)
想定では、未知のプロパティとして CloudFormation に弾かれると考えていました。実際は、リソースハンドラがプロパティを API にそのまま渡し、API 側のチェックで失敗していました。このことから、プロパティ自体は受け付けられていると判断し、2 回目で AttributeDefinitions を足しました。
3 回目は「Cannot perform more than one index creation or deletion in a single update」というエラーでした。GSI と同じく、1 回の更新で作成・削除できるインデックスは 1 本までのようです。ただし、cdk destroy してから新規に作り直すと、4 本まとめて作成できました。後からインデックスを足す場合は、1 本ずつデプロイする必要があります。
最終的なコードは、以下のとおりです。
// cdk/lib/stack.ts(要点抜粋)
const table = new Table(this, 'InspectionTable', {
  tableName: PROJECT,
  partitionKey: { name: 'pk', type: AttributeType.STRING },
  billingMode: BillingMode.PAY_PER_REQUEST, // ベクトルインデックスはオンデマンド必須
  removalPolicy: RemovalPolicy.DESTROY,
});

// 2026-10 時点で CDK L2 / CloudFormation リファレンスに VectorIndexes が無いため L1 に直接書く
const cfn = table.node.defaultChild as CfnTable;
// SearchSchema で参照する属性は AttributeDefinitions に定義が必要
['product', 'verdict', 'lighting'].forEach((name, i) =>
  cfn.addPropertyOverride(`AttributeDefinitions.${i + 1}`, { AttributeName: name, AttributeType: 'S' }));
cfn.addPropertyOverride('VectorIndexes', VECTOR_INDEXES.map((v) => ({
  IndexName: v.name,
  VectorAttribute: { AttributeName: v.attr },
  Dimensions: v.dim,
  DistanceFunction: v.fn,
  SearchSchema: [
    { AttributeName: 'product', SearchSchemaElementType: 'HASH' },
    { AttributeName: 'verdict', SearchSchemaElementType: 'INLINE_FILTER' },
    { AttributeName: 'lighting', SearchSchemaElementType: 'INLINE_FILTER' },
  ],
  Projection: { ProjectionType: 'INCLUDE', NonKeyAttributes: ['lot', 'inspectedAt', 'inspector', 'imageKey'] },
})));
なお、cdk synth では「AttributeDefinitions に KeySchema で使っていない属性がある」という警告(E3039)が出ますが、デプロイには影響しませんでした。今後、CDK の L2 などで専用のプロパティが提供された場合は、そちらへの移行を検討してください。
(2) 画像の埋め込み
Github scripts/common.ts
Bedrock の InvokeModel で、画像を Base64 にして渡します。outputEmbeddingLength で次元数(256 / 384 / 1024)を指定できます。
// scripts/common.ts(要点抜粋)
export const ddb = new DynamoDBClient({ region: process.env.AWS_REGION ?? 'ap-northeast-1' });
const bedrock = new BedrockRuntimeClient({ region: 'us-east-1' }); // Titan MME は東京に無い

export async function embed(path: string, dim: number): Promise<number[]> {
  const res = await bedrock.send(new InvokeModelCommand({
    modelId: 'amazon.titan-embed-image-v1',
    contentType: 'application/json',
    body: JSON.stringify({
      inputImage: readFileSync(path).toString('base64'),
      embeddingConfig: { outputEmbeddingLength: dim },
    }),
  }));
  return JSON.parse(new TextDecoder().decode(res.body)).embedding;
}
(3) 良品記録の登録
Github scripts/register.ts
ベクトルは、List of Number としてそのまま PutItem します。専用の型やスキーマ変更は必要ありません。ロット・検査日時・担当は、個体番号から作った合成値です。
// scripts/register.ts(要点抜粋)
const no = Number(img.id.slice(-2)); // 個体番号
const vectors = Object.fromEntries(
  await Promise.all(DIMS.map(async (d) => [vectorAttr(d), toList(await embedCached(img, d))])),
); // embedding / embedding384 / embedding256
await ddb.send(new PutItemCommand({
  TableName: TABLE,
  Item: {
    pk: { S: `INS-${img.id}` },
    product: { S: 'duck' },          // ベクトルインデックスの HASH
    verdict: { S: 'OK' },            // INLINE_FILTER
    lighting: { S: img.lighting },   // INLINE_FILTER(検査台ごとの照明)
    lot: { S: `LOT-2609-${String(no).padStart(2, '0')}` },
    inspectedAt: { S: `2026-09-${String(no).padStart(2, '0')}T10:00:00+09:00` },
    inspector: { S: INSPECTORS[no % 3] },
    imageKey: { S: imageKey },       // 原本は S3
    ...vectors,
  },
}));
登録後に DynamoDB のコンソールでテーブルをスキャンすると、良品記録 27 件が入っていることが確認できます。ベクトル(embedding など)と、ロット・照明・担当などの業務データが同じアイテムに並んでいます。
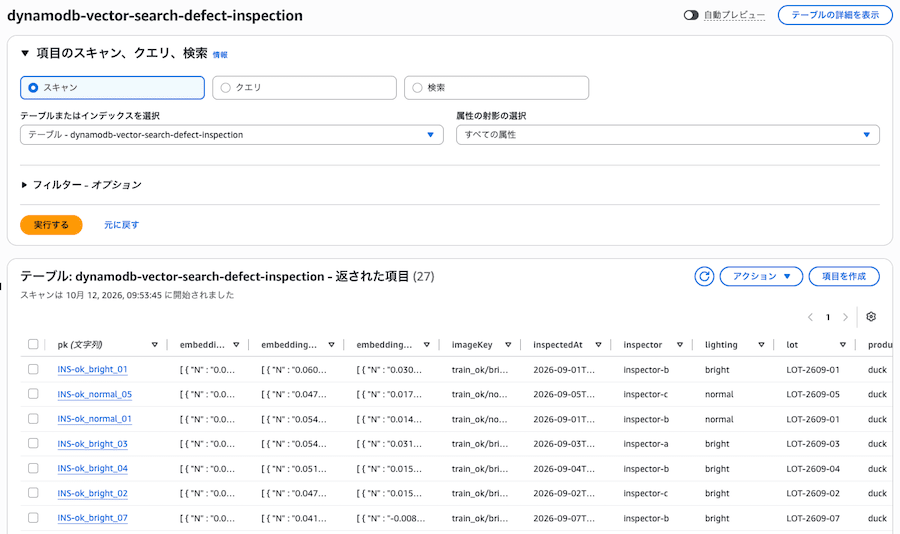
このうち 1 件(INS-ok_bright_01)の中身は、以下のようになっています(ベクトルは途中を省略しています)。
{
  "pk": { "S": "INS-ok_bright_01" },
  "embedding": {
    "L": [
      { "N": "0.021707198" },
      // ... 略(全 1024 個)
      { "N": "-0.0020241085" }
    ]
  },
  "embedding384": {
    "L": [
      { "N": "0.030024182" },
      // ... 略(全 384 個)
      { "N": "0.10171196" }
    ]
  },
  "embedding256": {
    "L": [
      { "N": "0.06021164" },
      // ... 略(全 256 個)
      { "N": "-0.050329484" }
    ]
  },
  "imageKey": { "S": "train_ok/bright/ok_bright_01.png" },
  "inspectedAt": { "S": "2026-09-01T10:00:00+09:00" },
  "inspector": { "S": "inspector-b" },
  "lighting": { "S": "bright" },
  "lot": { "S": "LOT-2609-01" },
  "product": { "S": "duck" },
  "verdict": { "S": "OK" }
}
embedding / embedding384 / embedding256 は、同じ画像を Titan Multimodal Embeddings でそれぞれの次元数のベクトルにしたものです。次元数を指定して別々に呼び出しているので、384 次元が 1024 次元の先頭を切り出したものになっているわけではありません。1 つ 1 つの数値に決まった意味はなく、組み合わせ全体で画像の特徴を表しています。人が見るのは、同じアイテムに入っているロット・照明・担当などの業務データのほうです。
(4) SearchVectors で一番近い良品記録を引く
Github scripts/inspect.ts
SearchConditionExpression で、HASH の product と、インラインフィルタの verdict を指定します。HASH を定義したインデックスでは、HASH の値の指定が必須です。
// scripts/inspect.ts(要点抜粋)
const res = await ddb.send(new SearchVectorsCommand({
  TableName: TABLE,
  IndexName: 'euclid-1024',
  SearchVector: (await embed(path, 1024)).map((n) => ({ N: String(n) })),
  TopK: 3,
  SearchConditionExpression: 'product = :p AND verdict = :ok',
  ExpressionAttributeValues: { ':p': { S: 'duck' }, ':ok': { S: 'OK' } },
  ReturnConsumedCapacity: 'TOTAL',
}));
const anomalyScore = res.SearchResults![0].Score!; // EUCLIDEAN は小さいほど近い
なお、インラインフィルタで使える演算子は、2026年10月時点の Developer Guide のとおり等価(=)のみです。実際に lighting <> :l や lighting IN (:l) を指定すると、ValidationException になりました。
5 デモ: 異常スコアと根拠の良品記録を 1 回の検索で返す
(1) 不良品を 1 枚検査する
不良の中で一番スコアが低かった ng_hard_18(幅 1mm 以下の傷)を検査した結果です(スコアは小数点以下 4 桁に丸めています)。
{
  "image": "ng_hard_18.png",
  "anomalyScore": 0.3070,
  "threshold": 0.2423,
  "judgement": "要確認",
  "nearestOkRecords": [
    { "score": 0.3070, "pk": "INS-ok_normal_09", "lot": "LOT-2609-09",
      "inspectedAt": "2026-09-09T10:00:00+09:00", "inspector": "inspector-a",
      "lighting": "normal", "verdict": "OK", "product": "duck",
      "imageKey": "train_ok/normal/ok_normal_09.png" }
    // ... 2 件目・3 件目は省略
  ],
  "consumedCapacity": { "VectorSearchRequestBytes": 22216 }
}
異常スコアと一緒に、比べた良品記録のロット・検査日時・担当・画像キーが返ってきています。画像キーを使えば S3 の原本をすぐに開けるので、作業者が見比べて判断するといった運用にもつなげやすいと感じました。
なお、HASH とインラインフィルタの属性(product・verdict・lighting)は、NonKeyAttributes に書いていなくても結果に含まれていました。また、SearchVectors には ProjectionExpression もあり、射影した属性の中から返す属性を絞ることもできます。
(2) 新しい検査画像 40 枚(良品 30・不良 10)の判定結果
冒頭の図(003.png)のとおり、euclid-1024 の結果は以下のようになりました。
| 項目 | 値 |
|---|---|
| しきい値(良品記録の leave-one-out の最大値) | 0.2423 |
| 不良の検出 | 10 / 10 |
| 良品の誤検知 | 4 / 30 |
| 不良の最小スコア | 0.3070(ng_hard_18) |
| 良品の最大スコア | 0.3588(test_ok_bright_10) |
不良はすべて要確認になりましたが、良品の 4 枚も要確認になりました。良品の最大スコアが不良の最小スコアを上回っているため、しきい値をどこに置いても、誤検知ゼロと全数検出を両立することはできません。
前回の記事と近い考え方で、この余裕(不良の最小スコア − 良品の最大スコア)を「良品記録のスコアの標準偏差(σ)の何倍か」で表すと、-1.55σ でした。マイナスは、良品と不良のスコアが重なっていることを意味します。前回の記事でも、Titan Multimodal Embeddings の値はマイナスでした。
(3) 同じ照明の記録とだけ比べる
インラインフィルタで lighting を同じ照明に絞った場合と、絞らない場合を比べました。
| 条件 | しきい値 | 不良の検出 | 良品の誤検知 | 余裕(σ) |
|---|---|---|---|---|
| 照明フィルタ無し | 0.2423 | 10 / 10 | 4 / 30 | -1.55 |
| 同じ照明に絞る | 0.2484 | 10 / 10 | 4 / 30 | -0.98 |
余裕は少し改善しましたが、誤検知の 4 枚は変わりませんでした。そもそもフィルタ無しでも、良品 30 枚のうち 26 枚は同じ照明の記録が一番近くに来ていました。誤検知の原因が照明ではないため、フィルタでは解消しないと判断しました(原因は 7 章で説明します)。
6 検証: 次元数とアイテムサイズ、距離関数
(1) 次元数による判定結果の違い
| インデックス | しきい値 | 不良の検出 | 良品の誤検知 | 余裕(σ) |
|---|---|---|---|---|
| euclid-1024 | 0.2423 | 10 / 10 | 4 / 30 | -1.55 |
| euclid-384 | 0.2103 | 10 / 10 | 5 / 30 | -1.52 |
| euclid-256 | 0.1832 | 10 / 10 | 5 / 30 | -1.47 |
次元を減らすと誤検知が 1 枚増えましたが、余裕の値はほぼ同じでした。このデータでは、次元数による大きな差は見られませんでした。
(2) アイテムサイズ
Github scripts/item-size.ts
DynamoDB のアイテムサイズの上限は 400KB です。ベクトルは数値のリストとして保存されるので、次元数がそのままサイズに効くと考えていました。
PutItem で返る消費 WCU は 1KB 単位なので、パディング用の文字列を少しずつ長くして、WCU が 1 増える境目からバイト数を求めました。最初は普通の属性名(v)で測っていたのですが、ベクトルインデックスの属性名(embedding)で書いたときに WCU が小さくなることに気づき、両方を測りました。
| 次元 | 普通の属性 | ベクトルインデックスの属性 |
|---|---|---|
| 1024 | 7,205 バイト(7.04 / 次元・8 WCU) | 4,108 バイト(4.01 / 次元・5 WCU) |
| 384 | 2,683 バイト(6.99 / 次元・3 WCU) | 1,551 バイト(4.04 / 次元・2 WCU) |
| 256 | 1,821 バイト(7.11 / 次元・2 WCU) | 1,039 バイト(4.06 / 次元・2 WCU) |
普通の数値リストでは、1 要素あたり約 7 バイトでした。Titan の出力は有効数字 7〜8 桁で、数値のサイズの計算式から見積もった約 6 バイトより少し大きくなりました。
これに対して、ベクトルインデックスの対象にした属性は、1 次元あたり約 4 バイト(f32 相当)で計算されていました。product が無く、インデックスに入らないアイテムでも同じだったので、属性名で決まっているようです。GetItem で読み戻した値は、書き込んだ文字列のまま(丸めなし)でした。
公式ドキュメントでは、インデックスには f32 精度で格納されると説明されています。ベーステーブル側の値は、2026年10月時点の実測結果として捉えてください。
いずれにしても、1024 次元でも 400KB の 1〜2% 程度です。次元数がアイテムサイズの上限に効いてくる場面は、ほとんどないと思います。
なお、PutItem で ReturnConsumedCapacity に INDEXES を指定すると、テーブルの WCU とは別に、インデックスごとの書き込み量が VectorWriteRequestBytes として返ってきました。値は euclid-1024 と cosine-1024 が 4,149 バイト、euclid-384 が 1,592 バイト、euclid-256 が 1,080 バイトで、ここでも 1 次元あたり約 4 バイトです。なお、この値はテーブルのキー(pk)の文字数によって変わり、キーが 1 文字長くなるごとに 1 バイト増えました。上の値は、7 文字のテスト用キーで測ったときのものです。インデックスを増やすと、その分だけ書き込みも増えることが分かります。
今回は検証のために 1 件のアイテムに 3 本のベクトルを持たせたので、登録時の書き込みも 3 本分発生しています。実際に使う場合は次元を 1 つに決めることになりますが、今回のデータでは次元数による判定結果の差は小さかったので、サイズと書き込み量を抑えたい場合は小さい次元を選ぶという判断もできそうです。
(3) EUCLIDEAN と COSINE
Github scripts/verify-distance.ts
公式ドキュメントでは、画像の埋め込み・近い重複の検出・異常検出には EUCLIDEAN が、テキストの意味検索には COSINE が向いているとされています。
そこで、同じ埋め込みを EUCLIDEAN と COSINE の 2 つのインデックスで検索し、40 枚の結果を比べました。
| 項目 | 結果 |
|---|---|
| EUCLIDEAN² / 2 と COSINE の差 | 最大 3.6e-7(f32 の精度の範囲) |
| 順位・一番近い良品記録 | 40 枚すべて一致 |
| 判定結果 | どちらも 検出 10 / 10・誤検知 4 / 30 |
| 余裕(σ) | EUCLIDEAN -1.55 / COSINE -2.83 |
順位と判定は完全に一致しました。ただし、σ を単位にした余裕の値は一致しませんでした。2 乗の関係にあるため、分布の形が変わるからです。しきい値や σ を記事や運用で比べるときは、距離関数をそろえておく必要があります。
この結果から、今回の埋め込みとデータでは、距離関数の選択によって検索結果は変わらなかったと判断しました。そのうえで、公式の推奨に合わせ、スコアをそのまま「距離」として読める EUCLIDEAN を採用しています。別の埋め込みモデルや入力を使う場合は結果が変わる可能性があるので、実際のデータで比べてから選ぶのが良いと思います。
7 できたこと / できていないこと
(1) できたこと
- ベクトルと検査記録を同じアイテムに置き、1 回の SearchVectors で異常スコアと根拠の良品記録を返すことができました
- インラインフィルタで「良品記録の中から」「同じ照明の記録の中から」を切り替えることができました
- 不良 10 枚(幅 1mm 以下の傷を含む)は、すべて要確認になりました
- CDK の L1 オーバーライドで VectorIndexes を指定し、ベクトルインデックスを作成できました
(2) できていないこと
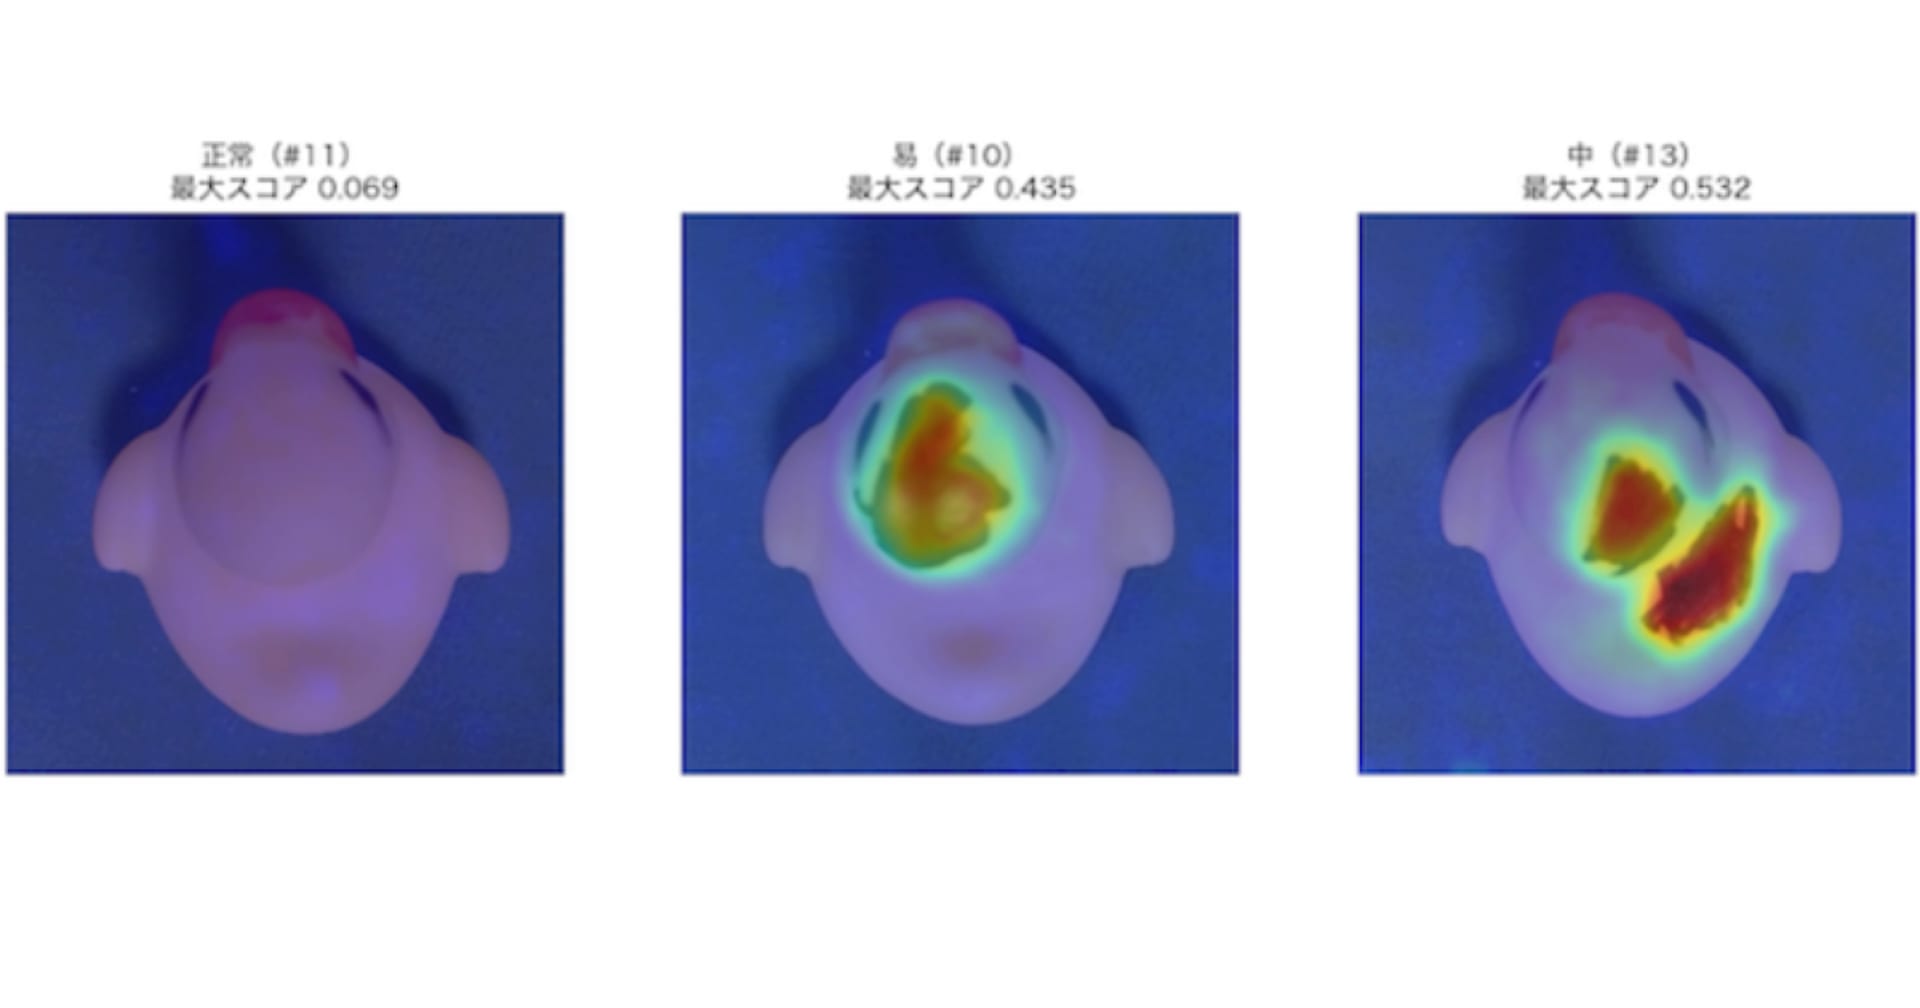
一番の課題は、良品 30 枚のうち 4 枚が要確認になったことです。4 枚はすべて個体 #10 と #18 で、データセットの README で「全長が最大 15% 大きい」とされている個体でした。
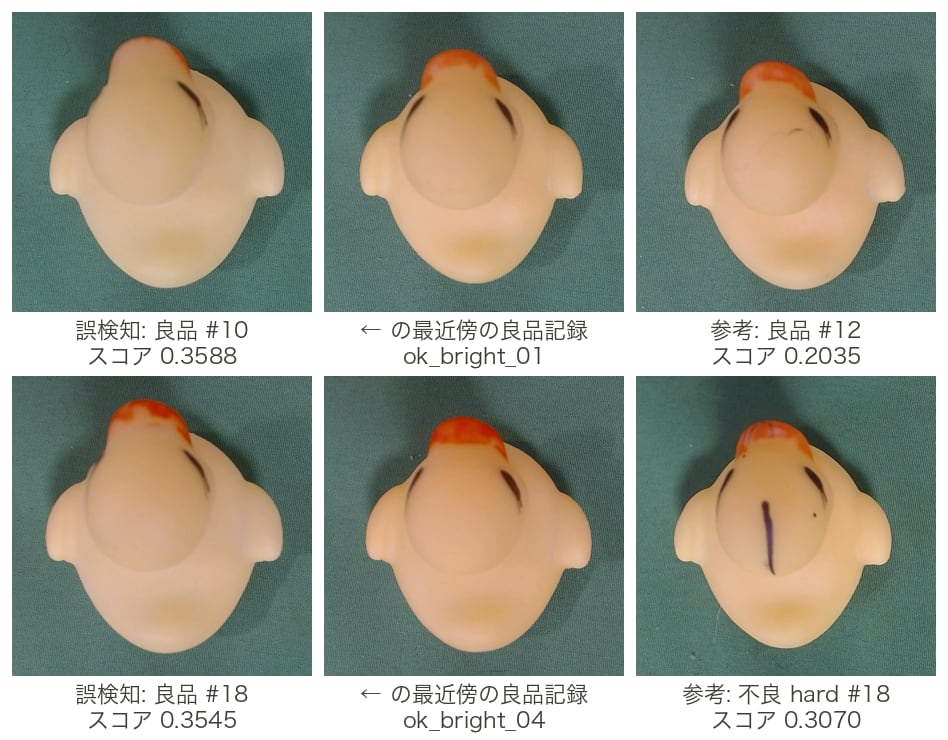
左列が誤検知した良品、中央がその一番近い良品記録、右列は参考です。並べてみると、#10 と #18 は大きく写っていることが分かります。
さらに、同じ個体 #18 で比べると、傷のない良品(0.354)より、傷のある不良(0.307)のほうがスコアが低くなっていました。汎用の埋め込みでは、異常スコアが傷の有無よりも、個体の大きさや置き方の違いに強く左右されているようです。
この点は、DynamoDB の検索の問題ではなく、埋め込みの性質によるものです。前回の記事では、DINOv2 に替えることや、照明条件を増やして撮影することで、良品と不良を分ける余裕が大きく改善することを確認しています。用途に応じて埋め込み側を選び、DynamoDB はその結果を業務データと一緒に引く役割と考えるのが良さそうです。
8 使い分けと制約
(1) S3 Vectors との使い分け
AWS には、ベクトルを保存・検索できるサービスとして Amazon S3 Vectors もあります。用途が違うので、以下のように使い分けるのが良いと思います。
| 観点 | DynamoDB のベクトル検索 | S3 Vectors |
|---|---|---|
| 向いている場面 | 業務データが DynamoDB にあり、検索結果を業務属性ごと低レイテンシで返したい | 大量のベクトルを低コストで保存し、検索頻度はそれほど高くない |
| 業務データとの関係 | 同じアイテムに同居 | ベクトルのメタデータとして持つ |
| 今回の題材 | 検査記録と一緒に引く用途に合う | 画像アーカイブ全体の類似検索などに合う |
今回のように「検査記録はもともと DynamoDB にあり、そこに類似検索を足したい」という場面では、DynamoDB のベクトル検索が自然な選択だと感じました。
(2) 制約
主な制約を、2026年10月時点の公式ドキュメントと実測からまとめます。
| 項目 | 内容 |
|---|---|
| 容量モード | オンデマンドのみ(テーブルもオンデマンドが必要) |
| 精度 | インデックスには f32 で格納 |
| レスポンス | 16MB まで。ページングは無い |
| インラインフィルタ | 等価(=)のみ |
| 整合性 | インデックスは書き込み後に非同期で更新される |
| 読み取り | Query / Scan / PartiQL は使えず、SearchVectors のみ。DAX も非対応 |
| IaC | CDK では L1 で VectorIndexes を指定。1 回の更新で作成できるのは 1 本 |
整合性については、公式ドキュメントに「書き込みが確定してから SearchVectors で検索できるようになるまでに遅れがある」と書かれています。登録した直後の記録を必ず検索対象にしたい処理では、この前提で設計する必要があります。
また、TTL で期限切れのアイテムが削除されると、ベクトルインデックスからも削除されます。検査記録の保持期間を TTL で管理すれば、比べる相手の良品記録も自動的に入れ替わります。
ただし、良品記録が入れ替わると、しきい値も変わりうる点に注意が必要です。今回のデモでは、しきい値は evaluate.ts で一度計算してファイルに保存し、検査のたびにはその値を読み込んで使っています。検査した画像を良品記録として追加登録していないため、良品記録の 27 件も、しきい値も固定です。
実際の運用で、合格した記録を順次追加したり、TTL で古い記録を削除したりする場合は、しきい値も計算し直す必要があります。タイミングは「良品記録が一定数増えたら」「ロットの切り替え時」などが考えられます。検査のたびに計算し直すと判定基準が日々ずれていくので、決めたタイミングで更新する方が扱いやすいと思います。
9 最後に
今回は、DynamoDB のネイティブベクトル検索で、外観検査の良品記録を業務データごと引き、未知の不良を見つける構成を試してみました。
検索そのものは素直に動き、異常スコアと根拠の記録を 1 回で返せる点は、検査記録をすでに DynamoDB で持っているシステムにとって扱いやすいと感じました。ただ、判定の精度は埋め込みによって決まり、今回のデータと設定では個体差による誤検知が残りました。
今回の検証で分かったことを 2 点にまとめます。
- ベクトルと業務データを同じアイテムに置くと、「なぜ要確認なのか(どの記録と比べたか)」まで 1 回の検索で返せる
- 今回の埋め込みとデータでは、EUCLIDEAN と COSINE で順位も判定も同じになった。距離関数は実際のデータで比べて選ぶ
不良の種類を集めにくい製品で、まず良品記録だけで要確認の仕組みを作る、といった場面のたたき台になれば嬉しいです。
この記事で使用したコードは、以下に置きました。
10 参考リンク
- Amazon DynamoDB vector search(What's New)
- Amazon DynamoDB がリアルタイムのベクトル検索に対応(AWS News Blog)
- Using vector indexes in DynamoDB
- Requirements and limitations
- Storage considerations for vector indexes
- AWS::DynamoDB::Table(CloudFormation)
- Amazon Titan Multimodal Embeddings G1
- Amazon S3 Vectors
- Duck Visual Inspection Dataset(CC BY 4.0・前回の記事のリポジトリ)
- 埋め込みモデルで外観検査(Bedrock Multimodal Embeddings vs DINOv2)