Amazon Kinesis Data Streams の拡張ファンアウトと共有スループットでレコードの遅延を比べてみた

はじめに
テクニカルサポートの 片方 です。
Amazon Kinesis Data Streams のコンシューマーには、2 種類あります。GetRecords でポーリングする共有スループットのコンシューマーと、SubscribeToShard でレコードをプッシュしてもらう拡張ファンアウトのコンシューマーです。
ドキュメントの比較表では、メッセージの伝播遅延は、共有スループットで平均約 200 ms、拡張ファンアウトで約 70 ms とされています。ただ、AWS Lambda のイベントソースマッピングは、標準イテレーターだと1 秒に 1 回の基本レートでポーリングします。Lambda で受け取ると、この数字どおりにはならないのではないかと考えました。
そこで、1 シャードのストリームに 1 秒 5 件を 10 分送り、遅延を測りました。コンシューマーは、Lambda の標準イテレーター、Lambda の拡張ファンアウト、boto3 の subscribe_to_shard、boto3 の get_records の 4 通りです。レコードが Kinesis に到着してからコンシューマーが受け取るまでの時間を、3,000 件ずつ記録しました。共有スループットの get_records を 3 つに増やしたときの変化も見ています。
構成
東京リージョンに、次のリソースを AWS CLI で作りました。
| リソース | 内容 |
|---|---|
| Kinesis Data Streams order-events | プロビジョンドモード、1 シャード |
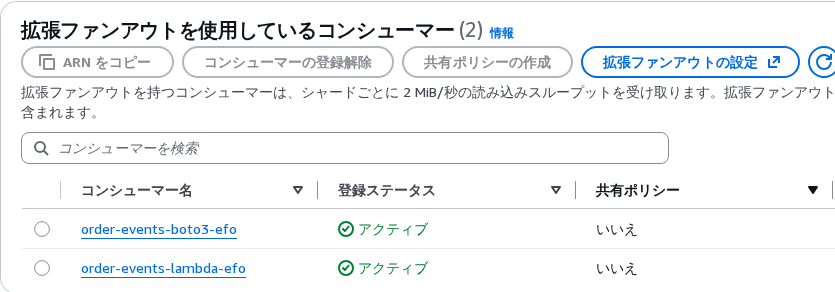
| 拡張ファンアウトのコンシューマー order-events-lambda-efo、order-events-boto3-efo | register-stream-consumer で登録 |
| Lambda 関数 order-latency-standard | Python 3.13、128 MB。イベントソースはストリームの ARN(標準イテレーター)。バッチサイズ 100、バッチウィンドウ 0 秒、開始位置 LATEST |
| Lambda 関数 order-latency-efo | 同じ設定で、イベントソースはコンシューマー order-events-lambda-efo の ARN |
作業端末では、boto3 のスクリプトを、ラウンド 1 で 3 プロセス、ラウンド 2 で 5 プロセス動かしました。
- プロデューサー:
put_recordで 1 秒に 5 件、3,000 件まで送ります。ペイロードには、連番と送信時刻(ミリ秒)を入れます。 - 拡張ファンアウトのコンシューマー:
subscribe_to_shard(開始位置LATEST、コンシューマー order-events-boto3-efo)で受け取ります。5 分で切れる接続は、ContinuationSequenceNumberの次から張り直します。 - 共有スループットのコンシューマー:
get_recordsを 200 ms 間隔で呼びます。ラウンド 1 は 1 つ、ラウンド 2 は 3 つです。
コンシューマーは受け取った時刻を記録するだけで、データの書き込みや更新はしません。そのため、同じレコードを 2 回受け取っても問題ありません。重複は連番で数えます。
再試行は、boto3 の standard モード(指数バックオフ)に任せ、Config の max_attempts を 3 にしました。Config で指定した max_attempts は初回を含まない再試行の回数なので、初回を含めて最大 4 回です。put_record が再試行の後も失敗したときは、同じ連番で 1 回だけ送り直します。同じレコードが 2 件届いても、連番で見分けられます。standard モードはスロットリングの例外も再試行するので、get_records の ProvisionedThroughputExceededException がスクリプトに返るのは、SDK が再試行をやめた後です。
Lambda 関数は、受け取ったレコードごとに 3 つの時刻を、1 行の JSON で Amazon CloudWatch Logs に出します。
def lambda_handler(event, context):
    recv_ms = time.time() * 1000
    for r in event.get("Records", []):
        k = r["kinesis"]
        payload = json.loads(base64.b64decode(k["data"]))
        print(json.dumps({"label": LABEL, "seq": payload["seq"], "sent_ms": payload["sent_ms"],
                          "arrival_ms": k["approximateArrivalTimestamp"] * 1000, "recv_ms": recv_ms,
                          "batch": len(event["Records"])}))
    return {"records": len(event.get("Records", []))}
遅延は、「到着 → 受信」(受信時刻 − ApproximateArrivalTimestamp)で比べます。「送信 → 到着」は同じレコードなので 4 通りで共通で、作業端末と Kinesis の時計の差を含みます。
先に結論から
- 「到着 → 受信」の中央値は、Lambda の拡張ファンアウトが 68 ms、boto3 の
subscribe_to_shardが 78 ms、boto3 のget_records(200 ms 間隔)が 161 ms、Lambda の標準イテレーターが 525 ms でした。標準イテレーターの Lambda には 1 秒分のレコードがまとめて届き、p99 は 1.6 秒、最大は 3.3 秒でした。 - 共有スループットの
get_recordsを 3 つに増やすと、3 つの中央値は 730〜838 ms、p99 は 7〜8 秒、最大は 11〜12 秒まで悪くなりました。各プロセスでProvisionedThroughputExceededExceptionが 10〜19 回出ています。 - 同じストリームの拡張ファンアウトのコンシューマー 2 つは、共有スループットのコンシューマーが増えても変わりませんでした。
- Lambda の標準イテレーターも、ラウンド 2 で中央値 511 ms、p99 1.9 秒で、boto3 の
get_recordsのような悪化はありませんでした。
やってみた
次の 2 つのラウンドで測りました。
- ラウンド 1:拡張ファンアウト 2 つと共有スループット 2 つで測る
- ラウンド 2:共有スループットの get_records を 3 つに増やす
1. ラウンド 1:拡張ファンアウト 2 つと共有スループット 2 つで測る
3,000 件を 10 分で送り、4 通りすべてで 3,000 件を重複なく受け取りました。「到着 → 受信」の分布です。
| コンシューマー | p50 | p90 | p99 | 最大 |
|---|---|---|---|---|
| Lambda 拡張ファンアウト | 68.3 ms | 109.0 ms | 119.1 ms | 297.7 ms |
| boto3 subscribe_to_shard | 77.8 ms | 118.3 ms | 156.6 ms | 489.8 ms |
| boto3 get_records(200 ms 間隔) | 161.4 ms | 669.5 ms | 1,364.7 ms | 2,451.7 ms |
| Lambda 標準イテレーター | 525.0 ms | 946.9 ms | 1,639.5 ms | 3,347.0 ms |
「送信 → 到着」は、p50 71.1 ms、p90 85.1 ms、p99 122.2 ms でした。最初の 1 件だけ 8.5 秒かかっていますが、これは最初の put_record の呼び出しに時間がかかったものです。
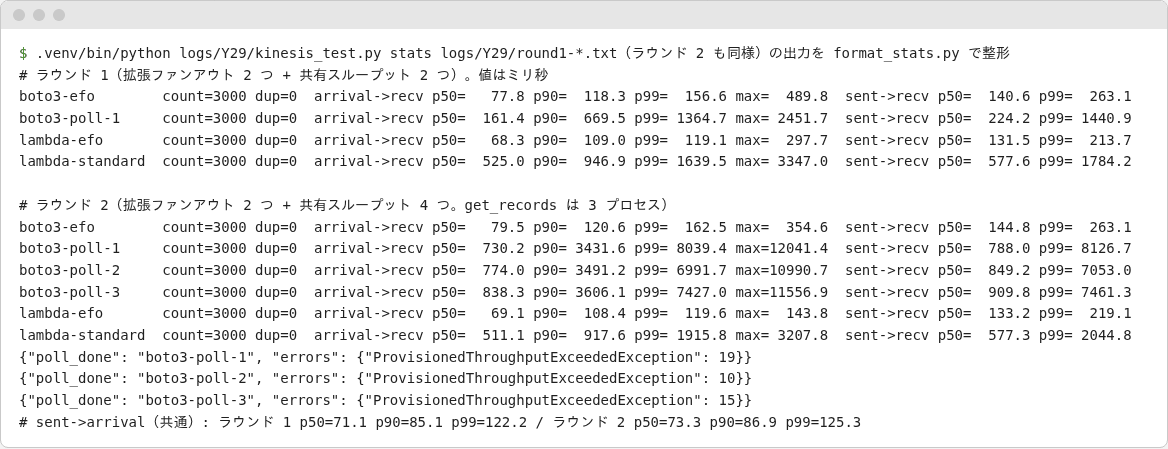
Lambda の標準イテレーターでは、3,000 件のうち 2,050 件が 5 件のバッチで届きました。6 件のバッチが 402 件、4 件のバッチが 268 件で、最大は 17 件です。1 秒に 5 件送っているので、1 秒分がまとめて届いています。拡張ファンアウトの関数では、2,972 件が 1 件のバッチで、残りは 2 件のバッチでした。
標準イテレーターは 1 秒に 1 回の基本レートでポーリングし、拡張ファンアウトは専用の接続でレコードをプッシュします。
- 標準イテレーター: Lambda は、レコードの Kinesis ストリームにある各シャードを 1 秒あたり 1 回の基本レートでポーリングします。利用可能なレコードが増えると、Lambda は関数がストリームに追いつくまでバッチを処理し続けます。イベントソースマッピングは、シャードの他のコンシューマーと読み取りスループットを共有します。
- 拡張ファンアウト: レイテンシーを最小限に抑え、読み取りスループットを最大化するには、拡張ファンアウトを使用してデータストリームコンシューマーを作成します。拡張ファンアウトを使用するコンシューマーは、ストリームから読み取る他のアプリケーションに影響を及ぼさないように、専用の接続を各シャードに割り当てます。ストリームのコンシューマーは HTTP/2 を使用して、長時間にわたる接続とリクエストヘッダーの圧縮でレコードを Lambda にプッシュすることによってレイテンシーを短縮します。
2. ラウンド 2:共有スループットの get_records を 3 つに増やす
boto3 の get_records を 3 プロセス(いずれも 200 ms 間隔)にして、同じように送りました。Lambda の 2 つの関数と、boto3 の subscribe_to_shard はそのままです。
| コンシューマー | p50 | p90 | p99 | 最大 |
|---|---|---|---|---|
| Lambda 拡張ファンアウト | 69.1 ms | 108.4 ms | 119.6 ms | 143.8 ms |
| boto3 subscribe_to_shard | 79.5 ms | 120.6 ms | 162.5 ms | 354.6 ms |
| boto3 get_records 1 | 730.2 ms | 3,431.6 ms | 8,039.4 ms | 12,041.4 ms |
| boto3 get_records 2 | 774.0 ms | 3,491.2 ms | 6,991.7 ms | 10,990.7 ms |
| boto3 get_records 3 | 838.3 ms | 3,606.1 ms | 7,427.0 ms | 11,556.9 ms |
| Lambda 標準イテレーター | 511.1 ms | 917.6 ms | 1,915.8 ms | 3,207.8 ms |
3 つの get_records では、ProvisionedThroughputExceededException が、それぞれ 19 回、10 回、15 回スクリプトに返りました。3 プロセス × 毎秒 5 回に Lambda の標準イテレーターのポーリングが加わり、1 シャードの GetRecords の上限(1 秒 5 回)を超えたためです。p99 の 7〜8 秒と最大 12 秒には、SDK の再試行の待ち時間が含まれます。
GetRecordsへの各呼び出しは、1 つの読み込みトランザクションとしてカウントされます。各シャードは 1 秒あたり最大 5 件のトランザクションをサポートできます。
拡張ファンアウトの 2 つは、ラウンド 1 と同じ水準でした。手順 1 の引用のとおり、拡張ファンアウトのコンシューマーは、シャードごとに専用の接続を使うためです。
確認してみた
CloudWatch のメトリクス
Amazon CloudWatch の 1 分粒度のメトリクスです。画像の数字は 1 分ごとの値で、ラウンド 1 の 11〜12 個の後に、ラウンド 2 の 11〜12 個が続きます。下の表の範囲は、送信していた 10 分の値(画像の 28〜37 分と 39〜48 分)です。
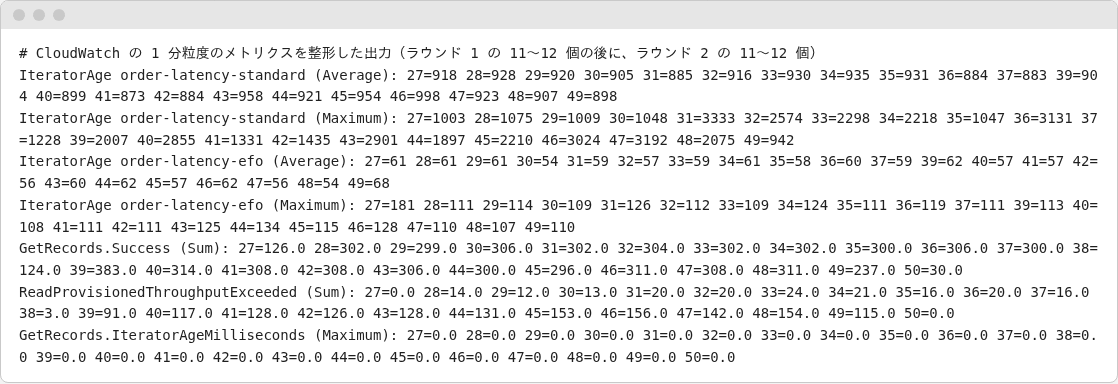
| メトリクス | ラウンド 1 | ラウンド 2 |
|---|---|---|
| IteratorAge(標準イテレーターの関数、平均) | 883〜935 ms | 873〜998 ms |
| IteratorAge(拡張ファンアウトの関数、平均) | 54〜61 ms | 54〜62 ms |
| ReadProvisionedThroughputExceeded(ストリーム、合計) | 毎分 12〜24 | 毎分 91〜156 |
| GetRecords.Success(ストリーム、合計) | 毎分 299〜306 | 毎分 296〜383 |
ラウンド 1 でも、ReadProvisionedThroughputExceeded が毎分 12〜24 ありました。boto3 の get_records だけでほぼ 1 秒 5 回なので、Lambda のポーリングが加わると上限を超えます。ただ、boto3 のスクリプトには例外が返っていません。上限に当たった分は、SDK や Lambda の再試行で吸収されたと考えられます。
拡張ファンアウトのコンシューマーの SubscribeToShard.Success は、Lambda のコンシューマーでは 5 分ごとに 1 でした。boto3 のコンシューマーでは、各ラウンドの開始時(最初の接続)と、その後 5 分ごと(接続の張り直し)に 1 でした。どちらのコンシューマーも、SubscribeToShard.RateExceeded は 0、SubscribeToShardEvent.MillisBehindLatest の最大は 0 でした。
ドキュメントの数字との比較
ドキュメントの比較表の「メッセージの伝播遅延」の行は、共有スループット、拡張ファンアウトの順に次のとおりです。
ストリームから読み取るコンシューマーが 1 つの場合は平均約 200 ms です。コンシューマーが 5 つの場合、この平均は最大約 1,000 ms まで上がります。
コンシューマーが 1 つまたは 5 つかによって、一般的に平均 70 ms です。
ドキュメントの伝播遅延は、PutRecord などで送ってから、GetRecords や SubscribeToShard でコンシューマーに届くまでの時間です。今回の「送信 → 受信」の中央値は、boto3 の subscribe_to_shard が 140.6 ms、get_records(1 つ)が 224.2 ms でした。この 2 つは作業端末の同じ時計で測った差なので、Kinesis の時計との差は含みません。ドキュメントの数字より大きいのは、作業端末から東京リージョンまでの往復と、get_records の 200 ms のポーリング間隔が入っているためと考えられます。
時計の差について
「到着 → 受信」の最小値は、ラウンド 1 で Lambda の拡張ファンアウトが 13.7 ms、作業端末の subscribe_to_shard が 20.0 ms、ラウンド 2 でそれぞれ 15.1 ms と 16.6 ms でした。作業端末の時計が Kinesis より大きくずれていれば、この値は負になるか、大きくなるはずです。そのため、時計の差は数十 ms より小さいと見ています。
また、Lambda の受信時刻は関数の先頭で取ったものです。Lambda がレコードを受け取ってから関数を起動するまでの時間も含みます。
まとめ
拡張ファンアウトの速さは、はっきりしていました。Lambda でも boto3 でも中央値は 100 ms を切り、共有スループットのコンシューマーを増やしても、まったく影響を受けませんでした。
予想どおりドキュメントの数字からずれたのは、Lambda の標準イテレーターです。比較表の「平均約 200 ms」だけを見ると十分に速そうですが、Lambda は 1 秒に 1 回の基本レートでポーリングします。そのため 1 秒分のレコードがまとめて届き、中央値は 525 ms でした。Lambda で 1 秒を切る遅延を求めるなら、最初から拡張ファンアウトを考えたほうがよさそうです。
もう 1 つは、共有スループットのコンシューマーを増やしたときの崩れ方です。1 シャードの GetRecords は 1 秒 5 回までなので、200 ms 間隔で呼ぶコンシューマーを 3 つにしただけで上限を超え、最大 12 秒まで遅れました。ポーリングの間隔を詰めても、コンシューマーの数との掛け算で上限に当たれば、かえって遅くなります。
プロビジョンドモードのストリームでは、拡張ファンアウトに、コンシューマーごとのシャード時間とデータ取得の料金がかかります(2026 年 10 月時点)。それでも、遅延を 100 ms 前後に収めたい場合や、共有スループットのコンシューマーが複数ある場合には、拡張ファンアウトを選ぶ理由になります。今回試したのは、1 シャードに 1 秒 5 件を送る構成です。
本ブログが誰かの参考になれば幸いです。
参考資料
- 専用スループットを備えた拡張ファンアウトを開発する - Amazon Kinesis Data Streams
- Lambda を使用して Amazon Kinesis Data Streams からのレコードを処理する - AWS Lambda
- クォータと制限 - Amazon Kinesis Data Streams
- Retries - Boto3
クラスメソッドオペレーションズ株式会社について
クラスメソッドグループのオペレーション企業です。
運用・保守開発・サポート・情シス・バックオフィスの専門チームが、IT・AIをフル活用した「しくみ」を通じて、お客様の業務代行から課題解決や高付加価値サービスまでを提供するエキスパート集団です。
当社は様々な職種でメンバーを募集しています。
「オペレーション・エクセレンス」と「らしく働く、らしく生きる」を共に実現するカルチャー・しくみ・働き方にご興味がある方は、クラスメソッドオペレーションズ株式会社 コーポレートサイト をぜひご覧ください。※2026年1月 アノテーション㈱から社名変更しました