ECSに環境変数経由で渡したSecrets Manager管理のDB パスワードを、接続エラーなしでローテーションできるかやってみた

皆さまこんにちは、こんばんは
コンサルティング部のみゃんです。
すっかり寒くなり、秋は短いなあと感じながらこのブログを書いています。
さて、季節は全く関係なく、今回はSecrets Managerのローテーションについてです。
ECS のタスク定義の secrets で DB のパスワードを環境変数に渡していると、パスワードをローテーションしても、動いているコンテナは古いパスワードのまま動き続けます。シングルユーザー方式では、DB 側のパスワードが変わった時点で、新しく接続できなくなります。
そう考えると、ローテーションを実際に組み込むことはかなりハードルがあるように思います。
AWS のドキュメントにも、環境変数に入るのはコンテナの起動時だけで、ローテーション後の値は自動では反映されないと書かれています。反映するには、新しいタスクを起動するか、サービスを「強制的に新しいデプロイ」で更新する必要があります。
では、ローテーションしたら自動で再デプロイする仕組みを作れば解決するのでしょうか?
私は「シングルユーザー方式だと、再デプロイが終わるまでの間は古いタスクが DB に接続できないのでは?」「交代ユーザー方式なら、パスワードを変えなかったほうのユーザーで、しばらく接続できるので、ローリングアップデートでダウンタイムなしに切り替えられるのでは?」と考えました。
というわけで今回は、実際に手を動かして確かめてみることにしました。
まずは結論から
忙しい人のために、まずは結論をまとめます。
詳細は、後述の「やってみた」章をご覧ください!
今回主に試したのは以下の2点です。
①シングルユーザー方式のローテーションをきっかけに、ECS のサービスを自動で再デプロイする
②交代ユーザー方式のローテーションをきっかけに、ECS のサービスを自動で再デプロイする
どちらも、ローテーションの検知には Secrets Manager が EventBridge に送る Secret Label Updated イベントを使い、Lambda から ECS のサービスを強制的に新しいデプロイで更新しました。
①は、ローテーションから古いタスクが入れ替わるまでの約2分30秒間、DB への接続エラーが発生しました。0.5秒ごとに送った1,079件のうち、224件が 500 でした。
古いタスクが持っているパスワードは、ローテーションの途中で DB 側が変更された時点で使えなくなるためです。
②は、ローテーションを2回試し、ローテーション中も再デプロイ中もエラーは0件でした(1回目389件、2回目429件がすべて 200)。
ローテーション後も、パスワードを変えなかったほうのユーザーで引き続き接続できるため、古いタスクと新しいタスクの両方が DB に接続できていました。
今回の条件(タスク2つ、0.5秒ごとのリクエスト、リクエストのたびにDBへ接続するアプリ)では、交代ユーザー方式と自動再デプロイの組み合わせで、ローテーション実行中のアプリケーションへの接続エラーは0件でした!ただし、ローテーションのタイミングとアプリのデプロイ時間等の兼ね合いで、瞬断が発生したケースもあるようです。本番環境への導入前に開発環境等の検証できる環境で十分なテストを行っていただければと思います。
やってみた
前提
- 東京リージョン(ap-northeast-1)で検証
- VPC、RDS、ALB、ECS クラスターなどは CloudFormation で構築。構築部分はカットし、検証部分にフォーカスしてお届け
- 検証部分の作業は、すべて CloudShell の AWS CLI で実施
- DB : Amazon RDS for MySQL(db.t4g.micro、シングル AZ)。マスターユーザーのパスワードは「Secrets Manager で管理」にして、RDS に管理させる
- アプリ : Amazon ECS on AWS Fargate(以下、ECS on Fargate)で動かす Python の簡易 HTTP サーバー。タスクは2つ
- アプリの前段に ALB(Application Load Balancer)を置き、CloudShell から0.5秒ごとにリクエストを送って結果を記録する
- アプリ用の DB ユーザーは、シングルユーザー方式用の
app_singleと、交代ユーザー方式用のapp_altの2つを事前に作成済み - ローテーション用の Lambda 関数が Secrets Manager と RDS の API を呼べるように、VPC エンドポイントを作成済み
今回検証した構成の概要図はこちらです。
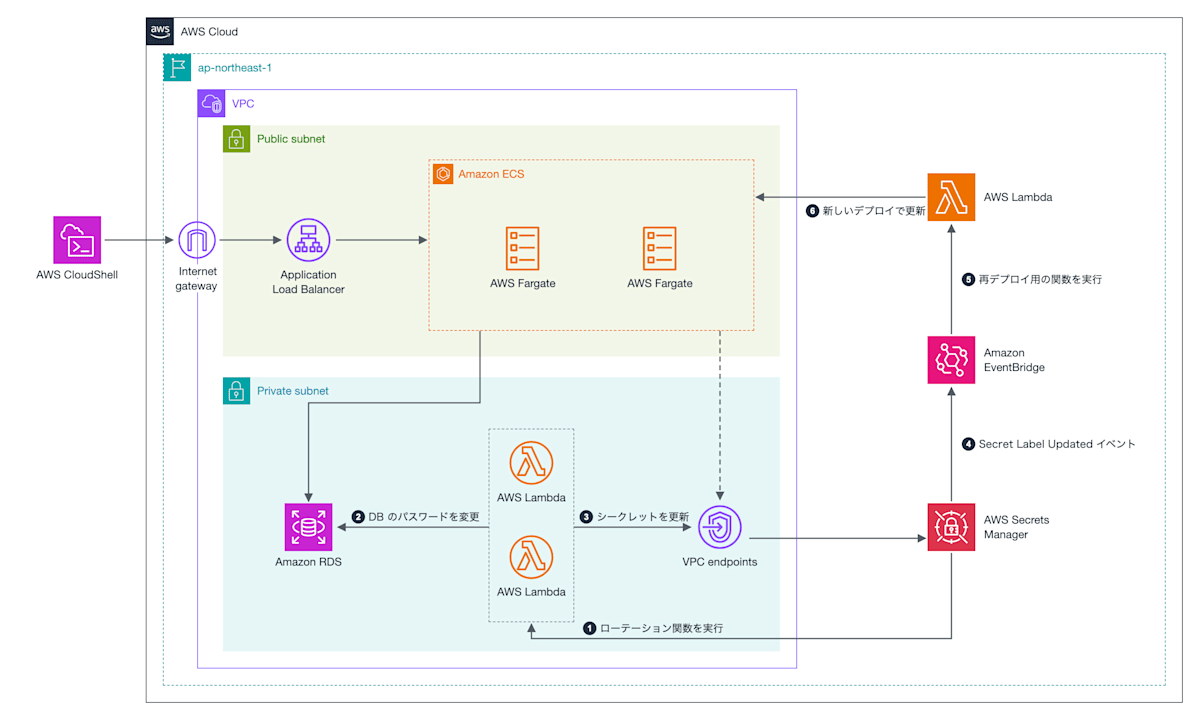
ローテーションから再デプロイまでの流れは次のとおりです。
- Secrets Manager がローテーション用の Lambda 関数を実行する
- ローテーション用の Lambda 関数が DB のパスワードを変更する
- ローテーション用の Lambda 関数がシークレットの値を更新し、新しいバージョンに
AWSCURRENTラベルを移す - Secrets Manager が EventBridge に
Secret Label Updatedイベントを送る - EventBridge ルールが再デプロイ用の Lambda 関数を呼び出す
- 再デプロイ用の Lambda 関数が ECS のサービスを強制的に新しいデプロイで更新する
- ECS が新しいタスクを起動する。新しいタスクは起動時に最新のシークレットを環境変数として受け取る
- 新しいタスクが ALB のヘルスチェックに合格したら、古いタスクが停止する(ローリングアップデート)
ローテーションの検知に Secret Label Updated イベントを使うのは、AWS のドキュメントで、シークレットの値が変わったことを検知する方法として推奨されているからです。
CloudTrail 経由の RotationSucceeded イベントを拾う方法も紹介されていますが、Secret Label Updated は CloudTrail を経由せず、すべてのシークレットで既定で有効になっています。
シングルユーザー方式と交代ユーザー方式の違い
検証に入る前に、2つの方式の違いを整理しておきます。
どちらも Lambda 関数でローテーションする方式で、AWS のドキュメントでは次のように説明されています。
| 項目 | シングルユーザー方式 | 交代ユーザー方式 |
|---|---|---|
| DB のユーザー | 1つ | 2つ(元のユーザーと、ローテーション関数が作る <ユーザー名>_clone) |
| ローテーションで変わるもの | 毎回、同じユーザーのパスワード | パスワードを変えるユーザーを毎回交代する |
| ローテーション後に DB に接続できる認証情報 | 最新の値だけ | 最新の値と、ひとつ前の値 |
| 管理者のシークレット | 不要(RDS for Db2 を除く) | 必要。ほとんどのユーザーにはユーザーを複製する権限がないため |
| ドキュメントで勧められている用途 | ほとんどのユースケース。特に一時的なユーザーや対話的に使うユーザー | 高可用性が必要なアプリケーション |
シークレットには、最新の値に AWSCURRENT、ひとつ前の値に AWSPREVIOUS というラベルが付きます。
1回目のローテーション後、古いタスクが残っている間のシークレット、タスク、DB のユーザーを図にすると、次のとおりです。
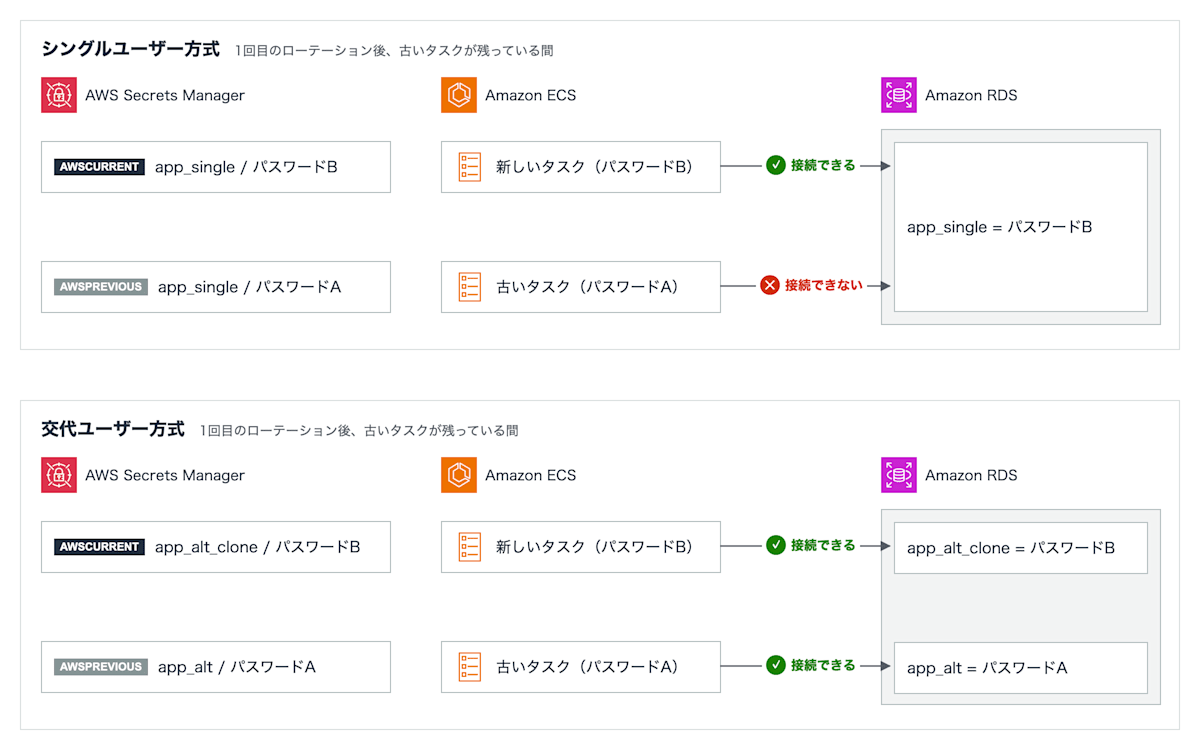
シングルユーザー方式は、1つのユーザーのパスワードを毎回変えます。
AWSPREVIOUS にひとつ前のパスワードは残りますが、DB 側のパスワードはもう変わっているので、その値では接続できません。
ドキュメントにも、DB のパスワードが変わってからシークレットが更新されるまでの短い間は、接続が拒否されることがあると書かれています。このリスクは再試行で減らせるとのことです。
※ローテーションしても、すでに開いている DB 接続は切断されません。
交代ユーザー方式は、1回目のローテーションで元のユーザーを複製して <ユーザー名>_clone を作り、以降はパスワードを変えるユーザーを交代します。
パスワードを変えなかったほうのユーザーの認証情報は AWSPREVIOUS に残り、次のローテーションまで DB に接続できます。
※2回目のローテーションでは app_alt のパスワードが変わるので、図のパスワードAは使えなくなります。次のローテーションまでに、タスクを最新の値に入れ替えておく必要があります。
※クローンユーザーは、作られた時点の元のユーザーと同じ権限を持ちます。あとから元のユーザーの権限を変えた場合は、クローンユーザーの権限も変える必要があります。
環境変数で渡しているタスクは、起動したときの値を持ち続けます。
ローテーション後、新しいタスクに入れ替わるまでは、ひとつ前の値で DB に接続します。
シングルユーザー方式ではこの間に接続エラーが出て、交代ユーザー方式では出ないはずです。これを検証1と検証2で確かめます。
準備1: ローテーションを設定する
ここからの作業は、すべて CloudShell で行います。
まず、アプリ用ユーザーのシークレットを2つ作ります。
シークレットの値は、RDS のシークレットと同じ JSON の形(engine host port username password dbname)にします。
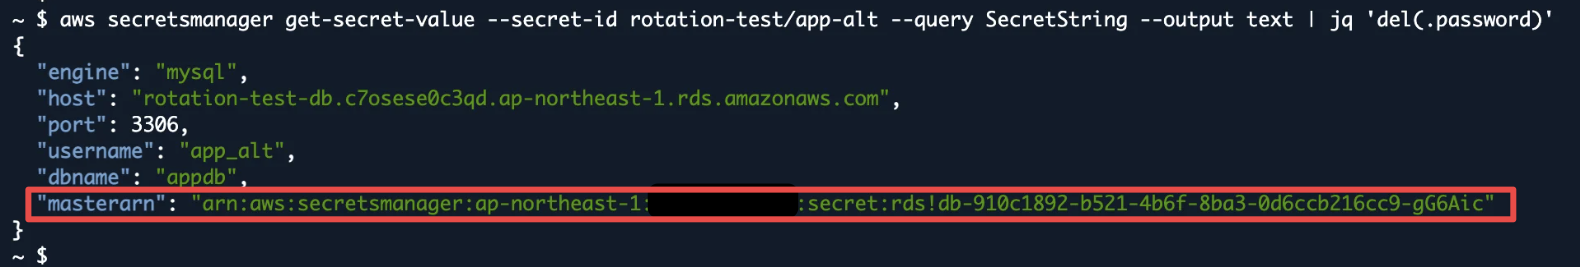
交代ユーザー方式のシークレットには、管理者のシークレットの ARN を masterarn として入れます。今回は AWS のチュートリアルと同じく、RDS が管理しているマスターユーザーのシークレットを管理者として使います。
# シングルユーザー方式用
export SINGLE_SECRET_ARN=$(aws secretsmanager create-secret \
  --name rotation-test/app-single \
  --secret-string "$(jq -n --arg host "$DB_HOST" --arg pw "$SINGLE_PASSWORD" \
    '{engine: "mysql", host: $host, port: 3306, username: "app_single", password: $pw, dbname: "appdb"}')" \
  --query ARN --output text)

# 交代ユーザー方式用
export ALT_SECRET_ARN=$(aws secretsmanager create-secret \
  --name rotation-test/app-alt \
  --secret-string "$(jq -n --arg host "$DB_HOST" --arg pw "$ALT_PASSWORD" --arg master "$MASTER_SECRET_ARN" \
    '{engine: "mysql", host: $host, port: 3306, username: "app_alt", password: $pw, dbname: "appdb", masterarn: $master}')" \
  --query ARN --output text)

echo "export SINGLE_SECRET_ARN=$SINGLE_SECRET_ARN" >> ~/rotation-test.env
echo "export ALT_SECRET_ARN=$ALT_SECRET_ARN" >> ~/rotation-test.env
※$SINGLE_PASSWORD と $ALT_PASSWORD は、DB ユーザーを作ったときに設定したパスワードです。
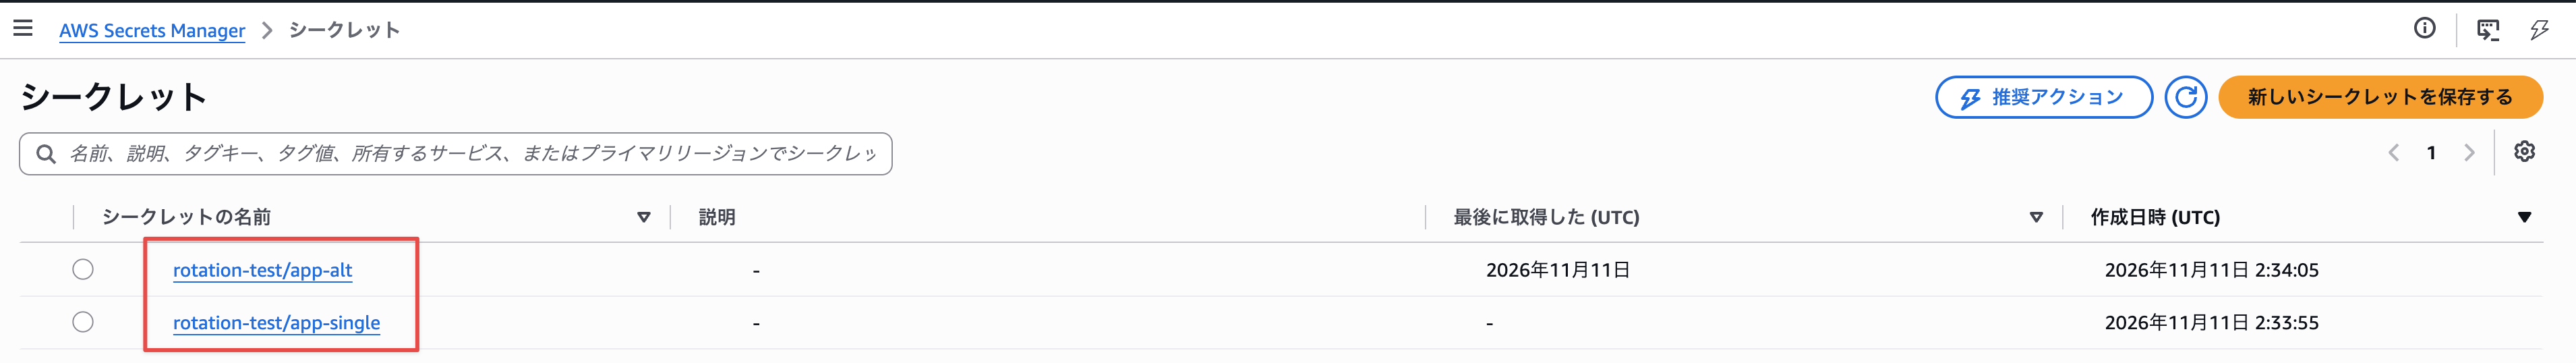
シングルユーザー方式用と交代ユーザー方式用のシークレットが作成されました。
交代ユーザー方式のシークレットに masterarn が入っていることを、パスワード以外のキーを表示して確認します。
aws secretsmanager get-secret-value --secret-id rotation-test/app-alt --query SecretString --output text | jq 'del(.password)'
次に、ローテーション用の Lambda 関数を作ります。
AWS が AWS Serverless Application Repository(以下、SAR)で公開している、RDS for MySQL 用のテンプレートからデプロイします。シングルユーザー方式は SecretsManagerRDSMySQLRotationSingleUser、交代ユーザー方式は SecretsManagerRDSMySQLRotationMultiUser です。
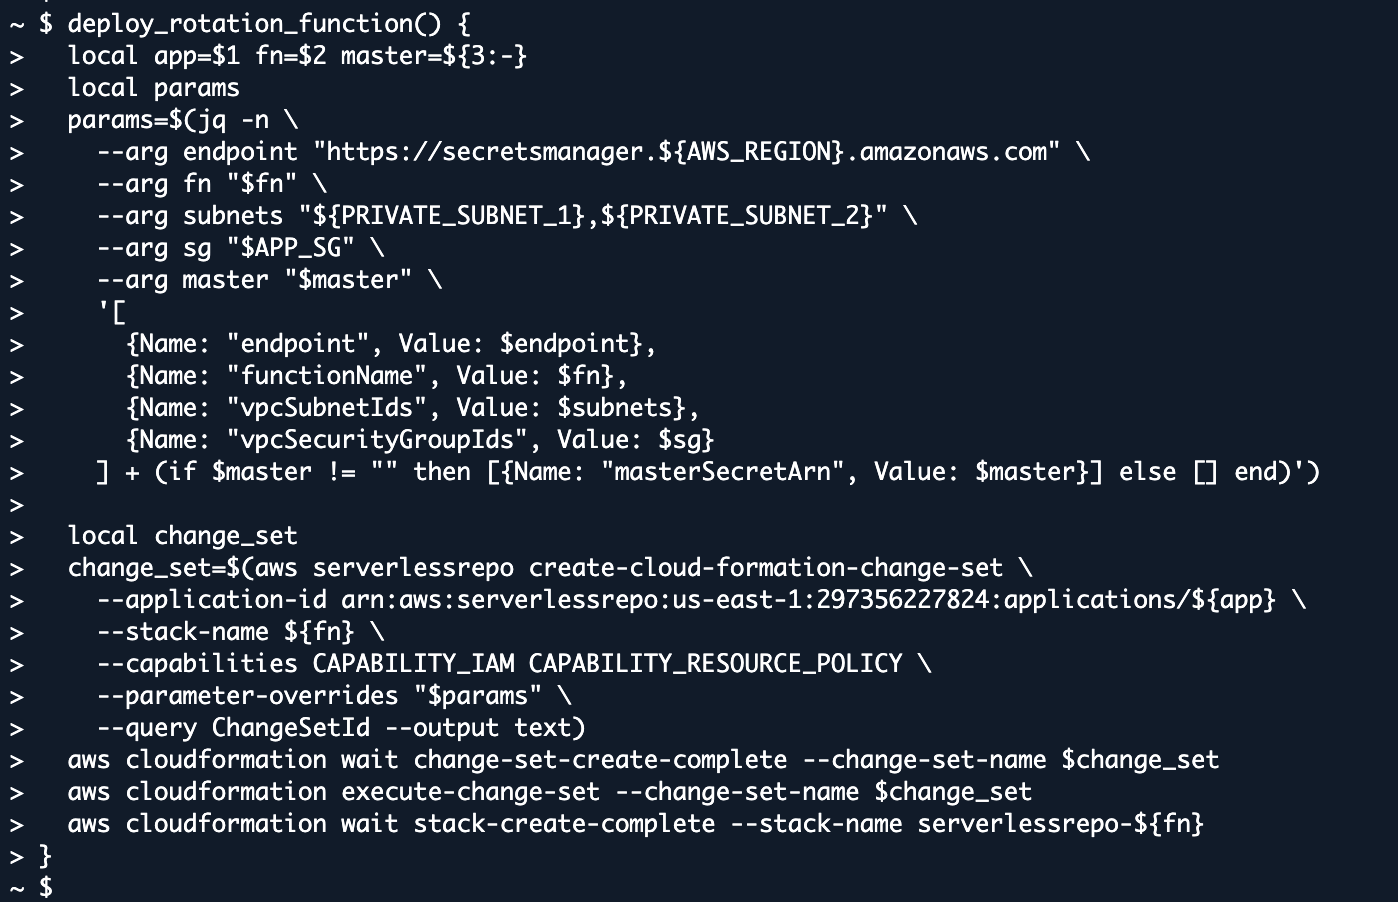
DB に接続できるように、Lambda 関数をプライベートサブネットに置き、DB と同じセキュリティグループを付けます。交代ユーザー方式には、管理者のシークレットの ARN も渡します。
deploy_rotation_function() {
  local app=$1 fn=$2 master=${3:-}
  local params
  params=$(jq -n \
    --arg endpoint "https://secretsmanager.${AWS_REGION}.amazonaws.com" \
    --arg fn "$fn" \
    --arg subnets "${PRIVATE_SUBNET_1},${PRIVATE_SUBNET_2}" \
    --arg sg "$APP_SG" \
    --arg master "$master" \
    '[
      {Name: "endpoint", Value: $endpoint},
      {Name: "functionName", Value: $fn},
      {Name: "vpcSubnetIds", Value: $subnets},
      {Name: "vpcSecurityGroupIds", Value: $sg}
    ] + (if $master != "" then [{Name: "masterSecretArn", Value: $master}] else [] end)')

  local change_set
  change_set=$(aws serverlessrepo create-cloud-formation-change-set \
    --application-id arn:aws:serverlessrepo:us-east-1:297356227824:applications/${app} \
    --stack-name ${fn} \
    --capabilities CAPABILITY_IAM CAPABILITY_RESOURCE_POLICY \
    --parameter-overrides "$params" \
    --query ChangeSetId --output text)
  aws cloudformation wait change-set-create-complete --change-set-name $change_set
  aws cloudformation execute-change-set --change-set-name $change_set
  aws cloudformation wait stack-create-complete --stack-name serverlessrepo-${fn}
}

deploy_rotation_function SecretsManagerRDSMySQLRotationSingleUser rotation-test-single-rotation
deploy_rotation_function SecretsManagerRDSMySQLRotationMultiUser rotation-test-alt-rotation "$MASTER_SECRET_ARN"
実行画面
スタックが作成されたことを確認しました。
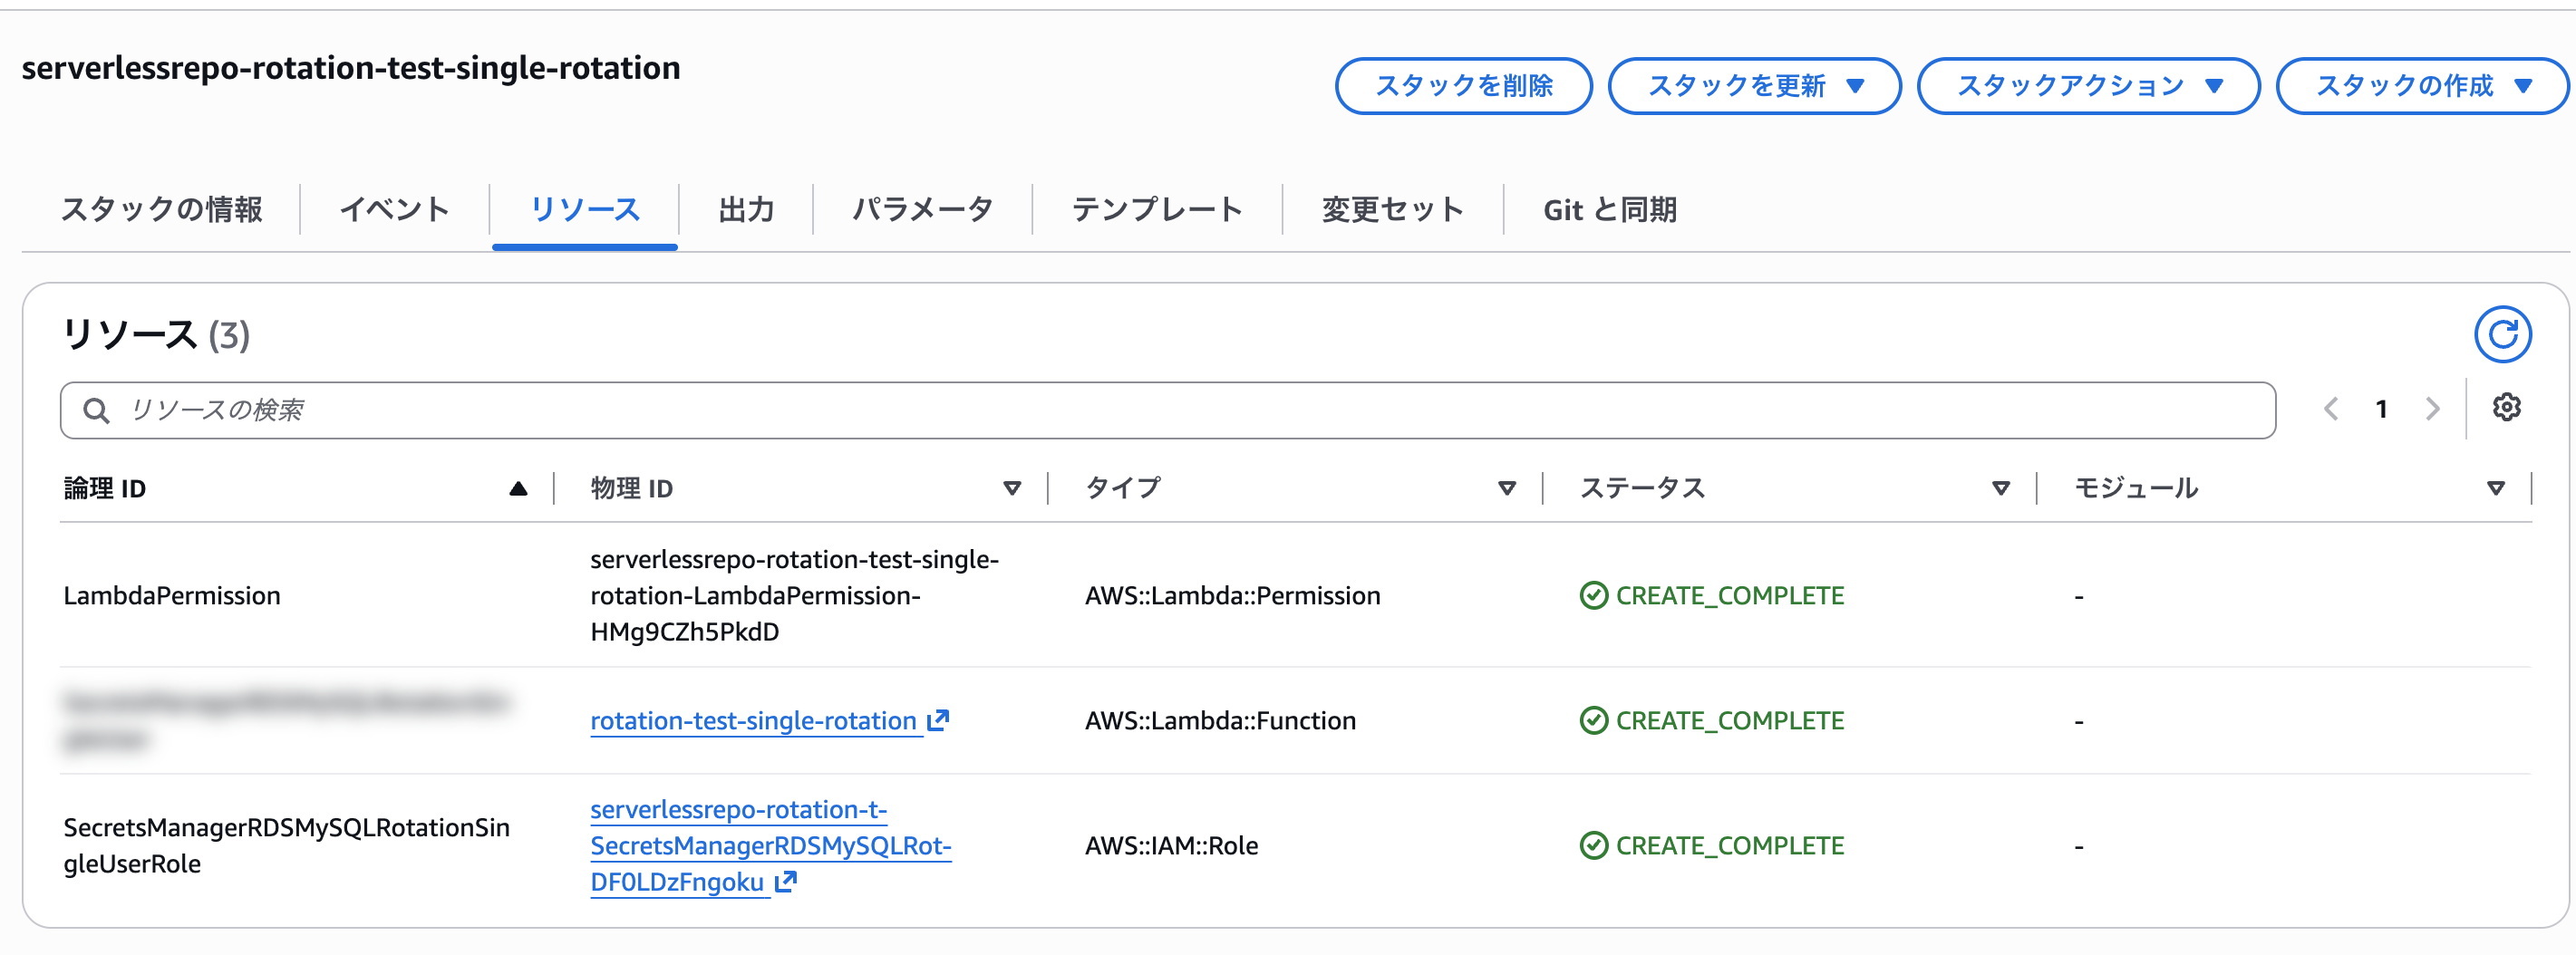
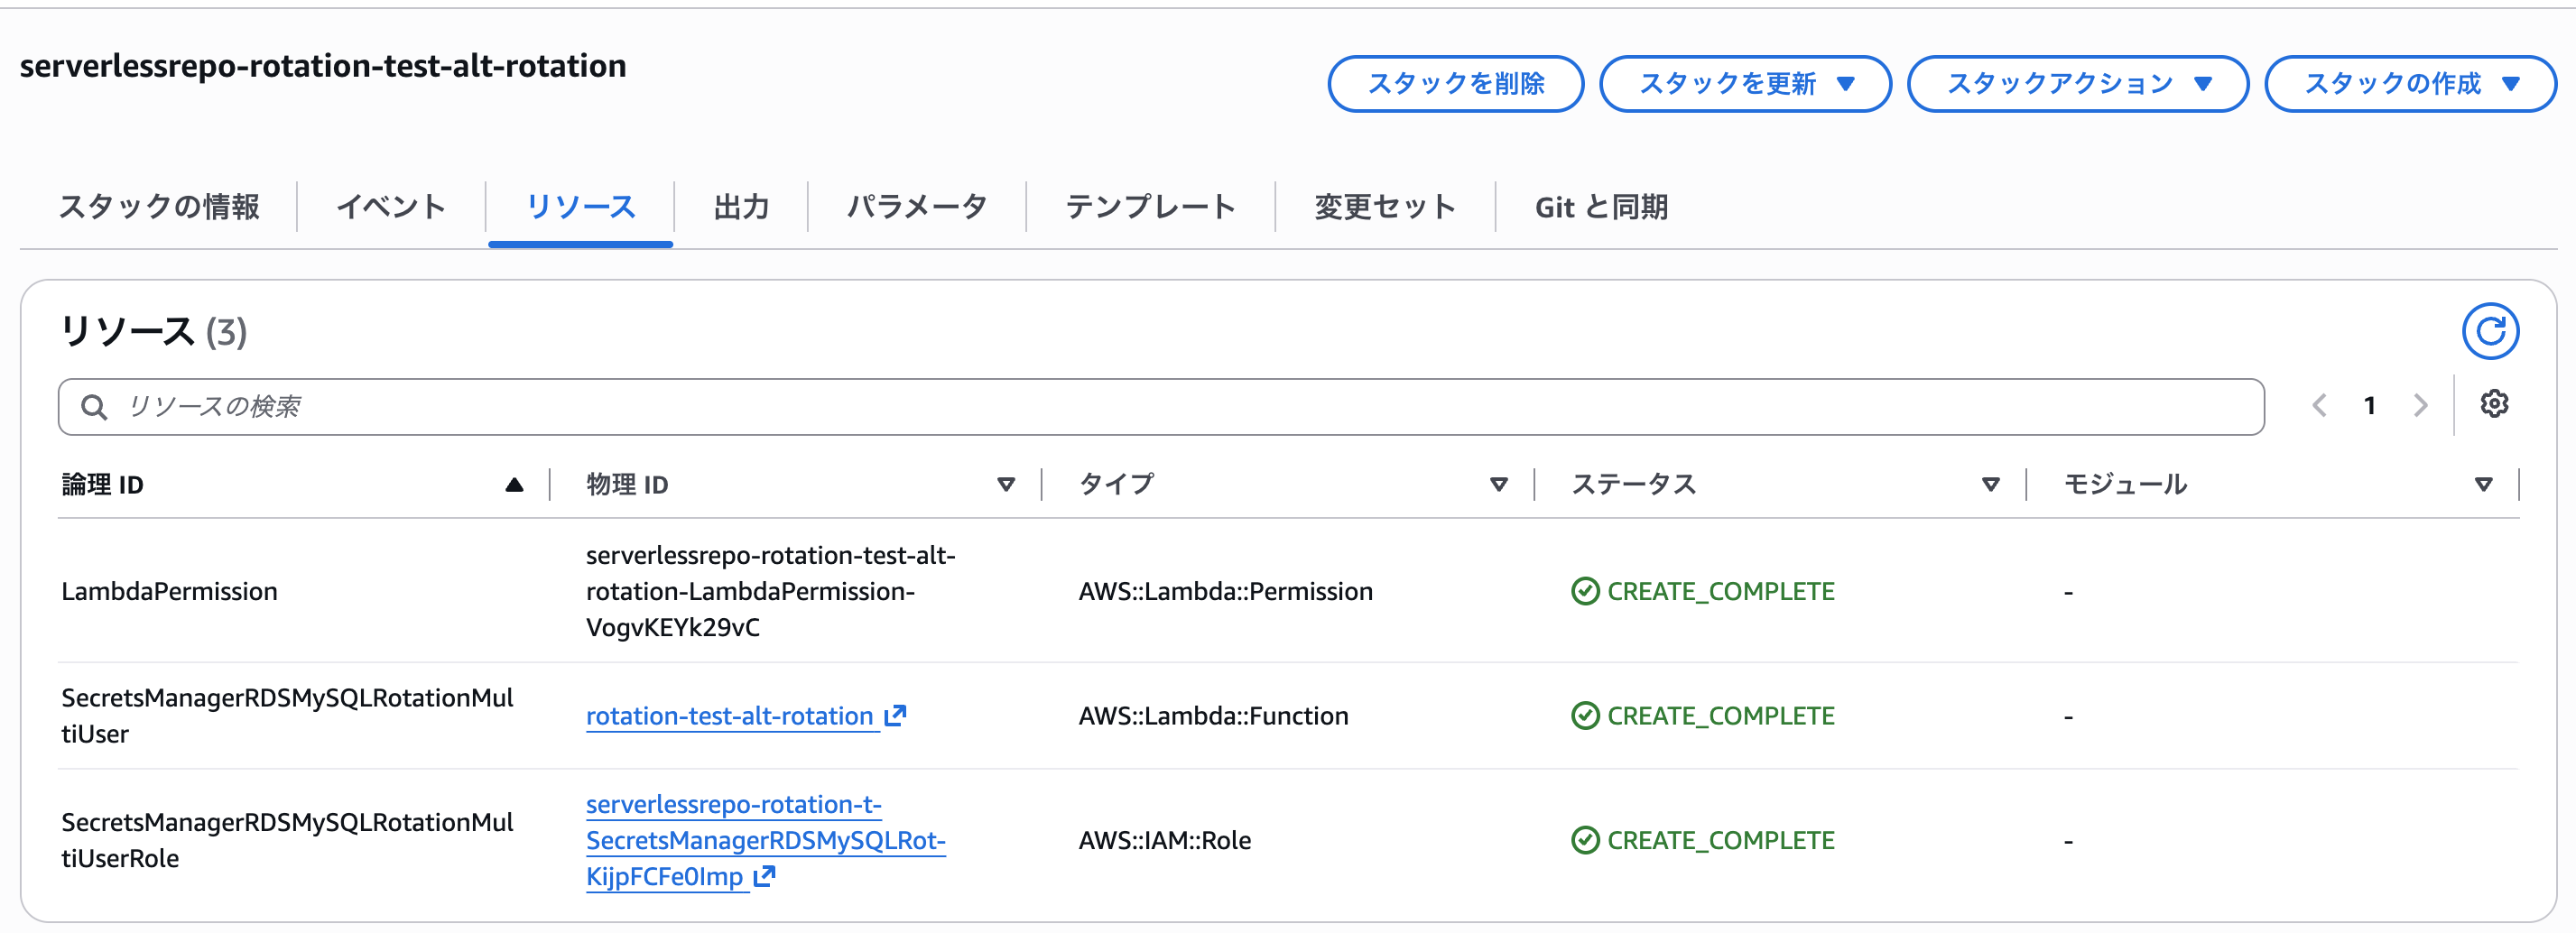
※SAR からデプロイしたスタックは、名前の先頭に serverlessrepo- が付きます。
ローテーション用の Lambda 関数が作成されています。
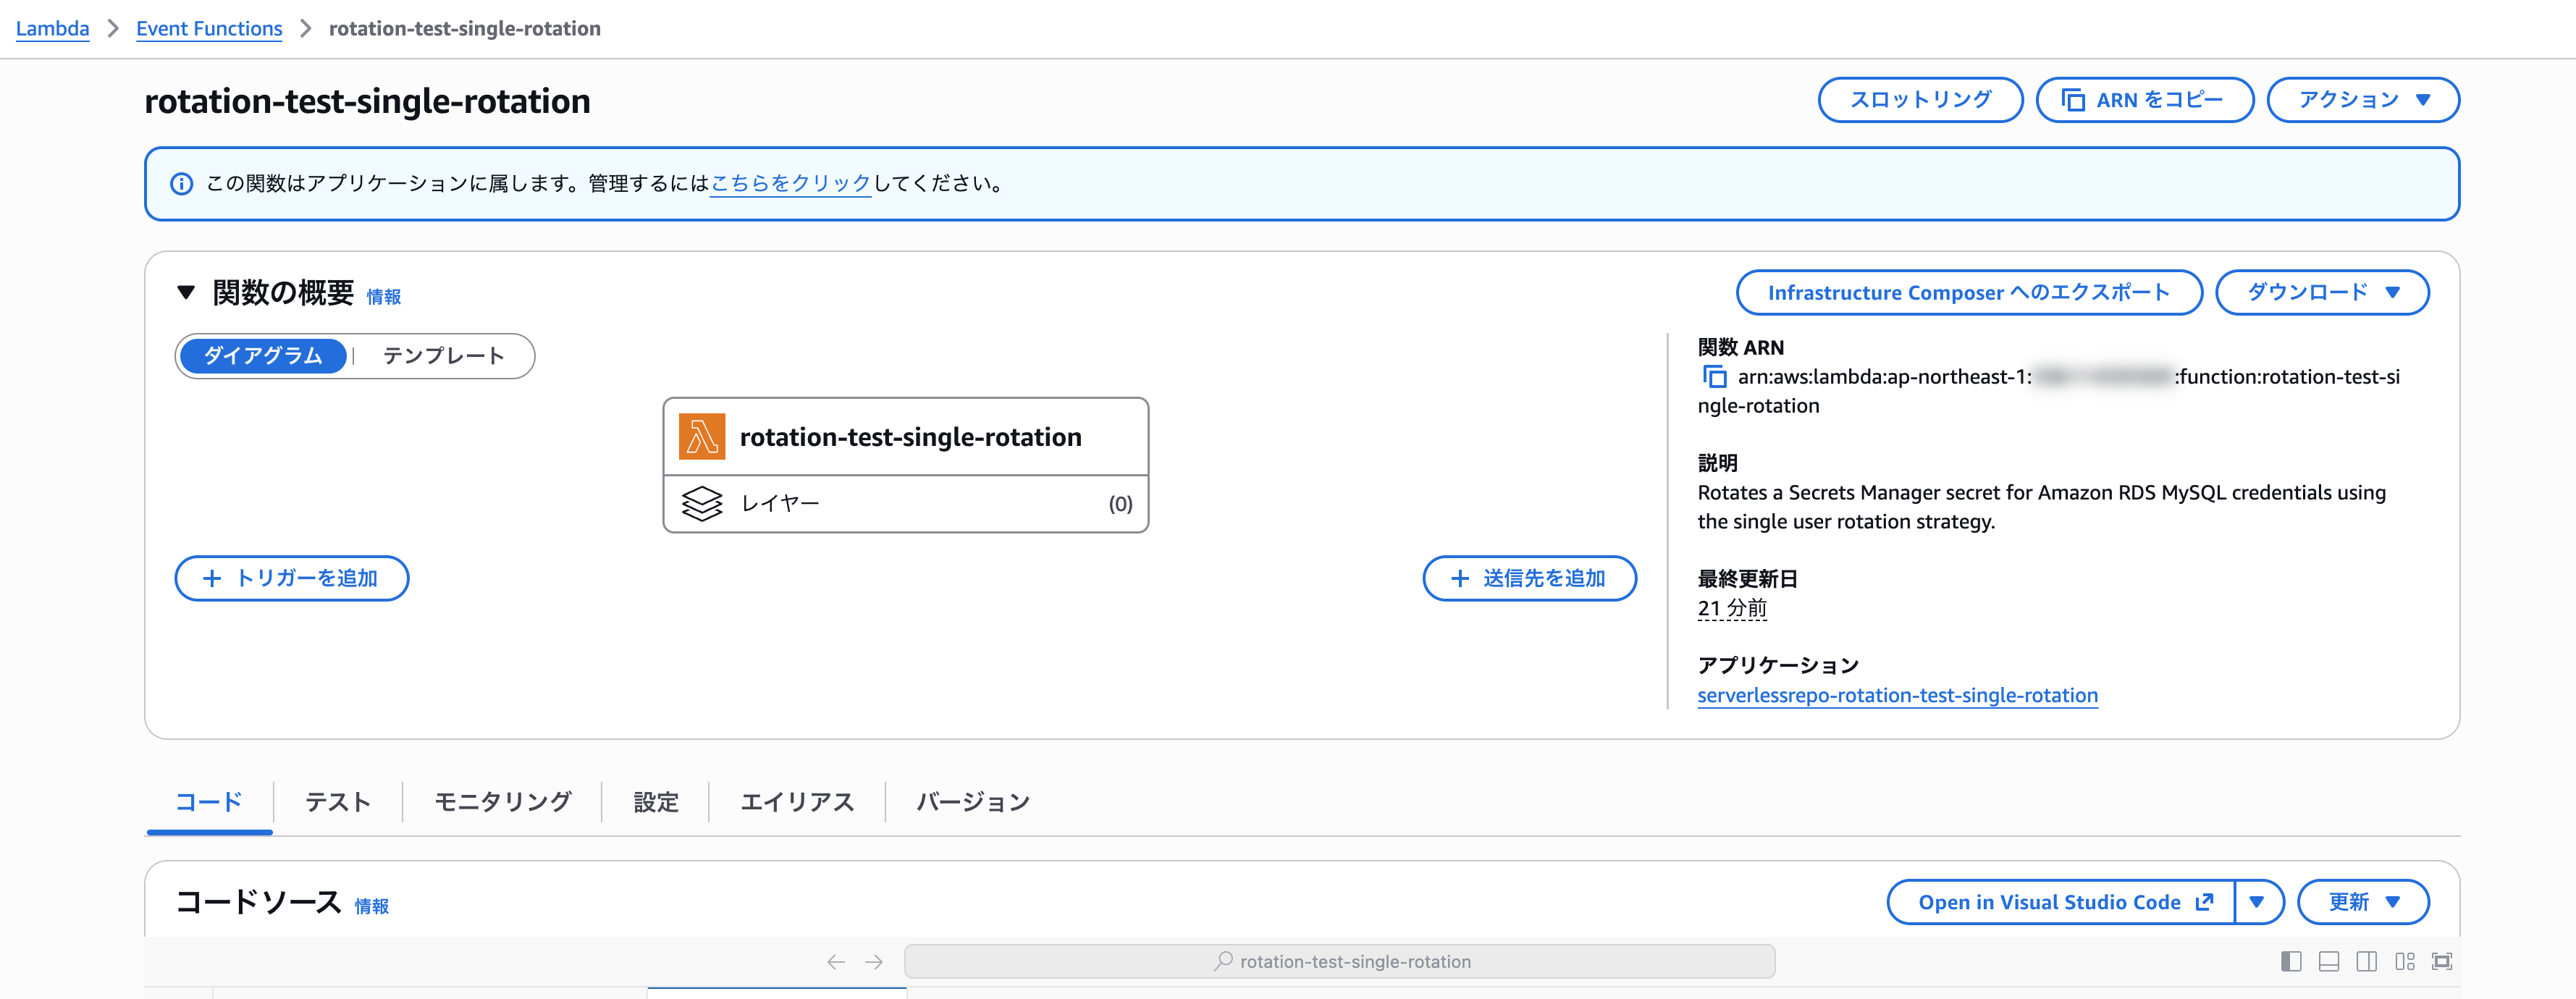
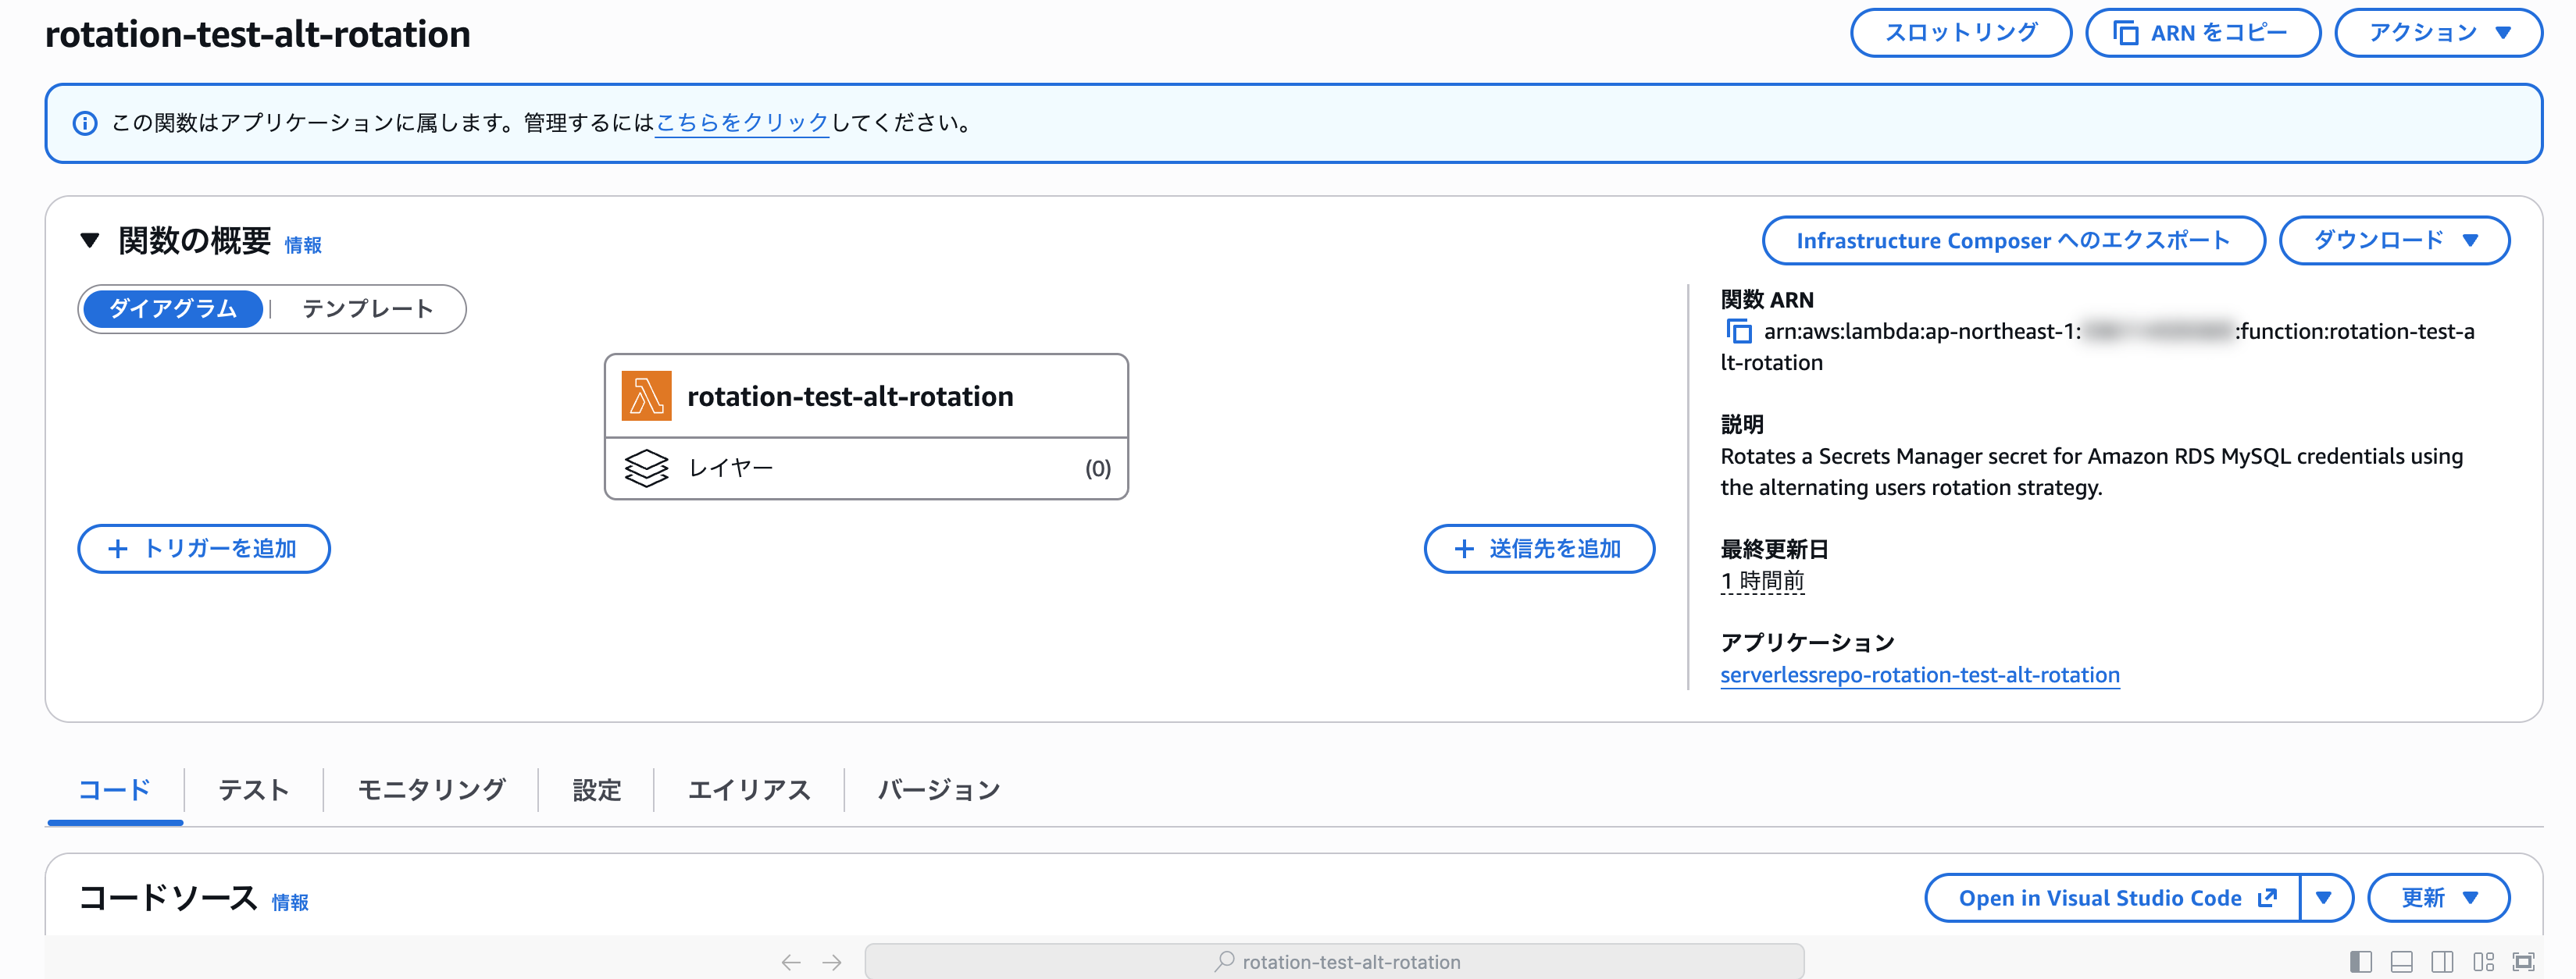
ローテーション用の Lambda 関数には、Secrets Manager からの呼び出しを許可するリソースベースのポリシーが付いています。
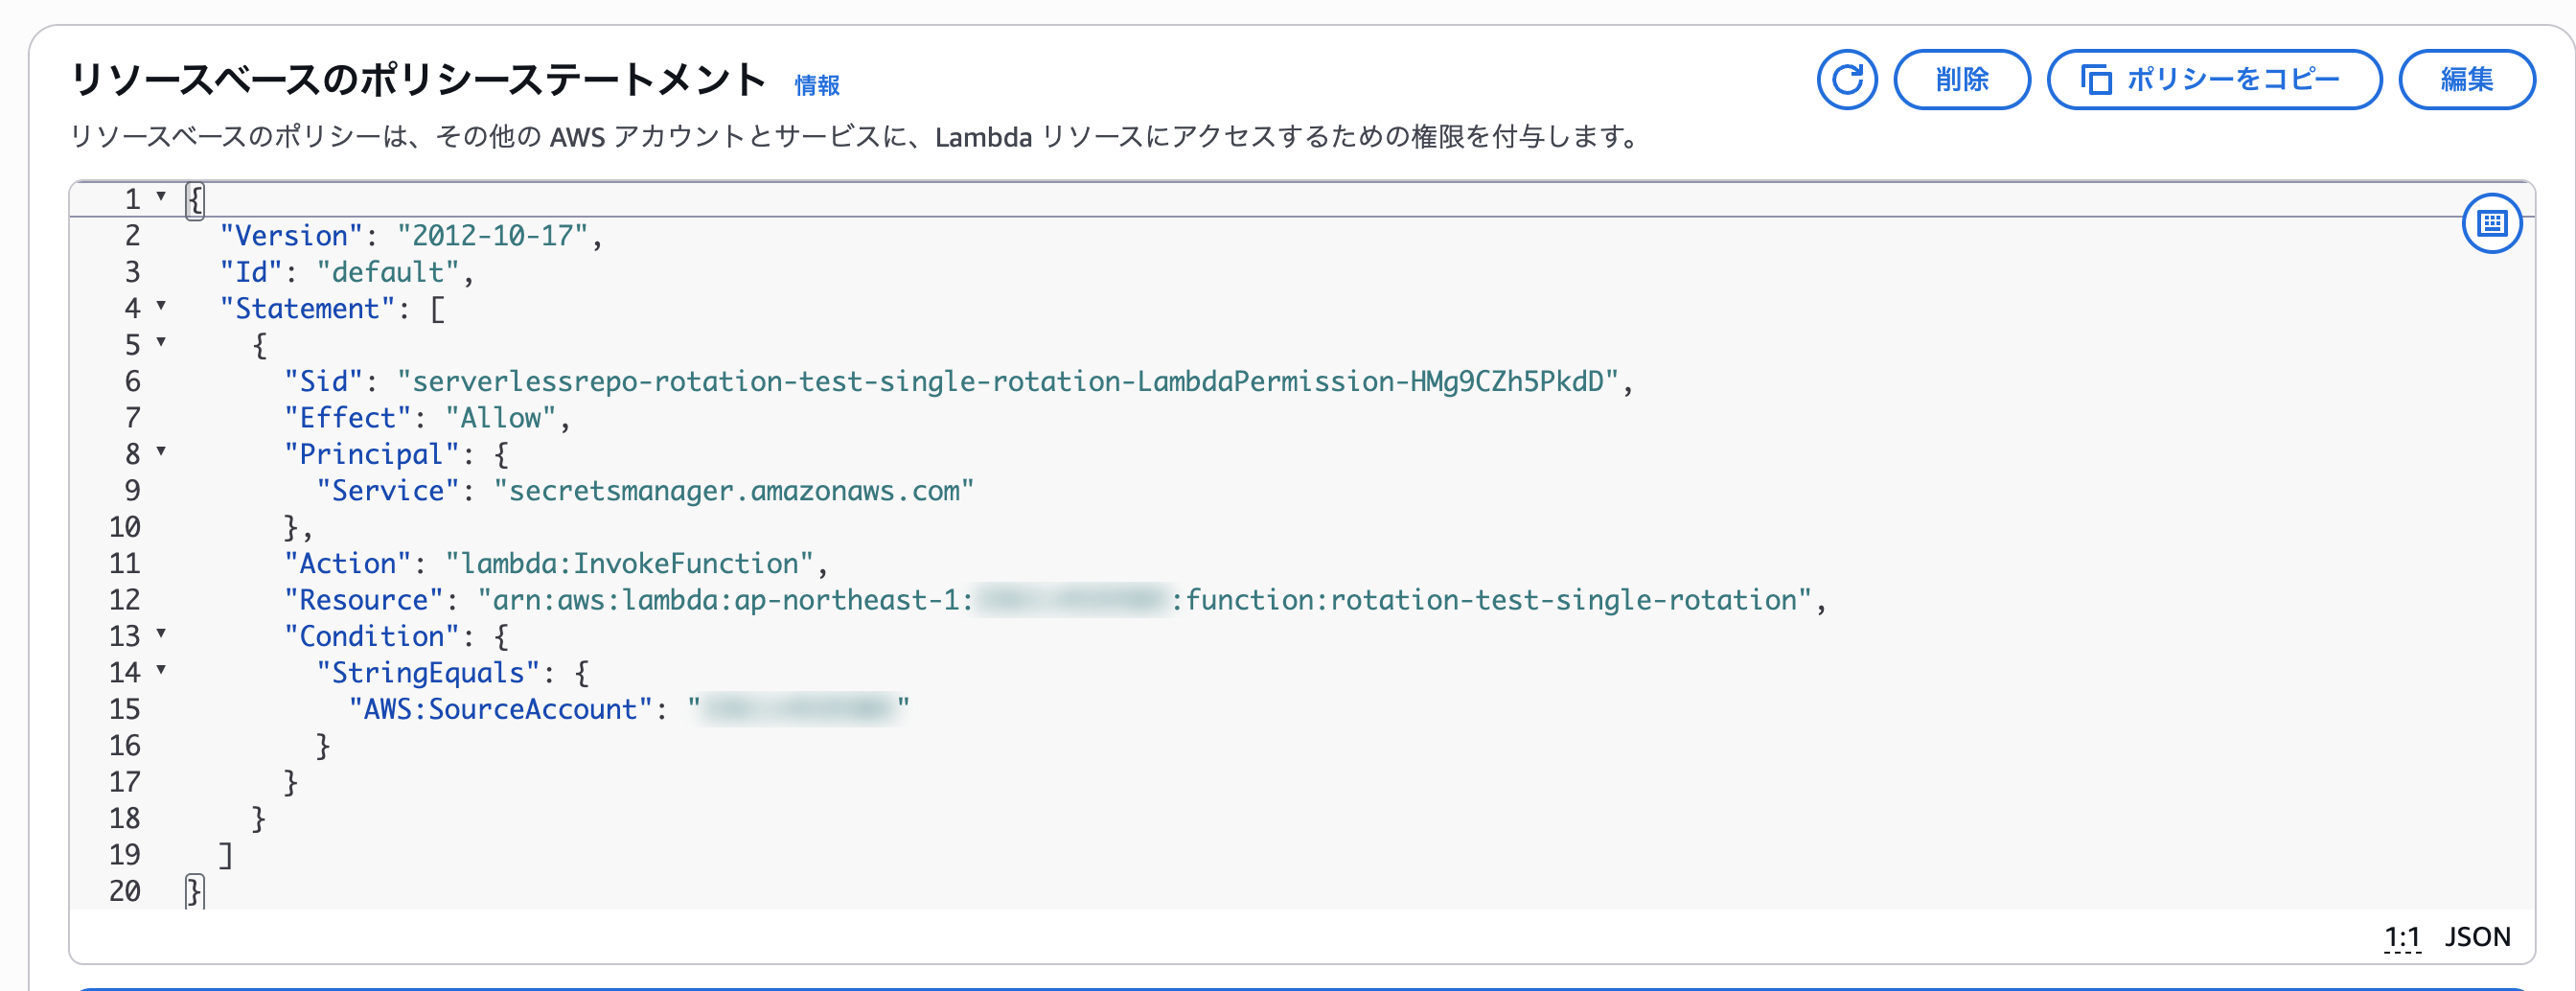
※Secrets Manager から Lambda 関数を呼び出すためのリソースベースのポリシーは、SAR のテンプレートが付けてくれます。
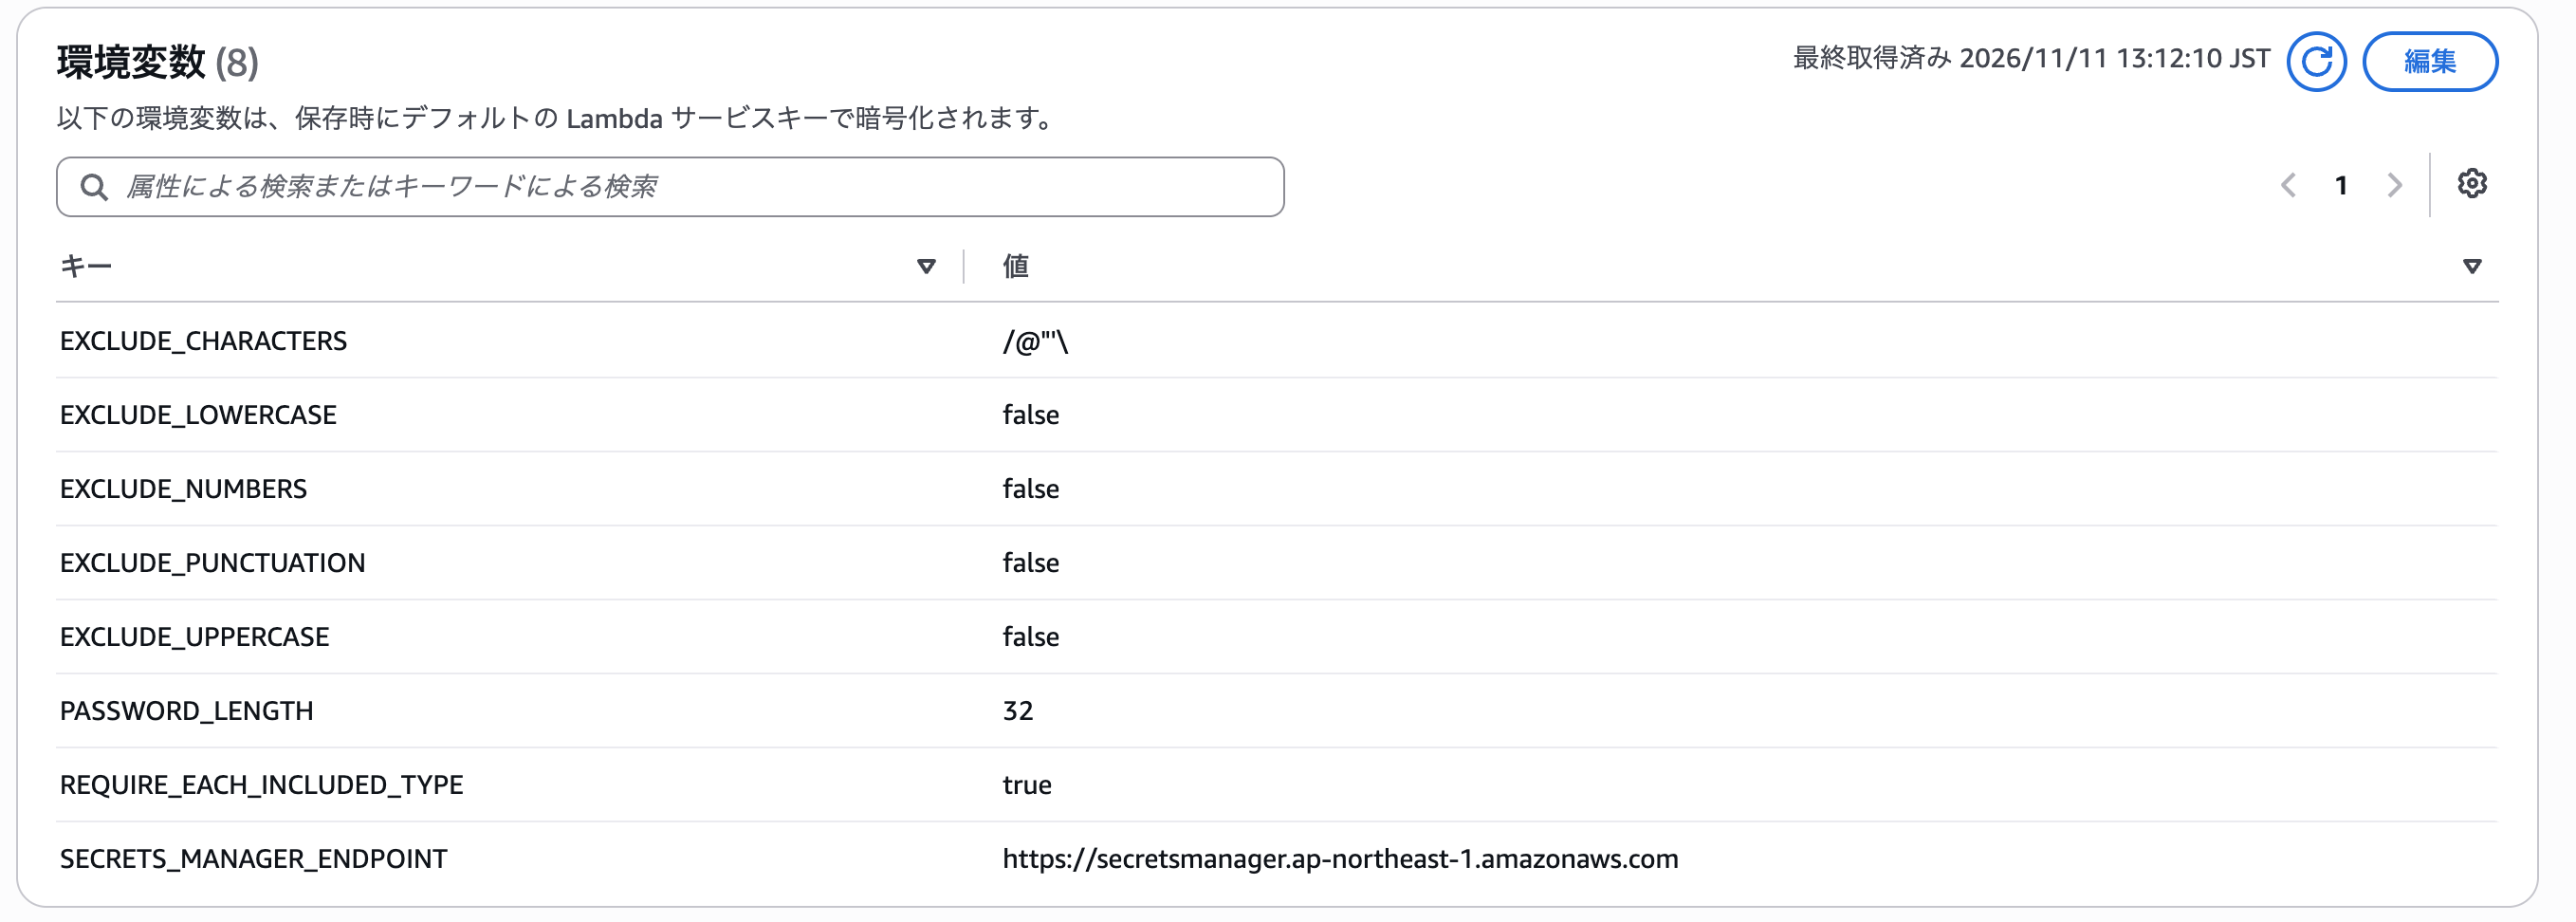
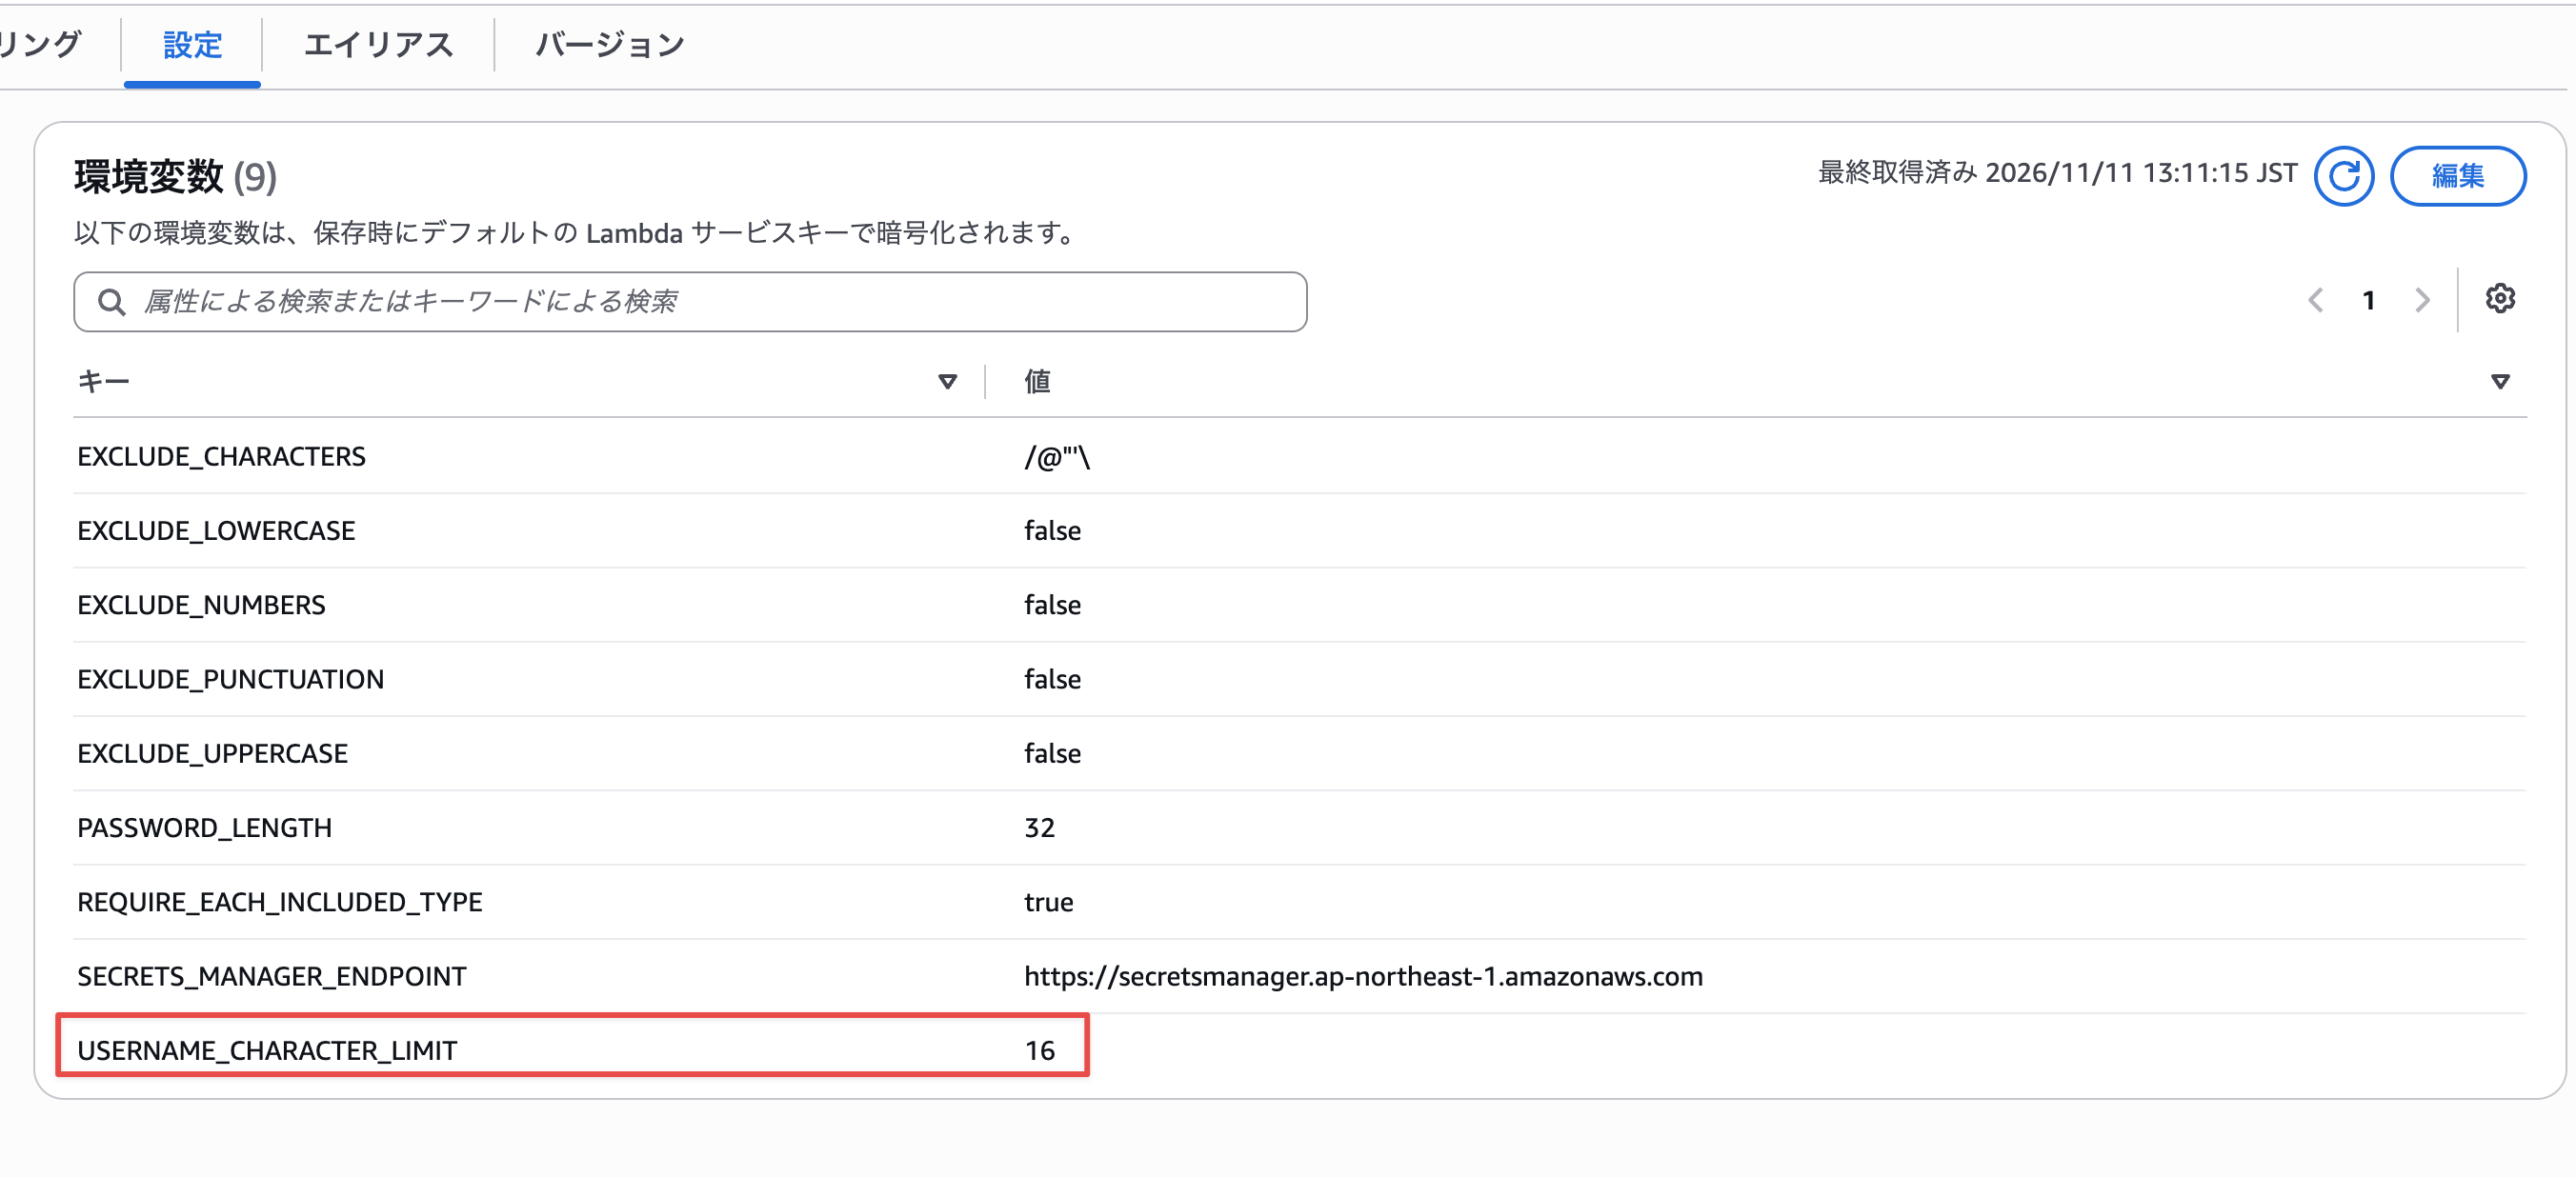
Lambda 関数の設定から、環境変数に設定されている値を確認します。
交代ユーザー方式の Lambda 関数の環境変数には、USERNAME_CHARACTER_LIMIT というキーが設定されており、ユーザー名の文字数の上限を定義しています(2枚目の赤枠参照)。
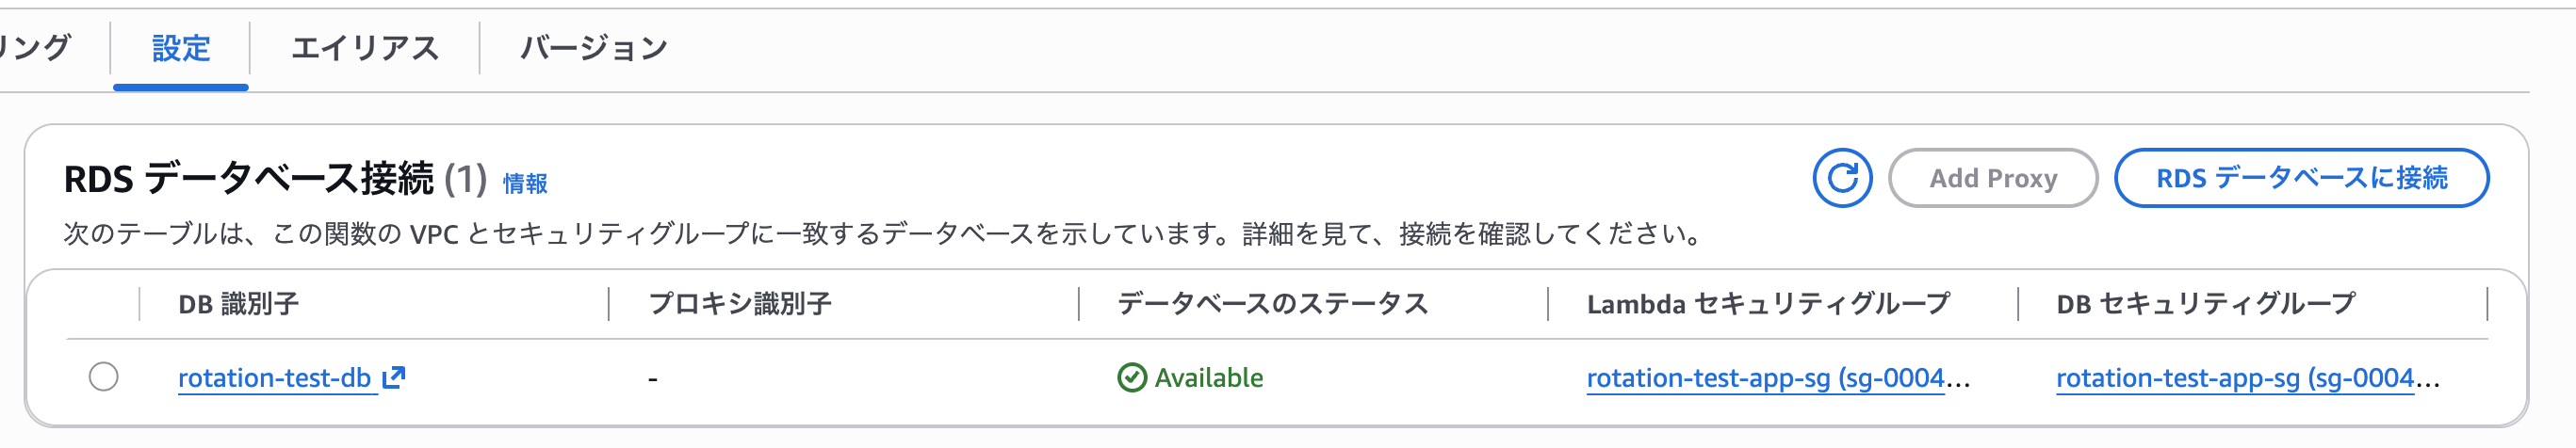
2つの Lambda 関数とも、今回の検証用に作成した RDS とのデータベース接続が設定されています。
最後に、シークレットにローテーションを設定します。
--no-rotate-immediately を付けて、設定した時点ではローテーションしないようにしています。検証の途中で、好きなタイミングでローテーションするためです。
※--no-rotate-immediately を付けても、Secrets Manager はローテーション関数の testSecret ステップだけを実行します。テスト用に AWSPENDING のバージョンを作り、テスト後に削除します。私の環境では2つとも成功し、パスワードは変わりませんでした。ローテーション関数から DB と VPC エンドポイントに接続できることの確認にもなりました。
export SINGLE_ROTATION_FN_ARN=$(aws lambda get-function --function-name rotation-test-single-rotation --query Configuration.FunctionArn --output text)
export ALT_ROTATION_FN_ARN=$(aws lambda get-function --function-name rotation-test-alt-rotation --query Configuration.FunctionArn --output text)

aws secretsmanager rotate-secret \
  --secret-id rotation-test/app-single \
  --rotation-lambda-arn $SINGLE_ROTATION_FN_ARN \
  --rotation-rules '{"ScheduleExpression": "rate(7 days)"}' \
  --no-rotate-immediately

aws secretsmanager rotate-secret \
  --secret-id rotation-test/app-alt \
  --rotation-lambda-arn $ALT_ROTATION_FN_ARN \
  --rotation-rules '{"ScheduleExpression": "rate(7 days)"}' \
  --no-rotate-immediately
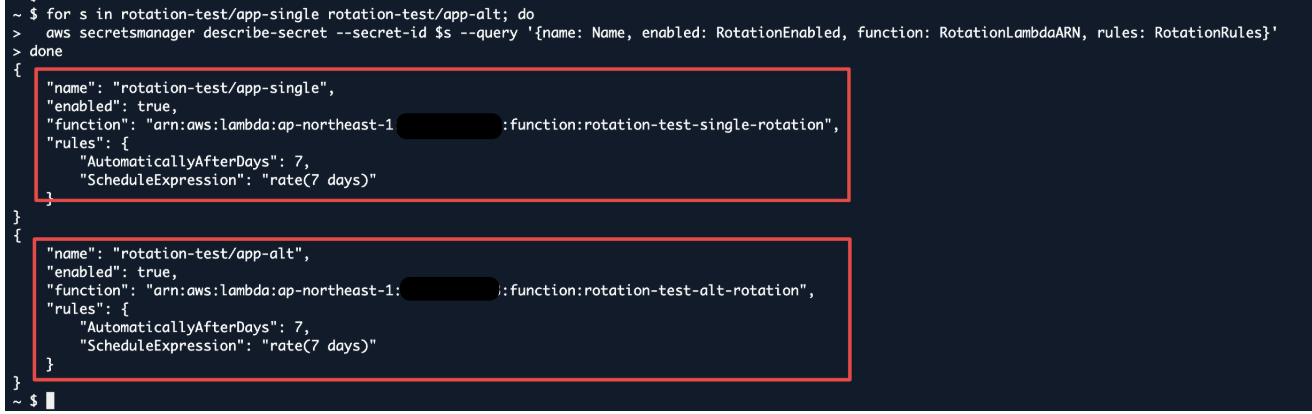
設定を確認します。
for s in rotation-test/app-single rotation-test/app-alt; do
  aws secretsmanager describe-secret --secret-id $s --query '{name: Name, enabled: RotationEnabled, function: RotationLambdaARN, rules: RotationRules}'
done
2つのシークレットのローテーション設定が完了しました。
コンソールからも、ローテーション設定が有効になっていることを確認しました。
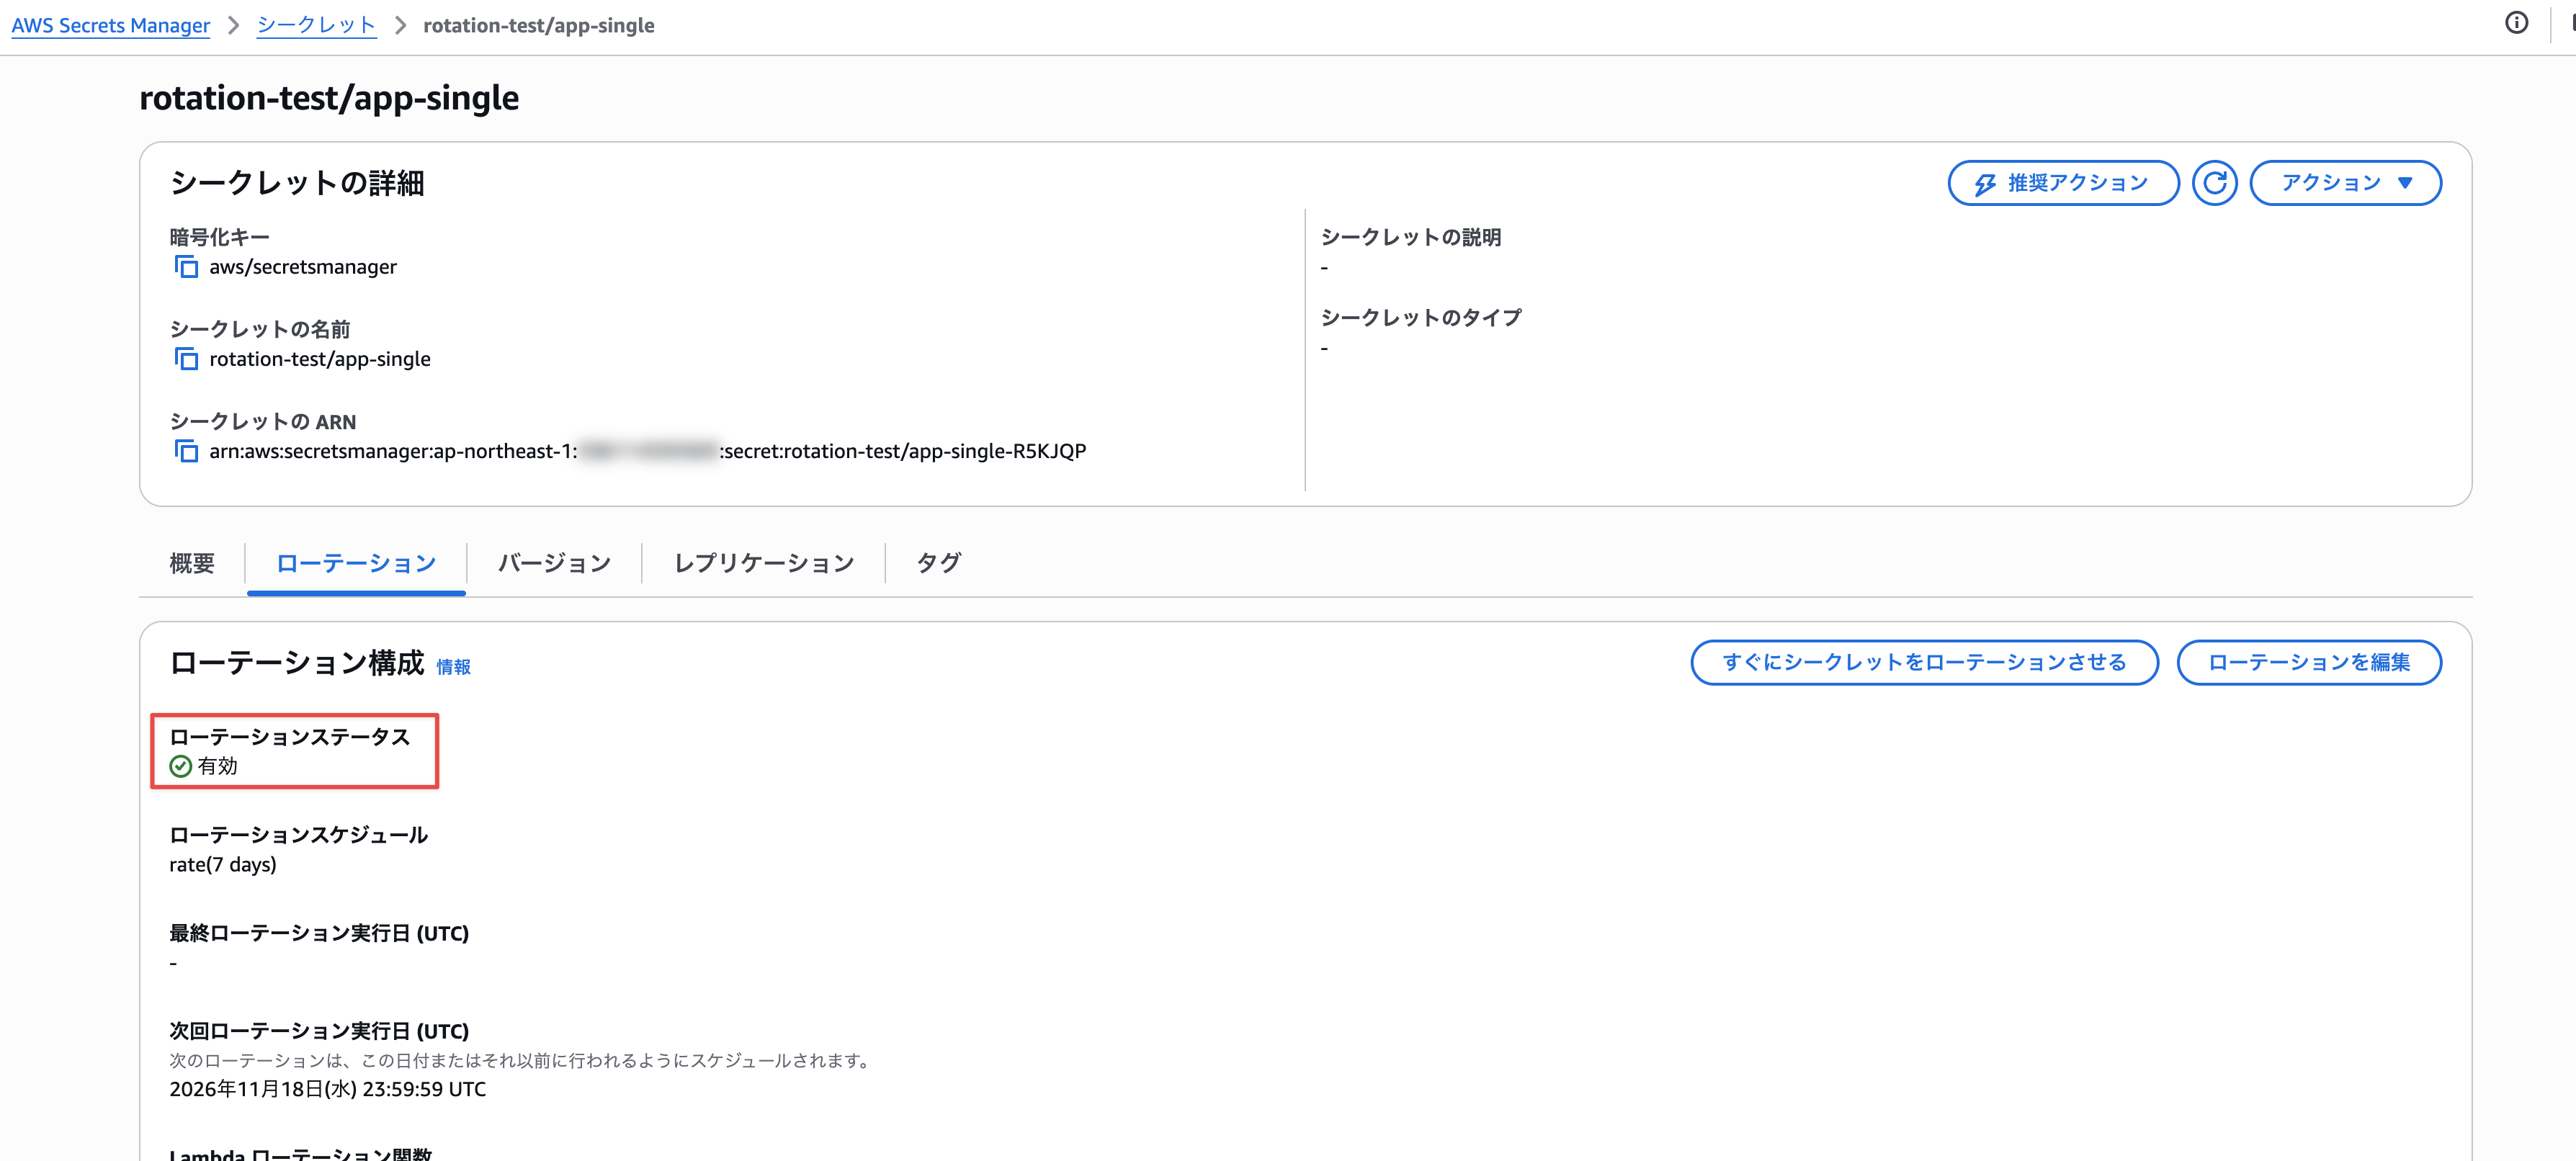
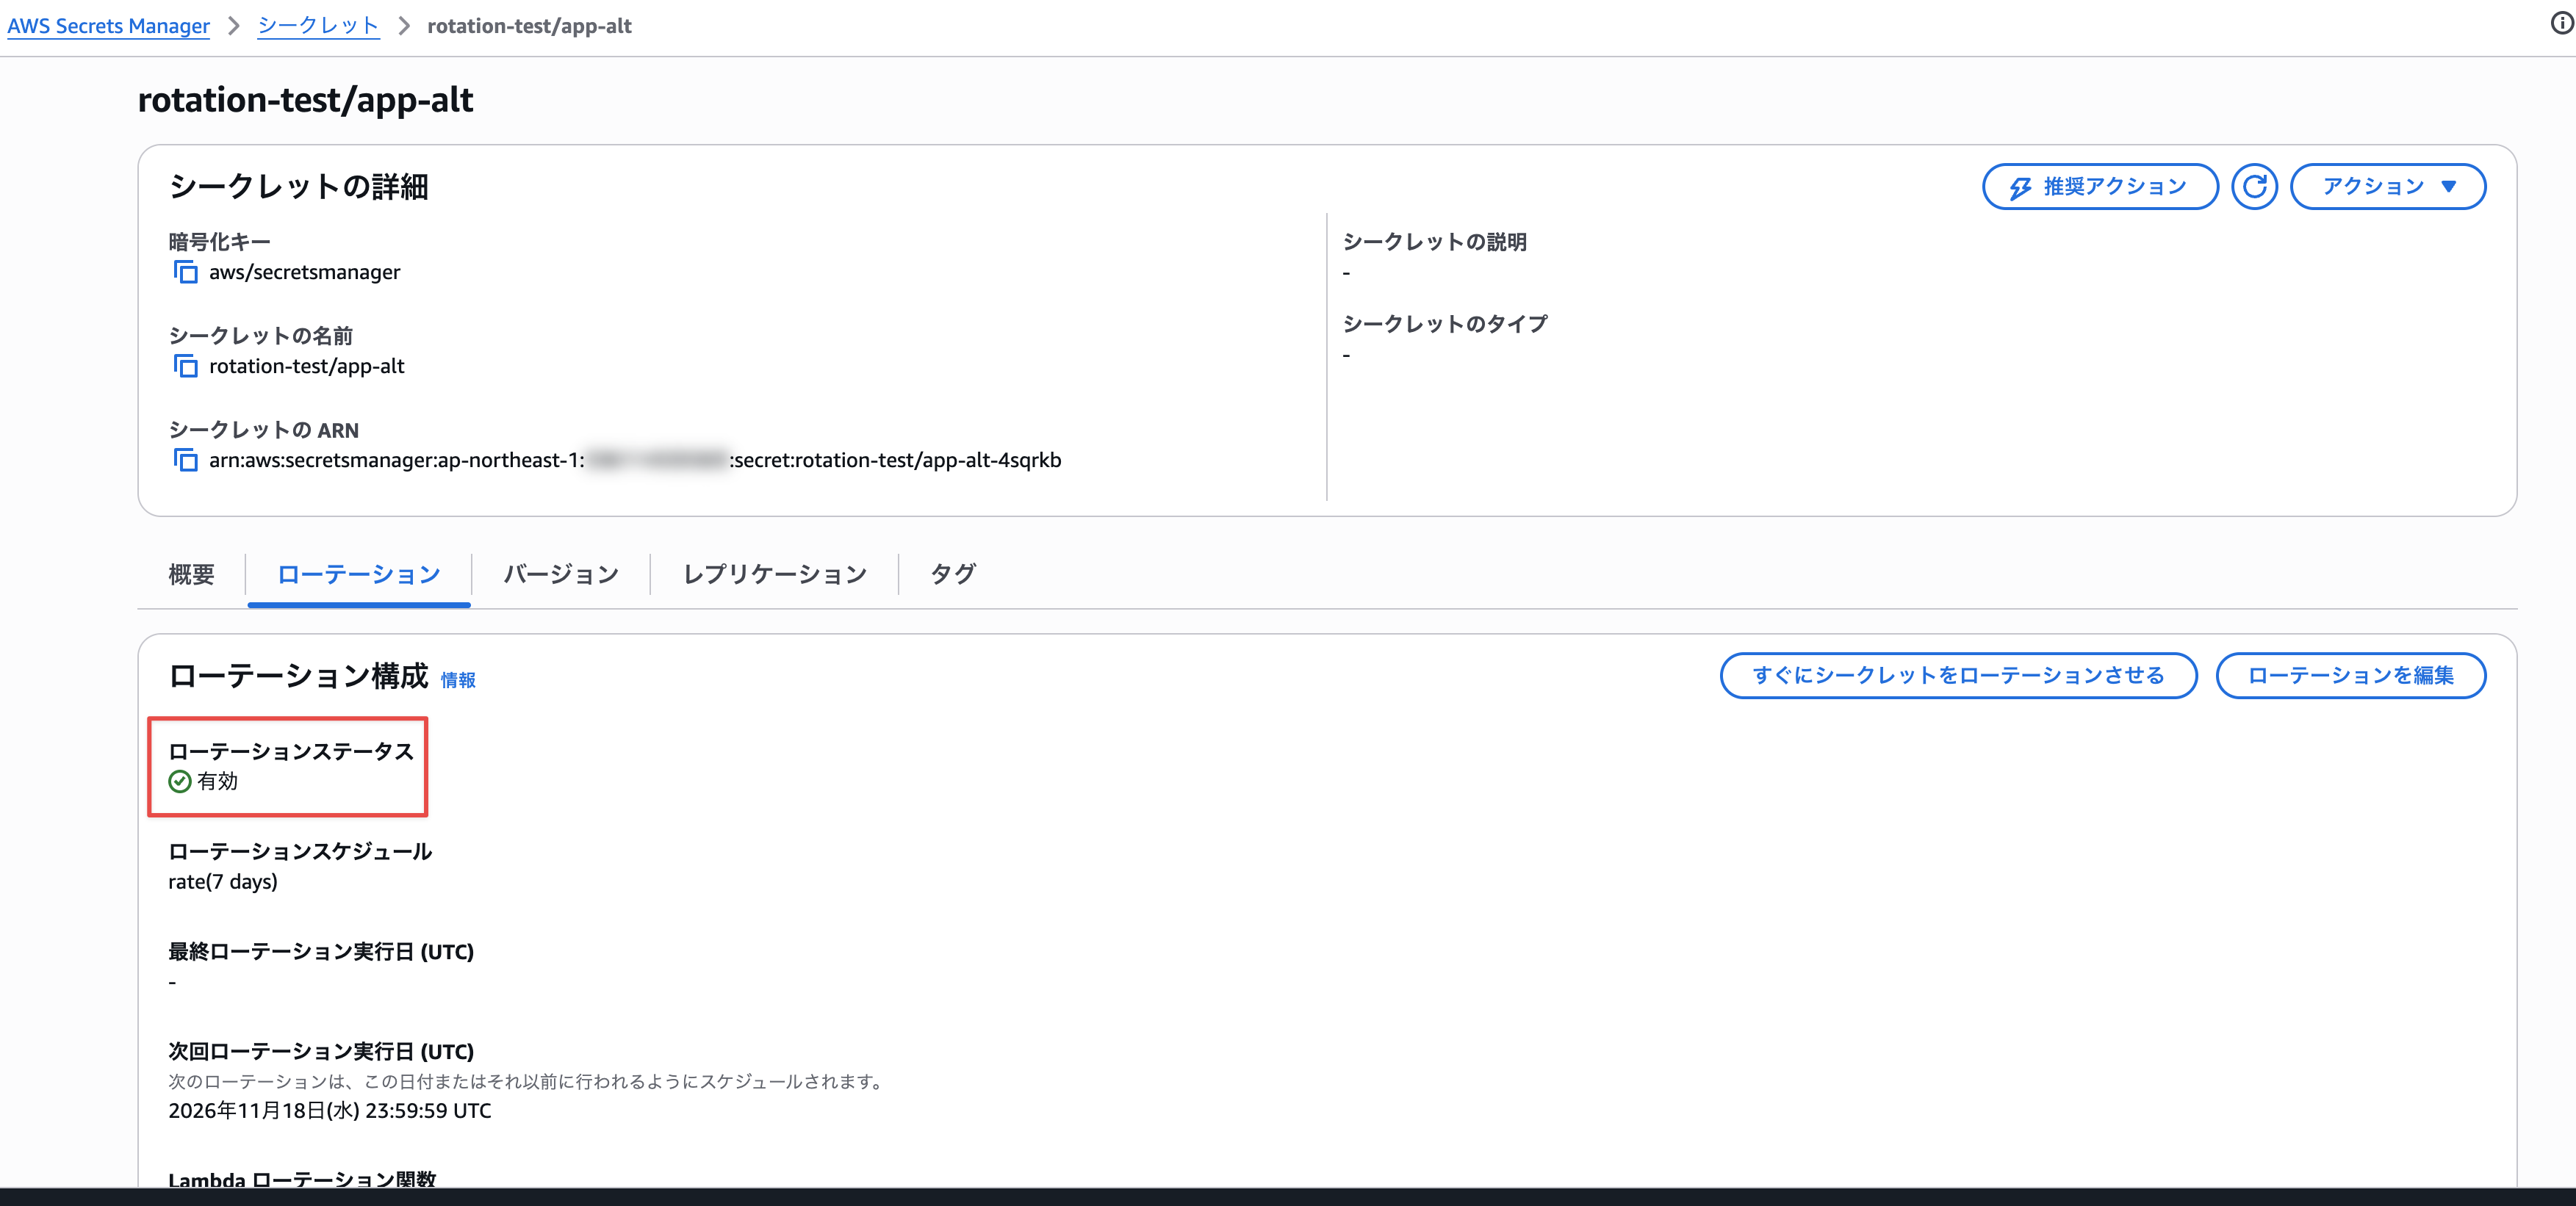
準備2: アプリを ECS on Fargate にデプロイする
アプリは、リクエストのたびに DB へ新しく接続して、SELECT CURRENT_USER() の結果とタスクのホスト名を返します。
接続に失敗したら 500 を返し、エラーをログに出します。
ALB のヘルスチェック用の /health は、DB に接続せずに 200 を返します。DB に接続できなくても ALB からタスクが外れないようにして、接続エラーを 500 として記録するためです。
実際に使用したアプリ app.py です。
import os
import socket

import pymysql
from http.server import BaseHTTPRequestHandler, ThreadingHTTPServer

HOSTNAME = socket.gethostname()

class Handler(BaseHTTPRequestHandler):
    def do_GET(self):
        if self.path == "/health":
            self.reply(200, "ok")
            return
        try:
            conn = pymysql.connect(
                host=os.environ["DB_HOST"],
                user=os.environ["DB_USER"],
                password=os.environ["DB_PASSWORD"],
                database="appdb",
                connect_timeout=3,
            )
            with conn.cursor() as cur:
                cur.execute("SELECT CURRENT_USER()")
                user = cur.fetchone()[0]
            conn.close()
            self.reply(200, f"OK {user} {HOSTNAME}")
        except Exception as e:
            print(f"DB_ERROR {e}", flush=True)
            self.reply(500, f"NG {e} {HOSTNAME}")

    def reply(self, code, body):
        data = body.encode()
        self.send_response(code)
        self.send_header("Content-Type", "text/plain")
        self.send_header("Content-Length", str(len(data)))
        self.end_headers()
        self.wfile.write(data)

    def log_message(self, format, *args):
        pass

ThreadingHTTPServer(("0.0.0.0", 8080), Handler).serve_forever()
CloudShell で app.py として保存します。
コンテナイメージはビルドせず、公式の Python イメージを使い、起動時に app.py を base64 で環境変数から受け取って実行します。
タスク定義の secrets では、シークレットの JSON から host username password のキーを指定して、環境変数に入れています。
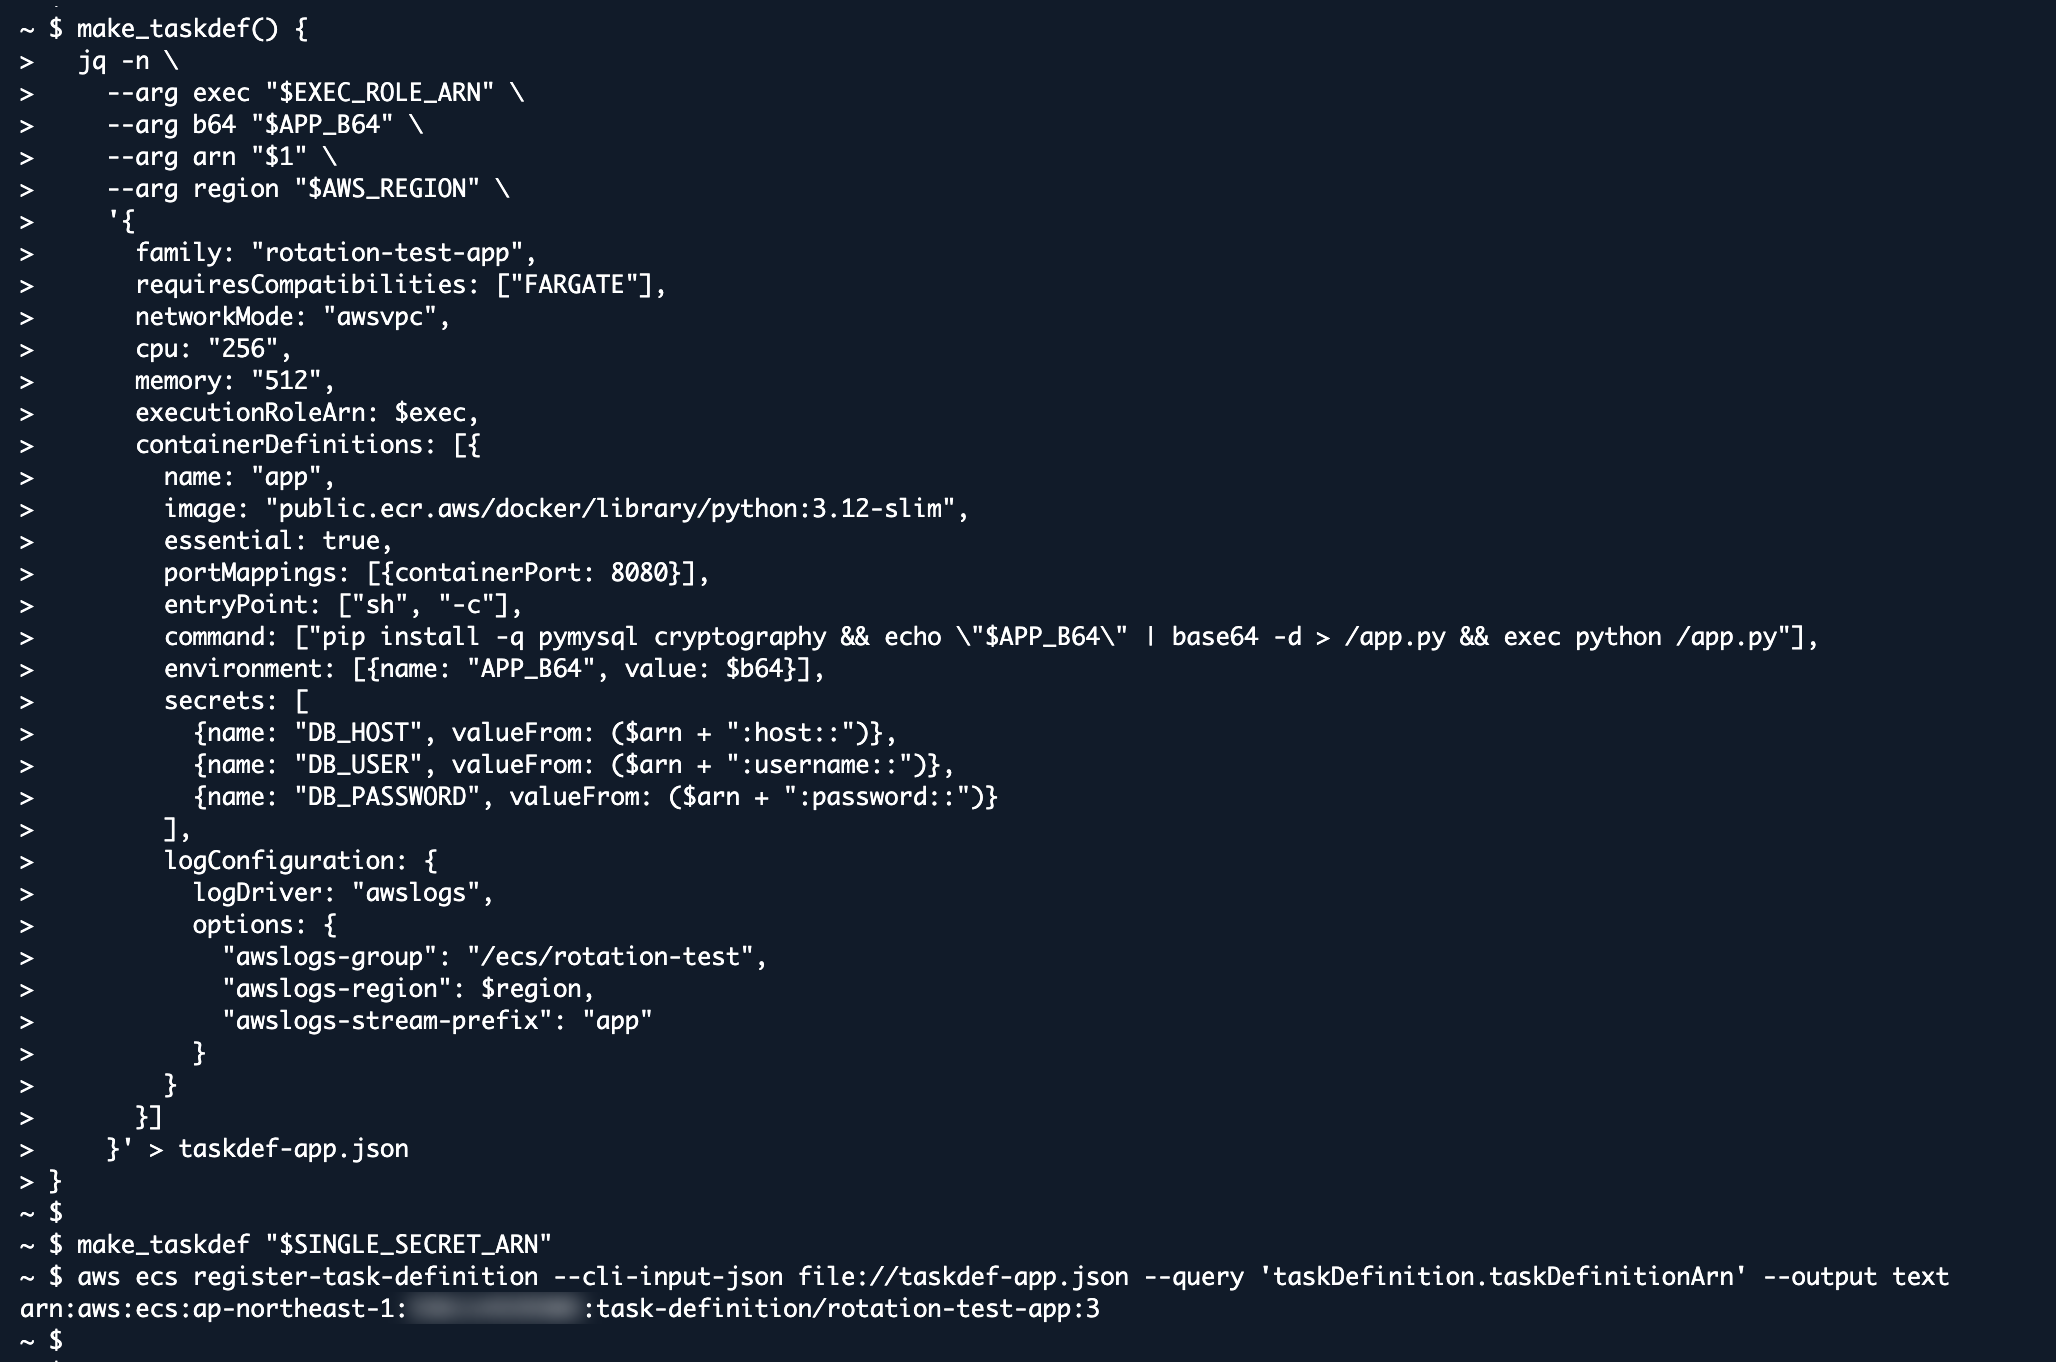
検証1と検証2でシークレットの ARN だけを変えて登録するので、タスク定義を作る処理を関数にしておきます。
export APP_B64=$(base64 -w0 app.py)

make_taskdef() {
  jq -n \
    --arg exec "$EXEC_ROLE_ARN" \
    --arg b64 "$APP_B64" \
    --arg arn "$1" \
    --arg region "$AWS_REGION" \
    '{
      family: "rotation-test-app",
      requiresCompatibilities: ["FARGATE"],
      networkMode: "awsvpc",
      cpu: "256",
      memory: "512",
      executionRoleArn: $exec,
      containerDefinitions: [{
        name: "app",
        image: "public.ecr.aws/docker/library/python:3.12-slim",
        essential: true,
        portMappings: [{containerPort: 8080}],
        entryPoint: ["sh", "-c"],
        command: ["pip install -q pymysql cryptography && echo \"$APP_B64\" | base64 -d > /app.py && exec python /app.py"],
        environment: [{name: "APP_B64", value: $b64}],
        secrets: [
          {name: "DB_HOST", valueFrom: ($arn + ":host::")},
          {name: "DB_USER", valueFrom: ($arn + ":username::")},
          {name: "DB_PASSWORD", valueFrom: ($arn + ":password::")}
        ],
        logConfiguration: {
          logDriver: "awslogs",
          options: {
            "awslogs-group": "/ecs/rotation-test",
            "awslogs-region": $region,
            "awslogs-stream-prefix": "app"
          }
        }
      }]
    }' > taskdef-app.json
}

make_taskdef "$SINGLE_SECRET_ARN"
aws ecs register-task-definition --cli-input-json file://taskdef-app.json --query 'taskDefinition.taskDefinitionArn' --output text
実行画面
サービスを作ります。
タスクは2つにして、デプロイ設定は minimumHealthyPercent(最小正常率)を100%、maximumPercent(最大率)を200%にします。新しいタスクがヘルスチェックに合格するまで、古いタスクを停止しない設定です。
ALB のターゲットグループの登録解除の遅延は、既定の300秒から30秒に短くしてあります。
aws ecs create-service \
  --cluster rotation-test-cluster \
  --service-name rotation-test-app \
  --task-definition rotation-test-app \
  --desired-count 2 \
  --launch-type FARGATE \
  --network-configuration "awsvpcConfiguration={subnets=[${PUBLIC_SUBNETS_CSV}],securityGroups=[${APP_SG}],assignPublicIp=ENABLED}" \
  --load-balancers "targetGroupArn=${TG_ARN},containerName=app,containerPort=8080" \
  --deployment-configuration "minimumHealthyPercent=100,maximumPercent=200" \
  --health-check-grace-period-seconds 60 \
  --query 'service.serviceArn' --output text

aws ecs wait services-stable --cluster rotation-test-cluster --services rotation-test-app
curl -s http://$ALB_DNS/; echo
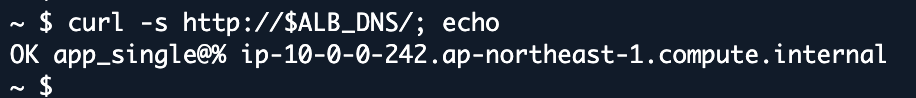
app_single で DB に接続できました!
準備3: ローテーションをきっかけに再デプロイする仕組みを作る
再デプロイ用の Lambda 関数です。
受け取ったイベントをログに出してから、ECS のサービスを強制的に新しいデプロイで更新します。
実際に使用した Lambda 関数 redeploy.py です。
import json
import os

import boto3

ecs = boto3.client("ecs")

def lambda_handler(event, context):
    print(json.dumps(event))
    ecs.update_service(
        cluster=os.environ["CLUSTER"],
        service=os.environ["SERVICE"],
        forceNewDeployment=True,
    )
    print("forceNewDeployment requested")
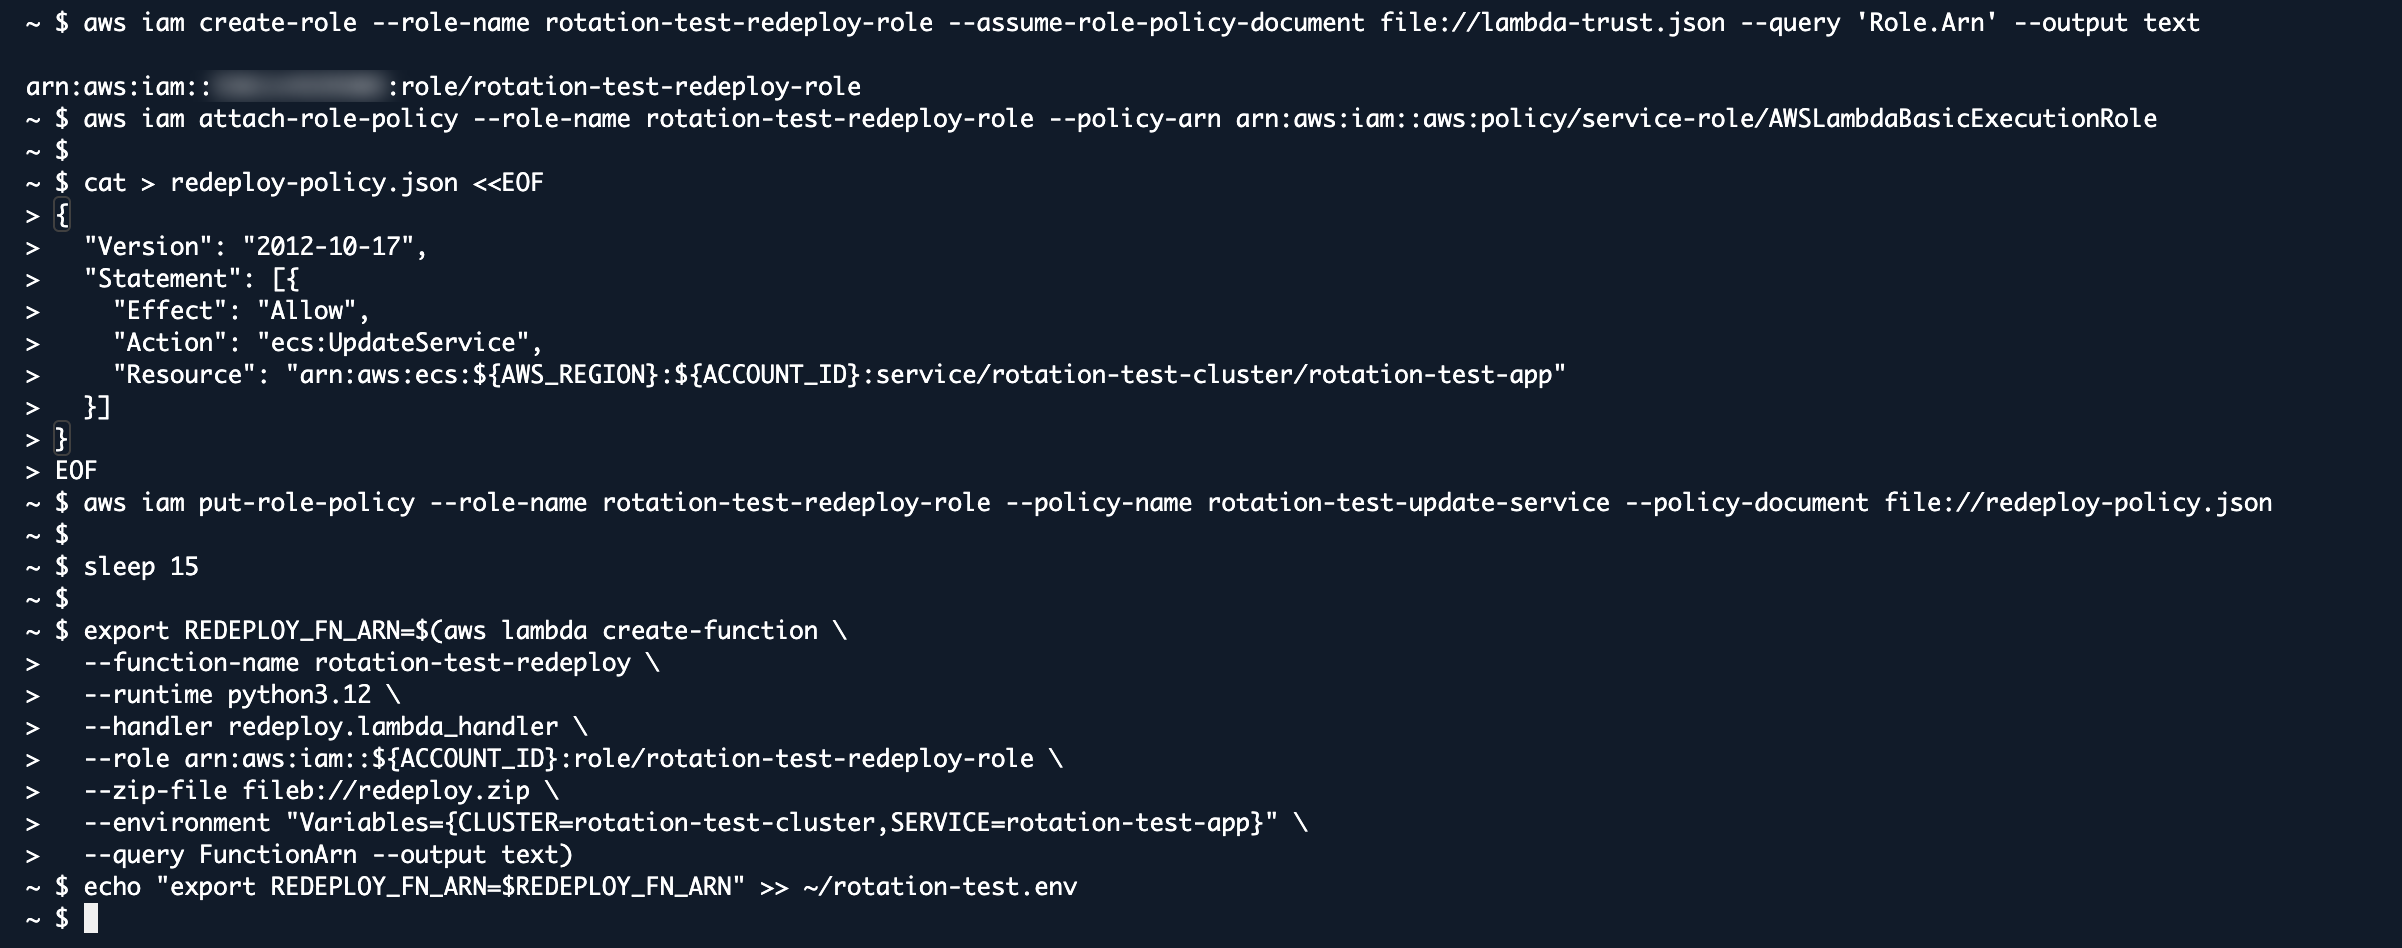
CloudShell で redeploy.py として保存し、Lambda 関数とロールを作ります。
ECS への権限は、対象のサービスに対する ecs:UpdateService だけにします。
zip redeploy.zip redeploy.py

cat > lambda-trust.json <<'EOF'
{
  "Version": "2012-10-17",
  "Statement": [{
    "Effect": "Allow",
    "Principal": {"Service": "lambda.amazonaws.com"},
    "Action": "sts:AssumeRole"
  }]
}
EOF
aws iam create-role --role-name rotation-test-redeploy-role --assume-role-policy-document file://lambda-trust.json --query 'Role.Arn' --output text
aws iam attach-role-policy --role-name rotation-test-redeploy-role --policy-arn arn:aws:iam::aws:policy/service-role/AWSLambdaBasicExecutionRole

cat > redeploy-policy.json <<EOF
{
  "Version": "2012-10-17",
  "Statement": [{
    "Effect": "Allow",
    "Action": "ecs:UpdateService",
    "Resource": "arn:aws:ecs:${AWS_REGION}:${ACCOUNT_ID}:service/rotation-test-cluster/rotation-test-app"
  }]
}
EOF
aws iam put-role-policy --role-name rotation-test-redeploy-role --policy-name rotation-test-update-service --policy-document file://redeploy-policy.json

sleep 15

export REDEPLOY_FN_ARN=$(aws lambda create-function \
  --function-name rotation-test-redeploy \
  --runtime python3.12 \
  --handler redeploy.lambda_handler \
  --role arn:aws:iam::${ACCOUNT_ID}:role/rotation-test-redeploy-role \
  --zip-file fileb://redeploy.zip \
  --environment "Variables={CLUSTER=rotation-test-cluster,SERVICE=rotation-test-app}" \
  --query FunctionArn --output text)
echo "export REDEPLOY_FN_ARN=$REDEPLOY_FN_ARN" >> ~/rotation-test.env
※sleep 15 は、作ったロールが Lambda から使えるようになるまでの待ち時間です。
実行画面
EventBridge ルールを作ります。
今回の2つのシークレットで、AWSCURRENT ラベルが新しいバージョンに移ったときだけ、Lambda 関数を呼び出します。
cat > pattern.json <<'EOF'
{
  "source": ["aws.secretsmanager"],
  "detail-type": ["Secret Label Updated"],
  "detail": {
    "name": ["rotation-test/app-single", "rotation-test/app-alt"],
    "labelUpdated": ["AWSCURRENT"]
  }
}
EOF
export RULE_ARN=$(aws events put-rule --name rotation-test-secret-updated --event-pattern file://pattern.json --query RuleArn --output text)
aws lambda add-permission \
  --function-name rotation-test-redeploy \
  --statement-id eventbridge \
  --action lambda:InvokeFunction \
  --principal events.amazonaws.com \
  --source-arn $RULE_ARN
aws events put-targets --rule rotation-test-secret-updated --targets "Id=redeploy,Arn=${REDEPLOY_FN_ARN}"
ルールを確認します。
aws events describe-rule --name rotation-test-secret-updated --query '{name: Name, state: State, pattern: EventPattern}'
aws events list-targets-by-rule --rule rotation-test-secret-updated --query 'Targets[].Arn'
2つのシークレットに対して、AWSCURRENT ラベルが新しいバージョンに移ったときのイベントを検知するルールが設定されています。
また、ルールのターゲットには、ECS のサービスを再デプロイするための Lambda 関数が設定されています。

準備4: 計測用のスクリプトを用意する
0.5秒ごとに ALB へリクエストを送り、時刻、アプリの応答、HTTP ステータスを1行ずつ記録するスクリプトです。
5秒で応答がなければ HTTP000 になります。
cat > measure.sh <<'EOF'
#!/bin/bash
trap 'exit 0' INT TERM
while true; do
  body=$(curl -s --max-time 5 -w ' HTTP%{http_code}' "http://${ALB_DNS}/")
  echo "$(date '+%H:%M:%S') ${body}"
  sleep 0.5
done
EOF
chmod +x measure.sh
これで準備は完了です!
検証1: シングルユーザー方式のローテーションで自動再デプロイする
CloudShell のタブを2つ使います。
1つ目のタブで計測を始めます。
./measure.sh | tee single.log
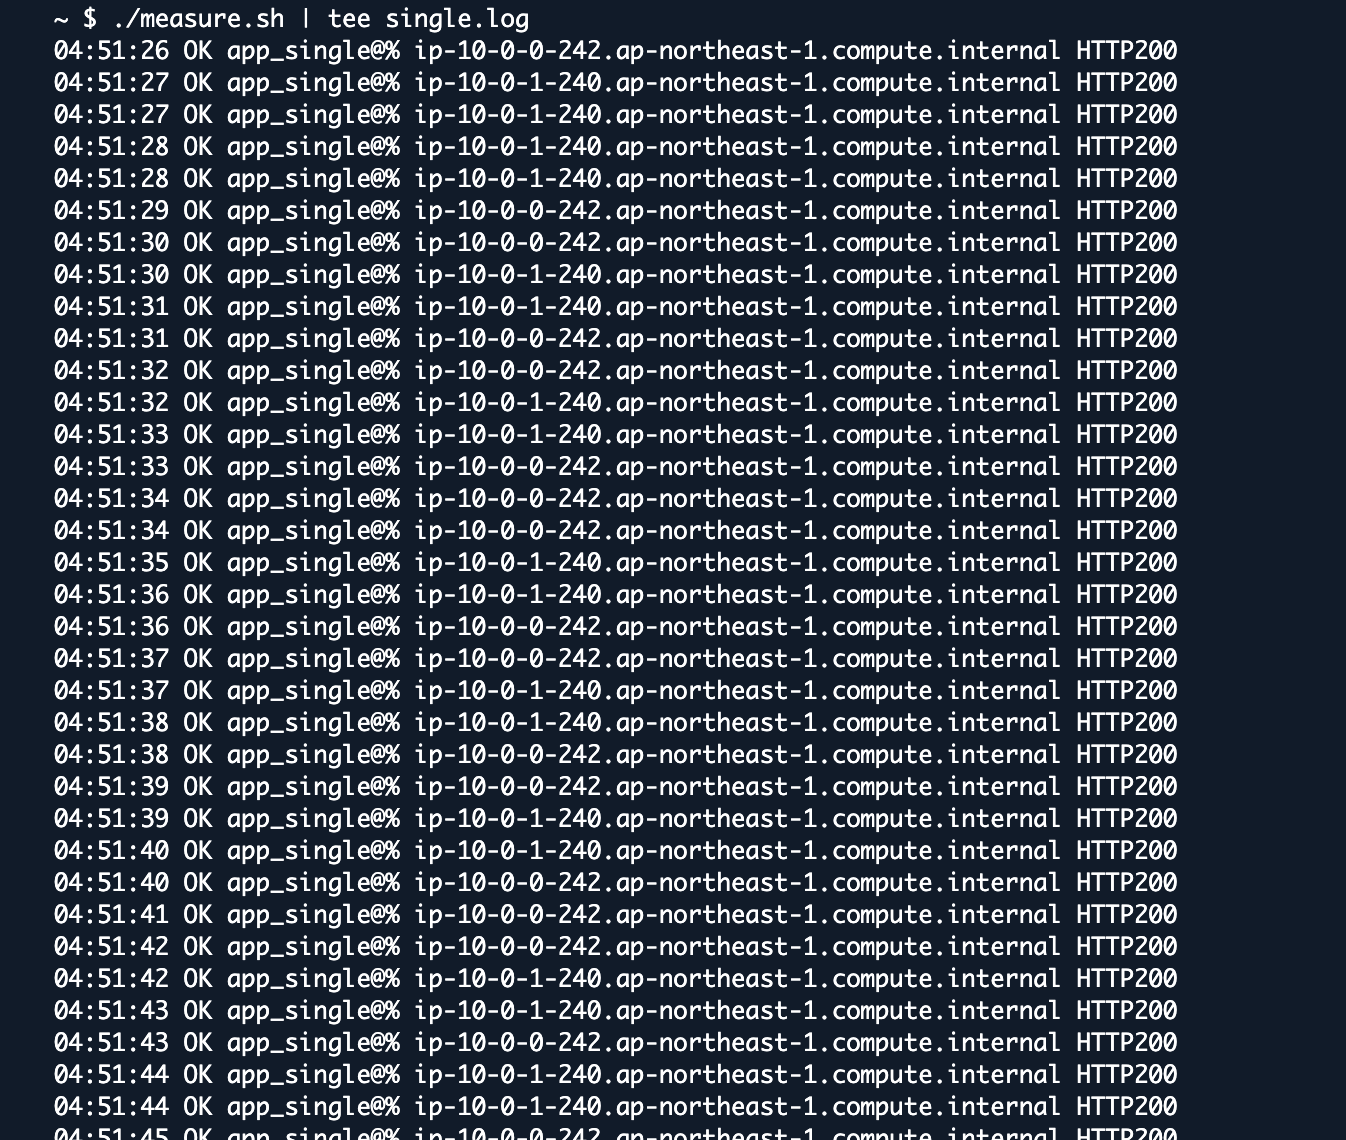
2つ目のタブでローテーションを実行します。
aws secretsmanager rotate-secret --secret-id rotation-test/app-single
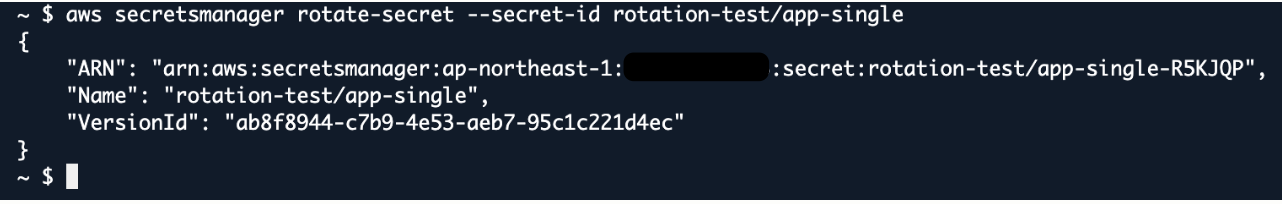
デプロイの状況は次のコマンドで確認できます。
aws ecs describe-services --cluster rotation-test-cluster --services rotation-test-app \
  --query 'services[0].deployments[].{status: status, rollout: rolloutState, running: runningCount, taskDefinition: taskDefinition}' --output table
PRIMARY と ACTIVE の2つのデプロイがあることが確認できました。
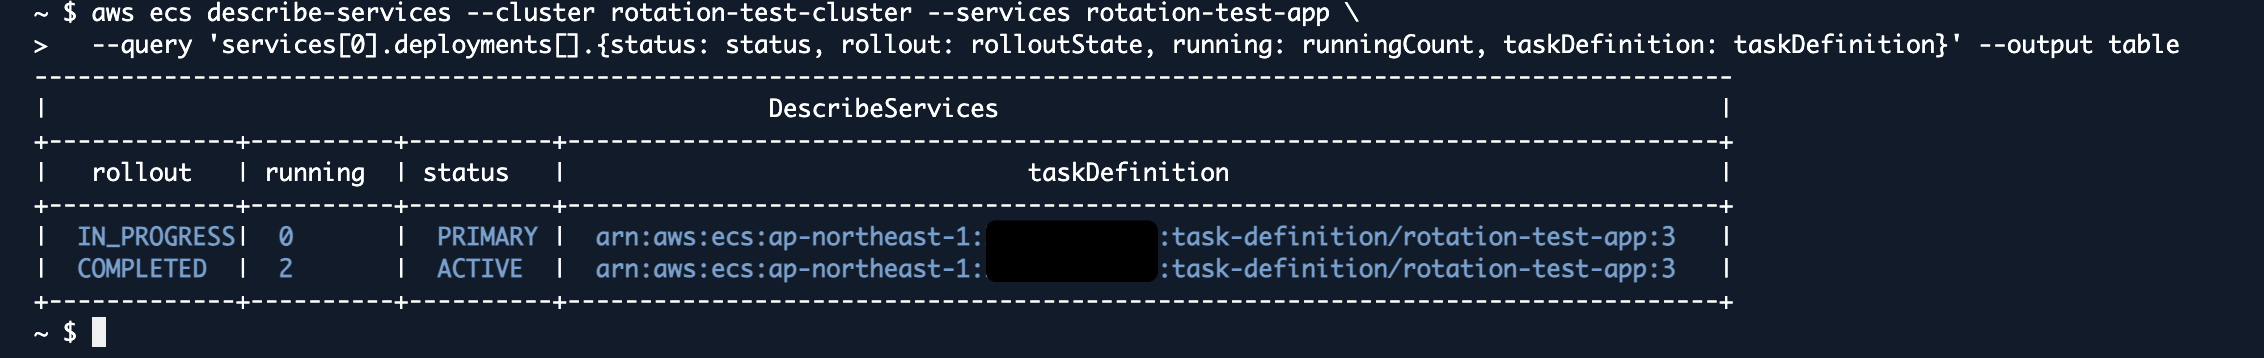
rollout が COMPLETED の PRIMARY だけになったら、デプロイ完了です。1つ目のタブで Ctrl+C を押下して、計測を止めます。

計測結果です。
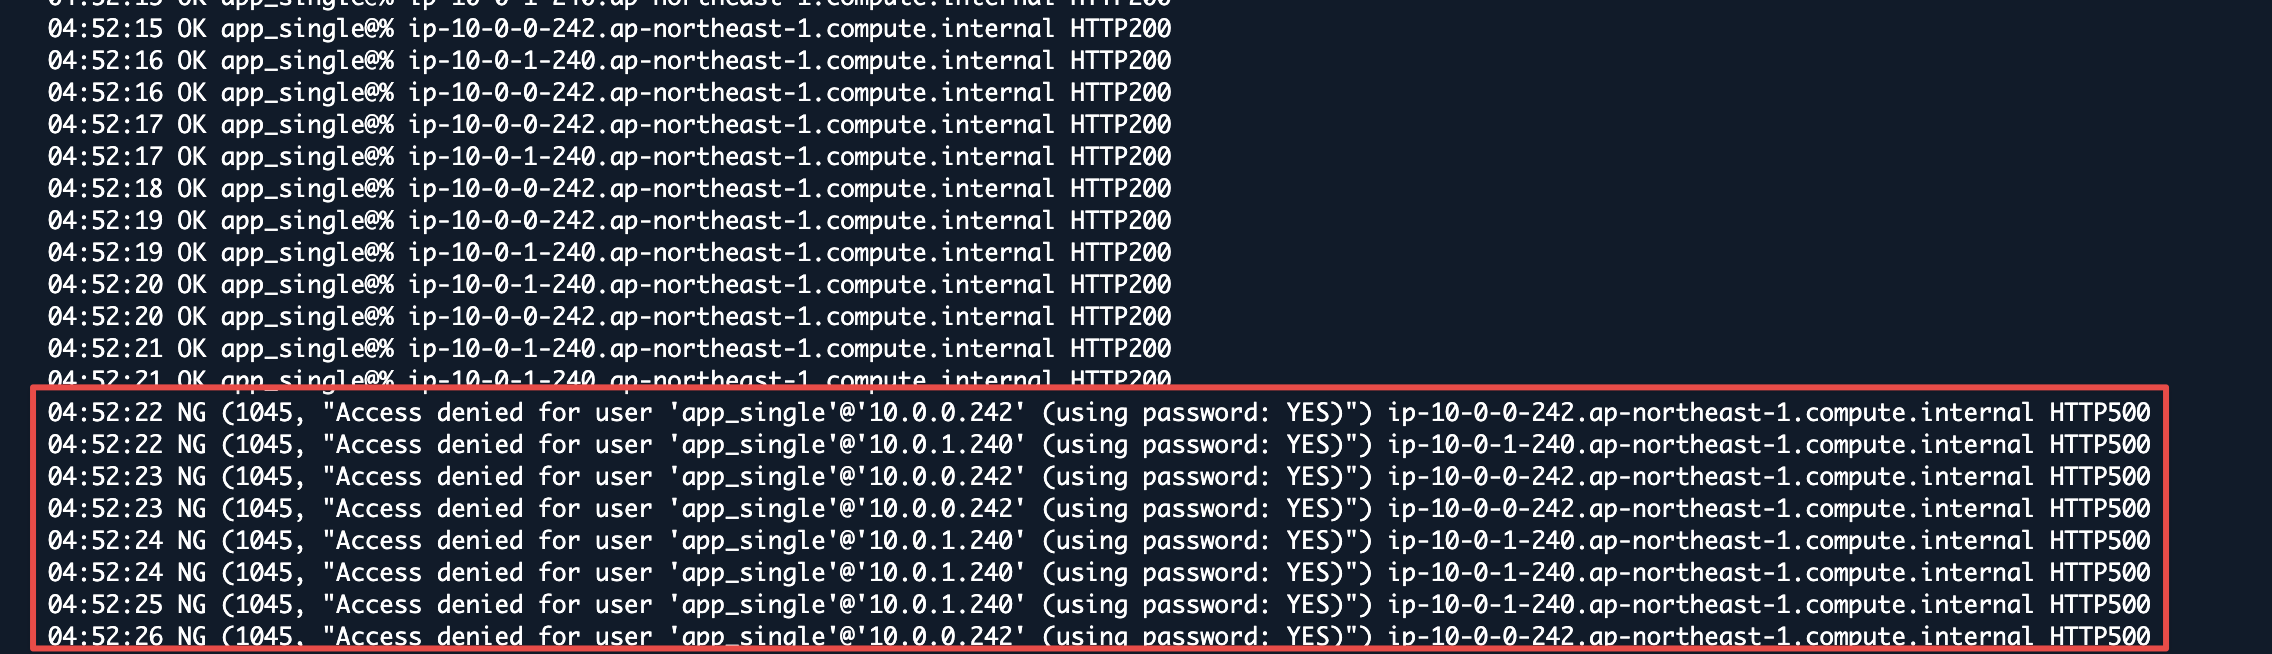
04:52:16 にローテーションを実行し、6秒後の 04:52:22 から、古いタスク2つへのリクエストがすべて次のエラーになりました。
NG (1045, "Access denied for user 'app_single'@'10.0.0.XXX' (using password: YES)")
新しいタスクが応答し始めたのは 04:53:57、最後のエラーは 04:54:55 でした。
HTTP ステータスごとの件数を数えます。
awk '{print $NF}' single.log | sort | uniq -c
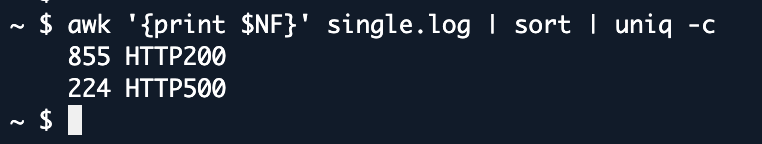
200 が855件、500 が224件でした。ALB が応答しない(HTTP000)ことはありませんでした。
ローテーション関数、再デプロイ用の Lambda 関数のログも確認します。
aws logs tail /aws/lambda/rotation-test-single-rotation --since 30m
aws logs tail /aws/lambda/rotation-test-redeploy --since 30m
まずローテーション関数のログを見ると、新しいパスワードを AWSPENDING として作り(createSecret)、DB のパスワードを変え(setSecret)、接続を確認し(testSecret)、AWSCURRENT を移していること(finishSecret)がわかります。
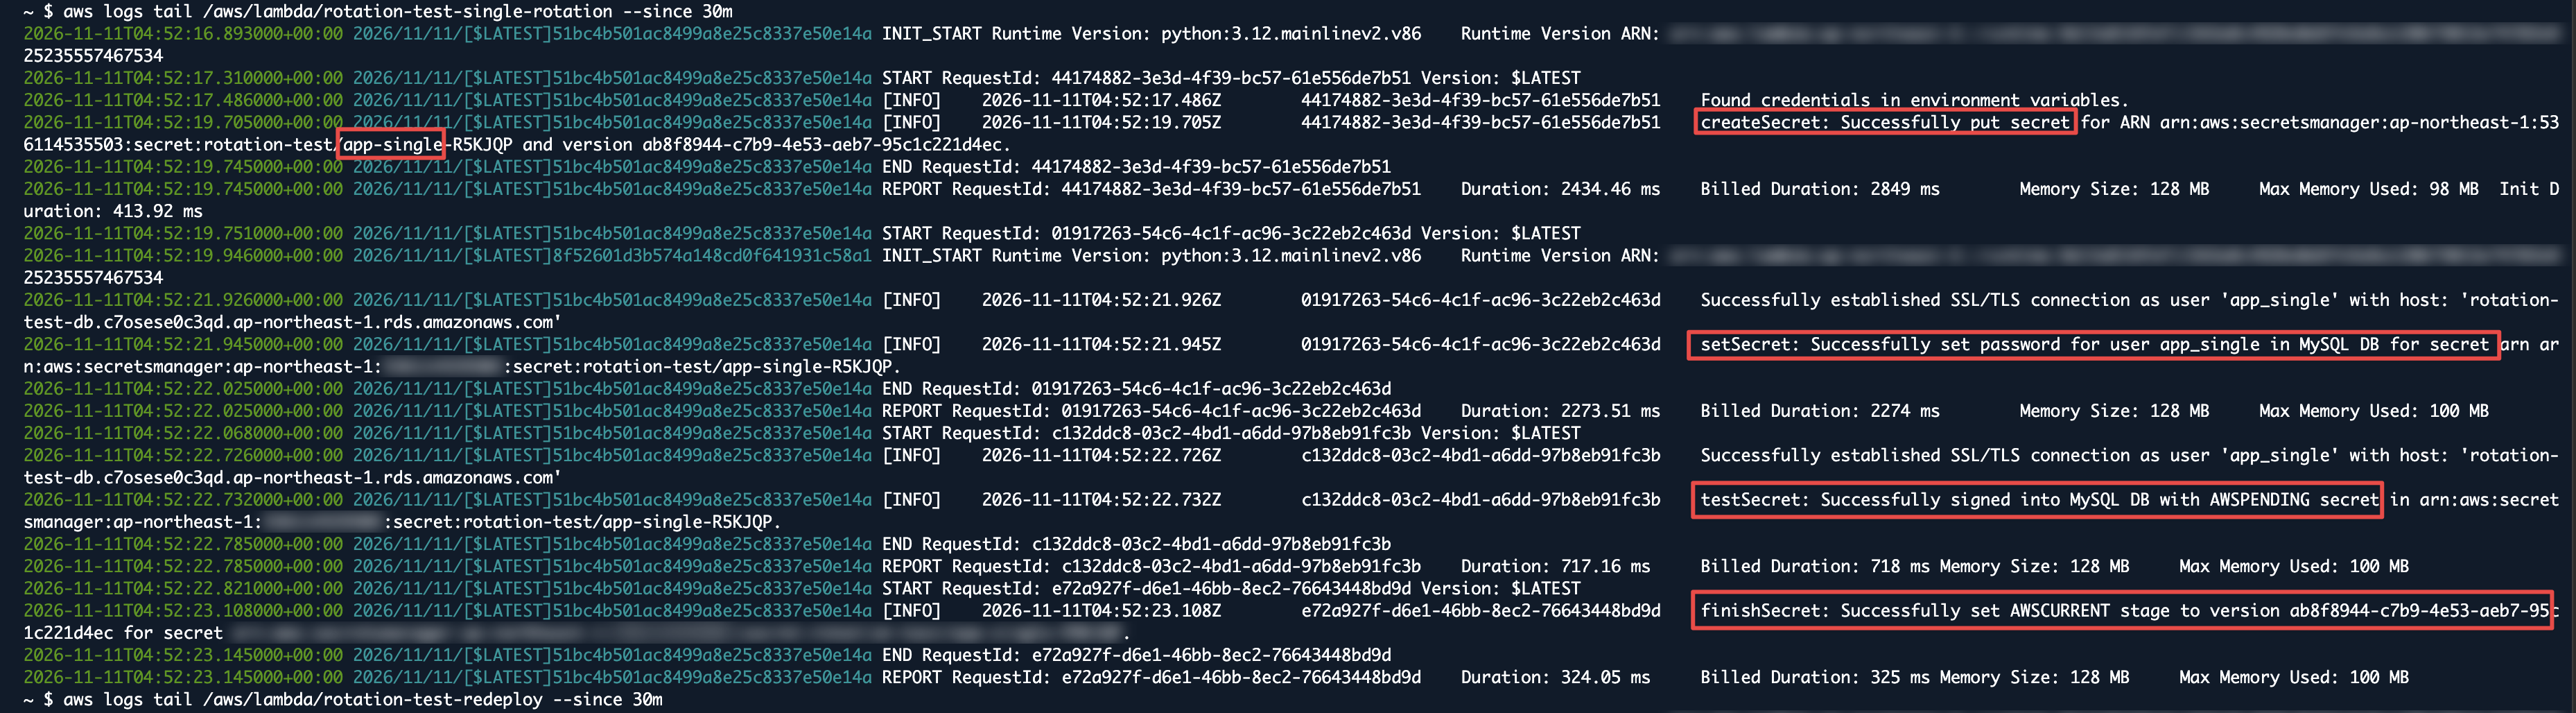
再デプロイ用の関数のログを見ると、EventBridge から Secret Label Updated イベントを受け取り、ECS のサービスを強制的に新しいデプロイで更新していることがわかります。detail.name が rotation-test/app-single になっていることも確認しました(画像ではマスクしています)。
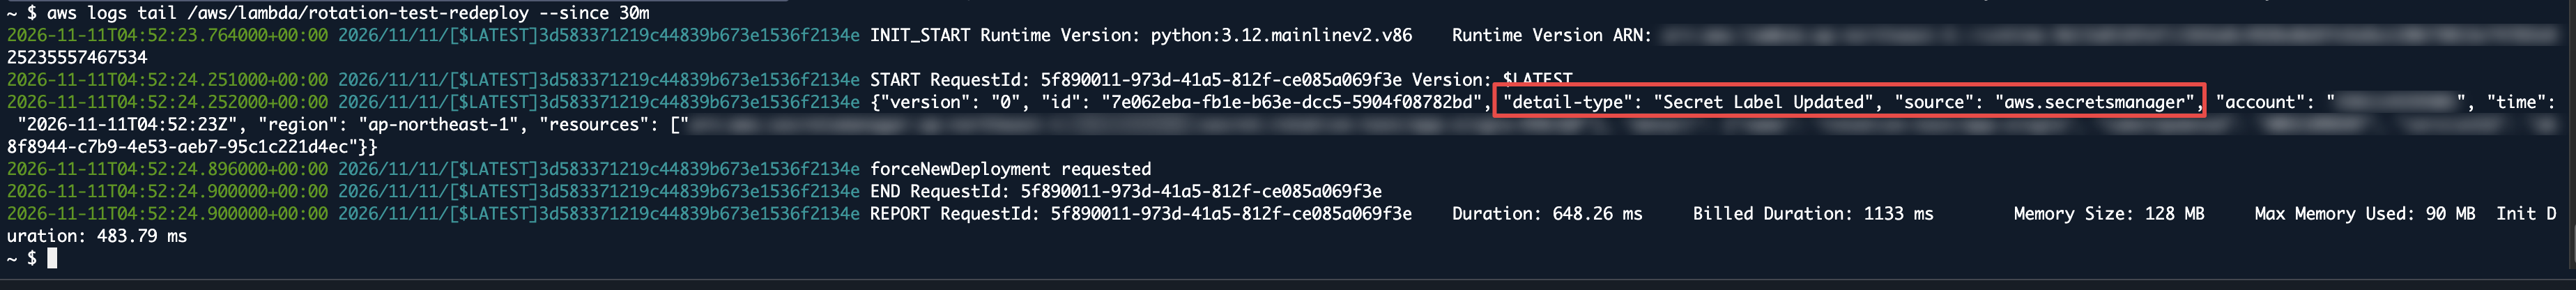
再デプロイ用の Lambda 関数が受け取ったイベントの detail は次のとおりです。
{
  "name": "rotation-test/app-single",
  "labelUpdated": "AWSCURRENT",
  "versionId": "ab8f8944-c7b9-4e53-aeb7-95c1c221d4ec"
}
時系列にまとめると、次のとおりです(時刻は UTC)。
| 時刻 | 出来事 |
|---|---|
| 04:52:16 | ローテーションを実行 |
| 04:52:21 | ローテーション関数が DB のパスワードを変更(setSecret) |
| 04:52:22 | 古いタスクへのリクエストが 500 になり始める |
| 04:52:23 | AWSCURRENT が新しいバージョンに移り、Secret Label Updated イベントが発生(finishSecret) |
| 04:52:24 | 再デプロイ用の Lambda 関数が、サービスを強制的に新しいデプロイで更新 |
| 04:52:42 | 新しいタスク1つ目が起動 |
| 04:53:23 | 新しいタスク1つ目が ALB に登録される |
| 04:53:24 | 新しいタスク2つ目が起動 |
| 04:53:54 | 新しいタスク2つ目が ALB に登録される |
| 04:53:57 | 新しいタスクが 200 を返し始める |
| 04:54:25 | 古いタスク1つ目が ALB から外れる |
| 04:54:55 | 古いタスク2つ目が ALB から外れる。最後の 500 |
| 04:55:48 | デプロイ完了 |
※ECS 側の時刻は、aws ecs describe-services の services[0].events で確認しました。
ECS は、新しいタスクの起動と古いタスクの停止を1つずつ進めていました。エラーは、古いタスク2つ目が ALB から外れる 04:54:55 まで続きました。
シングルユーザー方式では、ローテーション関数が DB のパスワードを変えた時点で、古いタスクが持っているパスワードは使えなくなります。
再デプロイが自動で始まっても、新しいタスクが起動してヘルスチェックに合格し、古いタスクが ALB から外れるまでの間は、古いタスクに振り分けられたリクエストが接続エラーになりました。
※Secrets Manager の FAQ では、ローテーションしても確立済みの DB 接続は再認証されないとしています。今回のアプリはリクエストのたびに新しく接続するので、パスワードの変更がすぐにエラーとして現れています。コネクションプールを使うアプリでは、エラーが出るのは新しい接続を作るときです。
検証2: 交代ユーザー方式のローテーションで自動再デプロイする
secrets の参照先を rotation-test/app-alt に差し替えたタスク定義を登録し、サービスを更新します。
make_taskdef "$ALT_SECRET_ARN"
aws ecs register-task-definition --cli-input-json file://taskdef-app.json --query 'taskDefinition.taskDefinitionArn' --output text
aws ecs update-service --cluster rotation-test-cluster --service rotation-test-app --task-definition rotation-test-app --query 'service.taskDefinition' --output text
aws ecs wait services-stable --cluster rotation-test-cluster --services rotation-test-app
curl -s http://$ALB_DNS/; echo
※make_taskdef は準備2で定義した関数です。新しいタブで実行するときは、source ~/rotation-test.env と export APP_B64=$(base64 -w0 app.py) を実行し、関数の定義も貼り直してください。
交代ユーザー方式用のユーザー名 app_alt が返っていることを確認しました。
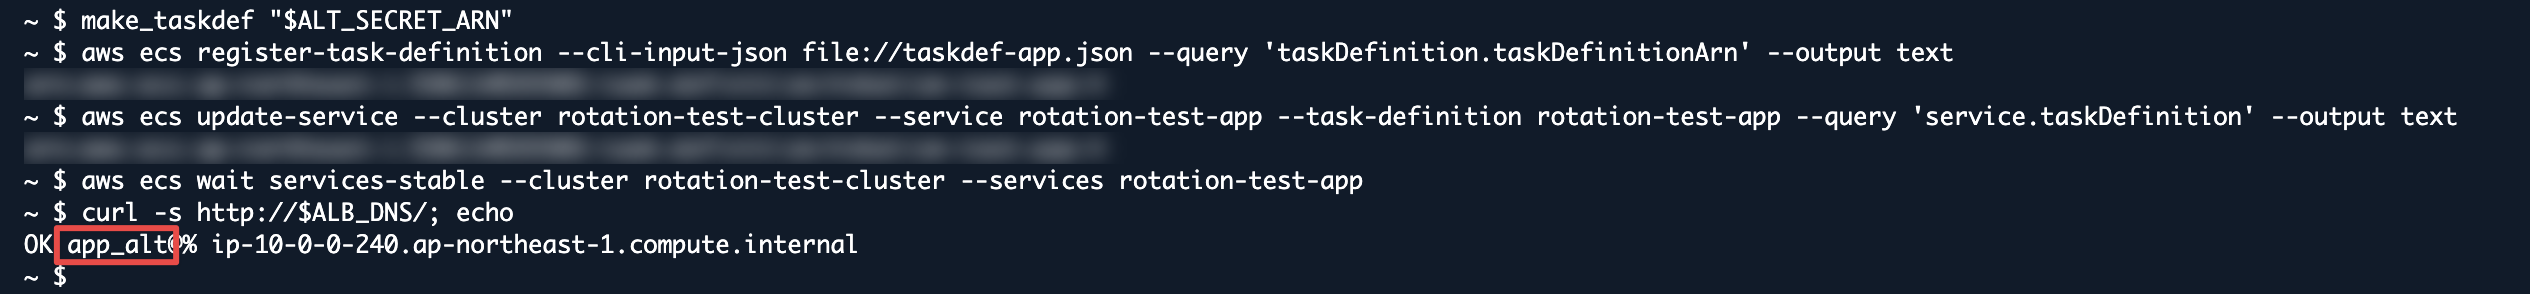
app_alt で接続できるようになりました。
検証1と同じく、1つ目のタブで計測を始めます。
./measure.sh | tee alt-1.log
2つ目のタブで、1回目のローテーションを実行します。
aws secretsmanager rotate-secret --secret-id rotation-test/app-alt
デプロイの状況は次のコマンドで確認できます。
aws ecs describe-services --cluster rotation-test-cluster --services rotation-test-app \
  --query 'services[0].deployments[].{status: status, rollout: rolloutState, running: runningCount, taskDefinition: taskDefinition}' --output table

デプロイが完了したら、計測を止めます。
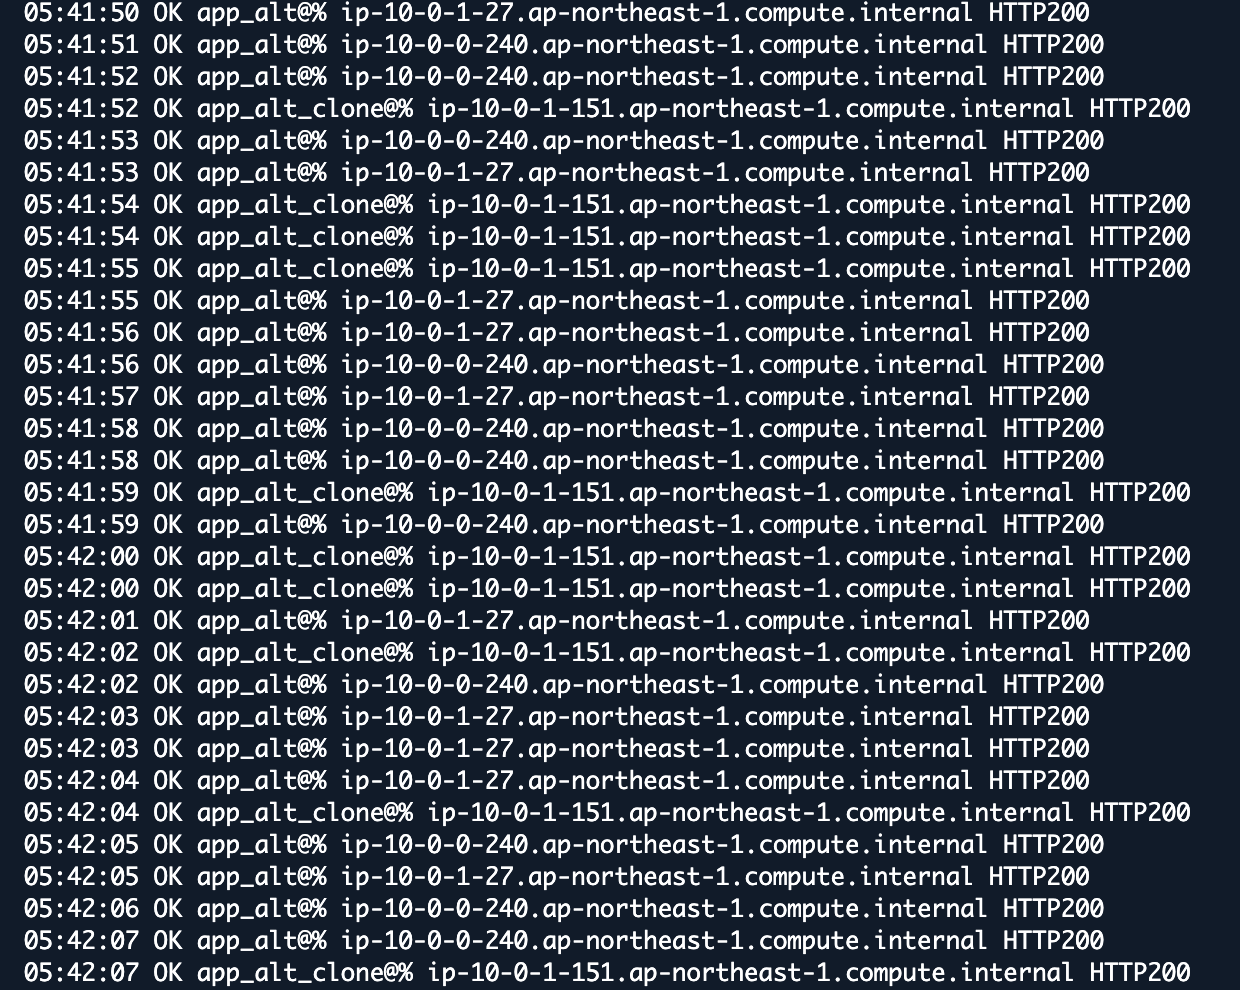
05:40:19 にローテーションを実行しました。05:41:52 に新しいタスクが app_alt_clone で応答し始め、05:42:32 まで古いタスクの app_alt の応答と混ざっていました。
時系列にまとめると、次のとおりです(時刻は UTC)。
| 時刻 | 出来事 |
|---|---|
| 05:40:19 | ローテーションを実行 |
| 05:40:23 | ローテーション関数が app_alt_clone を作成してパスワードを設定(setSecret) |
| 05:40:25 | AWSCURRENT が新しいバージョン(app_alt_clone)に移る(finishSecret) |
| 05:40:27 | 再デプロイ用の Lambda 関数が、サービスを強制的に新しいデプロイで更新 |
| 05:40:39 | 新しいタスク1つ目が起動 |
| 05:40:59 | 新しいタスク2つ目が起動 |
| 05:42:11 | 古いタスク1つ目が ALB から外れる |
| 05:42:31 | 古いタスク2つ目が ALB から外れる |
| 05:43:24 | デプロイ完了 |
※ローテーション関数と再デプロイ用の Lambda 関数の時刻は CloudWatch Logs、ECS 側の時刻は aws ecs describe-services の services[0].events で確認しました。
awk '{print $NF}' alt-1.log | sort | uniq -c
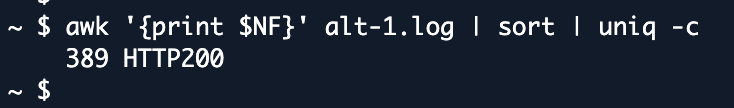
389件すべてが 200 でした(app_alt が229件、app_alt_clone が160件)。
1回目のローテーションで、ローテーション関数が app_alt を複製した app_alt_clone を作り、シークレットの AWSCURRENT が app_alt_clone に切り替わりました。
再デプロイ中は、古いタスクが app_alt、新しいタスクが app_alt_clone で接続していて、どちらも成功しています。
app_alt のパスワードは変わっていないので、古いタスクも接続できたままでした。
DB のユーザー一覧も確認します。
今回は ECS Exec を有効にしていないので、アプリのコンテナに入って SQL を実行できません。
代わりに、構築部分で CloudFormation から作成しておいたタスク定義 rotation-test-setup を使います。
mysql:8.0 のイメージで、RDS が管理するマスターユーザーとして DB に接続し、環境変数 SQL で渡した SQL を実行して終了するタスクです。
OVERRIDES=$(jq -n '{containerOverrides: [{name: "mysql", environment: [{name: "SQL", value: "SELECT user, host FROM mysql.user WHERE user LIKE '\''app%'\'';"}]}]}')

aws ecs run-task \
  --cluster rotation-test-cluster \
  --task-definition rotation-test-setup \
  --launch-type FARGATE \
  --network-configuration "awsvpcConfiguration={subnets=[${PUBLIC_SUBNET_1}],securityGroups=[${APP_SG}],assignPublicIp=ENABLED}" \
  --overrides "$OVERRIDES" \
  --query 'tasks[0].taskArn' --output text

# 1分ほど待ってから
aws logs tail /ecs/rotation-test --log-stream-name-prefix setup --since 5m
実行結果は CloudWatch Logs に出力されます。app_alt_clone が増えていました。

続いて、2回目のローテーションを実行します。
2回目は、app_alt のパスワードが変わり、AWSCURRENT が app_alt に戻るはずです。
./measure.sh | tee alt-2.log
aws secretsmanager rotate-secret --secret-id rotation-test/app-alt
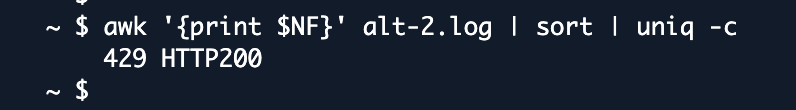
awk '{print $NF}' alt-2.log | sort | uniq -c
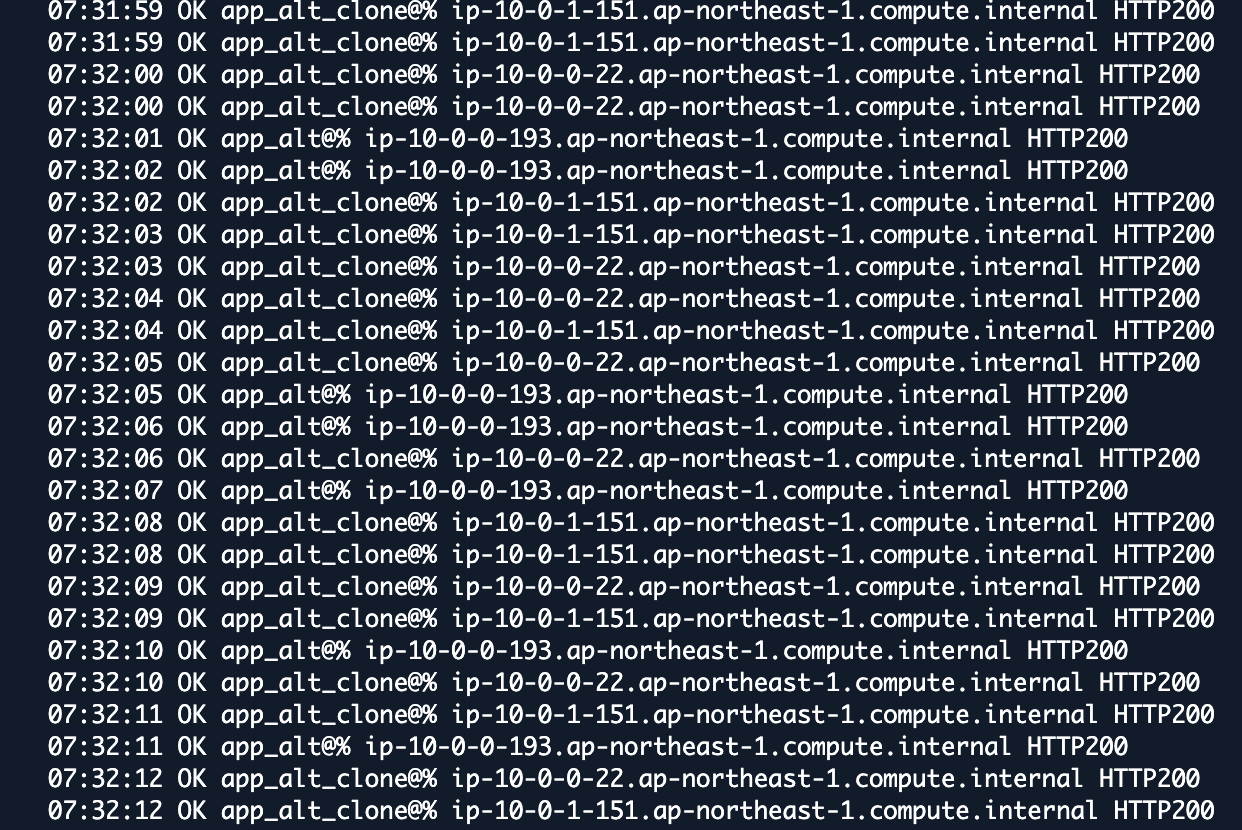
07:30:25 にローテーションを実行しました。07:32:01 に新しいタスクが app_alt で応答し始め、07:32:50 まで古いタスクの app_alt_clone の応答と混ざっていました。
時系列にまとめると、次のとおりです(時刻は UTC)。
| 時刻 | 出来事 |
|---|---|
| 07:30:25 | ローテーションを実行 |
| 07:30:32 | ローテーション関数が app_alt のパスワードを変更(setSecret) |
| 07:30:33 | AWSCURRENT が新しいバージョン(app_alt)に移る(finishSecret) |
| 07:30:35 | 再デプロイ用の Lambda 関数が、サービスを強制的に新しいデプロイで更新 |
| 07:30:47 | 新しいタスク1つ目が起動 |
| 07:31:28 | 新しいタスク2つ目が起動 |
| 07:32:18 | 古いタスク1つ目が ALB から外れる |
| 07:32:50 | 古いタスク2つ目が ALB から外れる |
| 07:33:52 | デプロイ完了 |
※1回目と同じく、ローテーション関数と再デプロイ用の Lambda 関数の時刻は CloudWatch Logs、ECS 側の時刻は aws ecs describe-services の services[0].events で確認しました。
429件すべてが 200 でした(app_alt が183件、app_alt_clone が246件)。
2回目も、古いタスク(app_alt_clone)と新しいタスク(app_alt)の両方が接続できていて、エラーは出ませんでした。
交代ユーザー方式で古い認証情報が使えるのは、次のローテーションまでです。
今回の構成で言えば、再デプロイが終わる前に次のローテーションが始まると、古いタスクのユーザーのパスワードが変わってしまいます。ローテーションの間隔は、デプロイにかかる時間より十分長くしておきましょう。
まとめ
今回は、Secrets Manager のローテーションをきっかけに ECS on Fargate のサービスを自動で再デプロイする構成を作り、シングルユーザー方式と交代ユーザー方式で、ローテーション中のリクエストがどうなるかを比べてみました。
シングルユーザー方式では、自動で再デプロイしても、古いタスクが入れ替わるまでの間に接続エラーが出ました。
交代ユーザー方式では、パスワードを変えなかったほうのユーザーで次のローテーションまで引き続き接続できるので、ローリングアップデートの間も古いタスクと新しいタスクの両方が DB に接続でき、エラーは0件でした。
交代ユーザー方式を使うときは、次の点に注意してください。
- ユーザーを複製するための管理者のシークレットが別に必要です。RDS が管理しているマスターユーザーのシークレットを使えます
- RDS が管理しているマスターユーザーのシークレットは、ドキュメントでは Lambda 関数を使わないマネージドローテーションと説明されています。今回はマスターユーザーのローテーションは試していませんが、アプリはマスターユーザーではなく、専用のユーザーで接続しておくと、今回の構成をそのまま使えます
環境変数で渡したままローテーションを始めたい方の参考になれば幸いです。
以上、コンサルティング部のみゃんでした!
参考リンク