Cloudflareがリリースした抽出モデルClairicを試してみた

こんばんは、情報システム室の夏目です。
先日、Cloudflareが新しいSystem Oneクラスの抽出モデルClairicをプレビュー版でリリースしました。
System OneクラスのモデルはJevやClefなどの意思決定モデルがありますが、今回リリースされたのはそれとは全く異なる抽出を行うための新しいモデルです。
今回はこれを試してみます。
Clairicとは
Clairicは入力された内容から、事前に定義したスキーマに従って抽出および推定と予測ができるモデルです。
CloudflareがSystem Oneモデルのコンセプトに触発されて、LLMでは効率が悪い他のタスクについて考えた結果、作られたモデルです。
Clairicでは以下のことができます。
- 抽出
- 入力内容に明示的に含まれている値を返します
- 計算したり推定したりするのではなく、既存の値を特定します
- 計算
- 入力内容に存在する値から別の値を算出します
- 結果は入力内に明示的に含まれている必要はありません
- 例えば、請求書の支払期日と指定した現在日時を使って何日延滞しているかを算出します
- 推定
- 入力内容には記載されていないものの根拠から推測する単一の値です
- 指定した上限下限の範囲内で、中央値と80%区間を伴う分布として返されます
- 予測
- 将来予想される複数の推定値です
- 指定したステップ毎に予測値と独自の80%区間が返されます
現状はプレビュー版でリリースされており、Workers AIで利用できるモデルの一つです。
近日中にはオープンウェイト版のモデルも公開する予定になっているようです。
リクエストの仕組み
Clairicでは入力内容として state (文字列) か images (最大4枚の画像) のどちらかか両方と、出力内容として辞書形式で型定義をした fields を渡します。
fields で定義する型定義では各フィールドの名前と型(type)、「そのフィールドに含めるべき内容」を自然言語で書いた instructions などを定義します。
JSON Schemaと同様の形式で書きますが、使用できる型は次のものです。
| 型 | 返ってくる値 | 備考 |
|---|---|---|
text |
読み取った文字列と、それが存在する範囲 | |
number |
読み取られた、もしくは算出された値 | integer や decimals で数値の形式を指定する |
date, time, datetime |
ISO形式の日付や時刻、もしくは日時 | |
duration |
選択した単位による時間の長さ | 単位は unit で指定する |
list |
入力順で一致するテキストや数値、および日付 | |
estimate |
下限上限の範囲内で推測した数値か日付 | min, max で範囲を定義する |
forecast |
一定間隔ごとの将来の数値か日付 | min, max で範囲を、 interval で間隔を、horizon で何個の値を推測させるかを定義する |
リクエストの形式とレスポンスの形式の完全な形は以下のURLで確認するすることができます。
ただ、JSON Schema形式で書かれていて、どういう型ならどういうフィールドが必要なのかは少々読み取りにくくなっていました。
- リクエスト
- レスポンス
使用例
イメージが湧きにくいとは思うのでリリースブログに書かれていた例も記載します。
例ではWorkersでWorkers AIにバインディングして使っていました。
抽出と計算
カスタマーサポートへのメールから抽出を行っています。
const { answers } = await env.AI.run("@cf/cloudflare/clairic", {
  state: "Hi, order A-88412 arrived on Sept 28, 2026 with a cracked screen and a dented corner. I paid $649.00 plus $52.10 tax. It's now Oct 9, 2026 and I'd like this fixed or refunded. Thanks, Dana",
  fields: {
    order_id:            { type: "text", instructions: "Order number" },
    delivered_on:        { type: "date", instructions: "Delivery date" },
    amount_paid:         { type: "number", decimals: 2, unit: "USD", instructions: "Total paid including tax" },
    days_since_delivery: { type: "duration", unit: "days", integer: true,
                           instructions: "Days from delivery to the date the customer wrote" },
    damage:              { type: "list", items: "text", instructions: "Each kind of damage described" },
    tracking_number:     { type: "text" },
  },
});
{
  "order_id": {
    "type": "text",
    "p_null": 3.4e-6,
    "span": [10, 17],
    "guess": "A-88412",
    "confidence": 0.999957,
    "value": "A-88412"
  },
  "delivered_on": {
    "type": "date",
    "p_null": 6.5e-8,
    "guess": "2026-09-28",
    "confidence": 0.999999,
    "value": "2026-09-28"
  },
  "amount_paid": {
    "type": "number",
    "p_null": 1.6e-5,
    "guess": 701.1,
    "confidence": 0.999944,
    "value": 701.1
  },
  "days_since_delivery": {
    "type": "duration",
    "p_null": 6.1e-9,
    "unit": "days",
    "guess": 11,
    "confidence": 0.999999,
    "value": 11
  },
  "damage": {
    "type": "list",
    "value": ["cracked screen", "dented corner"],
    "spans": [[50, 64], [71, 84]]
  },
  "tracking_number": {
    "type": "text",
    "p_null": 1,
    "span": [106, 112],
    "guess": "$52.10",
    "confidence": 0.416016,
    "value": null
  }
}
カスタマーサポートへのメールから注文IDや到着日時、支払金額などを 抽出/計算 しています。
テキストの抽出では value で値と span でどこに記載されていたかを返しています。
また、tracking_number はメールに含まれていないため、妥当そうな推測値ではなくnullが返っています (guess はモデルが選択したであろう推測値です)。
推定
入力に記載されていないが、その根拠が入力に含まれている値を得るために推定を使用します。
ブログにあった例では過去の住宅価格や類似物件の成約事例を元に推定を行っていました。
const { answers } = await env.AI.run("@cf/cloudflare/clairic", {
  state: `Comparable sales:
sqft,beds,year_built,neighborhood,sale_price
1450,3,1998,Elm Park,412000
2100,4,2006,Elm Park,585000
980,2,1975,Riverside,265000
1600,3,2003,Elm Park,449000
1300,3,1990,Riverside,318000

Subject property:
sqft,beds,year_built,neighborhood
1620,3,2001,Elm Park`,
  fields: {
    sale_price:     { type: "estimate", unit: "USD", min: 50000, max: 5000000, scale: "log", step: 1000 }
});
{
  "sale_price": {
    "median": 415000,
    "p_above": 0.0,
    "p_below": 0.0,
    "p10": 370000,
    "p90": 470000,
    "type": "estimate",
    "value": 418000
  }
}
指定した範囲の中で推定値を返しています。
下限上限値と値の単位(step が1000なので求める値は1000単位)を指定し、 scale: "log" として対数スケールで推定値を求めています。
レスポンスでは、推定値(value)と中央値(median)、10%と90%のパーセンタイルで80%区間が見えるようになっています。
予測
時系列データの値を予測します。
例では公開データセットを使用して、米国の空港検問所で検査する人数を予測しています。
具体的には21日間連続で、それまでのデータから、翌日の人数を予測しています。
(例として記載されたコードは21日を一気に出力させずに1日だけ予測させていました)
const { answers } = await env.AI.run("@cf/cloudflare/clairic", {
  state: `Daily number of people screened at TSA checkpoints at US airports.
date,weekday,travelers
2026-07-16,Thu,2850229
...
2026-10-13,Tue,2353356
Forecast date: 2026-10-14 (Wed)`,
  fields: {
    travelers: { type: "forecast", horizon: 1, interval: "day",
                 min: 500000, max: 4000000, scale: "log",
                 instructions: "Number of people screened tomorrow" },
  },
});
{
  "travelers": {
    "median": [2419283],
    "p10": [2270774],
    "p90": [2556769],
    "type": "forecast",
    "value": [2416117]
  }
}
レスポンスの形式は推定と非常に似たものになっていて、値が配列に入っているというものです。
今回は horizon: 1 だったので1件しか値がないですが、 horizon の値が増えるとこの配列に要素が増えていくと予想できます。
ちなみに、この予測については平均で3.3%の誤差だったそうです。
21日中17日が80%区間内に収まっていたとも記載されていました。
予測の精度は悪くなさそうです。
使ってみる
自分でも使ってみます。
今回は、 eMudhra中間CAの侵害 というページからNode.jsやPythonなどで対応が必要なものは何なのかを抽出してみます。
ちょっと定義が雑な気もしますが、試してみます。
コード
Workers AIのAPIをPythonから叩いてみます。
import json
import os
import sys

import requests

account_id = os.environ["ACCOUNT_ID"]
token = os.environ["API_TOKEN"]

# 上記URLのWebサイトをローカルに保存したテキスト
with open("e_mudhra.html") as f:
    text = f.read()

resp = requests.post(
    f"https://api.cloudflare.com/client/v4/accounts/{account_id}/ai/run/@cf/cloudflare/clairic",
    headers={"Authorization": f"Bearer {token}"},
    json={
        "model": "clairic",
        "state": text,
        "fields": {
            "node": {
                "type": "text",
                "instructions": "Node.jsで対応が必要なもの",
            },
            "python": {"type": "text", "instructions": "Pythonで対応が必要なもの"},
            "rust": {"type": "text", "instructions": "Rustで対応が必要なもの"},
        },
    },
)

print(resp.status_code)
data = resp.json()

with open(f"{sys.argv[0]}.json", "w") as f:
    json.dump(data, f, indent=2, ensure_ascii=False)
シンプルに文字列を抽出してます。
また、何が欲しいかについては日本語で書いてみました。
結果
{
  "result": {
    "model": "clairic",
    "answers": {
      "node": {
        "type": "text",
        "p_null": 0.0009888502536341548,
        "span": [
          11210,
          11217
        ],
        "guess": "22.23.4",
        "confidence": 0.9635940194129944,
        "value": "22.23.4"
      },
      "python": {
        "type": "text",
        "p_null": 0.004473418463021517,
        "span": [
          11403,
          11410
        ],
        "guess": "certifi",
        "confidence": 0.5628417730331421,
        "value": "certifi"
      },
      "rust": {
        "type": "text",
        "p_null": 0.0015650950372219086,
        "span": [
          11984,
          12021
        ],
        "guess": "Rust webpki-roots / webpki-root-certs",
        "confidence": 0.49232515692710876,
        "value": "Rust webpki-roots / webpki-root-certs"
      }
    },
    "truncated": false,
    "usage": {
      "state_tokens": 8298,
      "image_tokens": 0,
      "schema_tokens": 362,
      "input_tokens": 25256,
      "output_tokens": 0,
      "passes": 3
    }
  },
  "success": true,
  "errors": [],
  "messages": []
}
抽出できました。
実際の内容と比較してみる
では実際のウェブページの内容と比較してみます。
Node.js
抽出した値は次のようになっていました。
{
  "confidence": 0.9635940194129944,
  "guess": "22.23.4",
  "p_null": 0.0009888502536341548,
  "span": [11210, 11217],
  "type": "text",
  "value": "22.23.4"
}
ウェブページは次のように記載されています。

Node.jsでは 22.23.4, 24.22.1, 26.12.1 というのがあるので最初の一つしか拾えませんでした。
Python
{
  "confidence": 0.5628417730331421,
  "guess": "certifi",
  "p_null": 0.004473418463021517,
  "span": [11403, 11410],
  "type": "text",
  "value": "certifi"
}
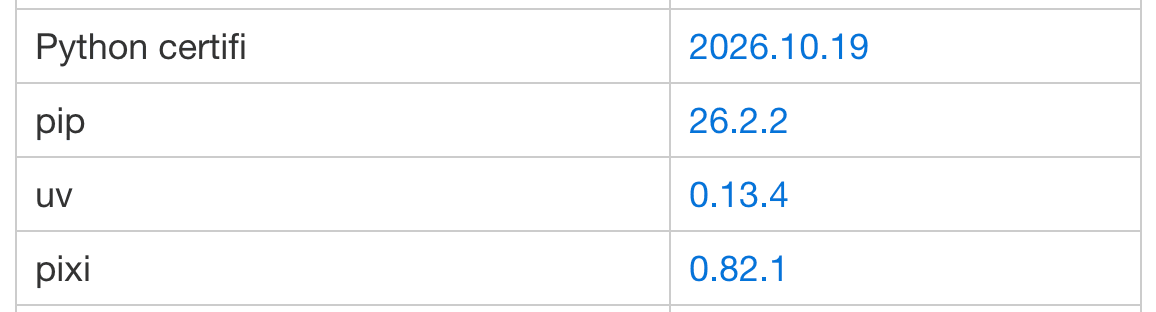
レスポンスでは certifi のみ抽出という結果になりました。
これはPythonで質問したため、Pythonという記述のあったものだけを回答したように思います。
Rust
{
  "confidence": 0.49232515692710876,
  "guess": "Rust webpki-roots / webpki-root-certs",
  "p_null": 0.0015650950372219086,
  "span": [
    11984,
    12021
  ],
  "type": "text",
  "value": "Rust webpki-roots / webpki-root-certs"
}
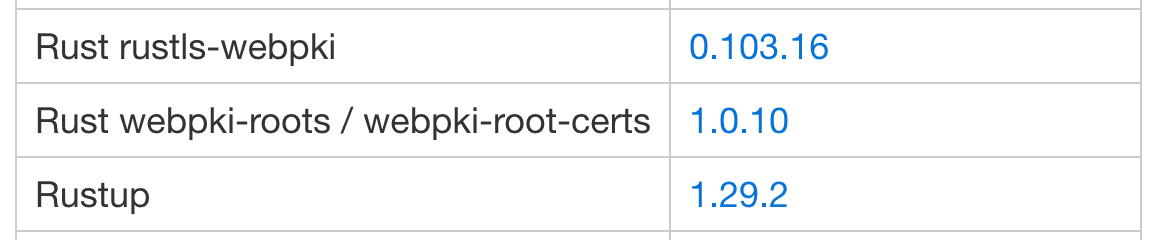
Rust webpki-roots / webpki-root-certs と抽出していますが、PythonのときにはPythonという文字列は含まれていなかったので少々不思議に思います。
所感
自分の質問の仕方が雑だった部分が非常に大きそうだと思いました。
それでも近いものは抽出しているので精度は悪くないと考えます。
ある程度決まった形式のものでより具体的に質問すれば、精度良く抽出できそうな気がします。
まとめ
Cloudflareがリリースした抽出モデルClairicを試してみました。
質問の仕方や渡すデータなどに注意すれば非常に便利に使えそうだと思います。
何かのお役に立てたら幸いです。