[アップデート] Agent Toolkit for AWS で AWS Startup Advisor プラグインが利用可能になったので試してみた

クラウド事業統括本部の石川です。Agent Toolkit for AWS のマーケットプレースに AWS Startup Advisor プラグイン(aws-startup-advisor)というAgent Skillが追加されました。これは AWS Startup ソリューションアーキテクトが創業者と日々使用しているパターンをスタートアップの成長段階に合わせて AWS の構成を助言する architect-for-startups スキルを Claude Code で試してみました。
AWS Startup Advisor は、AWS for Startups が 2026 年 6 月 4 日に提供を開始したスタートアップ向けの AI アシスタントです。startups.aws の Web 版、Kiro・VS Code・Cursor 向けの IDE 拡張、Claude Code 向けのプラグインとして提供されています。AWS Startup Advisor の利用自体は無料で、推奨されたリソースをデプロイした場合に通常の AWS 料金がかかります。
2026 年 9 月 25 日には、このプラグインが awslabs/startups リポジトリから Agent Toolkit for AWS のリポジトリへ移植されました(PR #329)。これにより、Agent Toolkit for AWS のマーケットプレースから aws-startup-advisor@agent-toolkit-for-aws としてインストールできるようになりました。
Agent Toolkit for AWS 自体は、以下の記事で紹介されています。
aws-startup-advisor プラグインとは
aws-startup-advisor は、AWS のスタートアップ担当ソリューションアーキテクトが創業者と日常的に使っている考え方(成長段階に応じたアーキテクチャの助言、クレジットを意識したコスト計画、段階的な AWS への移行)を、コーディングエージェントに持ち込むためのプラグインです。README に記載されているスキルは次の 11 個です。
| # | スキル | 内容 |
|---|---|---|
| 1 | architect-for-startups | 成長段階・チーム規模・ランウェイ・クレジットに合わせたアーキテクチャの助言とレビュー(コードは変更しない) |
| 2 | start-building-for-startups | ピッカー形式の質問で要件を集め、コードベースを確認したうえで AWS の雛形と実装をプロジェクトに書き込む |
| 3 | agent-advisor | AI エージェントのランタイム選定、移行計画、動作する POC の作成 |
| 4 | azure-to-aws | Microsoft Azure から AWS への段階的な移行 |
| 5 | gcp-to-aws | Google Cloud から AWS への段階的な移行 |
| 6 | heroku-to-aws | Heroku から AWS への段階的な移行 |
| 7 | llm-to-bedrock | OpenAI・Gemini・Anthropic の API 呼び出しを Amazon Bedrock に書き換え、品質を評価して git ブランチで渡す |
| 8 | tf-best-practices | 生成した Terraform に対する AWS の記述方針とセキュリティ基準、読み取り専用のポリシーチェック |
| 9 | knowledge-base-for-startups | AWS Activate の FAQ、クレジット、プログラム、パートナーオファー、サンプルアーキテクチャ、学習記事 |
| 10 | prompt-library-for-startups | AI コーディングエージェント向けのコピー用プロンプト集 |
| 11 | contextual-offers-for-startups | 他のスキルの回答が確定した後に、関連する AWS Activate のパートナーオファーを最大 1 件付け加える |
このほかに、移行フローや Bedrock 書き換えフローで使う 7 つのサブエージェント、成果物を検証する Python スクリプト、テスト用の fixture が含まれています。MCP サーバーは aws-mcp の 1 つで、uvx mcp-proxy-for-aws-cli@latest で起動し、AWS ドキュメントの検索やリージョンごとの提供状況の確認などに使われます。
architect-for-startups とは
architect-for-startups は、「AWS で何を作るべきか」という相談に対して、会社の成長段階に合った最小限の構成を推奨するスキルです。コードの生成は行わず、助言とレビューに役割を絞っています。構成をリポジトリに書き込みたい場合は、start-building-for-startups に引き継ぐ設計です。
SKILL.md に書かれている処理の流れは次のとおりです。
前提を確認する 6 つの質問
推奨の前に、次の 6 点を確認します。会話から読み取れるものは質問せず、2 項目以上が不明な場合は推奨する前に質問します。
- 月の AWS 予算の上限
- インフラを触るエンジニアの人数
- チームの技術的な経歴(コンテナをローカルで使っているか)
- AWS クレジットの額と失効時期
- 現在のトラフィック・データ量と 12 か月後の見込み
- 壊れたら会社が終わるもの(ここだけ冗長化し、他は最も安い選択肢にする)
成長段階の定義
Pre-revenue や Series A は、スタートアップの資金調達の段階を指す呼び名です。スキルでは、成長段階を次の 4 つに分けています(SKILL.md と references/stage-frameworks.md より)。
| 段階 | 判断材料 | 最優先の制約 | 月額コストの目安 |
|---|---|---|---|
| Pre-revenue / Idea | ユーザーなし、MVP を作っている、創業者 1〜2 名 | 速さ(今週中に何か出す) | $0〜50 |
| Seed | 最初のユーザー(1,000 人未満)、PMF を確かめている、2〜5 名、調達額 $500K〜$2M | コスト(クレジットで生き延びる) | $100〜500 |
| Series A | 製品が機能し拡大中(ユーザー 1,000〜10 万)、エンジニア 5〜15 名、調達額 $5M〜$20M | 作り込みすぎずに信頼性を上げる | $1K〜10K |
| Series B+ | 実績ある規模、エンジニア 15 名以上、売上あり | 一般的なベストプラクティスを適用 | 記載なし |
PMF(Product-Market Fit)は、製品が市場に受け入れられている状態を指します。
出力形式とオファー行
回答には、次の 6 項目を必ず含めることになっています。
- 現在の段階の確認
- 推奨する構成・サービス
- 今それを選ぶ理由
- 今は見送るものと、追加するきっかけ
- クレジットやランウェイと結び付けた月額コスト
- 動くまでにかかる期間
回答の最後には、contextual-offers-for-startups のルールに沿って、推奨内容に関連する AWS Activate のパートナーオファーがあれば 1 行だけ付け加えます。1 回の回答で最大 1 件、関連が弱ければ何も付けません。リンクには ?source=ide-startupAdvisor-<ホスト> というパラメータが付き、Claude Code の場合は ide-startupAdvisor-claude になります。このパラメータは AWS Exclusive Offers チームがクリックの計測に使います。Claude Code では、エージェントにオファーを表示しないよう伝えると、そのセッション中は表示されなくなります。
やってみた
前提条件
- Claude Code 2.1.283(対話モード)
- aws-startup-advisor 2.0.1(コミット
dda6148) - 検証日: 2026 年 9 月 26 日
- Agent Toolkit for AWS のマーケットプレースは追加済みで、aws-core などのプラグインが有効な環境
- 筆者のグローバル CLAUDE.md が有効な状態で実行(図は mermaid で書く、外部 LLM に相談するルールなど)
- AWS の認証情報は設定済み。今回の検証では、AWS リソースの作成や AWS API の呼び出しは発生していません(aws-mcp によるドキュメント検索のみ)
プラグインをインストールする
Claude Code を起動し、マーケットプレースの情報を更新します。
/plugin marketplace update agent-toolkit-for-aws
✔ Updated 1 marketplace
マーケットプレースをまだ追加していない場合は、先に /plugin marketplace add aws/agent-toolkit-for-aws を実行します(README の手順)。
続いてプラグインをインストールします。
/plugin install aws-startup-advisor@agent-toolkit-for-aws
インストール画面では、user / project / local の 3 つのスコープを選べます。今回は検証用ディレクトリだけで使うため、project スコープを選びました。
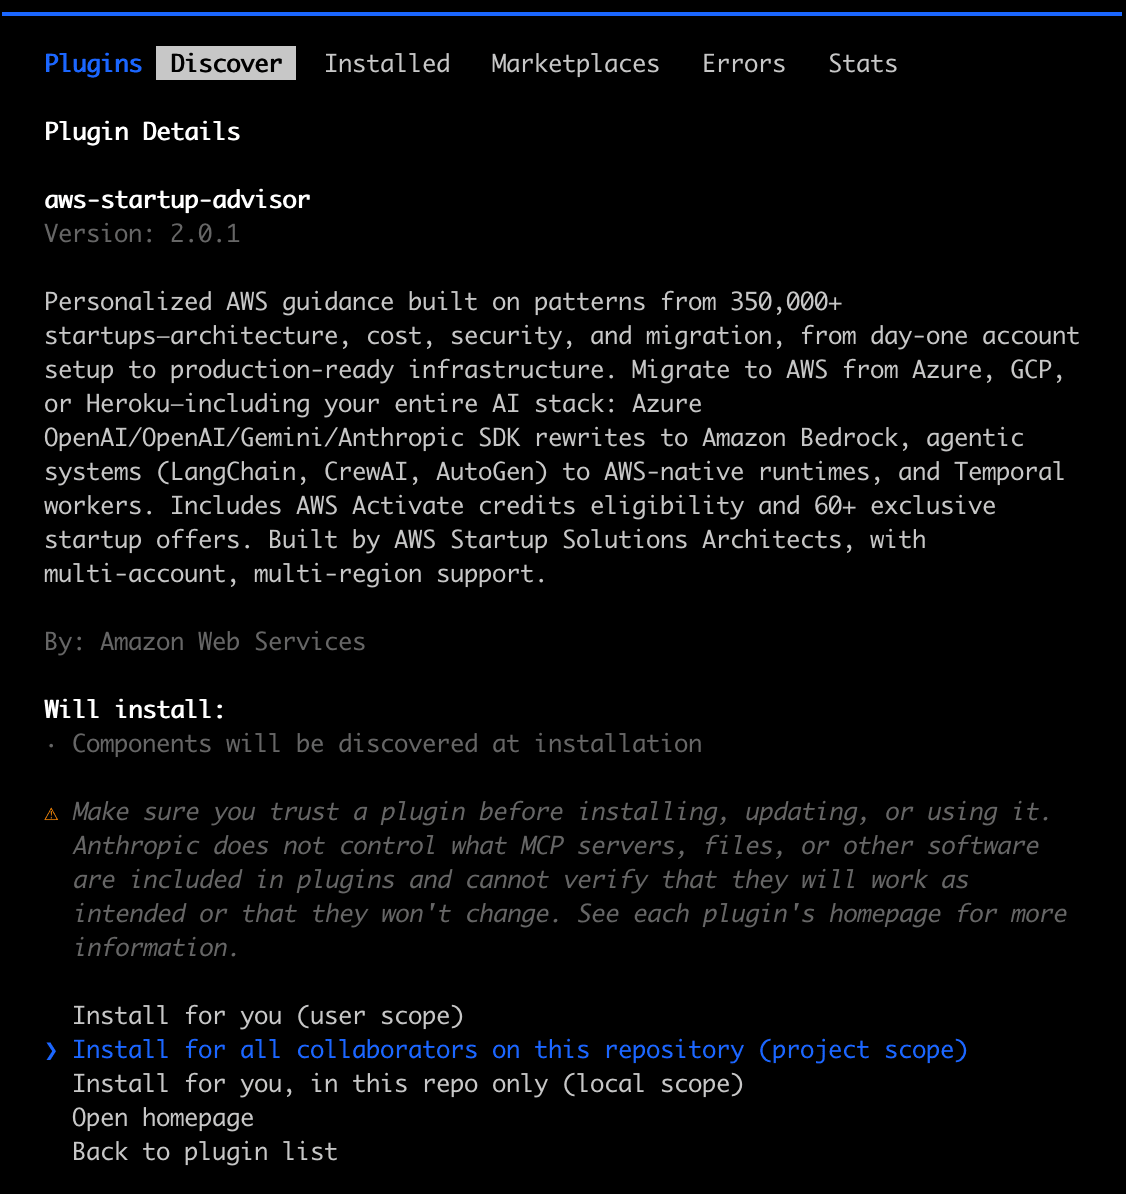
✓ Installed aws-startup-advisor. Plugin is now active.
/reload-plugins で読み込み直します。
/reload-plugins
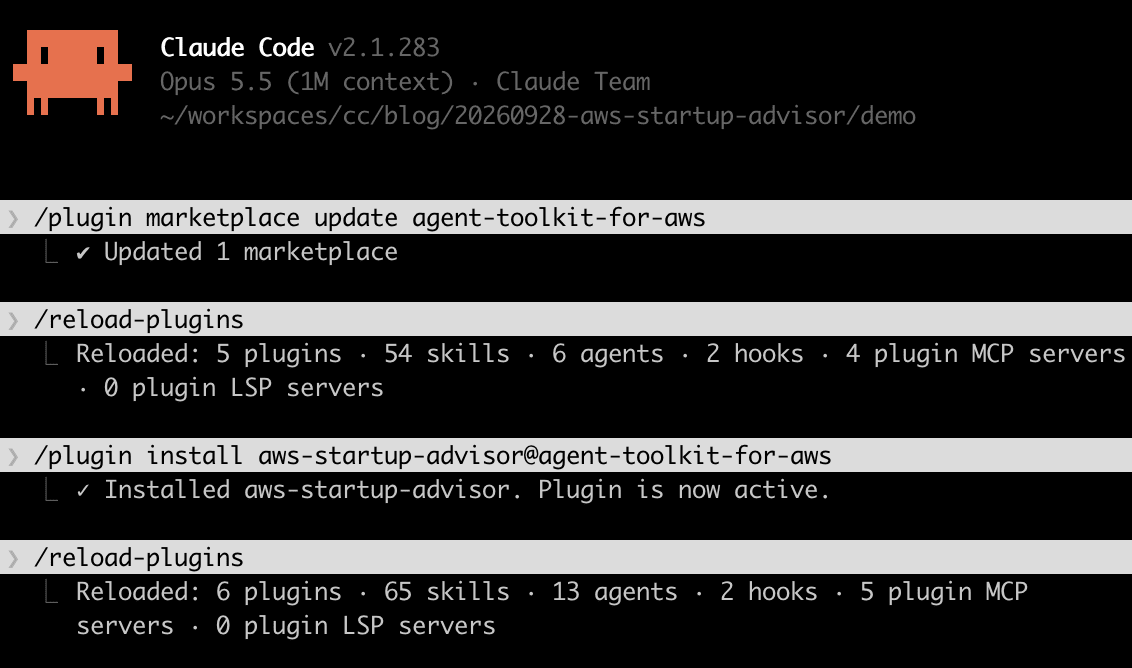
インストール前の /reload-plugins は「5 plugins · 54 skills · 6 agents · 2 hooks · 4 plugin MCP servers」、インストール後は「6 plugins · 65 skills · 13 agents · 2 hooks · 5 plugin MCP servers」でした。スキルが 11、エージェントが 7、MCP サーバーが 1 増えており、プラグインの構成と一致します。
project スコープでインストールすると、検証用ディレクトリの .claude/settings.json に次の設定が書き込まれていました。
.claude/settings.json:
{
  "enabledPlugins": {
    "aws-startup-advisor@agent-toolkit-for-aws": true
  }
}
構成とトークン量を確認する
別のターミナルで、プラグインの構成と、コンテキストに追加されるトークン量の見込みを確認します。
claude plugin details aws-startup-advisor
aws-startup-advisor 2.0.1
  Description: Personalized AWS guidance built on patterns from 350,000+ startups—architecture, cost, security, and migration, ...
  Source: aws-startup-advisor@agent-toolkit-for-aws

Component inventory
  Skills (11)  agent-advisor, architect-for-startups, azure-to-aws, contextual-offers-for-startups, gcp-to-aws, heroku-to-aws, knowledge-base-for-startups, llm-to-bedrock, prompt-library-for-startups, start-building-for-startups, tf-best-practices
  Agents (7)  generic-phase-worker-rw, generic-phase-worker-rwx, llm2bedrock-report-generator, llm2bedrock-prompt-evaluator, llm2bedrock-log-ingestor, llm2bedrock-code-analyzer, llm2bedrock-code-rewriter
  Hooks (0)
  MCP servers (1)  aws-mcp  (tool schemas resolved at runtime; not counted)
  LSP servers (0)

Projected token cost
  Always-on:   ~4,908 tok   added to every session

Per-component (rounded)
  component                       always-on  on-invoke
  tf-best-practices                    ~210      ~4.4k
  knowledge-base-for-startups          ~340      ~3.9k
  prompt-library-for-startups          ~390      ~3.9k
  llm-to-bedrock                       ~270     ~16.8k
  architect-for-startups               ~400      ~4.2k
  agent-advisor                        ~400      ~6.4k
  start-building-for-startups          ~390      ~8.1k
  contextual-offers-for-startups       ~390      ~5.9k
  heroku-to-aws                        ~390      ~9.4k
  gcp-to-aws                           ~390     ~20.3k
  azure-to-aws                         ~400      ~5.5k
  generic-phase-worker-rw              ~230      ~2.1k
  generic-phase-worker-rwx             ~260      ~3.1k
  llm2bedrock-report-generator          ~90     ~13.4k
  llm2bedrock-prompt-evaluator         ~100     ~23.4k
  llm2bedrock-log-ingestor              ~70      ~9.8k
  llm2bedrock-code-analyzer             ~90     ~11.3k
  llm2bedrock-code-rewriter             ~80     ~22.4k
...
スキルやエージェントの説明文として、セッションごとに約 4,908 トークンが常に追加されます。architect-for-startups を呼び出したときに追加されるのは約 4.2k トークンで、gcp-to-aws(約 20.3k)や llm-to-bedrock(約 16.8k)より少なめです。
ケース 1: Pre-revenue の段階で構成を相談する
前提情報をあえて省いて相談し、スキルが自動で呼ばれるか、推奨の前に質問してくるかを確認します。
社内ドキュメントを検索して回答する RAG チャットの SaaS を AWS で作ろうとしています。どんなアーキテクチャにすればよいですか?
スキル名を指定していませんが、Skill(aws-startup-advisor:architect-for-startups) が呼ばれ、推奨の前に AskUserQuestion で 4 つの質問が表示されました。
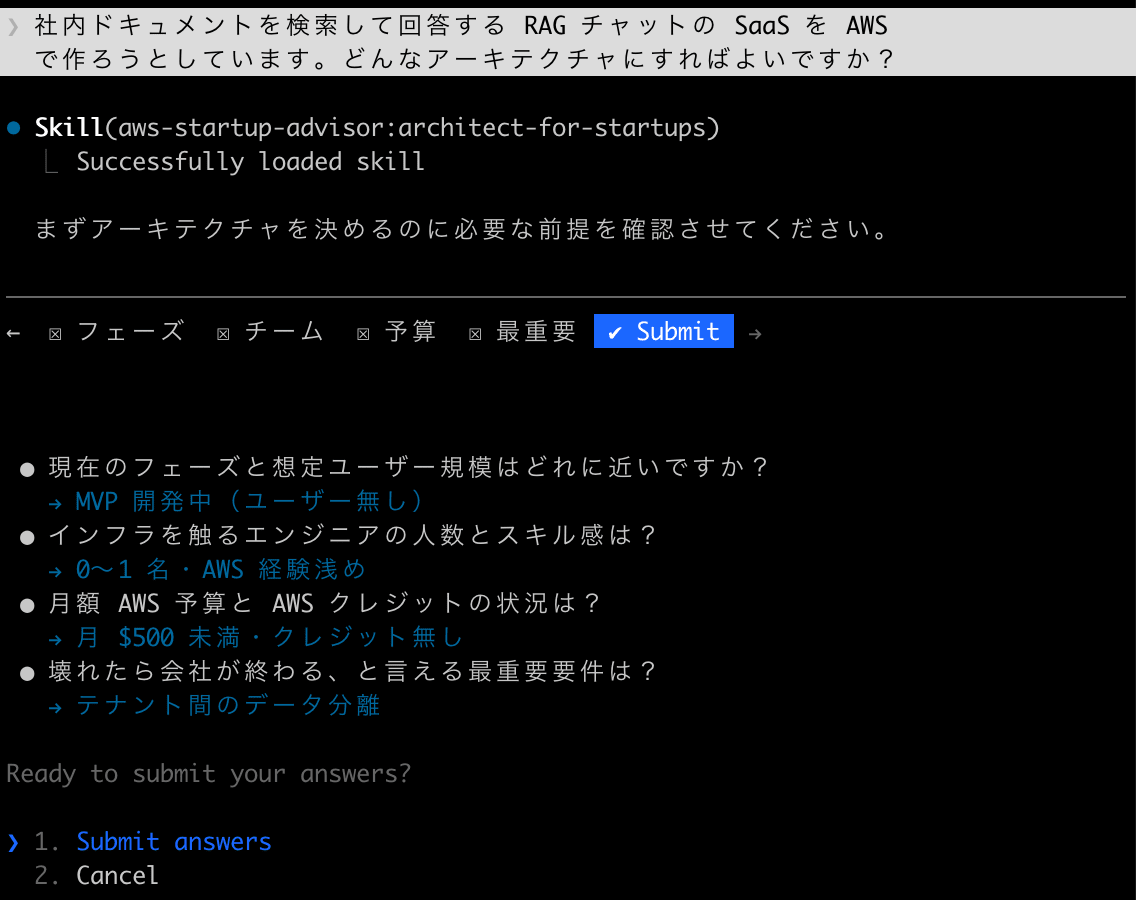
| 質問 | 選択肢 | 選んだ回答 |
|---|---|---|
| 現在のフェーズと想定ユーザー規模はどれに近いですか? | MVP 開発中(ユーザー無し)/Seed(〜1K ユーザー / 数社)/Series A(1K〜100K ユーザー)/Series B 以降 | MVP 開発中(ユーザー無し) |
| インフラを触るエンジニアの人数とスキル感は? | 0〜1 名・AWS 経験浅め/2〜5 名・AWS 経験あり/インフラ専任がいる | 0〜1 名・AWS 経験浅め |
| 月額 AWS 予算と AWS クレジットの状況は? | 月 $500 未満・クレジット無し/月 $500〜$3,000 / クレジット少額/クレジット潤沢($10K 以上)/月 $3,000 以上の予算あり | 月 $500 未満・クレジット無し |
| 壊れたら会社が終わる、と言える最重要要件は? | テナント間のデータ分離/文書単位の閲覧権限の反映/回答品質・ハルシネーション/可用性・応答速度 | テナント間のデータ分離 |
SKILL.md の 6 つの質問は、フェーズ(想定ユーザー規模を含む)、チーム、予算(クレジットを含む)、最重要要件の 4 問にまとめられていました。
回答を送ると、スキルの参照資料 14 ファイル(stage-frameworks.md、bedrock.md、lambda.md など)とオファーの一覧(offers.md)を読み込み、aws-mcp で AWS ドキュメントを確認しました。aws-mcp の呼び出しは search_documentation が 4 回、read_documentation が 2 回です。
search_documentation: Bedrock Knowledge Bases Amazon S3 Vectors vector store metadata filtering
search_documentation: multi-tenant RAG Bedrock Knowledge Bases tenant isolation metadata filter
search_documentation: Amazon Bedrock fully managed knowledge base vs custom knowledge base
read_documentation:   https://docs.aws.amazon.com/bedrock/latest/userguide/kb-build-managed.html
search_documentation: Bedrock Managed Knowledge Base pricing supported AWS Regions
read_documentation:   https://aws.amazon.com/blogs/machine-learning/build-multi-tenant-agentic-chat-applications-on-enterprise-data-with-amazon-bedrock-managed-knowledge-base/
回答に含まれていた構成図は、次のとおりです。
推奨されたサービスと理由です(回答からの抜粋)。
| 役割 | サービス | 選んだ理由 |
|---|---|---|
| フロントエンド | Amplify Hosting | git push だけでデプロイできる |
| 認証 | Cognito ユーザープール | JWT に tenant_id を載せ、API Gateway で検証できる |
| API | API Gateway HTTP API + Lambda(Python か Node.js、arm64) | 待機中は費用がかからない。REST API より安い |
| RAG 基盤 | Bedrock Managed Knowledge Base | 取り込み・パース・埋め込み・ベクトル保存・リランクを Bedrock が管理する。ベクトル DB の運用が不要 |
| 回答生成 | Bedrock Converse API(Nova Lite など安いモデルから始める) | モデルとプロンプトを自分で選べ、トークン費用を管理しやすい |
| 状態管理 | DynamoDB オンデマンド | 文書の取り込み状態、会話履歴、ファイル名と document ID の対応を保存する |
最重要要件として選んだテナント分離については、MVP でも省かない 6 項目が示されました。
1 つの Knowledge Base を全テナントで共有し、メタデータフィルターで分離します。...
tenant_idはサーバー側で決める
...- 取り込むときは、すべての文書に
tenant_idを付ける - 検索するときは、必ず
equalsフィルターを付ける
... - 返ってきたチャンクをもう一度確認する
... - DynamoDB と S3 もテナントで区切る
... - 自動テストを 1 本用意する
- テナント A の文書を、テナント B の JWT で検索しても 0 件になることを確認するテストです。
- デプロイのたびに実行します。
「今は見送るもの」は、追加するきっかけと対になっています。
| 後回しにするもの | 追加する時期 |
|---|---|
| 回答のストリーミング表示 | 回答の待ち時間に不満が出たとき。HTTP API の上限は 30 秒 |
| SQS による取り込みの非同期化 | 同時アップロードが増え、アップロードの応答が遅くなったとき |
| 文書単位の閲覧権限(Managed KB の ACL 機能) | 顧客が「社内の部署ごとに見せる文書を分けたい」と求めたとき |
| テナントごとの専用 KB(サイロ型) | 大口顧客がテナント別の暗号鍵や物理的な分離を契約で求めたとき |
| WAF・独自ドメイン・ステージング環境 | 最初の有料顧客がついたとき |
| VPC・マルチアカウント・GuardDuty | 最初のエンタープライズ顧客からセキュリティチェックシートが届いたとき |
費用、構築期間、自己チェックの結果です。
- 固定費はほぼかかりません。 Lambda、API Gateway HTTP API、DynamoDB オンデマンド、S3、Amplify Hosting は、MVP の利用量なら無料枠内か数ドル程度です。常時起動のリソース(NAT Gateway、OpenSearch Serverless、RDS)は使いません。
... - 最初の日に AWS Budgets を設定してください。 予算の上限($500)に対してアラートを出します。クレジットがないので、請求がそのまま手元の資金から出ていきます。
構築期間の目安の結果です。
- 1 人で、認証、アップロード、チャットの 3 画面を作るとして、2〜4 週間が目安です。...
この案の自己診断の結果です。
- 判定は このまま作ってよい です。
...
ベクトルストアについては、OpenSearch Serverless を「最低でも月 $700 程度」として候補から外していました。この金額は考察で取り上げます。
ベクトルストアを選ぶときに注意したいのは OpenSearch Serverless です。最低でも月 $700 程度かかるため、今回の予算には合いません。今回は **Bedrock Managed Knowledge Base** を推奨します。...
回答の最後には、Cognito を推奨したうえで、代替として Auth0 のオファーが 1 行付いていました。
*推奨は Cognito です。マネージドな代替サービスを使いたい場合は、**Auth0** に AWS Activate 経由のオファーがあります。1 年間無料で、対象はベンチャー資金を受けていて調達額 $5M 未満、ARR $1M 未満、設立 2 年未満のスタートアップです。[Redeem →](https://aws.amazon.com/startups/offers/auth0?source=ide-startupAdvisor-claude)*
質問への回答待ちを除いた処理時間は、ターミナルの表示で「Brewed for 2m 21s」でした。
実際の回答
# 社内ドキュメント RAG チャット SaaS のアーキテクチャ案

## 前提

いただいた回答から、次の条件で設計しました。

- MVP 開発中で、ユーザーはまだいない
- インフラを見るのは 0〜1 名で、AWS の経験は浅め
- 月の予算は $500 未満で、AWS クレジットはない
- 最重要要件は**テナント間のデータ分離**

この段階では、早く出すことと固定費をかけないことが優先です。サーバーやクラスタの運用は避け、フルマネージドのサービスだけで組みます。ただしテナント分離は壊れると会社が終わる要件なので、ここだけは最初から厳密に作ります。

## 推奨構成

```mermaid
flowchart LR
    classDef client fill:#E3F2FD,stroke:#64B5F6,color:#0D47A1
    classDef edge fill:#F3E5F5,stroke:#BA68C8,color:#4A148C
    classDef compute fill:#FFF3E0,stroke:#FFB74D,color:#E65100
    classDef data fill:#E8F5E9,stroke:#81C784,color:#1B5E20
    classDef ai fill:#FCE4EC,stroke:#F06292,color:#880E4F

    U[利用者のブラウザ]:::client
    AMP[Amplify Hosting<br/>SPA 配信]:::edge
    COG[Cognito ユーザープール<br/>custom:tenant_id]:::edge
    API[API Gateway HTTP API<br/>JWT オーソライザー]:::edge

    UP[Lambda: upload / status]:::compute
    CHAT[Lambda: chat]:::compute

    S3[(S3<br/>6MB 超ファイルの一時置き場)]:::data
    DDB[(DynamoDB<br/>文書状態・会話履歴<br/>PK に tenant_id)]:::data

    KB[Bedrock Managed Knowledge Base<br/>カスタムコネクタで直接取り込み]:::ai
    FM[Bedrock モデル<br/>Converse API]:::ai

    U --> AMP
    U -->|サインイン| COG
    U -->|JWT 付きリクエスト| API
    API --> UP
    API --> CHAT
    UP -->|大きいファイル| S3
    UP -->|IngestKnowledgeBaseDocuments<br/>metadata: tenant_id| KB
    UP --> DDB
    CHAT -->|Retrieve<br/>tenant_id equals フィルター| KB
    CHAT -->|検索結果 + 質問| FM
    CHAT --> DDB
```

| 役割 | サービス | 選んだ理由 |
| --- | --- | --- |
| フロントエンド | Amplify Hosting | `git push` だけでデプロイできる |
| 認証 | Cognito ユーザープール | JWT に `tenant_id` を載せ、API Gateway で検証できる |
| API | API Gateway HTTP API + Lambda(Python か Node.js、arm64) | 待機中は費用がかからない。REST API より安い |
| RAG 基盤 | **Bedrock Managed Knowledge Base** | 取り込み・パース・埋め込み・ベクトル保存・リランクを Bedrock が管理する。ベクトル DB の運用が不要 |
| 回答生成 | Bedrock Converse API(Nova Lite など安いモデルから始める) | モデルとプロンプトを自分で選べ、トークン費用を管理しやすい |
| 状態管理 | DynamoDB オンデマンド | 文書の取り込み状態、会話履歴、ファイル名と document ID の対応を保存する |

### Knowledge Base の種類について

ベクトルストアを選ぶときに注意したいのは OpenSearch Serverless です。最低でも月 $700 程度かかるため、今回の予算には合いません。今回は **Bedrock Managed Knowledge Base** を推奨します。ベクトルストアを自分で用意する必要がなく、東京リージョンでも使えます([AWS Blog](https://aws.amazon.com/blogs/machine-learning/build-enterprise-search-for-agents-with-amazon-bedrock-managed-knowledge-base/))。

- 利用者がアップロードした文書は `IngestKnowledgeBaseDocuments` API で直接取り込みます。S3 コネクタの定期同期は使いません。S3 コネクタは一括取り込み向けで、同期のたびに利用者が追加した文書を上書き・削除してしまう可能性があるためです。
- 検索は `Retrieve` API で行い、`Converse` API で回答を生成します。Managed KB は `RetrieveAndGenerate` API に対応していません。`AgenticRetrieveStream` API を使えば 1 回の呼び出しで回答まで得られますが、質問を分解して複数回検索するため、呼び出し数とトークン費用の見積もりが難しくなります。MVP では単純な `Retrieve` から始めてください。

## テナント分離の実装

1 つの Knowledge Base を全テナントで共有し、メタデータフィルターで分離します。AWS が公開しているマルチテナント構成も同じ方式です([AWS Blog](https://aws.amazon.com/blogs/machine-learning/build-multi-tenant-agentic-chat-applications-on-enterprise-data-with-amazon-bedrock-managed-knowledge-base/))。

1. **`tenant_id` はサーバー側で決める**
   - Cognito のカスタム属性 `custom:tenant_id` に入れます。
   - アプリクライアントの書き込み権限を外し、利用者自身が変更できないようにします。
   - Lambda は、API Gateway が検証した JWT の claims から `tenant_id` を読みます。リクエストボディの値は信用しません。
2. **取り込むときは、すべての文書に `tenant_id` を付ける**
3. **検索するときは、必ず `equals` フィルターを付ける**
   - Knowledge Base には質問文からフィルターを推測する機能もあります。ただしこれは検索精度を上げるための機能で、アクセス制御としては使えません。
4. **返ってきたチャンクをもう一度確認する**
   - 返ってきたチャンクの `tenant_id` が呼び出し元と一致しないものは捨てます。フィルターの付け忘れに備えた二重チェックです。
5. **DynamoDB と S3 もテナントで区切る**
   - DynamoDB のパーティションキーは `TENANT#<id>#...` の形にします。
   - S3 のキーは `<tenant_id>/` から始めます。
6. **自動テストを 1 本用意する**
   - テナント A の文書を、テナント B の JWT で検索しても 0 件になることを確認するテストです。
   - デプロイのたびに実行します。

## この段階でやらないこと(と追加する時期)

| 後回しにするもの | 追加する時期 |
| --- | --- |
| 回答のストリーミング表示 | 回答の待ち時間に不満が出たとき。HTTP API の上限は 30 秒 |
| SQS による取り込みの非同期化 | 同時アップロードが増え、アップロードの応答が遅くなったとき |
| 文書単位の閲覧権限(Managed KB の ACL 機能) | 顧客が「社内の部署ごとに見せる文書を分けたい」と求めたとき |
| テナントごとの専用 KB(サイロ型) | 大口顧客がテナント別の暗号鍵や物理的な分離を契約で求めたとき |
| WAF・独自ドメイン・ステージング環境 | 最初の有料顧客がついたとき |
| VPC・マルチアカウント・GuardDuty | 最初のエンタープライズ顧客からセキュリティチェックシートが届いたとき |

## 費用

- **固定費はほぼかかりません。** Lambda、API Gateway HTTP API、DynamoDB オンデマンド、S3、Amplify Hosting は、MVP の利用量なら無料枠内か数ドル程度です。常時起動のリソース(NAT Gateway、OpenSearch Serverless、RDS)は使いません。
- **従量で増えるのは次の 2 つです。**
  - Managed KB:Bedrock のマネージドモデルを使う場合、保存量と検索回数(トークン数ではなく呼び出し回数)で課金され、取り込みには追加料金がかかりません。単価は [Bedrock の料金ページ](https://aws.amazon.com/bedrock/pricing/)で確認してください。今回、具体的な単価までは確認していません。
  - 回答生成のトークン費用:モデルの選び方で大きく変わります。Nova Lite など安いモデルで品質を確かめ、足りない質問が出たときだけ上位モデルを使ってください。
- **最初の日に AWS Budgets を設定してください。** 予算の上限($500)に対してアラートを出します。クレジットがないので、請求がそのまま手元の資金から出ていきます。

## 構築期間の目安

1 人で、認証、アップロード、チャットの 3 画面を作るとして、**2〜4 週間**が目安です。Knowledge Base、Cognito、Lambda は AWS CDK の 1 スタックにまとめるか、最初はコンソールで作っても構いません。

## この案の自己チェック

判定は **このまま作ってよい** です。

- **運用できるか**:運用が必要なサーバーやクラスタはありません。フルマネージドのサービスだけなので、1 名以下のチームでも回せます。
- **利用が 10 倍になったら**:すべて従量課金で自動的にスケールします。費用は主に KB の呼び出しとトークン数に比例して増えます。
- **注意点**:テナント分離がアプリ側のフィルターに依存しています。上で挙げた 6 項目は、MVP でも省かないでください。

## 最初の日にやるセキュリティ設定

- ルートアカウントの MFA
- アカウント単位の S3 ブロックパブリックアクセス
- アクセスキーをソースコードに入れない(シークレットは SSM Parameter Store へ)
- DynamoDB のポイントインタイムリカバリ(PITR)を有効化
- AWS Budgets のアラート
- CloudTrail のデフォルト証跡は無効化しない

---

*推奨は Cognito です。マネージドな代替サービスを使いたい場合は、**Auth0** に AWS Activate 経由のオファーがあります。1 年間無料で、対象はベンチャー資金を受けていて調達額 $5M 未満、ARR $1M 未満、設立 2 年未満のスタートアップです。[Redeem →](https://aws.amazon.com/startups/offers/auth0?source=ide-startupAdvisor-claude)*
ケース 2: Series A の段階で現行構成をレビューしてもらう
/clear で会話をリセットしてから、Series A の段階を想定し、前提と現行構成を最初にまとめて渡します。技術 DD(デューデリジェンス。投資家が行う技術面の調査)にも触れています。
同じ RAG チャット SaaS を AWS で運用しています。Series A で資金調達を終え、次の調達に向けた技術 DD も意識しています。
・現行構成: API Gateway + Lambda + DynamoDB + S3 + Bedrock Knowledge Bases、1アカウント・本番のみ
・エンジニア 10 名(うちインフラ経験者 2 名、全員ローカルでコンテナ開発)
・有料顧客 150 社・MAU 3 万、1 年後に 10 倍を見込む
・月の AWS 予算: $8,000
・Activate クレジット残高 $20,000(6か月後に失効)
・致命的なもの: 検索 API の停止と顧客データの漏えい
次の四半期で構成をどう変えるべきかレビューしてください。
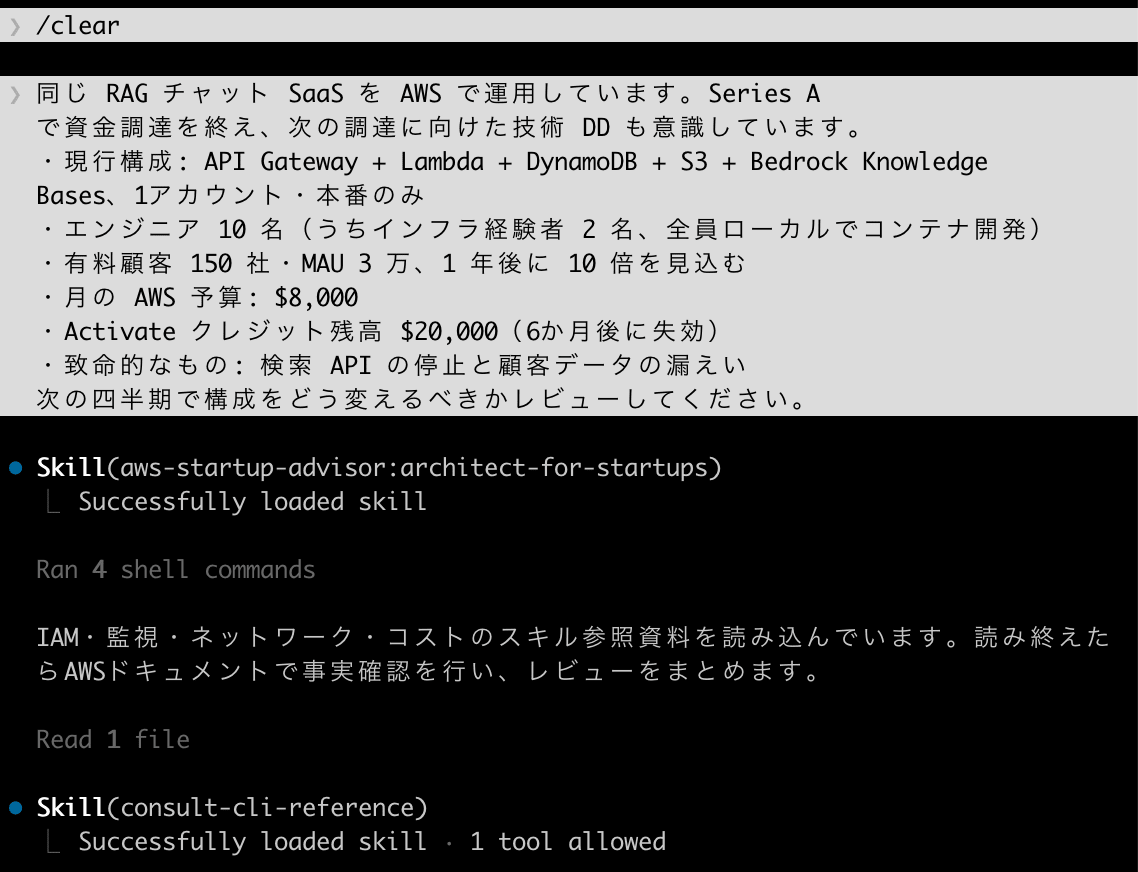
こちらもスキルが自動で呼ばれました。前提を最初に渡したため、質問はなく、そのまま参照資料の読み込みに進みました。技術 DD に触れたことで、参照資料には investor-readiness.md も含まれていました。aws-mcp の search_documentation は 14 回呼ばれ、Knowledge Bases のクォータ、クロスリージョン推論、API Gateway の REST API と HTTP API の違い、OpenSearch Serverless の OCU、Lambda の同時実行数などを確認していました。
スクリーンショットに Skill(consult-cli-reference) が表示されています。これはプラグインのスキルではなく、筆者のグローバル CLAUDE.md にある「外部 LLM に相談する」ルールによって読み込まれたスキルです。Kiro CLI と Codex CLI への相談が試みられましたが、回答の補足によると、Kiro は回答ファイルの読み取りが auto mode の判定で拒否され、Codex はサンドボックス内で起動に失敗しており、どちらも回答には反映されていません。
回答の結論は、アーキテクチャは変えず、周りを固めるというものでした。
## 結論

**アーキテクチャ(API Gateway + Lambda + DynamoDB + S3 + Bedrock KB)は変えなくてよいです。変えるべきなのは構成の周りです。** Series A の段階でやることは、動いているものを作り直すことではなく、信頼性と監視を足して固めることです。

いまの状態は、致命的と挙げていただいた 2 つのリスクに直結しています。

- **本番のみ・1 アカウント**: すべての変更を本番で初めて試すことになり、検索 API が止まる最大の原因になります。技術 DD でもまず指摘される点です。
- **テナント分離がアプリのコード頼み**: Bedrock KB は、テナントのメタデータフィルタを付けるのはアプリの責任という設計です(AWS Prescriptive Guidance で確認済み)。フィルタを付け忘れるバグが 1 つあれば、他社のデータが検索結果に出ます。
回答に含まれていた四半期末の目標構成図です。
推奨する変更は、致命的と挙げた 2 つのリスクごとに表で示されました(抜粋)。
顧客データの漏えい対策の結果です。
| 対策 | 内容 | 理由 |
|---|---|---|
| テナントフィルタをサーバー側で強制 | KB の Retrieve 呼び出しを 1 つの社内モジュールにまとめ、tenant_id は認可済みトークンのクレームからだけ取る。フィルタがなければ呼び出しを拒否する |
フィルタの付け忘れ 1 件が漏えいに直結するため |
| 取り込み時のメタデータ検査 | S3 の各オブジェクトに tenantId 入りの .metadata.json があるか検査し、なければ取り込まない |
メタデータのない文書は、フィルタの外れた検索に全テナント分まとめて出てしまう |
| クロステナント漏えいテスト | テナント A にだけ置いた識別文字列入りの文書が、テナント B の検索結果に出ないことを CI と本番の外形監視で毎回確認する | 分離の証拠が残り、DD でそのまま示せる |
| アカウント分割と ID 管理 | 新しく管理アカウントを作り、既存アカウントを prod として招待する(本番リソースは移設しない)。... | 本番への直接操作を減らし、監査ログを本番から切り離す |
| ... | ... | ... |
検索 API の停止対策の結果です。
| 止まる原因 | 対策 |
|---|---|
| Bedrock のスロットリング・リージョンの容量不足 | クロスリージョン推論プロファイルを使う。... |
| KB Retrieve のクォータ | Managed KB の既定値は Retrieve 600 RPM/KB(バースト 25 RPS)。customer-managed KB の値は Service Quotas で確認してください。テナントを 1 つの KB に同居させている場合、150 社でこの上限を共有します |
| Lambda の同時実行数 | アカウント既定は 1,000 で、全関数の共有です。検索用の関数に予約同時実行を設定し、取り込みやバッチに枠を取られないようにする |
| ... | ... |
チーム全員がローカルでコンテナ開発をしているという前提に対しては、あえて Lambda を続けるよう推奨していました。
Lambda を続けるか、ECS Fargate に移るかの結果です。
今四半期は Lambda を続けてください。 全員がローカルでコンテナ開発をしているので ECS に寄せたくなりますが、止めてはいけない検索 API の実行基盤を、分割・分離・監視と同じ四半期に入れ替えるのはリスクが大きすぎます。開発環境を揃えたい場合は、Lambda のコンテナイメージを使えば同じ Dockerfile を流用できます。
次のどれかが起きたら ECS Fargate を検討します。
- Lambda の請求が安定した負荷で月 $500 を超える
- コールドスタートで p99 が SLO を超える
- WebSocket など長時間の接続が必要になる
インフラ担当 2 名とプロダクトエンジニアに分けた 3 か月の進め方と、技術 DD に向けて揃える資料も示されました。
3 か月の進め方の結果です。
| 月 | インフラ担当 2 名 | プロダクトエンジニア |
|---|---|---|
| 1 か月目 | Organizations・Identity Center・組織 CloudTrail・SCP、GuardDuty / Security Hub CSPM、PITR とバージョニング、予算アラート、クォータの確認と引き上げ申請、予約同時実行 | テナントフィルタの強制モジュール、取り込み時のメタデータ検査、クロステナント漏えいテスト |
| 2 か月目 | staging アカウント、IaC の残り(検索経路から)、CI/CD とカナリアデプロイ、SLO・アラーム・Synthetics | クロスリージョン推論、リトライとフォールバック、テナント別トークン記録 |
| 3 か月目 | WAF、テナント単位のレート制限、staging での 10 倍負荷試験、再取り込みによる復旧のリハーサル | 負荷試験で見つかった問題の修正、runbook の作成 |
| ... | ... | ... |
技術 DD に向けて揃える資料の結果です。
- 1 枚の構成図(上の図を実構成に合わせたもの)
- 単一障害点の一覧と対策(2 章の表がそのまま使えます)
- RTO / RPO(再取り込みの実測値と PITR から決める)
- 検索 API の直近 90 日の稼働率と MTTR(Synthetics から取る)
- 10 倍時のスケール計画(クォータ・費用の試算)
- テナント分離の設計と、漏えいテストの実行記録
- インフラ費用の MRR 比とテナント別原価
- インシデント対応手順(1 ページでもよい)
自己チェックでは、現状を DANGEROUS、計画に沿った構成を SHIP IT と判定していました。
- **判定**: 現状は DANGEROUS(本番のみの単一アカウントとアプリ頼みのテナント分離)、上の計画に沿った構成は SHIP IT です。
回答の補足では、スキルの参照資料にある OpenSearch Serverless の金額が、現在の料金ページと異なることを指摘していました。
- スキルの参照資料には「OpenSearch Serverless は最低 月 ~$700」とありますが、現在の料金ページでは NextGen はゼロまで縮み、Classic は最低 2 OCU(HA を含む)です。実際の費用は請求で確認してください。
オファー行は、AWS WAF を推奨したうえでの WafCharm でした。
*推奨は AWS WAF です。WAF のルール管理を外部に任せたい場合は、**WafCharm** に AWS Activate 経由のスタートアップ限定オファーがあります(最大 $6,500 相当)。[Redeem →](https://aws.amazon.com/startups/offers/cyber-security-cloud?source=ide-startupAdvisor-claude)*
プロンプトを送ってから最終回答までの時間は、ターミナルの表示で「Baked for 6m 31s」でした。
実際の回答
# RAG チャット SaaS 構成レビュー(次の四半期)

## 結論

**アーキテクチャ(API Gateway + Lambda + DynamoDB + S3 + Bedrock KB)は変えなくてよいです。変えるべきなのは構成の周りです。** Series A の段階でやることは、動いているものを作り直すことではなく、信頼性と監視を足して固めることです。

いまの状態は、致命的と挙げていただいた 2 つのリスクに直結しています。

- **本番のみ・1 アカウント**: すべての変更を本番で初めて試すことになり、検索 API が止まる最大の原因になります。技術 DD でもまず指摘される点です。
- **テナント分離がアプリのコード頼み**: Bedrock KB は、テナントのメタデータフィルタを付けるのはアプリの責任という設計です(AWS Prescriptive Guidance で確認済み)。フィルタを付け忘れるバグが 1 つあれば、他社のデータが検索結果に出ます。

## 四半期末の目標構成

```mermaid
%%{init: {'theme':'base','themeVariables':{'fontSize':'14px','lineColor':'#9aa5b1'}}}%%
flowchart LR
  subgraph ORG["AWS Organizations"]
    MGMT["管理アカウント<br/>Identity Center・SCP"]
    LOG["ログ保管アカウント<br/>組織 CloudTrail"]
    STG["staging アカウント<br/>本番と同じ IaC"]
    subgraph PROD["prod アカウント(既存を招待)"]
      WAF["AWS WAF"] --> APIGW["API Gateway<br/>テナント単位のレート制限"]
      APIGW --> FN["Lambda(検索)<br/>予約同時実行"]
      FN -->|"tenant_id フィルタ必須"| KB["Bedrock Knowledge Bases"]
      KB --> VS["ベクトルストア"]
      FN -->|"クロスリージョン推論"| FM["Bedrock モデル<br/>+フォールバックモデル"]
      FN --> DDB["DynamoDB<br/>PITR 有効"]
      SRC["S3 原本<br/>バージョニング・マルウェア検査"] --> KB
    end
  end
  SYN["CloudWatch Synthetics<br/>可用性とテナント分離を外から監視"] --> WAF
  CI["GitHub Actions"] -->|"デプロイ"| STG
  CI -->|"カナリアデプロイ"| PROD

  classDef org fill:#eef2ff,stroke:#a5b4fc,color:#312e81
  classDef acct fill:#e0f2fe,stroke:#7dd3fc,color:#0c4a6e
  classDef edge fill:#fce7f3,stroke:#f9a8d4,color:#831843
  classDef app fill:#dcfce7,stroke:#86efac,color:#14532d
  classDef ai fill:#fef9c3,stroke:#fde047,color:#713f12
  classDef data fill:#ffedd5,stroke:#fdba74,color:#7c2d12
  classDef ext fill:#f3e8ff,stroke:#d8b4fe,color:#581c87
  class MGMT,LOG,STG acct
  class WAF,APIGW edge
  class FN app
  class KB,VS,FM ai
  class DDB,SRC data
  class SYN,CI ext
  style ORG fill:#f8fafc,stroke:#cbd5e1
  style PROD fill:#f0fdf4,stroke:#86efac
```

## 推奨する変更(優先順)

### 1. 顧客データの漏えい対策

| 対策 | 内容 | 理由 |
|---|---|---|
| **テナントフィルタをサーバー側で強制** | KB の Retrieve 呼び出しを 1 つの社内モジュールにまとめ、`tenant_id` は認可済みトークンのクレームからだけ取る。フィルタがなければ呼び出しを拒否する | フィルタの付け忘れ 1 件が漏えいに直結するため |
| **取り込み時のメタデータ検査** | S3 の各オブジェクトに `tenantId` 入りの `.metadata.json` があるか検査し、なければ取り込まない | メタデータのない文書は、フィルタの外れた検索に全テナント分まとめて出てしまう |
| **クロステナント漏えいテスト** | テナント A にだけ置いた識別文字列入りの文書が、テナント B の検索結果に出ないことを CI と本番の外形監視で毎回確認する | 分離の証拠が残り、DD でそのまま示せる |
| **アカウント分割と ID 管理** | 新しく管理アカウントを作り、**既存アカウントを prod として招待**する(本番リソースは移設しない)。staging とログ保管のアカウントを新設し、IAM Identity Center に移行して IAM ユーザーとアクセスキーを廃止する | 本番への直接操作を減らし、監査ログを本番から切り離す |
| **SCP(最小限)** | 組織からの離脱禁止、CloudTrail / GuardDuty の停止禁止、使うリージョン以外の禁止、root 利用禁止 | アカウントが 4 つになるので、SCP を入れる意味が出る |
| **検知と監査** | GuardDuty(S3 Malware Protection を含む)、Security Hub CSPM(FSBP 標準)、IAM Access Analyzer、S3 Block Public Access(アカウント単位) | 顧客がアップロードした文書を扱うため、アップロード時のマルウェア検査も入れる |
| **推論ログの扱い** | Bedrock のモデル呼び出しログを有効にしている場合、中身はプロンプトと回答、つまり顧客データそのもの。アクセス権と保持期間を絞る | 見落とされやすい漏えい経路 |

IAM で DynamoDB と S3 をテナント単位に分離する方法(セッションタグ + `dynamodb:LeadingKeys` や S3 プレフィックス制御)もありますが、今四半期は上の「強制・検査・テスト」を優先します。

### 2. 検索 API の停止対策

検索 1 件は「API Gateway → Lambda → KB Retrieve → ベクトルストア → Bedrock モデル」と流れます。止まりうる箇所ごとに対策します。

| 止まる原因 | 対策 |
|---|---|
| **Bedrock のスロットリング・リージョンの容量不足** | クロスリージョン推論プロファイルを使う。地理的プロファイルは US / EU / オーストラリア / 日本の範囲内で処理が完結します。あわせて指数バックオフ付きのリトライと、スロットリング時に別モデルへ切り替えるフォールバックを入れる |
| **KB Retrieve のクォータ** | Managed KB の既定値は Retrieve 600 RPM/KB(バースト 25 RPS)。customer-managed KB の値は Service Quotas で確認してください。テナントを 1 つの KB に同居させている場合、150 社でこの上限を共有します |
| **Lambda の同時実行数** | アカウント既定は 1,000 で、全関数の共有です。検索用の関数に予約同時実行を設定し、取り込みやバッチに枠を取られないようにする |
| **一部テナントによる枠の使い切り** | テナント単位のレート制限。REST API なら使用量プランで設定できます。HTTP API はクライアント単位のスロットリングにも WAF にも対応していないので、REST API に移すか、アプリ側(DynamoDB のカウンタなど)で実装する |
| **ベクトルストア** | OpenSearch Serverless の NextGen コレクションは、10 分使われないと OCU がゼロまで縮みます。検索は止めてはいけない経路なので、コレクショングループで検索用の最小 OCU を設定し、コールドスタートを避ける。Classic コレクションなら、スタンバイのない dev-test モードを本番で使わない |
| **デプロイ起因の障害** | 3 章の staging とカナリアデプロイで対応 |
| **検知の遅れ** | 検索 API の SLO(可用性・p95 レイテンシ)を決め、5xx 率、レイテンシ、Bedrock の `ThrottlingException` 件数にアラームを設定する。CloudWatch Synthetics で 1 分ごとにテスト用テナントから検索し、可用性とテナント分離を同時に確認する |
| **データ消失** | DynamoDB の PITR と、S3 原本のバージョニングを有効にする。ベクトルインデックスは S3 原本から作り直せる派生データなので、**全件の再取り込みを staging で一度実行し、かかった時間を RTO とする**(取り込みジョブにもクォータがあるため実測が必要) |

10 倍時の負荷は、仮定を置いて試算しておきます(1 ユーザーあたり月 20 回検索、ピークは平均の 5〜10 倍と仮定)。

- MAU 30 万 × 20 回 = 月 600 万回 → 平均 2.3 RPS、ピーク 12〜23 RPS
- これは Managed KB の既定値 600 RPM(= 平均 10 RPS)を超えます
- Lambda の同時実行は、23 RPS × 1 件 10 秒でおよそ 230

実際の検索回数とレスポンス時間を入れて計算し直し、**必要なクォータの引き上げは今四半期中に申請**してください。

### 3. 変更の安全性

- **staging アカウント**: 本番と同じ IaC から作ります。クレジットが残っている今のうちに作るのが適しています。
- **IaC**: まだ IaC 化していないリソースがあれば、検索 API の経路(API Gateway・Lambda・KB・ベクトルストア・DynamoDB)から先に取り込みます。本番をコンソールから変更するのはやめます。
- **CI/CD**: GitHub Actions で staging → prod の順にデプロイします。Lambda はエイリアスの重み付けでカナリアデプロイし、アラームが出たら自動でロールバックします。

## Lambda を続けるか、ECS Fargate に移るか

**今四半期は Lambda を続けてください。** 全員がローカルでコンテナ開発をしているので ECS に寄せたくなりますが、止めてはいけない検索 API の実行基盤を、分割・分離・監視と同じ四半期に入れ替えるのはリスクが大きすぎます。開発環境を揃えたい場合は、Lambda のコンテナイメージを使えば同じ Dockerfile を流用できます。

次のどれかが起きたら ECS Fargate を検討します。

- Lambda の請求が安定した負荷で月 $500 を超える
- コールドスタートで p99 が SLO を超える
- WebSocket など長時間の接続が必要になる

## 今四半期はやらないこと

| やらないこと | 再検討するきっかけ |
|---|---|
| ECS / EKS への移行 | 上の 3 条件のどれか |
| マルチリージョン | リージョン障害時の切り替えを契約 SLA で求められたとき |
| Bedrock Provisioned Throughput、Savings Plans | クレジット失効後、利用量が 3 か月以上安定してから。クレジット期間中に買うと、失効後も支払いだけが残る |
| Control Tower | アカウントが 5 つを超える、または SOC 2 監査の証跡整備に入るとき |
| テナントごとの KB(サイロ型) | 専用の暗号鍵や物理的な分離を求める企業顧客が現れたとき。同居型では KMS キーをテナント間で共有するため、テナント別の鍵は使えない |
| ベクトルストアの S3 Vectors への移行 | ベクトルストアの費用が大きくなり、レイテンシの要件を満たせるとき。S3 Vectors は問い合わせ頻度の低い用途向けとされているため、今は対象外 |
| Datadog などの外部監視 | CloudWatch Logs Insights で調査に 1 時間以上かかることが常態化したとき |

## コストとクレジット

- **クレジット**: $20,000 ÷ 6 か月 ≒ 月 $3,333 です。
  - 現在の月額がこれ以上なら、何もしなくても失効前に使い切ります。
  - 下回る場合は、差額分を staging の構築、10 倍負荷試験、安いモデルへのルーティング評価に前倒しで使ってください。
  - 使い切るためだけにリソースを立てることはしません。
- **追加費用**: 監視・セキュリティ系(GuardDuty、Security Hub CSPM、Config、WAF、Synthetics)で月 $100〜$300 程度が目安です(スキル参照資料の目安値を合計したもので、見積もりではありません)。staging の費用は構成次第です。予算 $8,000 に対して、支配的な費用にはなりません。
- **10 倍時の判断基準**: 費用は Bedrock のトークン代に比例して増えます。
  - 現在の月額のうち Bedrock とベクトルストアが占める額を 10 倍して $8,000 を超えるなら、次の 3 つを今四半期に入れてください。
    - 簡単な問い合わせを安いモデルへ回すルーティング
    - プロンプトキャッシュが効く順序でのプロンプト構成(固定のシステムプロンプトを先頭に置く)
    - 回答長の上限
  - あわせて、Converse の応答に含まれる入出力トークン数を `tenant_id` 付きで構造化ログに記録し、**テナント別の原価**を出せるようにします。アプリケーション推論プロファイルにタグを付けて集計する方法もあります。
- **予算アラート**: AWS Budgets を $8,000 の 80% と 100% に設定し、Cost Anomaly Detection を有効にします。

## 3 か月の進め方

| 月 | インフラ担当 2 名 | プロダクトエンジニア |
|---|---|---|
| 1 か月目 | Organizations・Identity Center・組織 CloudTrail・SCP、GuardDuty / Security Hub CSPM、PITR とバージョニング、予算アラート、クォータの確認と引き上げ申請、予約同時実行 | テナントフィルタの強制モジュール、取り込み時のメタデータ検査、クロステナント漏えいテスト |
| 2 か月目 | staging アカウント、IaC の残り(検索経路から)、CI/CD とカナリアデプロイ、SLO・アラーム・Synthetics | クロスリージョン推論、リトライとフォールバック、テナント別トークン記録 |
| 3 か月目 | WAF、テナント単位のレート制限、staging での 10 倍負荷試験、再取り込みによる復旧のリハーサル | 負荷試験で見つかった問題の修正、runbook の作成 |

収まらない場合は、IaC 化のうち検索経路以外のリソースと、Security Hub の検出結果の細かい調整を次の四半期に回します。テナント分離と検索 API の対策は削らないでください。オンコールは、インフラ担当 2 名に 2 名以上のプロダクトエンジニアを加えた 4 名以上で回します。

## 技術 DD に向けて揃える資料

1. 1 枚の構成図(上の図を実構成に合わせたもの)
2. 単一障害点の一覧と対策(2 章の表がそのまま使えます)
3. RTO / RPO(再取り込みの実測値と PITR から決める)
4. 検索 API の直近 90 日の稼働率と MTTR(Synthetics から取る)
5. 10 倍時のスケール計画(クォータ・費用の試算)
6. テナント分離の設計と、漏えいテストの実行記録
7. インフラ費用の MRR 比とテナント別原価
8. インシデント対応手順(1 ページでもよい)

今四半期の作業は、SOC 2 を取得する場合の証跡にもなります。

## 自己チェック

- **この体制で運用できるか**: 10 名・インフラ 2 名で、Lambda 中心の構成とアカウント 4 つなら運用できる範囲です。EKS もマルチリージョンも入れていません。
- **10 倍になったら何が壊れるか**: 壊れるのは構成ではなくクォータ(Lambda の同時実行、KB Retrieve、Bedrock の TPM)です。上の計画で事前に対処します。
- **明日クレジットが切れたら**: 長期の契約は買わないので、残るのは使った分の料金だけです。
- **判定**: 現状は DANGEROUS(本番のみの単一アカウントとアプリ頼みのテナント分離)、上の計画に沿った構成は SHIP IT です。

## 最初に確認してほしいこと

一部の推奨は、次の答えで変わります。

1. ベクトルストアの種類(OpenSearch Serverless の Classic か NextGen か、Aurora か)
2. API Gateway が REST API か HTTP API か
3. 使っているリージョン(日本のクロスリージョン推論プロファイルを使えるか)
4. 直近 3 か月の月額実績と、その内訳(特に Bedrock とベクトルストア)

## 補足

- **外部 LLM への相談は反映していません。** Kiro CLI への相談は実行しましたが、回答ファイルの読み取りが自動モードの判定で拒否されました。Codex CLI はサンドボックス内で起動に失敗しました(exit 137)。どちらも回避策はとっていません。必要なら許可設定を見直したうえで再実行します。
- スキルの参照資料には「OpenSearch Serverless は最低 月 ~$700」とありますが、現在の料金ページでは NextGen はゼロまで縮み、Classic は最低 2 OCU(HA を含む)です。実際の費用は請求で確認してください。

*推奨は AWS WAF です。WAF のルール管理を外部に任せたい場合は、**WafCharm** に AWS Activate 経由のスタートアップ限定オファーがあります(最大 $6,500 相当)。[Redeem →](https://aws.amazon.com/startups/offers/cyber-security-cloud?source=ide-startupAdvisor-claude)*

このレビューを DD やチームへの共有用の Web ページにまとめることもできます。
2 つのケースの比較
| ケース 1(Pre-revenue) | ケース 2(Series A) | |
|---|---|---|
| スキルの起動 | スキル名なしの質問で自動起動 | スキル名なしの質問で自動起動 |
| 推奨前の質問 | AskUserQuestion で 4 問 | なし(前提を最初に渡したため) |
| aws-mcp の呼び出し | search 4 回、read 2 回 | search 14 回 |
| 推奨の方向 | フルマネージドのサービスだけで組み、テナント分離だけは最初から厳密に作る | アーキテクチャは変えず、アカウント分割・テナントフィルタの強制・監視・staging を追加する |
| 見送るもの | WAF・ステージング環境・VPC・マルチアカウントなど | ECS/EKS への移行・マルチリージョン・Savings Plans・Control Tower など |
| 自己チェックの判定 | このまま作ってよい | 現状 DANGEROUS、計画後 SHIP IT |
| オファー行 | Auth0(Cognito の代替) | WafCharm(AWS WAF の代替) |
| 所要時間 | 2 分 21 秒(質問への回答待ちを除く) | 6 分 31 秒 |
考察
成長段階によって推奨がはっきり変わる
ケース 1 ではマルチアカウントや WAF を「後回しにするもの」に入れ、ケース 2 ではアカウント分割と WAF を今四半期の作業に入れていました。stage-frameworks.md の Series A の項目には、本番と非本番のアカウント分離、機密データを扱う場合の WAF、カナリアデプロイが挙げられており、回答はこの定義に沿っていました。どちらのケースも、見送るものに「追加するきっかけ」が付いているため、次に何が起きたら構成を見直すかを判断しやすい形になっています。
前提を最初に書くと質問が省かれる
ケース 1 では前提を省いたため、AskUserQuestion で 4 問の質問が出ました。ケース 2 では前提を最初に書いたため、質問なしで回答が返りました。SKILL.md の「2 項目以上が不明なら推奨の前に質問する」という指示どおりの動きです。ピッカーの選択肢は「月 $500 未満・クレジット無し」のように幅のある区分なので、具体的な金額やクレジットの失効時期を踏まえた助言がほしい場合は、ケース 2 のように最初のプロンプトに書いておく方が確実です。
同梱資料の料金情報は古い場合がある
同梱の参照資料(bedrock.md、credits-strategy.md、rapid-patterns.md)には、OpenSearch Serverless の最低料金を「~$700/月(インデックス 2 OCU + 検索 2 OCU)」とする記述があります。
grep -rn -i "700" ~/.claude/plugins/cache/agent-toolkit-for-aws/aws-startup-advisor/2.0.1/skills/architect-for-startups/references/*.md | grep -i -E "opensearch|serverless|OCU"
.../references/bedrock.md:41:**OpenSearch Serverless minimum cost: ~$700/month** (2 OCU indexing + 2 OCU search minimum).
.../references/bedrock.md:49:| 50K-500K        | Single OpenSearch Serverless collection shared across KBs | $700 minimum             |
.../references/bedrock.md:50:| 500K+           | Dedicated OpenSearch Serverless per KB                    | $700+ per collection     |
.../references/bedrock.md:62:- **OpenSearch Serverless for a PoC.** $700/month minimum for something 50 users will touch. ...
.../references/credits-strategy.md:20:| OpenSearch Serverless | ~$700/mo minimum             | Bedrock Knowledge Base managed vector store |
.../references/rapid-patterns.md:10:- **Skip OpenSearch Serverless for RAG**: ~$700/month minimum. Use Bedrock Knowledge Base with managed vector store instead.
.../references/rapid-patterns.md:36:- **Bedrock Knowledge Base with OpenSearch Serverless** = ~$700/month minimum. Use Bedrock's managed vector store instead.
現在の料金ページでは、NextGen コレクションは最小 OCU がなく 10 分間使われないとゼロまで縮み、Classic コレクションは最小 2 OCU(インデックス 1 OCU と検索 1 OCU。それぞれスタンバイやレプリカを含む)と説明されています。
ケース 1 の回答は同梱資料の金額をそのまま使っていました。ケース 2 は aws-mcp で OpenSearch Serverless の料金を検索し、この差を自分で指摘していました。今回の 2 回の実行でも、同梱資料の金額をそのまま使った回答と、最新の料金を確認した回答の両方があったので、コストに関わる数字は料金ページで確認してから使う必要があります。
オファー行は回答の最後に 1 行だけ付く
どちらのケースでも、オファー行は回答の最後に 1 行だけ付いていました。いずれも AWS のサービス(Cognito、AWS WAF)を推奨として示したうえで、パートナー製品を代替として紹介する形です。リンクには ?source=ide-startupAdvisor-claude が付いており、クリックが AWS Startup Advisor 経由として計測されます。不要な場合は、セッション中にオファーを表示しないよう伝えると止められます。
利用者の CLAUDE.md とあわせて動く
プラグインのスキルは、利用者のグローバル CLAUDE.md やユーザースキルと同じセッションで動きます。ケース 2 では、筆者の CLAUDE.md のルールによって consult-cli-reference が読み込まれ、外部 CLI への相談が試みられました。また、SKILL.md には図の形式の指定がありませんが、筆者の CLAUDE.md には「図は mermaid(パステルカラー)で書く」という指示があり、両ケースの図はこの形式で出力されました。スキルの素の動作を確かめたい場合は、CLAUDE.md の影響を考慮して結果を読む必要があります。
常時追加されるトークンとスコープ
claude plugin details によると、このプラグインを有効にするとセッションごとに約 4,908 トークンが常に追加されます。README では、スキル間の依存関係があるため 11 スキルをまとめてインストールするよう案内されています。今回は project スコープでインストールしたため、有効になるのは検証用ディレクトリだけでした。スタートアップ向けの相談をするリポジトリに限って有効にしたい場合は、project スコープや local スコープが使えます。
今後に期待すること
- 同梱の参照資料(料金の目安など)が、現在の料金体系に合わせて更新されること
最後に
Agent Toolkit for AWS のマーケットプレースから aws-startup-advisor をインストールし、architect-for-startups に Pre-revenue と Series A の 2 つの段階で相談してみました。前提が足りなければ質問し、段階に合わせて推奨と見送るものを切り替え、見送るものには追加するきっかけを付けるという、SKILL.md に書かれた流れどおりの回答が返ってきました。一方で、回答中の金額には同梱資料由来の古い値が混ざることがあったため、コストの判断には料金ページや AWS Pricing Calculator での確認が欠かせません。
今回は AWS API を呼び出さない architect-for-startups だけを試しました。プラグインには heroku-to-aws や llm-to-bedrock など、Terraform やコードの書き換えまで行うスキルも含まれているので、別の記事で試してみたいと思います。スタートアップで AWS の構成を検討している方は、予算・人数・クレジット・トラフィック・致命的な要素を最初のプロンプトに書いたうえで相談してみてください。
この記事がどなたかのお役に立てば幸いです。
合わせて読みたい