AWS Batch のジョブの成功数や待ち時間が Amazon CloudWatch で見られるようになったので試してみた

はじめに
2026 年 10 月 6 日のアップデートで、AWS Batch がジョブのメトリクスを CloudWatch に自動で発行するようになりました。ジョブメトリクスとは、ジョブキューに投入したジョブの動きを数値にしたものです。ジョブは投入から終了までに SUBMITTED、RUNNABLE、RUNNING、SUCCEEDED などの状態を移ります。状態ごとに何件のジョブが入ったかという件数と、キューで待った時間や実行時間などの所要時間が記録されます。実際に試して確認してみました。
確認結果
ジョブキューには AWS Fargate のコンピュート環境を使いました。成功するジョブを 3 つ、リトライ後に失敗するジョブを 1 つ流しました。結果は CloudWatch コンソールと AWS Batch コンソールのグラフで確認しています。
- 何も設定しなくても、ジョブを流したジョブキューに 13 個のメトリクスが記録されていた
- AWS Batch コンソールのダッシュボードとジョブキューの画面で、メトリクスのグラフを確認できた
JobAttemptExecutionDurationにはタスクの停止待ちが含まれ、コンテナの実行時間より 23〜25 秒長かった
アップデートの概要
今回のアップデートで、AWS Batch 自身がジョブキュー単位のメトリクスを自動で発行するようになりました。メトリクスの発行に追加料金はかかりません。
キューに今何件のジョブが滞留しているのかは今回のメトリクスでは取得できません。メトリクスに記録されるのは各状態に入った件数で、その時点で各状態にいるジョブ数ではないためです。滞留している件数を監視したい場合は、以下の記事で紹介している方法が引き続き有効です。
公式ドキュメントから仕様確認
今回追加されたメトリクスはベストエフォートで発行されます。公式ドキュメントでは監視向けとされ、課金や監査のように正確な件数が必要な用途には使わないよう案内されています。
- 名前空間は
AWS/Batchで、ディメンションはJobQueueNameの 1 つ - 単位は件数のメトリクスが
Count、所要時間のメトリクスがMilliseconds - メトリクスは 21 個。うち 5 個は Amazon SageMaker AI のトレーニングジョブ向けのサービスジョブ専用
- すぐ終わるジョブでは RUNNING への遷移が欠落することもある
検証環境
構築手順自体は省略します。次のリソースを用意しました。
| 項目 | 値 |
|---|---|
| 確認日 | 2026/10/17 |
| リージョン | ap-northeast-1 |
| コンピュート環境 | batch-metrics-demo-fargate(Fargate のマネージド環境) |
| ジョブキュー | batch-metrics-demo-queue |
ジョブ定義はどちらも ecsProperties 形式です。すぐ終わるジョブでは RUNNING への遷移が欠落することもあるので、どちらも sleep で待たせています。失敗ジョブの定義はリトライ戦略で試行回数を 2 にしているので、終了コード 1 で失敗すると 1 回リトライされます。
| ジョブ定義 | コマンド | 試行回数 |
|---|---|---|
batch-metrics-demo-success |
sh -c "sleep 60" |
1 回 |
batch-metrics-demo-fail |
sh -c "sleep 30; exit 1" |
最大 2 回 |
成功ジョブ 3 つと、失敗ジョブ 1 つ流してみる
メトリクスごとに件数が違う値になるよう成功ジョブは 3 つ、失敗ジョブを 1 つ続けて投入しました。
for i in 1 2 3; do
  aws batch submit-job --region ap-northeast-1 \
    --job-name metrics-success-$i \
    --job-queue batch-metrics-demo-queue \
    --job-definition batch-metrics-demo-success \
    --query jobId --output text
done
aws batch submit-job --region ap-northeast-1 \
  --job-name metrics-fail-1 \
  --job-queue batch-metrics-demo-queue \
  --job-definition batch-metrics-demo-fail \
  --query jobId --output text
失敗ジョブは 1 回目の試行が終わると RUNNABLE へ戻り、2 回目の試行を終えて FAILED になりました。
本題のメトリクスを確認してみる
何も設定しなくても 13 個のメトリクスは記録されていた
ジョブがすべて終わった後、CloudWatch コンソールの「すべてのメトリクス」を開きました。「参照」タブで「Batch」から JobQueueName を開くと、ジョブキューのメトリクスが 13 個表示されています。名前空間は AWS/ を外した「Batch」の名前で表示されます。
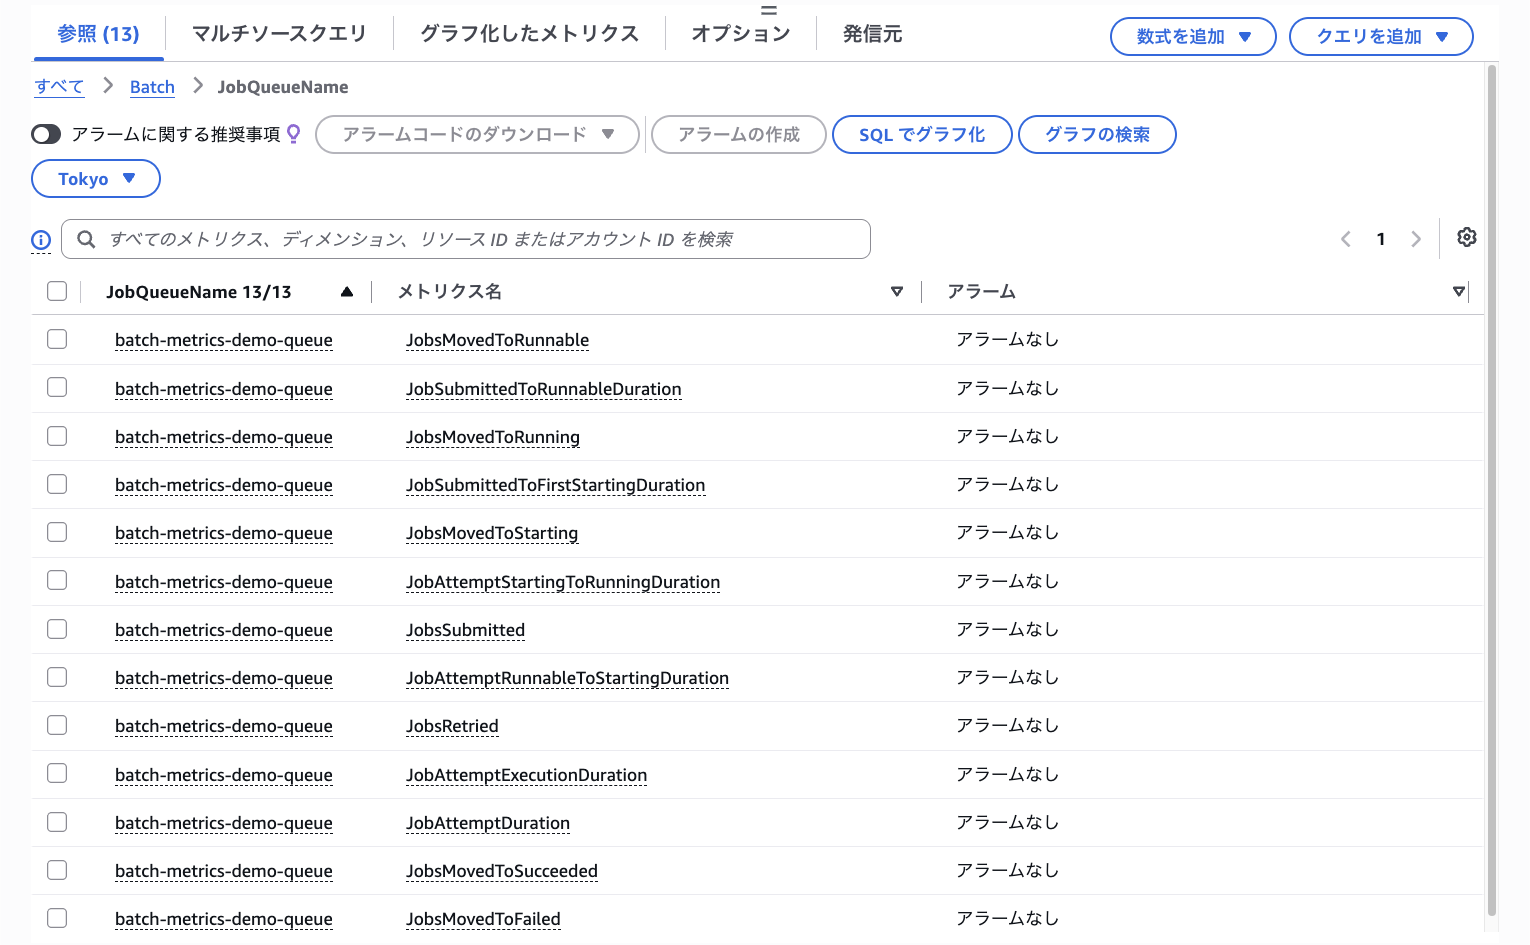
内訳は件数のメトリクス 7 個と所要時間のメトリクス 6 個です。依存関係の無いジョブは PENDING にならず、SUBMITTED から RUNNABLE へ直接進みます。そのため JobsMovedToPending は出ませんでした。キャンセルと終了もしていないので JobsCancelled と JobsTerminated もなく、サービスジョブ専用の 5 個も同様です。
ダッシュボードではメトリクスごとに別のグラフで表示された
AWS Batch コンソールではダッシュボードとジョブキューの詳細画面でグラフを確認できます。
ナビゲーションの「ダッシュボード」には「Batch リソース」と「バッチメトリクス - 新機能」のタブがあります。次の画面は「バッチメトリクス - 新機能」タブを開いた状態です。トグル「CloudWatch メトリクスの表示」はオフで、タブの説明と料金の注記が表示されています。
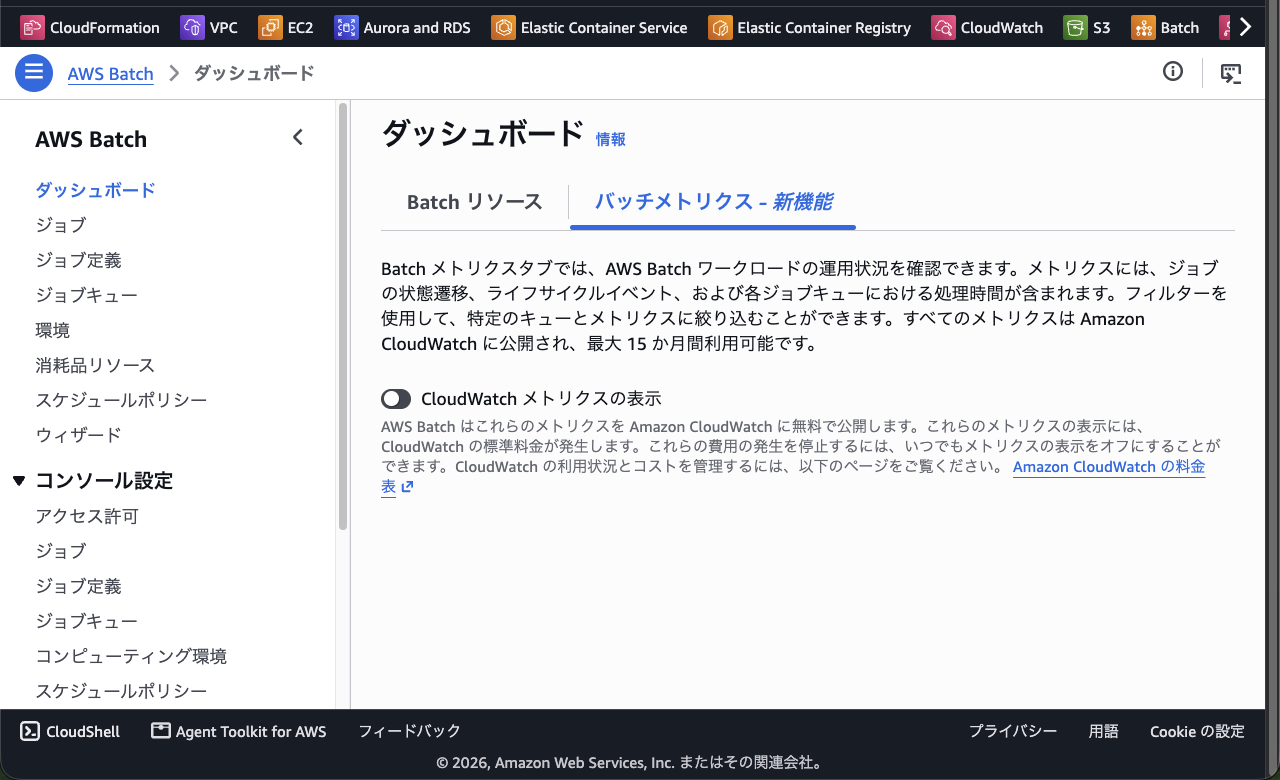
注記によると、メトリクスの公開は無料で、表示には CloudWatch の標準料金がかかります。トグルをオンにしても確認ダイアログは出ませんでした。
オンにすると「指標をフィルタリングする」パネルが出ます。「ジョブキュー」は最大 5 つ選べます。「メトリクス」の候補は、状態遷移、ライフサイクルイベント、期間の 3 グループに分かれていました。デフォルトではアカウント内の別のジョブキューが選ばれていたので、対象のキューが選ばれているかを確認してから適用してください。
ジョブキューを batch-metrics-demo-queue だけにし、メトリクスを 7 個選んだ状態です。
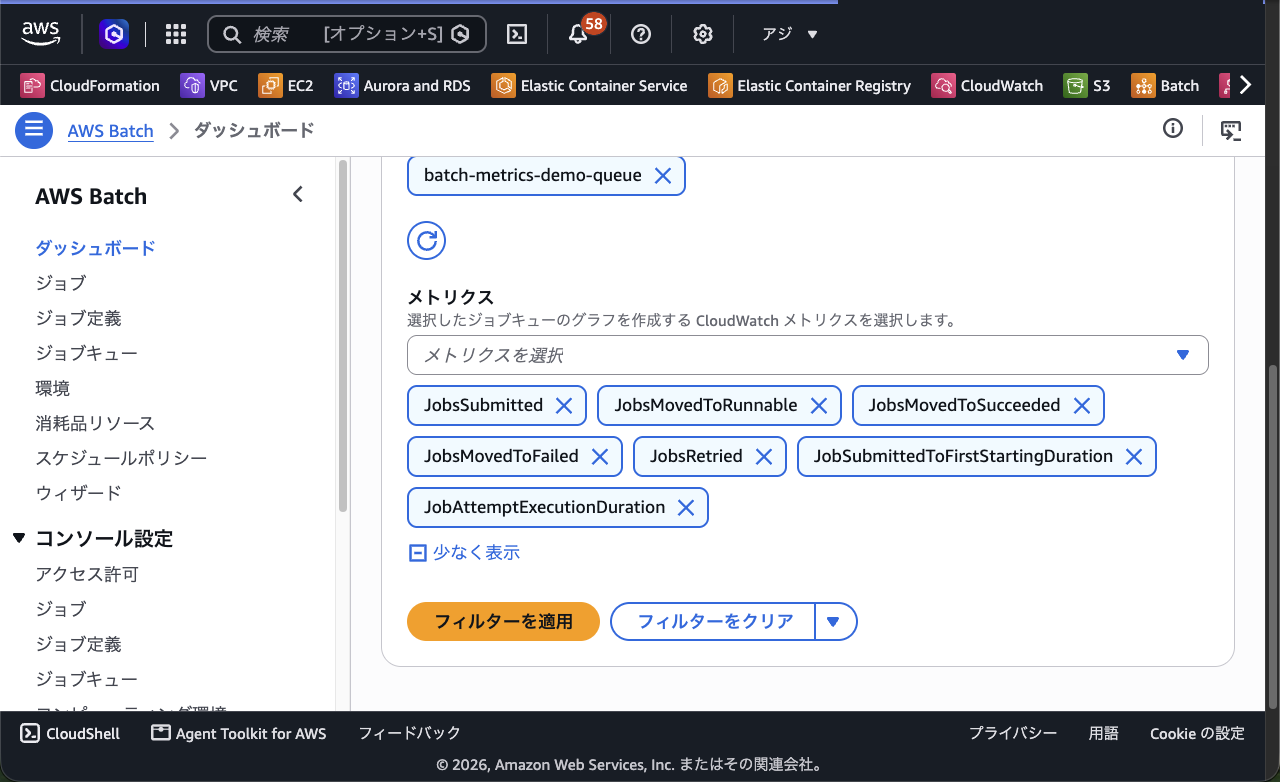
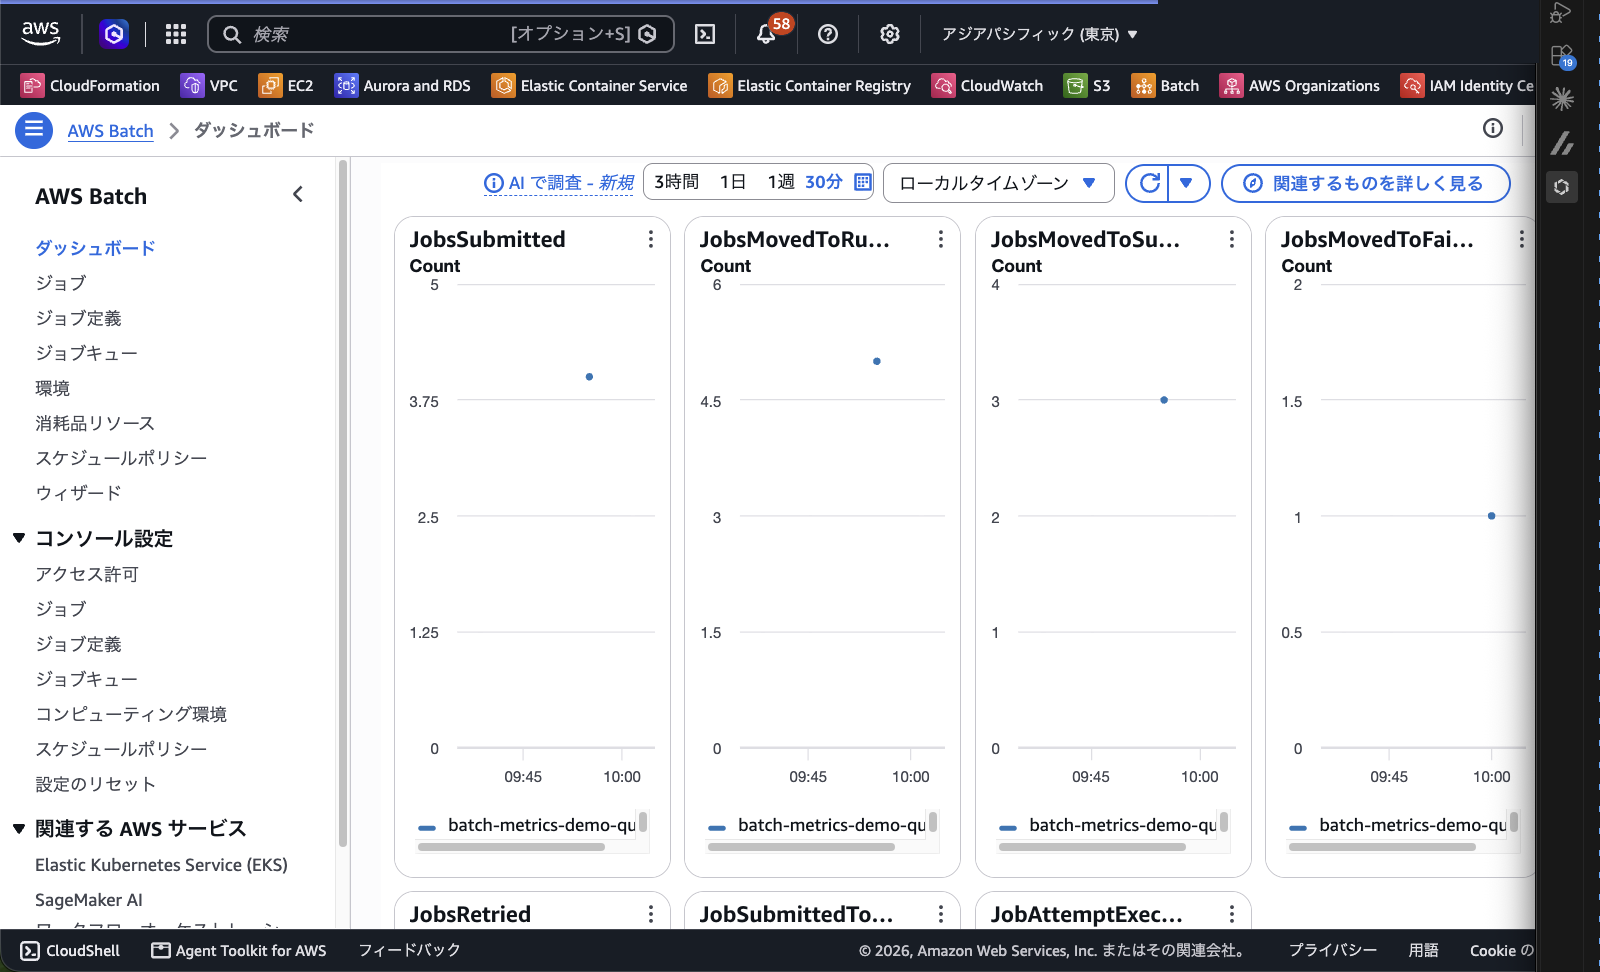
「フィルターを適用」を押すとメトリクスごとにグラフが 1 つずつ表示されました。期間は相対値で「30 分」にしています。
メトリクスと実際に流したジョブを比較してみる
1 段目にある件数のグラフです。JobsSubmitted が 4、JobsMovedToRunnable が 5、JobsMovedToSucceeded が 3、JobsMovedToFailed が 1 です。
2 段目には JobsRetried の 1 と、所要時間のグラフ 2 つが表示されています。所要時間のグラフは後半で扱います。
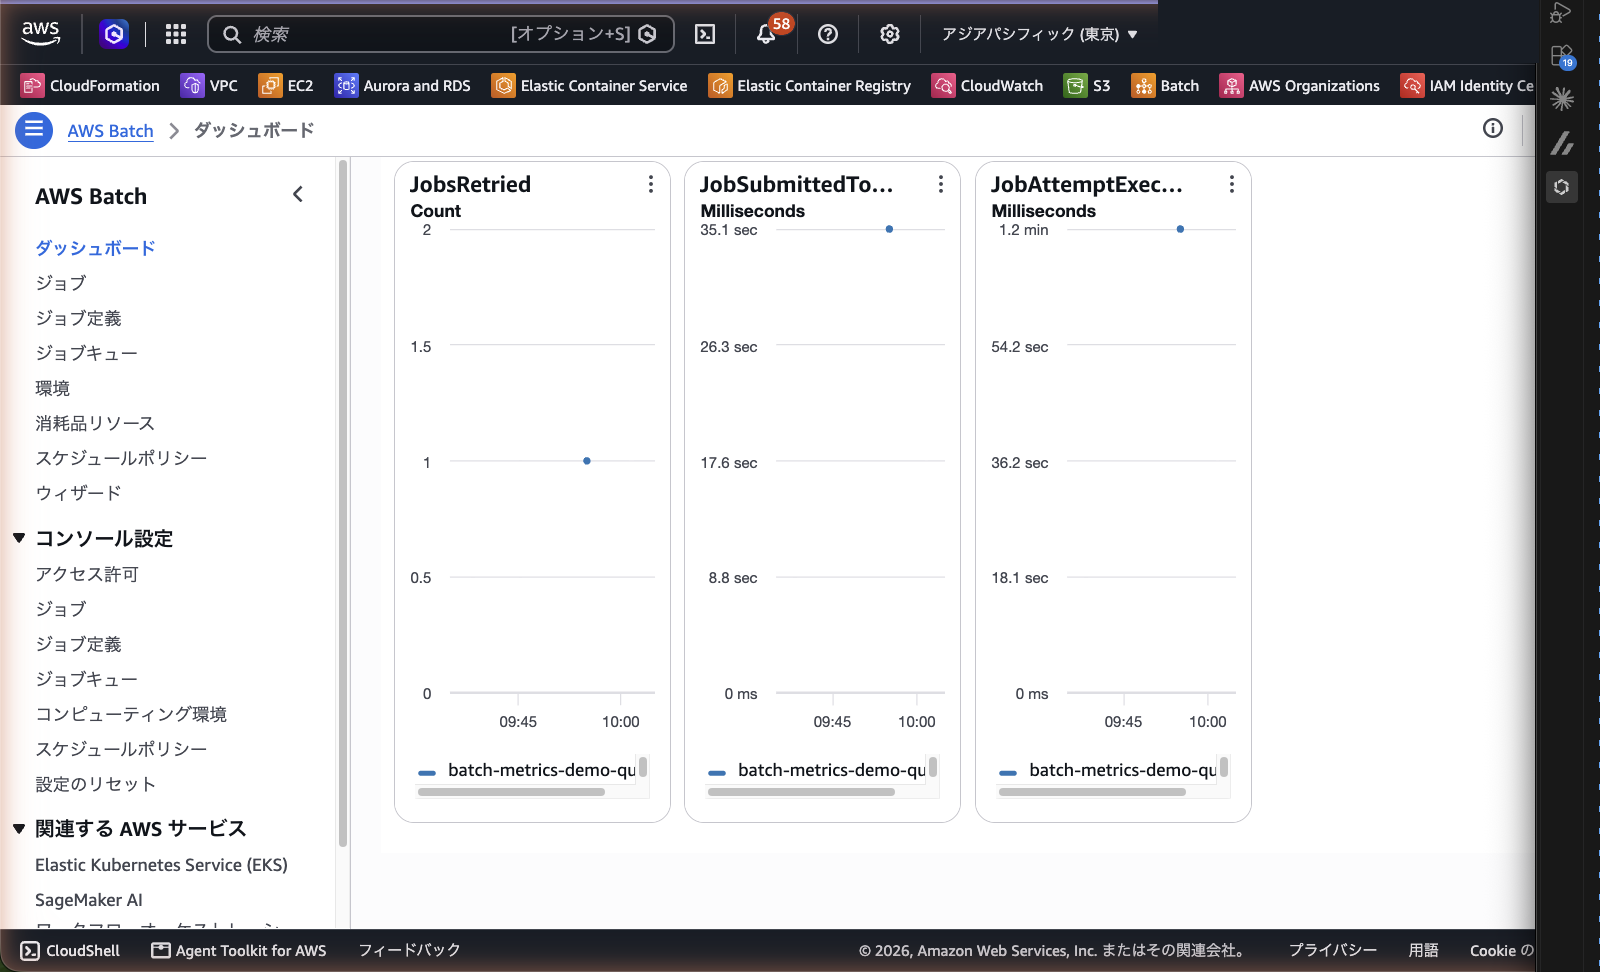
グラフの値を流したジョブと突き合わせると、次のとおりです。JobsMovedToRunnable だけは投入した数より 1 多く、リトライで RUNNABLE に戻った回も数えています。
| メトリクス | グラフの値 | 内訳 |
|---|---|---|
JobsSubmitted |
4 | 投入した 4 つ |
JobsMovedToRunnable |
5 | 4 つとリトライで戻った 1 回分が追加 |
JobsMovedToSucceeded |
3 | 成功ジョブ 3 つ |
JobsMovedToFailed |
1 | 失敗ジョブ 1 つ |
JobsRetried |
1 | 失敗ジョブの 1 回目の試行 |
どれも流したジョブの結果どおりでした。
ジョブキューの画面からもメトリクスを確認できるようになっている
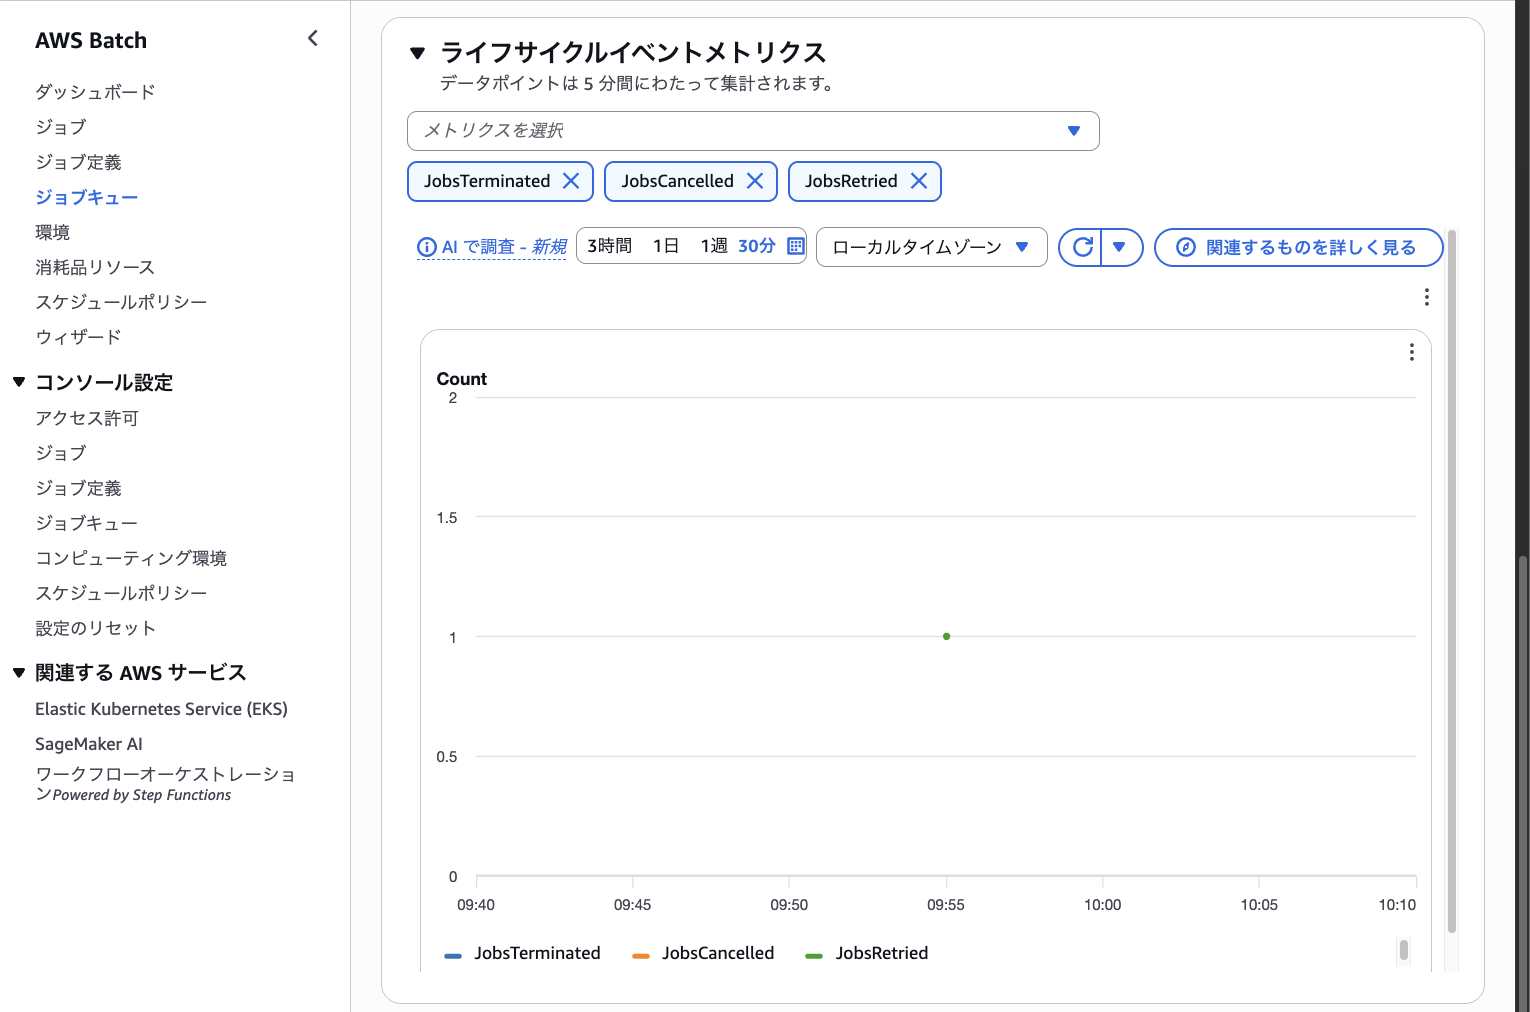
ナビゲーションの「ジョブキュー」からキューを開くと、「モニタリング - 新機能」タブがあります。グラフは「状態遷移メトリクス」、「ライフサイクルイベントメトリクス」、「期間メトリクス」の 3 つです。どのグラフにも、選んだメトリクスが色違いで表示されます。共通するメトリクスの値はダッシュボードと同じでした。期間はどれも 30 分にしています。
「状態遷移メトリクス」はデフォルトで設定されている 4 つのままです。
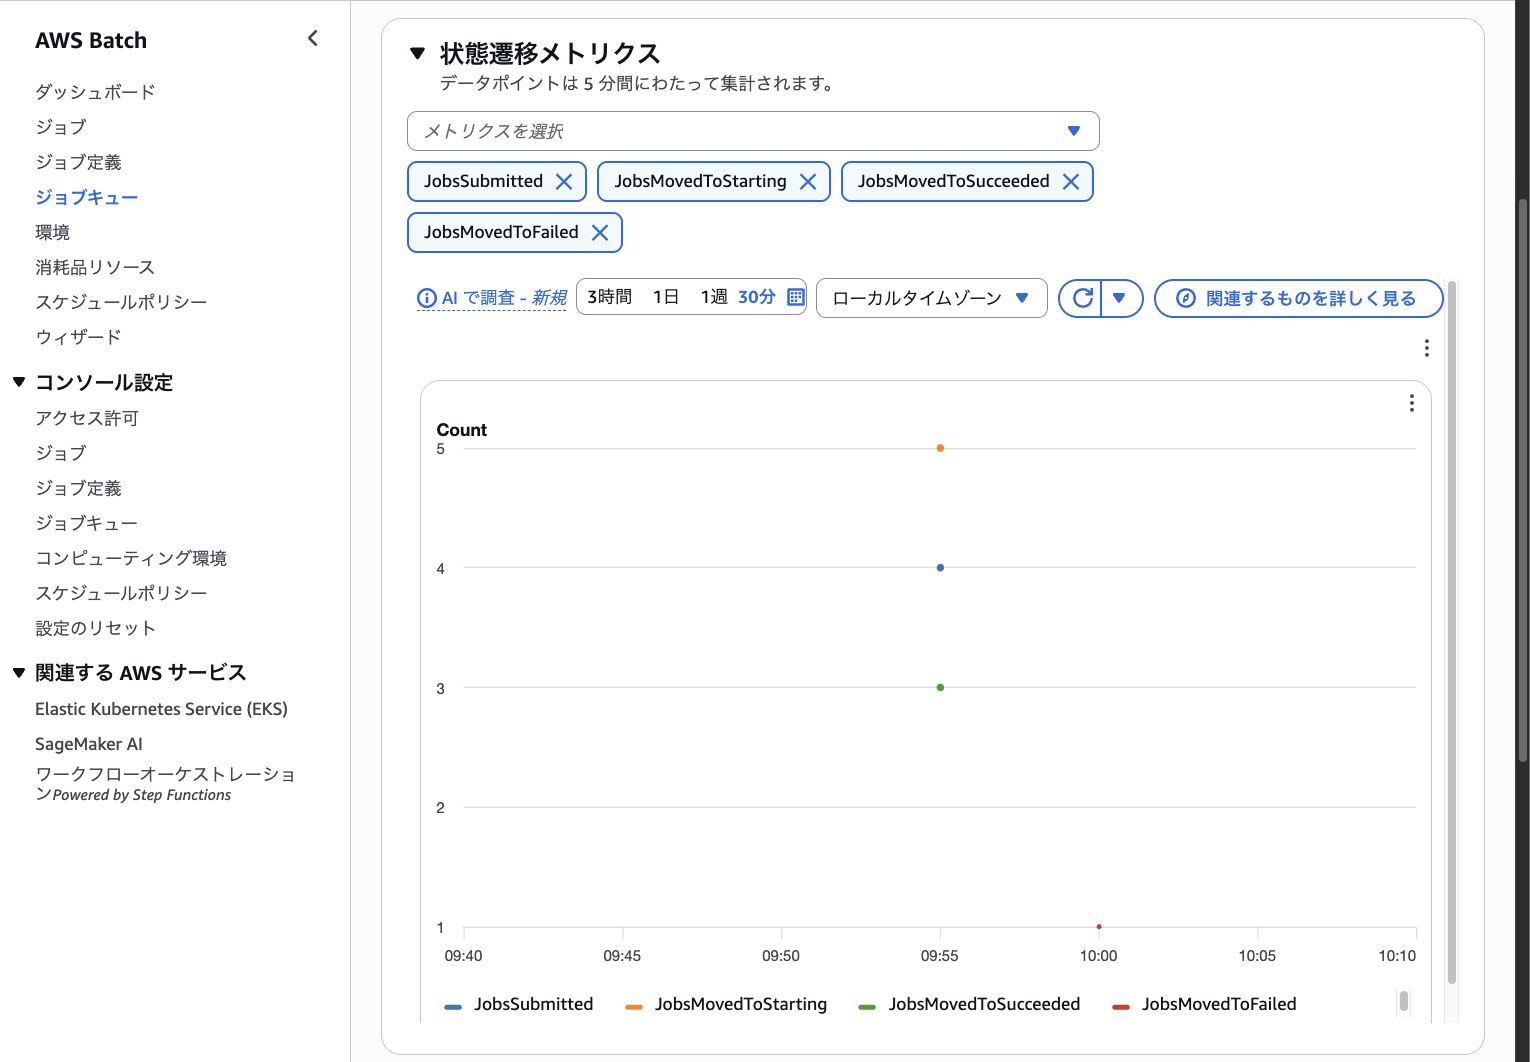
「ライフサイクルイベントメトリクス」には JobsRetried を追加しました。
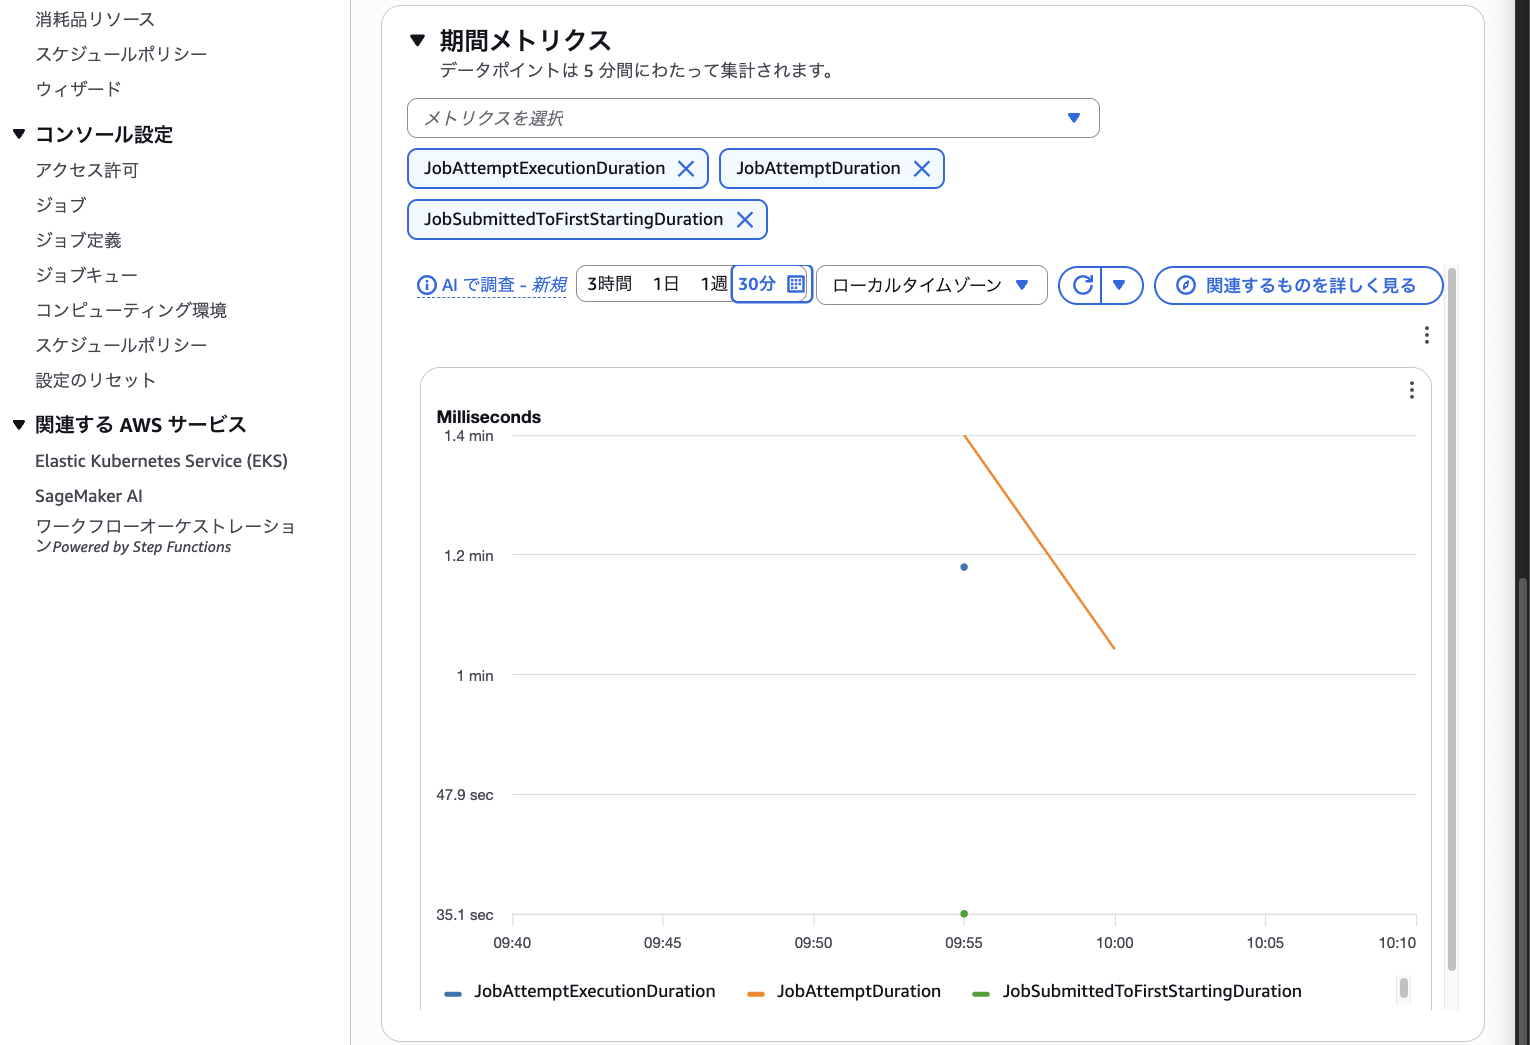
「期間メトリクス」は、デフォルトで設定されている 3 つのうち 2 つがサービスジョブ専用でした。JobAttemptScheduledToStartingDuration と JobAttemptRunnableToScheduledDuration です。コンピュートジョブのキューではデータが出ません。今回は JobSubmittedToFirstStartingDuration と JobAttemptDuration に入れ替えています。
JobAttemptExecutionDuration にはタスクの停止待ちが含まれていた
JobAttemptExecutionDuration は試行の実行時間のメトリクスです。グラフの値は 1.2 min でした。成功ジョブは sleep 60 を 3 回、失敗ジョブは sleep 30 を 2 回実行しています。sleep だけなら 5 試行の平均は 48 秒です。グラフの値はそれより 24 秒ほど長くなっていました。
理由を調べるため、describe-jobs で試行ごとの時刻を取得しました。ecsProperties 形式のジョブ定義では attempts[].container.exitCode が null になります。終了コードは attempts[].taskProperties[0].containers[0].exitCode から取っています。
aws batch describe-jobs --region ap-northeast-1 \
  --jobs <ジョブ ID 4 つ> \
  --query 'jobs[].{name:jobName,status:status,createdAt:createdAt,startedAt:startedAt,stoppedAt:stoppedAt,attempts:attempts[].{startedAt:startedAt,stoppedAt:stoppedAt,exitCode:taskProperties[0].containers[0].exitCode,reason:statusReason}}'
時刻はミリ秒の UNIX 時間で返ります。試行ごとの stoppedAt - startedAt(以下、試行時間)は次のとおりでした。
| ジョブ | 試行 | 終了コード | 試行時間(ミリ秒) |
|---|---|---|---|
| metrics-success-1 | 1 | 0 | 84,212 |
| metrics-success-2 | 1 | 0 | 85,165 |
| metrics-success-3 | 1 | 0 | 83,370 |
| metrics-fail-1 | 1 | 1 | 55,328 |
| metrics-fail-1 | 2 | 1 | 53,452 |
成功ジョブは sleep 60 で 83〜85 秒、失敗ジョブは sleep 30 で 53〜55 秒かかっていました。5 試行の平均は 72,305 ミリ秒で、グラフの 1.2 min と一致します。
試行時間がコンテナの実行時間より長い理由を見るため、Batch が起動した ECS のタスクの時刻も取得しました。タスク ARN は先ほどの --query には含めていませんが、describe-jobs の出力の attempts[].taskProperties[0].taskArn にあります。
aws batch describe-compute-environments --region ap-northeast-1 --compute-environments batch-metrics-demo-fargate \
  --query 'computeEnvironments[0].ecsClusterArn' --output text
aws ecs describe-tasks --region ap-northeast-1 \
  --cluster <コンピュート環境の ECS クラスター ARN> \
  --tasks <タスク ARN 1> <タスク ARN 2> <タスク ARN 3> <タスク ARN 4> <タスク ARN 5> \
  --query 'tasks[].{task:taskArn,createdAt:createdAt,pullStartedAt:pullStartedAt,pullStoppedAt:pullStoppedAt,startedAt:startedAt,executionStoppedAt:executionStoppedAt,stoppingAt:stoppingAt,stoppedAt:stoppedAt,group:group}'
metrics-success-1 のタスクを抜粋します。Batch の試行は 09:57:50.791 に始まり、09:59:15.003 に停止しています。ECS の startedAt と stoppedAt の 2 行に注目します。
3d251770ff864160ad5f911e3b2ad3c4 family:batch-metrics-demo-success
   createdAt 2026-10-17T09:57:28.841000+09:00
   pullStartedAt 2026-10-17T09:57:43.886000+09:00
   pullStoppedAt 2026-10-17T09:57:50.749000+09:00
+  startedAt 2026-10-17T09:57:50.791000+09:00
   executionStoppedAt 2026-10-17T09:58:50.795000+09:00
   stoppingAt 2026-10-17T09:59:00.846000+09:00
+  stoppedAt 2026-10-17T09:59:15.003000+09:00
   startedAt->executionStoppedAt 60.004 s
+  executionStoppedAt->stoppedAt 24.208 s
Batch の試行の startedAt は、ECS のタスクの startedAt(コンテナ起動)と一致しました。stoppedAt も ECS のタスクの stoppedAt(タスク停止完了)と同じです。コンテナが動いていた startedAt から executionStoppedAt までは、sleep の秒数どおり 60 秒でした。
ほかの 4 タスクも同様で、コンテナの実行時間は 60.0 秒か 30.0 秒です。試行時間との差の 23〜25 秒は、コンテナ終了からタスク停止完了までの停止待ちでした。
JobAttemptExecutionDuration は、コンテナの実行時間にタスクの停止待ちを足した時間でした。公式ドキュメントの説明は「試行が実行を始めてから停止するまで」で、この停止はタスクの停止完了を指していました。今回の Fargate の環境では、23〜25 秒の停止待ちがグラフの値に上乗せされていました。ジョブの処理時間の目安として見るときは注意してください。
まとめ
AWS Batch のジョブメトリクスは、何も設定しなくてもジョブを実行するとジョブキュー単位で記録されました。AWS Batch コンソールのダッシュボードとジョブキューの画面でグラフを確認でき、カウントされていた件数は流したジョブの結果どおりでした。今回 Fargate で試した JobAttemptExecutionDuration にはタスクの停止待ちが含まれ、コンテナの実行時間より 23〜25 秒長くなっていました。
おわりに
今回はジョブの状態遷移のメトリクスの追加でした。以前、シェア別の vCPU 利用率が CloudWatch で取れず、標準メトリクス化を期待していましたがこちらはまだ来ません。需要はないのかもしれない。