AWS Parallel Computing Service がスケーリングログに対応したので試してみた

はじめに
AWS Parallel Computing Service(AWS PCS)は、Slurm の HPC クラスターのマネージドサービスです。2026 年 9 月にスケーリングログが追加され、コンピュートノードの起動や終了が理由付きで記録されるようになりました。動的ノードグループの起動から終了までを中心に、どのような内容がログに記録されるかを試してみました。
スケーリングログとは
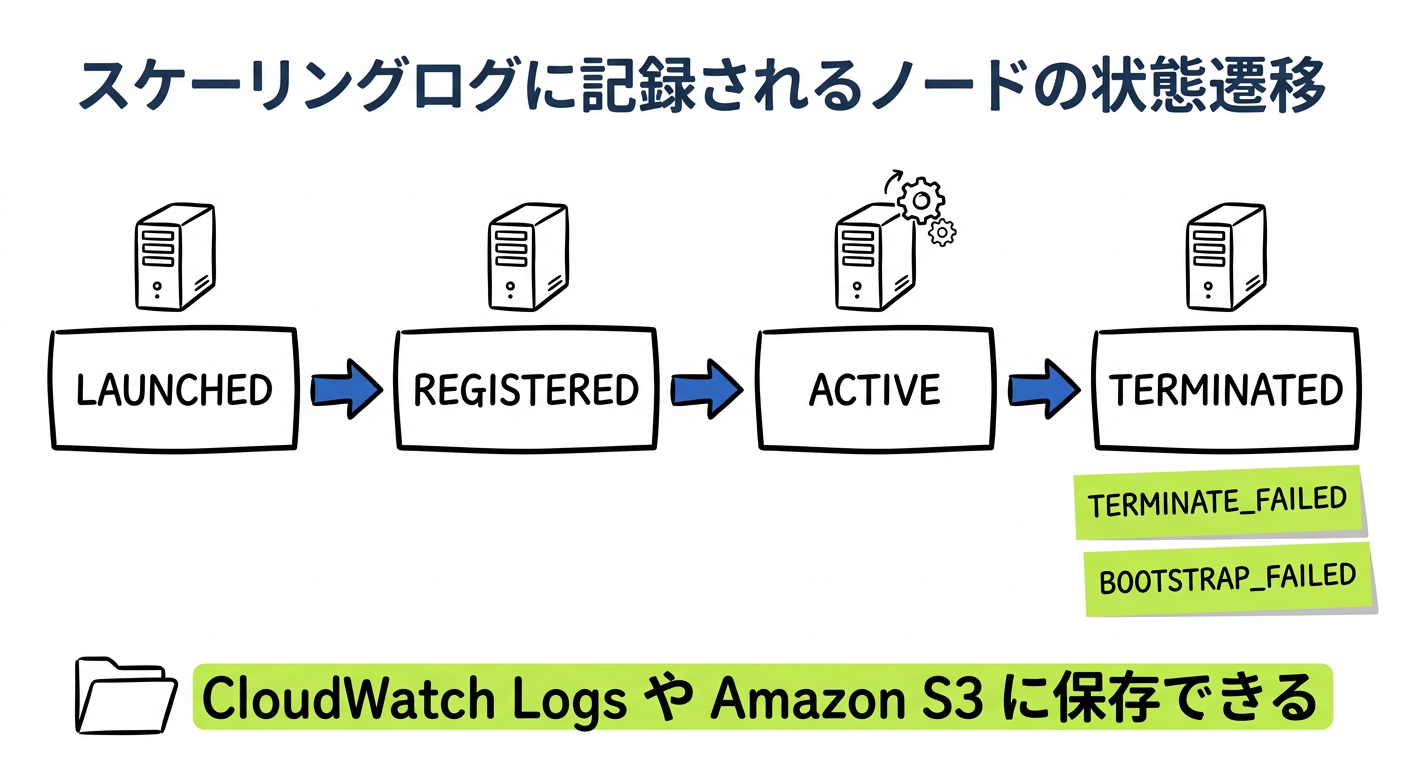
スケーリングログは、クラスター内のコンピュートノードの状態遷移を 1 件ずつ JSON で記録するログです。status_code が遷移後の状態、reason_code が遷移の理由を表します。キャパシティ不足で起動できなかった場合は LAUNCH_FAILED / INSUFFICIENT_CAPACITY のように記録されます。
ノードがなぜ起動し、なぜ終了したかを status_code や reason_code の値で絞り込めます。Slurm のログを文字列で追わずに済むのが嬉しい点です。PCS のログには既にスケジューラーログ、スケジューラー監査ログ、ジョブ完了ログがあります。スケーリングログと性質の近い 2 つを比べると次のとおりです。
| 項目 | スケーリングログ(New) | スケジューラーログ | ジョブ完了ログ |
|---|---|---|---|
| 内容 | ノードの状態遷移 | slurmctld などのデーモンログ | ジョブ終了時のメタデータ |
| logType | PCS_SCALING_LOGS |
PCS_SCHEDULER_LOGS |
PCS_JOBCOMP_LOGS |
| ストリーム | AWSLogs/PCS/{id}/node_lifecycle.log |
AWSLogs/PCS/{id}/{log_name}_{major}.log |
AWSLogs/PCS/{id}/jobcomp.log |
| event_timestamp | ミリ秒 | 例では秒とミリ秒が混在 | 秒 |
公式ドキュメントでは仕様が次のように示されています。
- 配信はオプトインで、配信を設定するまでログは出ない
- 配信元はクラスター単位
- ノードグループは各レコードの
compute_node_group_idで見分ける - 出力先は CloudWatch Logs、Amazon S3、Amazon Data Firehose から最大 3 つまで設定できる
出力先ごとに選べる出力形式は、配信の設定テンプレート(aws logs describe-configuration-templates)で確認しました。
| 出力先 | 出力形式 |
|---|---|
| CloudWatch Logs | plain、json |
| Amazon S3 | plain、json、w3c、parquet |
| Amazon Data Firehose | plain、json、raw |
スケーリングログという名前ですが、ストリーム名に「scaling」は入らず、node_lifecycle.log になります。ロググループの中から探すときは注意してください。
検証環境
スケーリングログの配信を設定した既存のクラスターに、動的ノードグループ dyn-cng とキュー dyn-queue を追加して確認しました。クラスターの構築手順は省略します。PCS クラスターの構築は次の記事を参考にしてください。
| 項目 | 値 |
|---|---|
| リージョン | ap-northeast-1 |
| Slurm | 26.05 |
| 動的ノードグループ | c7i.large、最小 0 台、最大 1 台 |
| アイドル時間 | クラスター既定の 600 秒(scaleDownIdleTimeInSeconds、ノードグループでは指定なし) |
| スケーリングログの出力先 | CloudWatch Logs |
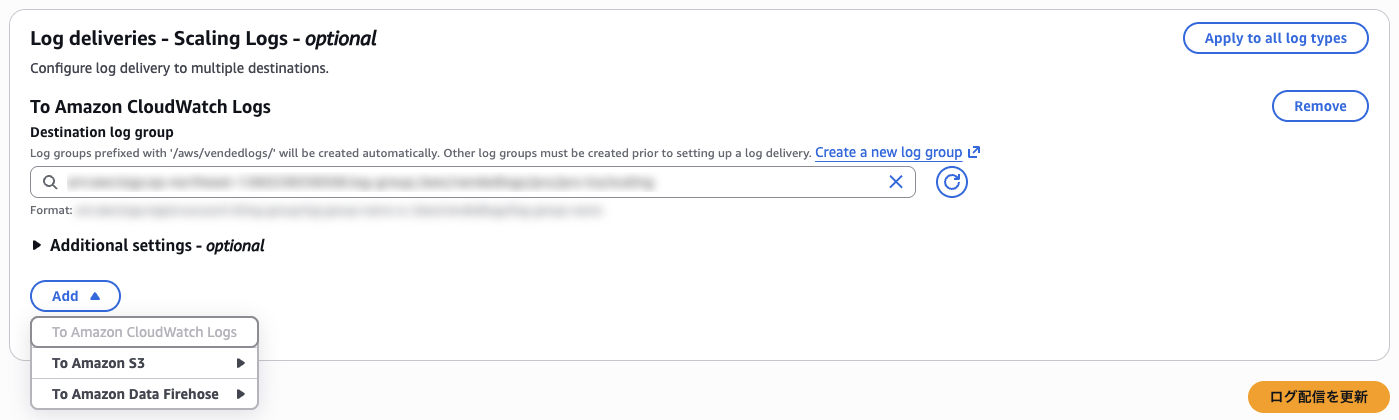
配信の設定は、コンソールのクラスター詳細にある「ログ」タブの「Log deliveries - Scaling Logs」で行います。CloudWatch Logs を配信先に設定した状態で「Add」を開くと、S3 と Firehose も選べました。
動的ノードグループの起動から終了までを確認してみる
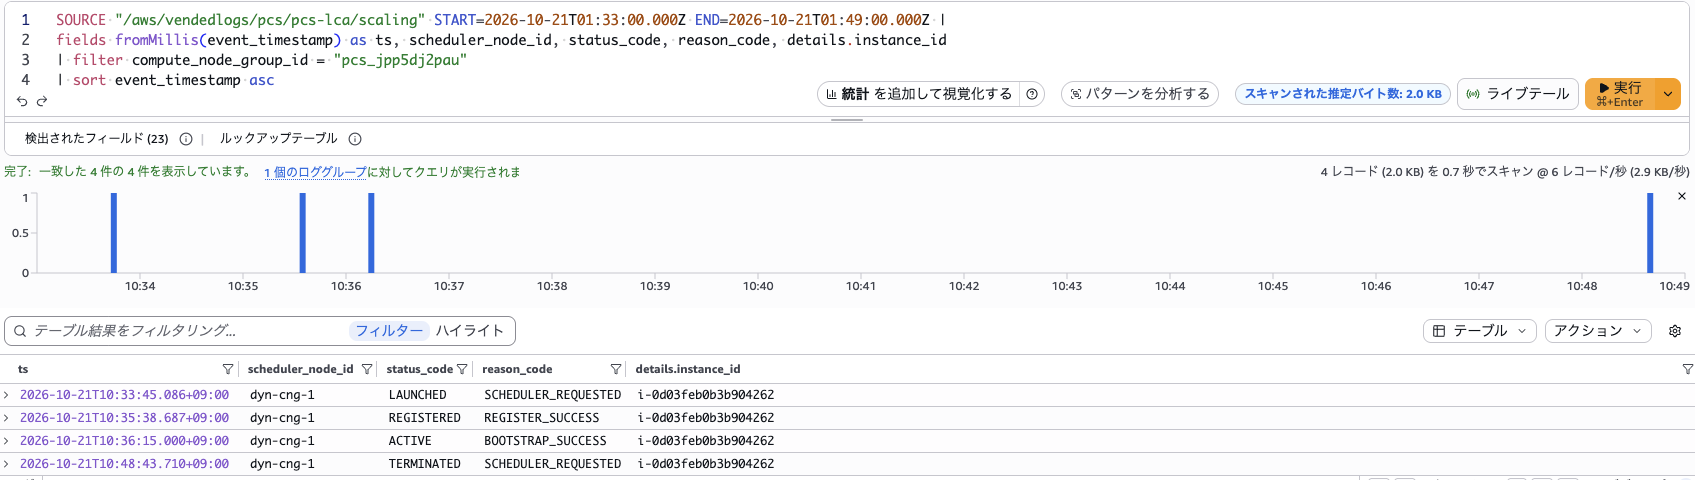
ログインノードから短いジョブを 1 件投入し、スケールダウンされるまで待ちました。この間に動的ノードグループで記録されたのは次の 4 件です。status_code は LAUNCHED、REGISTERED、ACTIVE、TERMINATED と進みました。details にはインスタンス ID、インスタンスタイプ、サブネットが入っています。
{"resource_id":"pcs_c5jwrhddlj","event_timestamp":1792546425086,"id":"519227d4-750e-433e-8ff3-29e3b27f30d3","resource_type":"PCS_CLUSTER","compute_node_group_id":"pcs_jpp5dj2pau","scheduler_node_id":"dyn-cng-1","status_code":"LAUNCHED","reason_code":"SCHEDULER_REQUESTED","description":"Instance launched to satisfy a scheduler scale-up request.","details":{"instance_id":"i-0d03feb0b3b904262","subnet_id":"subnet-01ae32fc2479e77ad","instance_type":"c7i.large"}}
{"resource_id":"pcs_c5jwrhddlj","event_timestamp":1792546538687,"id":"80aa1762-741c-43d2-b441-2993bc59b83a","resource_type":"PCS_CLUSTER","compute_node_group_id":"pcs_jpp5dj2pau","scheduler_node_id":"dyn-cng-1","status_code":"REGISTERED","reason_code":"REGISTER_SUCCESS","description":"Node registered successfully via the PCS agent.","details":{"instance_id":"i-0d03feb0b3b904262","subnet_id":"subnet-01ae32fc2479e77ad","instance_type":"c7i.large"}}
{"resource_id":"pcs_c5jwrhddlj","event_timestamp":1792546575000,"id":"904ebda8-49ff-4984-b9a8-f1ce132e9717","resource_type":"PCS_CLUSTER","compute_node_group_id":"pcs_jpp5dj2pau","scheduler_node_id":"dyn-cng-1","status_code":"ACTIVE","reason_code":"BOOTSTRAP_SUCCESS","description":"Node bootstrap completed; slurmd is running and accepting jobs.","details":{"instance_id":"i-0d03feb0b3b904262","subnet_id":"subnet-01ae32fc2479e77ad","instance_type":"c7i.large"}}
{"resource_id":"pcs_c5jwrhddlj","event_timestamp":1792547323710,"id":"a7d60ead-d5e5-43c8-ae71-ae97504d1679","resource_type":"PCS_CLUSTER","compute_node_group_id":"pcs_jpp5dj2pau","scheduler_node_id":"dyn-cng-1","status_code":"TERMINATED","reason_code":"SCHEDULER_REQUESTED","description":"Instance terminated after the scheduler suspended the node (idle timeout or user initiated power-down).","details":{"instance_id":"i-0d03feb0b3b904262","subnet_id":"subnet-01ae32fc2479e77ad","instance_type":"c7i.large"}}
ジョブが完了してノードがアイドルになった時点のレコードはありませんでした。公式ドキュメントの status_code の一覧にも、アイドルに当たる値はありませんでした。
CloudWatch Logs Insights では event_timestamp を fromMillis でそのまま時刻に変換できました。次のクエリでは動的ノードグループの ID(pcs_jpp5dj2pau)で絞り込み、時刻順の表にします。
fields fromMillis(event_timestamp) as ts, scheduler_node_id, status_code, reason_code, details.instance_id
| filter compute_node_group_id = "pcs_jpp5dj2pau"
| sort event_timestamp asc
コンソールで実行すると、同じ 4 件が status_code と reason_code の列で表示されました。
終了保護で終了できないときの記録を確認してみる
もう一度ジョブを投入し、ジョブの完了から 20 秒後にインスタンスの EC2 終了保護(DisableApiTermination)を有効にしました。最初の終了の失敗は、ジョブ完了から 671 秒後に次のレコードで記録されました。reason_code は EC2_OPERATION_NOT_PERMITTED で、description には終了保護が有効でないか確認するよう書かれています。details の ec2_error_code も OperationNotPermitted で、それ以上の情報はありませんでした。
{"resource_id":"pcs_c5jwrhddlj","event_timestamp":1792548403939,"id":"fbf37ce0-bad4-4644-a661-38cdd371310c","resource_type":"PCS_CLUSTER","compute_node_group_id":"pcs_jpp5dj2pau","scheduler_node_id":"dyn-cng-1","status_code":"TERMINATE_FAILED","reason_code":"EC2_OPERATION_NOT_PERMITTED","description":"Instance termination failed. Ensure termination protection is not enabled on the instance.","details":{"instance_id":"i-0dd215e22ab8c817b","ec2_error_code":"OperationNotPermitted","subnet_id":"subnet-01ae32fc2479e77ad","instance_type":"c7i.large"}}
失敗は 1 件では終わりませんでした。終了は約 60 秒ごとに再試行され、そのたびに TERMINATE_FAILED が 1 件ずつ記録されました。CloudWatch Logs の JSON フィルターパターンで TERMINATE_FAILED だけを取り出し、件数を数えます。
aws logs filter-log-events --region ap-northeast-1 \
  --log-group-name /aws/vendedlogs/pcs/pcs-lca/scaling \
  --start-time 1792548000000 \
  --filter-pattern '{ $.status_code = "TERMINATE_FAILED" }' \
  --query 'events[].message' --output json \
  | python3 -c 'import json,sys; ms=json.load(sys.stdin); print(len(ms), "records"); [print(m) for m in ms[:2]]'
終了保護を解除するまでに 8 件が記録されていました。件数の行だけを載せます。
8 records
ノードグループで絞る場合は、フィルターパターンを { $.compute_node_group_id = "pcs_jpp5dj2pau" } にすると同じように取り出せました。
終了保護を解除すると、次の再試行で TERMINATED / SCHEDULER_REQUESTED が記録されました。reason_code は通常のスケールダウンと同じでした。
ノードライフサイクルアクションが失敗したときの記録を確認してみる
ノードライフサイクルアクションは、ノードの起動時にスクリプトを実行する PCS の機能です。スクリプトが失敗したときの動作は onError で選びます。TERMINATE はノードを終了します。STOP_SEQUENCE は同じステージの残りのスクリプトを実行せず、ノードを残します。この機能を検証していたときのスケーリングログも取得しました。
検証では 1 つの静的ノードグループ lca-static を更新し、設定を切り替えています。1 台目は成功するスクリプトだけで、起動後に scontrol reboot で OS を再起動しました。2 台目は失敗するスクリプトと STOP_SEQUENCE、3〜5 台目は失敗するスクリプトと TERMINATE です。検証の間に 24 件が記録されていました。先ほどのクエリから filter を外して実行し、3〜21 件目(すべて lca-static-1)を載せます。先頭の 2 件はログインノード、末尾の 3 件は設定を戻した後の起動の記録です。時刻は UTC です。
2026-10-21 00:45:45.164 | lca-static-1 | LAUNCHED | MAINTAIN_MIN_CAPACITY | i-0b5db08fd16459a70
2026-10-21 00:47:21.475 | lca-static-1 | REGISTERED | REGISTER_SUCCESS | i-0b5db08fd16459a70
2026-10-21 00:47:57.000 | lca-static-1 | ACTIVE | BOOTSTRAP_SUCCESS | i-0b5db08fd16459a70
2026-10-21 00:51:43.105 | lca-static-1 | PENDING_REPLACEMENT | NODE_GROUP_UPDATE | i-0b5db08fd16459a70
2026-10-21 00:53:43.679 | lca-static-1 | TERMINATED | REPLACEMENT_REQUESTED | i-0b5db08fd16459a70
2026-10-21 00:55:45.091 | lca-static-1 | LAUNCHED | MAINTAIN_MIN_CAPACITY | i-046cb3897e5a0a6a3
2026-10-21 00:57:03.748 | lca-static-1 | REGISTERED | REGISTER_SUCCESS | i-046cb3897e5a0a6a3
2026-10-21 00:57:52.000 | lca-static-1 | ACTIVE | BOOTSTRAP_SUCCESS | i-046cb3897e5a0a6a3
2026-10-21 01:00:42.882 | lca-static-1 | PENDING_REPLACEMENT | NODE_GROUP_UPDATE | i-046cb3897e5a0a6a3
2026-10-21 01:02:43.574 | lca-static-1 | TERMINATED | REPLACEMENT_REQUESTED | i-046cb3897e5a0a6a3
2026-10-21 01:04:45.032 | lca-static-1 | LAUNCHED | MAINTAIN_MIN_CAPACITY | i-059b4b99b4f2e9739
2026-10-21 01:06:03.214 | lca-static-1 | REGISTERED | REGISTER_SUCCESS | i-059b4b99b4f2e9739
2026-10-21 01:06:42.766 | lca-static-1 | TERMINATED | BOOTSTRAP_FAILED | i-059b4b99b4f2e9739
2026-10-21 01:09:44.713 | lca-static-1 | LAUNCHED | MAINTAIN_MIN_CAPACITY | i-06644f6e5a2b001c9
2026-10-21 01:11:17.979 | lca-static-1 | REGISTERED | REGISTER_SUCCESS | i-06644f6e5a2b001c9
2026-10-21 01:12:42.808 | lca-static-1 | TERMINATED | BOOTSTRAP_FAILED | i-06644f6e5a2b001c9
2026-10-21 01:15:45.427 | lca-static-1 | LAUNCHED | MAINTAIN_MIN_CAPACITY | i-00b99a7657e634e3e
2026-10-21 01:16:42.695 | lca-static-1 | PENDING_REPLACEMENT | NODE_GROUP_UPDATE | i-00b99a7657e634e3e
2026-10-21 01:18:26.856 | lca-static-1 | TERMINATED | REPLACEMENT_REQUESTED | i-00b99a7657e634e3e
レコードからは次のことがわかりました。
- 静的ノードグループの起動は
LAUNCHED / MAINTAIN_MIN_CAPACITYで記録された。更新による置き換え後の起動も同じだった - 更新による置き換えは
PENDING_REPLACEMENT / NODE_GROUP_UPDATE→TERMINATED / REPLACEMENT_REQUESTEDで記録された TERMINATEのノード(i-059b…とi-06644…)はACTIVEを経ずにTERMINATED / BOOTSTRAP_FAILEDで記録されたSTOP_SEQUENCEのノード(2 台目のi-046cb…)は、スクリプトが失敗してもACTIVE / BOOTSTRAP_SUCCESSで記録された- 1 台目の
scontrol rebootによる再起動に当たるレコードは無かった
TERMINATE で終了と起動が繰り返されている間に、ノードグループを更新して設定を戻しました。そのとき起動中だった i-00b99… は、BOOTSTRAP_FAILED ではなく更新による置き換えとして記録されました。
まとめ
AWS PCS のスケーリングログで、コンピュートノードの起動と終了を理由付きで追えるようになりました。CloudWatch Logs Insights や JSON のフィルターパターンで、status_code と reason_code の値を指定して絞り込めます。
動的ノードグループの起動から終了までに記録されたのは 4 件でした。終了保護で終了できない間は、約 60 秒ごとの再試行のたびに TERMINATE_FAILED が記録されました。ノードライフサイクルアクションの失敗は、TERMINATE なら BOOTSTRAP_FAILED で記録されました。STOP_SEQUENCE ではスクリプトが失敗しても ACTIVE / BOOTSTRAP_SUCCESS でした。
おわりに
ノード起動失敗時のトラブルシュート用にログを保存しておくと、切り分けに便利そうです。マネージドサービスということもあり、ユーザー側で確認できる範囲のログは設定しておきたい気持ちになりました。