[Amazon Bedrock] VLM に判定を先に書かせるのを止めて、外観検査の検出率を比べてみました 〜Jev のドキュメントにヒントを得て〜

1 はじめに
製造ビジネステクノロジー部の平内(SIN)です。
前回、洗濯ばさみを題材に、Amazon Bedrock の VLM(Claude Haiku 4.5)で外観検査を試しました。
[Amazon Bedrock] 洗濯ばさみで外観検査AIを試してみました 〜つまずいたのは「正常の定義」でした〜
そのとき、検査プロンプトを改善したら、検出できていた欠陥まで検出できなくなるという結果が出ています。3条件の検査プロンプトは GitHub に置いてあります。
| 条件 | 検査プロンプト | 出力スキーマのキー順 | 検出(REVIEW 以上)/ 異常4枚 | 過検出 / 正常5枚 |
|---|---|---|---|---|
| A 欠陥の記述のみ | A_description_only.md | verdict → findings → … | 2 | 0 |
| B 検査手順のみ | B_steps_only.md | symmetry_check → verdict → findings | 0 | 0 |
| C 記述 + 手順 | C_description_and_steps.md | verdict → findings → … | 0 | 0 |
チェックリストを足したほうが良くなるはずだと思って足したのですが、逆でした。このとき私は、プロンプトの書き方の問題として片付けています。
ただ、少し引っかかっていました。そこで今回は、前回の結果 JSON を全部数え直すところから見直してみました。
先に結論を述べると、分かったことは3つです。
- 判定を
findings(欠陥候補)の後に書かせると、3条件すべてで検出が上がりました - さらに判定を目(VLM)から切り離すと、C は上がり、A は変わらず、B は下がりました。B では判定欄を消しても、
findings(欠陥候補)の文章に「欠陥ではない」が紛れ込み、切り離しきれていません - 切り離しがうまくいった A と C では、判定をルール・Claude Haiku 4.5・Jev のどれにしても結果は同じでした。効いているのは判断層の賢さではなく、目に判定を書かせないことです。ただし目が「欠陥と見なさないもの」の一覧を持っている限り、目は判定を続けます
一番確実に効いたのは 1 のキー順で、2 と 3 は条件がそろえば効く、という位置づけです。
| 条件 | 変えたところ | A の検出/4 | B の検出/4 | C の検出/4 | 過検出/5 |
|---|---|---|---|---|---|
| ① 前回のまま | — | 2 | 0 | 0 | 0 |
| ② キー順の入れ替え | スキーマの並びだけ。検査プロンプト本文は変更なし | 3 | 3 | 2 | 0 |
| ③ 判定を切り離す(ルール) | 目は観測だけを書き、判定はルールで行う | 3 | 2 | 3 | 0 |
| ③ 判定を切り離す(Haiku) | 同上。判定は Claude Haiku 4.5 | 3 | 1 | 3 | 0 |
| ③ 判定を切り離す(Jev) | 同上。判定は Jev | 3 | 1 | 3 | 0 |
1 について、前回の出力スキーマは verdict(判定)を findings(欠陥候補)より先に定義していて、モデルは実際にその順で書いていました。並びを入れ替えると結果が変わったので、順番が効いていたことは確かです。ただし、なぜ効いたのかまでは確かめていません(4章)。
なお、判定を目から切り離すという発想は、Jev のドキュメントを読んでいて思いつきました。Jev は TypeSafe AI の System One モデルで、文字列を生成せず、渡された情報に対する判定だけを返します。判定だけを別のモデルに任せられるなら、目には観測だけを書かせればよいのではないか、と考えたのが出発点です。ただし Jev は画像を扱えないので、外観検査そのものはできません。本稿で Jev が担当したのは、VLM が書いた観測テキストを読んで合否を決める部分だけです。
2 前回の結果を数え直す
新しい実験に入る前に、前回の結果 JSON を機械的に集計しました。9枚 × 4条件 × 3 run で 108 run です(条件 A は前回 Nova 2 Lite でも回していたので、それを含めて4条件です)。ここで、前提が3つ覆りました。
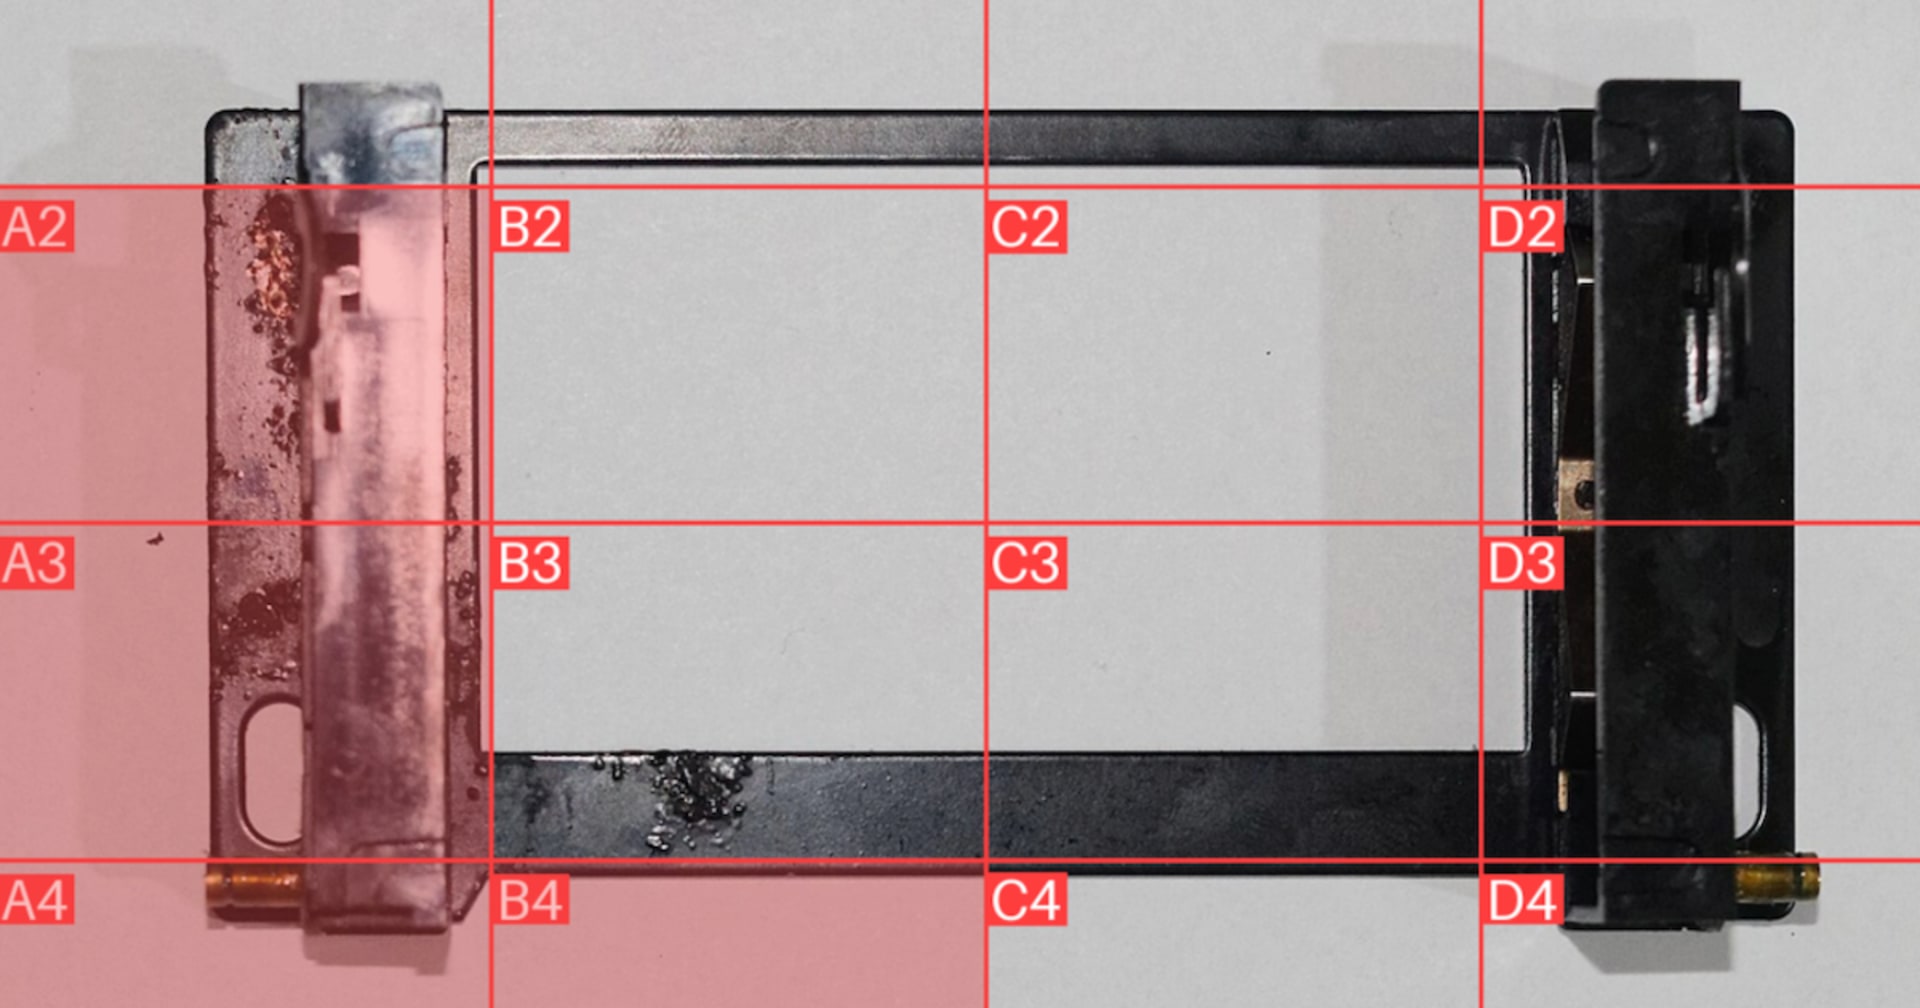
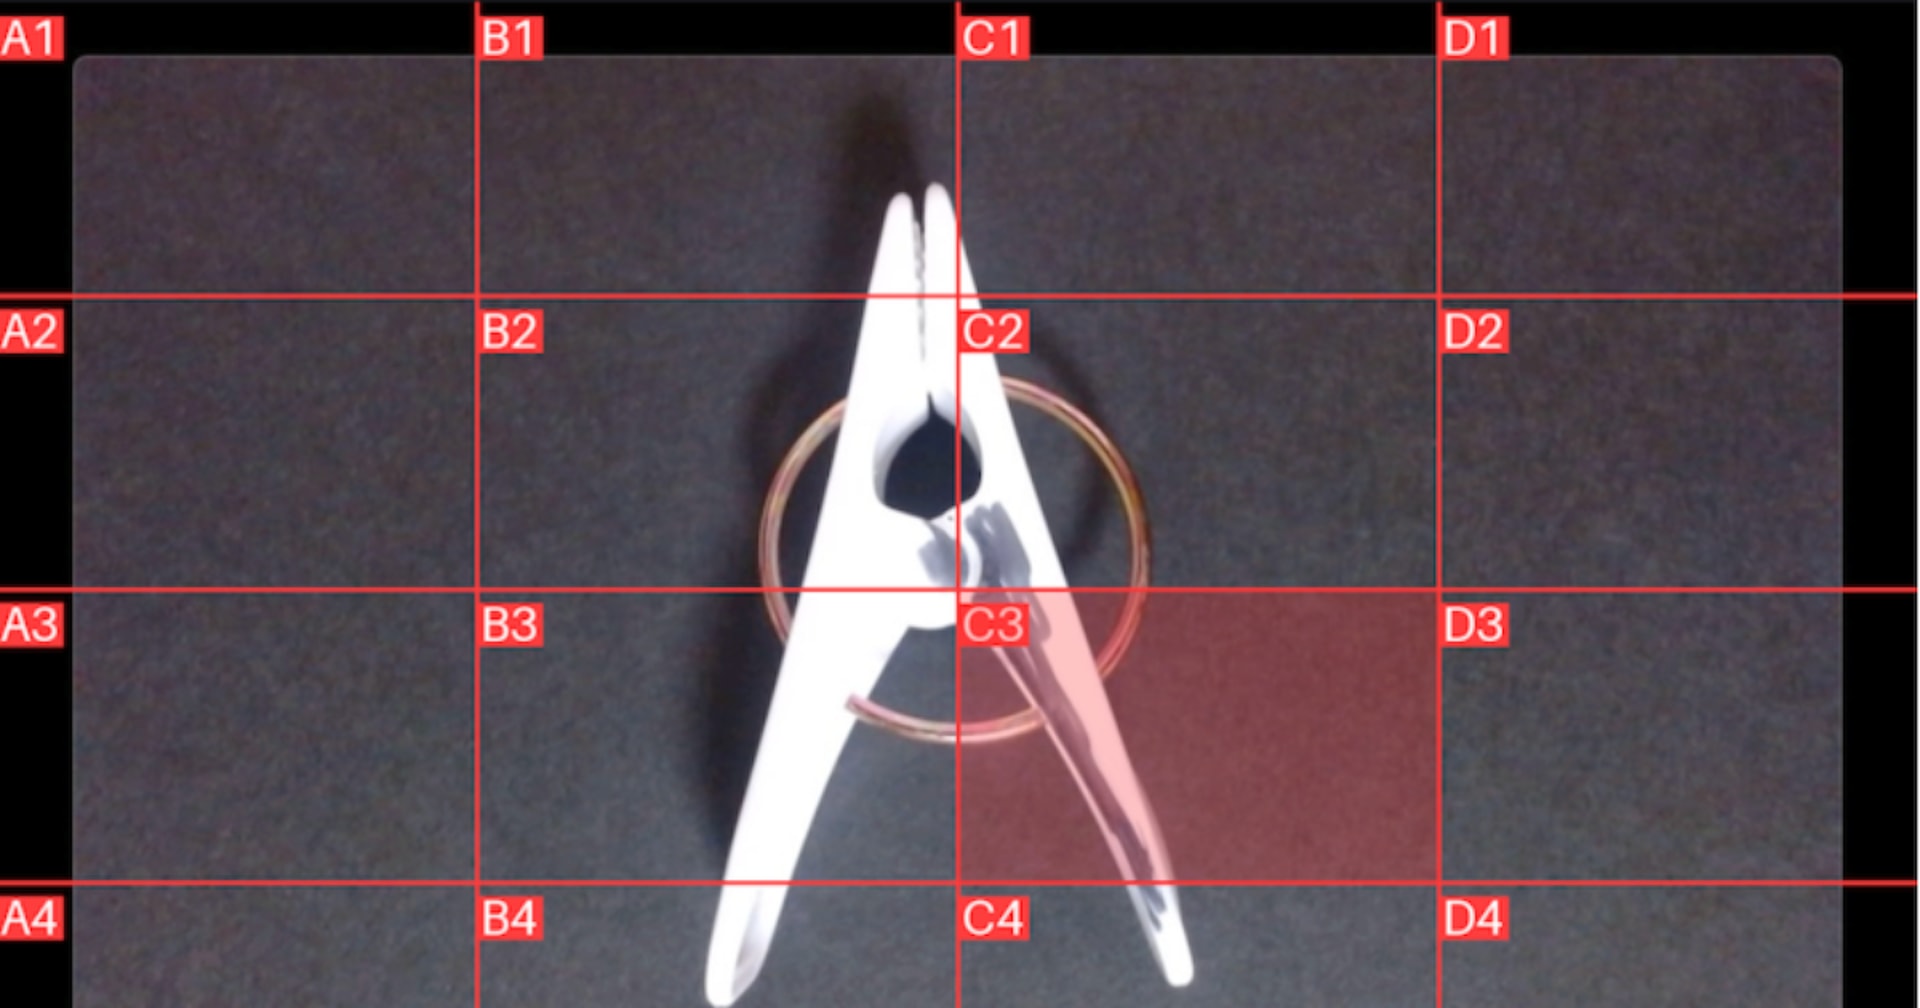
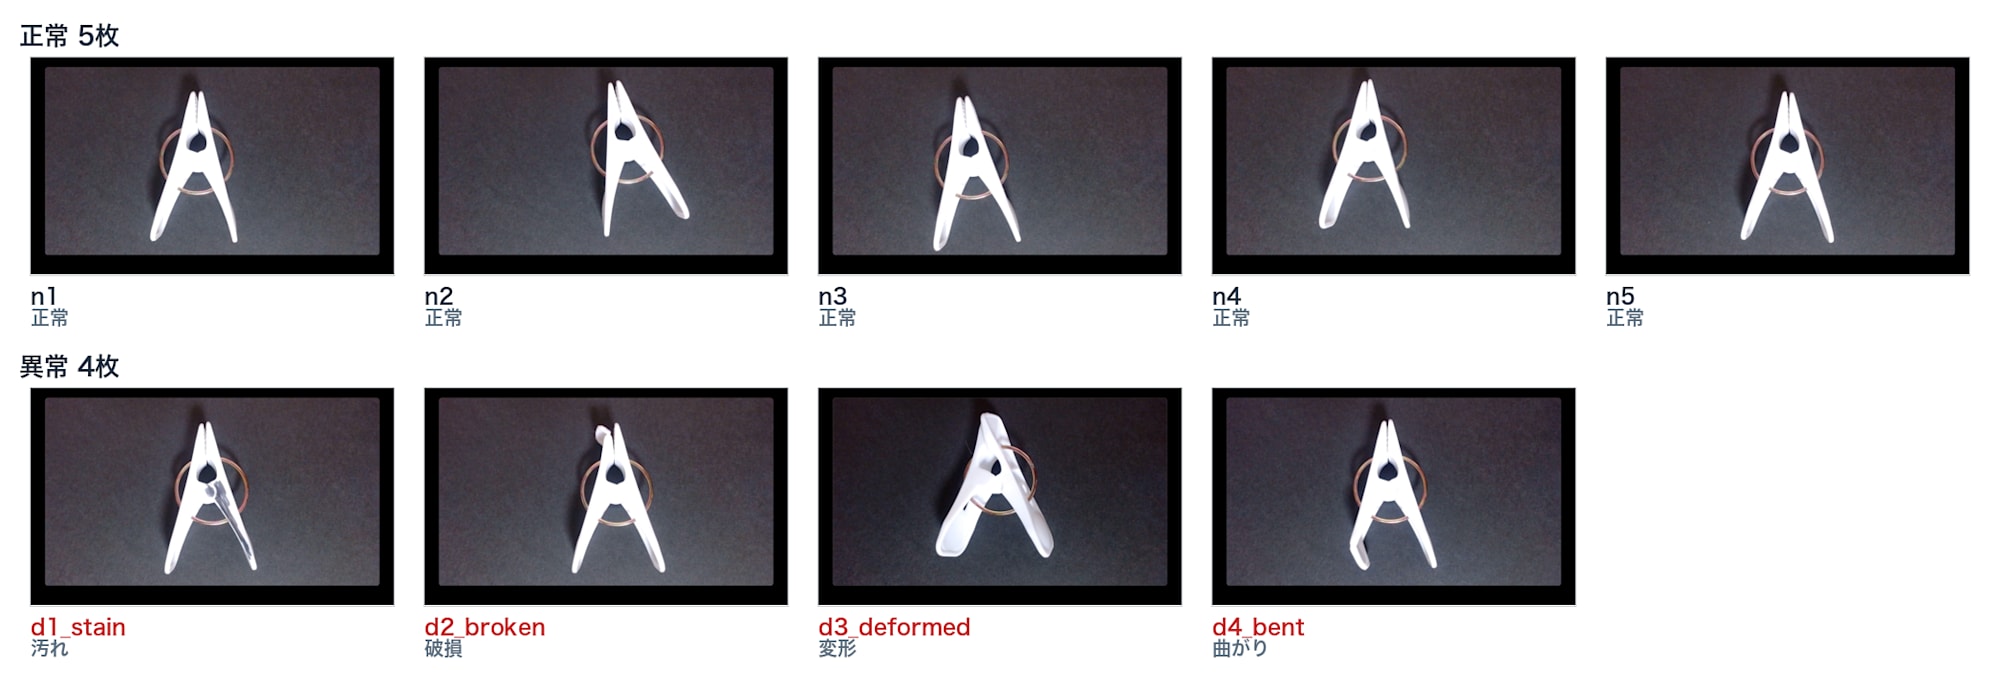
以降、画像は次の ID で示します。前回と同じ洗濯ばさみで、正常5枚と異常4枚です。
(1) findings と verdict が完全に一致していた
各 run の出力を、findings(欠陥候補)が出ているかどうかと verdict(判定)の組み合わせで数えました。パース失敗の 1 run を除いた 107 run です。
findings(欠陥候補)あり |
findings(欠陥候補)なし |
|
|---|---|---|
| 判定が REVIEW または NG | 6 | 0 |
| 判定が OK | 0 | 101 |
findings(欠陥候補)が出ているのに判定が OK、というケースは1件もありませんでした。逆に、findings(欠陥候補)がないのに REVIEW や NG になったケースもありません。findings(欠陥候補)が出た 6 run は、A の d1_stain と d2_broken の各 3 run です。B と C は、9枚すべてで findings(欠陥候補)が空でした。
前回、私は「VLM が欠陥を否定する文章を書いて、誤った OK に変わった」と書いています。しかし実際に起きていたのは、見つけたうえで否定したのではなく、そもそも何も報告していないという状態でした。
(2) 全条件で、判定を findings(欠陥候補)より先に書いていた
保存されている JSON のキーの並びは、モデルが出力した順そのままです。数えると、こうなっていました。
| 条件 | モデルが実際に出力した順 | 該当 run |
|---|---|---|
| A 記述のみ | verdict → findings → normal_observations → overall_notes | 21/21 |
| B 手順のみ | symmetry_check → verdict → findings | 21/21 |
| C 記述+手順 | symmetry_check → verdict → findings → normal_observations → overall_notes | 21/21 |
3条件とも、例外なく verdict を findings(欠陥候補) より先に書いています。出力スキーマで verdict を先に定義していたためで、モデルはその順に従っていました。(1) の完全な一致は、この順番と関係がありそうです。
(3) 検出できていた2件の中身も怪しかった
検出できていた2件(A の d1_stain と d2_broken)の findings(欠陥候補) を読み直しました。ユニークな内容は2種類だけで、3 run とも一字一句同じです。そのうえで、次の点があります。
- どちらも
confidenceが 0.65 evidenceが「ただし、影との区別が難しく判断しにくい」と自分で打ち消している- d1_stain(汚れ)に対する報告が「脚の途中が欠けて切り欠きができている」で、欠陥の種別が違う
つまり検出 2/4 のうち少なくとも1件は、種別を取り違えたまま REVIEW に倒れたものでした。REVIEW 以上を検出と数える指標は、当たった理由を問いません。前回の私の指標の使い方は甘かったと思います。
(4) 補足: JSON のパース失敗も起きていた
results/nova/res_n1.json の3回目が null でした。108 run 中 1 件(0.93%)です。
3 構成と実行環境
(1) 目と判断を分ける
構成はシンプルで、画像を見る部分と合否を決める部分を分けるだけです。
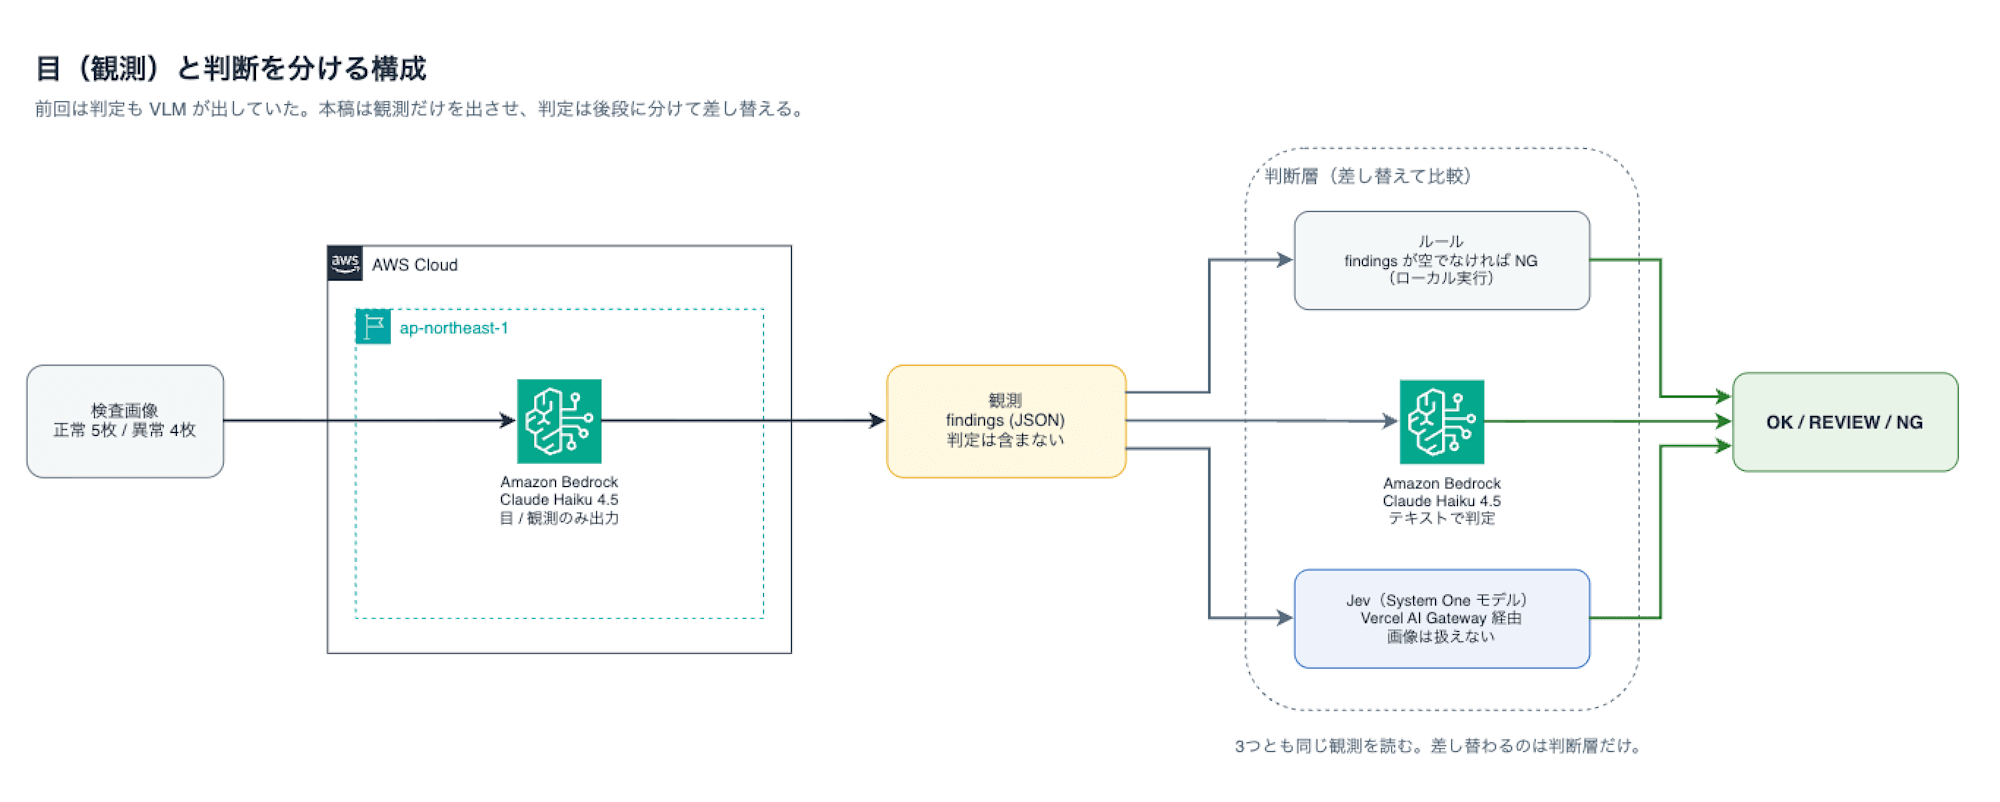
前回との違いは1点で、VLM に verdict を出させません。何が見えたかだけを書かせて、だから OK か NG かは後段が決めます。
| 観測 | 判断 | |
|---|---|---|
| 前回 | VLM | VLM |
| 本稿 | VLM | ルール / Haiku テキスト判定 / Jev の3つを比較 |
(2) 実行環境
| 役割 | 使ったもの |
|---|---|
| 目(画像から観測を出す) | Amazon Bedrock / Claude Haiku 4.5(jp.anthropic.claude-haiku-4-5-20251001-v1:0、ap-northeast-1) |
| 判断 ① ルール | Python のみ(findings(欠陥候補) が空でなければ NG) |
| 判断 ② テキスト判定 | 目と同じ Claude Haiku 4.5(画像は渡さず、観測テキストだけ渡す) |
| 判断 ③ Jev | typesafe-ai/jev(Vercel AI Gateway 経由、TypeSafe 互換 API) |
| 観測の英訳(7章(4) のみ) | Amazon Translate(ap-northeast-1) |
| 試行回数 | 各画像3回・多数決(前回と同じ) |
| 実行環境 | Python 3.10.13 / boto3 1.43.89 / Pillow 11.0.0 |
(3) データ
今回は新たに撮影しておらず、前回の記事で撮影した画像をそのまま使っています。参考までに、前回の撮影環境と検査対象を再掲します。
撮影は、自宅の机に黒い画用紙を敷き、アームで固定した Web カメラで真上から行いました。
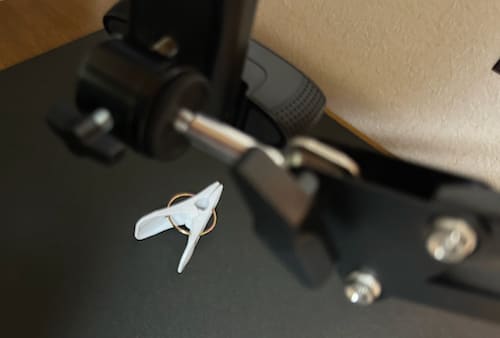
検査対象は、100円ショップで買った樹脂成形の洗濯ばさみです。異常品は、汚れを付ける、先端を折る、本体を変形させる、脚を曲げる、の4通りを前回手で作ったものです。
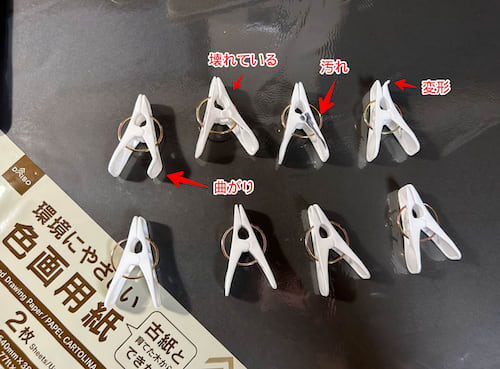
これを1個ずつ撮影した正常5枚・異常4枚の計9枚が評価データで、2章に ID 付きで載せた画像がそれです。枚数が少ないので、本稿の数値はあくまで特定環境での一例として捉えてください。
なお、前回は正常品を異常と判定してしまう過検出が、3条件すべてでゼロでした。過検出はこれ以上減らせないので、今回改善できるとすれば、異常品を見逃さない側(検出)だけです。ただし、何でも異常と判定すれば検出は簡単に上がります。そのため本稿では、過検出をゼロのまま保てた場合だけを改善と数えます。各表に過検出の列を残しているのはそのためです。
4 出力スキーマのキー順を入れ替えてみる
ここから VLM を再実行します。使うプロンプトは A・B・C の3つすべてです。
(1) 変えたのはスキーマの並びだけ
output_schema.properties の並びを verdict → findings から findings → verdict に入れ替えました。検査プロンプトの本文(inspection_prompt)は一文字も変えていません。
手で書き直すと差分が曖昧になるので、変換はプログラムで行い、本文が原文と同一であることを機械的に検証しています。
ただし、ここは正確に書いておきます。本実装ではスキーマを JSON にしてプロンプトの末尾に付けて送っているので、キー順を変えると、モデルが読む入力テキストも変わります。
content.append({"text": f"{spec['inspection_prompt']}\n\n【JSON スキーマ】\n{schema}"})
したがって、この実験で分かるのは「並び順を変えると結果が変わる」ことまでです。生成順の効果と、指示の書かれ方が変わった効果は分離できていません。
Github scripts/make_specs.py
# (要点抜粋)findings を verdict より前に出す。他は順序も中身も変えない
keys = list(schema["properties"].keys())
keys.remove("findings")
keys.insert(keys.index("verdict"), "findings")
schema["properties"] = OrderedDict((k, schema["properties"][k]) for k in keys)
$ python scripts/make_specs.py
--- C  元 : ['verdict', 'findings', ...] → ord: ['findings', 'verdict', ...]
       ord のプロンプトは原文と同一か: True
(2) 結果
| 条件 | 検出/4 | 過検出/5 | 秒/枚 |
|---|---|---|---|
| ① A 前回のまま | 2 | 0 | 20.31 |
| ② A キー順入れ替え | 3 | 0 | 20.37 |
| ① B 前回のまま | 0 | 0 | 7.46 |
| ② B キー順入れ替え | 3 | 0 | 9.25 |
| ① C 前回のまま | 0 | 0 | 23.89 |
| ② C キー順入れ替え | 2 | 0 | 27.26 |
3条件すべてで上がりました。B は 0/4 から 3/4、C は 0/4 から 2/4、A も 2/4 から 3/4 です。
出力順が狙いどおり入れ替わったことも確認しました。2章(2) と同じ数え方で、3条件とも全 run で findings(欠陥候補) が verdict より先に出ています。
A で新たに検出された d3_deformed の findings(欠陥候補)は、次のとおりでした。
{ "defect_type": "本体が曲がって左右非対称になっている(ねじれ・変形)",
  "cells": ["B2", "C2", "B3", "C3"], "confidence": 0.72,
  "evidence": "上端のつまみ部が、正常サンプルと比較して明らかに右側に傾いており、中心線からのずれが顕著。…" }
欠陥種別も正解です。前回は全条件で見逃していた変形を拾うことができました。
なお、B で検出した3件は欠陥種別がいずれも「表面付着物」で、d2(破損)と d3(変形)は種別が合っていません。検出数が上がっても、種別まで当たるわけではない点は留意が必要です。
正常5枚はすべて OK のままです。検出を増やすために過検出を犠牲にしたわけではない、という点は確認できました。
5 判定を目から切り離してみる
キー順で改善したので、次は判定そのものを目から外し、観測だけを書かせてみました。
(1) スキーマとプロンプトから判定を外す
verdict/normal_observations/overall_notesをスキーマから削除- プロンプトの「■ 判定」節を削除し、「■ 出力」節を観測専用に差し替え
なお、B と C の symmetry_check(左右対称性を確認した記録)は観測なので残しました。手順を踏ませる条件の性格を保つためです。B は「■ 出力」節に部位名などの指示がまとめて入っているので、節は差し替えず「判定は出力しない」の一文だけを足しています。
(2) 目が findings(欠陥候補)を出した画像は変わったか
判断層を通す前の、目の側の結果です。キー順を入れ替えた ② と比べます。
| 条件 | ② キー順の入れ替え | ③ 観測のみ | 変化 |
|---|---|---|---|
| A | d1 / d2 / d3 | d1 / d2 / d3 | 変わらず |
| B | d1 / d2 / d3 | d1 / d2 | d3 が出なくなった |
| C | d1 / d2 | d1 / d2 / d3 | d3 が出るようになった |
C は上がり、A は変わらず、B は下がりました。B で出なくなった d3 の findings(欠陥候補)は、② では「表面付着物」と報告されていたもので、変形という実際の欠陥とは種別が違っていました。出なくなった理由は特定できていません。
判定を切り離す効果は、条件によって出方が違う、というのがここでの結果です。
(3) 出力が減った分だけ速くなった
副次的な効果として、C では判定と正当化を書かせなくなったぶん出力が減り、目の処理が速くなりました。
| 条件 | 秒/枚 | $/9枚 | 出力トークン(n1・3回分) |
|---|---|---|---|
| ① C 前回のまま | 23.89 | 0.2987 | 1,971 |
| ③ C 観測のみ | 11.54 | 0.2220 | 621 |
事前には、判断層を速くしても目が支配的なので全体は変わらないと考えていました。実測では、目に書かせる量が減ったぶん目自体が速くなっています。B はもともと normal_observations などを出させない短いプロンプトで、変わりませんでした(7.46 → 10.22 秒/枚)。
6 判断層を3つ比べてみる
観測が固定できたので、判断する側だけを差し替えて比べます。判断層の3つは同じ VLM の実行結果を共有しているため、変わるのは判断層だけです。
(1) 比べた3つ
| # | 判断層 | 中身 |
|---|---|---|
| ⑤ | ルール | findings(欠陥候補) が空でなければ NG。モデルを使わない |
| ④ | Claude Haiku 4.5 | 観測をテキストだけ渡して判定させる(画像は渡さない) |
| ③ | Jev | TypeSafe AI の System One モデル。文字列を生成せず、型付きの答えと確率を返す |
Jev は 2026年9月15日に公開されたモデルです。state(非構造データ)と型付きの質問を受け取り、型に応じた答えと確率を返します。質問の型は3つあります。
| 型 | 聞き方 | 返るもの | 本稿での使い方 |
|---|---|---|---|
| Choice | 選択肢から1つ選ぶ | 選ばれた選択肢、各選択肢の確率、confidence | OK / REVIEW / NG のどれか |
| Score | 段階評価 | 補間された点数、各段階の確率、confidence | 欠陥の程度(欠陥なし / 軽微 / 明らか) |
| Noul | 文が真かどうか | 0〜1 の確率が1つ(confidence は返らない) | 「この検査対象には欠陥がある」が真である確率 |
Noul は TypeSafe AI 独自の呼び名で、確率付きの yes/no と考えると分かりやすいと思います。なお、Jev は画像を扱えません。公式ドキュメントに明記されています。
Jev accepts text only. State must be a string, JSON object, or array of text values.
Images, audio, and video are not supported (yet).
なお、判定基準の文面は3つとも前回の検査プロンプトの「■ 判定」節をそのまま使いました。判断層以外を動かさないためです。
Github scripts/judge_observations.py
$ python scripts/judge_observations.py --src results/exp2/C_obs --judge jev
  n1〜n5  OK / d1_stain, d2_broken, d3_deformed  REVIEW / d4_bent  OK
  平均 0.485秒/回
(2) A と C では、判断層を変えても同じだった
| 判断層 | A の検出/4 | B の検出/4 | C の検出/4 | 過検出/5 | 判断の秒/回 |
|---|---|---|---|---|---|
| ⑤ ルール | 3 | 2 | 3 | 0 | ほぼ0 |
| ④ Haiku テキスト | 3 | 1 | 3 | 0 | 0.54〜0.60 |
| ③ Jev | 3 | 1 | 3 | 0 | 0.47〜0.55 |
A と C では、モデルを使わないルールも、Haiku も、Jev も同じ 3/4 でした。違ったのは粒度だけです。
| 判断層 | d1_stain | d2_broken | d3_deformed | d4_bent |
|---|---|---|---|---|
| ルール(A / C) | NG | NG | NG | OK |
| Haiku テキスト(A / C) | REVIEW | REVIEW | REVIEW | OK |
| Jev(A) | NG | NG | REVIEW | OK |
| Jev(C) | REVIEW | REVIEW | REVIEW | OK |
観測側の confidence が 0.65〜0.72 で、evidence も「判別が困難」と書いているので、REVIEW に倒す Haiku の判断のほうが妥当かと思いました。ただし検出数は動きません。
ルールという下限で同じ結果になったことから、効いているのは判断層の賢さではなく、目に判定を書かせないことだと言えます。なお、d4_bent(曲がり)は全条件で見逃しています。目が観測を出していないので、判断層をどう変えても届きませんでした。
(3) B では、findings(欠陥候補)の中に判定が残っていた
B は d2_broken で判断層が割れました。
| 判断層 | d1_stain | d2_broken | d3_deformed | d4_bent |
|---|---|---|---|---|
| ルール(B) | NG | NG | OK | OK |
| Haiku テキスト(B) | REVIEW | OK | OK | OK |
| Jev(B) | NG | OK | OK | OK |
d2 の findings(欠陥候補)は3 run とも次の内容でした。B の findings(欠陥候補)には、A・C にない reason(理由)欄があります。
defect_type: 表面異常 - 白飛びハイライト
reason: ただし、指示に従い白飛びハイライトは欠陥と見なさないものに該当するため、
        これは形の異常ではなく照明由来の現象と判断されます。
findings(欠陥候補)を出しながら、同じ findings(欠陥候補)の中で「欠陥ではない」と判定しています。ルールは findings(欠陥候補)が空でないので NG、Haiku と Jev はこの文を読んで OK にしました。判断層はどちらも観測に忠実に動いていて、割れたのは観測の側に判定が残っていたためです。
reason 欄が判定の入口になっていると考え、reason を外した版も回しました。
| 条件 | ルール | Haiku | Jev |
|---|---|---|---|
| B 観測のみ(reason あり) | 2 | 1 | 1 |
| B 観測のみ(reason なし) | 2 | 1 | 1 |
結果は変わりませんでした。判定は difference_from_normal(正常品との違い)欄に移っただけです。
difference_from_normal: 先端上部(C1領域)に強い白飛びハイライトが見られます。…
                        ただし、これは照明条件による光学的な現象であり、樹脂の形状異常ではありません。
欄を1つふさいでも、自由に書ける欄があればそこに判定が入り込みます。根本は観測の誤りで、B は d2 の折れを白飛びハイライトと見ていました。A は同じ d2 を「先端のつまみ部が折れて欠けている」と正しく報告しています。C は「白い異物」と種別を誤りましたが、欠陥ではないとは書いていません。そのうえで B は、プロンプトの「欠陥と見なさないもの」にある白飛びを、目の側が自分で当てはめています。
つまり判定欄を消しても、除外ルールを目に持たせている限り、目は判定を続けます。除外ルールも判断層に移すのが筋の通った分離ですが、A・C のプロンプトにも同じ一覧があり、3条件を作り直す別の実験になるため、今回はここまでにしました。
7 Jev を単体で確認してみる
本稿の結論には直接関わりませんが、Jev 自体の挙動で分かったことを書いておきます。
(1) 日本語の state は問題なく通った
公式は、英語が主たる学習言語で、CJK を含む他言語は精度が低いとしています。試した範囲では、差は出ませんでした。
| state | choice | confidence | noul | 応答 |
|---|---|---|---|---|
| 欠陥(日本語 / 英語) | NG / NG | 1.0 / 1.0 | 0.97 / 0.98 | 925 / 502ms |
| 正常(日本語 / 英語) | OK / OK | 1.0 / 1.0 | 0.07 / 0.05 | 369 / 489ms |
(2) confidence の読み方には注意が必要です
428 リクエストぶんを confidence 帯で分けた集計です。
| confidence 帯 | 件数 | 正解率 |
|---|---|---|
| 0.9〜1.0 | 219 | 63.9% |
| 0.5 未満 | 207 | 56.0% |
中間帯はほぼ空で、二極化していました。ただし、これをキャリブレーションが悪いと読むのは正しくないようです。
0.9 以上で外した 79 件を調べたところ、全件が「正解は異常、Jev の答えは OK、state の findings(欠陥候補) は空」という同じ形でした。目が何も報告しなかった画像を、Jev が「findings(欠陥候補)が無いのだから OK」と答えたケースです。confidence は与えられた state に対する確信度であって、正解である確率ではない、ということかと思います。判断層だけを評価するなら、観測が空でないケースに限って測るべきでした。
なお、428 リクエストといっても元の画像は9枚です。この規模でキャリブレーションの良し悪しを論じるのは無理があるので、傾向としてこう見えた、までに留めます。
(3) Choice と Noul の一致
| 一致 | 割合 | |
|---|---|---|
| Choice(NG/REVIEW)と Noul(0.5 超) | 408/428 | 95.3% |
公式が載せている構造的不整合ほどの乖離は出ませんでした。ただし noul の絶対値は低いままで、正常画像が平均 0.174(最大 0.38)、異常画像が平均 0.217(最大 0.56)です。異常画像でも 0.5 をほとんど超えません。閾値を 0.5 に置くと、この題材ではほぼすべて欠陥なしになります。閾値は自分のデータで決める必要がありそうです。
(4) 前回の観測をそのまま渡しても変わらなかった
前回保存した観測から verdict を捨てて Jev に渡す、という検証もやってみました。VLM は再実行していません。観測テキストを Amazon Translate で英訳し、normal_observations の有無も変えて4通り試しましたが、結果はすべて同じで、前回の VLM 自身の判定と一致しました(A は 2/4、B・C は 0/4、過検出 0)。2章で見たとおり B と C の観測は空なので、判断層だけを差し替えても検出は増えませんでした。
8 つまずいた点
(1) VLM は、判定させないと指示しても JSON の外で判定していました
観測のみ条件で、findings(欠陥候補) が空なのに出力が 531 トークンありました。生テキストを見ると、次のようになっています。
```json
{ "findings": [] }
```
**判定理由:**
…
**欠陥の有無:**
- 先端の折れ・欠け: なし …
スキーマから verdict を消し、プロンプトで判定は出力しないと書いても、モデルは JSON の外で判定していました。ただし JSON が先に出ているので、観測そのものは汚染されていません。
(2) Jev の確率値は決定的ではありません
最初、confidence 1.0 の state で5回試して完全に一致したので、決定的だと判断しましたが、これは誤りでした。判定が割れる境界付近の state で10回試すと、次のようになります。
| state | 10回の結果 |
|---|---|
| 判断材料が乏しい state | 10回とも異なる確率。P(OK) が 0.51〜0.63、confidence が 0.27〜0.44 |
| 確信度が高い state | choice は安定(10回とも REVIEW)、confidence は 0.98 と 0.99 の2通り |
実際、同じ観測に対して ['REVIEW', 'NG', 'NG'] と割れた画像もありました。文字列を生成しないから安定、というわけではないようです。前回と同じ3回多数決は、Jev でも有用かもしれません。
(3) Jev では、質問文の言い回しだけで確率が変わります
当初、2つのスクリプトで REVIEW の基準の書き方が違っていました。短い版が「人が目視で確認すべき」、前回準拠版が「欠陥かどうか判断がつかない、影や光沢と区別できない、部分的に隠れて確認できない」です。同じ state に両方を投げると、P(OK) が 0.52 と 0.63 になりました。比較実験では、判定基準の文面を固定する必要があります。
(4) Jev への重複リクエストをまとめたら、3回多数決が成立しなくなりました
7章(4)の実験を最初に回したとき、同じ内容の state をまとめて1回だけ投げ、結果を3回分に複製していました。そのせいで、日本語だと全て REVIEW、英語だと全て OK という言語差があるように見えました。
(2) で Jev が非決定的だと分かってから、重複をまとめるのをやめて回し直すと、差は消えています。境界付近の1回の揺れを、言語の効果と読み違えていました。
(5) Jev を Vercel AI Gateway の無料枠で使うと、レート制限に当たります
Vercel AI Gateway 経由で連続して投げると 429 が返ります。原因は無料枠でした。
AI Gateway does not rate limit paid-tier requests. The free tier applies lower per-model limits.
投入レートは約 2.1 req/秒(126 req/分)で、Jev 本体の公式上限 1,200 req/分 の約10%です。モデルの制限ではなく、ゲートウェイ無料枠の制限に当たっていました。
| 実行 | リクエスト | 429 | 503 |
|---|---|---|---|
| 7章(4) 日本語 | 214 | 14 | 12 |
| 7章(4) 英語 | 214 | 15 | 21 |
| 6章(2) 判断層の比較 | 54 | 4 | 1 |
公式の案内どおり指数バックオフで再試行したところ、536 リクエストすべて成功しました。なお 503 は公式のエラー一覧に無く、原因は特定できていません。
9 最後に
今回の検証で分かったことを3点にまとめます。
- 判定を
findings(欠陥候補)の後に書かせると、3条件すべてで検出が上がりました。
出力スキーマの並びを入れ替えるだけで、A は 2/4 から 3/4、B は 0/4 から 3/4、C は 0/4 から 2/4 になっています。検査プロンプトの文面は変えていませんが、スキーマもプロンプトに含まれるため、生成順の効果か指示の書かれ方の効果かは分離できていません - さらに判定を目から切り離すと、C は上がり、A は変わらず、B は下がりました。
B では判定欄を消しても、findings(欠陥候補)の文章に「欠陥ではない」が紛れ込んでいて、切り離しきれていません - 切り離しがうまくいった A と C では、判定をルール・Haiku・Jev のどれにしても同じでした。
効いているのは判断層の賢さではなく、目に判定を書かせないことです。ただし目が除外ルールを持っている限り、目は判定を続けます
一番確実に効いたのは 1 のキー順で、2 と 3 は条件がそろえば効く、という位置づけです。
| # | 判断層 | A 検出/4 | B 検出/4 | C 検出/4 | 過検出/5 | 秒/枚(C) |
|---|---|---|---|---|---|---|
| ① 前回のまま | VLM 自身 | 2 | 0 | 0 | 0 | 23.89 |
| ② キー順の入れ替え | VLM 自身 | 3 | 3 | 2 | 0 | 27.26 |
| ⑤ 観測のみ + ルール | ルール | 3 | 2 | 3 | 0 | 11.54 |
| ④ 観測のみ + Haiku | Haiku 4.5 | 3 | 1 | 3 | 0 | 13.18 |
| ③ 観測のみ + Jev | Jev | 3 | 1 | 3 | 0 | 13.00 |
なお、前回のデータでは 108 run 中 1 件のパース失敗がありましたが、今回の再実行分では0件でした。
実務に入れるとしたら、まずキー順は必ず「findings(欠陥候補) → 判定」にすると思います。変更はスキーマの並びだけで、今回の3条件すべてで効きました。判定の切り離しは、観測から判定を追い出せる場合に限って効果が出ます。除外ルール(何を欠陥と見なさないか)を目のプロンプトに持たせたままだと目が判定を続けるので、切り離すなら除外ルールごと判断層へ移すのが良いのでは、と思います。
できていないことも書いておきます。d4_bent(曲がり)は全条件で見逃していて、これは判断層ではなく目の限界です。除外ルールを判断層に移す実験も、今回は行っていません。また、検出できたといっても報告される欠陥種別はまだ当てになりません。検出率という指標は、当たった理由を問わないという点に注意が必要だと感じました。
構造化出力を使うときは、書かせる順番が書かれる中身を変える、という視点を持っておくと良さそうです。同じような検証のたたき台になれば嬉しいです。
本稿の数値はすべて、洗濯ばさみ9枚・自宅の机・Web カメラという1つの環境での実測値です。
この記事で使用したコードは、以下に置きました。
GitHub: bedrock-vlm-inspection-key-order