原材料投入が正しくできたかをQRコードとVLMでAWS上で判定してみた

概要
こんにちは、クラスメソッド製造ビジネステクノロジー部の田中聖也です。
食品工場の投入工程で「正しいものを、きちんと入れたか」を検出できるようにしたい、という話を現場でよく伺います。これを映像から自動でチェックできないかと思い、AWS上で検証してみました。
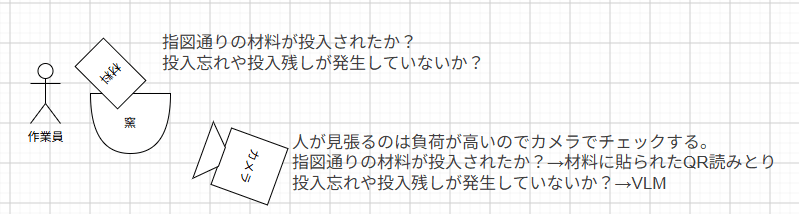
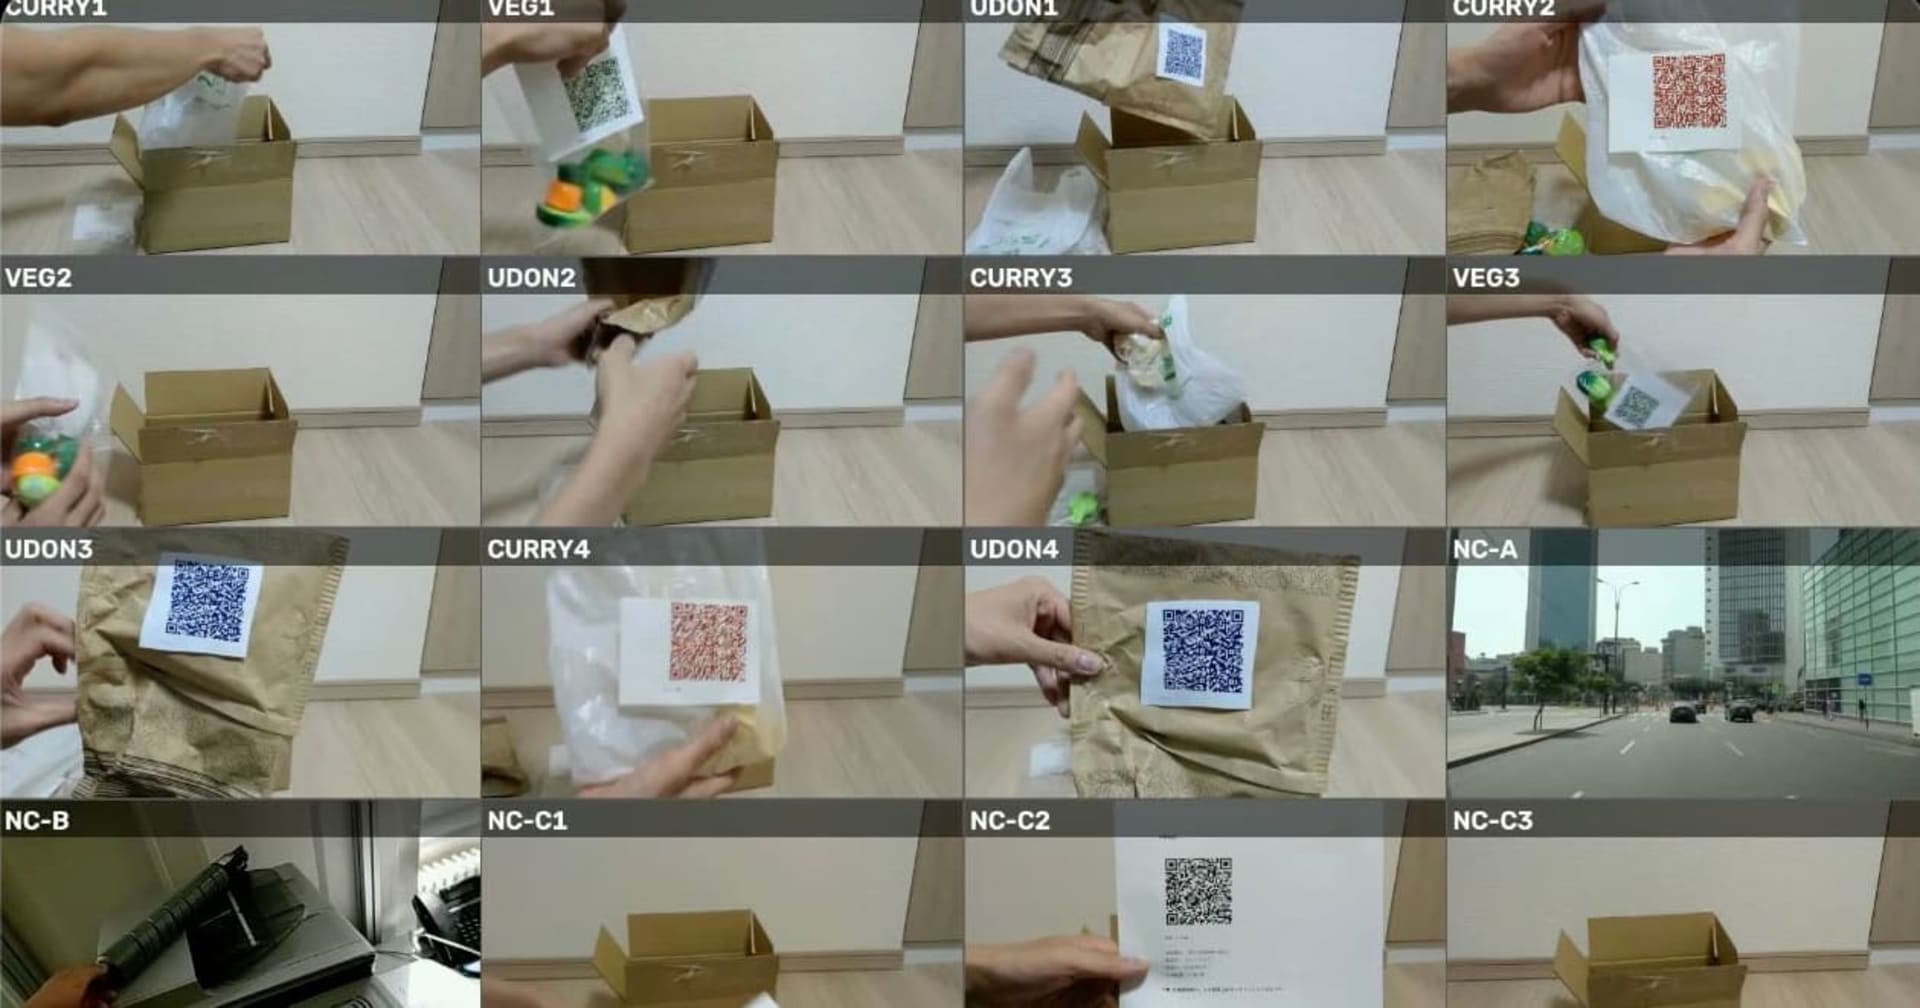
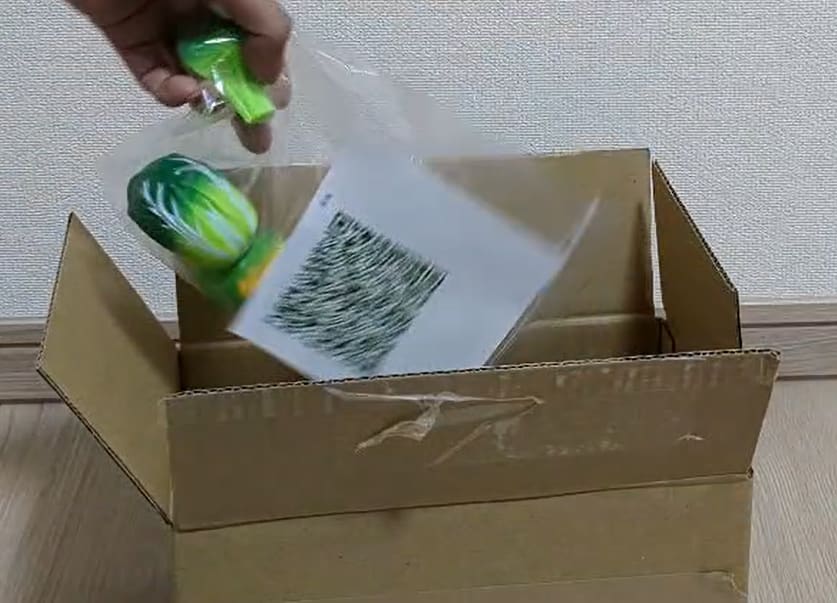
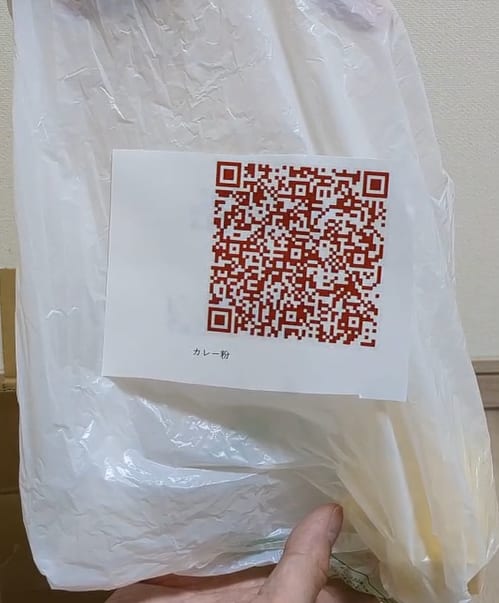
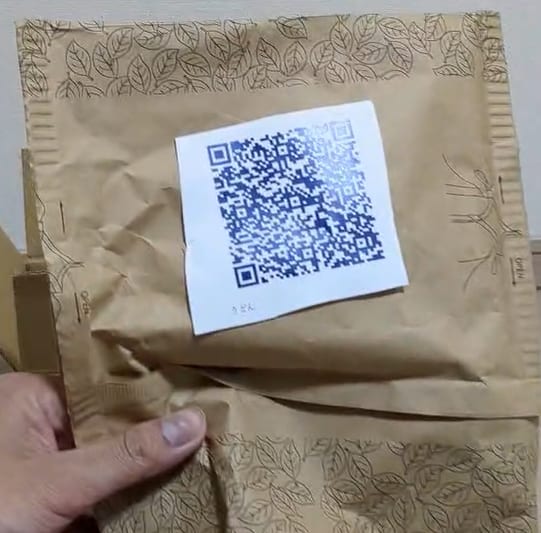
あくまで検証なのでチャック袋にQRを貼って子供のおもちゃを段ボールに投入しているのを検証動画としました。
同じ検証のローカル側(DGX Spark上でローカルVLMを動かして判定精度を見る担当)は、同じ部署のtanaka-takeruが書いています。
役割分担はこうなっています。ローカル検証は判定の精度を見る、クラウド検証は最後まで繋がるかを見る。目的が違うので、クラウド側にはUIを作っていません。
| ローカル検証(takeru担当) | クラウド検証(この記事) | |
|---|---|---|
| 目的 | QR検出+投入判定が成立するか | ローカルで検証した内容がAWS上のパイプラインが通るか |
| VLM | DGX Spark上のローカルVLM | Amazon Bedrock経由のモデル |
| 永続化 | JSONファイル | Amazon DynamoDB |
| UI | Streamlit | なし |
環境
| 項目 | 内容 |
|---|---|
| 検証日 | 2026-09-30〜10-01 |
| リージョン | ap-northeast-1(東京) |
| IaC | AWS CDK (Python) |
| 開発端末 | Windows 11 |
| 動画 | 1280x720 / 約56秒 / 1689フレーム |
| シナリオ | 4本(正常・投入漏れ・部分投入・遮蔽)を各1テイク |
やりたかったこと
「ちゃんと入れたか」は3つの問いに分かれる
調合・投入工程で品質異常が出たとき、「投入が正しく行われたこと」を客観的に示す手段が現場にはあまりありません。記録は人手なので、原因調査が作業者への聞き取りにいくような感じになると思います。
ただ、「正しいものを人がきちんと入れたか」をすべてAI聞くのは無理だと判断しました。
なぜなら「正しく」という言葉を分解すると性質の違う3つ要素が混ざっているからです。
| 問い | 内容 | 適した手段 |
|---|---|---|
| 何を | 対象は正しい品目か | コード読み取り(決定論的処理) |
| 入れたか | 実際に容器へ投入されたか | 映像による動作・状態の判定 |
| どれだけ | 量は手順どおりか | 重量計等のセンサー |
このうち映像でなければ解けないのは「入れたか」だけです。
「何を」をVLMに読ませると、それらしい品目名を作ってしまう(ハルシネーション)失敗が起きるので、OpenCVのQRデコーダに任せます。
「どれだけ」は映像では扱えないので今回の検証では対象外としています。
検証した題材
カレーうどんの調合を模した撮影をしました。段ボール箱を容器に見立てて、野菜・カレー粉・うどんの3品目を投入します。
各袋にはQRコード(品目IDと品目名をJSONで埋め込んだもの)を貼っていて、作業者は投入直前にQRをカメラに向けて見せる、という手順です。
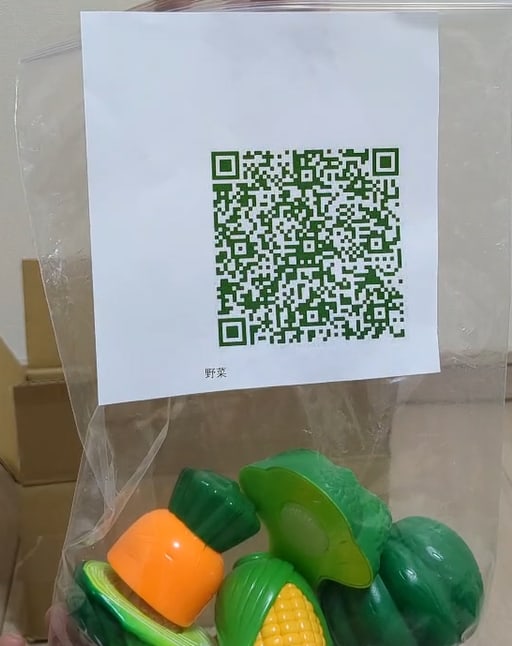
撮影したシナリオは4本。
| シナリオ | 内容 |
|---|---|
| S1 | 正常(3品目すべて投入) |
| S2 | 投入漏れ(野菜をQR提示後に床へ置く) |
| S3 | 部分投入(野菜の袋に中身が残る) |
| S4 | 遮蔽(野菜のQRを意図的に隠す) |
構成
動画をS3に置いたら、あとは勝手に判定されてDynamoDBに結果が並ぶ、という形にしました。Lambdaは使わず、AWS Step Functions(処理の順番を定義して自動で回してくれるサービス)からAmazon ECS / DynamoDBを直接呼んでいます。
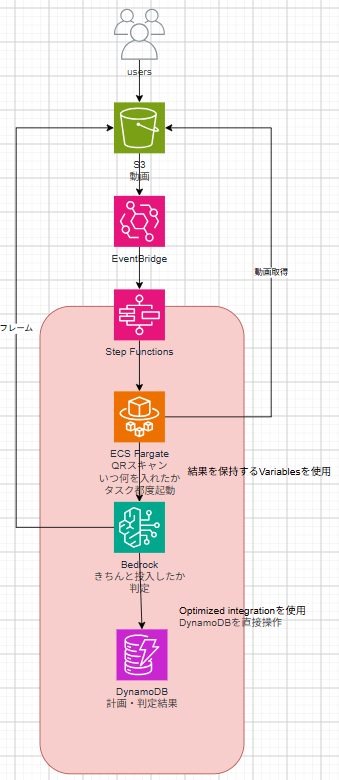
users → S3 (動画 raw/)
          ↓
     EventBridge → Step Functions ─→ ECS Fargate (QRスキャン・フレーム切り出し・投入判定)
                         │                ↕ S3 (動画取得 / フレーム・クリップ保存)
                         │                → Bedrock (Converse API にフレーム画像20枚を渡して投入判定)
                         └─→ DynamoDB (計画・判定結果)
設計で一番効いたのは、判定の単位を「QRセグメント(袋1つ分)」にしたことです。袋のQRが読めた時刻から次の袋のQRまでを1つの区画とみなし、その区画のフレームだけをモデルに渡す。(take_id, run_id, seq) が「何を入れたか」と「きちんと入れたか」を紐づけるキーになるので、後から時刻で突き合わせる処理が不要になるからです。
ECSコンテナは薄いアダプタに徹しています。S3の入出力とStep Functionsへのコールバック以外は、ローカル検証と同じPythonパッケージをimportして呼ぶようにしていて、コンテナ化しています。
やってみた
1.QRコードで「何を」を取る
ECSコンテナが動画を取得して、全フレームをOpenCVで走査します。QRが小さく写っているので、前処理ラダー(グレースケール→2倍拡大→CLAHE→適応二値化→アンシャープ→4倍拡大、と段階的に試す仕組み)を通して、どれかの段で読めたら採用という形にしています。
ここで分かったのは、読めるかどうかを決めていたのはQRの印刷サイズだった、ということです。最初の撮影では成功の50〜94%が最終段の4倍拡大頼みで、これはモジュール解像度(QRの最小マス1つが何ピクセルあるか)が規格の下限を割っている状態でした。
QRの印刷サイズを大きくして撮り直したら、拡大なしで読めるフレームが各シナリオで74〜220枚現れて、4倍拡大への依存は1〜7%まで落ちました。
| 旧テイク | 新テイク(印刷サイズ拡大後) | |
|---|---|---|
| success_rate | 1.6〜8.3% | 18〜31% |
| 拡大なしで成功 | 0フレーム | 74〜220フレーム |
| 4倍拡大への依存 | 50〜94% | 1〜7% |
カメラの解像度は1280x720のままです。補間拡大は情報を増やさないので、前処理をいくら工夫しても足りない分は戻ってこない。光学条件側を変えるのが正解でした。現場に展開するときも、まず読み取れるQRの印刷サイズから確認するのが早そうですね。
2.VLMに「入れたか」を判定させる
切り出した20枚を、各画像の直前に経過秒数のテキストを置いて、Bedrock経由でモデルに渡します。モデルはGPT-5.5です。
以下が設定したプロンプトです。
最初のフレームで人が手に持ち、QRコードの紙を見せている袋を「対象の袋」とします。
この区間で、対象の袋の中身が段ボール箱の中に移されたかを判断してください。
対象の袋以外の袋や物が写っていても、判断には使わないでください。
...
- 中身を箱に移し終えた空の袋を、箱の外に置くのは通常の作業です。
  袋が最後に箱の外にあることだけで not_charged にしないでください
- 中身が箱に入るところ、または中身が袋から無くなったことを画像で確認できない場合は、
  charged にしないでください
1: 出力例に具体的な値を書かない。キーと値の選択肢だけを説明する
2: 「投入する工程を撮影したもの」という前提を書かない。投入が起きた前提の答えに誘導してしまうため
3: 「空になった袋を箱の外に置くのは通常の作業」と明記する。書かないと「袋が最後に箱の外にある=未投入」と読まれる
4: partial(一部が袋に残った)を選択肢に加える。部分投入を区別するため
出力はJSONで、袋の見た目・時刻つきの変化・最後の位置・中身が残っているかを返させています。
判定だけでなく「なぜそう判定したか」を人が後から追えるようにするためです。
証跡として残す以上、ここは必要であると判断しました。
3.結果をDynamoDBに残す
Step Functionsが、ECSから返ってきた袋ごとの判定を計画(PLAN)と照合して、result を決めてDynamoDBに保存します。1テーブルで、指図をPKにしています。
| result | 条件 |
|---|---|
| OK | 計画内 かつ charged かつ 確信度 0.7以上 |
| NG:未投入 | 計画内 かつ not_charged |
| NG:部分投入 | 計画内 かつ partial |
| NG:計画外 | 計画外 かつ charged または partial |
| 要確認 | 上記以外(判断不能、パース失敗、確信度が低い) |
狙いは、人がマネジメントコンソールで指図を開けば result 列(日本語)を追うだけで分かること。
応答のパースに失敗した行を OK にしないのも、合格ラインを守るためです。
結果
シナリオ1〜4を通した結果です。
11袋中9袋が正解で、残る2袋は「要確認」。未投入・部分投入をOKにした袋はゼロで、合格ラインを満たしました!!
つまり、AWS上で材料が正しく入れられたの判定ができるということです。
| シナリオ | 内容 | 野菜の確信度 | カレー粉の確信度 | うどんの確信度 | 全体の判定 |
|---|---|---|---|---|---|
| S1 | 正常 | 0.88 (OK) | 0.78 (OK) | 0.78 (OK) | OK |
| S2 | 投入漏れ | 0.95 (NG:未投入) | 0.88 (OK) | 0.86 (OK) | NG |
| S3 | 部分投入 | 0.82 (NG:部分投入) | 0.82 (OK) | 0.72 (要確認) | NG |
| S4 | 遮蔽 | — (QR未検出) | 0.78 (OK) | 0.63 (要確認) | NG |
S2の未投入の野菜に対する実際の応答がこちらです↓
{
  "target_bag": "透明なビニール製のジッパー袋で、白い紙に緑色のQRコードが貼られている。
                 中には緑色やオレンジ色のプラスチック製の野菜のような物が複数入っている。",
  "timeline": [
    {"t": 6.1, "event": "対象の袋は箱の左下の床付近へ下げられ、中身が入ったまま見えている。"},
    {"t": 7.1, "event": "対象の袋は箱の左側の床に置かれ始める。中身は袋内に残っている。"}
  ],
  "final_bag_location": "段ボール箱の左側の床の上",
  "contents_left_in_bag": "yes",
  "verdict": "not_charged",
  "confidence": 0.95,
  "reason": "対象の透明ビニール袋は一度も箱の真上に来て袋の口を箱へ向ける動作が確認できず、
             中身が箱の中へ落ちる場面もない。..."
}
「袋の口を箱へ向ける動作が確認できず」という根拠の立て方が、そのまま人のチェックポイントになっているのが良いですね。これなら現場の方にも説明できそうだと感じました。
「要確認」になった2袋はどちらも不透明な紙袋(うどん)でした。モデルは「中身が落ちる瞬間が見えず、空になったか断定できない」と答えています。正直、これは人が見ても同じことを言いそうなので、妥当なだと感じました。
透明な袋かどうかで判定のしやすさが変わる、というのは現場展開の際の考慮すべきことだと思いました。
処理時間と確信度の実測値
| 項目 | 実測 |
|---|---|
| 1本あたりの所要時間 | 24〜32分(ほぼすべてがQRの全フレーム走査) |
| 1袋あたりの入力トークン | 約2万(画像20枚) |
charged の確信度 |
0.74〜0.90 |
| OKの閾値 | 0.70(当初0.95では全件が「要確認」に落ちた) |
未投入を見逃さないことは、閾値ではなく判定そのもので守れていました。
未投入・部分投入は確信度0.82〜0.95で、それぞれ not_charged / partial と答えています。
所要時間の24〜32分は、ほぼ全部がQRの全フレーム走査です。リアルタイム処理は要件に入れていないので今回は許容していますが、フレームを間引けば1/6くらいにはなる見込みですね。
コストを試算してみた
動画1本(3袋)を処理するコスト
| 項目 | 根拠 | 1本あたり |
|---|---|---|
| GPT-5.5 入力 | 19,472トークン/袋 × 3袋 × $5/1Mトークン | $0.292 |
| GPT-5.5 出力 | 平均1,684トークン/袋 × 3袋 × $30/1Mトークン | $0.152 |
| Fargate(1 vCPU / 4GB) | 平均28.4分 × $0.0727/時 | $0.034 |
| Step Functions・S3・DynamoDB・CloudWatch Logs | 状態遷移は約20回/実行 | $0.001未満 |
| 合計 | 約$0.48(約72円) |
1袋あたり約$0.15、日本円で23円くらいですね。投入1回あたり23円を証跡のために払う価値があるかどうかは会社ごとの判断になると思います。
内訳でいうと9割強がVLMの料金です。処理時間のほとんどを占めているQR走査(約30分)は、費用としては7%程度。なので、フレームを間引く改善は所要時間には効きますが、コストにはあまり効かないですね。コストを下げたいならモデルに渡すフレーム枚数を減らす方が早そうです。
※単価は請求額から逆算しています。GPT-5.5は入力$5・出力$30(いずれも1Mトークンあたり、global. プロファイル)、Fargateは東京リージョンのx86料金。
※2026年10月時点の情報です。1ドル150円換算
検証全体でかかった費用
| 区分 | 内訳 | 金額 |
|---|---|---|
| VLM | GPT-5.5(入力0.61M / 出力0.075Mトークン) | $5.28 |
| Nova Pro(入力0.95Mトークン) | $0.93 | |
| Nova 2 Lite | $0.12 | |
| 計算・ネットワーク | Fargate(4.3 vCPU時間) | $0.31 |
| NATインスタンス、EBS、パブリックIPv4 | $0.15 | |
| その他 | AWS Config、CloudWatch、Step Functions、S3、ECR | $0.30 |
| 合計 | 約$7.1(約1,060円) |
検証まるごとで約1,060円でした。しかもその大半はモデルの比較(11袋 × 3モデル × 複数回)に使った分で、パイプラインそのものを通す費用は$1未満です。卓上規模の技術検証なら、このくらいの桁で回せるのは確かに大きいですね。
置いているだけでかかる固定費
| 項目 | 1日 | 1か月 |
|---|---|---|
| NATインスタンス(t4g.micro) | 約$0.26 | 約$7.9 |
| パブリックIPv4 | 約$0.12 | 約$3.7 |
動画を処理していなくてもかかる分です。検証が終わったら cdk destroy で落とす前提ですね。
苦戦したところ
動画をそのまま渡したら、判定になっていなかった
当初はAmazon Nova 2 Liteに動画クリップをそのまま渡す設計でした。
ところが結果を見たら、11袋すべてが観察項目の値も verdict=charged も confidence=0.8 も、プロンプトに書いた出力例とまるごと同じだったんです。
未投入のS2の野菜も「投入」と判定していました。
切り分けたら、物(緑とオレンジのおもちゃの野菜、茶色い紙袋)は正しく認識している一方で、動作だけが誤りだらけでした。床に置いた袋を「箱に入れた」、同じ動作を9回くり返す、など。
原因はドキュメントに書いてありました。
Nova 2は動画を1fps(1秒に1コマ)で取り込み、672×672の正方形に歪めて縮小する仕様です。5fpsで切り出した15秒のクリップを渡しても、モデルが見ているのは15枚だけ。
投入動作は1秒未満で終わりうるので、そもそも見えていなかったわけですね。
ここから、動画ではなくフレーム画像列を渡す方式に切り替えました。
- 動画入力のVLMは、内部のサンプリングレート(1秒あたり何コマ見るか)と解像度を先に確かめる
- プロンプトの出力例に具体値を書くと、判断できないモデルはその値を写す
モデルによって結果が大きく違った
フレーム画像20枚に揃えたうえで、11袋(投入8・未投入1・部分投入1、遮蔽の1袋はQR未検出)で比べました。
| モデル | 正解数 | 未投入・部分投入をchargedにした数 | 問題 |
|---|---|---|---|
| Nova 2 Lite | 4 | 1 | 3袋で出力が崩れた(同じ語のくり返し) |
| Nova Pro | 5 | 2 | プロンプトの書き方に引きずられた |
| GPT-5.5(3回) | 9 / 10 / 9 | 0 / 0 / 0 | 誤りは「判断できない」か「未投入」寄りの安全側 |
未投入・部分投入を charged にしなかったのはGPT-5.5だけだったので、これを採用しています。モデルの比較は、パイプラインを組み切る前に数袋分の画像列で先にやっておけば良かったですね。
その他の細かい落とし穴
| 症状 | 原因と対処 |
|---|---|
| ECSタスクがECRに届かず起動しない | NATインスタンス(t4g.nano)の初期化スクリプトがメモリ不足で強制終了し、iptablesが設定されていなかった。t4g.microに変更。タイプ変更だけでは初期化スクリプトが再実行されないので、論理IDも変えて作り直させる |
| QR走査が30分でタイムアウト | 全フレーム走査に約30分かかる。TimeoutSeconds を3600秒に延長 |
| 画像20枚をStep Functionsから渡せない | ペイロード上限が256KiB(262,144バイト)。判定をECSコンテナに移し、Converse APIで呼ぶ形にした |
| ECSが起動前に落ちると実行が止まらない | ecs:runTask.waitForTaskToken はコールバック待ちで、タスクの停止を検知しない。HeartbeatSeconds かEventBridgeでの検知が対策 |
| 評価用フレームが1枚も保存されない | WindowsのOpenCVは日本語を含むパスに cv2.imwrite で書けない。エラーも出さずに False を返す |
※GPT-5.5はglobal推論プロファイル(複数リージョンに処理を振り分けて呼び出す仕組み)のみの提供なので、国外リージョンで処理されうる点はPoCとして許容しています。IAMでは3つのARNに bedrock:InvokeModel が必要です。
※2026年10月時点の情報です
残っている課題
| 課題 | 内容 |
|---|---|
| QR走査が遅い | 1本約30分。フレームを間引くか、走査とデコードを並列化する |
| 不透明な袋が「要確認」になる | 紙袋の2袋。フレーム数や窓の長さ、プロンプトを見直す余地がある |
| 評価が各シナリオ1テイクだけ | 11袋の結果。ばらつきを見るには各3テイクが要る |
まとめ
食品工場の原材料投入を、QRコードで「何を」、VLMで「入れたか」に分けてAWS上で判定してみました。
役割分担を決めてから組んだので、11袋中9袋が正解、未投入・部分投入の見逃しゼロまで持っていけました!!
次は不透明な袋の「要確認」を減らしにいきたいと思います。