材料投入作業の有無判定をDGX SparkのローカルVLMで検証してみた

こんにちは!クラスメソッド製造ビジネステクノロジー部のtanaka-takeruです。
食品や材料の製造現場では、釜などへの材料投入工程が日常的に行われています。
材料の入れ忘れなどのヒューマンエラー防止のためにさまざまな仕組みが取り入れられていますが、
今回は、動画データから「材料の投入作業が行われたかどうか」を判定できるか、実際に検証実験を行ってみました。
データ
簡単に模擬動画を撮影しました。
段ボールに透明のビニール袋や紙袋の中身を、手作業で投入している様子です。
各袋には何を投入しているかを示すQRコードを貼り付けています。
作業の流れとしては、QRコードをカメラに示し、段ボールの中に投入するというものになります。
合計4シナリオ撮影して、1シナリオあたり3種類の材料(野菜、カレー粉、うどんの設定)の投入作業を行っています。
動画データとしては次のような値となっています。
| 動画データ | 解像度 | fps設定 | フレーム数 | 時間 |
|---|---|---|---|---|
| S1-take01 | 1280×720 | 30 | 1,689 | 56.54秒 |
| S2-take01 | 1280×720 | 30 | 1,513 | 50.66秒 |
| S3-take01 | 1280×720 | 30 | 1,657 | 55.47秒 |
| S4-take01 | 1280×720 | 30 | 1,591 | 53.26秒 |
※田中聖也さんに動画を撮影していただきました。
解析パイプライン
動画全てをローカル環境のVLMに入力してしまうと、動画のデコードでメモリが枯渇したり、VLM側で大幅にフレームが間引かれたりするため、動画の入力サイズを適切にコントロールすることが必要です。
そこで、動画の中で、特にVLMにチェックしてもらいたい区間(以降、クリップ)を抽出する処理を導入することが有効になります。これは他の動画データであっても同様のことが言え、特に製造現場や実験プロセスの様子をモニタリングする場合では、解析パイプラインの基本形になります。前処理には、古典的な画像処理や物体検出モデル、骨格検出を用いて、リアルタイムないし高速な処理を導入しますが、今回は、QRコード認識を用います。
動画中でQRコードを検出してから15秒間分のフレームを切り出してクリップを作成し、VLMに入力することとします。15秒以内に次の投入作業が行われる可能性もあるため、もし、15秒以内に次のQRコードを検知したら、そこでクリップを打ち切ります。
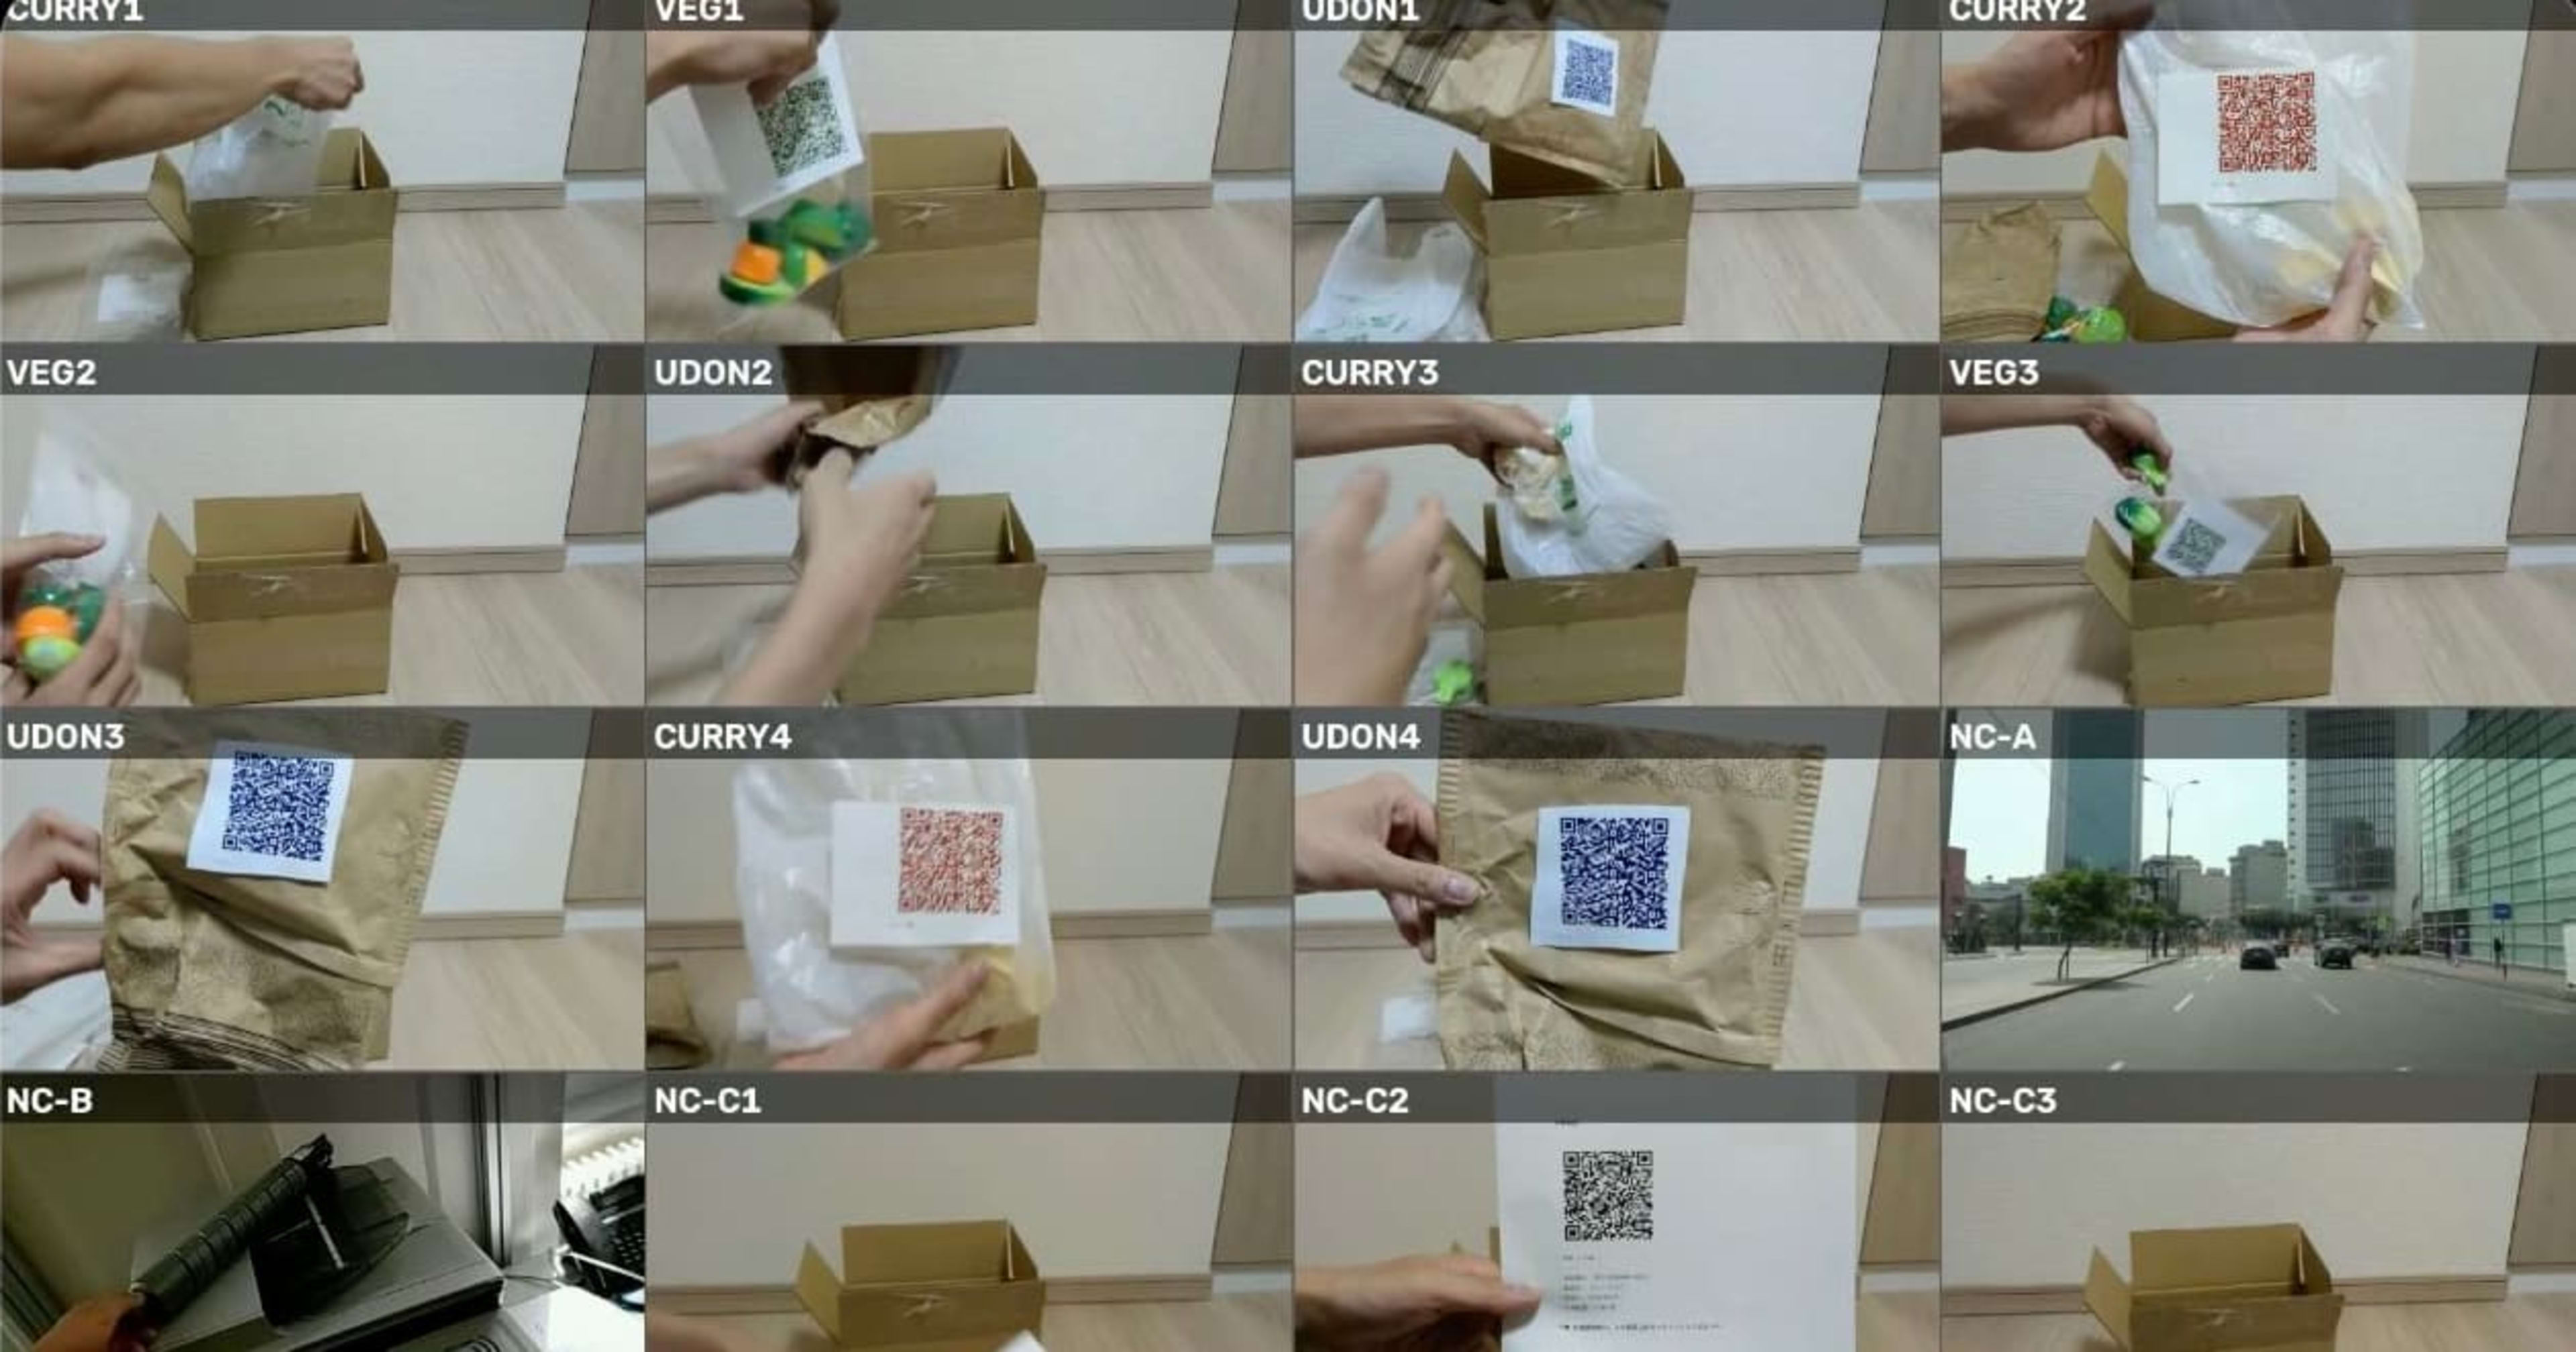
以上の処理で、先ほど示した4つの動画から作成したクリップの一覧を示します。
| ID | テイク | 材料 | フレーム数 | 長さ | 正解 |
|---|---|---|---|---|---|
| CURRY1 | S1-take01 | カレー粉 | 65 | 13.06秒 | 有 |
| VEG1 | S1-take01 | 野菜 | 75 | 15.06秒 | 有 |
| UDON1 | S1-take01 | うどん | 68 | 13.66秒 | 有 |
| CURRY2 | S2-take01 | カレー粉 | 75 | 15.07秒 | 有 |
| VEG2 | S2-take01 | 野菜 | 44 | 8.84秒 | 無 |
| UDON2 | S2-take01 | うどん | 52 | 10.45秒 | 有 |
| UDON3 | S3-take01 | うどん | 64 | 12.85秒 | 有 |
| CURRY3 | S3-take01 | カレー粉 | 63 | 12.65秒 | 有 |
| VEG3 | S3-take01 | 野菜 | 75 | 15.06秒 | 無 |
| UDON4 | S4-take01 | うどん | 55 | 11.05秒 | 有 |
| CURRY4 | S4-take01 | カレー粉 | 63 | 12.65秒 | 有 |
正解列には、投入作業がクリップ内にあったかどうかを 有 / 無 で記載しています。VLMが取り組む問題としては、この 有 / 無 を当てられるかということになります。
さらに、投入作業が行われなかったのに、有 と判定すること(偽陽性)が、実運用上大きなリスクになり得るため、慎重にチェックする必要があります。そこで、ネガティブコントロール用のデータ点として、次のクリップも実験データに加えます。
| ID | テイク | 材料 | フレーム数 | 長さ | 正解 |
|---|---|---|---|---|---|
| NC-A | — | 陰性対照(車載カメラ) | 63 | 12.61秒 | 無 |
| NC-B | — | 陰性対照(コピー機) | 50 | 12.50秒 | 無 |
| NC-C1 | S1-take01 | 陰性対照(同一シーン) | 51 | 10.24秒 | 無 |
| NC-C2 | S2-take01 | 陰性対照(同一シーン) | 55 | 11.05秒 | 無 |
| NC-C3 | S3-take01 | 陰性対照(同一シーン) | 50 | 10.04秒 | 無 |
合計16クリップを示します。
また、エッジケースとしての二例を補足します。
- VEG2 : QRコードの提示はあったものの、投入作業が行われず、野菜の袋は段ボールの横に置かれたまま終わる。
- VEG3 : QRコードの提示・投入作業は行われたものの、袋の中に野菜が1個残り、全量が投入されなかった。
※今回、投入作業の有無を問う設定なので、VEG3を 有 / 無 のどちらにするかは議論の余地がありますが、ポカよけを目的と考えたときに、より厳しくチェックすることが望ましいと考え、無 を正解と設定しました。実務では、投入の作業と投入された量は機能的に分けて保証すべきです。
クリップの動画データとしては次のような値となっています。
| ID | 解像度 | fps設定 | フレーム数 | 長さ | 正解 |
|---|---|---|---|---|---|
| CURRY1 | 1280×720 | 5 | 65 | 13.05秒 | 有 |
| VEG1 | 1280×720 | 5 | 75 | 15.06秒 | 有 |
| UDON1 | 1280×720 | 5 | 68 | 13.66秒 | 有 |
| CURRY2 | 1280×720 | 5 | 75 | 15.07秒 | 有 |
| VEG2 | 1280×720 | 5 | 44 | 8.84秒 | 無 |
| UDON2 | 1280×720 | 5 | 52 | 10.45秒 | 有 |
| UDON3 | 1280×720 | 5 | 64 | 12.85秒 | 有 |
| CURRY3 | 1280×720 | 5 | 63 | 12.65秒 | 有 |
| VEG3 | 1280×720 | 5 | 75 | 15.06秒 | 無 |
| UDON4 | 1280×720 | 5 | 55 | 11.05秒 | 有 |
| CURRY4 | 1280×720 | 5 | 63 | 12.65秒 | 有 |
| NC-A | 1280×720 | 5 | 63 | 12.61秒 | 無 |
| NC-B | 896×504 | 5 | 50 | 12.50秒 | 無 |
| NC-C1 | 1280×720 | 5 | 51 | 10.24秒 | 無 |
| NC-C2 | 1280×720 | 5 | 55 | 11.05秒 | 無 |
| NC-C3 | 1280×720 | 5 | 50 | 10.04秒 | 無 |
fps設定のトレードオフについて
元動画は30fps設定で撮影されたものですが、クリップ処理の過程で5fps設定まで落としています。当然fpsが高いほど一瞬の動きも捉えられるメリットがありますが、VLMに入力する上で、画素数とのバランスを取って調整しています。
具体的には、例えば今回検討したVLMの一つ、Cosmos3-Nanoのプロセッサは、動画全体を一定のトークン数(実測で約12,000)に収めるよう、フレーム数に応じて解像度を自動的に下げます。つまりfpsを上げると、モデルが受け取る情報量が、フレームあたりの画素数側で調整されてしまいます。時間方向の細かさと空間方向の細かさがトレードオフになっています。仮に30fpsのまま入力すると、1フレームあたりの画素数が、5fpsと比べて、6分の1(約310×170)まで落ちることが確認できました。そこで、データを目視確認しながら、投入動作を捉えられる最低限の画素数・fpsを768×416以上・5fpsとしました。
ローカルVLMについて
実行環境は次の通りです。
| 項目 | 値 |
|---|---|
| デバイス | NVIDIA DGX Spark(GB10) |
| CPU | ARM64/aarch64、20コア |
| GPU | NVIDIA GB10(Blackwell、Compute Capability 12.1) |
| メモリ | 128GB 統合メモリ |
| NVIDIAドライバ | 580.173.02 |
| CUDA | 13.0 |
| Python | 3.13.15 |
| PyTorch | 2.10.0+cu130 |
| transformers | 5.17.0 |
精度・速度の比較のため、次のモデルを使用しました。
| モデル名 | 提供元 | Hugging Face ID | コミットハッシュ | 精度 |
|---|---|---|---|---|
| Qwen3-VL-8B-Instruct | Alibaba Cloud (Qwen) | Qwen/Qwen3-VL-8B-Instruct |
0c351dd01ed87e9c1b53cbc748cba10e6187ff3b |
BF16 |
| Cosmos-Reason2-8B | NVIDIA | nvidia/Cosmos-Reason2-8B |
a9fae2cf89dc64db96b12860417f0eb403013bb9 |
BF16 |
| Cosmos3-Edge | NVIDIA | nvidia/Cosmos3-Edge |
a9d944e2c6a1bf9f48b92ad16348e70c5f1836ba |
BF16 |
| Cosmos3-Nano | NVIDIA | nvidia/Cosmos3-Nano |
7a312c868bcce8e40b3eb40861300a9d0ba3fde1 |
BF16 |
| InternVL3.5-8B-HF | OpenGVLab | OpenGVLab/InternVL3_5-8B-HF |
741a7d03020411e666c6109218ab71e08151ef86 |
BF16 |
5つのうち、 InternVL3.5-8B-HF 以外の4つのモデルは、言語側にQwen系のモデルを採用しています。特に Cosmos-Reason2-8B は、アーキテクチャ・層数・語彙数・重みファイルの合計サイズ(17.53GB)のいずれも Qwen3-VL-8B-Instruct と一致しており、同モデルに対しNVIDIAがポストトレーニングしたことが見てとれます。
Cosmos3-Nano は言語側・視覚側の構成が Qwen3-VL-8B-Instruct と同一ですが、パラメータ数は約15.8Bと約1.8倍であり、この差は映像生成を担う拡散モデル側(diffusion_expert_config)に由来します。ただし推論時のピークメモリが他のQwen系3モデルと同値(21.4GB)であることからも、本タスクのような Reasoning では生成側は使用されません。InternVL3.5-8B-HF は言語側にテキスト専用の Qwen3-8B を用いていますが、視覚側は独自実装であり、フレームあたり256トークンの固定割当という、どのモデルとも異なる方式を採用しています。また、Cosmos3-Edge のみが語彙数131,072・約3.9Bと、より小ささ・速さを重視した構成となっています。
今回は、 Qwen3-VL-8B-Instruct をベースラインとしたポストトレーニングの影響、Cosmosファミリーのモデルサイズ、アーキテクチャの観点で結果を比較できるように5つのモデルを選びました。
プロンプト
以下の文字列を、全モデルで変更せずに使用しています。システムプロンプトは設定していません。
ダンボールの中への投入動作の有無を観察し、有/無/わからないで判定してください。
生成パラメータ
クリップを処理するにあたって各モデルの生成パラメータは次の通りとしました。
| パラメータ | 値 |
|---|---|
do_sample |
False(貪欲法) |
temperature / top_p / top_k |
指定しない |
repetition_penalty |
既定値1.0(無効) |
max_new_tokens |
4096(Cosmos3系3モデルのモデルカードがreasoning出力に対しmax_tokens=4096+を推奨) |
do_sample=False で貪欲法を採用しています。言語モデルは、各ステップで語彙全体に対する確率分布を出力しますが、do_sample=True では、この分布から乱数を用いて1語を選ぶため、同一の入力に対しても実行ごとに異なる出力が生じ得ます( temperature で分布の山の鋭さを調整し、 top_k / top_p で下位の候補を切り捨てたうえで妥当な出力を抽出します)。対して、貪欲法( do_sample=False )は、確率が最大の語を常に選ぶため、乱数を用いず、同一の入力に対して同一の出力を返します。製造現場のモニタリングや判断を目的とする場合、同じ入力に対しては同じ結果を得ることが重要ですので貪欲法を採用します。
なお、貪欲法の再現性は、ハードウェア・ライブラリのバージョン・バッチ構成が同一であることを前提としています。運用時にはこれらを固定し、判定ごとに記録する必要があります。
推論のソースコードの例を示します。
import torch
from transformers import AutoProcessor, Cosmos3OmniForConditionalGeneration

MODEL_ID = "nvidia/Cosmos3-Nano"
PROMPT = "ダンボールの中への投入動作の有無を観察し、有/無/わからないで判定してください。"

processor = AutoProcessor.from_pretrained(MODEL_ID)
model = Cosmos3OmniForConditionalGeneration.from_pretrained(
    MODEL_ID, dtype=torch.bfloat16, device_map="auto")

messages = [{"role": "user", "content": [
    {"type": "video", "path": "clips/S3-take01/veg.mp4"},
    {"type": "text", "text": PROMPT},
]}]

inputs = processor.apply_chat_template(
    messages, fps=5, tokenize=True, add_generation_prompt=True,
    return_dict=True, return_tensors="pt",
).to(model.device, torch.bfloat16)

generated = model.generate(**inputs, max_new_tokens=4096, do_sample=False)

trimmed = generated[0][inputs["input_ids"].shape[-1]:]
print(processor.batch_decode([trimmed], skip_special_tokens=True)[0])
結果
精度
まずは各クリップに対して各モデルの出力結果をまとめます。左から成績順にモデルを並べています。
| clip | 正解 | Cosmos3-Nano | Qwen3-VL-8B-Instruct | Cosmos-Reason2-8B | Cosmos3-Edge | InternVL3.5-8B-HF |
|---|---|---|---|---|---|---|
| CURRY1 | 有 | 有 | 有 | 有 | 有 | 有 |
| VEG1 | 有 | 有 | 有 | 有 | 無 | 有 |
| UDON1 | 有 | 有 | 有 | 有 | 無 | 有 |
| CURRY2 | 有 | 有 | 有 | 有 | 有 | 有 |
| VEG2 | 無 | 無 | 無 | 有 | 有 | 有 |
| UDON2 | 有 | 有 | 有 | 有 | 無 | 有 |
| UDON3 | 有 | 有 | 有 | 有 | 有 | 有 |
| CURRY3 | 有 | 有 | 有 | 有 | 無 | 有 |
| VEG3 | 無 | 無 | 有 | 有 | 無 | 有 |
| UDON4 | 有 | 有 | 有 | 有 | 無 | 有 |
| CURRY4 | 有 | 有 | 有 | 有 | 有 | 有 |
| NC-A | 無 | 無 | 無 | 無 | 無 | わからない |
| NC-B | 無 | 無 | 無 | 無 | わからない | わからない |
| NC-C1 | 無 | 無 | 無 | 無 | 無 | 有 |
| NC-C2 | 無 | 無 | 無 | 無 | 無 | 有 |
| NC-C3 | 無 | 無 | 無 | 無 | 無 | 有 |
モデル別の成績をまとめます。
| モデル | 正解 | 無を有と判定 | 有を無と判定 | わからない | 解析不能 |
|---|---|---|---|---|---|
| Cosmos3-Nano | 16/16 | 0 | 0 | 0 | 0 |
| Qwen3-VL-8B-Instruct | 15/16 | 1 | 0 | 0 | 0 |
| Cosmos-Reason2-8B | 14/16 | 2 | 0 | 0 | 0 |
| Cosmos3-Edge | 9/16 | 1 | 5 | 1 | 0 |
| InternVL3.5-8B-HF | 9/16 | 5 | 0 | 2 | 0 |
Cosmos3-Nano のみが全問正解という結果となりました。僅差で Qwen3-VL-8B-Instruct 、Cosmos-Reason2-8B が続き、Cosmos3-Edge と InternVL3.5-8B-HF は大きく差をつけられる形となりました。
Qwen3-VL-8B-Instruct が間違えた一例はVEG3であり、投入動作はあったものの袋に材料が残ってしまったクリップですので、 Cosmos3-Nano とほぼ近い成績と考えています。
速度・負荷
推論の速度・負荷面を表にまとめます。前処理の内訳は動画のデコード・テンソル化・GPU転送処理となっています。この前処理時間に生成時間を足した時間をサイクルタイムとしています。QR読み取り処理は含めていません。
また、プリフィル速度は、モデルが入力(動画由来のトークン)を読み込む速度であり、入力トークン数をmodel.generate()の実行時間で除して算出しています。今回は出力が概ね2トークンと極めて短く、処理時間のほぼ全体が入力の読み込みに費やされるため、この指標を以て実質的な処理速度を評価しています。
サイクルタイム順に結果を表にまとめます。
| モデル | 前処理(秒) | 生成(秒) | サイクルタイム(秒) | 入力トークン | プリフィル速度(tok/秒) | モデルロード(秒) | ピークメモリ |
|---|---|---|---|---|---|---|---|
| Cosmos3-Edge | 0.313 | 4.578 | 4.91 | 23,618 | 5,189 | 28.1 | 9.7GB |
| Cosmos3-Nano | 0.292 | 5.654 | 5.94 | 11,945 | 2,113 | 115.0 | 21.4GB |
| Qwen3-VL-8B-Instruct | 0.289 | 5.638 | 5.94 | 11,945 | 2,118 | 123.5 | 21.4GB |
| Cosmos-Reason2-8B | 0.292 | 5.692 | 6.02 | 11,945 | 2,100 | 103.6 | 21.4GB |
| InternVL3.5-8B-HF | 0.259 | 6.527 | 6.79 | 16,655 | 2,556 | 103.1 | 22.4GB |
やはり Cosmos3-Edge が速い結果となりました。なお、サイクルタイムの変動幅は、Nano・Qwen3VL・Reason2・Edgeで1割未満でした。InternVLのみ4.58〜11.28秒と2.5倍の幅があり、これはInternVLのトークン数がフレーム数に比例する仕様からきていると考えます。
生成トークン数と出力言語
生成されたトークン数と出力言語についてもまとめます。
| モデル | 生成トークン数(中央値) | 最大 | 上限到達 | 出力言語 |
|---|---|---|---|---|
| Cosmos3-Nano | 2 | 2 | 0 | 日本語 16/16 |
| Qwen3-VL-8B-Instruct | 2 | 2 | 0 | 日本語 16/16 |
| Cosmos-Reason2-8B | 2 | 2 | 0 | 日本語 16/16 |
| Cosmos3-Edge | 2 | 3 | 0 | 日本語 11/16、英語等 5/16 |
| InternVL3.5-8B-HF | 2 | 39 | 0 | 日本語 16/16 |
max_new_tokens=4096に到達したケースはゼロで、反復ループも発生してませんでした。
Edgeのみ出力言語が安定せず、同一プロンプトに対してYes、yes、無、不存在、不明と異なる語彙が出力された結果となりました。
判定の確信度の検討
今回のタスクの正解・不正解は生成1トークン目で確定します(有か無なので)。そのトークンの確率を記録することで、定量的に判断結果の確信度として解釈し、例えば人間のレビュー動線に使えるのではと考えました。「無」が正解である7つのクリップに対する結果をまとめます。
| モデル | VEG2 | VEG3 | NC-A | NC-B | NC-C1 | NC-C2 | NC-C3 |
|---|---|---|---|---|---|---|---|
| Cosmos3-Nano | 無 .801 | 無 .526 | 無 .777 | 無 .796 | 無 .688 | 無 .594 | 無 .616 |
| Qwen3-VL-8B-Instruct | 無 .990 | 有 .998 | 無 .988 | 無 .999 | 無 .794 | 無 .937 | 無 .900 |
| Cosmos-Reason2-8B | 有 .543 | 有 .678 | 無 .851 | 無 .794 | 無 .694 | 無 .643 | 無 .489 |
| Cosmos3-Edge | 有 .419 | 無 .569 | 無 .367 | 不明 .179 | 無 .556 | 無 .747 | 無 .564 |
| InternVL3.5-8B-HF | 有 .916 | 有 .791 | 不明 .193 | 不明 .397 | 有 .415 | 有 .555 | 有 .547 |
Cosmos3-Nano では、最も判定が難しいVEG3の値や、ネガティブコントロールの中でも投入有りに見え方が近い NC-C1~C3 で値が落ち込んでいるため、一見すると使えそうな印象を持ちますが、その他のモデルでは投入無しの事実に対して関係性が見られなさそうです。
16クリップに対する各モデルの値の範囲を示します。
| モデル | 正解時のトークン確率の範囲 | 誤り時のトークン確率 |
|---|---|---|
| Cosmos3-Nano | 0.526 – 0.888 | 誤りなし |
| Qwen3-VL-8B-Instruct | 0.794 – 1.000 | 0.998(VEG3) |
| Cosmos-Reason2-8B | 0.489 – 0.901 | 0.543(VEG2)、0.678(VEG3) |
| InternVL3.5-8B-HF | 0.791 – 0.945 | 0.415 – 0.916 |
データ点数を増やしつつ、値が解釈可能かについて検討していきたいと思います。
まとめ
タスクに関しては、16クリップの実験において、Cosmos3-Nano が全て正解しました。また、およそ10~15秒程度の動画データに対して、DGX Spark上でのサイクルタイムの中央値は5.94秒となりました。現時点で、このタスクで最も優れたモデルの可能性があると考えます。また、Qwen3-VL-8B-Instruct についても近いパフォーマンスであることが確認できました。
実際に運用するにあたっては、投入無しのクリップを中心にデータ点数を増やして、信頼性を上げることが重要です。
統計的には、0件観測時の95%上側信頼限界(Clopper-Pearson、1 - 0.05^(1/n))は、n=2で77.6%です。つまり、データ数が2件の場合、たまたま一度も問題が発生しなかったとしても、統計的には「最大で約78%の確率で発生する可能性がある」ということです。
今回は意図的にネガティブコントロール用のクリップを追加しましたが、実務では、まずは最低30点ほどのクリップでパイプラインを立ち上げ、実際に現場で日付や作業者、ロット、拠点などを変えながら、300点以上にデータ点数を増やして調整を進めることが重要と考えます。