【登壇資料】 DevelopersIO 2026 Osakaで「AI の判定を ワークフローに組み込んでみよう」というタイトルで登壇しました! #devio2026

こんにちは。
コンサルティング部の桑野です。
2026年9月28日、29日に開催された Classmethod DevelopersIO 2026 Osaka の Day2 で「AI の判定をワークフローに組み込んでみよう」というタイトルで登壇しました。
大阪オフィスでは2セッション同時並行で進行していたのですが、私は A 会場の最初のセッションを担当させていただきました。
使用したスライドと登壇内容を本ブログにて共有します。
スライド
自己紹介
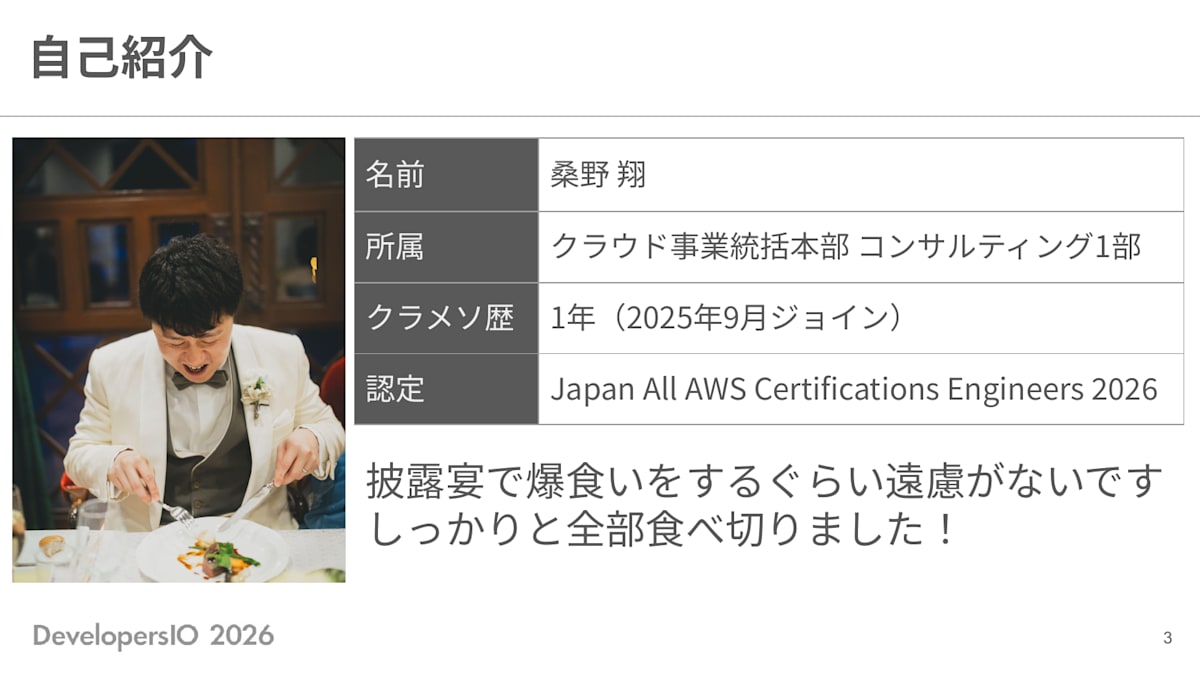
冒頭自己紹介しました。今回はこんな感じです。
スライドには妻とツーショットの写真もスライドに入れていましたが、記事では割愛します。
7月に結婚式を挙げました。
クラウド事業統括本部 コンサルティング1部でソリューションアーキテクトとして働いています。
クラスメソッドにはちょうど去年の9月にジョインしたので、クラメソ歴は1年になります。
自分たちの披露宴で料理を爆食いするぐらい遠慮がない人間です。お料理はしっかりと食べ切りました。
想定する対象と目的
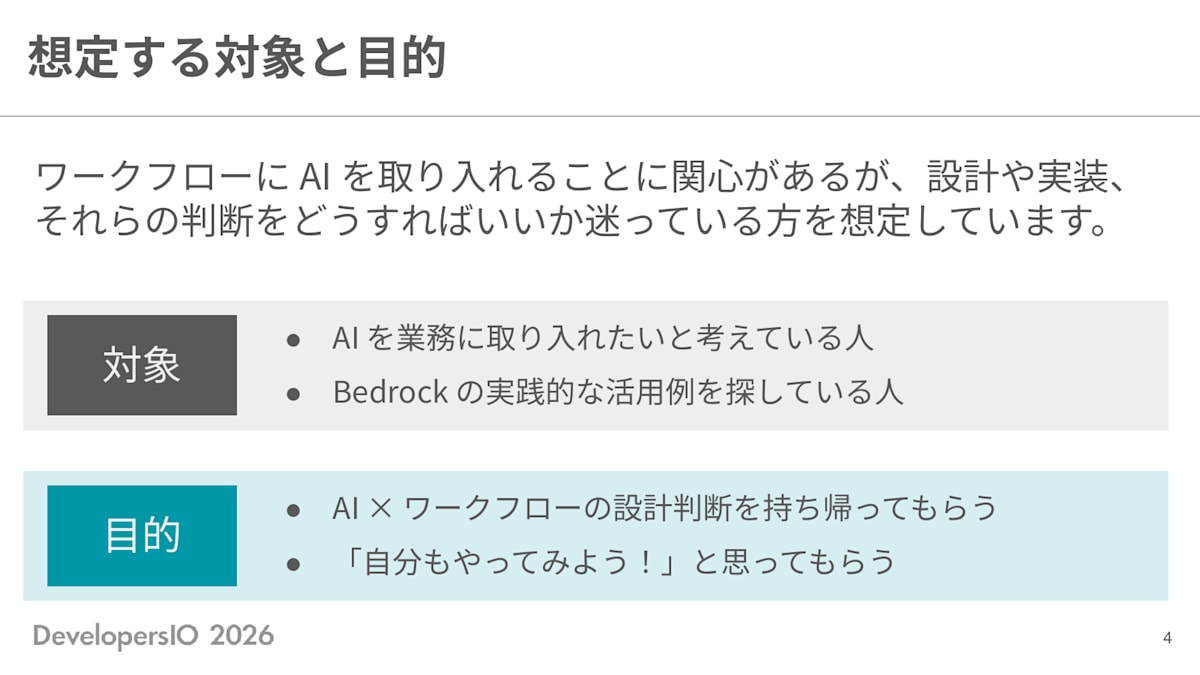
本セッションは、ワークフローに AI を取り入れることに関心があるものの、設計や実装、それらの判断をどうすれば良いか迷っている方を特に想定しています。
- AI を業務に取り入れたいと考えている人
- Bedrock の実践的な活用例を探している人
目的は以下の2点です。
- AI × ワークフローの設計判断を持ち帰っていただく
- 「自分もやってみよう!」と思っていただく
アジェンダ
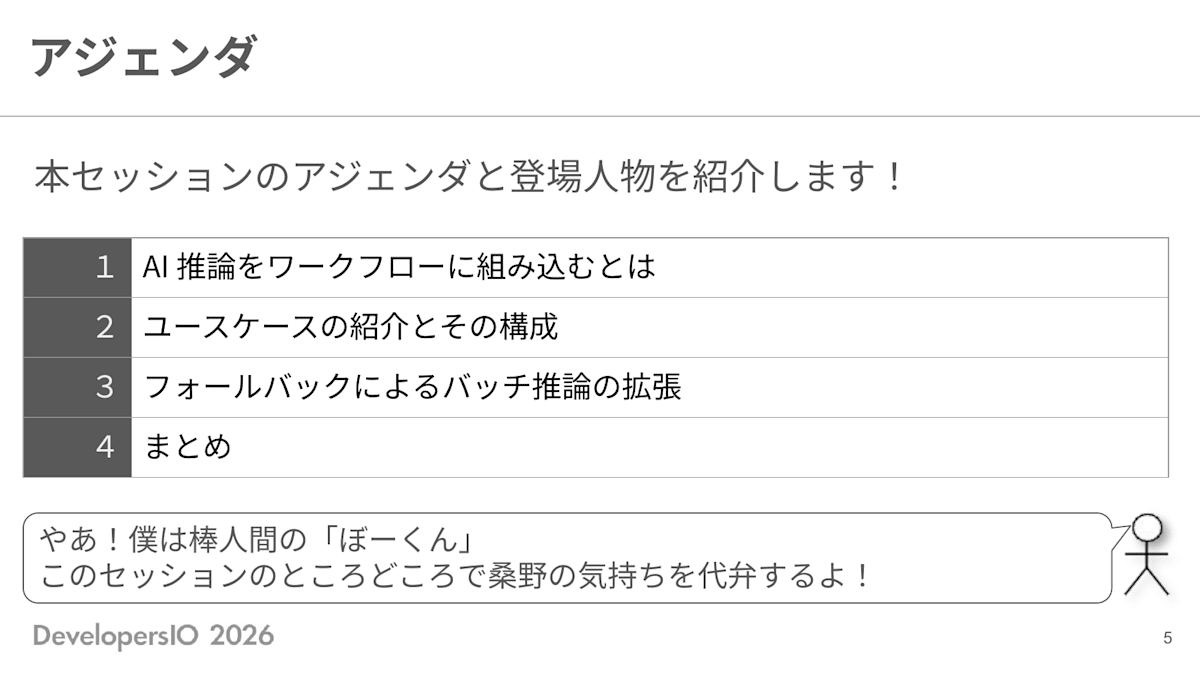
アジェンダは以下の4つで構成しています。
- AI 推論をワークフローに組み込むとは
- ユースケースの紹介とその構成
- フォールバックによるバッチ推論の拡張
- まとめ
また、本セッションには棒人間の「ぼーくん」が登場します。
セッションのところどころで私の気持ちを代弁してもらいました。
AI 推論をワークフローに組み込むとは
私が考えるワークフローのイメージ
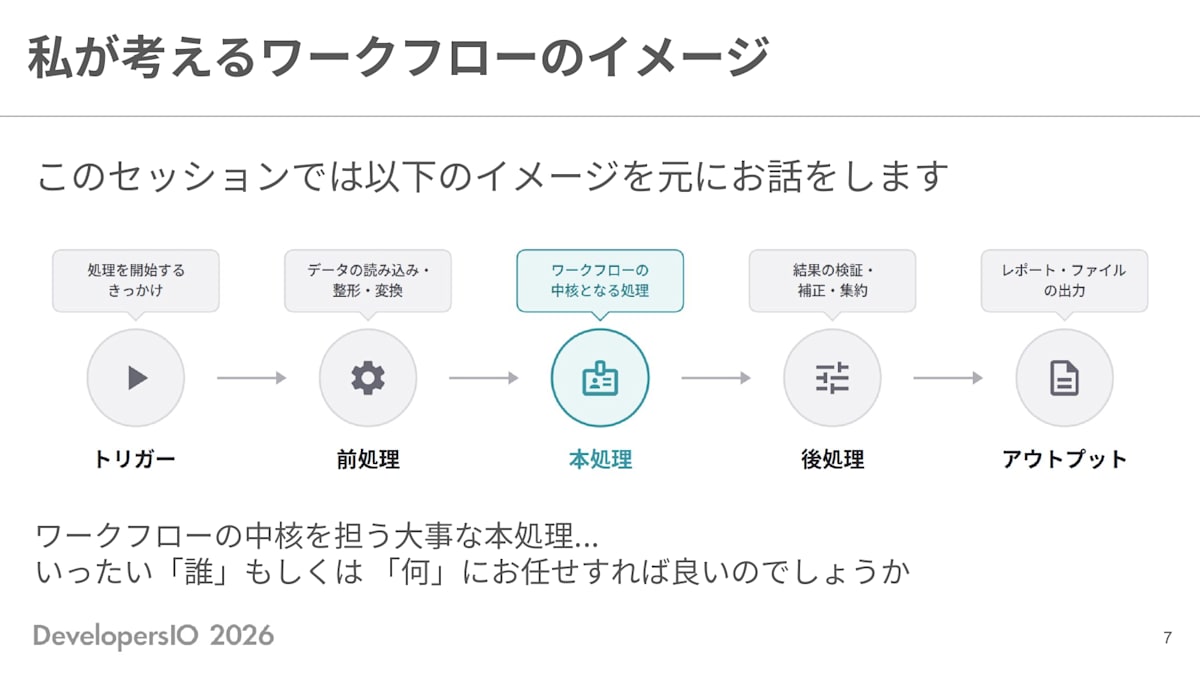
本セッションでいうワークフローは、トリガー、前処理、本処理、後処理、アウトプットの5つのジョブから構成されるものとしました。
何かしらの処理を開始するきっかけ(トリガー)をもとに、データを読み込んで整形・変換する前処理を経て、ワークフローの中核となる本処理を行います。
本処理の結果は、検証・補正・集約といった後処理を施し、最終的にレポートやファイルといったアウトプットが成果物として残ります。
ここで考えたいのは、ワークフローの中核を担う大事な本処理を、いったい「誰」もしくは「何」にお任せすれば良いのかという点です。
3つのパターンを考えてみました。
人間に任せる場合
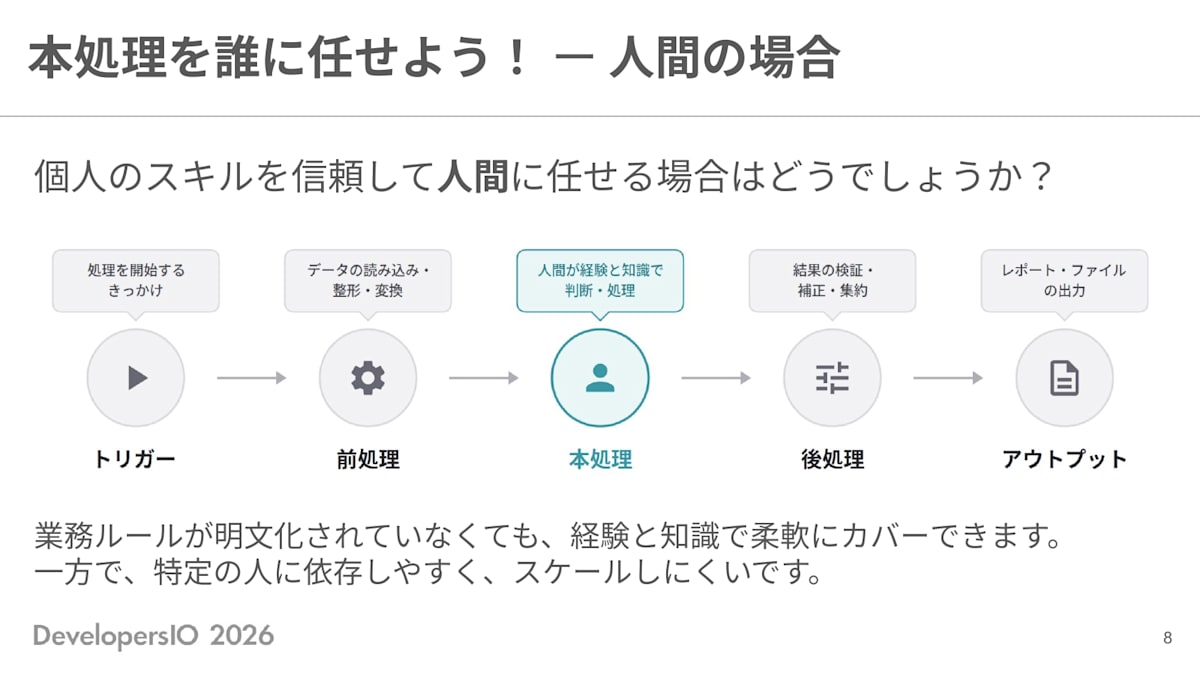
人に任せる場合は、個人のスキルを信頼することになります。
業務ルールが明文化されていなくても、任せられた人の経験と知識で柔軟にカバーできます。
一方で、特定の人に依存しやすくなります。
スケールしたいとなった場合、その方と同じようなスキル・知識・経験を持つ人を新しく投入しなければなりません。
プログラムに任せる場合
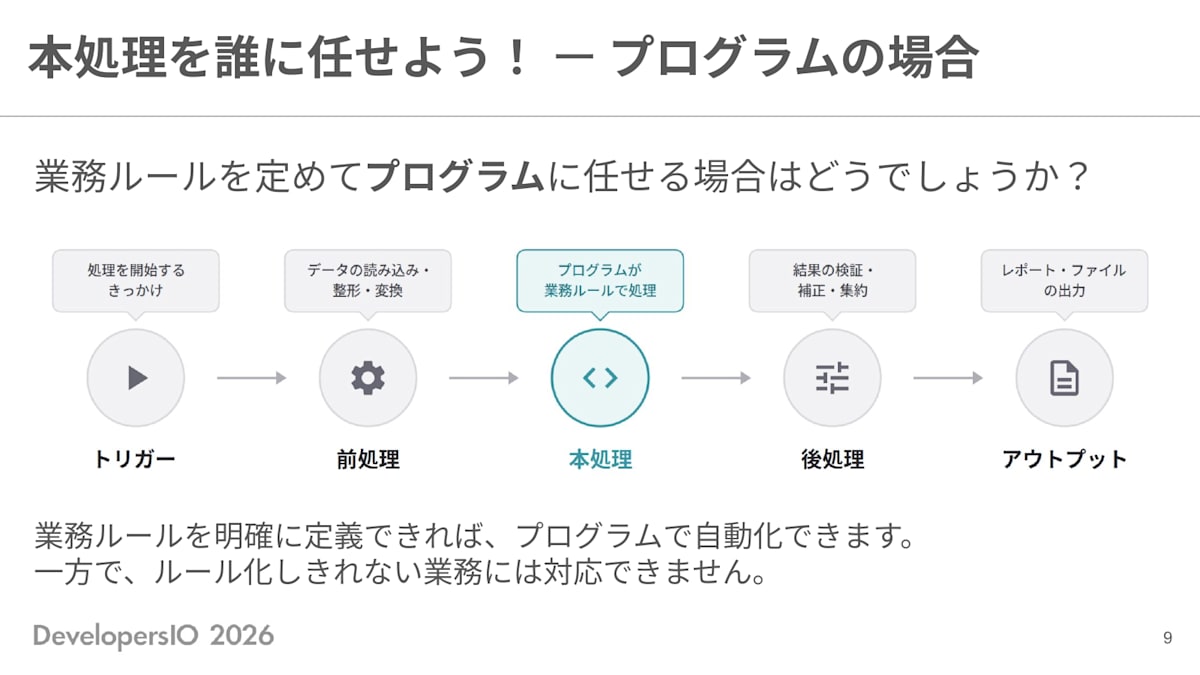
プログラムに任せる場合は、業務ルールを定める必要があります。
業務ルールを明確に定義できればプログラムで自動化できる一方で、ルール化しきれない業務にはどうしても対応が難しくなります。
AI に任せる場合
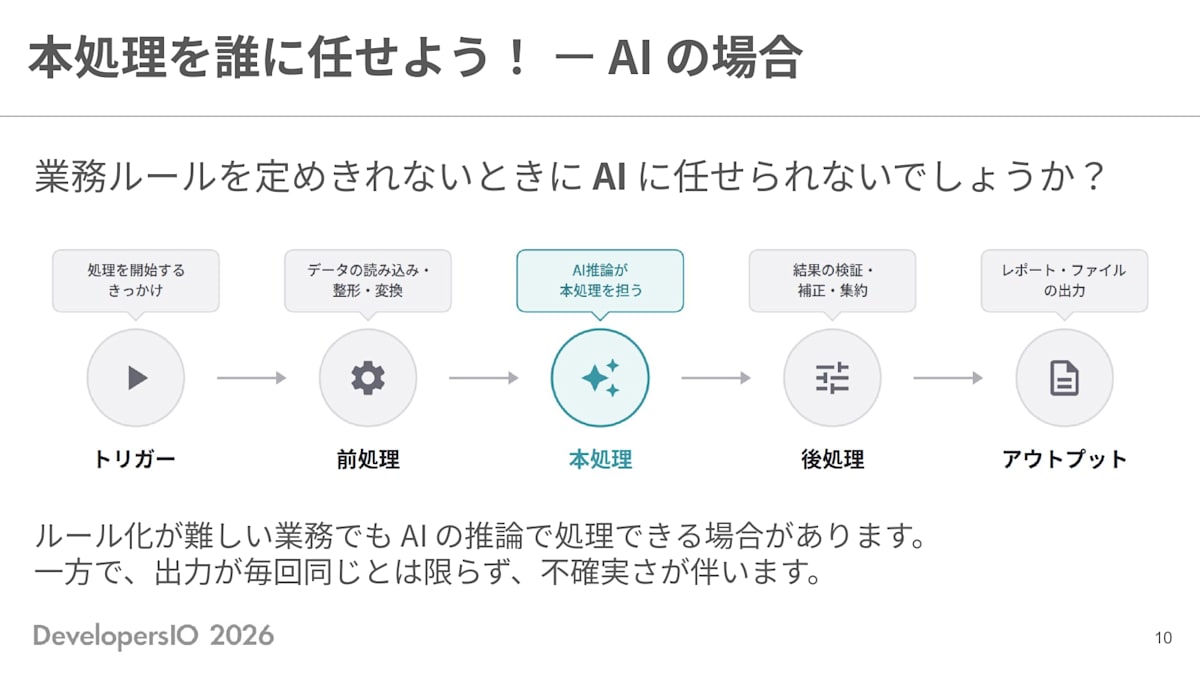
では、業務ルールを定めきれないときに AI に任せることはできないでしょうか。
ルール化が難しい業務であっても、AI の推論で処理できる場合があるかもしれません。
一方で、出力が毎回同じとは限らないため、不確実さが伴います。
実際に AI 推論をワークフローに組み込んでみた
ユースケースとしての一例になりますが、ルール化が難しい大量データの判定業務を AI 推論で置き換えてみました。
実際に作ってみると、設計上の判断に迷うポイントや、工夫が必要な場面がいくつかありました。
ここから先は、試行錯誤の過程で私が学んだ内容をお伝えします。
なお、ワークフローや推論には AWS のサービスを利用しています。
AWS 以外のサービスをお使いの方は「自分の環境だったらどう作るだろう」とイメージしながら読んでいただければと思います。
ユースケースの紹介とその構成
こんな業務はありませんか?
例えば、以下のような業務です。
- 大量のテキストデータを人手で分類・判定している
- ルールベースで自動化したいが、自然言語の揺れが大きくルール化が困難
まずは確実に制御できる形で自動化できるよう、プログラムでの代替を考えます。
しかし、ルールとして整備するには現場の知見を棚卸しする必要があります。
労力がかかる分、時間や人手が限られた状況では厳しい場合も少なくありません。
今回のユースケース
今回は以下のような架空の業務要件に対処します。
- E コマースのカスタマーサポートに届くクレームが対象
- 自然言語で書かれたクレーム本文ごとに以下を判定する
- 緊急度(HIGH / MEDIUM / LOW / INFO)
- 対応カテゴリ(SAFETY / DEFECT など)
- 対処が追いつかず、日常的に件数が積み重なる(最大10万件)
人手で回すのがそろそろ厳しくなってきたので、業務改善のターゲットに選ばれた、という想定です。
入力内容のイメージ
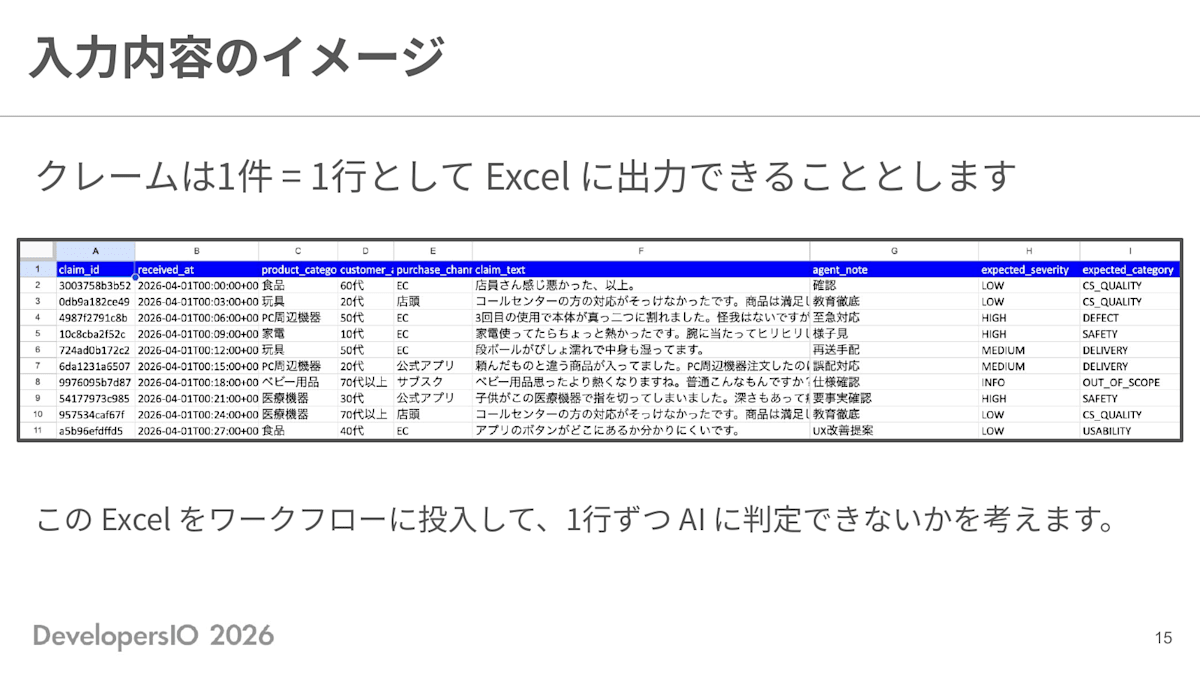
クレームは1件 = 1行として Excel に出力できることとします。
この Excel をワークフローに投入して、1行ずつ AI に判定させられないかを考えます。
ワークフローで処理するなら、以下のような流れになりそうです。
- Excel ファイルの投入を起点に、クレームを1行ずつ分割する
- 分割したクレームを1行ずつ AI に判定させる
- 判定結果が正しいかをチェックし、人間が分かりやすい形に加工して成果物を整える
AWS 上で作る場合のワークフローの構成
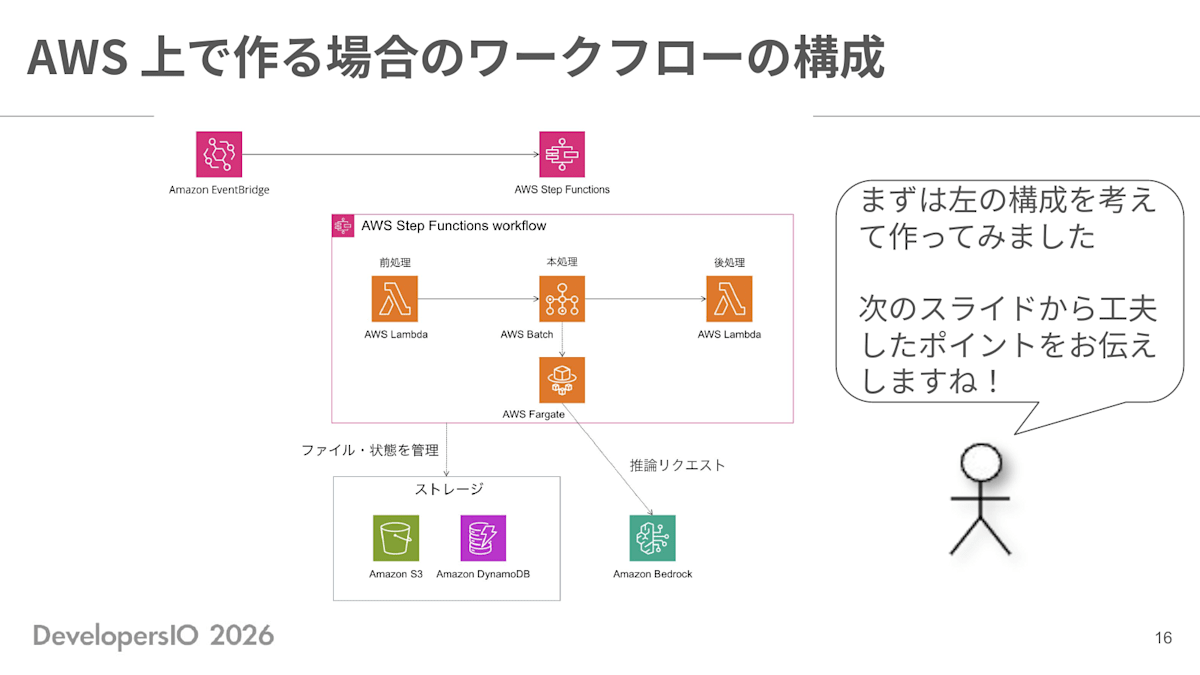
まずはこの構成を考えて作ってみました。
- Amazon EventBridge をトリガーに AWS Step Functions を起動する
- Step Functions の中は前処理・本処理・後処理に分かれる
- 前処理と後処理は AWS Lambda
- 本処理は AWS Batch を起動し、AWS Fargate 上で Amazon Bedrock の推論を実行する
- ファイルや状態の管理には Amazon S3 と Amazon DynamoDB を使う
ここからは、この構成で工夫したポイントをお伝えします。
クォータ制限を意識したワークフローの工夫
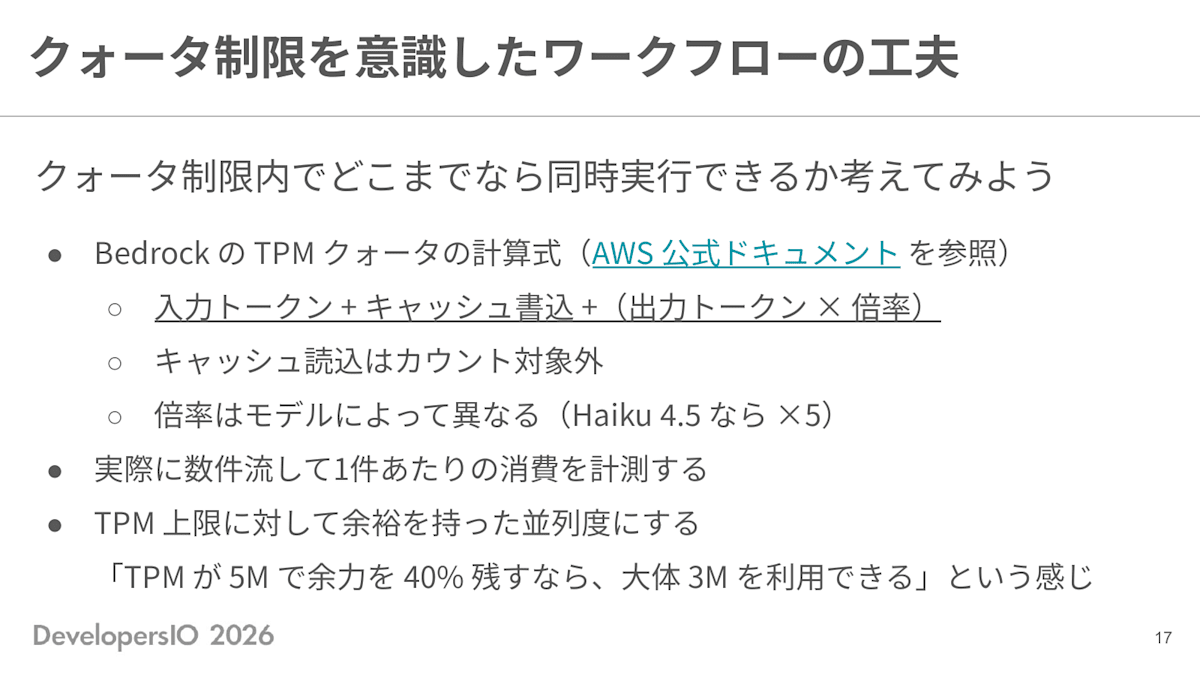
Bedrock の推論を大量に回すにあたって、まず整理しておく必要があるのが TPM(Tokens Per Minute) です。
TPM は1分間に使えるトークンの上限で、これを超えると一時的に推論を実行できなくなります。
TPM の消費量は、公式ドキュメントに記載されている以下の計算式で求められます。
- 入力トークン + キャッシュ書込 +(出力トークン × 倍率)
- キャッシュ読込はカウント対象外
- 倍率はモデルによって異なる(Claude Haiku 4.5 なら ×5)
実際に数件流してみて、1件あたりの消費量を計測しておくのがおすすめです。
また、同じ AWS アカウント上で同じモデルを使う推論が他にもある場合は、TPM 上限に対して余裕を持った並列度にしておく必要があります。
例えば TPM が 5M で余力を 40% 残すなら、このワークフローでは大体 3M を利用できる、という考え方です。
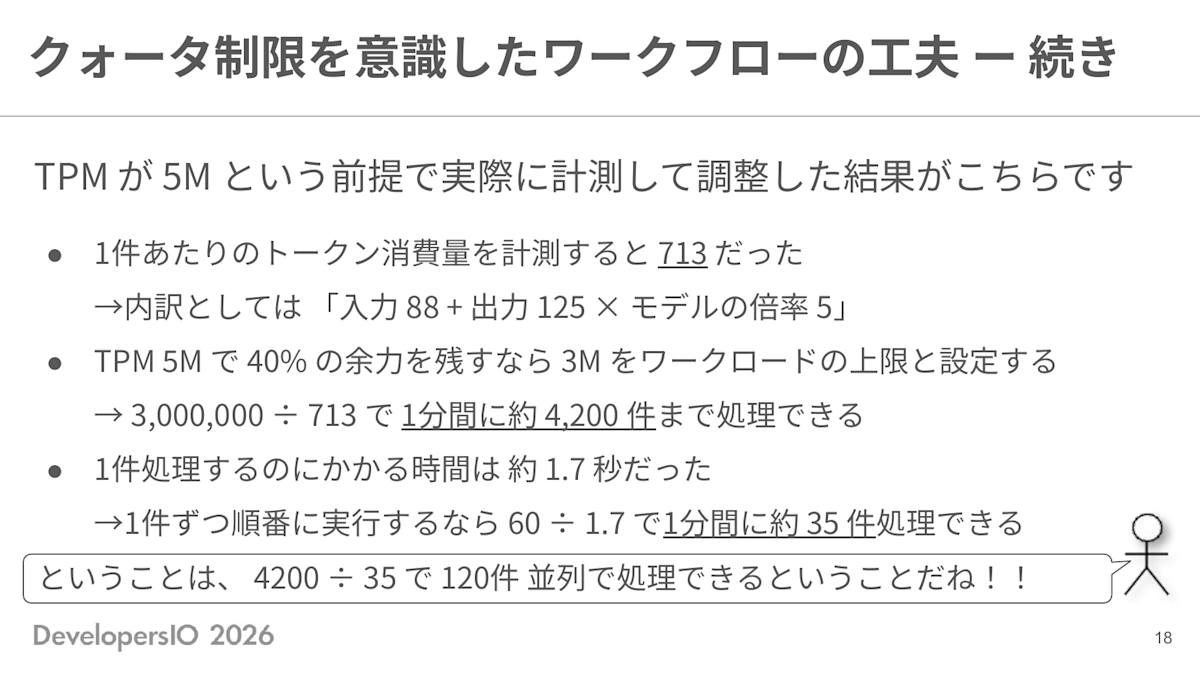
TPM が 5M という前提で、実際に計測して調整した結果がこちらです。
- 1件あたりのトークン消費量は 713
- 内訳は「入力 88 + 出力 125 × モデルの倍率 5」(キャッシュ書込は一旦考えない)
- TPM 5M のうち 40% の余力を残し、3M をワークロードの上限とする
- 3,000,000 ÷ 713 で、1分間に約 4,200 件 まで処理できる
- 1件の処理にかかる時間は約 1.7 秒
- 1件ずつ順番に実行するなら、60 ÷ 1.7 で1分間に約 35 件
ということは、4,200 ÷ 35 で 120 件並列 で処理できる計算になります。
ワークフローを制御するための役割の工夫
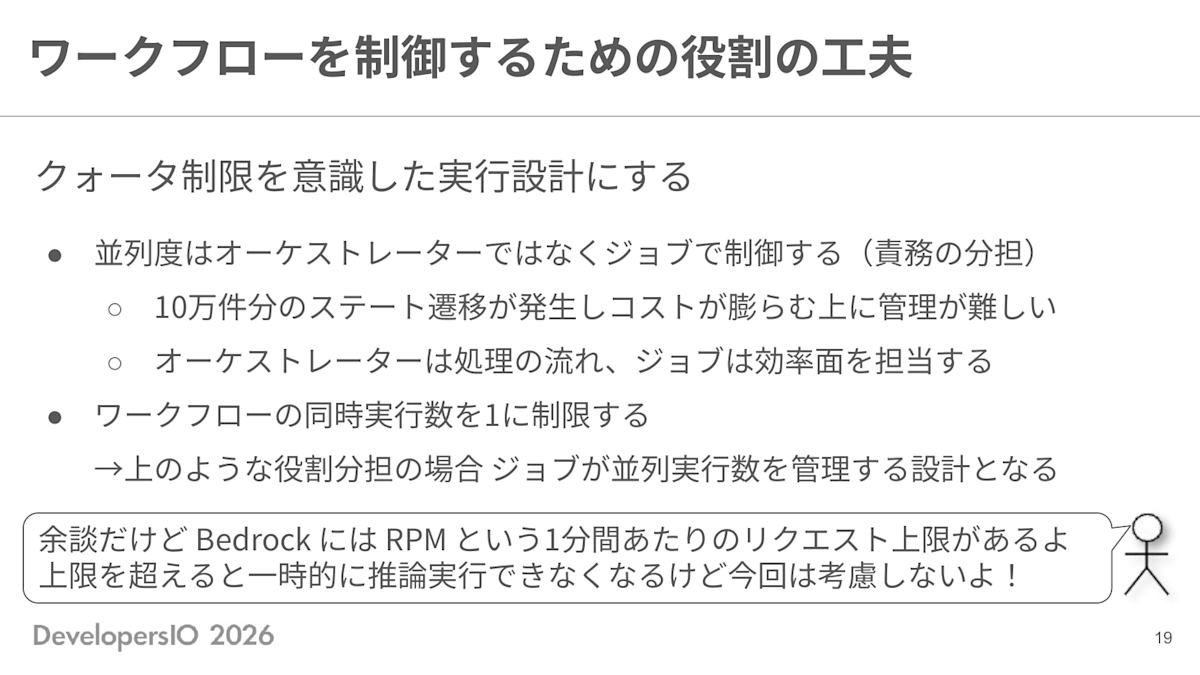
120 件並列で処理できることがわかりましたが、その並列処理をどこで行えば良いでしょうか。
並列度は、オーケストレーターである Step Functions でも、ジョブである Lambda や Fargate でも調整できます。
もしオーケストレーターで並列度を制御すると、10万件分のステート遷移が発生します。
コストが膨らむうえに、10万件ものステートを管理するのは非常に難しいと考えました。
そこで、以下のように責務を分担しました。
- オーケストレーターは処理の流れだけに責任を持つ
- ワークフローの同時実行数は1に制限する
- ジョブは効率面を担当する
- ソースコードの中で並列実行数を制御する
余談ですが、Bedrock にはモデルごとに RPM(Requests Per Minute)という1分間あたりのリクエスト上限もあります。
本来はこちらも気にする必要がありますが、今回使用したモデルの RPM は1万だったため、TPM が先にボトルネックになると考えて今回は考慮していません。
Bedrock 推論をリクエストする環境の工夫
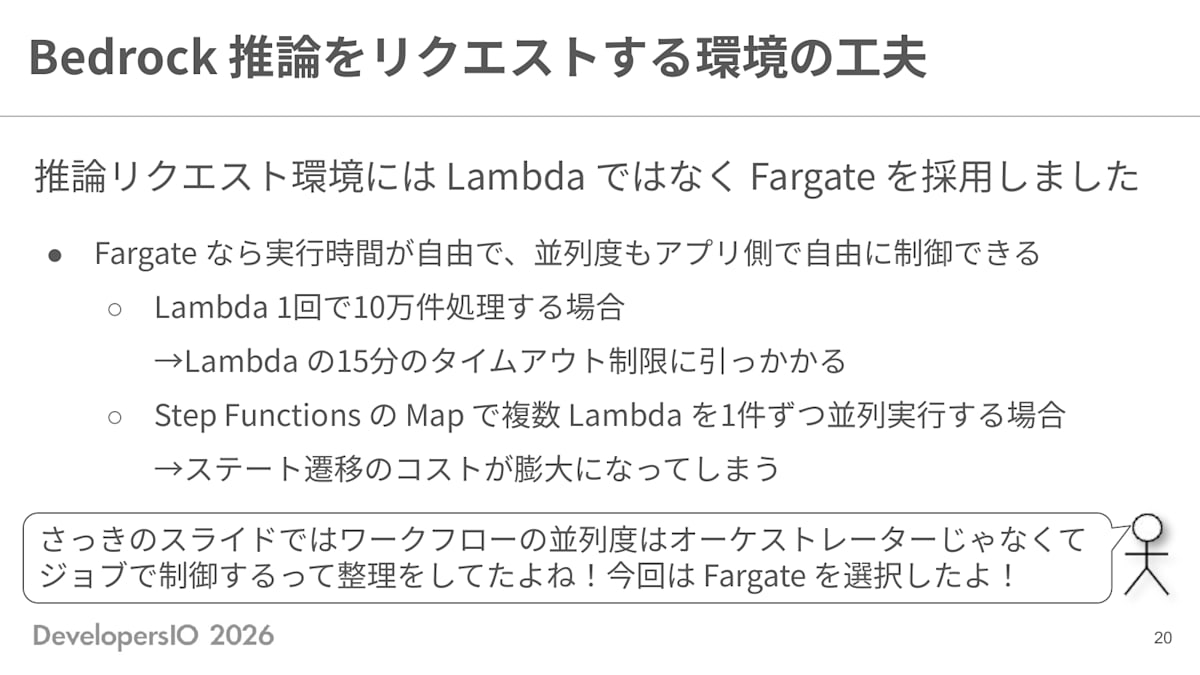
推論をリクエストする環境には、Lambda ではなく Fargate を採用しました。
Fargate なら実行時間の制約がなく、並列度もアプリ側で自由に制御できます。
Lambda を使う場合は、以下の課題がありました。
- Lambda 1回で10万件処理する場合
- Lambda の15分のタイムアウト制限に引っかかる
- Step Functions の Map で複数の Lambda を1件ずつ並列実行する場合
- 先ほどお話ししたように、ステート遷移のコストが膨大になる
「並列度はオーケストレーターではなくジョブで制御する」という整理に沿って、Fargate を選択しました。
Bedrock 推論実行時の工夫
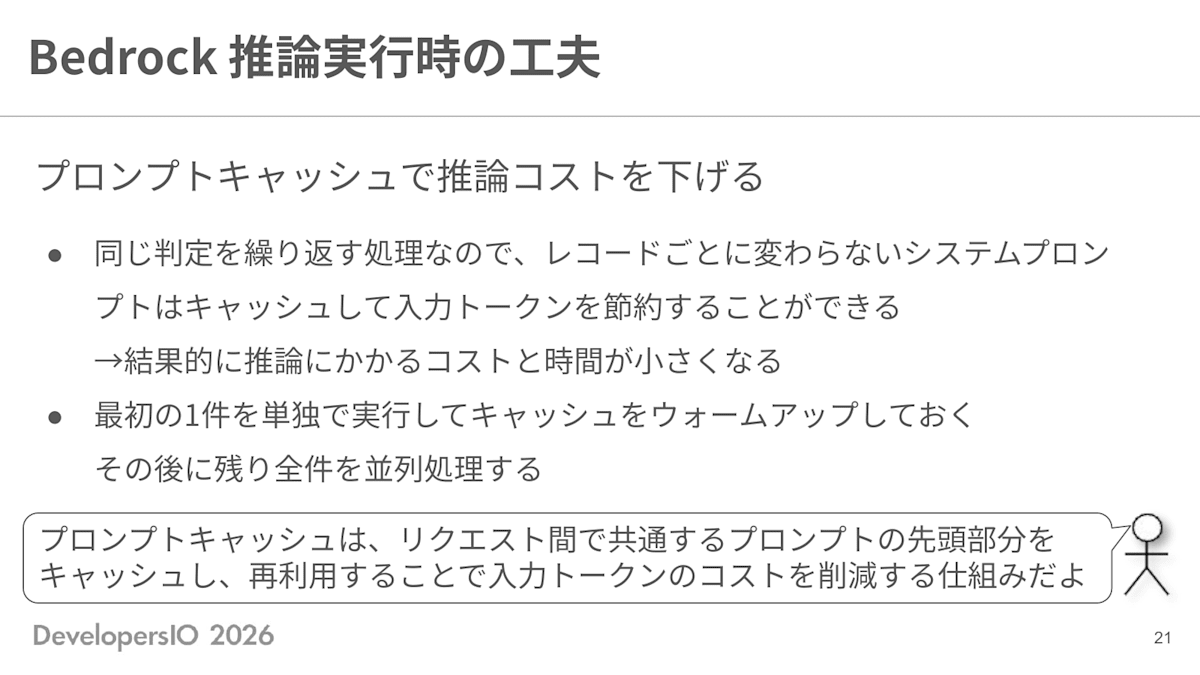
推論コストを下げるために プロンプトキャッシュ を使いました。
プロンプトキャッシュは、リクエスト間で共通するプロンプトの先頭部分をキャッシュして再利用することで、入力トークンのコストを削減する仕組みです。
最大10万件を1件ずつ判定するワークフローなので、同じ判定を何度も繰り返します。
レコードごとに変わらないシステムプロンプトをキャッシュすれば、入力トークンを節約でき、結果的に推論にかかるコストと時間を小さくできます。
進め方としては、最初の1件を単独で実行してキャッシュをウォームアップしておき、その後に残りの全件を並列処理します。
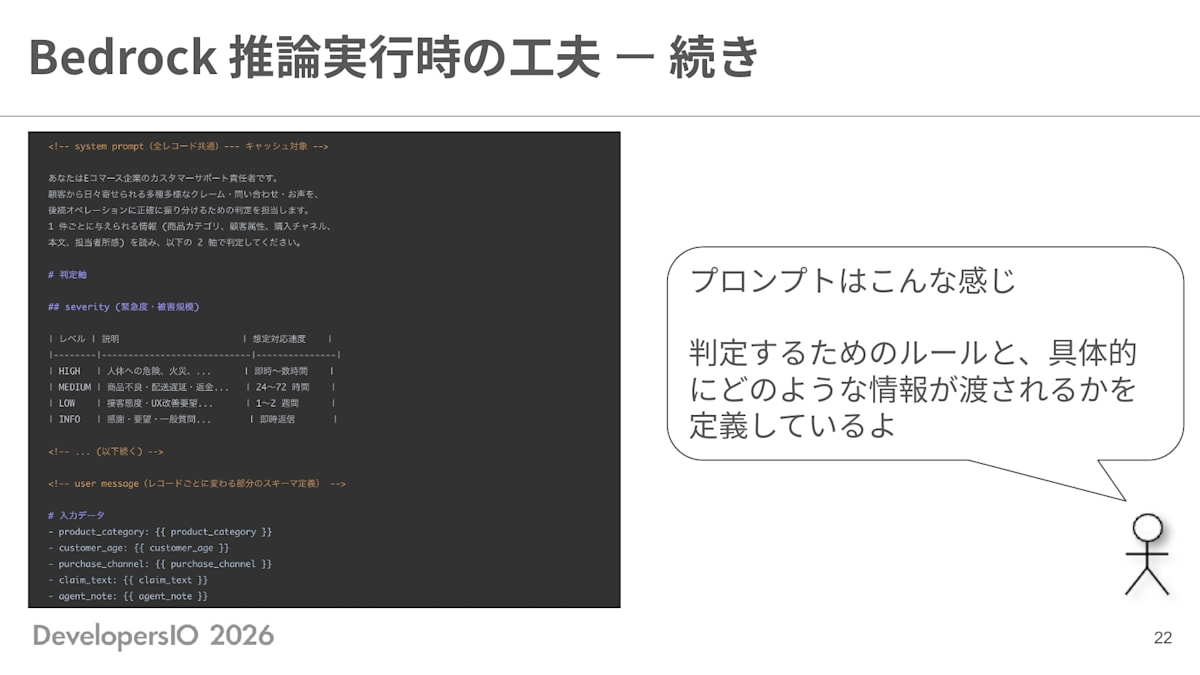
プロンプトはこんな感じです。
判定するためのルールと、具体的にどのような情報が渡されるかを定義しています。
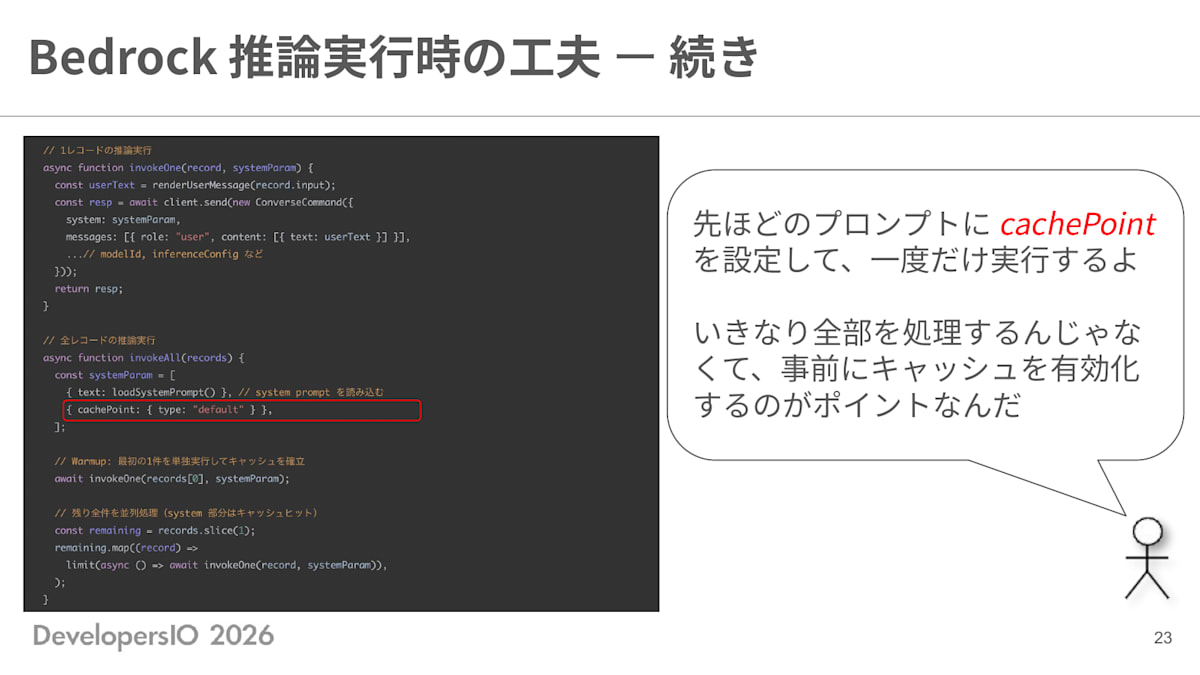
Bedrock の推論を呼び出す処理の中で、先ほどのプロンプトに cachePoint を設定し、まず一度だけ実行します。
// 1レコードの推論実行
async function invokeOne(record, systemParam) {
  const userText = renderUserMessage(record.input);
  const resp = await client.send(new ConverseCommand({
    system: systemParam,
    messages: [{ role: "user", content: [{ text: userText }] }],
    ...// modelId, inferenceConfig など
  }));
  return resp;
}

// 全レコードの推論実行
async function invokeAll(records) {
  const systemParam = [
    { text: loadSystemPrompt() }, // system prompt を読み込む
    { cachePoint: { type: "default" } },
  ];

  // Warmup: 最初の1件を単独実行してキャッシュを確立
  await invokeOne(records[0], systemParam);

  // 残り全件を並列処理(system 部分はキャッシュヒット)
  const remaining = records.slice(1);
  remaining.map((record) =>
    limit(async () => await invokeOne(record, systemParam)),
  );
}
いきなり全部を処理するのではなく、事前にキャッシュを有効化しておくのがポイントです。
こうすることで入力トークンを節約でき、実行時間と推論料金を抑えられます。
推論出力の工夫
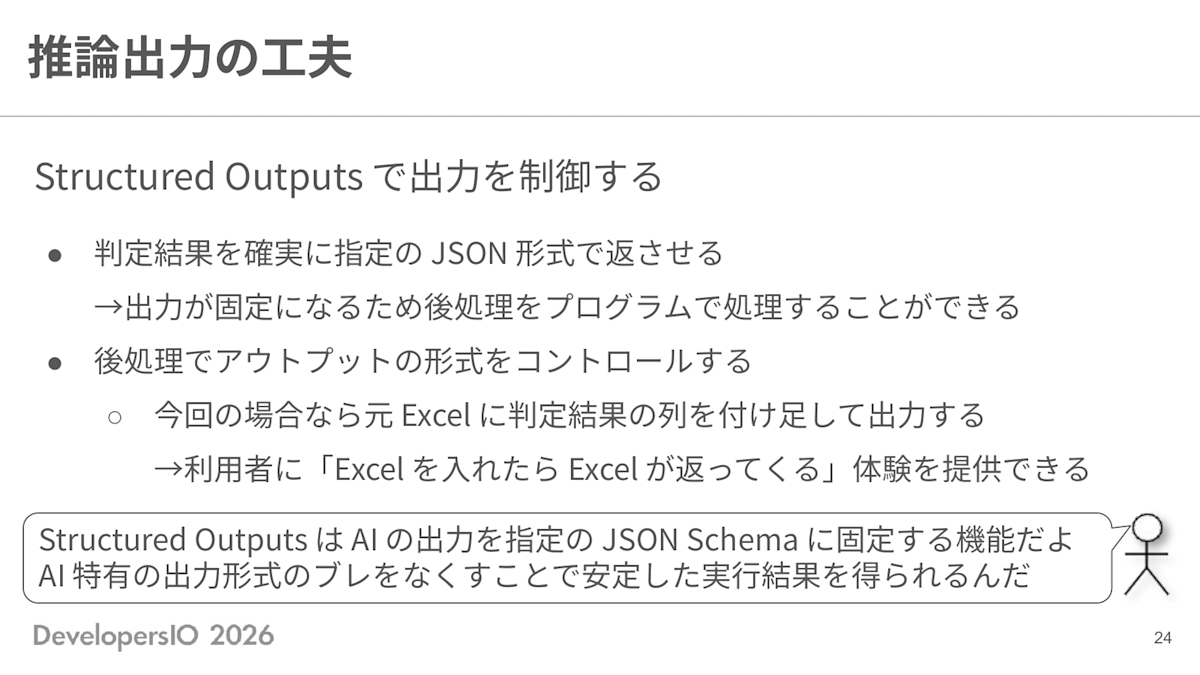
出力の制御には Structured Outputs を使いました。
Structured Outputs は、AI の出力を指定した JSON Schema に固定する機能です。
AI 特有の出力形式のブレをなくせるので、安定した実行結果を得られます。
- 判定結果を確実に指定の JSON 形式で返させる
- 出力が固定になるため、後処理をプログラムで扱いやすくなる
- 後処理でアウトプットの形式をコントロールする
- 今回なら、元の Excel に判定結果の列を付け足して出力する
- 利用者に「Excel を入れたら Excel が返ってくる」体験を提供できる
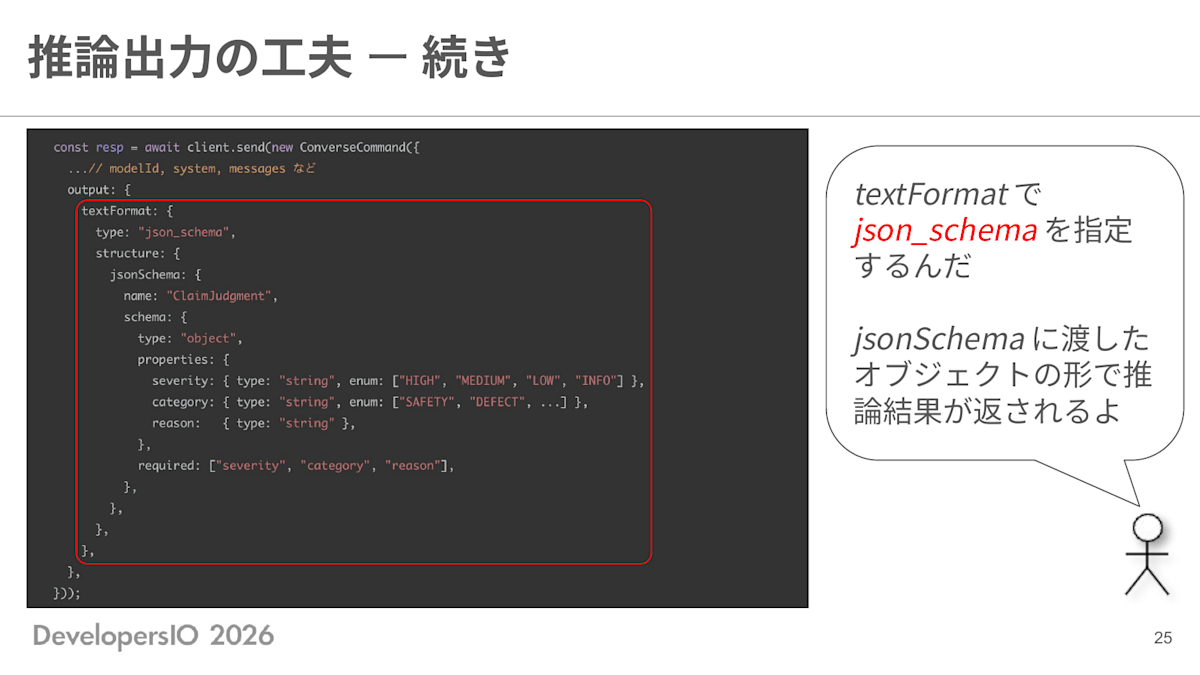
指定方法としては、Converse API の output の中で textFormat の type に json_schema を指定します。
structure.jsonSchema に渡したオブジェクト(今回は severity / category / reason)の形で推論結果が返ってきます。
オンデマンド推論で10万件処理してみたら...
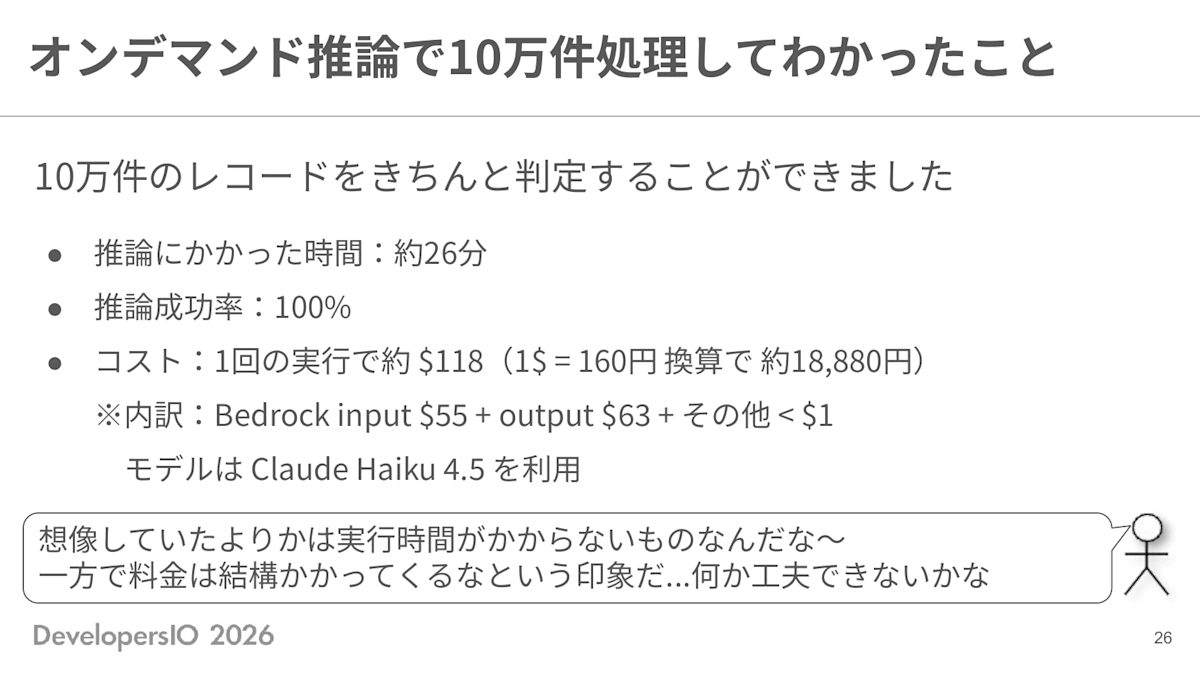
こうした工夫を施した結果、10万件のレコードをきちんと判定できました。
| 項目 | 結果 |
|---|---|
| 推論にかかった時間 | 約26分 |
| 推論成功率 | 100% |
| コスト(1回の実行) | 約 |
コストの内訳は Bedrock の input が $55、output が $63、その他が $1 未満です。モデルは Claude Haiku 4.5 を利用しました。
想像していたよりも実行時間はかからない一方で、料金は結構かかるなという印象でした。
何か工夫できないかと考え、次の取り組みにつながります。
フォールバックによるバッチ推論の拡張
オンデマンド推論と比較するバッチ推論
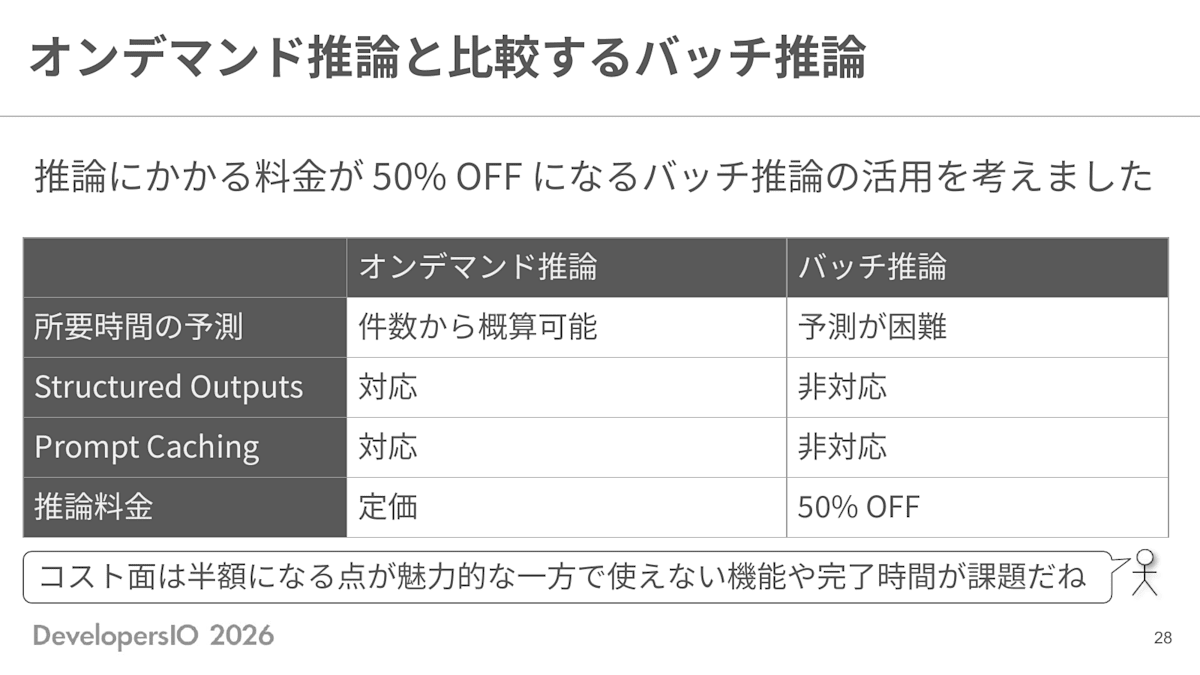
Bedrock にはオンデマンド推論のほかに、バッチ推論 があります。両者を比較してみました。
| オンデマンド推論 | バッチ推論 | |
|---|---|---|
| 所要時間の予測 | 件数から概算可能 | 予測が困難 |
| Structured Outputs | 対応 | 非対応 |
| Prompt Caching | 対応 | 非対応 |
| 推論料金 | 定価 | 50% OFF |
推論料金が半額になる点は魅力的です。
一方で、使えない機能があることと、完了時間が読めないことが課題になります。
ハイブリッド構成の可能性
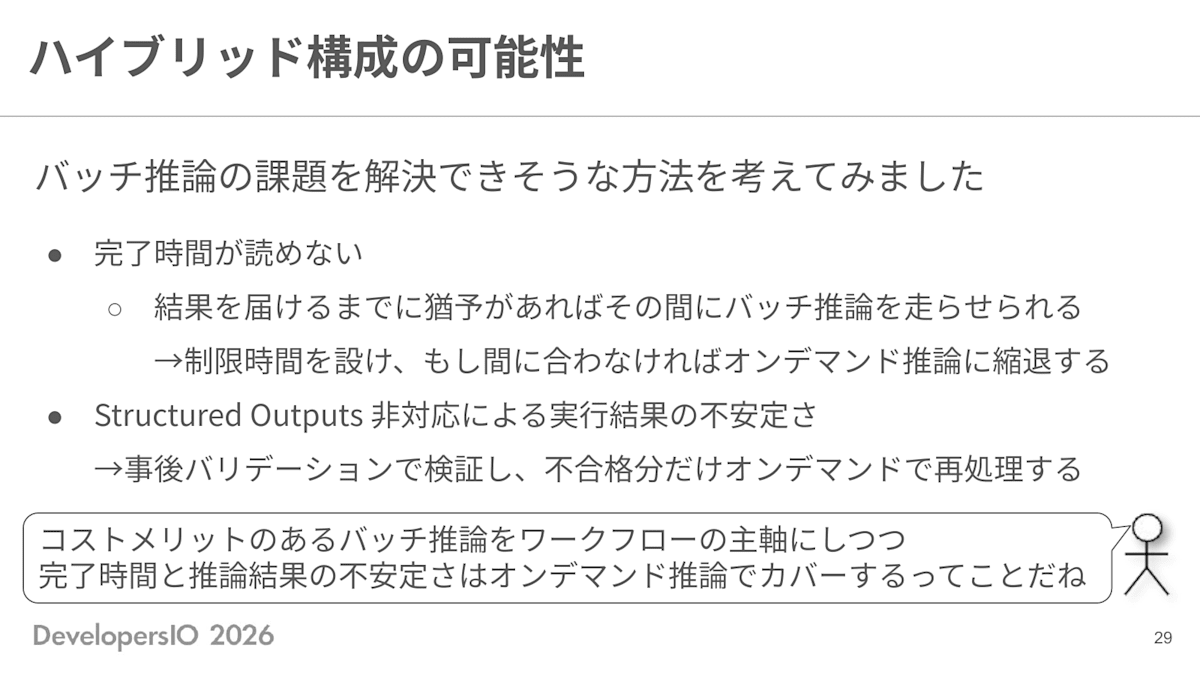
バッチ推論の課題を解消できる方法として、オンデマンド推論と組み合わせたハイブリッド構成を考えました。
- 完了時間が読めない
- 結果を届けるまでに猶予があれば、その間にバッチ推論を走らせられる
- 制限時間を設け、間に合わなければオンデマンド推論に引き継ぐ
- Structured Outputs 非対応による実行結果の不安定さ
- 事後バリデーションで検証し、不合格分だけをオンデマンド推論で再処理する
コストメリットのあるバッチ推論をワークフローの主軸にしつつ、完了時間と推論結果の不安定さはオンデマンド推論でカバーする、という考え方です。
両方の推論を取り入れたワークフローの構成
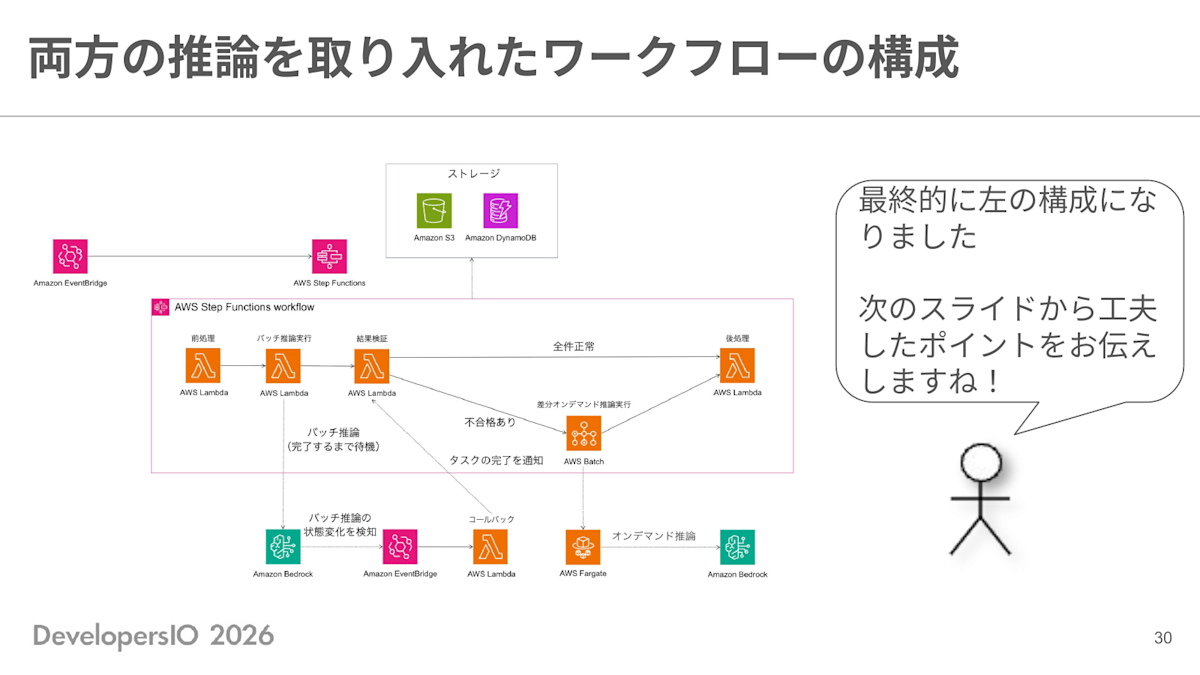
最終的にこの構成になりました。
ここからは、この構成で工夫したポイントをお伝えします。
バッチ推論におけるタイムリミットの工夫
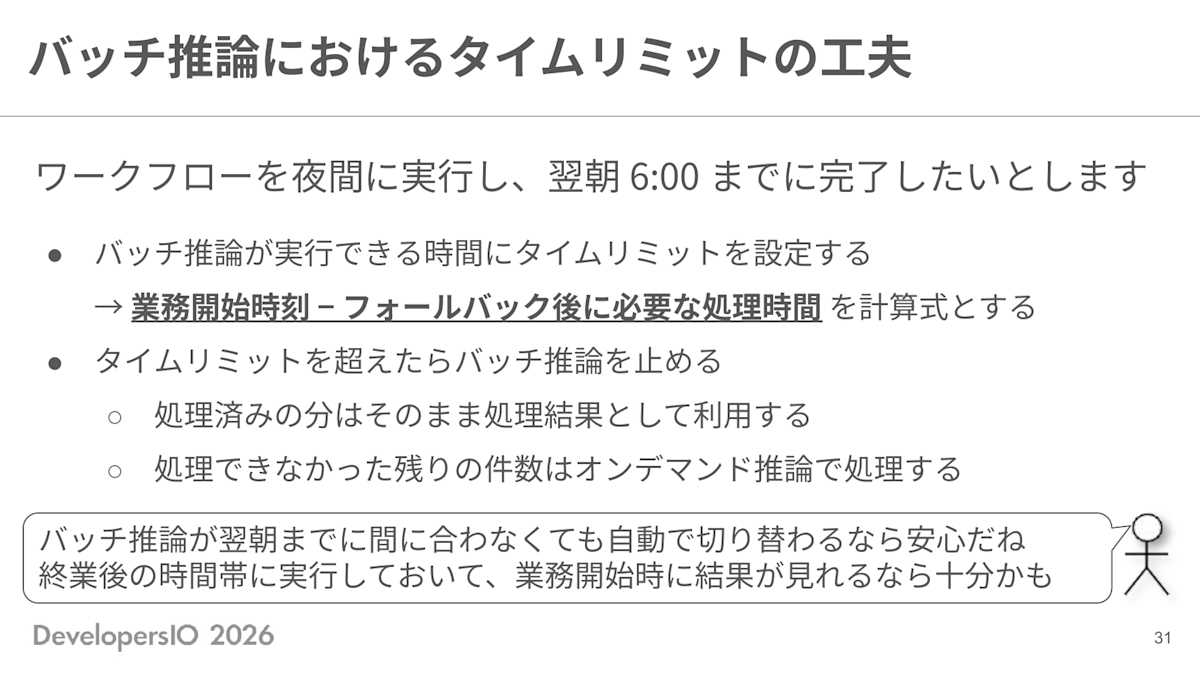
ワークフローを夜間に実行し、翌朝 6:00 までに完了すれば OK、というケースを考えます。
- バッチ推論を実行できる時間にタイムリミットを設定する
- 計算式は「業務開始時刻 − フォールバック後に必要な処理時間」
- タイムリミットを超えたらバッチ推論を止める
- 処理済みの分はそのまま処理結果として利用する
- 処理できなかった残りの件数はオンデマンド推論で処理する
バッチ推論が翌朝までに間に合わなくても、自動でオンデマンド推論に切り替わるので安心です。
終業後の時間帯に実行しておき、業務開始時に結果が見られれば十分というケースもあると思います。
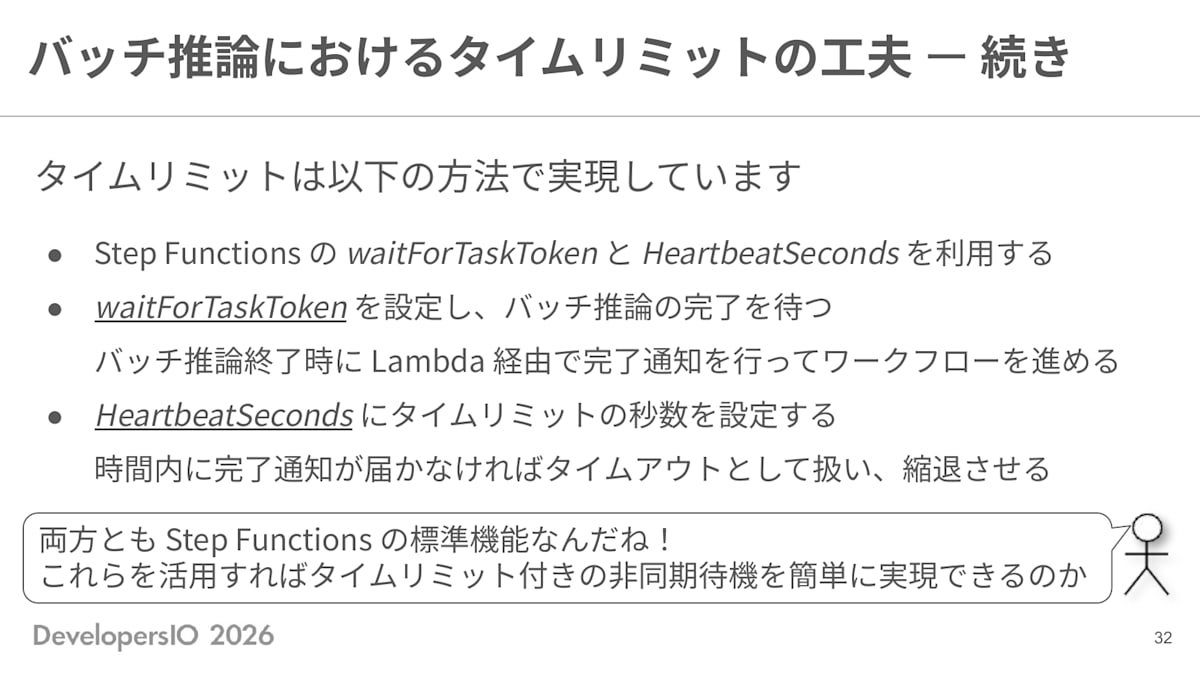
タイムリミットは、Step Functions の waitForTaskToken と HeartbeatSeconds を利用して実現しました。
waitForTaskTokenを設定し、バッチ推論の完了を待つ- バッチ推論が終了したら、Lambda 経由で完了通知を行ってワークフローを進める
HeartbeatSecondsにタイムリミットの秒数を設定する- 時間内に完了通知が届かなければタイムアウトとして扱い、オンデマンド推論にフォールバックする
どちらも Step Functions の標準機能なので、これらを組み合わせればタイムリミット付きの非同期待機を簡単に実現できます。
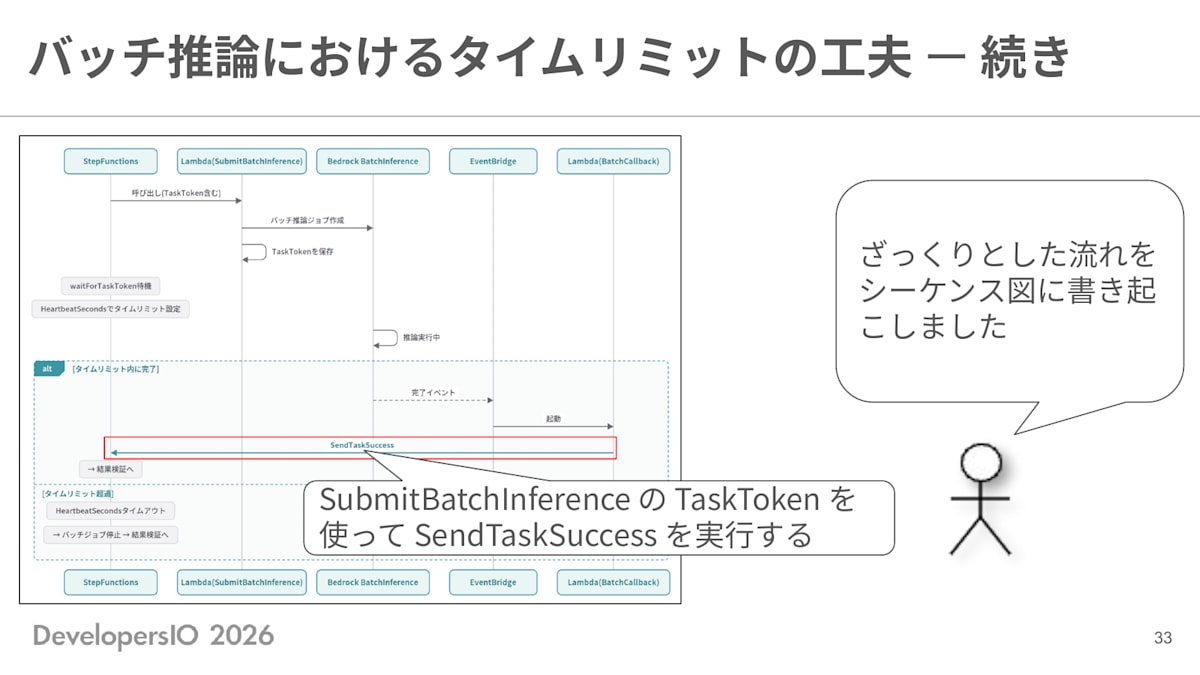
ざっくりとした流れをシーケンス図に書き起こしました。
- バッチ推論を実行する Lambda で、タスクトークンを保存しておく
- バッチ推論が終わると EventBridge に完了イベントが届き、コールバック用の Lambda が起動する
- コールバック用の Lambda が、保存しておいたタスクトークンを使って
SendTaskSuccessを実行し、バッチ推論がタイムアウトせずに完了したことを Step Functions に伝える SendTaskSuccessが実行されたら、結果検証のジョブに進む
一方で、SendTaskSuccess が実行される前に HeartbeatSeconds のタイムアウトを迎えた場合は、バッチジョブを停止して結果検証のジョブに進みます。
バッチ推論における出力品質の工夫
出力形式の品質は、事後バリデーションで担保しました。
バッチ推論には Structured Outputs に該当する仕組みがありません。
現状はシステムプロンプトで JSON 出力を指示するぐらいが限界なので、出力形式が期待と異なることを考慮した作りにする必要があります。
そこで、推論結果が期待する形式になっているかをチェックし、不合格となったレコードだけをオンデマンド推論で再処理するようにしました。
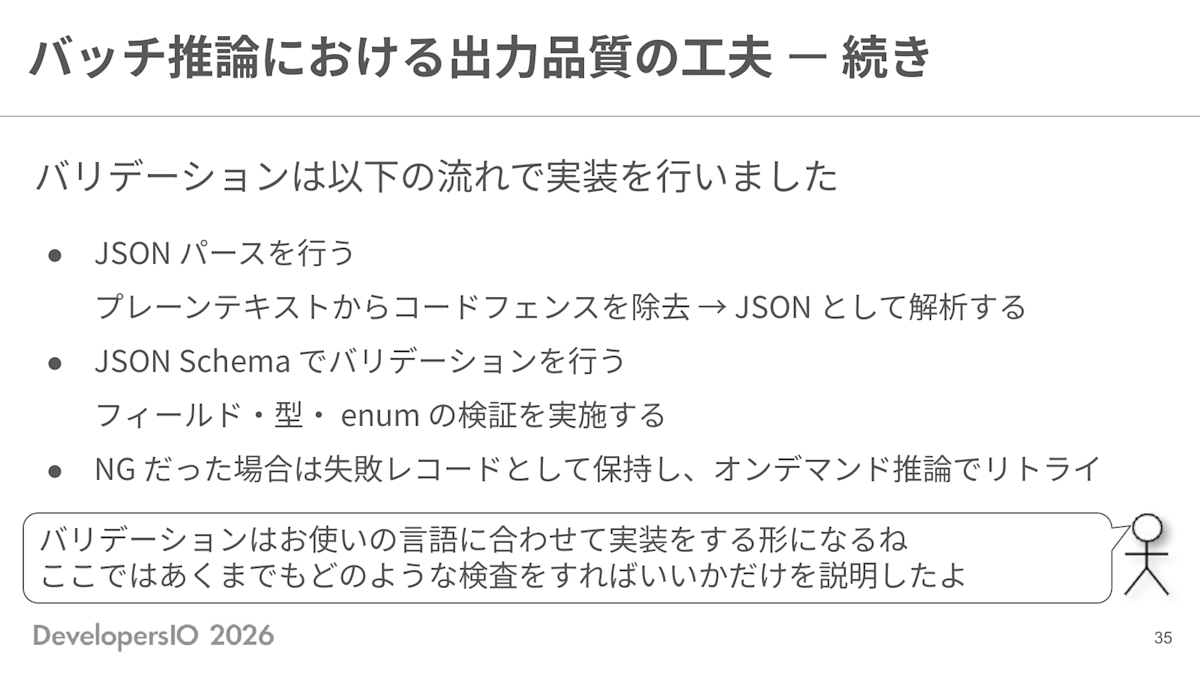
バリデーションは以下の流れで実装しました。
- JSON パースを行う
- バッチ推論の結果はプレーンテキストで返ってくるため、コードフェンスを除去してから JSON として解析する
- JSON Schema でバリデーションを行う
- フィールド・型・enum を検証する
- NG だった場合は失敗レコードとして保持し、オンデマンド推論でリトライする
バリデーションはお使いの言語に合わせて実装する形になります。
ここでは具体的なコードではなく、どのような検査をすればいいかだけを紹介しました。
バッチ推論で10万件処理してわかったこと
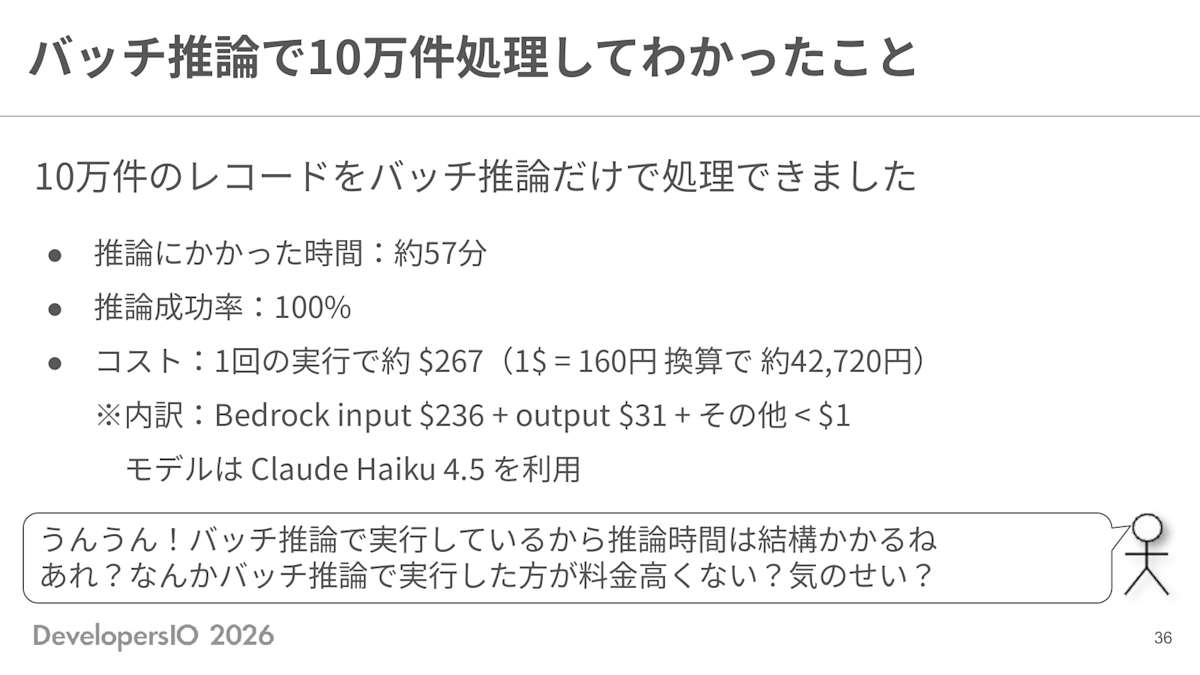
こうした工夫を施し、10万件のレコードをバッチ推論だけで処理できました。
| 項目 | 結果 |
|---|---|
| 推論にかかった時間 | 約57分 |
| 推論成功率 | 100% |
| コスト(1回の実行) | 約 |
コストの内訳は Bedrock の input が $236、output が $31、その他が $1 未満です。モデルはオンデマンド推論のときと同じく Claude Haiku 4.5 を利用しました。
バッチ推論なので推論時間が長くなるのは仕方ないと思っていました。
ただ……バッチ推論で実行した方が料金が高くないでしょうか?
バッチ推論を入れる前 vs 入れた後
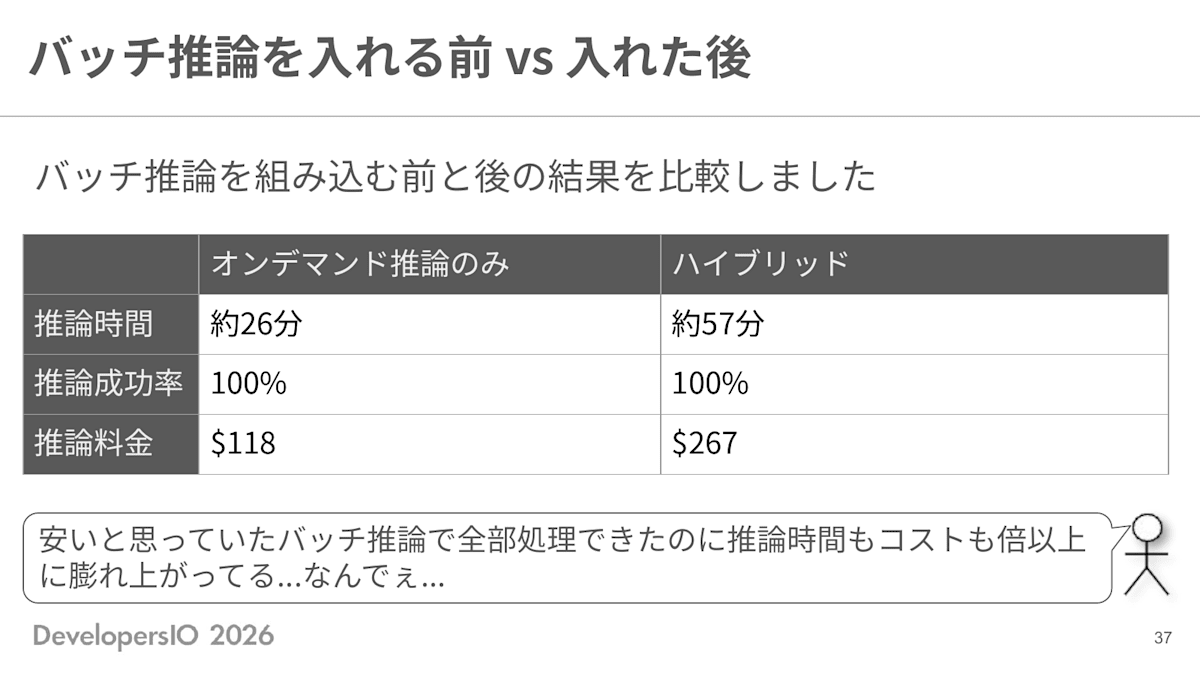
| オンデマンド推論のみ | ハイブリッド | |
|---|---|---|
| 推論時間 | 約26分 | 約57分 |
| 推論成功率 | 100% | 100% |
| 推論料金 | $118 | $267 |
推論成功率はどちらも 100% で、品質自体は問題ありません。
一方で、推論時間は約2倍、推論料金は2倍以上になりました。
50% OFF で安くなると思っていたバッチ推論で全件処理できたのに、終わってみたら推論時間もコストも倍以上に膨れ上がっていました。
バッチ推論の方が高くなった理由を考えてみた
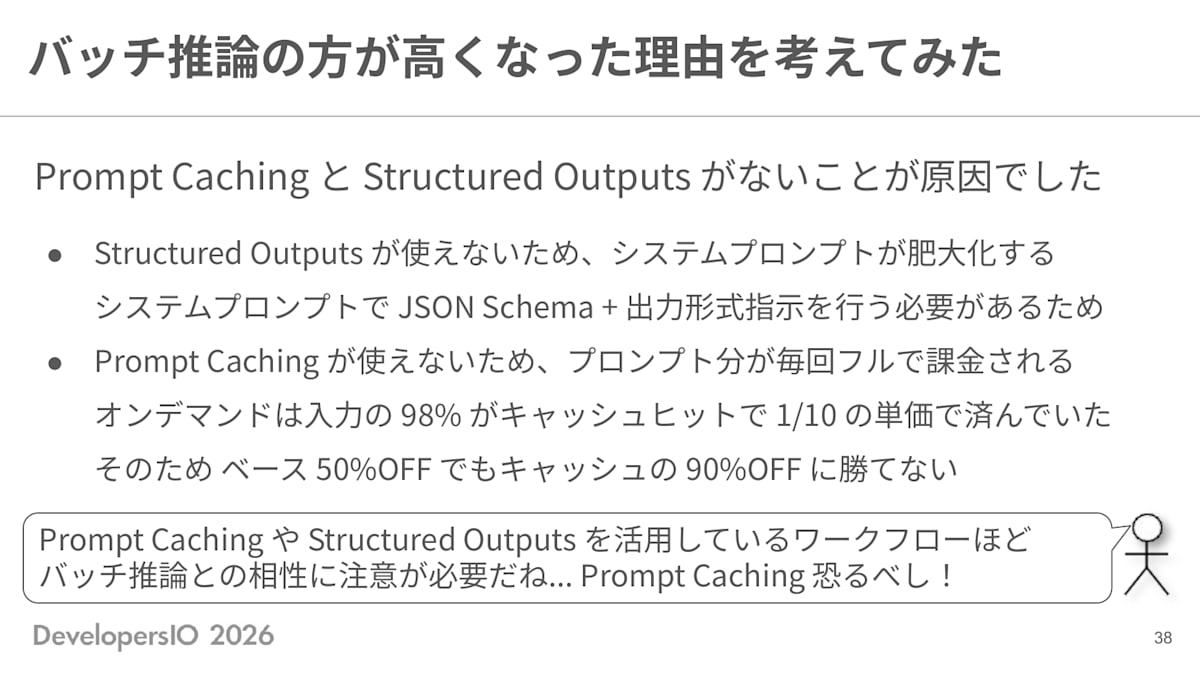
原因は Prompt Caching と Structured Outputs が使えないこと でした。
- Structured Outputs が使えないため、システムプロンプトが肥大化する
- 出力品質を維持するために、システムプロンプトで JSON Schema と出力形式の指示を行う必要があった
- その結果、入力トークン数が増えた
- Prompt Caching が使えないため、プロンプト分が毎回フルで課金される
- オンデマンド推論では入力の 98% がキャッシュヒットしており、通常の入力トークンの 1/10 の単価で済んでいた
- そのため、ベース料金が 50% OFF でも、キャッシュの 90% OFF には勝てない
Prompt Caching や Structured Outputs を活用しているワークフローほど、バッチ推論との相性には注意が必要だと気づきました。
Prompt Caching 恐るべしと痛感しました。
まとめ
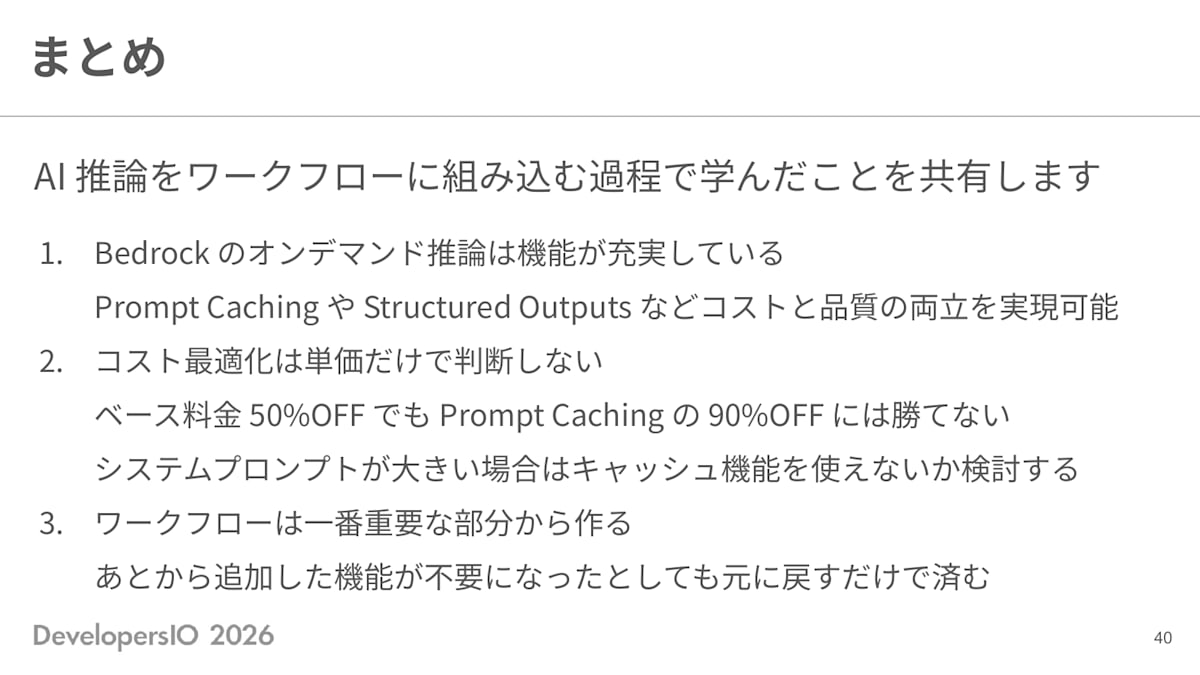
AI 推論をワークフローに組み込む過程で学んだことは、以下の3つです。
Bedrock のオンデマンド推論は機能が充実している
Prompt Caching や Structured Outputs など、コストと品質を両立できる機能が揃っています。
コスト最適化は単価だけで判断しない
ベース料金が 50% OFF でも、Prompt Caching の 90% OFF には勝てませんでした。
コストを下げたいときは、事前に何にどのぐらいお金がかかっているのかを整理しておく必要があります。
今回の私は、そこを考えずに「安くできる」と思い込んでしまったため、かえってコストを大幅に上げてしまいました。
これが本番のワークフローだったらと考えると恐ろしいです。
システムプロンプトが大きい場合は、まずキャッシュ機能を使えないか検討するのがおすすめです。
ワークフローは一番重要な部分から作る
今回は事前にワークフローの形を整理していたので、一番重要な部分であるオンデマンド推論、つまり確実に処理できる部分から作りました。
その後「コストを安くできないか」というきっかけでバッチ推論を追加しましたが、結果的にこの機能は不要になりました。
あくまで拡張の機能だったので、外すだけで元の安定した構成にすぐ戻せました。
もし最初から大きな仕組みを作っていたら、不要な部分を外して作り直すのにかなりの労力がかかったはずです。
コアになる部分から作って一度動かすことの重要性を、改めて認識しました。
まとめで取り上げたのは、特に強くお伝えしたかった部分です。
それ以外にも、ワークフローを考えていく過程のどこか一つでも、皆さんの新しい発見につながれば幸いです。
お礼
平日にさらに悪天候が重なった中、足を運んでいただいた方に感謝です。
ありがとうございました。
名古屋から来てくださった参加者もいらっしゃりとても嬉しい気持ちになりました。
今回私は運営にも関わりましたが多くの人のご協力あってこそのイベントだと思います。
来年も開催すると思いますので、今回参加されなかった方も是非いらしていただけると嬉しいです。