embeddinggemma-2を使って画像をembeddingしてみる

こんばんは、情報システム室の夏目です。
Google DeepMindは軽量な埋め込みモデル EmbeddingGemma 2 を公開しました。
昨年公開EmbeddingGemmaがテキスト専用だったのに対して、EmbeddingGemma 2ではマルチモーダル対応して画像や動画、音声にも対応しました。
今回はEmbeddingGemma 2をM5を積んだMacで使って画像をEmbeddingしてみます。
1. EmbeddingGemma 2
Gemma 4のアーキテクチャや機能の進化を基盤とした埋め込みモデルで、以下の主要な機能があります。
- ネイティブなマルチモーダル対応
- テキスト/画像/動画/音声 の4つのモダリティに対応し単一の768次元埋め込みを行う
- 多言語対応とコード
- 100以上の言語を理解し、コードタスクにおいて前世代より14%向上した
- 柔軟なフットプリント
- Textのバックボーンに、選択的にロード可能なVisionとAudioのエンコーダーを組み合わせている
- ユースケースに必要なモダリティのみロードできる
- マトリョーシカ表現学習 (MRL)
- 128/256/512/768 次元への切り詰め埋め込みにネイティブで対応
- 品質への影響を最小限に抑えながら、ストレージコストを削減できる
- コンテキスト長
- 8Kトークンのコンテキスト長を入力可能
- その範囲内でテキストや画像などを組み合わせて入力できる
2. Quick Startを試してみる
モデルカードに記載されているQuick Startを参考に動かしてみます。
2-1. ライブラリをインストールし、サンプルコードを実行する
$ uv init --python 3.14 --bare
$ uv add sentence-transformers transformers
ライブラリをインストールしたので、Quick Startのコードを動かして見ます。
from sentence_transformers import SentenceTransformer

model = SentenceTransformer("google/embeddinggemma-2")

query = "What causes the northern lights?"
document = "The northern lights are caused by charged particles from the sun."

query_emb = model.encode(query, prompt_name="SearchQuery")
doc_emb = model.encode(document, prompt_name="Document")
print(model.similarity(query_emb, doc_emb))
$ uv run quick_start.py
ValueError: The checkpoint you are trying to load has model type `embedding_gemma2` but Transformers does not recognize this architecture. This could be because of an issue with the checkpoint, or because your version of Transformers is out of date.

You can update Transformers with the command `pip install --upgrade transformers`. If this does not work, and the checkpoint is very new, then there may not be a release version that supports this model yet. In this case, you can get the most up-to-date code by installing Transformers from source with the command `pip install git+https://github.com/huggingface/transformers.git`
Quick Startの通りに動かすと失敗しました。
2-2. エラーに対処する
transformersがEmbeddingGemma 2のアーキテクチャに対応していないようなので、エラーメッセージにあるようにGithubのmainブランチの内容を使うことにします。
$ uv add git+https://github.com/huggingface/transformers.git
Resolved 62 packages in 1.94s
Uninstalled 1 package in 181ms
Installed 1 package in 82ms
 - transformers==5.18.0
 + transformers==5.19.0.dev0 (from git+https://github.com/huggingface/transformers.git@e598fbad926d80bc356c0c4d96532030e3dfdb62)

$ uv run quick_start.py
ImportError: EmbeddingGemma2Processor requires the PIL library but it was not found in your environment. You can install it with pip:
`pip install pillow`. Please note that you may need to restart your runtime after installation.

To install the required dependencies, run:
pip install -U "sentence-transformers[image]"
今度はPILがないとエラーが出ました。
画像へのネイティブ対応で必要になったのだと思います。
エラーメッセージにあるように sentence-tranformers[image] をインストールします。
$ uv add sentence-transformers[image]
Resolved 64 packages in 1.61s
Installed 2 packages in 17ms
 + pillow==12.3.0
 + torchvision==0.29.1

$ uv run quick_start.py
tensor([[0.8713]])
動くようになりました。
3. 画像の埋め込みをしてみる
動かすことに成功したので次は画像の埋め込みをしてみます。
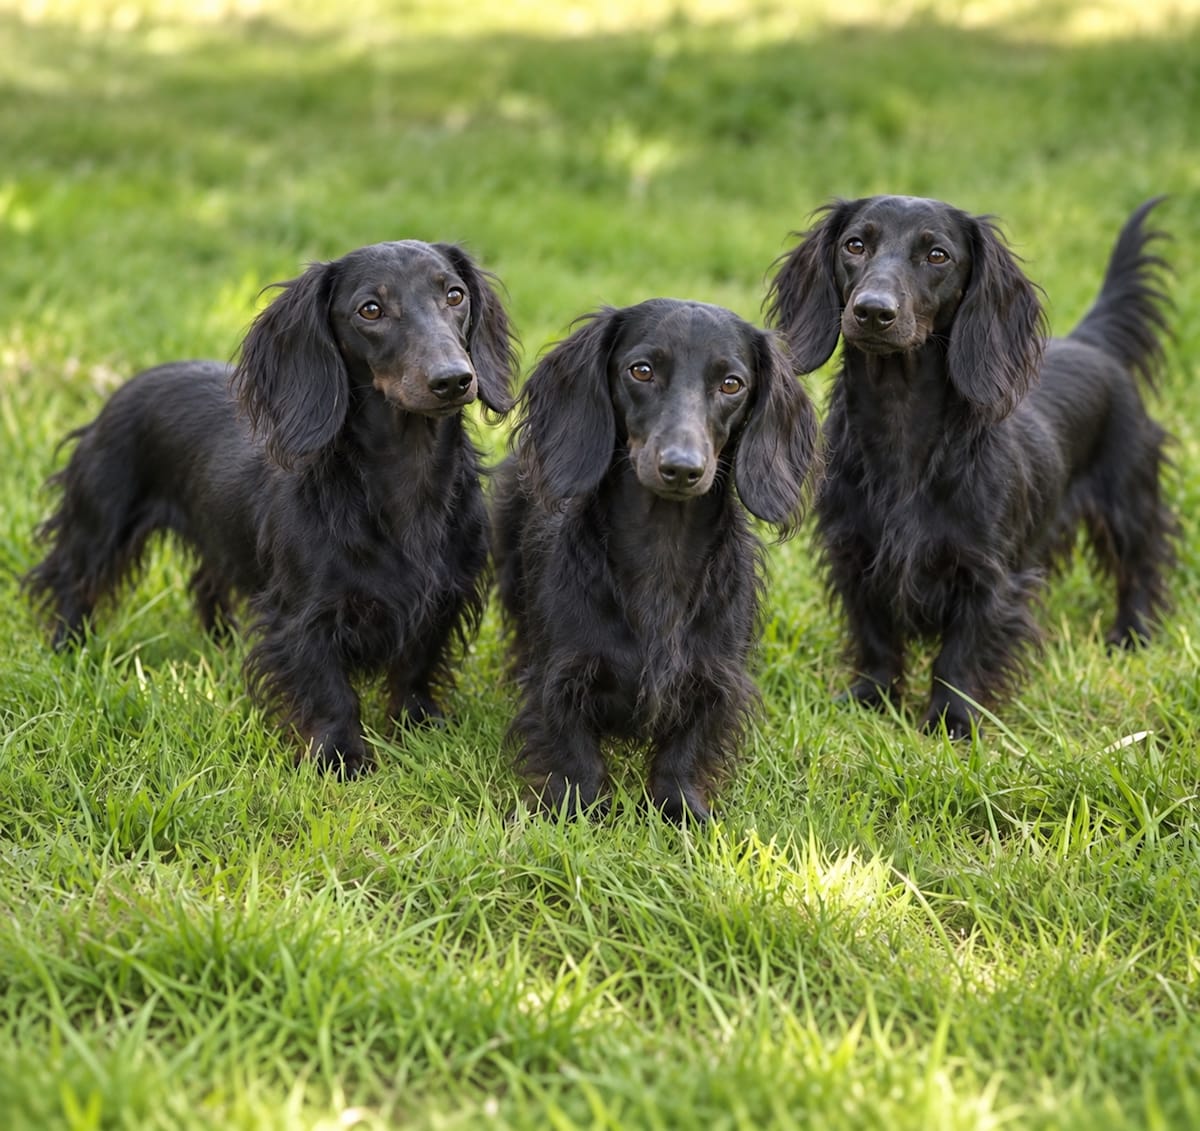
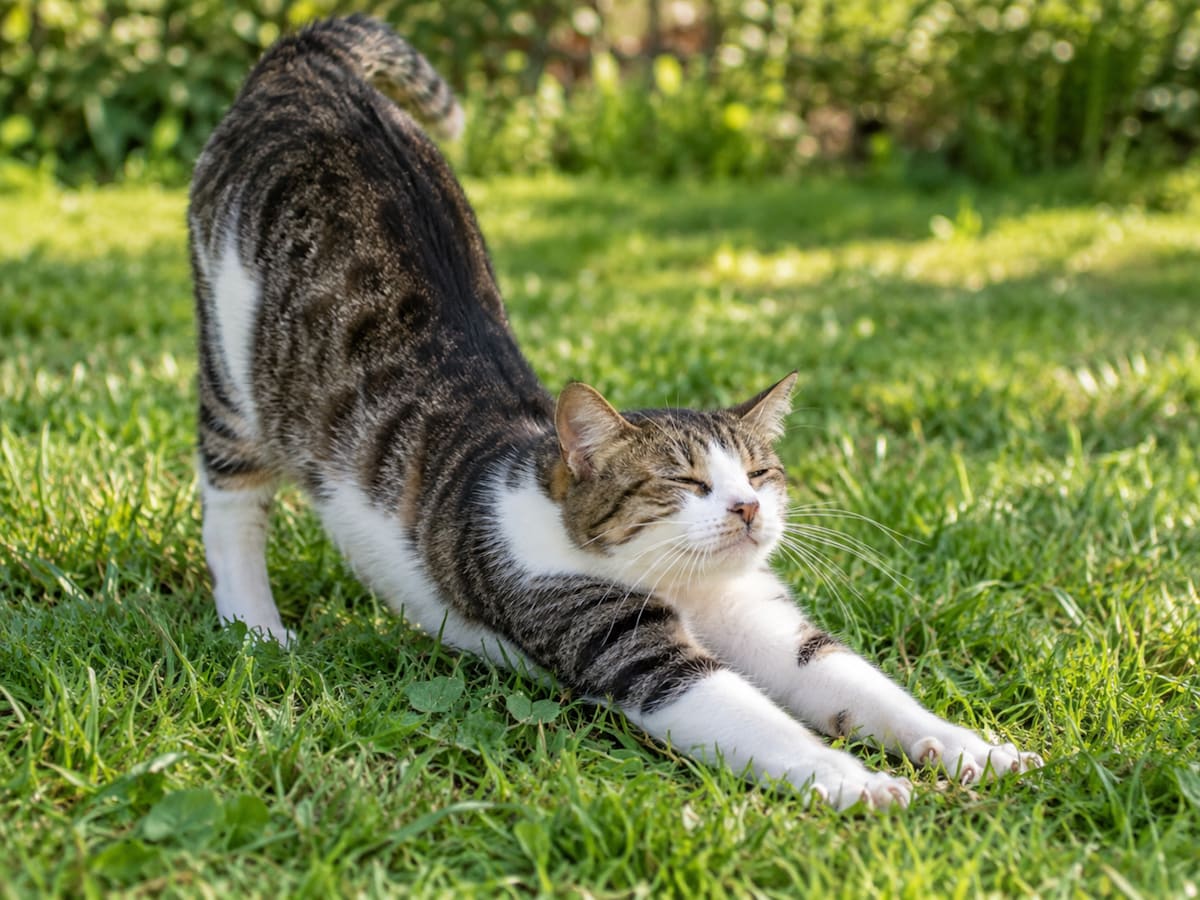
画像はChatGPTで作った次の3枚を使います。
これらを使って類似度などを取得してみようかと思います。
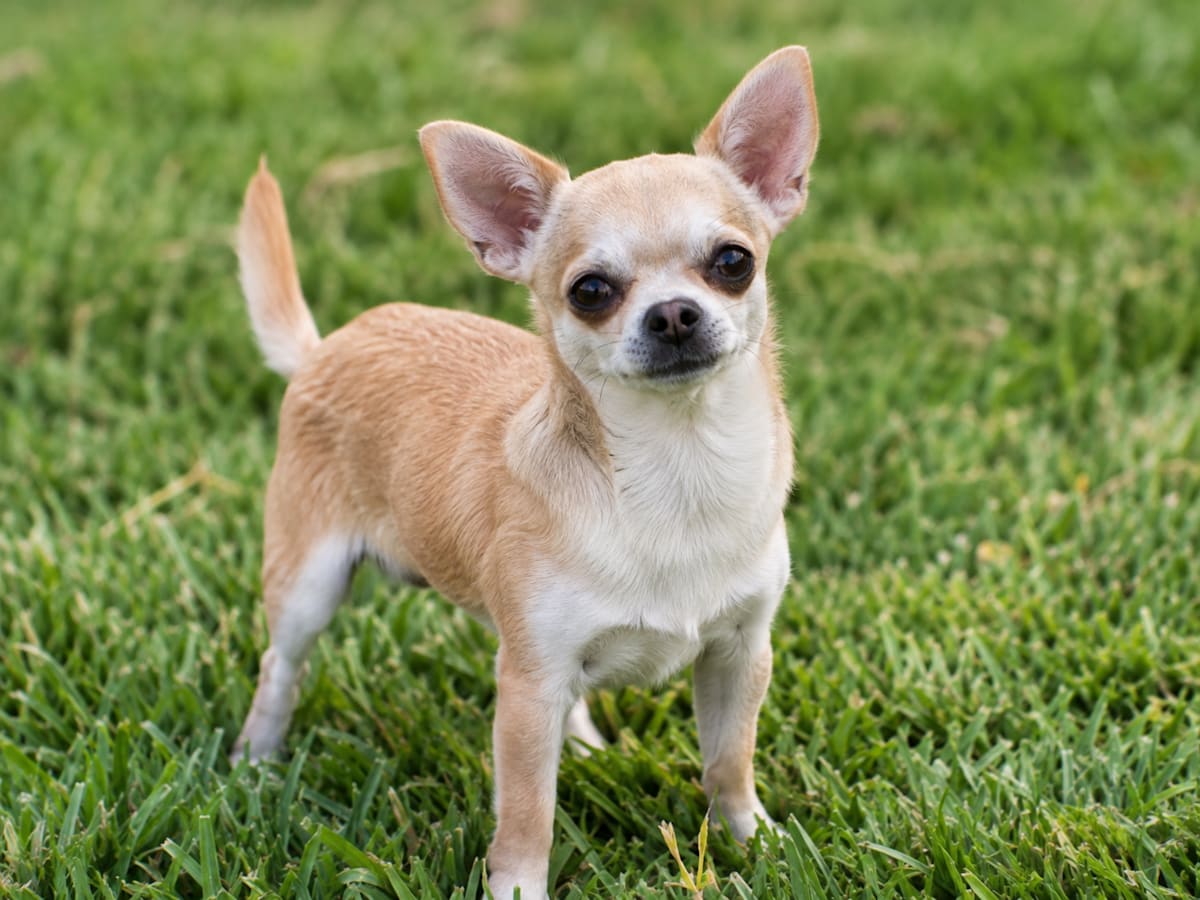
images/01_a_chihuahua.png
images/02_three_miniature_dachshunds.png
images/03_a_cat.png
3-1. 画像の埋め込みをする
まず画像の埋め込みそのものを試します。
from sentence_transformers import SentenceTransformer

model = SentenceTransformer("google/embeddinggemma-2")

embedded = model.encode({"image": "images/01_a_chihuahua.png"})
print(embedded)
print(type(embedded))
print(embedded.shape)
print(embedded.dtype)
$ uv run image_embedding.py
[ 4.71191406e-02  2.94494629e-03 -3.63769531e-02 -1.47247314e-03
 -2.29492188e-02  1.69677734e-02  5.07354736e-04 -1.73339844e-02
 ... (中略) ...
 -2.34603882e-04 -2.18505859e-02  1.98974609e-02  2.09045410e-03]
<class 'numpy.ndarray'>
(768,)
float32
無事埋め込みができました。
3-2. 類似度を調べてみる
画像の埋め込みができたので、三枚の画像とテキストを使って類似度を見てみます。
from sentence_transformers import SentenceTransformer

model = SentenceTransformer("google/embeddinggemma-2")

query = "search dog image"
documents = [
    {"image": "images/01_a_chihuahua.png"},
    {"image": "images/02_three_miniature_dachshunds.png"},
    {"image": "images/03_a_cat.png"},
]

emb_query = model.encode_query(query)
emb_document = model.encode_document(documents)

similarities = model.similarity(emb_query, emb_document)
print(similarities)
$ uv run calculate_similarities.py
tensor([[0.7282, 0.7152, 0.6756]])
documentsに書いた順に類似度が出力されています。
チワワ, ミニチュアダックスフンド, 猫 の順なので類似度は意図通りかなと思います。
他にもいくつかのクエリを試して類似度を見てみます。
()の数字は一番大きなものを1としたときの割合 (相対的な差を見たいので)。
search dog image- 01_a_chihuahua.png:
0.7282 (1.000) - 02_three_miniature_dachshunds.png:
0.7152 (0.982) - 03_a_cat.png:
0.6756 (0.928)
- 01_a_chihuahua.png:
search cat image- 01_a_chihuahua.png:
0.6501 (0.874) - 02_three_miniature_dachshunds.png:
0.6378 (0.858) - 03_a_cat.png:
0.7434 (1.000)
- 01_a_chihuahua.png:
search a dog- 01_a_chihuahua.png:
0.7357 (1.000) - 02_three_miniature_dachshunds.png:
0.7042 (0.957) - 03_a_cat.png:
0.6670 (0.907)
- 01_a_chihuahua.png:
search dachshund- 01_a_chihuahua.png:
0.6954 (0.874) - 02_three_miniature_dachshunds.png:
0.7960 (1.000) - 03_a_cat.png:
0.6614 (0.831)
- 01_a_chihuahua.png:
search flying birds- 01_a_chihuahua.png:
0.6110 (0.985) - 02_three_miniature_dachshunds.png:
0.6133 (0.989) - 03_a_cat.png:
0.6200 (1.000)
- 01_a_chihuahua.png:
犬の画像はどれ?- 01_a_chihuahua.png:
0.7128 (1.000) - 02_three_miniature_dachshunds.png:
0.6913 (0.970) - 03_a_cat.png:
0.6457 (0.906)
- 01_a_chihuahua.png:
猫の画像はどれ?- 01_a_chihuahua.png:
0.6171 (0.866) - 02_three_miniature_dachshunds.png:
0.5978 (0.839) - 03_a_cat.png:
0.7126 (1.000)
- 01_a_chihuahua.png:
一匹の犬の画像はどれ?- 01_a_chihuahua.png:
0.7183 (1.000) - 02_three_miniature_dachshunds.png:
0.6920 (0.963) - 03_a_cat.png:
0.6525 (0.908)
- 01_a_chihuahua.png:
ミニチュアダックスフンドの画像はどれ?- 01_a_chihuahua.png:
0.6592 (0.959) - 02_three_miniature_dachshunds.png:
0.6875 (1.000) - 03_a_cat.png:
0.5948 (0.865)
- 01_a_chihuahua.png:
飛んでる鳥の画像はどれ?- 01_a_chihuahua.png:
0.6016 (0.978) - 02_three_miniature_dachshunds.png:
0.5847 (0.950) - 03_a_cat.png:
0.6154 (1.000)
- 01_a_chihuahua.png:
英語と日本語で試してみました。
傾向としては概ね識別できているように思います。
(だいたい類似度0.7が閾値になってそう。一部例外もあるけど)
類似度だと少しわかりにくいものもありました。
4. S3 VectorsでQueryしてみる
S3 VectorsでのQueryも試してみます。
4-1. BucketとIndexを作成する
AWS CLIを使ってS3VectorsのBucketとIndexを作成します。
Bucket名を test-bucket 、Index名を test-index としています。
$ aws s3vectors create-vector-bucket \
      --vector-bucket-name test-bucket
{
    "vectorBucketArn": "arn:aws:s3vectors:ap-northeast-1:000000000000:bucket/test-bucket"
}

$ aws s3vectors create-index \
      --vector-bucket-name test-bucket \
      --index-name test-index \
      --data-type float32 \
      --dimension 768 \
      --distance-metric cosine
{
    "indexArn": "arn:aws:s3vectors:ap-northeast-1:000000000000:bucket/test-bucket/index/test-index"
}
4-2. IndexにPutする
作成したIndexに画像のベクトルをPutします。
import boto3
from sentence_transformers import SentenceTransformer

client = boto3.client("s3vectors")

model = SentenceTransformer("google/embeddinggemma-2")

documents = [
    {"image": "images/01_a_chihuahua.png"},
    {"image": "images/02_three_miniature_dachshunds.png"},
    {"image": "images/03_a_cat.png"},
]

emb_documents = model.encode_document(documents)

vectors = [
    {"key": doc["image"], "data": {"float32": emb.tolist()}}
    for doc, emb in zip(documents, emb_documents)
]

client.put_vectors(
    vectorBucketName="test-bucket",
    indexName="test-index",
    vectors=vectors,
)
$ uv add boto3
$ uv run put_vectors.py
4-3. Queryしてみる
IndexにQueryしてDistanceを取得してみます。
先ほどと異なりDistanceなので値が小さいものが似ているということになります。
import boto3
from sentence_transformers import SentenceTransformer

client = boto3.client("s3vectors")

model = SentenceTransformer("google/embeddinggemma-2")

query = "search dog image"

emb = model.encode_query(query)

resp = client.query_vectors(
    vectorBucketName="test-bucket",
    indexName="test-index",
    topK=3,
    queryVector={"float32": emb.tolist()},
    returnDistance=True,
)

print(resp["vectors"])
$ uv run query_vectors.py
[{'distance': 0.27181023359298706, 'key': 'images/01_a_chihuahua.png'},
 {'distance': 0.28478217124938965,
  'key': 'images/02_three_miniature_dachshunds.png'},
 {'distance': 0.3243723511695862, 'key': 'images/03_a_cat.png'}]
先ほど試したQueryも同様に試してみます。
() は一番小さな値と比較したときの割合です。
search dog image- 01_a_chihuahua.png:
0.2718 (1.00) - 02_three_miniature_dachshunds.png:
0.2848 (1.05) - 03_a_cat.png:
0.3244 (1.19)
- 01_a_chihuahua.png:
search cat image- 01_a_chihuahua.png:
0.3499 (1.36) - 02_three_miniature_dachshunds.png:
0.3622 (1.41) - 03_a_cat.png:
0.2566 (1.00)
- 01_a_chihuahua.png:
search a dog- 01_a_chihuahua.png:
0.2643 (1.00) - 02_three_miniature_dachshunds.png:
0.2958 (1.12) - 03_a_cat.png:
0.3330 (1.26)
- 01_a_chihuahua.png:
search dachshund- 01_a_chihuahua.png:
0.3046 (1.49) - 02_three_miniature_dachshunds.png:
0.2040 (1.00) - 03_a_cat.png:
0.3386 (1.66)
- 01_a_chihuahua.png:
search flying birds- 01_a_chihuahua.png:
0.3891 (1.02) - 02_three_miniature_dachshunds.png:
0.3867 (1.02) - 03_a_cat.png:
0.3800 (1.00)
- 01_a_chihuahua.png:
犬の画像はどれ?- 01_a_chihuahua.png:
0.2872 (1.00) - 02_three_miniature_dachshunds.png:
0.3087 (1.07) - 03_a_cat.png:
0.3543 (1.23)
- 01_a_chihuahua.png:
猫の画像はどれ?- 01_a_chihuahua.png:
0.3829 (1.33) - 02_three_miniature_dachshunds.png:
0.4022 (1.40) - 03_a_cat.png:
0.2874 (1.00)
- 01_a_chihuahua.png:
一匹の犬の画像はどれ?- 01_a_chihuahua.png:
0.2817 (1.00) - 02_three_miniature_dachshunds.png:
0.3080 (1.09) - 03_a_cat.png:
0.3475 (1.23)
- 01_a_chihuahua.png:
ミニチュアダックスフンドの画像はどれ?- 01_a_chihuahua.png:
0.3408 (1.09) - 02_three_miniature_dachshunds.png:
0.3125 (1.00) - 03_a_cat.png:
0.4051 (1.30)
- 01_a_chihuahua.png:
飛んでる鳥の画像はどれ?- 01_a_chihuahua.png:
0.3984 (1.04) - 02_three_miniature_dachshunds.png:
0.4153 (1.08) - 03_a_cat.png:
0.3845 (1.00)
- 01_a_chihuahua.png:
こちらだと、だいたい 0.3 未満のものが近いようです。
日本語でミニチュアダックスフンドの画像を尋ねたときだけ妙に距離があるようですが、他は概ね識別できているように見えます。
個人的には類似度を見るときよりもわかりやすいように感じます。
まとめ
以上、EmbeddingGemma 2を試してみた話でした。
画像も認識して、テキストで検索することもできそうです。
何かのお役に立てたら幸いです。