Amazon EMR Serverless の事前初期化容量で、ジョブが開始されるまでの時間をジョブの間隔ごとに測ってみた

はじめに
テクニカルサポートの 片方 です。
Amazon EMR Serverless には、ドライバーとエグゼキューターのワーカーをあらかじめ起動しておく「事前初期化容量」(initialCapacity)があります。ワーカーが初期化済みなら、ジョブは直ちに開始されます。
一方で、ジョブが終わると使ったワーカーは解放され、使えるリソースの数は initialCapacity に戻ります。では、前のジョブが終わってすぐに次のジョブを送ったときにも、ジョブはすぐに始まるのでしょうか。
そこで、ドライバーとエグゼキューターが 1 ワーカーずつの最小構成のアプリケーションを、事前初期化なしとありで 1 つずつ作りました。前のジョブの SUCCESS が見えてから次のジョブを送るまでの秒数(以下、ジョブの間隔)を変えて、StartJobRun から RUNNING までの時間を測っています。
構成
東京リージョンに、次のリソースを AWS CLI で作りました。
| リソース | 内容 |
|---|---|
| Amazon S3 バケット spark-startup-bench-k7m2 | PySpark スクリプトとジョブのログ |
| ジョブランタイムロール spark-startup-bench-job-role | 信頼ポリシーは emr-serverless.amazonaws.com。バケットの読み書きだけ |
| アプリケーション spark-startup-bench-cold | Spark・emr-7.9.0・ARM64・事前初期化なし。最大容量 2 vCPU/4 GB/40 GB、自動起動あり。自動停止のアイドル時間は、1 回目の計測が 1 分、2 回目が 15 分 |
| アプリケーション spark-startup-bench-warm | 同じ設定に、事前初期化容量 DRIVER 1 ワーカー・EXECUTOR 1 ワーカー(各 1 vCPU/2 GB/20 GB) |
ジョブは spark.range(1000000).count() だけの PySpark スクリプトで、StartJobRun で送りました。Spark のパラメータは次のとおりです。
spark.driver.cores=1、spark.driver.memory=1gspark.executor.cores=1、spark.executor.memory=1g、spark.executor.instances=1spark.dynamicAllocation.enabled=false
Spark のメモリのオーバーヘッドは、デフォルトでコンテナのメモリの 10%、最小 384 MB です。1g の 10%(約 102 MB)は最小値より小さいので、オーバーヘッドは 384 MB になり、合計は約 1.4 GB です。事前初期化容量のワーカーの 2 GB に収まります。
計測は boto3 のスクリプトで行いました。
StartJobRunの直後から 1 秒ごとにGetJobRunとGetApplicationを呼び、ジョブとアプリケーションの状態が変わった時刻を記録します。- 2 回目の計測では、前のジョブの
SUCCESSが見えてから決めた秒数だけ待って、次のジョブを送ります。 StartJobRunには毎回新しいclientTokenを付けます。再試行は boto3 の standard モード(max_attemptsを 3 にし、初回を含めて最大 4 回)に任せます。- ジョブはデータを数えるだけで書き換えないので、同じジョブが 2 回実行されても結果は変わりません。
次は、2 回目の計測のスクリプトの一部です。クライアントや定数の定義、now と app_state の関数は省いています。1 回目の run_once も、出力の項目と戻り値のほかは同じです。
cfg = Config(retries={"mode": "standard", "max_attempts": 3})
emr = boto3.client("emr-serverless", config=cfg)

def run_once(app_id, role, bucket, label, i):
    t0 = time.time()
    r = emr.start_job_run(applicationId=app_id, clientToken=str(uuid.uuid4()), executionRoleArn=role, name=f"{label}-{i}",
                          jobDriver={"sparkSubmit": {"entryPoint": f"s3://{bucket}/scripts/count.py", "sparkSubmitParameters": SPARK_PARAMS}},
                          configurationOverrides={"monitoringConfiguration": {"s3MonitoringConfiguration": {"logUri": f"s3://{bucket}/logs/"}}})
    job_id = r["jobRunId"]
    print(f"{now()} [{label}-{i}] StartJobRun returned after {time.time() - t0:.1f} s jobRunId={job_id}", flush=True)
    last_job = last_app = None
    times = {}
    while True:
        j = emr.get_job_run(applicationId=app_id, jobRunId=job_id)["jobRun"]
        a = app_state(app_id)
        if j["state"] != last_job or a != last_app:
            if j["state"] != last_job:
                times[j["state"]] = round(time.time() - t0, 1)
            print(f"{now()} [{label}-{i}] +{time.time() - t0:5.1f}s job={j['state']} app={a}", flush=True)
            last_job, last_app = j["state"], a
        if j["state"] in ("SUCCESS", "FAILED", "CANCELLED"):
            summary = {"label": label, "run": i, "jobRunId": job_id, "times": times,
                       "totalExecutionDurationSeconds": j.get("totalExecutionDurationSeconds"),
                       "billedResourceUtilization": j.get("billedResourceUtilization"),
                       "totalResourceUtilization": j.get("totalResourceUtilization"),
                       "stateDetails": j.get("stateDetails"),
                       "createdAt": j.get("createdAt"), "startedAt": j.get("startedAt"), "endedAt": j.get("endedAt")}
            print("SUMMARY " + json.dumps(summary, default=str), flush=True)
            return time.time(), j.get("endedAt")
        time.sleep(1)

def seq(app_id, label, waits):
    prev_seen = prev_ended = None
    for i, w in enumerate(waits, start=1):
        if prev_seen is None:
            time.sleep(w)
        else:
            time.sleep(max(0.0, prev_seen + w - time.time()))
        state = app_state(app_id)
        t = time.time()
        if prev_seen is None:
            print(f"{now()} [{label}-{i}] app={state} before start (first job, waited {w} s)", flush=True)
        else:
            gap_ended = t - prev_ended.timestamp() if prev_ended else None
            print(f"{now()} [{label}-{i}] app={state} before start; {t - prev_seen:.1f} s after previous SUCCESS was seen, "
                  f"{gap_ended:.1f} s after previous endedAt (target {w} s)", flush=True)
        prev_seen, prev_ended = run_once(app_id, ROLE, BUCKET, label, i)
先に結論から
- アプリケーションが
STARTEDのまま、前のジョブ(1 本目は準備)から 120 秒以上あけて送ったジョブは、事前初期化ありで 4.2〜7.6 秒でRUNNINGになりました。事前初期化なしは 77.6〜80.0 秒でした。 - ジョブの間隔が短いと、事前初期化ありでも遅くなりました。約 33 秒で 48.7 秒、60.1 秒で 23.2 秒でした。前のジョブの直後に送ると 74.2〜77.6 秒で、事前初期化なし(78.2〜84.3 秒)とほとんど変わりません。
- ジョブの後に、事前初期化容量のワーカーが作り直されるためと判断しました。Amazon CloudWatch のメトリクスでも、ジョブの後にワーカーが作成保留中(PendingCreation)になっていました。
STOPPEDからの自動起動では、事前初期化ありのほうが、RUNNINGまで約 10 秒遅くなりました。
やってみた
次の順に進めました。
- アプリケーションを 2 つ作る
- 1 回目の計測:前のジョブの直後に送る、STOPPED から自動起動する
- 2 回目の計測:STARTED のまま、ジョブの間隔を 180 秒にして送る
- ジョブの間隔を 30・60・120 秒にして送る
1. アプリケーションを 2 つ作る
次のスクリプトでアプリケーションを作りました(2 回目の計測のもので、自動停止のアイドル時間は 15 分です)。同じ名前のアプリケーションがあれば作らないので、何度実行しても 1 つずつのままです。バケットとロールの作成、count.py のアップロード、時刻を出す ts 関数の定義などは省いています。
RELEASE=emr-7.9.0

COMMON=(--type SPARK --architecture ARM64 --maximum-capacity cpu=2vCPU,memory=4GB,disk=40GB
  --auto-start-configuration enabled=true --auto-stop-configuration enabled=true,idleTimeoutMinutes=15 --tags owner=katagata)
INIT='{"DRIVER":{"workerCount":1,"workerConfiguration":{"cpu":"1vCPU","memory":"2GB","disk":"20GB"}},"EXECUTOR":{"workerCount":1,"workerConfiguration":{"cpu":"1vCPU","memory":"2GB","disk":"20GB"}}}'

app_id() {  # 名前が同じで TERMINATED 以外のアプリケーションの ID
  aws emr-serverless list-applications \
    --query "applications[?name=='$1' && state!='TERMINATED'].id | [0]" --output text
}
COLD=$(app_id spark-startup-bench-cold)
if [ "$COLD" = None ]; then
  COLD=$(aws emr-serverless create-application --name spark-startup-bench-cold --release-label "$RELEASE" "${COMMON[@]}" --query applicationId --output text)
  echo "$(ts) cold app created $COLD"
else
  echo "$(ts) cold app exists $COLD"
fi
WARM=$(app_id spark-startup-bench-warm)
if [ "$WARM" = None ]; then
  WARM=$(aws emr-serverless create-application --name spark-startup-bench-warm --release-label "$RELEASE" "${COMMON[@]}" --initial-capacity "$INIT" --query applicationId --output text)
  echo "$(ts) warm app created $WARM"
else
  echo "$(ts) warm app exists $WARM"
fi
事前初期化容量は initialCapacity で指定し、ワーカーが初期化済みなら、ジョブは直ちに開始されます。
この機能を設定するには、アプリケーションの
initialCapacityパラメータを事前初期化するワーカーの数に設定します。ワーカー容量が初期化済みの場合、ジョブは直ちに開始されます。
2. 1 回目の計測:前のジョブの直後に送る、STOPPED から自動起動する
1 回目の計測は、自動停止のアイドル時間を 1 分にして行いました。作成直後(CREATED)から 5 本続けて送り、2〜5 本目は、前のジョブの SUCCESS が見えてから 0〜1 秒後に送りました。その後、アプリケーションが STOPPED になるのを待ってから、2 本ずつ送りました。
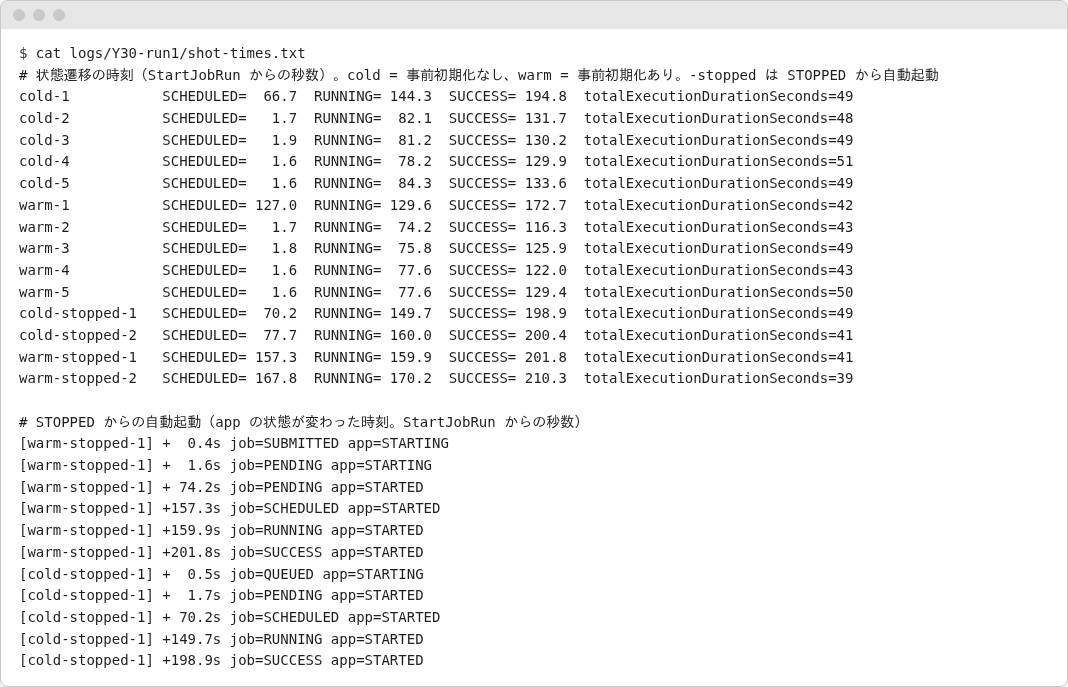
| 条件 | 事前初期化なし:RUNNING まで | 事前初期化あり:RUNNING まで |
|---|---|---|
| CREATED から(1 本目) | 144.3 秒 | 129.6 秒 |
| 前のジョブの直後(2〜5 本目) | 78.2〜84.3 秒 | 74.2〜77.6 秒 |
| STOPPED から自動起動(2 本) | 149.7・160.0 秒 | 159.9・170.2 秒 |
前のジョブの直後に送った 2〜5 本目は、どちらも 2 秒以内に SCHEDULED になりました。そこから RUNNING までは、事前初期化なしで 76.6〜82.7 秒、事前初期化ありで 72.5〜76.0 秒かかっています。事前初期化ありでも、ほとんど速くなりませんでした。
STOPPED からの自動起動では、事前初期化なしは、StartJobRun から 2 秒以内に STARTED になりました。事前初期化ありは、STARTED になるまでに 74.2 秒と 82.3 秒かかっています。事前初期化ありのアプリケーションは、事前初期化容量の準備ができてから STARTED になり、STOPPED になると事前初期化容量は解放されるためです。
事前初期化ありの STOPPED からの 2 本と CREATED からの 1 本は、STARTED になった後も、50〜86 秒 PENDING が続きました。SCHEDULED は 127.0〜167.8 秒、RUNNING はその 2〜3 秒後です。
前のジョブの直後に送ると事前初期化の効果がほとんど無かったので、2 回目は、アプリケーションを STARTED のままにして、ジョブの間隔を変えて測りました。
3. 2 回目の計測:STARTED のまま、ジョブの間隔を 180 秒にして送る
2 回目は、自動停止のアイドル時間を 15 分にしました。boto3 のスクリプトから StartApplication を呼んで、2 つのアプリケーションを起動しています。事前初期化なしは 2.6 秒、事前初期化ありは 79.6 秒で STARTED になりました。両方が STARTED になってから、最初のジョブを送るまで 196 秒あけています。
2 つのアプリケーションで同時にスクリプトを開始し、ジョブを 3 本ずつ送りました。
- 1 本目は、準備の後に同時に送りました。
- 2・3 本目は、それぞれのアプリケーションで、前のジョブの
SUCCESSが見えてから 180 秒後に送りました。そのため、送った時刻は 2 つのアプリケーションでずれています。
表の SCHEDULED と RUNNING は、StartJobRun からの秒数です。
| 本目 | 事前初期化あり:ジョブの間隔 | SCHEDULED | RUNNING | 事前初期化なし:ジョブの間隔 | SCHEDULED | RUNNING |
|---|---|---|---|---|---|---|
| 1 | (準備の後) | 1.7 秒 | 4.2 秒 | (準備の後) | 1.6 秒 | 77.6 秒 |
| 2 | 180.1 秒 | 1.6 秒 | 5.3 秒 | 180.2 秒 | 1.5 秒 | 78.8 秒 |
| 3 | 180.1 秒 | 1.6 秒 | 6.3 秒 | 180.1 秒 | 1.6 秒 | 80.0 秒 |
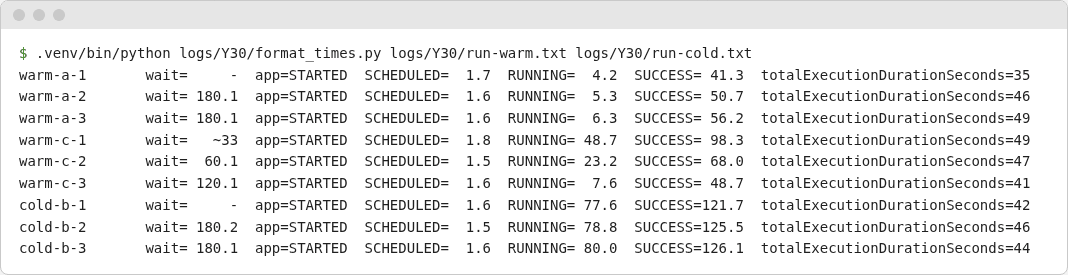
画像の warm-a が事前初期化あり、cold-b が事前初期化なしです。どちらも 2 秒以内に SCHEDULED(ジョブを実行するリソースを割り当てている状態)になりました。そこから RUNNING までは、事前初期化ありが 2.5〜4.7 秒、事前初期化なしが 76.0〜78.4 秒でした。
SUCCESS までは、事前初期化ありが 41.3〜56.2 秒、事前初期化なしが 121.7〜126.1 秒です。totalExecutionDurationSeconds は、2 回目の 9 本で 35〜49 秒でした。
4. ジョブの間隔を 30・60・120 秒にして送る
事前初期化ありのアプリケーションで、ジョブの間隔を 30 秒、60 秒、120 秒にして、1 本ずつ送りました。30 秒の回は、別のプロセスとして起動したスクリプトの 1 本目です。ログの時刻(秒単位)では、前のジョブの SUCCESS が見えてから実際に送るまで、約 33 秒でした(画像の ~33)。
| ジョブの間隔 | SCHEDULED | RUNNING | SUCCESS |
|---|---|---|---|
| 約 33 秒 | 1.8 秒 | 48.7 秒 | 98.3 秒 |
| 60.1 秒 | 1.5 秒 | 23.2 秒 | 68.0 秒 |
| 120.1 秒 | 1.6 秒 | 7.6 秒 | 48.7 秒 |
手順 3 の画像の warm-c-1 から warm-c-3 が、この 3 本です。間隔が短いほど、SCHEDULED から RUNNING までが長くなりました。
ジョブが終わると、使ったワーカーは解放され、使えるリソースの数は initialCapacity に戻ります。
ジョブの実行が完了すると、使用したワーカーが解放され、アプリケーションで使用できるリソースの数は
initialCapacityに戻ります。
確認してみた
事前初期化容量のワーカーがジョブに使われたか
EMR Serverless は、CloudWatch のメトリクス(名前空間 AWS/EMRServerless)を、容量の割り当てタイプ(CapacityAllocationType)ごとにも出します。ジョブごとのメトリクス WorkerCpuAllocated のディメンションを、ListMetrics で一覧にしました。
2 回目の計測の事前初期化ありの 6 本は、ドライバーとエグゼキューターのどちらも PreInitCapacity でした。事前初期化なしの 3 本は OnDemandCapacity でした。
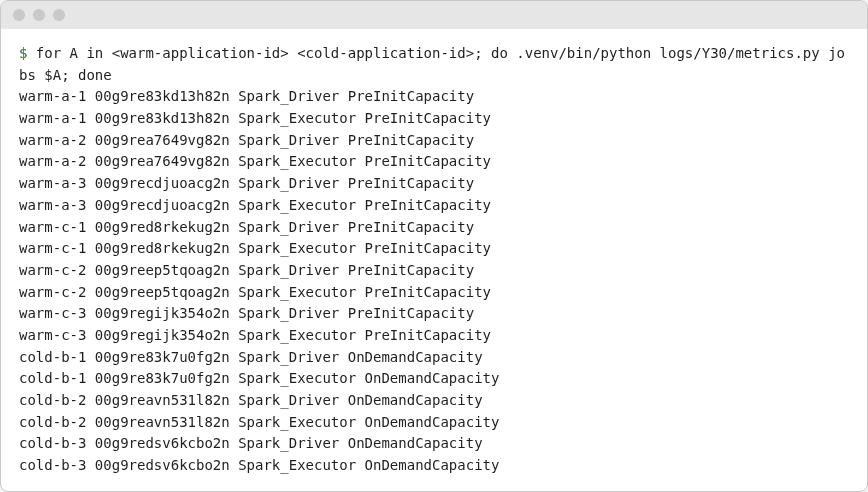
1 回目の計測でも、事前初期化ありの 7 本は、すべて PreInitCapacity でした。遅かった「前のジョブの直後」の 4 本と STOPPED からの 2 本も、事前初期化容量のワーカーで実行されています。事前初期化なしの 7 本は、すべて OnDemandCapacity でした。
事前初期化容量のワーカーの作り直し
次の画像は、2 回目の計測で、事前初期化ありのアプリケーションに出た 1 分ごとのワーカー数です(PreInitCapacity、統計は Maximum)。左の列は、準備で StartApplication を送った分を 0 とした経過分です。
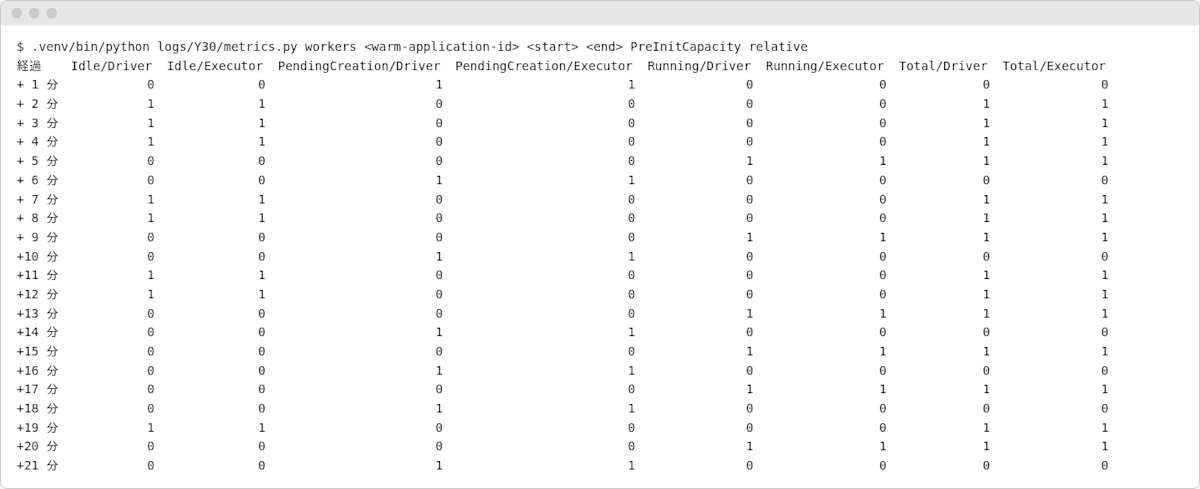
Running が 1 の行は 6 つで、ジョブの本数と同じです。どの行も、次の行で PendingCreation(作成保留中のワーカーの数)が 1、Total(使用可能なワーカーの数)が 0 になっていました。次のジョブまで時間があった回は、その後の行で Idle が 1 に戻っています。1 回目の計測でも、Running が 1 の行の次の行で、PendingCreation が 1 になっていました。
メトリクスは 1 分単位で、ログの秒単位の時刻とは、そのままでは重なりません。ジョブが RUNNING になった時刻を含む分の行でも、Running は 0 でした。そのため、この表から読み取っているのは、状態が変わる順番だけです。
前のジョブの SUCCESS が見えてから 60.1 秒以内に送ったジョブ(1 回目の計測の 2〜5 本目と、2 回目の約 33 秒・60.1 秒の回)は、前のジョブの SUCCESS から 74〜83 秒後に RUNNING になっていました。
このことから、今回の構成では、次のように判断しました。
- ジョブが終わると、事前初期化容量のワーカーは作り直される。
- ジョブの間隔が作り直しにかかる時間より短いと、次のジョブは作り直しを待ってから
RUNNINGになる。
今回の構成は、最大容量(2 vCPU/4 GB)と事前初期化容量の合計が同じ大きさです。そのため、作り直しの間に、別のワーカーを使う余地がありません。
請求の対象になるリソース使用量
ジョブが終わった後に、GetJobRun で billedResourceUtilization を取得しました。取得できた 21 本(1 回目の計測の 12 本と、2 回目の 9 本)は、すべて vCPU 0.033 時間、メモリ 0.067 GB 時間、ストレージ 0 でした。これは、2 vCPU・4 GB をちょうど 1 分使った値です。ジョブの実行時間は 1 分未満でしたが、ワーカーの最低 1 分の使用量で計上されています。アイドル状態の事前初期化容量のワーカーの分は、この値には含まれません。
The billed resources include a 1-minute minimum usage for workers, plus additional storage over 20 GB per worker. Note that billed resources do not include usage for idle pre-initialized workers.
事前初期化容量のワーカーには、アプリケーションがアイドルの間も料金がかかります。ジョブの billedResourceUtilization だけを見ていると、その分を見落とします。
今回の計測について
条件ごとの本数は、次のとおりです。
- 1 回目の計測:CREATED からが各 1 本、前のジョブの直後が各 4 本、STOPPED からが各 2 本
- 2 回目の計測:準備の後の 1 本目が各 1 本、ジョブの間隔 180 秒が各 2 本、約 33 秒・60.1 秒・120.1 秒が各 1 本(事前初期化ありだけ)
GetJobRun と GetApplication を 1 秒の間隔で呼んでいるので、各時刻には約 1.2 秒の幅があります。
まとめ
事前初期化容量で、ジョブの開始は条件が合えばはっきり速くなりました。アプリケーションが STARTED のまま、前のジョブから時間をあけて送ったジョブは、RUNNING までが 77〜80 秒から 4〜8 秒に縮んでいます。CloudWatch で見ても、事前初期化容量のワーカーが使われていました。
ただ、「事前初期化しておけば、いつでも速い」とは言えませんでした。前のジョブの直後に送った場合は、事前初期化なしとほとんど変わりません。ジョブが終わると事前初期化容量のワーカーが作り直され、今回の 1 ワーカーずつの構成では、次のジョブがその作り直しを待っていたと見ています。
STOPPED からの自動起動でも、事前初期化ありのほうが約 10 秒遅く、事前初期化の効果は見られませんでした。事前初期化容量のワーカーにはアイドルの間も料金がかかるので、ジョブをどれくらいの間隔で送るのか、アプリケーションをどれくらい起動したままにするのかを決めてから使うのがよさそうです。
参考資料
- EMR Serverless でアプリケーションを操作するための事前初期化された容量 - Amazon EMR
- EMR Serverless でのアプリケーションの動作について - Amazon EMR
- ジョブ実行状態 - Amazon EMR
- EMR Serverless アプリケーションとジョブのモニタリング - Amazon EMR
- JobRun - Amazon EMR Serverless
クラスメソッドオペレーションズ株式会社について
クラスメソッドグループのオペレーション企業です。
運用・保守開発・サポート・情シス・バックオフィスの専門チームが、IT・AIをフル活用した「しくみ」を通じて、お客様の業務代行から課題解決や高付加価値サービスまでを提供するエキスパート集団です。
当社は様々な職種でメンバーを募集しています。
「オペレーション・エクセレンス」と「らしく働く、らしく生きる」を共に実現するカルチャー・しくみ・働き方にご興味がある方は、クラスメソッドオペレーションズ株式会社 コーポレートサイト をぜひご覧ください。※2026年1月 アノテーション㈱から社名変更しました