Lambdaの/tmpを使わずにS3上の数十GBのZIPを解凍してみた

こんにちは!製造ビジネステクノロジー部の石井です。
S3に置かれた数十GBのZIPをLambdaで展開しようとすると、一時領域(/tmp)が足りません。
/tmp は最大10GiBで、ZIP本体と展開後のファイルを両方置くと、ZIPのサイズの倍以上の容量が必要になるためです。
そこで /tmp を使わずに展開(解凍)する方法を2つ試しました。無圧縮のZIPなら、10GiBのファイルを4.3秒で展開できます。
この記事では、どちらの方式を選ぶか、Lambdaで扱えるのはどこまでかを実測値で整理して、実装も載せています。コードは長いので折りたたみにしました。
先に結論
やり方は2つ。どちらもZIP全体をダウンロードせず、/tmp も使いません(エフェメラルストレージは既定の512MBのまま完走)。
| 方式 | 対象 | 処理 | 10GiBの所要時間 | メモリ使用量 |
|---|---|---|---|---|
| ストリーミング展開 | DEFLATE(普通に圧縮されたZIP) | 範囲読み → 展開 → マルチパートアップロード | 約145秒(Lambda 3008MB) | 300〜400MiB |
| S3内コピー | STORED(無圧縮のZIP) | UploadPartCopy でZIPの該当範囲をコピー |
約4.3秒(Lambda 1024MB) | 約100MiB |
メモリ使用量は、どちらもファイルサイズに比例しません。
方式とLambdaの構成は、次の順に決めていきます。
-
ZIPの中身が無圧縮か → 無圧縮ならS3内コピー、圧縮されていればストリーミング展開
-
ストリーミング展開が15分に収まるか → 実測の約70MiB/sだと、15分で展開できるのは約61GiB。余裕を見るなら展開後30GiBが目安。超えるならファイル単位でLambdaを分ける
-
1ファイルでも30GiBを超えるか → 超えるならLambda以外も検討する(今回は測っていません)
-
VPC内で動かすか → S3 Gateway Endpoint経由にする。NAT Gateway経由だと、データ処理料金がLambdaの料金の約190倍になる
数値は東京リージョン・Node.js 24・x86_64のLambdaで測りました。
テストデータは、乱数で作った10GiBのファイルを1つだけ入れたZIP(乱数は圧縮しても縮まないので、動画の代わり)。
DEFLATE版は圧縮レベル0で作っています。乱数はどの圧縮レベルでも縮まず、展開側の処理は同じになるためです。
方式の選び方
ZIPの中身が圧縮されているか
無圧縮なら、ZIPの中の該当範囲がそのまま元のファイル。S3の中でコピーするだけで済みます。
圧縮されていると元に戻す計算が要るので、Lambdaに読み込んで展開します。
手元にZIPがあれば、unzip -v で確認できます。
 Length   Method    Size  Cmpr    Date    Time   CRC-32   Name
--------  ------  ------- ---- ---------- ----- --------  ----
  200000  Stored   200000   0% 09-18-2026 15:59 a5cf234e  video.mp4
  200000  Defl:N      422 100% 09-18-2026 15:59 9b025ae4  data.csv
Method列が Stored ならS3内コピー、Defl: で始まっていればストリーミング展開。Cmpr(圧縮率)が0%でもMethodが Defl:N ならDEFLATEです。
縮まなかっただけで圧縮はされているので、見るのはMethod列です。Lambdaの中では、ZIP末尾の目録(後述)に入っている圧縮方式の値で見分けます。
1つのZIPに両方が混ざることもあります。
ツールによっては、縮まないファイルだけ自動で無圧縮に切り替えるためです。ZIP単位で決め打ちにせず、ファイルごとに方式を分けるのがおすすめです。
ZIPの作り方を送り手にお願いできるなら、無圧縮(zip -0)で作ってもらうのが一番速いです。
動画のように圧縮済みのデータは、ZIPにしてもほぼ縮みません。手元で試したところ、元の99.99%でした。無圧縮にしても容量はほとんど変わりません。
なお、暗号化されたZIPと、STOREDとDEFLATE以外の圧縮方式は、今回の実装ではエラーにしています。
15分に収まるか
10GiBのファイルを1つ展開したときの実測値と、その速度から計算した15分(900秒)で展開できる量です。
| 方式 | メモリ | 10GiBの所要時間 | 速度 | 15分で展開できる量 |
|---|---|---|---|---|
| ストリーミング展開 | 1024MB | 269.8秒 | 38MiB/s | 約33GiB |
| ストリーミング展開 | 3008MB | 145.2秒 | 70MiB/s | 約61GiB |
| ストリーミング展開 | 10240MB | 145.1秒 | 70MiB/s | 約61GiB |
| S3内コピー | 1024MB | 4.3秒 | 2,420MiB/s | — |
ストリーミング展開はパート32MiB × 8並列、S3内コピーはパート64MiB × 48並列で測っています。
S3内コピーは10GiBで数秒なので、15分の制限にはかかりません(10GiBより大きいファイルでは測っていません)。考えるのはストリーミング展開のほう。
ストリーミング展開は3008MB以上にしても約70MiB/sから伸びず(理由は方式1の章で)、15分で展開できるのは約61GiBです。ただし900秒を使い切る前提の値なので、余裕を見るなら30GiB(約7分)あたりが目安。1024MBだと速度が約半分になり、15分で約33GiBまで下がります。
ここでいうサイズは、ZIPのサイズではなく展開後のサイズです。詰まっているのがS3への書き込みなので、書き込む量で時間が決まります。
よく縮むZIPをLambdaで展開する計測はしていません。ただ、手元のMacではよく縮むCSV(圧縮後は元の25%)でもinflateが約900MiB/s出ていたので、70MiB/sの書き込みのほうが先に上限になるとみています。
1回の実行に収まらないときは、ファイル単位でLambdaを分けます。2GiBのファイル8本を8つのLambdaで同時に展開したところ、1本あたり71〜73MiB/sのまま、16GiBを31秒(合計約530MiB/s)で処理できました。こうすると、15分に収めるべきなのはいちばん大きい1ファイルになります。
検証では、展開するファイル名(entryName)を変えて、手元のスクリプトから8回同時に呼びました。本番で使うなら、目録を読んでファイルごとに展開Lambdaを呼び出す仕組み(Step FunctionsのMapなど)が別に要ります。ここは作っていません。
1ファイルが大きすぎる場合は、Lambdaを分けても解決しません。DEFLATEは途中から展開を始められないので、1つのファイルを複数のLambdaで分担できないためです。
メモリはどれくらいにするか
上の表と同じ計測での、最大RSSとLambdaの料金です。料金は所要時間から計算しました(x86_64、東京リージョンの単価$0.0000166667/GB秒)。
| 方式 | メモリ | 最大RSS | 10GiBを1回展開したときのLambdaの料金 |
|---|---|---|---|
| ストリーミング展開 | 1024MB | 339MiB | 約$0.0045 |
| ストリーミング展開 | 3008MB | 347MiB | 約$0.0071 |
| ストリーミング展開 | 10240MB | 402MiB | 約$0.024 |
| S3内コピー | 1024MB | 103MiB | $0.0001未満 |
S3のリクエスト料金は、どちらの方式も$0.002未満でした。
ストリーミング展開なら3008MBがおすすめ。1024MBから上げると料金は約1.6倍になりますが、差は1セントにも届かず、所要時間は半分近くまで縮みます。1024MBが遅いのは、CPUの割り当てが足りないためとみています(Lambdaはメモリに比例してCPUが割り当てられ、1024MBだと約0.58 vCPU)。10240MBまで上げても速度は同じで、料金だけ3.4倍になります。
S3内コピーはデータがLambdaを通らないので、1024MBで十分です。
VPC内で動かすか
VPC内のLambdaがNAT Gateway経由でS3と通信すると、通ったデータ量に応じてデータ処理料金(東京リージョンで$0.062/GB)がかかります。
ストリーミング展開は、ZIPの読み込みと展開結果の書き込みの両方がNAT Gatewayを通ります。10GiBなら読み書き合わせて約21.5GBで、約$1.3。3008MBのLambdaの料金の約190倍です。
S3 Gateway Endpointを付けておけば、このデータ処理料金はかかりません。Gateway Endpoint自体も無料です。S3内コピーは、データがS3の中で動くのでどちらでもかかりません。
今回のVPC内の計測はS3 Gateway Endpoint経由で、速度はVPC外と同じ70MiB/sでした。NAT Gateway経由の速度は測っていません。
Lambda以外の環境やZIPライブラリは使えるか
どちらも今回は試していません。分かっている範囲だけ書いておきます。
- 2026年9月のアップデートで、Lambda Managed Instances(Lambda関数を自分のアカウントのEC2インスタンス上で動かす実行形態)では、非同期呼び出しとイベントソースマッピングのタイムアウトを最大90分まで設定できるようになりました(AWS What's New)。通常のLambdaと同期呼び出しは15分のままです
- ECSやFargateのように実行時間の制限がない環境でも、展開処理のコードは流用できます。Lambdaに依存する部分がないためです。速度が70MiB/sになるかは確かめていません
- ZIPライブラリは使わず、目録の読み取りを自分で書きました。S3内コピーには「ファイルのデータがZIPの何バイト目から始まるか」が必要で、ストリーミング展開でもその値でRange GETの範囲を決めるためです。既存のライブラリで同じことができるかは確かめていません
ZIPは末尾から読める
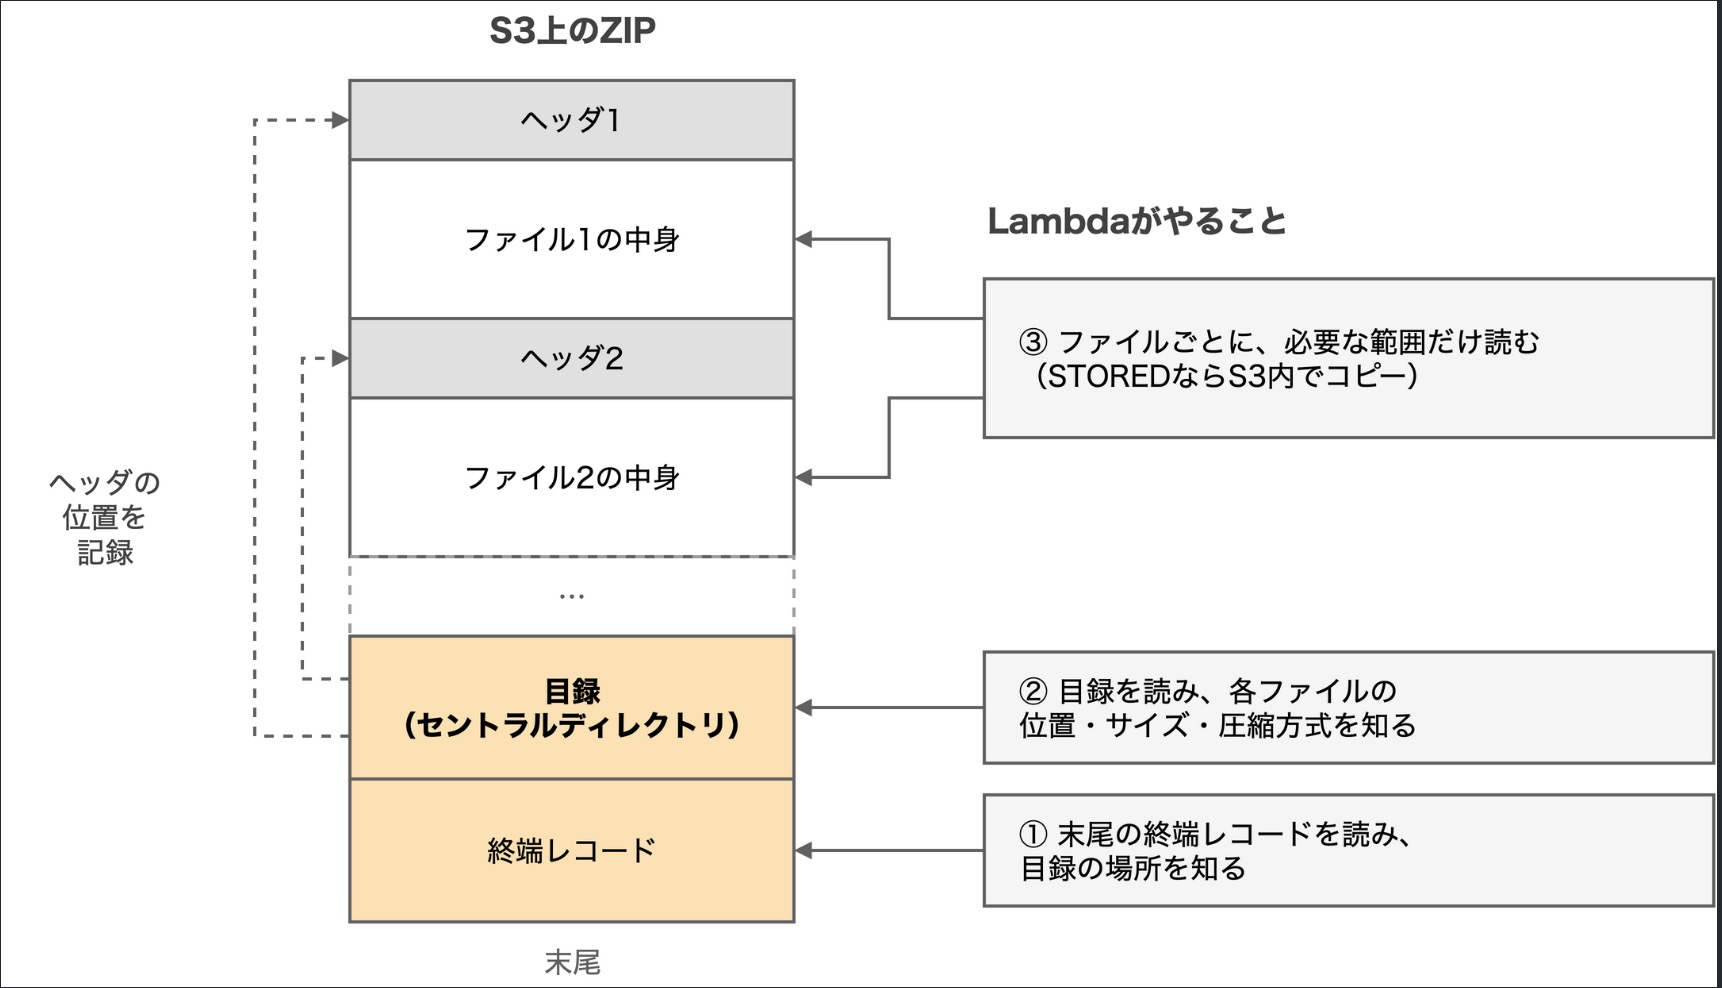
両方の方式の前提になるのがZIPの構造です。ZIPは、ファイルごとにヘッダと中身を順に並べて、最後に目録(セントラルディレクトリ)と終端レコードを付けた形式になっています。
目録には、ファイルごとに次の情報が入っています。
- ファイル名
- 圧縮方式(STORED = 無圧縮、DEFLATE = 圧縮)
- 圧縮後のサイズと元のサイズ
- CRC-32
- ヘッダの位置(ZIPの先頭から何バイト目か)
末尾の目録さえ読めば、「どのファイルがZIPの何バイト目から何バイト目にあるか」が分かります。S3の GetObject は Range ヘッダでバイト範囲を指定できるので、30GiBのZIPでも最初に読むのは末尾の64KiBほどと目録(ファイルが十数個なら数KB)だけ。末尾を64KiBまとめて読むのは、終端レコードの後ろに最大65,535バイトのコメントが入ることがあるためです。
目録を読んで、ファイルごとに方式を選ぶコード(TypeScript)
目録の読み取り(central-directory.ts)。S3に依存しないよう、範囲を読む関数(ReadRange)だけを受け取ります。
/** ZIPの [start, end) の範囲を読む関数。S3ならRange GETで実装する */
export type ReadRange = (start: number, end: number) => Promise<Buffer>;

/** 目録から得たファイルの情報 */
export type ZipEntry = {
  /** ZIP内のパス */
  name: string;
  /** 圧縮方式(0: STORED, 8: DEFLATE) */
  method: number;
  /** 汎用ビットフラグ */
  flags: number;
  /** 展開後データのCRC-32 */
  crc32: number;
  /** ZIP内で占めるバイト数 */
  compressedSize: number;
  /** 展開後のバイト数 */
  uncompressedSize: number;
  /** ローカルファイルヘッダの位置(ZIP先頭からのバイト数) */
  localHeaderOffset: number;
};

export const METHOD_STORED = 0;
export const METHOD_DEFLATE = 8;

const SIG_EOCD = 0x06054b50;
const SIG_ZIP64_EOCD_LOCATOR = 0x07064b50;
const SIG_ZIP64_EOCD = 0x06064b50;
const SIG_CENTRAL_FILE_HEADER = 0x02014b50;
const SIG_LOCAL_FILE_HEADER = 0x04034b50;

const EOCD_MIN_SIZE = 22;
const MAX_COMMENT_SIZE = 0xffff;
const ZIP64_EOCD_LOCATOR_SIZE = 20;
const ZIP64_EOCD_MIN_SIZE = 56;
const CENTRAL_FILE_HEADER_SIZE = 46;
const LOCAL_FILE_HEADER_SIZE = 30;
const ZIP64_EXTRA_FIELD_ID = 0x0001;
const UINT16_MAX = 0xffff;
const UINT32_MAX = 0xffffffff;
const FLAG_ENCRYPTED = 0x0001;

const readUInt64 = (buf: Buffer, offset: number): number => {
  const value = Number(buf.readBigUInt64LE(offset));
  if (!Number.isSafeInteger(value)) {
    throw new Error(`64bit value exceeds MAX_SAFE_INTEGER at ${offset}`);
  }
  return value;
};

// 終端レコード(EOCD)を探す。後ろに最大65535バイトのコメントが付くので、末尾をまとめて読んで後ろから探す
const findEocd = async (
  readRange: ReadRange,
  zipSize: number
): Promise<{ tail: Buffer; tailStart: number; eocdPos: number }> => {
  if (zipSize < EOCD_MIN_SIZE) {
    throw new Error('not a zip: too small');
  }
  const tailStart = Math.max(0, zipSize - EOCD_MIN_SIZE - MAX_COMMENT_SIZE);
  const tail = await readRange(tailStart, zipSize);
  for (let pos = tail.length - EOCD_MIN_SIZE; pos >= 0; pos--) {
    if (tail.readUInt32LE(pos) === SIG_EOCD) {
      return { tail, tailStart, eocdPos: pos };
    }
  }
  throw new Error('not a zip: end of central directory not found');
};

// 目録の位置・サイズ・件数を得る。EOCDの値が上限値ならZIP64 EOCDを読みにいく
const locateCentralDirectory = async (
  readRange: ReadRange,
  zipSize: number
): Promise<{ offset: number; size: number; count: number }> => {
  const { tail, tailStart, eocdPos } = await findEocd(readRange, zipSize);

  const count = tail.readUInt16LE(eocdPos + 10);
  const size = tail.readUInt32LE(eocdPos + 12);
  const offset = tail.readUInt32LE(eocdPos + 16);
  const needsZip64 =
    count === UINT16_MAX || size === UINT32_MAX || offset === UINT32_MAX;

  const locatorPos = eocdPos - ZIP64_EOCD_LOCATOR_SIZE;
  const hasLocator =
    locatorPos >= 0 && tail.readUInt32LE(locatorPos) === SIG_ZIP64_EOCD_LOCATOR;

  if (!hasLocator) {
    if (needsZip64) {
      throw new Error('broken zip: zip64 locator not found');
    }
    return { offset, size, count };
  }

  // ロケータにはZIP64 EOCDの絶対位置が書いてある。末尾バッファ内に収まっていれば読み直さない
  const zip64EocdOffset = readUInt64(tail, locatorPos + 8);
  const posInTail = zip64EocdOffset - tailStart;
  const zip64Eocd =
    posInTail >= 0
      ? tail.subarray(posInTail, posInTail + ZIP64_EOCD_MIN_SIZE)
      : await readRange(zip64EocdOffset, zip64EocdOffset + ZIP64_EOCD_MIN_SIZE);

  if (zip64Eocd.readUInt32LE(0) !== SIG_ZIP64_EOCD) {
    throw new Error('broken zip: zip64 end of central directory not found');
  }
  return {
    count: readUInt64(zip64Eocd, 32),
    size: readUInt64(zip64Eocd, 40),
    offset: readUInt64(zip64Eocd, 48),
  };
};

// ZIP64拡張フィールドには「ヘッダ側が0xFFFFFFFFの項目だけ」が
// 元サイズ → 圧縮後サイズ → ローカルヘッダ位置 の順に入る
const applyZip64Extra = (
  extra: Buffer,
  header: {
    uncompressedSize: number;
    compressedSize: number;
    localHeaderOffset: number;
  }
): {
  uncompressedSize: number;
  compressedSize: number;
  localHeaderOffset: number;
} => {
  const result = { ...header };
  const needs = [
    header.uncompressedSize,
    header.compressedSize,
    header.localHeaderOffset,
  ].some((v) => v === UINT32_MAX);
  if (!needs) {
    return result;
  }

  let pos = 0;
  while (pos + 4 <= extra.length) {
    const id = extra.readUInt16LE(pos);
    const len = extra.readUInt16LE(pos + 2);
    if (id === ZIP64_EXTRA_FIELD_ID) {
      let p = pos + 4;
      if (header.uncompressedSize === UINT32_MAX) {
        result.uncompressedSize = readUInt64(extra, p);
        p += 8;
      }
      if (header.compressedSize === UINT32_MAX) {
        result.compressedSize = readUInt64(extra, p);
        p += 8;
      }
      if (header.localHeaderOffset === UINT32_MAX) {
        result.localHeaderOffset = readUInt64(extra, p);
      }
      return result;
    }
    pos += 4 + len;
  }
  throw new Error('broken zip: zip64 extra field not found');
};

// 目録を読み、全ファイルの情報を返す。ファイル名はUTF-8として解釈する
export const readCentralDirectory = async (
  readRange: ReadRange,
  zipSize: number
): Promise<ZipEntry[]> => {
  const { offset, size, count } = await locateCentralDirectory(
    readRange,
    zipSize
  );
  if (offset + size > zipSize) {
    throw new Error('broken zip: central directory out of range');
  }
  const cd = await readRange(offset, offset + size);

  const entries: ZipEntry[] = [];
  let pos = 0;
  for (let i = 0; i < count; i++) {
    if (
      pos + CENTRAL_FILE_HEADER_SIZE > cd.length ||
      cd.readUInt32LE(pos) !== SIG_CENTRAL_FILE_HEADER
    ) {
      throw new Error(`broken zip: central file header #${i} not found`);
    }
    const nameLen = cd.readUInt16LE(pos + 28);
    const extraLen = cd.readUInt16LE(pos + 30);
    const commentLen = cd.readUInt16LE(pos + 32);
    const nameStart = pos + CENTRAL_FILE_HEADER_SIZE;
    const extraStart = nameStart + nameLen;

    const sizes = applyZip64Extra(
      cd.subarray(extraStart, extraStart + extraLen),
      {
        compressedSize: cd.readUInt32LE(pos + 20),
        uncompressedSize: cd.readUInt32LE(pos + 24),
        localHeaderOffset: cd.readUInt32LE(pos + 42),
      }
    );

    entries.push({
      name: cd.subarray(nameStart, extraStart).toString('utf8'),
      method: cd.readUInt16LE(pos + 10),
      flags: cd.readUInt16LE(pos + 8),
      crc32: cd.readUInt32LE(pos + 16),
      ...sizes,
    });
    pos = extraStart + extraLen + commentLen;
  }
  return entries;
};

// データ本体の開始位置を求める。ローカルヘッダの拡張フィールド長は目録側と一致するとは限らないため、
// ローカルヘッダの固定部(30バイト)を読んで計算する
export const resolveDataOffset = async (
  readRange: ReadRange,
  entry: ZipEntry
): Promise<number> => {
  if (entry.flags & FLAG_ENCRYPTED) {
    throw new Error(`encrypted entry is not supported: ${entry.name}`);
  }
  const header = await readRange(
    entry.localHeaderOffset,
    entry.localHeaderOffset + LOCAL_FILE_HEADER_SIZE
  );
  if (header.readUInt32LE(0) !== SIG_LOCAL_FILE_HEADER) {
    throw new Error(`broken zip: local file header not found: ${entry.name}`);
  }
  const nameLen = header.readUInt16LE(26);
  const extraLen = header.readUInt16LE(28);
  return entry.localHeaderOffset + LOCAL_FILE_HEADER_SIZE + nameLen + extraLen;
};
呼び出し側(extract-zip.ts)。目録の圧縮方式を見て、ファイルごとに方式を選びます。extractByStreaming と extractByCopy は、それぞれ方式1・方式2の章に載せています。
import {
  GetObjectCommand,
  HeadObjectCommand,
  type S3Client,
} from '@aws-sdk/client-s3';
import {
  METHOD_STORED,
  type ReadRange,
  readCentralDirectory,
  resolveDataOffset,
  type ZipEntry,
} from './central-directory.ts';
import { extractByCopy } from './copy-extract.ts';
import { extractByStreaming } from './stream-extract.ts';

const MiB = 1024 * 1024;
// どちらも今回の計測で使った値
const COPY_OPTIONS = { partSize: 64 * MiB, concurrency: 48 };
const STREAM_OPTIONS = { partSize: 32 * MiB, concurrency: 8, windowSize: 64 * MiB };

/** 1ファイルを展開するための入力 */
export type ExtractInput = {
  /** S3クライアント */
  client: S3Client;
  /** バケット名(ZIPと展開先で共通) */
  bucket: string;
  /** ZIPのキー */
  zipKey: string;
  /** 目録から得たファイルの情報 */
  entry: ZipEntry;
  /** データ本体の開始位置 */
  dataOffset: number;
  /** 展開先のキー */
  destKey: string;
};

// 目録やローカルヘッダのような小さな範囲を、Range GETで丸ごと読む
const createS3ReadRange = (
  client: S3Client,
  bucket: string,
  key: string
): ReadRange => {
  return async (start, end) => {
    const res = await client.send(
      new GetObjectCommand({
        Bucket: bucket,
        Key: key,
        Range: `bytes=${start}-${end - 1}`,
      })
    );
    if (!res.Body) {
      throw new Error(`empty body: s3://${bucket}/${key}`);
    }
    return Buffer.from(await res.Body.transformToByteArray());
  };
};

export const extractZip = async (
  client: S3Client,
  bucket: string,
  zipKey: string,
  destPrefix: string
): Promise<void> => {
  const head = await client.send(
    new HeadObjectCommand({ Bucket: bucket, Key: zipKey })
  );
  const readRange = createS3ReadRange(client, bucket, zipKey);
  // 名前が `/` で終わるのはディレクトリのエントリなので飛ばす
  const entries = (
    await readCentralDirectory(readRange, head.ContentLength ?? 0)
  ).filter((e) => !e.name.endsWith('/'));

  for (const entry of entries) {
    const input: ExtractInput = {
      client,
      bucket,
      zipKey,
      entry,
      dataOffset: await resolveDataOffset(readRange, entry),
      destKey: `${destPrefix}${entry.name}`,
    };
    if (entry.method === METHOD_STORED) {
      await extractByCopy(input, COPY_OPTIONS);
    } else {
      await extractByStreaming(input, STREAM_OPTIONS);
    }
  }
};
目録を自分で読むときに引っかかった点が3つあります。
ZIP64への対応は必須
4GiBを超えるファイルを含むZIPや、全体が4GiBを超えるZIPはZIP64形式になります。目録のサイズ欄やヘッダ位置の欄が上限値(0xFFFFFFFF)になり、実際の値は拡張フィールドに入ります。終端レコードもZIP64用のものが別に付くので、そちらから目録の位置を読み直します。
データの開始位置は目録だけでは決まらない
目録に書かれているのは、ローカルファイルヘッダ(各ファイルの中身の直前に付くヘッダ)の位置です。そこからデータ本体までの距離は、ローカルヘッダ側のファイル名と拡張フィールドの長さで決まります。しかも拡張フィールドの長さは、目録側と一致するとは限りません。ローカルヘッダの固定部(30バイト)を読んで、そこに書かれた長さから計算します。
日本語ファイル名のフラグ
ZIPには「ファイル名がUTF-8である」ことを示すフラグがあります。macOSの zip コマンドで日本語名のファイルを固めたところ、このフラグが立っていないのにUTF-8で格納されていました。作成環境によってはShift_JISのこともあります。展開先のS3キーは目録のファイル名から作るので、読み違えるとキー名が文字化けします。
今回の実装はUTF-8で決め打ちにしています。Shift_JISのZIPが来るなら、文字コードの判定と変換が別に要ります。
方式1: DEFLATEをストリーミング展開する
圧縮されているZIPは、展開の計算が要るのでデータがLambdaを通ります。ただ、すべてを溜めてから処理する必要はありません。
-
目録から、ファイルのデータ範囲を得る
-
その範囲をRange GETで少しずつ読む
-
届いた分から順に展開(inflate)する
-
展開できた分から順に、マルチパートアップロードで送る
Node.jsなら、2〜4をパイプでつなぐだけです。
const source = Readable.from(
  streamS3Range(client, bucket, zipKey, dataOffset, dataOffset + entry.compressedSize, {
    windowSize: 64 * MiB,
    maxRetries: 3,
  })
);

const sink = async (chunks: AsyncIterable<Buffer>) => {
  for await (const chunk of chunks) {
    await writer.write(chunk); // マルチパートアップロード(送信キューが詰まっていれば待つ)
  }
};

await pipeline(source, createInflateRaw(), sink);
メモリに載るのは、送信中のパートと組み立て中の1パートだけ。32MiB × 8並列で、最大RSSは339〜402MiBでした。仕組み上、ファイルが10GiBでも30GiBでも変わりません。
実装で気をつけたのは次の2点です。
- 送信が詰まったら読み込みも止める。止めないと読み込みだけ先行して、メモリを食い潰します。上のコードでは、
writer.write()が送信キューの空きを待つことで止めています - Range GETは64MiBずつに分けて、前の範囲を読み終えてから次を開く。開いたレスポンスを読まずに待たせると、接続が切られるためです。途中で切れたときは、読み終えた位置から読み直します
ストリーミング展開のコード(TypeScript)
範囲読み(range-stream.ts)
import type { Readable } from 'node:stream';
import { GetObjectCommand, type S3Client } from '@aws-sdk/client-s3';

// 範囲を windowSize ごとのRange GETに分け、前の範囲を読み終えてから次を開く。
// 先に開いたレスポンスを読まずに待たせると、接続が切られるため
export const streamS3Range = async function* (
  client: S3Client,
  bucket: string,
  key: string,
  start: number,
  end: number,
  options: { windowSize: number; maxRetries: number }
): AsyncGenerator<Buffer> {
  const { windowSize, maxRetries } = options;
  let position = start;
  let consecutiveFailures = 0;

  while (position < end) {
    const windowEnd = Math.min(position + windowSize, end);
    const res = await client.send(
      new GetObjectCommand({
        Bucket: bucket,
        Key: key,
        Range: `bytes=${position}-${windowEnd - 1}`,
      })
    );
    const body = res.Body as Readable | undefined;
    if (!body) {
      throw new Error(`empty body: s3://${bucket}/${key}`);
    }

    let interruption: unknown;
    try {
      for await (const chunk of body) {
        const buf = chunk as Buffer;
        position += buf.length;
        consecutiveFailures = 0;
        yield buf;
      }
      if (position < windowEnd) {
        interruption = new Error(`short read at ${position}`);
      }
    } catch (error) {
      interruption = error;
    } finally {
      body.destroy();
    }

    // 途中で切れたら、読み終えた位置(position)から読み直す
    if (interruption === undefined) {
      continue;
    }
    consecutiveFailures++;
    if (consecutiveFailures > maxRetries) {
      throw interruption;
    }
  }
};
マルチパートアップロードのライタ(multipart-writer.ts)。crc32ToBase64 は後半の「展開結果をS3に検証させる」に載せています。
import { crc32 } from 'node:zlib';
import {
  AbortMultipartUploadCommand,
  type CompletedPart,
  CompleteMultipartUploadCommand,
  CreateMultipartUploadCommand,
  PutObjectCommand,
  type S3Client,
  UploadPartCommand,
} from '@aws-sdk/client-s3';
import { crc32ToBase64 } from './checksum.ts';

/** 順に届くデータをS3へ書き込むライタ */
export type MultipartWriter = {
  /** データを書き込む。送信待ちのパートが上限に達していれば、空くまで待つ */
  write: (chunk: Buffer) => Promise<void>;
  /** 残りを送ってアップロードを完了する。書き込んだバイト数とCRC-32を返す */
  complete: () => Promise<{ bytes: number; crc32: number }>;
  /** 途中まで送ったパートを破棄する */
  abort: () => Promise<void>;
};

// メモリ使用量は最大で partSize × (concurrency + 1)。ファイルサイズには比例しない。
// 1パートに満たない小さなデータはPutObjectで送る
export const createMultipartWriter = (
  client: S3Client,
  bucket: string,
  key: string,
  options: { partSize: number; concurrency: number }
): MultipartWriter => {
  const { partSize, concurrency } = options;
  let uploadId: string | undefined;
  let buffer = Buffer.allocUnsafe(partSize);
  let filled = 0;
  let partNumber = 0;
  let bytes = 0;
  let totalCrc = 0;
  const completedParts: CompletedPart[] = [];
  const inFlight = new Set<Promise<void>>();
  let failure: unknown;

  // 1パートを送信キューに入れ、キューが上限に達していれば1つ空くまで待つ(ここで背圧がかかる)
  const dispatch = async (body: Buffer): Promise<void> => {
    if (!uploadId) {
      const created = await client.send(
        new CreateMultipartUploadCommand({
          Bucket: bucket,
          Key: key,
          ChecksumAlgorithm: 'CRC32',
          ChecksumType: 'FULL_OBJECT',
        })
      );
      uploadId = created.UploadId;
    }
    const currentPart = ++partNumber;
    const task: Promise<void> = client
      .send(
        new UploadPartCommand({
          Bucket: bucket,
          Key: key,
          UploadId: uploadId,
          PartNumber: currentPart,
          Body: body,
          ChecksumCRC32: crc32ToBase64(crc32(body)),
        })
      )
      .then((res) => {
        completedParts.push({
          PartNumber: currentPart,
          ETag: res.ETag,
          ChecksumCRC32: res.ChecksumCRC32,
        });
      })
      .catch((error: unknown) => {
        failure ??= error;
      })
      .finally(() => {
        inFlight.delete(task);
      });
    inFlight.add(task);

    if (inFlight.size >= concurrency) {
      await Promise.race(inFlight);
    }
    if (failure) {
      throw failure;
    }
  };

  const write = async (chunk: Buffer): Promise<void> => {
    totalCrc = crc32(chunk, totalCrc);
    bytes += chunk.length;
    let offset = 0;
    while (offset < chunk.length) {
      const copied = chunk.copy(buffer, filled, offset);
      filled += copied;
      offset += copied;
      if (filled === partSize) {
        const full = buffer;
        buffer = Buffer.allocUnsafe(partSize);
        filled = 0;
        await dispatch(full);
      }
    }
  };

  const complete = async (): Promise<{ bytes: number; crc32: number }> => {
    const expected = crc32ToBase64(totalCrc);

    if (partNumber === 0) {
      await client.send(
        new PutObjectCommand({
          Bucket: bucket,
          Key: key,
          Body: buffer.subarray(0, filled),
          ChecksumCRC32: expected,
        })
      );
      return { bytes, crc32: totalCrc };
    }

    if (filled > 0) {
      await dispatch(buffer.subarray(0, filled));
    }
    await Promise.all(inFlight);
    if (failure) {
      throw failure;
    }

    completedParts.sort((a, b) => (a.PartNumber ?? 0) - (b.PartNumber ?? 0));
    await client.send(
      new CompleteMultipartUploadCommand({
        Bucket: bucket,
        Key: key,
        UploadId: uploadId,
        MultipartUpload: { Parts: completedParts },
        ChecksumType: 'FULL_OBJECT',
        ChecksumCRC32: expected,
      })
    );
    return { bytes, crc32: totalCrc };
  };

  const abort = async (): Promise<void> => {
    await Promise.allSettled(inFlight);
    if (!uploadId) {
      return;
    }
    await client.send(
      new AbortMultipartUploadCommand({
        Bucket: bucket,
        Key: key,
        UploadId: uploadId,
      })
    );
  };

  return { write, complete, abort };
};
1ファイルの展開(stream-extract.ts)
import { Readable } from 'node:stream';
import { pipeline } from 'node:stream/promises';
import { createInflateRaw } from 'node:zlib';
import { METHOD_DEFLATE, METHOD_STORED } from './central-directory.ts';
import type { ExtractInput } from './extract-zip.ts';
import { createMultipartWriter } from './multipart-writer.ts';
import { streamS3Range } from './range-stream.ts';

const MAX_RANGE_RETRIES = 3;

export const extractByStreaming = async (
  input: ExtractInput,
  options: { partSize: number; concurrency: number; windowSize: number }
): Promise<void> => {
  const { client, bucket, zipKey, entry, dataOffset, destKey } = input;
  if (entry.method !== METHOD_DEFLATE && entry.method !== METHOD_STORED) {
    throw new Error(`unsupported method ${entry.method}: ${entry.name}`);
  }

  const writer = createMultipartWriter(client, bucket, destKey, options);
  const source = Readable.from(
    streamS3Range(
      client,
      bucket,
      zipKey,
      dataOffset,
      dataOffset + entry.compressedSize,
      { windowSize: options.windowSize, maxRetries: MAX_RANGE_RETRIES }
    )
  );

  // ライタの送信キューが詰まっている間は、次を読まない
  const sink = async (chunks: AsyncIterable<Buffer>): Promise<void> => {
    for await (const chunk of chunks) {
      await writer.write(chunk);
    }
  };

  try {
    if (entry.method === METHOD_DEFLATE) {
      await pipeline(source, createInflateRaw(), sink);
    } else {
      await pipeline(source, sink);
    }
    const written = await writer.complete();

    // S3側の検証に加えて、Lambda側でも目録の値と照合する
    if (written.bytes !== entry.uncompressedSize) {
      throw new Error(
        `size mismatch: ${entry.name} expected ${entry.uncompressedSize}, got ${written.bytes}`
      );
    }
    if (written.crc32 !== entry.crc32) {
      throw new Error(`crc32 mismatch: ${entry.name}`);
    }
  } catch (error) {
    await writer.abort().catch(() => undefined);
    throw error;
  }
};
速度はS3への書き込みで頭打ちになる
3008MB以上で約70MiB/sから伸びなかったので、どこが詰まっているのかを切り分けました。
| 変えたこと | 速度 |
|---|---|
| 変えない(パート32MiB × 8並列) | 70MiB/s |
| アップロードをパート128MiB × 16並列に | 69MiB/s |
| 読み込みで4範囲を同時に先読み | 69MiB/s |
| 読み込みで8範囲を同時に先読み | 68MiB/s |
| VPC内(S3 Gateway Endpoint経由)で実行 | 70MiB/s |
| STOREDのZIPで、展開の計算を抜く | 70MiB/s |
| 展開せず、乱数をS3へ書き込むだけ | 71MiB/s |
どれを変えても70MiB/s前後。展開の計算を抜いても、書き込むだけでも変わらないので、1つの実行環境からS3への書き込みが約70MiB/s(約590Mbps)で頭打ちになっているとみています。
先読みを増やすと、速くならないまま最大RSSだけが1,610MiB(4範囲)から2,514MiB(8範囲)に増えました。読み込みのほうが速く進み、データがメモリに溜まっていました。なので、先読みはしない実装にしています。
方式2: STOREDはS3の中だけでコピーする
無圧縮(STORED)のZIPは、中身が元ファイルのバイト列そのままなので、展開に計算が要りません。
S3には、既存オブジェクトの一部の範囲をコピーして、新しいオブジェクトのパートにするAPI(UploadPartCopy の CopySourceRange)があります。Lambdaがやるのは「ZIPのここからここまでをコピーして」と指示するだけ。実際の転送はS3の中で行われ、データはLambdaを通りません。
await client.send(
  new UploadPartCopyCommand({
    Bucket: bucket,
    Key: destKey,
    UploadId: uploadId,
    PartNumber: index + 1,
    // パス区切りの `/` は残してエンコードする
    CopySource: `${bucket}/${zipKey.split('/').map(encodeURIComponent).join('/')}`,
    CopySourceRange: `bytes=${dataOffset + start}-${dataOffset + end - 1}`,
  })
);
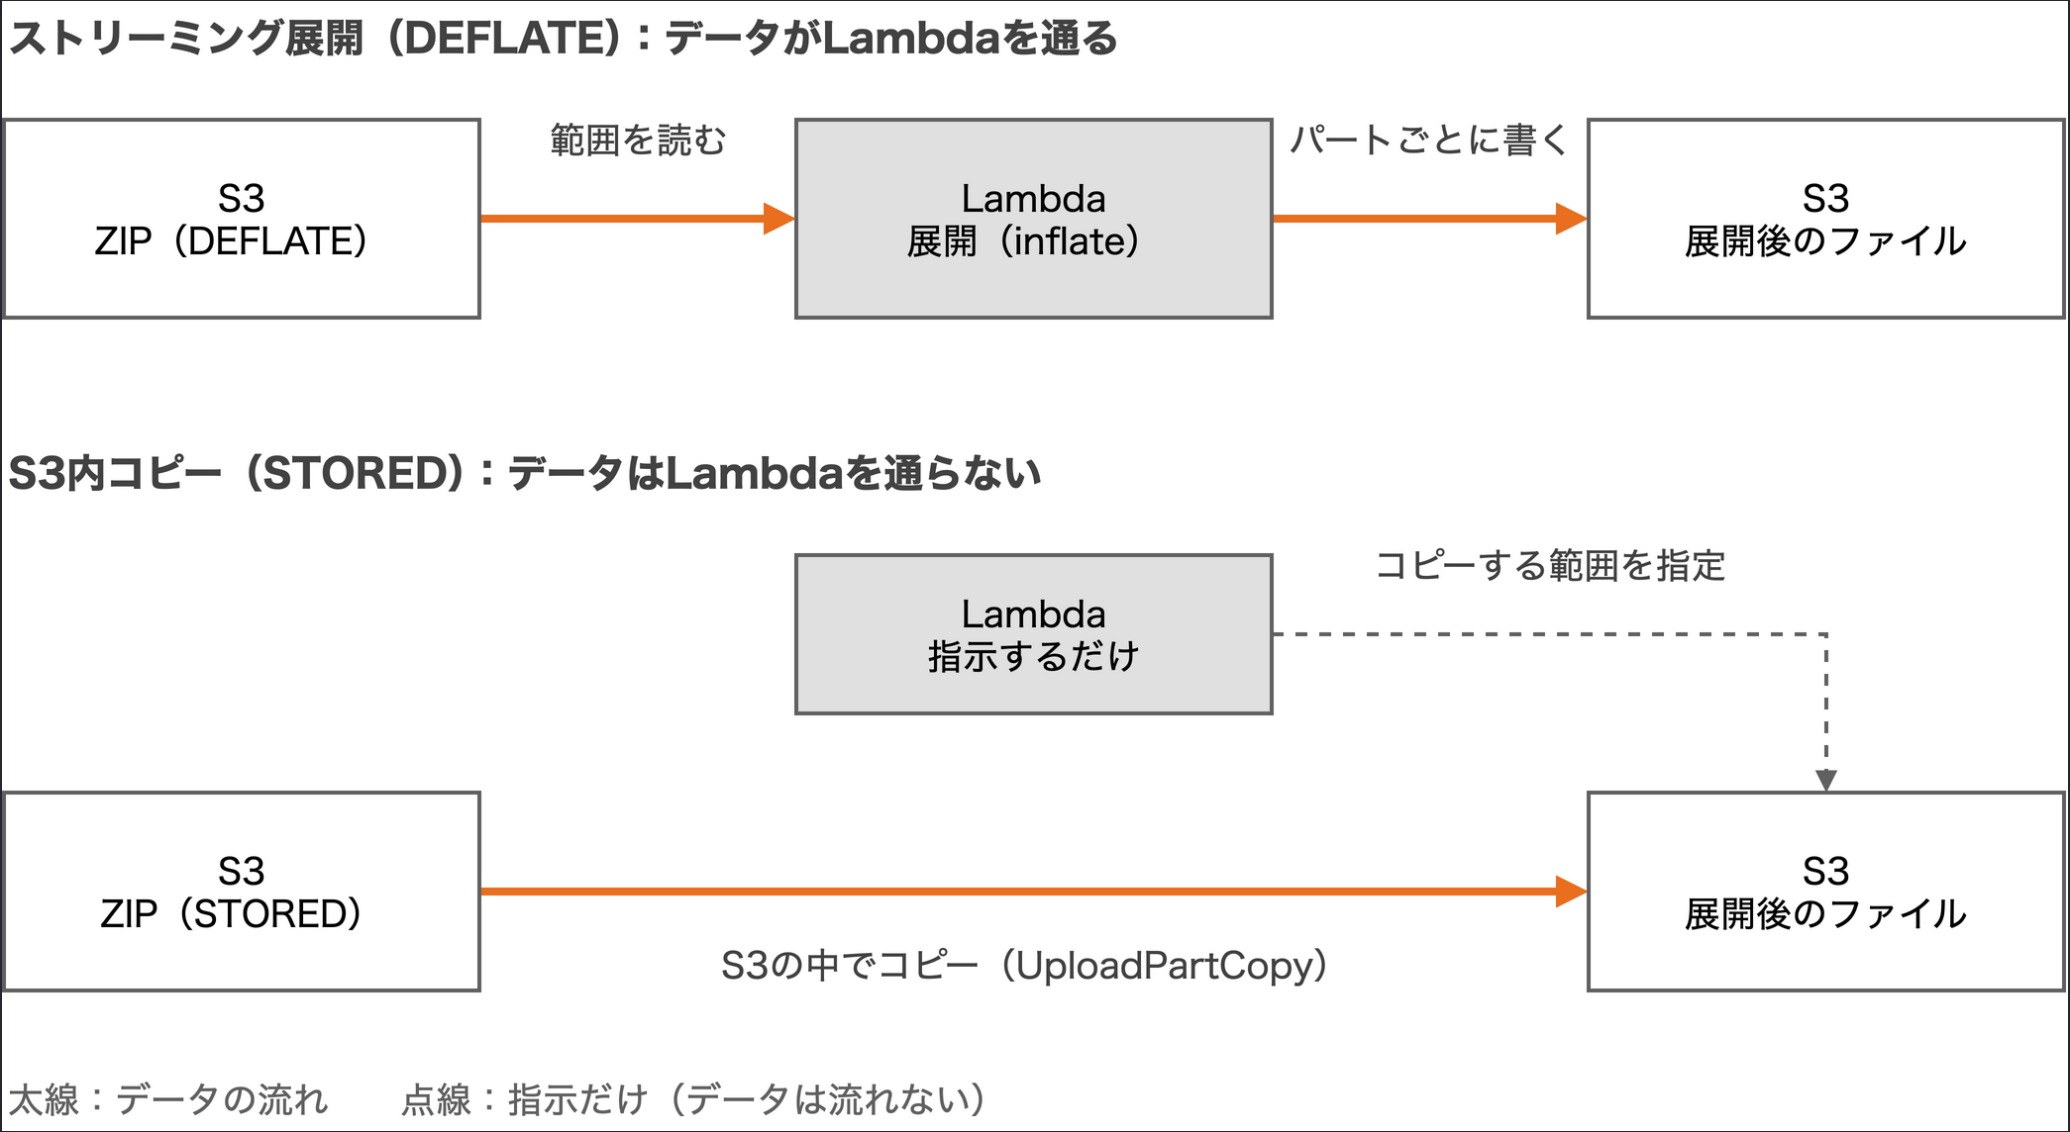
パートには通常のマルチパートアップロードと同じ制約があります。最後以外は5MiB以上、5GiB以下で、パート数は10,000まで。小さいファイルは1パートでコピーします。
S3内コピーのコード(TypeScript)
1ファイルのコピー(copy-extract.ts)
import {
  AbortMultipartUploadCommand,
  CompleteMultipartUploadCommand,
  CreateMultipartUploadCommand,
  PutObjectCommand,
  UploadPartCopyCommand,
} from '@aws-sdk/client-s3';
import { crc32ToBase64 } from './checksum.ts';
import { METHOD_STORED } from './central-directory.ts';
import type { ExtractInput } from './extract-zip.ts';

const MiB = 1024 * 1024;
/** UploadPartCopyのパートサイズの下限(最後のパートを除く) */
const MIN_PART_SIZE = 5 * MiB;
/** UploadPartCopyのパートサイズの上限 */
const MAX_PART_SIZE = 5 * 1024 * MiB;
/** マルチパートアップロードのパート数の上限 */
const MAX_PARTS = 10_000;

// 同時実行数を制限しながら、各要素に非同期処理を適用する(結果は入力と同じ順)
const mapWithConcurrency = async <T, R>(
  items: readonly T[],
  limit: number,
  fn: (item: T, index: number) => Promise<R>
): Promise<R[]> => {
  const results = new Array<R>(items.length);
  let next = 0;

  const worker = async (): Promise<void> => {
    while (next < items.length) {
      const index = next++;
      results[index] = await fn(items[index] as T, index);
    }
  };

  await Promise.all(
    Array.from({ length: Math.min(limit, items.length) }, () => worker())
  );
  return results;
};

// コピー元のキーは、パス区切りの `/` を残してURLエンコードする
const toCopySource = (bucket: string, key: string): string => {
  return `${bucket}/${key.split('/').map(encodeURIComponent).join('/')}`;
};

export const extractByCopy = async (
  input: ExtractInput,
  options: { partSize: number; concurrency: number }
): Promise<void> => {
  const { client, bucket, zipKey, entry, dataOffset, destKey } = input;
  const { partSize, concurrency } = options;
  if (entry.method !== METHOD_STORED) {
    throw new Error(`copy strategy requires STORED: ${entry.name}`);
  }
  if (partSize < MIN_PART_SIZE || partSize > MAX_PART_SIZE) {
    throw new Error(`partSize must be between 5MiB and 5GiB: ${partSize}`);
  }

  const size = entry.compressedSize;
  const expectedChecksum = crc32ToBase64(entry.crc32);

  // 空ファイルはパートを作れないので、空のオブジェクトを置く
  if (size === 0) {
    await client.send(
      new PutObjectCommand({
        Bucket: bucket,
        Key: destKey,
        Body: Buffer.alloc(0),
        ChecksumCRC32: expectedChecksum,
      })
    );
    return;
  }

  const ranges: Array<{ start: number; end: number }> = [];
  for (let start = 0; start < size; start += partSize) {
    ranges.push({ start, end: Math.min(start + partSize, size) });
  }
  if (ranges.length > MAX_PARTS) {
    throw new Error(`too many parts: ${ranges.length}`);
  }

  const created = await client.send(
    new CreateMultipartUploadCommand({
      Bucket: bucket,
      Key: destKey,
      ChecksumAlgorithm: 'CRC32',
      ChecksumType: 'FULL_OBJECT',
    })
  );
  const uploadId = created.UploadId;

  try {
    const parts = await mapWithConcurrency(
      ranges,
      concurrency,
      async ({ start, end }, index) => {
        const res = await client.send(
          new UploadPartCopyCommand({
            Bucket: bucket,
            Key: destKey,
            UploadId: uploadId,
            PartNumber: index + 1,
            CopySource: toCopySource(bucket, zipKey),
            CopySourceRange: `bytes=${dataOffset + start}-${dataOffset + end - 1}`,
          })
        );
        return {
          PartNumber: index + 1,
          ETag: res.CopyPartResult?.ETag,
          ChecksumCRC32: res.CopyPartResult?.ChecksumCRC32,
        };
      }
    );

    // 目録のCRC-32を全体のチェックサムとして渡し、S3側でコピー結果と照合させる
    await client.send(
      new CompleteMultipartUploadCommand({
        Bucket: bucket,
        Key: destKey,
        UploadId: uploadId,
        MultipartUpload: { Parts: parts },
        ChecksumType: 'FULL_OBJECT',
        ChecksumCRC32: expectedChecksum,
      })
    );
  } catch (error) {
    await client
      .send(
        new AbortMultipartUploadCommand({
          Bucket: bucket,
          Key: destKey,
          UploadId: uploadId,
        })
      )
      .catch(() => undefined);
    throw error;
  }
};
パートを小さく切って並列にするほど速い
10GiBのファイルを、パートサイズと同時コピー数を変えてコピーしました。Lambdaは1024MBで、最大RSSは81〜103MiBです。
| パートサイズ | 同時コピー数 | 所要時間 | 速度 |
|---|---|---|---|
| 5GiB | 2 | 69.4秒 | 147MiB/s |
| 1GiB | 10 | 14.2秒 | 726MiB/s |
| 256MiB | 16 | 9.6秒 | 1,098MiB/s |
| 256MiB | 40 | 8.9秒 | 1,183MiB/s |
| 64MiB | 48 | 4.3秒 | 2,420MiB/s |
1パートあたりのコピー速度は50〜75MiB/s程度なので、パートを小さく切って同時コピー数を増やすほど速くなりました。ただ、256MiBのまま同時コピー数を16から40にしても、9.6秒から8.9秒にしか縮んでいません。64MiB × 48並列が一番速かったので、パートサイズと並列数はセットで決めます。
同時コピー数を48で止めているのは、AWS SDK for JavaScript v3の既定の同時接続数が50だからです。それを超える並列数を指定しても、SDK側で接続待ちになります。並列数を増やしても速くならないときは、ここも確認してみてください。
両方式で共通の実装
展開結果をS3に検証させる
データがLambdaを通らないS3内コピーで、「正しくコピーされたか」を読み戻して確かめると、せっかくの速さが台無し。そこでS3のチェックサム機能を使いました。
ZIPの目録には、各ファイルのCRC-32が入っています。一方、S3のマルチパートアップロードは、オブジェクト全体のCRC32を受け取って検証できます(ChecksumType: FULL_OBJECT)。ZIPのCRC-32とS3のCRC32は同じ多項式(IEEE 802.3)なので、目録の値をBase64(ビッグエンディアン4バイト)に直すだけで渡せます。
// ZIPのCRC-32(数値)を、S3の `ChecksumCRC32` の表記にする(checksum.ts)
export const crc32ToBase64 = (value: number): string => {
  const buf = Buffer.alloc(4);
  buf.writeUInt32BE(value >>> 0);
  return buf.toString('base64');
};

// 開始時に「全体のCRC32で検証する」と宣言しておく
await client.send(
  new CreateMultipartUploadCommand({
    Bucket: bucket,
    Key: destKey,
    ChecksumAlgorithm: 'CRC32',
    ChecksumType: 'FULL_OBJECT',
  })
);

// ...パートを送ったあと、完了時に期待値を渡す

await client.send(
  new CompleteMultipartUploadCommand({
    // ...
    ChecksumType: 'FULL_OBJECT',
    ChecksumCRC32: crc32ToBase64(entry.crc32), // ZIPの目録に書かれていた値
  })
);
わざと違う値を渡して試すと、こうなりました。
BadDigest: The crc32 you specified did not match the calculated checksum.
オブジェクトも作られませんでした。データを一度も読まずに、展開結果の正しさをS3側に保証させられます。ストリーミング展開でも同じ値を渡していて、こちらはLambda側でもサイズとCRCを照合しています。
FULL_OBJECT は比較的新しいので、Lambdaランタイム同梱のSDKでは扱えません。CDKのバンドル設定で bundleAwsSDK: true にして、package.json でバージョンを固定したSDKを同梱しています。
new lambdaNodejs.NodejsFunction(this, 'Extract', {
  // ...
  bundling: {
    bundleAwsSDK: true,
  },
});
タイムアウトしたときの後始末
失敗したら AbortMultipartUpload でアップロードを取り消すようにしています。ただ、タイムアウトは処理ごと止まるので、これが呼ばれません。アップロード済みのパートは、バケットの一覧に出ないまま保管料金がかかり続けます。
対策として、バケットのライフサイクルルールで、1日経っても完了しないアップロードを消すようにしました。
const bucket = new s3.Bucket(this, 'Bucket', {
  // ...
  lifecycleRules: [
    { abortIncompleteMultipartUploadAfter: cdk.Duration.days(1) },
  ],
});
まとめ
Lambdaの /tmp を使わずに、S3上の大きなZIPを展開できました。
- ZIPの中身が無圧縮(STORED)ならS3内コピー。データがLambdaを通らず、10GiBが4.3秒
- 圧縮されている(DEFLATE)ならストリーミング展開。Lambdaは3008MBで、速度は約70MiB/sで頭打ち
- ストリーミング展開は、1回の実行で展開後30GiBあたりまで。超えるならファイル単位でLambdaを分ける
- VPC内ならS3 Gateway Endpoint経由にする
- 展開結果の検証は、ZIPの目録のCRC-32をS3に渡せば任せられる
大きなZIPをLambdaでどう展開するか迷っている方の参考になれば嬉しいです。
おまけ
クラスメソッド名古屋オフィス(伏見駅徒歩5分)で月イチペースで開催している「なごやクラメソゆる勉強会」、第6回を2026年11月4日(水)19:00〜21:00に開催します!
今回のテーマは「Claude Codeで一歩踏み出す:手を動かしてつくってみよう」。前回の基礎・活用事例編に続く実践回で、その場でClaude Codeと対話しながらアプリを作ります。テーマは自由、PCの持ち込みも任意(お持ちでない方はクラスメソッドのメンバーとグループで開発)。定員15名の先着です。名前のとおりゆるめの雰囲気なので、気軽に参加できます!
詳細・申し込みはこちらから!