[AWS Lambda] Web Functions で Bedrock の応答をストリーミングするチャットを、画面ごと Hono で動かしてみました

1 はじめに
製造ビジネステクノロジー部の平内(SIN)です。
2026 年 10 月、AWS Lambda に Web Functions という新しい形態が追加されました。ポートで待ち受ける普通の Node.js の HTTP サーバーを、Lambda 用のアダプターやハンドラーなしで動かせるものです。
新機能、とりあえず使ってみたいということで、Amazon Bedrock と組み合わせた簡単なサンプルを書いてみました。
公式ドキュメントにあった Hono のサンプルをもとに、Bedrock の ConverseStream の応答をそのまま流す処理を加え、画面(HTML)と API を 1 つのアプリにまとめたものです。あわせて、クライアントが切断したときやタイムアウトのときに、Bedrock の呼び出しがどうなるかも確かめてみました。
試してみて分かったことは、以下のとおりです。
- ストリーミングのための設定は何もせずに、Bedrock の応答が少しずつ届きました。私の環境では、最初の文字が届くまで 0.33〜0.49 秒でした
- 画面と API が 1 つのアプリで動きます。Lambda 固有のコードは、待ち受け先を環境変数から読む 1 行だけです
- クライアントが切断したときは、Bedrock の呼び出しも止めるようにしました。タイムアウトで打ち切られたときも、同じ仕組みで止まりました
- Lambda のタイムアウトを超えると、ステータスは 200 のまま本文が途中で切れます。クライアントからは正常に終わったように見えるので注意が必要だと思います
動作確認した環境は以下のとおりです。
| 項目 | バージョン |
|---|---|
| hono / @hono/node-server | 4.13.13 / 2.1.5 |
| @aws-sdk/client-bedrock-runtime | 3.1151.0 |
| aws-cdk-lib | 2.273.0 |
| モデル | jp.anthropic.claude-haiku-4-5-20251001-v1:0 |
| リージョン | ap-northeast-1(東京) |
2 Lambda Web Functions
今回の題材に関係するところだけですが、公式ドキュメントから整理してみました。
| 項目 | 内容 |
|---|---|
| ランタイム | Node.js 24 のみ |
| 実行環境 | Arm64、2 vCPU、メモリ 2 GB(いずれも固定)。1 つの実行環境で複数のリクエストを同時に処理 |
| 待ち受け | 環境変数 AWS_LAMBDA_HTTP_ENDPOINT(host:port)で待ち受ける |
| ストリーミング | 追加の設定なしで対応 |
| コード | コンソールでは Hello World テンプレート / ZIP ファイルのアップロード / Amazon S3 から選べる。CDK(CloudFormation)では S3 の .zip を指定する(Lambda がコードを S3 から直接参照するため、バケットのバージョニングが必須)。起動するファイルは既定で index.js(環境変数 AWS_LAMBDA_NODEJS_ENTRYPOINT で変更可) |
| リソース | Web Function(入れ物)、リビジョン(コードと設定の不変のスナップショット)、エンドポイント(HTTPS の入口) |
| 認証 | エンドポイントごとに、IAM 認証(IamAuth)かアプリケーションマネージド認証(ApplicationManaged)を選ぶ |
| タイムアウト | 1 リクエスト 3〜900 秒、既定 30 秒 |
| 課金 | リクエスト数、実際に使った CPU 時間、実行環境が存在する間のメモリ、データ転送 |
実行環境について、少し補足します。
- 従来の Lambda(Event Functions)はメモリを 128 MB〜10 GB から選び、それに比例して CPU も増えます。Web Functions にはメモリや CPU を選ぶ設定がなく、1 つの実行環境の大きさは固定です
- その代わり、1 つの実行環境が普通の Web サーバーと同じように、複数のリクエストを同時に処理します。同時に処理する数の上限は既定で 64(maxConcurrencyPerEnvironment で 1〜128 に変更可)で、実際の数は Lambda が負荷を見て調整します
- 上限に近づくと Lambda が実行環境を増やし、アクセスがなくなるとゼロまで減らします。実行環境の数の上限は、エンドポイントごとに設定できます(今回は 2 個)
- Node.js のヒープは既定で 1,024 MB です。2 GB の中で、同時に処理するリクエストの分も含めて収める必要があります
リクエストが来て実行環境が起動すると、環境が存在する間は、リクエストの合間のアイドル中もメモリが課金されます。一方、アクセスがなくなると実行環境はゼロまで減り、その後は課金されません。私の環境では、最後のアクセスから約 6〜7 分後に実行環境が停止していました。
3 構成
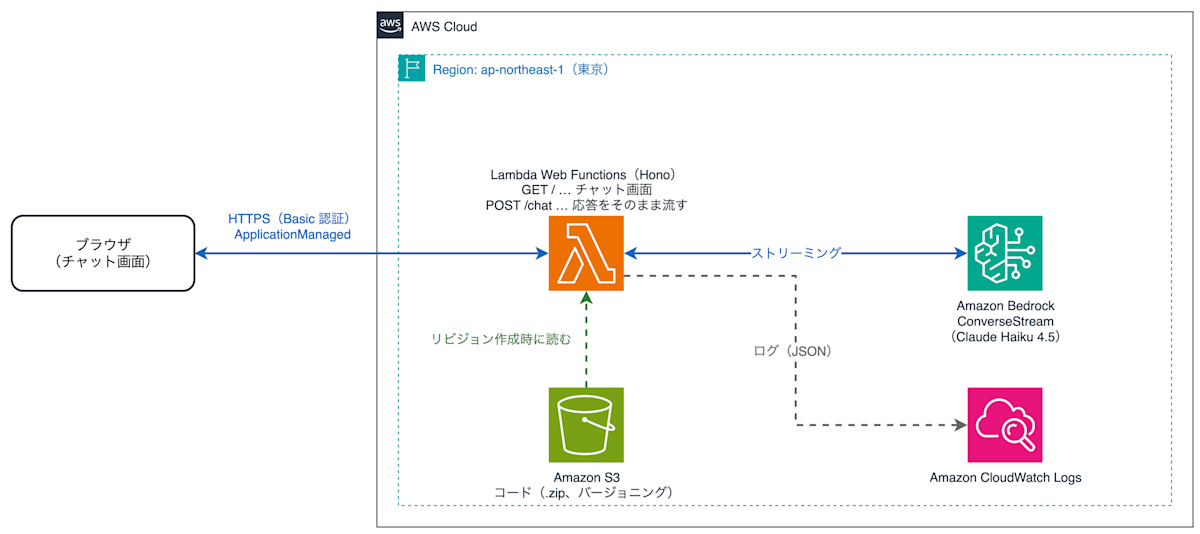
構成はシンプルで、1 つの Hono アプリが 2 つのパスを持っています。
- GET / … チャット画面(index.html)を返す
- POST /chat … Bedrock の ConverseStream の応答を、届いた順にそのまま流す
アプリケーションマネージド認証(ApplicationManaged)では、Lambda は認証をせず、すべてのリクエストをアプリに渡します。そのままでは URL を知っていれば誰でも呼べるので、Bedrock を呼ぶこのアプリでは、Hono の basicAuth で Basic 認証と、エンドポイントの流量制限を入れました。
4 アプリの実装
Github app/src/index.ts / app/src/index.html
(1) 待ち受け
Lambda は、待ち受け先を環境変数 AWS_LAMBDA_HTTP_ENDPOINT で渡してきます。これを読んで、普通に serve するだけです。
// index.ts から抜粋
// Lambda が待ち受け先を AWS_LAMBDA_HTTP_ENDPOINT(host:port)で渡してくる。ローカルでは 3000 番で待ち受ける
const [hostname, port] = (process.env.AWS_LAMBDA_HTTP_ENDPOINT ?? 'localhost:3000').split(':')
serve({ fetch: app.fetch, hostname, port: Number(port) })
私の環境では、ログに listening on 0.0.0.0:3000 と出ていました。Lambda 固有のコードはここだけなので、ローカルでも同じコードがそのまま動きます。
(2) Bedrock の応答をそのまま流す
Hono の streamText を使い、ConverseStream から文字の断片(delta)が届くたびに書き出します。
// index.ts から抜粋
app.post('/chat', async (c) => {
  const { messages } = await c.req.json<{ messages: Message[] }>()

  return streamText(c, async (stream) => {
    // クライアントが切断したら、Bedrock の呼び出しも止める
    const ac = new AbortController()
    stream.onAbort(() => ac.abort())

    const res = await bedrock.send(new ConverseStreamCommand({ modelId: MODEL_ID, messages }), { abortSignal: ac.signal })
    for await (const event of res.stream ?? []) {
      // 文字の断片(delta)が届いたら、すぐに書き出す
      const text = event.contentBlockDelta?.delta?.text
      if (text) await stream.write(text)
    }
  })
})
ポイントは、stream.onAbort で AbortController を止め、その signal を bedrock.send に渡していることです。
公式ドキュメントの SSE のサンプルにも、クライアントが切断したら処理を止める書き方が載っています。Bedrock の場合、これを入れないと、誰も読まない回答の生成が最後まで続き、その分のトークンも消費される可能性があります。
なお、検証のために終了時に「中断されたか」「かかった時間」「出力トークン数」をログに出しています。
(3) チャット画面
画面は index.html として別ファイルにし、起動時に 1 回だけ読み込んで、GET / で返しているだけです。
// index.ts から抜粋
const HTML = readFileSync(path.join(__dirname, 'index.html'), 'utf8')
app.get('/', (c) => c.html(HTML))
応答は fetch の body を少しずつ読み、届いた分から画面に足していきます。
モデルの回答は Markdown で返ってくるので、marked で HTML にしてから表示しています。モデルの出力をそのまま HTML として表示すると、不正なスクリプトが混ざる危険があるため、DOMPurify で無害化しています。どちらも CDN から読み込んでいます。script タグには integrity 属性(SRI)を付け、CDN のファイルが改ざんされていた場合はブラウザが実行しないようにしています。
// index.html の <script> から抜粋
const res = await fetch('/chat', { method: 'POST', headers: { 'content-type': 'application/json' }, body: JSON.stringify({ messages }) })
const reader = res.body.getReader()
const decoder = new TextDecoder()
let text = ''
for (;;) {
  const { done, value } = await reader.read()
  if (done) break
  text += decoder.decode(value, { stream: true })
  // 届くたびに、それまでの全文を Markdown として描画し直す
  div.innerHTML = DOMPurify.sanitize(marked.parse(text))
}
届くたびに全文を描画し直しているので、回答の途中でも見出しや箇条書きが整った形で表示されます。
なお、最初は文字をそのまま表示していたため、見出しの ## や太字の記号が画面に出ていました。チャットの画面として使うなら、Markdown の描画は入れておいたほうが良いと思います。
会話の履歴はブラウザ側で持ち、毎回まとめて送っています。サーバーは状態を持たないので、実行環境が増えても、どの実行環境で処理されても問題ありません。
(4) Basic 認証
Hono の basicAuth ミドルウェアを 1 行入れています。
// index.ts から抜粋
// エンドポイントは ApplicationManaged(アプリ側で認証)なので、誰でも届く。Basic 認証で守る
app.use('*', basicAuth({ username: process.env.BASIC_USER ?? 'user', password: process.env.BASIC_PASSWORD ?? 'pass' }))
パスワードは、デプロイ時に指定した値をリビジョンの環境変数で渡しています(5 章)。環境変数がないローカルでは、user / pass になります。検証用の最小限の守りとして捉えてください。
(5) ビルド
esbuild で、依存パッケージごと dist/index.js の 1 ファイルにまとめ、index.html を dist にコピーします。Web Functions は .zip の直下にある index.js を読み込んで起動します。index.html は、index.js と同じ場所から読み込みます。
$ pnpm -C app build
# => dist/index.js  1.3mb
# => dist/index.html
なお、ローカルで動かしたときに Region is missing というエラーになりました。AWS SDK for JavaScript v3 は AWS_DEFAULT_REGION を見ないためで、AWS_REGION を指定して起動します。Web Functions 上では AWS_REGION が設定されているので、指定は不要でした。
$ AWS_REGION=ap-northeast-1 pnpm -C app dev
5 CDK
Github cdk/lib/stack.ts
Web Functions の L2 コンストラクトがまだ無いようなので、L1(CfnWebFunction / CfnWebFunctionRevision / CfnWebFunctionEndpoint)で組みました。これらは aws-cdk-lib 2.273.0 から入っています。
(1) コードを置く S3 バケット
Web Functions はコードを S3 の .zip から読みます。バケットはバージョニングが必須です。Lambda はリビジョンを作った時点のオブジェクトバージョンを参照し続けるので、使っているバージョンを消すとリビジョンが動かなくなります。BucketDeployment に extract: false を指定して、app/dist(index.js と index.html)を .zip のまま置きます。
// stack.ts から抜粋
const code = new s3deploy.BucketDeployment(this, 'Code', {
  sources: [s3deploy.Source.asset(path.join(__dirname, '../../app/dist'))],
  destinationBucket: bucket,
  extract: false, // 展開せず .zip のまま置く
})
加えて、バケットポリシーで Lambda のサービス(lambda.amazonaws.com)に s3:GetObject と s3:GetObjectVersion を許可します。条件の aws:SourceArn は、この Web Function のリビジョン(revision/*)に絞りました。
(2) リビジョン
// stack.ts から抜粋
const revision = new lambda.CfnWebFunctionRevision(this, 'Revision', {
  functionName: fn.ref,
  buildConfig: {
    runtimeConfig: { runtime: 'nodejs24.x' },
    codeConfig: { s3Object: { bucket: bucket.bucketName, key: Fn.select(0, code.objectKeys) } },
  },
  serviceConfig: {
    executionRoleArn: role.roleArn,
    // ストリーミングは応答を流し終えるまでが 1 リクエストなので、長めにする(最大 900 秒)
    timeoutSeconds: 120,
    environmentVariables: { MODEL_ID: 'jp.anthropic.claude-haiku-4-5-20251001-v1:0', BASIC_USER: 'user', BASIC_PASSWORD: password },
  },
})
// コードの配置とバケットポリシーが済んでからリビジョンを作る
revision.node.addDependency(code, bucket.policy!)
リビジョンの作成時に、Lambda が S3 の読み取り権限を確認します。そのため、バケットポリシーの後にリビジョンを作るよう依存関係を付けています。
実行ロールには bedrock:InvokeModelWithResponseStream を付けています。jp. で始まる推論プロファイルは国内の別のリージョンのモデルにも振り分けるので、リソースのリージョンはワイルドカードにしました。
(3) エンドポイント
認証の種類、流量の上限、実行環境の数の上限は、エンドポイントで設定します。
// stack.ts から抜粋
const endpoint = new lambda.CfnWebFunctionEndpoint(this, 'Endpoint', {
  functionName: fn.ref,
  endpointName: 'prod',
  endpointType: 'HomeRegion',
  // ブラウザで開くだけでは SigV4 の署名が付かないので、アプリ側で認証する(Basic 認証)
  authType: 'ApplicationManaged',
  revisionWeights: [{ revisionId: revision.attrRevisionId, weight: 100 }],
  // 費用の上限を抑えるため、流量(秒間リクエスト数)と実行環境の数に上限を付ける
  throttleConfig: { rateLimit: 100 },
  scalingConfig: { maxEnvironments: 2 },
})
(4) デプロイ
デプロイは以下のとおりです。
$ cd cdk
$ cdk deploy -c basic_password=<パスワード>
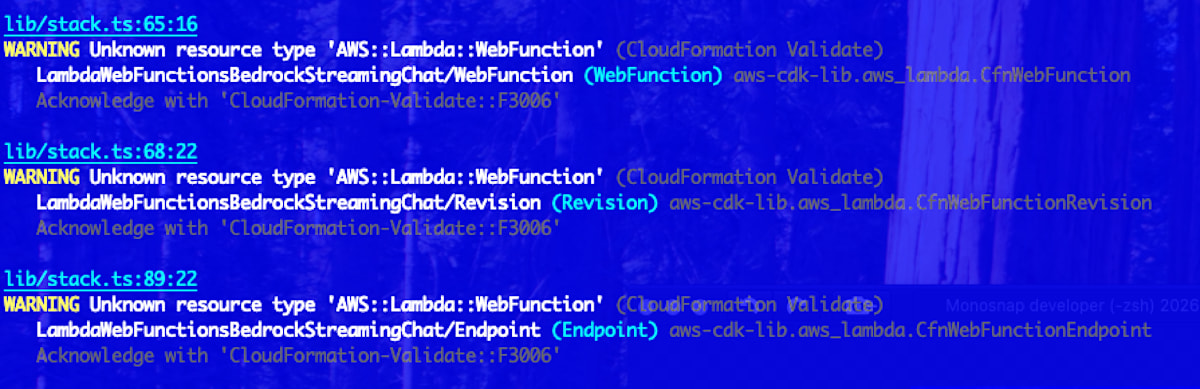
cdk synth のときに Unknown resource type 'AWS::Lambda::WebFunction' という警告が出ていましたが、デプロイ後、正常に利用できました。
6 動作確認
(1) ストリーミング
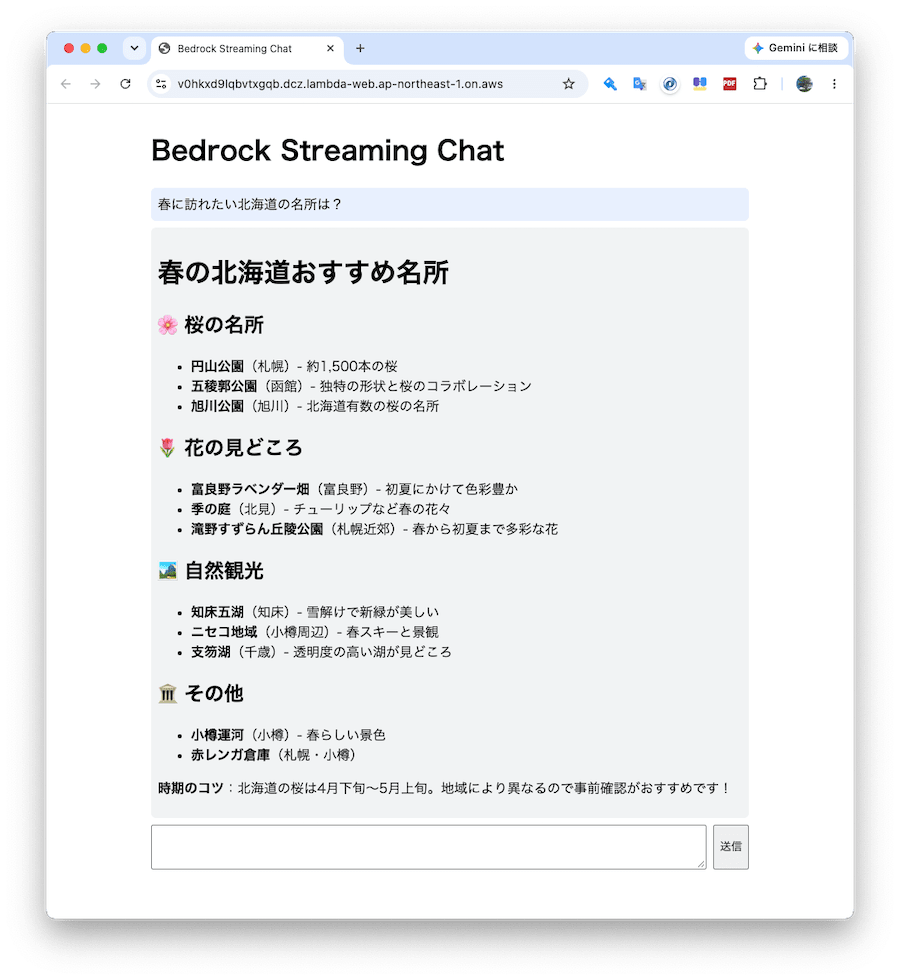
ブラウザで URL を開くと、Basic 認証のあとにチャット画面が表示されます。質問すると、回答が見出しや箇条書きの形に描画されながら、少しずつ表示されました。冒頭の画像の左が回答の流れている途中、右が表示し終わった状態です。
curl でも、応答が少しずつ届くことを確認しました。
$ curl -N -u user:<パスワード> -X POST https://xxxxxxxx.dcz.lambda-web.ap-northeast-1.on.aws/chat \
    -H 'content-type: application/json' \
    -d '{"messages":[{"role":"user","content":[{"text":"春の季語を5つ、1行ずつ挙げて"}]}]}'
| 回 | 最初の断片が届くまで | 断片の数 | 完了まで |
|---|---|---|---|
| 1 回目 | 0.33 秒 | 16 | 0.88 秒 |
| 2 回目 | 0.49 秒 | 12 | 1.00 秒 |
レスポンスヘッダーは Content-Type: text/plain、Transfer-Encoding: chunked でした。
(2) 切断すると Bedrock の呼び出しも止まる
長い回答を頼んで、2 秒でクライアントを切断しました(curl の -m 2)。
$ curl -N -m 2 -u user:<パスワード> -X POST https://xxxxxxxx.dcz.lambda-web.ap-northeast-1.on.aws/chat \
    -H 'content-type: application/json' \
    -d '{"messages":[{"role":"user","content":[{"text":"日本の歴史を3000字で詳しく"}]}]}'
アプリのログは以下のとおりです。
{"aborted":true,"ms":2399,"outputTokens":0}
aborted が true になっており、切断を受けて Bedrock の呼び出しを止めたことが確認できました。
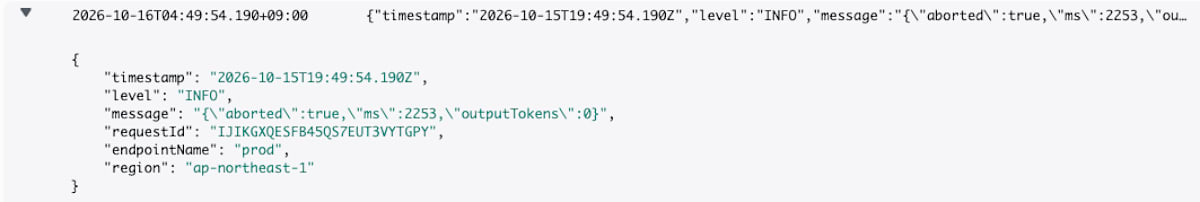
ブラウザで長い回答を表示している途中にタブを閉じた場合も、{"aborted":true,"ms":2253,"outputTokens":0} となり、同じように止まりました。
従来の Lambda のレスポンスストリーミングでは、ドキュメントに次のように書かれており、クライアントが切断しても処理は止まりません。
streamed responses are not interrupted or stopped when the invoking client connection is broken. Customers are billed for the full function duration
Web Functions では切断をアプリで受け取れるので、LLM のように時間とトークンを使う処理を途中で止められます。
(3) タイムアウトを超えたとき
タイムアウトを一時的に 5 秒にしたリビジョンで、長い回答を頼みました。
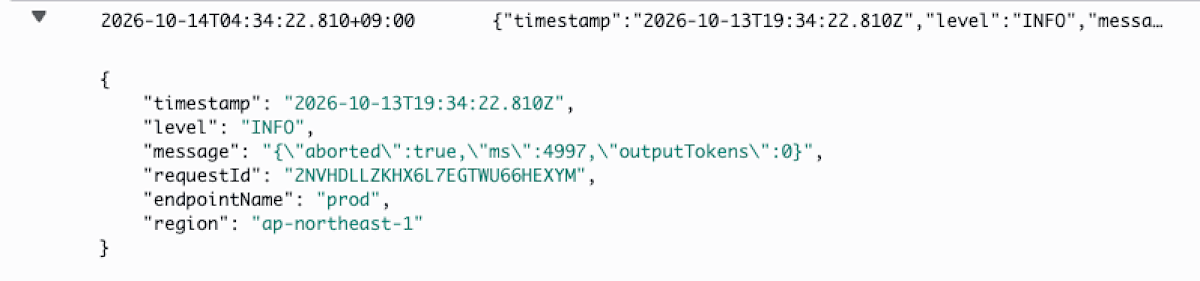
- クライアントは 5.5 秒で HTTP 200 のまま、1,641 バイト(文の途中)で終了しました
- curl の終了コードは 0 で、クライアントからは正常に終わったように見えます
- アプリのログは {"aborted":true,"ms":4997} でした。タイムアウトでも onAbort が呼ばれ、Bedrock の呼び出しが止まりました
ストリーミングでは、ヘッダー(ステータス 200)を先に返してしまうので、タイムアウトをステータスで伝えることができません。既定の 30 秒は、長い回答だと足りなくなる可能性があります。回答の長さに合わせて、余裕を持って明示的に設定するのが良いと思います。今回は 120 秒にしました。
(4) 流量の制限
認証なしの GET を 64 並列で 400 回送りました。
$ seq 1 400 | xargs -P 64 -I{} curl -s -o /dev/null -w "%{http_code}\n" https://xxxxxxxx.dcz.lambda-web.ap-northeast-1.on.aws/ | sort | uniq -c
結果は、401 が 178 件、429 が 209 件、503 が 13 件でした。429 には lambda-web-error-type: Platform.EndpointRequestThrottle というヘッダーが付いていました。
401 で返すリクエストも制限の対象として数えられていました。ドキュメントにも、rateLimit は実行環境に届く前に適用されると書かれており、アプリの認証より手前で制限がかかるようです。なお、503 の理由は今回は確認できていません。ドキュメントには、サービスを守るために 503 を返すことがあり、lambda-web-error-type ヘッダーのない 503 は再試行してよいと書かれています。
(5) ログ
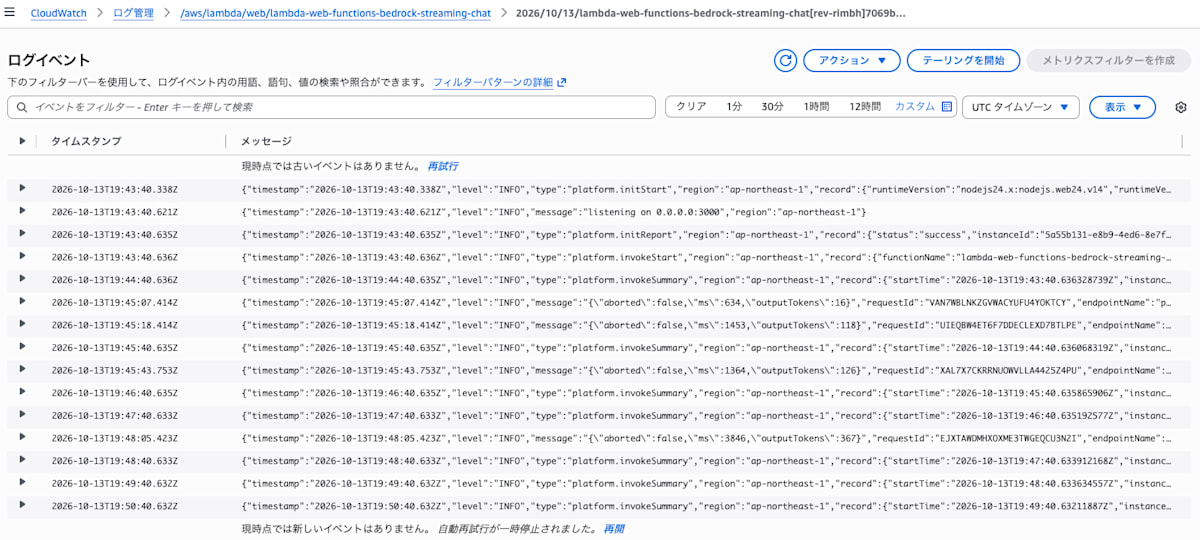
ログは CloudWatch Logs の /aws/lambda/web/(Web Function の名前)に JSON で出力されます。
ちなみに、ロググループは 2 つ作られていました。もう 1 つは、名前の末尾に .local が付いたものです。最初は「なぜ 2 つ?」と思いましたが、ドキュメントによると、Lambda はまずリージョンごとに .local に書き込み、そのあとホームリージョンの本体のロググループに集めているそうです。そのため .local の方が早く出ます。実際、ブラウザを閉じたときの aborted:true も、.local に先に出ていました。動かしながらログを見るなら .local、検索や通知の仕組みを作るなら本体、と使い分けるようです。
| ログ | 内容(私の環境での値) |
|---|---|
| platform.initReport | 初期化 320〜400 ms、メモリ 150 MB 台 |
| platform.invokeSummary | 1 分ごとのリクエスト数、同時リクエスト数、CPU 時間、メモリ |
| アプリの console.log | message に入り、リクエストごとの requestId が付く |
実際のログは以下のとおりです。アプリが出力した aborted などの行と、プラットフォームの行が並んでいます。
実行環境が停止するとき(アクセスがなくなってから数分後など)には、platform.invokeReport が出力されます。
| 実行環境 | 存在した時間 | リクエスト数 | CPU 時間の合計 |
|---|---|---|---|
| 最初のリビジョン | 418.7 秒 | 5 | 1,067 ms |
| タイムアウト 5 秒のリビジョン | 338.7 秒 | 1 | 423 ms |
存在した時間に比べて、CPU を使った時間はごくわずかです。なお、リクエストが 1 件もない 1 分間でも、invokeSummary には CPU 時間が 115 ms 計上されていました。CPU は使った分だけ、メモリは実行環境が存在する間ずっと課金されるので、Bedrock の応答を待つ時間が長いアプリでは、この差を意識しておくと良さそうです。
7 最後に
今回は、新機能の Web Functions で、Bedrock の応答をストリーミングするチャットを動かしてみました。今回の確認作業で分かったことです。
- ストリーミングのための設定は何もせずに、Bedrock の応答を少しずつ返せました。画面と API も 1 つのアプリにまとめられます
- クライアントの切断やタイムアウトに合わせて Bedrock の呼び出しを止めるには、onAbort で AbortController を止め、その signal を渡すだけで済みました
- タイムアウトを超えると、200 のまま本文が途中で切れます。タイムアウトは回答の長さに合わせて明示的に設定する必要があります
社内向けなどの小さな生成 AI のアプリを、画面ごとサーバーレスで用意したい場面のサンプルになれば嬉しいです。
この記事で使用したコードは、以下に置きました。
8 参考リンク
- Announcing AWS Lambda Web Functions
- AWS Lambda Web Functions
- Web Function sample applications
- Request timeout
- Web Function logs in Amazon CloudWatch Logs
- Scaling behavior for Lambda Web Functions
- Lambda Web Function endpoint access control
- Deploying Web Function code from Amazon S3
- AWS::Lambda::WebFunction
- Lambda 関数のレスポンスストリーミング