Amazon MemoryDB のシャードを書き込み中にフェイルオーバーさせ、止まった時間と再試行の結果を確認してみた

はじめに
テクニカルサポートの 片方 です。
MemoryDB は、プライマリノードに障害が起きるとレプリカにフェイルオーバーし、通常は数秒で書き込みを再開できます。では、書き込みを続けているアプリケーションから見ると、何秒止まり、どんなエラーが返り、再試行すれば取りこぼさずに済むのでしょうか。
Valkey のクラスターに、Lambda 関数から平均で毎秒 30 件以上の SET を送り続けながら、failover-shard でフェイルオーバーを起こしました。止まった時間、エラーの種類、再試行の結果を確かめています。
構成
東京リージョンのデフォルト VPC に、次のリソースを AWS CLI で作りました。
| リソース | 内容 |
|---|---|
| MemoryDB クラスター order-counter-cache | Valkey 7.3、db.t4g.small、シャード 1、レプリカ 1、TLS あり、ACL は open-access(検証のための設定) |
| サブネットグループ order-counter-cache-subnets | デフォルト VPC のサブネット |
| セキュリティグループ order-counter-cache-sg | クラスターと Lambda 関数の両方に付ける |
| Lambda 関数 order-counter-writer | Python 3.13、VPC 内、valkey-py 6.2.0 を同梱。タイムアウトは実行時間(約 7 分半)より長くする |
プライマリの 0001-001 が ap-northeast-1a、レプリカの 0001-002 が ap-northeast-1c です。
先に結論から
- 書き込みが止まったのは 17.9 秒でした。返ったエラーは、
TimeoutErrorが 1 回、ClusterDownErrorが 8 回です。途中の接続し直しは、タイムアウト、Error 104(Connection reset by peer)、Connection refused の順に失敗し、5 回目で接続できました。 - 再試行で書き込み直し、15,822 件すべてを欠落なく書き込めました。ただし、止まった分が通ったのは、試行の上限 10 回のうち 10 回目で、余裕はありませんでした。
- イベントでは、フェイルオーバーの開始から完了まで 48 秒かかりました。一方、書き込みは開始から約 20 秒で再開しました。
- 接続し直しに再試行を入れていなかった最初の Lambda 関数は、フェイルオーバーの後、接続し直しの 1 回目の失敗でエラーになって終わりました。書き込みだけでなく、接続し直しにも再試行が必要です。
やってみた
次の順に進めました。
- クラスターと Lambda 関数を作る
- フェイルオーバーを起こす(最初の関数はエラーで終わった)
- 接続し直しにも再試行を入れて、もう一度試す
- イベントで進み方を見る
- 書き込み側の結果を見る
1. クラスターと Lambda 関数を作る
クラスターは create-cluster で作り、available になるまで 14 分かかりました。Lambda 関数の接続先は、クラスターエンドポイント(clustercfg. で始まるアドレス)です。
Lambda 関数は、キー order:{n} に値 n を順番に SET し、OK が返った n を記録します。エラーが出たら、同じ n を、フルジッター付きの指数バックオフ(100 ms から 2 倍、上限 2 秒)で書き込み直します。試行は初回を含めて最大 10 回で、それでも書き込めなかった n は「未確定」として別に記録します。同じキーに同じ値を書き込むだけなので、何度書き込み直しても結果は変わりません(カウンターの INCR は使いません)。
エラーが出るたびにクライアントを作り直します。その接続にも、フルジッター付きの指数バックオフ(0.5 秒から 2 倍、上限 8 秒)で、初回を含めて最大 12 回の再試行を入れています。この接続の再試行は、手順 2 の結果を受けて後から入れたものです。
"""MemoryDB(Valkey)へ order:{n} を順に SET し続け、OK が返った n を記録する。

- 接続:クラスターエンドポイント(TLS)。valkey-py の ValkeyCluster を使う。
- 再試行:接続エラー・タイムアウト・MOVED/CLUSTERDOWN・READONLY などのエラーは、フルジッター付きの指数バックオフ
  (100 ms から 2 倍、上限 2 秒)で最大 10 回まで同じ n を書き直す。上限を超えた n は「未確定」として別に記録する。
- 冪等性:キー order:{n} に値 n を書くだけなので、同じ n を何度書いても結果は変わらない(カウンターの INCR は使わない)。
- 終了:DURATION 秒(環境変数、既定 420 秒)経ったら止まり、書けた n の一覧・エラーの種類と回数・書けなかった時間帯を返す。
"""
import json
import os
import random
import time

from valkey.cluster import ValkeyCluster
from valkey.exceptions import ConnectionError, TimeoutError, ClusterDownError, ValkeyError

HOST = os.environ["MEMORYDB_HOST"]
DURATION = int(os.environ.get("DURATION", "420"))
INTERVAL = float(os.environ.get("INTERVAL", "0.02"))

def connect():
    """クラスターに接続する。失敗したらフルジッター付きの指数バックオフ(0.5 秒から 2 倍、上限 8 秒)で最大 12 回まで試す。"""
    last = None
    for attempt in range(12):
        try:
            t0 = time.time()
            client = ValkeyCluster(host=HOST, port=6379, ssl=True, socket_timeout=1.0, socket_connect_timeout=2.0,
                                   cluster_error_retry_attempts=0)
            print(json.dumps({"connected": True, "attempt": attempt + 1, "seconds": round(time.time() - t0, 1)}))
            return client
        except Exception as e:
            last = e
            print(json.dumps({"connect_error": type(e).__name__, "attempt": attempt + 1,
                              "seconds": round(time.time() - t0, 1), "message": str(e)[:160]}))
            time.sleep(random.uniform(0, min(8.0, 0.5 * 2 ** attempt)))
    raise last

def lambda_handler(event, context):
    start_n = int(event.get("start", 1))
    t_start = time.time()
    client = connect()
    ok = []
    unresolved = []
    errors = {}
    outages = []
    n = start_n
    outage_start = None
    while time.time() - t_start < DURATION:
        key = f"order:{n}"
        done = False
        for attempt in range(10):
            try:
                if client.set(key, str(n)):
                    done = True
                    break
            except (ConnectionError, TimeoutError, ClusterDownError, ValkeyError) as e:
                name = type(e).__name__
                errors[name] = errors.get(name, 0) + 1
                if outage_start is None:
                    outage_start = time.time()
                time.sleep(random.uniform(0, min(2.0, 0.1 * 2 ** attempt)))
                try:
                    client.close()
                except Exception:
                    pass
                client = connect()
        if done:
            ok.append(n)
            if outage_start is not None:
                outages.append({"from_n": n, "seconds": round(time.time() - outage_start, 2), "at": round(time.time() - t_start, 1)})
                outage_start = None
        else:
            unresolved.append(n)
        n += 1
        time.sleep(INTERVAL)
    # 検算:OK を記録した n がすべて読めるか
    missing = []
    for m in ok:
        try:
            if client.get(f"order:{m}") != str(m).encode():
                missing.append(m)
        except ValkeyError:
            missing.append(m)
    return {
        "start": start_n, "last_n": n - 1, "ok_count": len(ok), "unresolved": unresolved, "errors": errors,
        "outages": outages, "missing_after_check": missing, "elapsed": round(time.time() - t_start, 1),
        "ok_first": ok[:3], "ok_last": ok[-3:],
    }
2. フェイルオーバーを起こす
Lambda 関数を AWS CLI で同期で呼び出し、書き込みが始まってから、別の端末で次のコマンドを実行しました。
aws memorydb failover-shard --cluster-name order-counter-cache --shard-name 0001
failover-shard は、フェイルオーバーが起きたときのアプリケーションの動作を試すための API です。24 時間に 5 回まで使えます(2026 年 10 月時点)。
Lambda 関数の実行は 7 分半ほどかかり、AWS CLI の読み取りタイムアウトのデフォルト(60 秒)より長くなります。同じ手順で試すときは、aws lambda invoke に --cli-read-timeout を付けて、当該関数の実行時間より長い値か 0 にしてください。
最初の 2 回は、接続し直しに再試行を入れていない関数で試しました。どちらも ValkeyClusterException で、Lambda 関数がエラーで終わりました。メッセージは、1 回目が「Timeout connecting to server」、2 回目が「Connection reset by peer」です。イベントの「Starting failover」は、呼び出しからそれぞれ 79 秒後と 94 秒後でした。
エラーのスタックトレースは、どちらも、SET が失敗した後に接続し直す行を指していました。フェイルオーバーかその後の旧プライマリの回復の間に SET が失敗し、続く接続し直しの 1 回目でも失敗して、そのまま Lambda 関数が終わったと判断しました。
セキュリティグループやサブネットの設定の問題も疑いました。DURATION を 20 秒にして呼び出したところ、22 秒で 775 件を書き込めたので、設定の問題ではないと判断しました。
この 2 回のフェイルオーバーで、プライマリは 1 回目で 0001-002 に替わり、2 回目で 0001-001 に戻りました。
3. 接続し直しにも再試行を入れて、もう一度試す
手順 1 のコードのとおり、接続し直しにも再試行を入れて、3 回目の呼び出しを行いました。最初の接続は 1 回目の試行(0.4 秒)で成功し、Lambda 関数の開始から約 54 秒後に failover-shard を実行しました。この回が 3 回目のフェイルオーバーで、直前のプライマリとレプリカの配置は作成時と同じです。
以降の結果は、すべてこの 3 回目のものです。
4. イベントで進み方を見る
describe-events で取ったイベントです。開始から完了まで 48 秒で、その後に旧プライマリ 0001-001 の回復が始まりました。1 行目は、手順 2 の 2 回目のフェイルオーバーの後に始まった、0001-002 の回復の完了です。
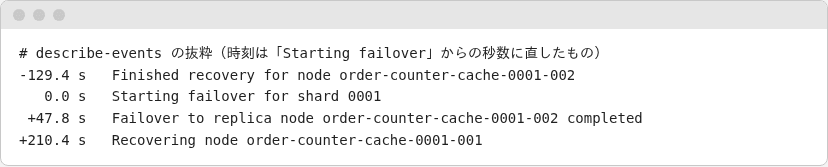
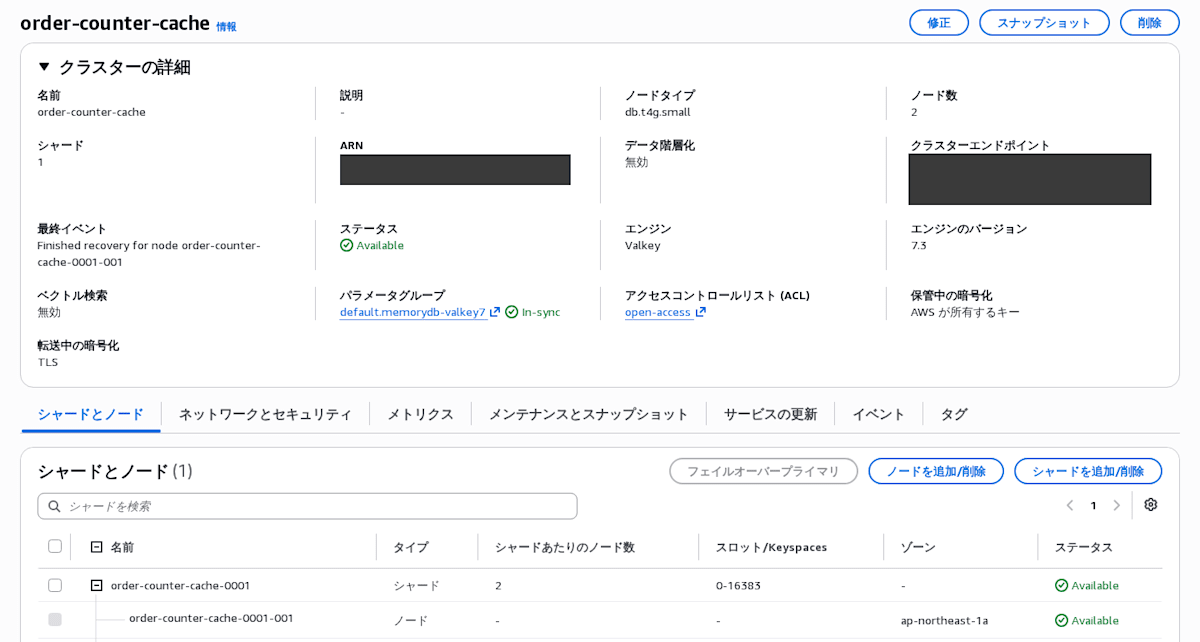
フェイルオーバー先は、レプリカだった 0001-002 です。MemoryDB コンソールのクラスターの画面では、最終イベントに旧プライマリ 0001-001 の回復の完了が出ています。ノードがプライマリかレプリカかは、この画面には出ません。
5. 書き込み側の結果を見る
Lambda 関数の戻り値です。
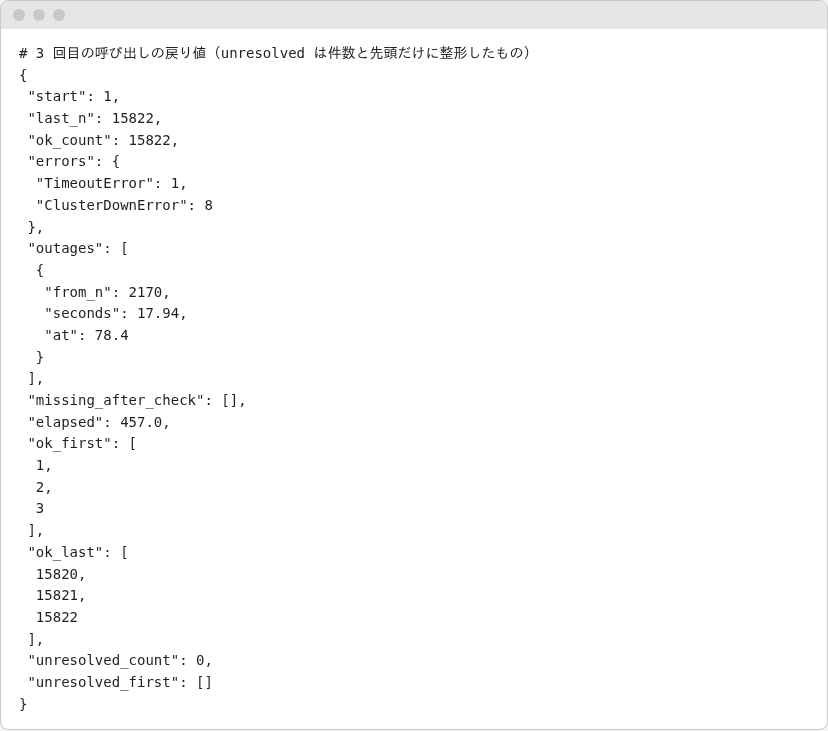
| 項目 | 値 |
|---|---|
| 書き込んだ件数(ok_count) | 15,822 |
| エラー(errors) | TimeoutError 1 回、ClusterDownError 8 回 |
| 書き込みが止まった時間(outages) | 17.94 秒(関数の開始から 60.5 秒後に止まり、78.4 秒後に order:2170 で再開) |
| 試行の上限でも書き込めなかった件数(unresolved) | 0(画像では件数の unresolved_count に整形) |
| 終了後に GET して読めなかった件数(missing_after_check) | 0 |
elapsed(457.0 秒)は、書き込みの後の検算の GET も含めた、当該関数の中の経過時間です。
書き込みが止まり始めたのは、failover-shard の実行から約 6 秒後、イベントの「Starting failover」から約 2 秒後でした。再開は、イベントの「completed」より 28 秒早く、書き込み側はイベントの完了を待たずに戻りました。
次は、接続し直したときのログです。
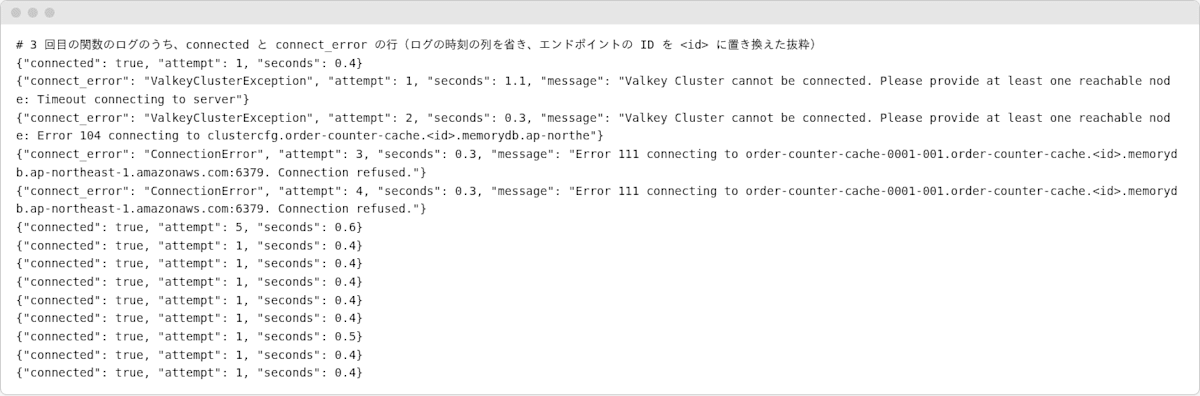
最初の SET が TimeoutError になった後、接続し直しは、タイムアウト、Error 104、Connection refused(2 回)と失敗し、5 回目で接続できました。Error 104 のメッセージは、コードで 160 文字に切っているため、途中までしか出ていません。
その後の ClusterDownError(8 回)は、接続はできても書き込めない状態です。この間に、新しいプライマリへの切り替えが進んでいたと考えています。9 回のエラーはすべて order:2170 のもので、10 回目の試行で書き込めました。上限ちょうどです。
確認してみた
データは失われなかったか
終了後に、OK が返った 15,822 件すべてを GET して値を確かめ、欠落は 0 件でした。MemoryDB は、整合性のとれたレプリカにフェイルオーバーし、その間にデータを失わない設計です。
プライマリノードに障害が発生すると、整合性のとれたレプリカへのフェイルオーバーがトリガーされ、フェイルオーバー中にデータが失われることはありません。これで、書き込みは新しいプライマリノードから処理されます。
止まった時間はどのくらいか
通常は数秒で、クラスターへの書き込みが再び可能になります。
今回は 17.9 秒で、「数秒」より長くなりました。ただし、この値には、クライアント側の再試行の待ち(1 回あたり最大 2 秒)と、接続し直しの待ちが含まれています。クラスターが書き込みを受け付けなかった時間そのものではありません。
一方、最初の SET が TimeoutError になるまでの待ち(socket_timeout の 1 秒まで)は含まれていません。止まった時間は、例外を受け取った時刻から数えているためです。測ったのは 1 回だけなので、毎回この秒数になるとは限りません。
イベントの文言
開始と完了のイベントは次のメッセージです。
- クラスターメッセージ:
FailoverShard API called for shard <shard-id>- クラスターメッセージ:
Failover from primary node <primary-node-id> to replica node <node-id> completed
今回のクラスターで出たのは、「Starting failover for shard 0001」「Failover to replica node order-counter-cache-0001-002 completed」「Recovering node order-counter-cache-0001-001」「Finished recovery for node order-counter-cache-0001-001」でした。開始と完了の 2 つは、同じページの CLI の例の JSON と同じ文言です。回復の 2 つは、ドキュメントの一覧では「Recovering nodes」「Finished recovery for nodes」(複数形)になっています。イベントの文字列で判定する場合は、実際の文言を確かめてから使ってください。
まとめ
本ブログが誰かの参考になれば幸いです。
参考資料
- マルチ AZ による MemoryDB のダウンタイムの最小化 - Amazon MemoryDB
- failover-shard — AWS CLI Command Reference
- 接続エンドポイントの検索 - Amazon MemoryDB
- Command line options in the AWS CLI - AWS Command Line Interface
クラスメソッドオペレーションズ株式会社について
クラスメソッドグループのオペレーション企業です。
運用・保守開発・サポート・情シス・バックオフィスの専門チームが、IT・AIをフル活用した「しくみ」を通じて、お客様の業務代行から課題解決や高付加価値サービスまでを提供するエキスパート集団です。
当社は様々な職種でメンバーを募集しています。
「オペレーション・エクセレンス」と「らしく働く、らしく生きる」を共に実現するカルチャー・しくみ・働き方にご興味がある方は、クラスメソッドオペレーションズ株式会社 コーポレートサイト をぜひご覧ください。※2026年1月 アノテーション㈱から社名変更しました