Nemotron-3-Diarizationで手元のMacでローカル話者分離してみたら、約27分の会議データでも6秒で話者分離できた

こんちには。製造ビジネステクノロジー部の中村(@nokomoro3)です。
先日NVIDIAから話者分離モデルの「Nemotron-3-Diarization」が公開されました。100M程度のパラメータ数でありながら、話者分離のベンチマークで1位を獲得しているモデルです。
今回はこのモデルを手元のMacで動かし、会議の録音データに対して話者分離を試してみました。推論結果を確認するための簡単なViewerもあわせて作ってみています。
なお、検証に使用したコードは以下に配置しています。
はじめに
いままでローカル話者分離には以下の選択肢がありました。
- pyannote.audio (WhisperXの内部で使用)
- 特徴: オープンソースのデファクトスタンダード
- デメリット: モデルが大規模であり、Macでは動作が遅い
- sherpa-onnx (CAM++ / 3D-Speaker)
- 特徴: C++製でありMacに組み込みやすく、超軽量
- デメリット: 事前に話者数を指定しないと精度がでない、発話のかぶりに弱い
今回NVIDIAが発表したNemotron-3-Diarizationは100Mパラメータ程度の軽量なモデルながら、VoiceArenaのDiarization-BenchでDER 14.72%を記録して1位を獲得しており、最大8名の発話に対応しています。
またpyannote.audioやsherpa-onnxはクラスタリング方式を採用していましたが、Nemotron-3-DiarizationはSortformer(End-to-End方式)となっています。クラスタリング方式は音声をセグメントに分割して、この声は誰と似ているかを判別していましたが、音声がまざるとどの話者に分別するか判定不能となっていました。これに対して、Sortformerは各話者(8名分)のそれぞれの発話の確率が直接出力されるため、重複発話もきれいに拾える特徴があります。
さらに、Nemotron-3-Diarizationはストリーミング処理にも対応しています。Arrival-Order Speaker Cache(AOSC)という仕組みで、話者を登場した順に番号付けしつつキャッシュしていくため、音声をチャンクに区切って逐次処理しても話者ラベルが入れ替わりにくくなっています。1つのチェックポイントで、0.32秒程度の低遅延な設定から30.4秒のバッファを使うオフライン相当の設定まで切り替えられるため、リアルタイムの文字起こしなどにも組み込みやすそうです。
なお、今回の記事ではストリーミングは試さず、録音済みの音声ファイルを一括で処理しています。
検証環境
- Mac(Apple M4、メモリ16GB)
- macOS 26.7
- Python 3.14.0
- uv
試してみた
環境構築
uvで環境構築をしてみます。
uv init
#Initialized project `nemotron-3-diarization-sample`
#mise WARN  missing: python@3.14.7

# PyTorchのインストール
uv add torch torchaudio librosa

# 最新のTransformers(Nemotron-3-Diarization対応版)
uv add git+https://github.com/huggingface/transformers

# 音声インメモリ処理用
uv add av
pyproject.tomlは以下のようになりました。Transformersは執筆時点でNemotron-3-Diarizationに対応したリリース版がなかったため、GitHubのmainブランチから入れています。
実際に入った主要パッケージのバージョンは以下のとおりです。
| パッケージ | バージョン |
|---|---|
| torch | 2.14.0 |
| torchaudio | 2.11.0 |
| transformers | 5.18.0.dev0(a0ccef2) |
| av | 18.1.0 |
| librosa | 1.0.0 |
uv.lockは以下のとおりです。
動かしてみる
以下のようなファイルを準備します。
以下のコマンドで入出力を指定して実行できます。
$ uv run python run.py recording.webm -o diarization_result.json

# Using device: mps
# Loading model and processor...
# Loading weights: 100%|███████████████████████████████████████████████████████████████████| 417/417 [00:00<00:00, 6676.07it/s]
# Reading audio from: recording.webm
# Audio loaded: 1615.24s
# Diarizing...
# Done! 6.16s (Speed: 262.3x)
#
# --- Summary ---
# 音声の長さ   : 1615.24 秒
# 推論処理時間 : 6.159 秒 (262.3倍速)
# 使用デバイス : mps
# 検出話者数   : 7
# セグメント数 : 489
# 結果JSON     : diarization_result.json
約27分(1615秒)の会議の録画データですが、Apple M4のMPS(Metal)で6秒程度で話者分離の推論が完了しました。実時間の約260倍の速度です。
結果はJSONで出力されるようにしてみました。確率値があるので確率値を平均してセグメントあたりの信頼度として出力してみています。
{
  "metadata": {
    "source_file": "recording-2.mp4",
    "total_duration_sec": 1615.24,
    "inference_time_sec": 6.159,
    "rtfx": 262.3,
    "device": "mps",
    "num_speakers_detected": 7,
    "speakers": [
      "speaker_0",
      "speaker_1",
      "speaker_2",
      "speaker_3",
      "speaker_4",
      "speaker_5",
      "speaker_6"
    ]
  },
  "segments": [
    {
      "segment_id": 0,
      "speaker": "speaker_0",
      "speaker_id": 0,
      "start": 1.12,
      "end": 3.04,
      "duration": 1.92,
      "confidence": 0.9587
    },
    {
      "segment_id": 1,
      "speaker": "speaker_0",
      "speaker_id": 0,
      "start": 3.51,
      "end": 5.59,
      "duration": 2.08,
      "confidence": 0.9919
    },
    {
      "segment_id": 2,
      "speaker": "speaker_1",
      "speaker_id": 1,
      "start": 12.52,
      "end": 14.13,
      "duration": 1.61,
      "confidence": 0.9174
    },
    ...
  ]
}
segmentsは開始時刻順に並んでおり、話者ごとに別々のセグメントとして出力されます。そのため、複数の話者が同時に話している区間では、時間が重なるセグメントがそれぞれの話者に出力されます。今回の結果でも、異なる話者のセグメントが時間的に重なっている箇所が28組ありました。
可視化してみる
Reactを作ってもらってViewerを作成してみました。コードは以下に置いています。
Viewerは音声と話者ごとのタイムラインを並べて表示し、発話区間をクリックするとその位置から再生できるようにしています。Node.js 22.18以上が必要で、初回はビルドしてから起動します。
cd frontend
npm install
npm run build
cd ..
以下でViewerを起動できます。
node frontend/server.mjs --audio ./recording.webm --json ./diarization_result.json

# 音声: ~/repo/blog/nemotron-3-diarization-sample/recording.webm
# JSON: ~/repo/blog/nemotron-3-diarization-sample/diarization_result.json
# [remix-serve] http://localhost:5173 (http://127.0.0.1:5173)
分離結果は以下のように表示されます。
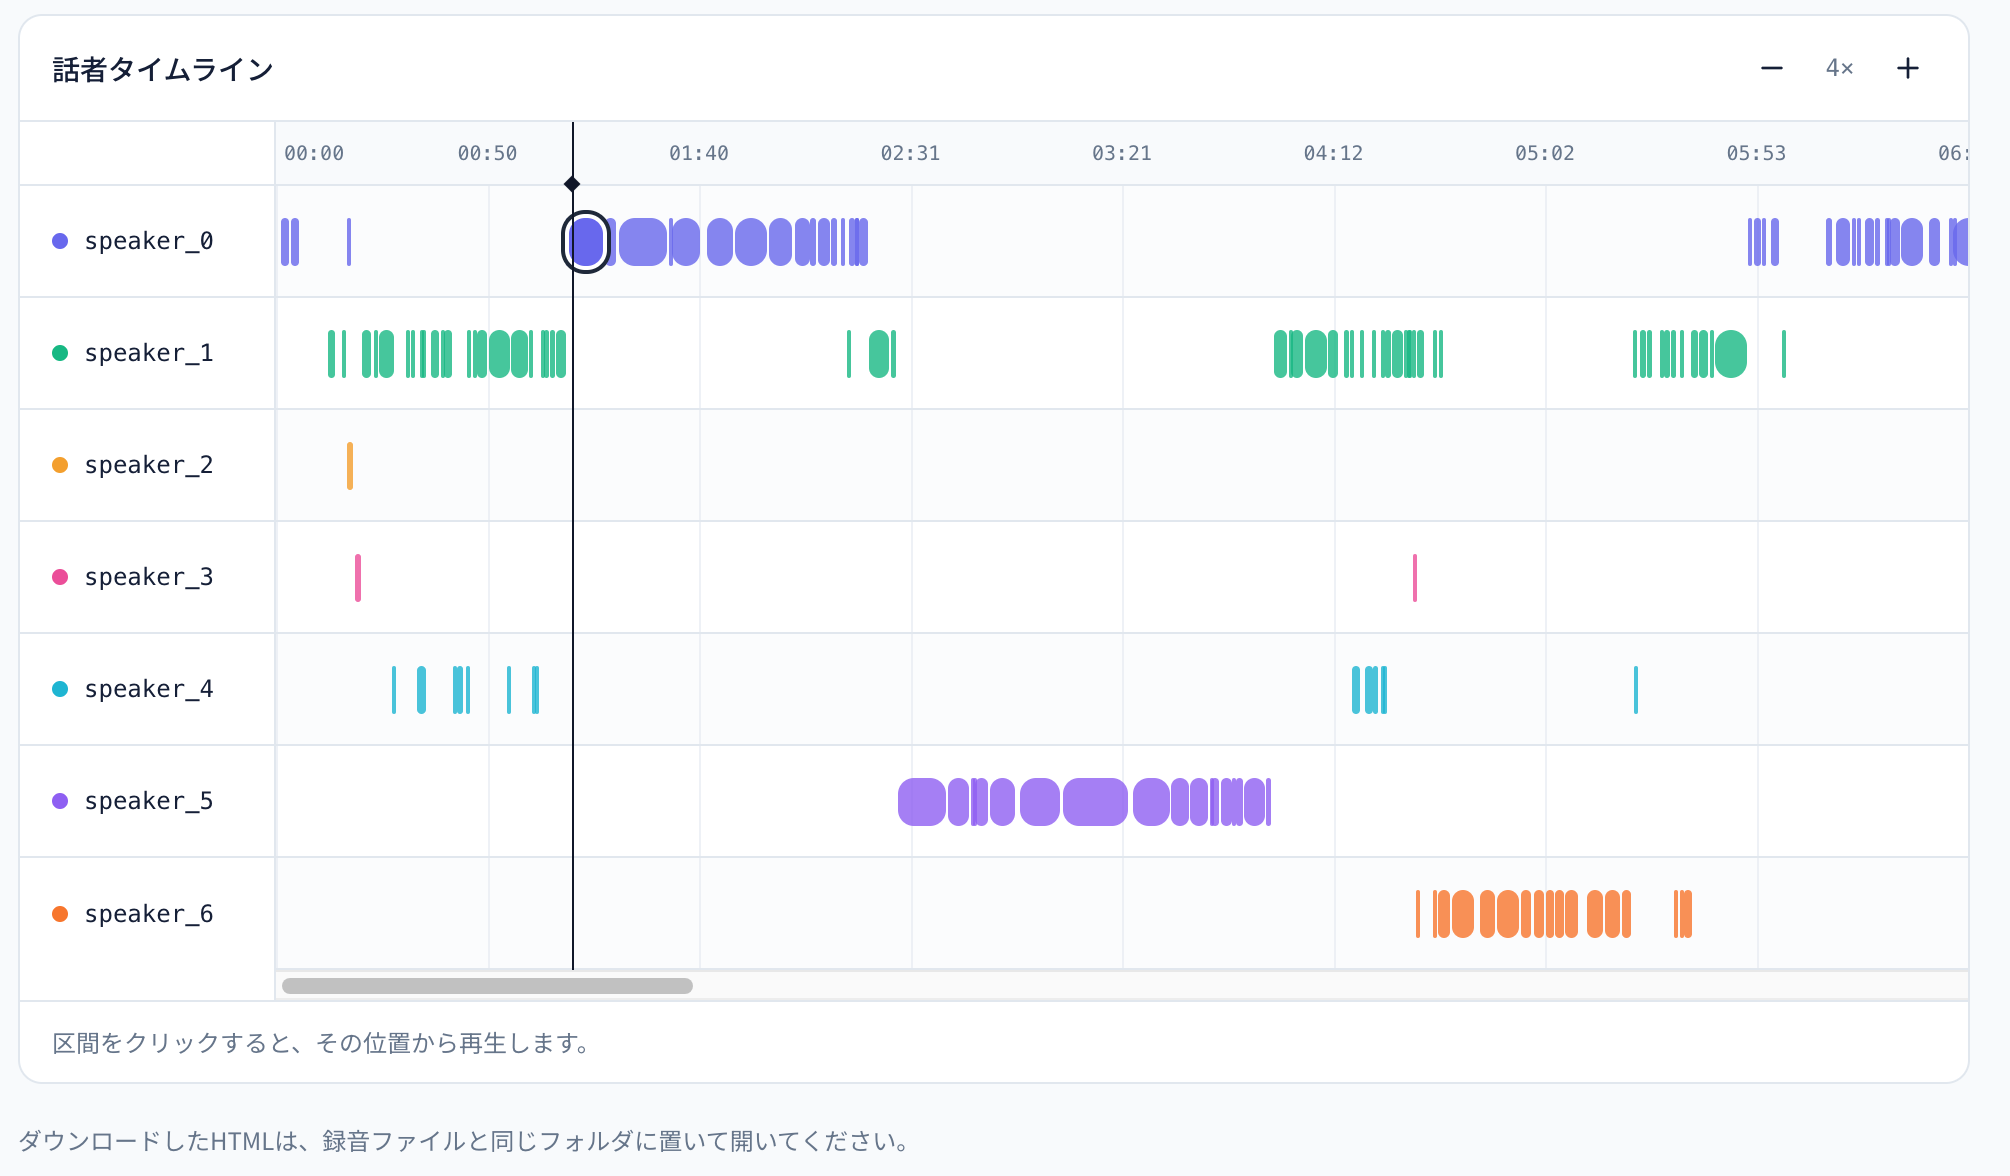
あいづち含めてかなり綺麗に分離できており、発話の重複に強いというのは間違いなさそうです。
まとめ
今回はNemotron-3-Diarizationを使って、手元のMacでローカルに話者分離を試してみました。
- Transformersから数行で呼び出せ、Apple M4のMPSで約27分の音声を6秒程度で処理できた
- End-to-End方式のため、あいづちなどの重複発話もそれぞれの話者として検出できた
- 話者数を事前に指定する必要がない
Macさえあればサクッと手元で実行できると思うので、ぜひお手元のデータでお試しください。今後はストリーミング処理や、文字起こしモデルとの組み合わせも試してみたいと思います。
本記事が皆様のご参考になれば幸いです。