NVIDIA Nemotron 3 Nano Omni 30B-A3Bは「不良品のアヒル」を見抜けるのか?
今回はベルトコンベアを流れてくるおもちゃのアヒルを見て、正常品か不良品かを判定するVLMを作ってみました。
ベースモデルには NVIDIA Nemotron 3 Nano Omni 30B-A3B(BF16版)を使い、LoRAでファインチューニングしています。
評価したのは次の 2 つです。
- 正常 / 不良品の判定(2 値分類)
- 不良品の理由判定
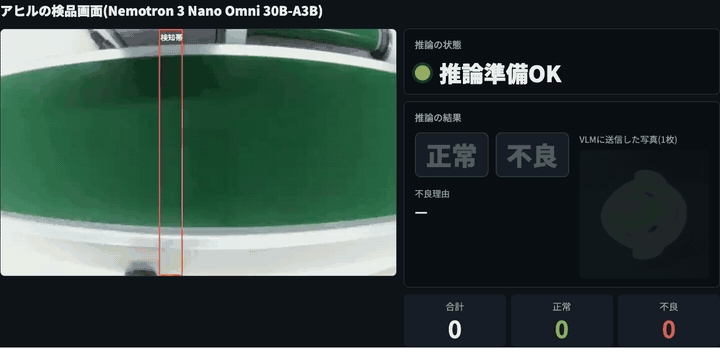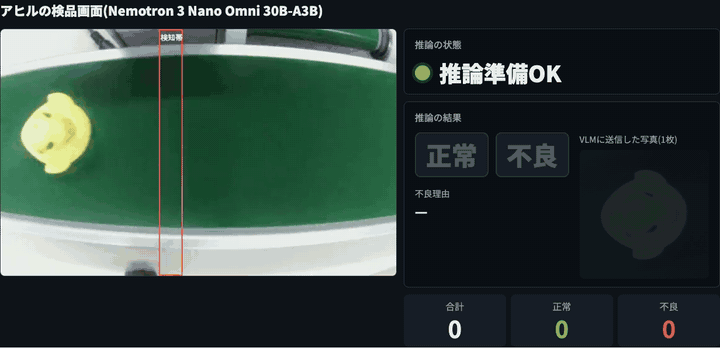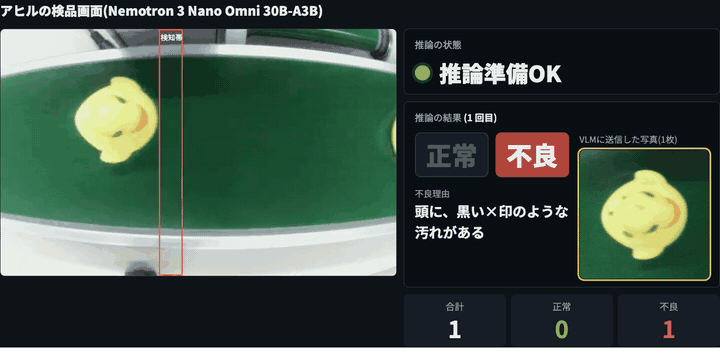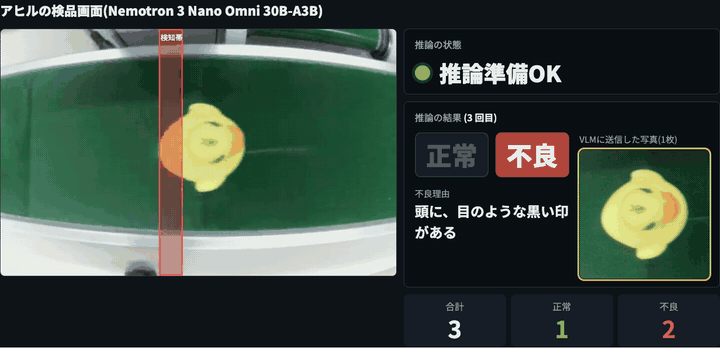
まず結論から
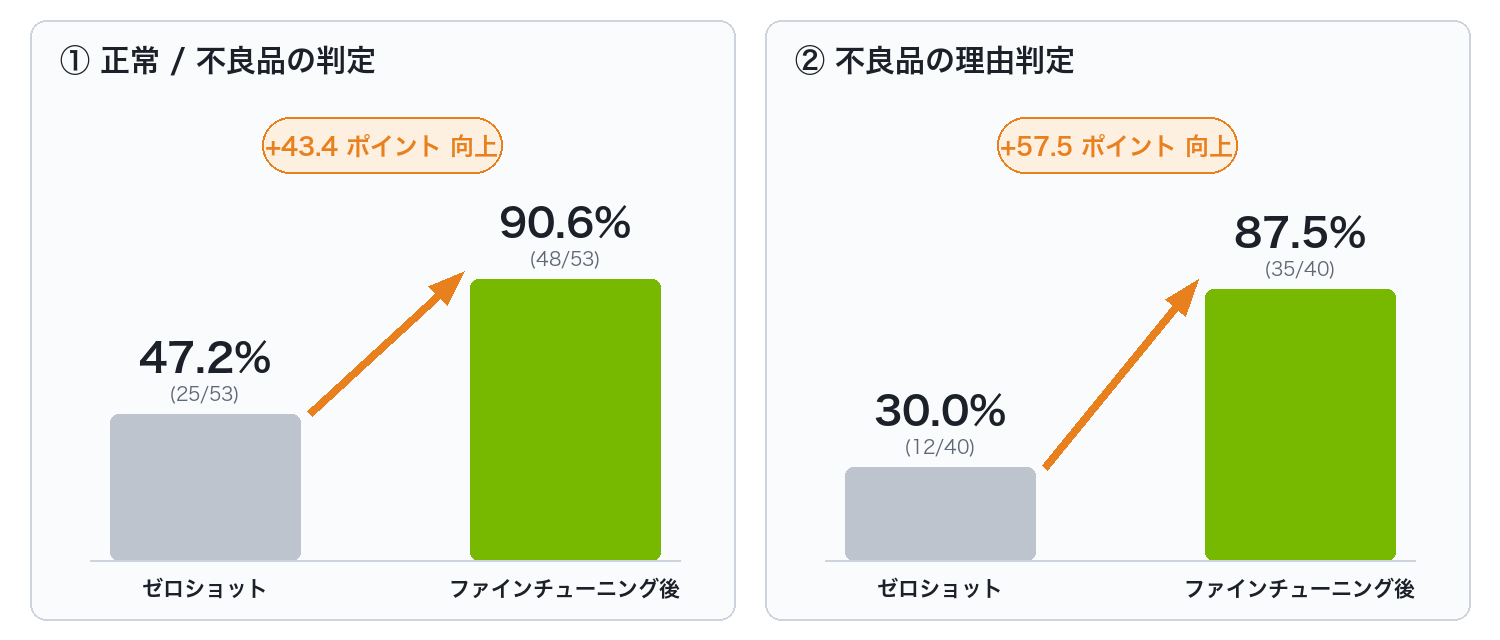
ファインチューニングによって、どちらの正解率も大きく上がりました。
1. データセット
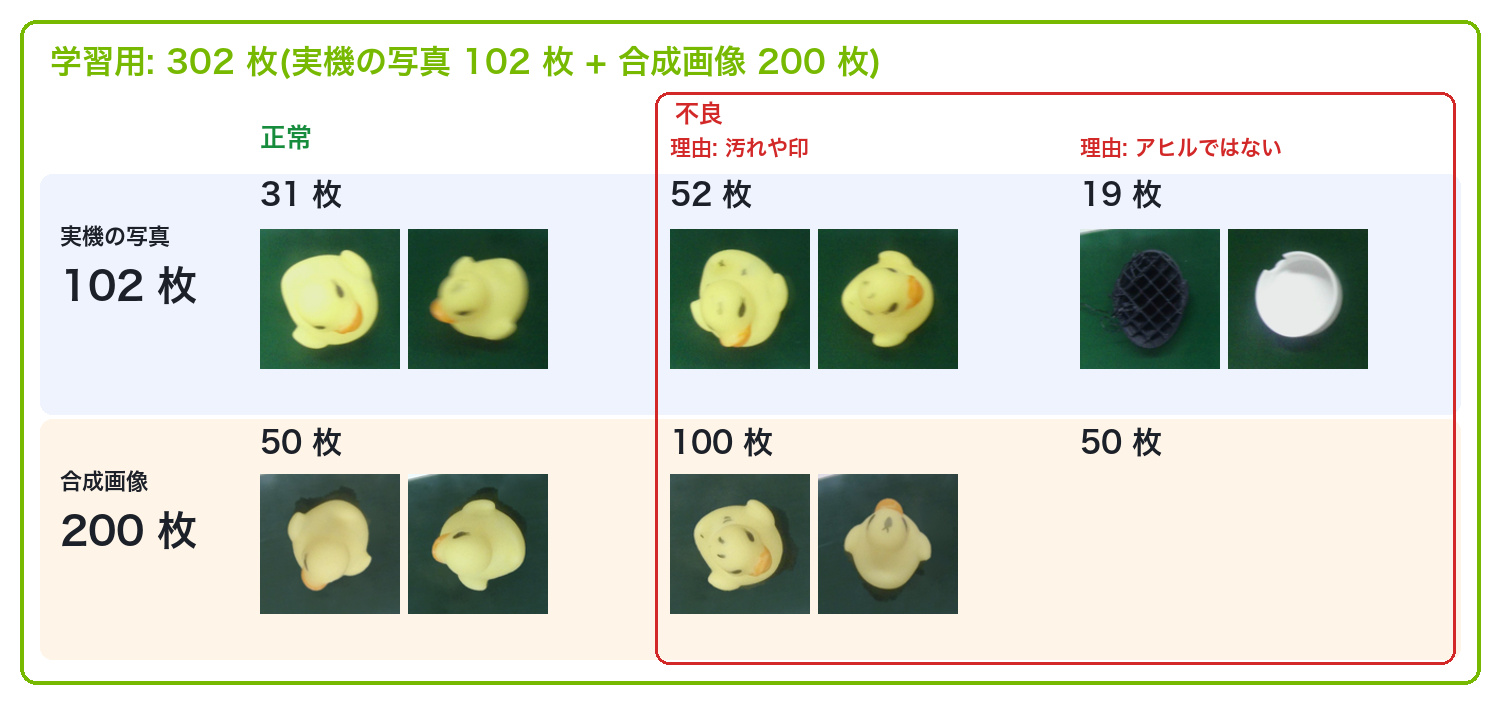
学習用と評価用には、撮った回の異なる別々の写真を使っています。写真は正常と不良に分け、不良の理由は「汚れや印」(×印・点・目のような印)と「アヒルではない」の 2 種類です。
学習用: 302 枚
評価用: 実機の写真 53 枚
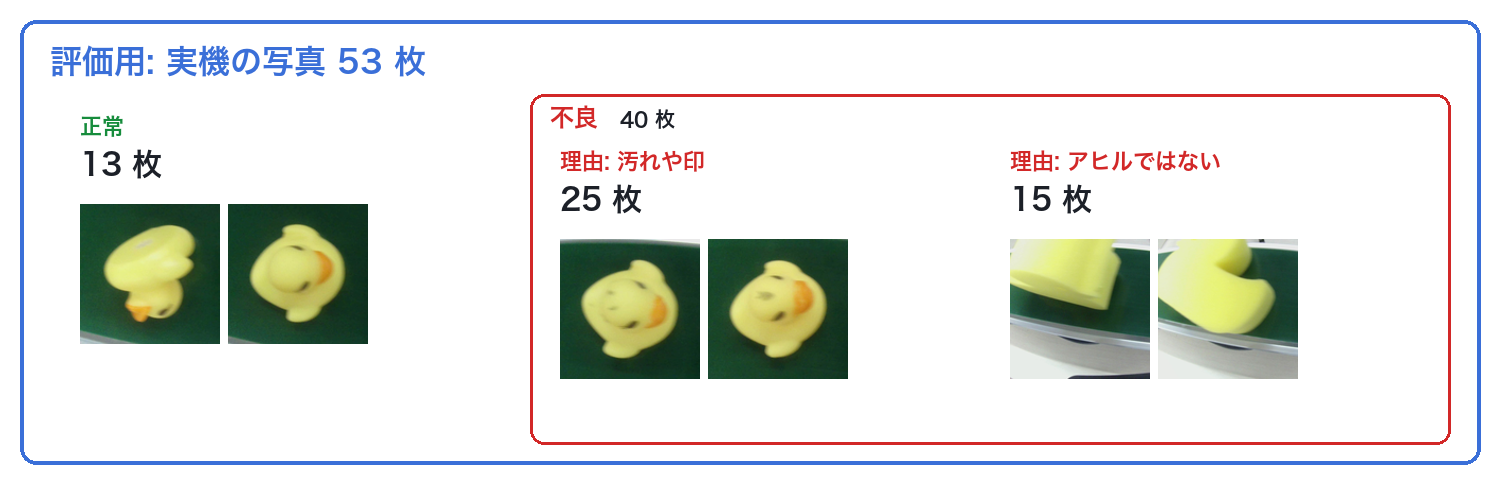
評価用の写真は学習には使っていません。正解率はこの 53 枚で測ります。
正解の答え: 日本語の JSON
答えは、判定・分類・理由の 3 つを持つ JSON です。
| 種類 | 正解の答え(学習データの実物) |
|---|---|
| 正常 | {"verdict": "normal", "category": "none", "reason": ""} |
| 汚れや印 | {"verdict": "defect", "category": "stain", "reason": "頭と背中に、黒い汚れが何か所もある"} |
| 汚れや印(目のような印) | {"verdict": "defect", "category": "stain", "reason": "頭に、目のような黒い印がある"} |
| アヒルではない | {"verdict": "defect", "category": "not_duck", "reason": "アヒルではない。白い器"} |
- 判定(verdict)は正常か不良かを決めるのに使います。
- 分類(category)は決まった言葉から選ばせて、種類ごとの数を数えるのに使います。
- 理由(reason)は自由な日本語の文です。実機の写真では 1 枚ずつ見たままを書きました。
2. ゼロショット予測とファインチューニング後の予測を比べる
プロンプト内容
写真 1 枚と次の質問を渡します。ゼロショット(ファインチューニングなし)とファインチューニング後で同じ質問を使い、答えは vLLM の構造化出力でこの JSON の形に固定しています。
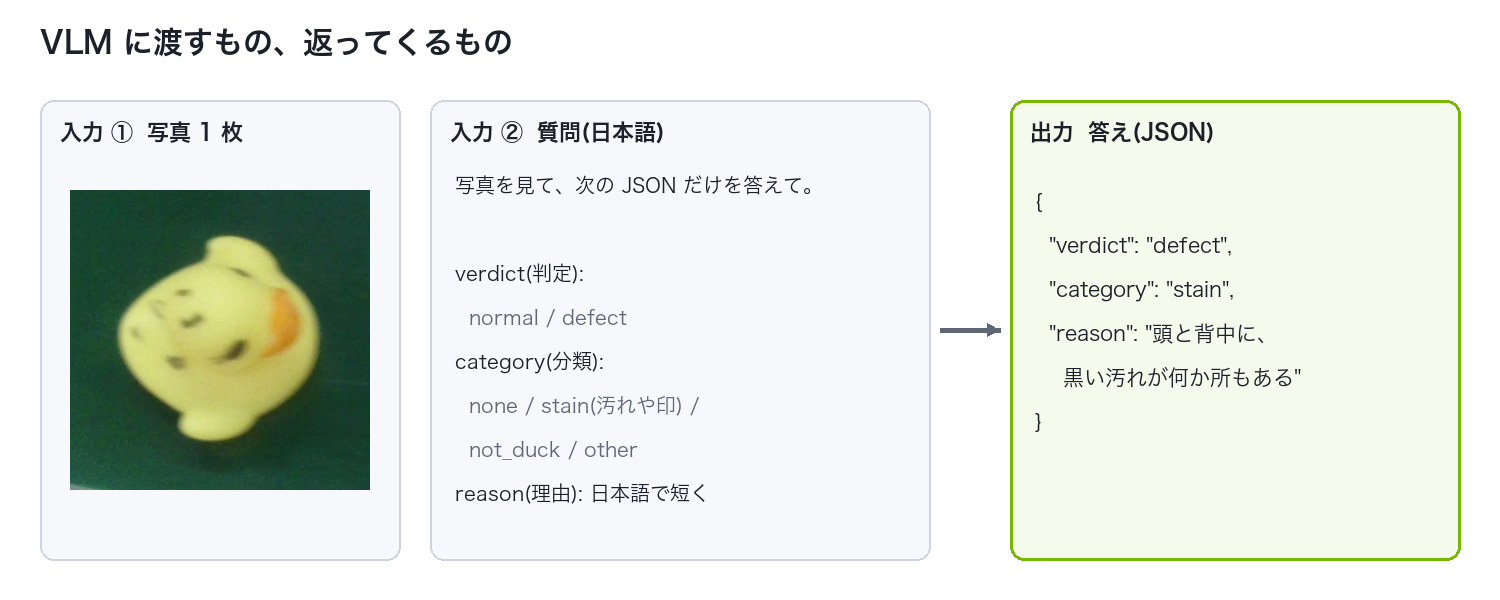
これはベルトコンベアの上を撮った写真です。ふつうは、黄色いゴムのアヒルが 1 つ写っています。
写真を見て、次の JSON だけを答えてください。説明や前置きは書かないでください。

{"verdict": "...", "category": "...", "reason": "..."}

- verdict: 正常なアヒルなら "normal"。アヒルに不良があるか、アヒルではない物なら "defect"。
- category: verdict に合わせて、次のどれか 1 つ。
  - "none": 正常
  - "stain": アヒルに、黒い汚れや印がある(×印、点、線、目のような印も含む)
  - "not_duck": アヒルではない物(人形、玉、スポンジ、別の種類のアヒルなど)
  - "other": 上のどれでもない不良
- reason: 不良のときは、どこが、どうおかしいかを、日本語の短い文で書く(例: 「頭と背中に、黒い汚れが何か所もある」)。正常のときは "" にする。
  reason は必ず日本語で書く。
結果
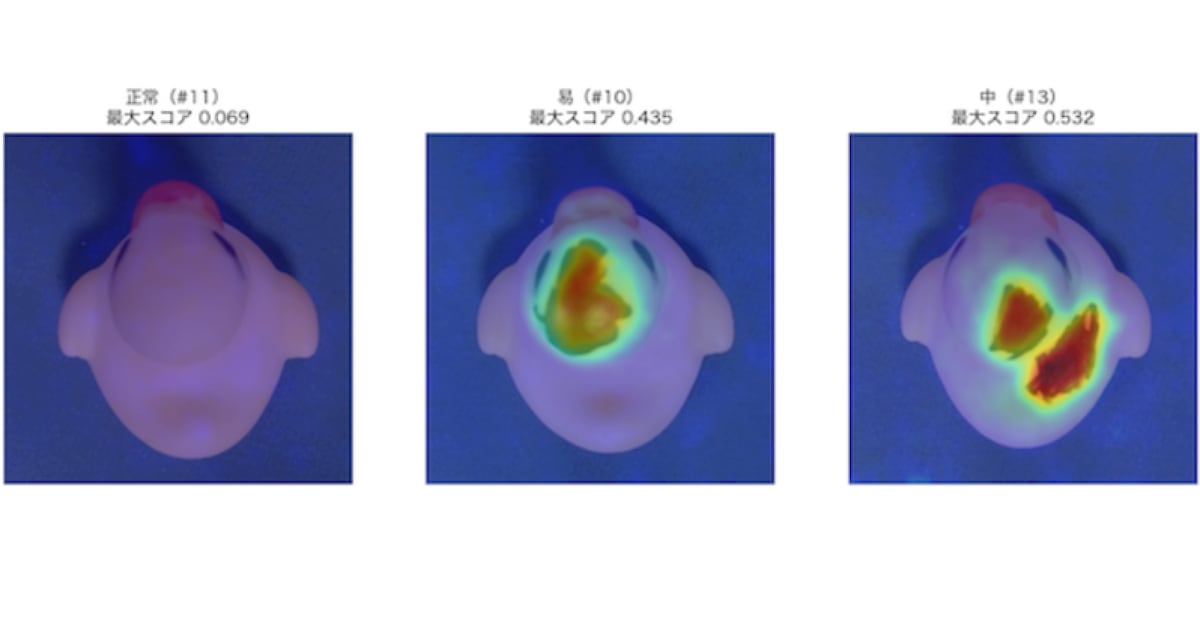
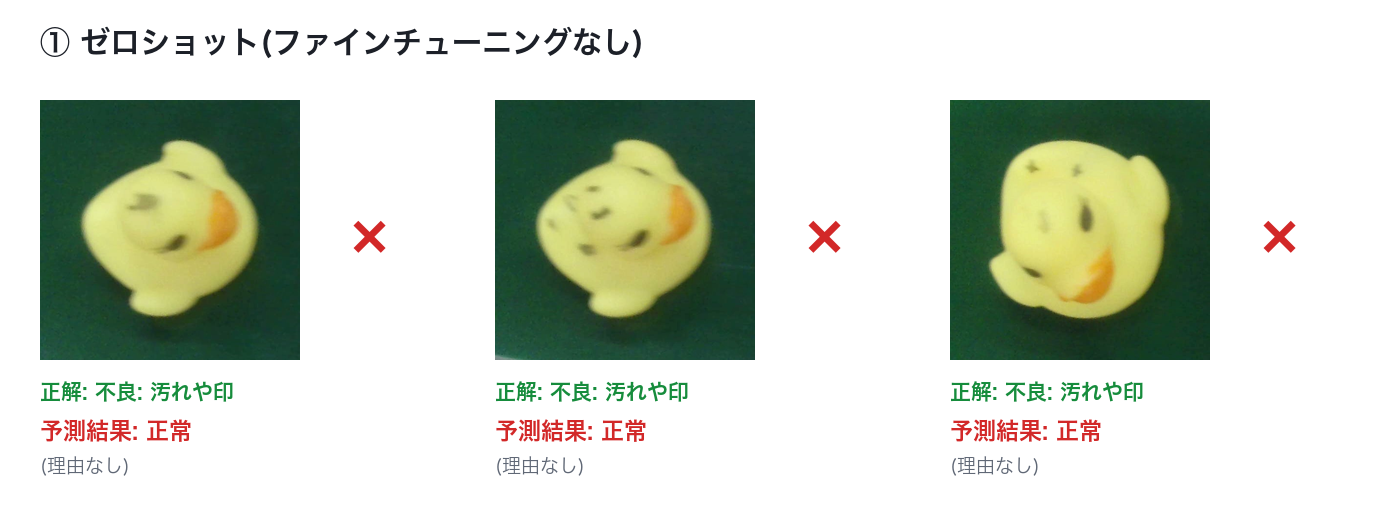
同じ写真に対するそれぞれの予測結果です。ゼロショットでは汚れや印のあるアヒルを「正常」と答えています。
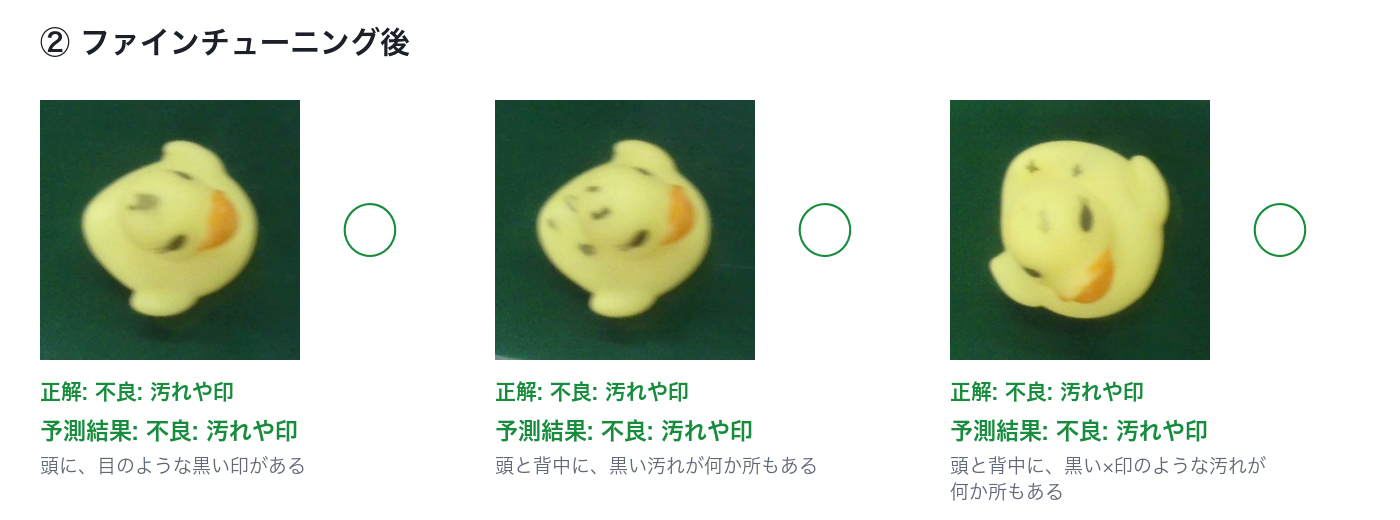
ファインチューニング後は不良と判定したうえで、どこに何があるかを日本語で答えるようになりました。
評価用 53 枚全体の正解率は次のとおりです。
| ゼロショット | ファインチューニング後 | |
|---|---|---|
| ① 正常か不良か(53 枚) | 47.2%(25/53) | 90.6%(48/53) |
| ② 不良品の理由判定(40 枚) | 30.0%(12/40) | 87.5%(35/40) |
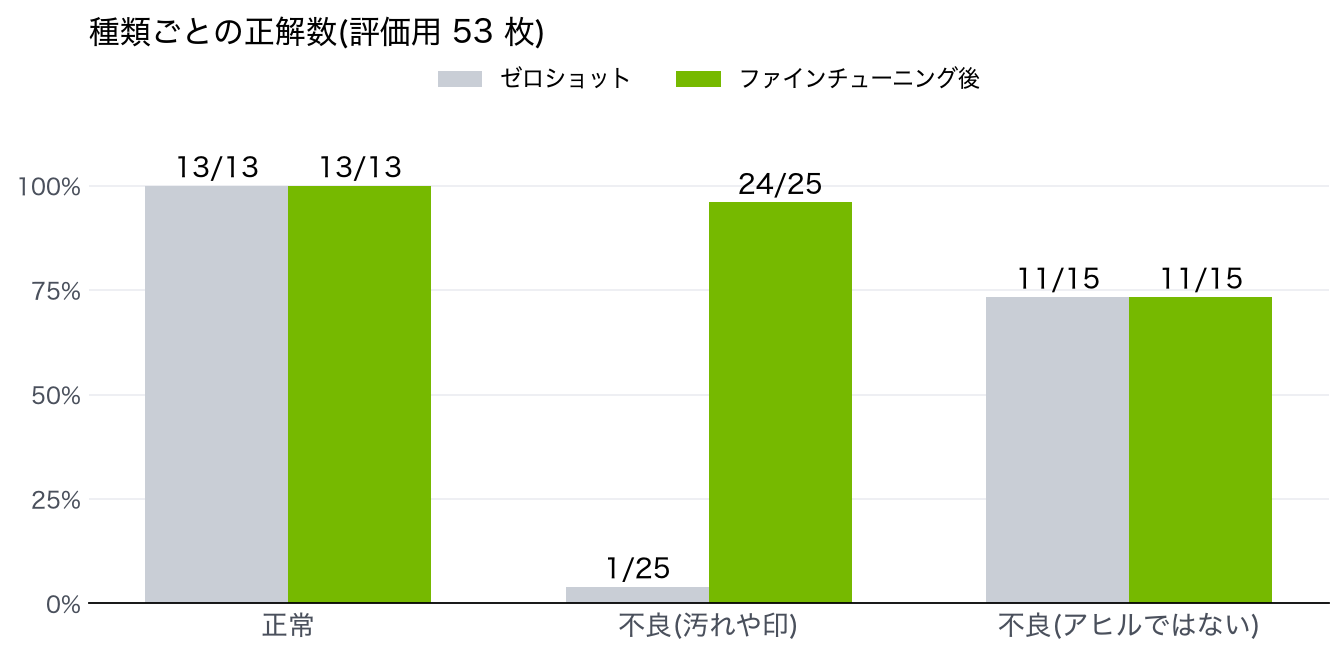
種類ごとに見ると、大きく変わったのは汚れや印です。ゼロショットは汚れや印のあるアヒルをほぼすべて「正常」と答えていました(1/25)。VLM は「アヒルの写真」とはわかっても、「この印は不良」というこのラインだけの決まりは知らないためです。ファインチューニング後は 24/25 当たるようになりました。
一方、アヒルではない物はゼロショットでも 11/15 当たっていて、ファインチューニング後も 11/15 のままでした。
ファインチューニングしても間違えたもの
ファインチューニング後も間違えたのは 53 枚のうち 5 枚です。どれも不良を「正常」と答えました。
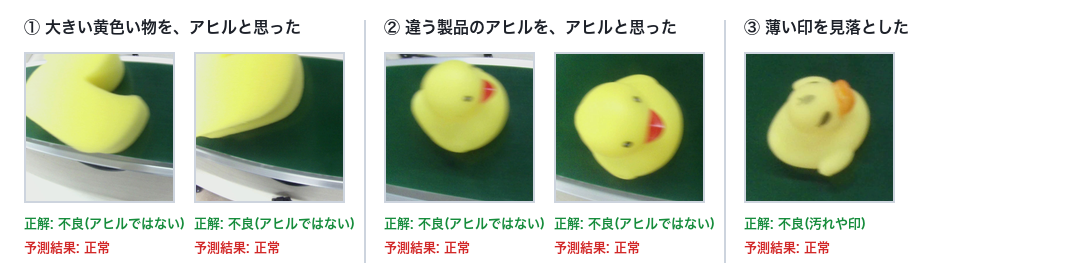
- 大きい黄色い物をアヒルと思った(2 枚): 黄色いアヒルのスポンジです。大きくて画面からはみ出しているため、黄色い部分をアヒルと見てしまったと考えられます。
- 違う製品のアヒルをアヒルと思った(2 枚): 大きくてくちばしが赤い、別の種類のアヒルです。このラインのアヒルとの違いを見分けられませんでした。
- 薄い印を見落とした(1 枚): 頭のてっぺんにある薄い目の印です。
3. LoRA で学習する
LoRA は、元のモデルの重みはそのままに、小さな追加部品(アダプター)だけを学習する方法です。少ない計算量で済むので、GPU 1 枚でも学習できます。
学習には NVIDIA NeMo AutoModel を使い、公式のレシピ(NVIDIA H100 ×8 用)を GPU 1 枚用に直しました。
step_scheduler:
  global_batch_size: 8
  max_steps: 100

peft:
  _target_: nemo_automodel.components._peft.lora.PeftConfig
  exclude_modules: ["*vision_tower*", "*vision_model*", "*audio*", "*sound*", "*lm_head*", "*mlp1*"]
  dim: 64
  alpha: 128
学習率は 1e-4 で、GPU のメモリは約 78GiB 使いました。学習後はアダプターを元の重みに足し込んで(統合)、1 つのモデルにしてから vLLM で動かします。統合しておくと、推論のときにアダプターを別に読み込まなくて済みます。
おまけ(苦労したところ)
VLM に写真を送るまでの部分でも、いくつか苦労しました。
1. いつ撮るか(タイミング)
画面の中に赤い帯(検知帯)を置き、帯の中が物で埋まった割合が 0.15 以上になった瞬間に写真を 1 枚撮ります。
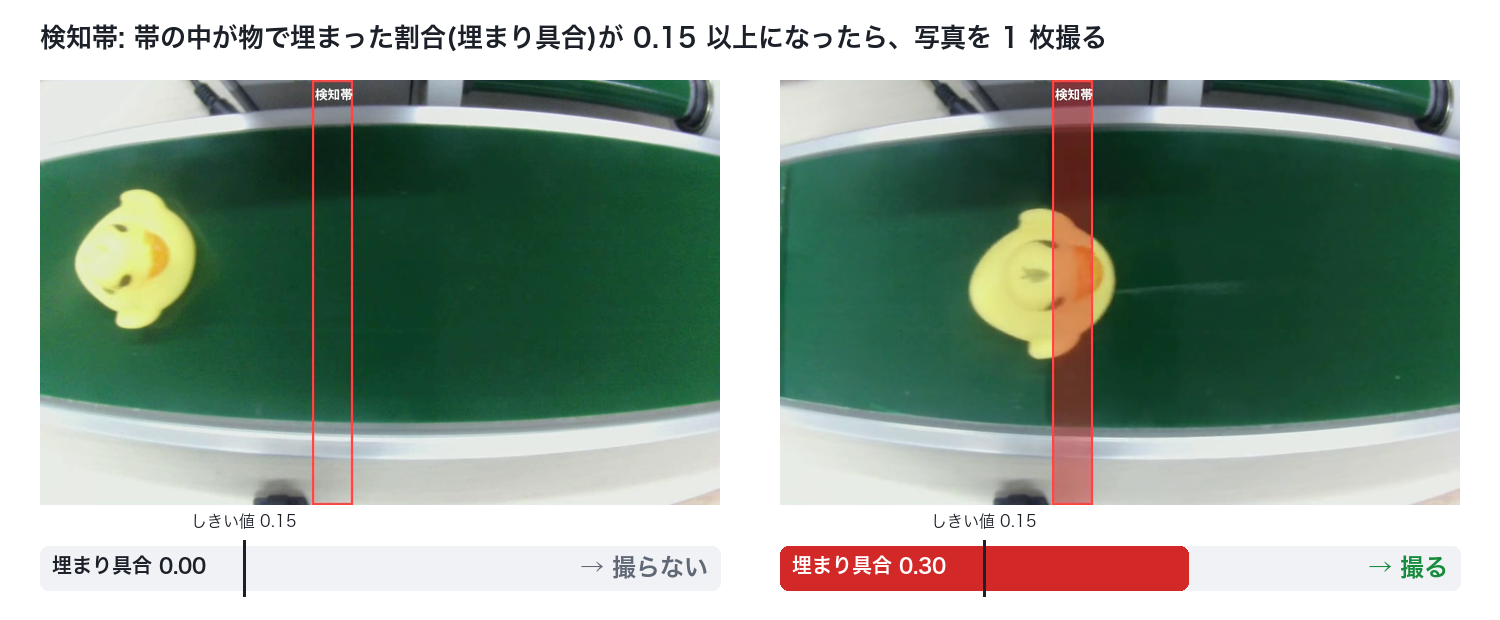
苦労したのは、何も流れていないのに「物がある」と判断して撮ってしまうことでした。照明の反射や影、カメラの明るさの自動調整でベルトの色が変わるのが原因です。そこで決まった緑の色ではなく、その場のベルトの色を覚えて比べるようにしました。
どうやって「物がある」と判断しているか
- ベルトの色を覚える: 何も載っていないベルトを約 25 秒映し、検知帯の中の色を数字にして平均します。
- 色を比べる: 毎コマ検知帯の中の点を覚えた色と比べ、大きく違う点を「物」とします。
- 割合を数える: 「物」の点の割合(埋まり具合)が 0.15 以上になったら撮ります。
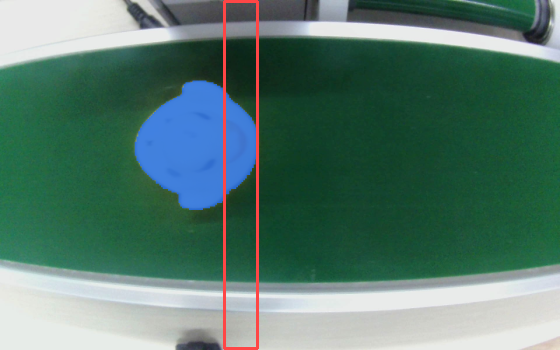
下の図の青い所が「物」、赤い枠が検知帯です。
2. どこを撮るか(範囲)
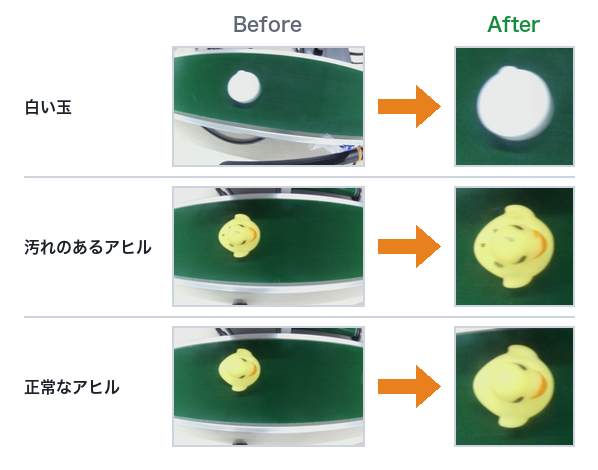
カメラにはベルトの外の物も写ります。機械の部品やケーブル、ベルトの横に置いた物、作業する人の手などです。これらが写ったまま送ると、VLM に推論させる際に誤った対象物を判定してしまうことがあります。
そこでベルトの上だけを見るようにしました。
- 検知帯はベルトの幅に合わせて置きます(最初にその場のベルトの位置と色を覚えます)。
- 切り出すのは「ベルトの緑に囲まれた物」だけです。ベルトの外にある物は緑に囲まれていないので切り出されません。
切り出しの手順は次のとおりです。
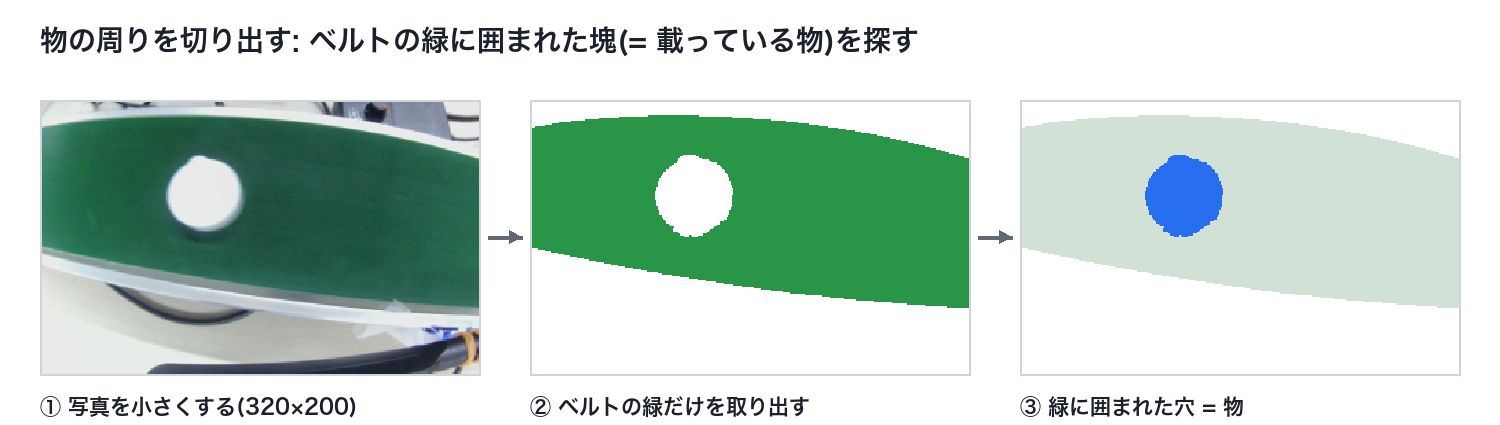
カメラの写真をそのまま送っていたとき(Before)と比べると、物が大きく写ります。