NVIDIA Agentic AI Day Japan 2026 で LLM ルーティングについて登壇しました

はじめに
こんにちは、クラスメソッド製造ビジネステクノロジー部の森茂です。
2026 年 11 月 10 日、ザ・プリンス パークタワー東京で開催された NVIDIA Agentic AI Day Japan 2026 で、「284B から 30B へ - 品質とコストを両立する本番環境向け LLM ルーティング」というタイトルで登壇しました。
講演の動画とスライドのアーカイブが、NVIDIA On-Demand のプレイリストで公開されました。自分のセッション以外にも当日の講演が全 10 本まとまっているので、あわせて覗いてみてください。
タイトルにある「284B から 30B へ」は、回答を作るモデルを小さくした話ではありません。依頼ごとに送り先のモデルを選ぶ「判定役」を、284B の DeepSeek V4 Flash 0731 から、30B の NVIDIA Nemotron 3.5 Lightning に置き換えた実践の話です。判定役を追加学習した経緯は 8 月の記事にまとめています(2026-08-16 時点の記事です)。
細かい測定条件や数字の内訳は公開アーカイブの動画とスライドにすべて入っているので、この記事では「どんな課題感から始めて、何が分かり、どこに難しさが残ったのか」をかいつまんで紹介します。モデルの使い分けで API 利用料を抑えたい方や、振り分けの判定役を自作するか迷っている方の判断材料になればうれしいです。
高性能なモデルにすべて任せると利用料が積み上がる
今回の振り分けに使ったのは、オープンソースのルーティング基盤である NVIDIA NeMo Switchyard です。エージェントとモデル提供元の間に置くことで、エージェント側からは 1 つのモデルに見せつつ、裏側で依頼ごとに送り先を切り替えられます。
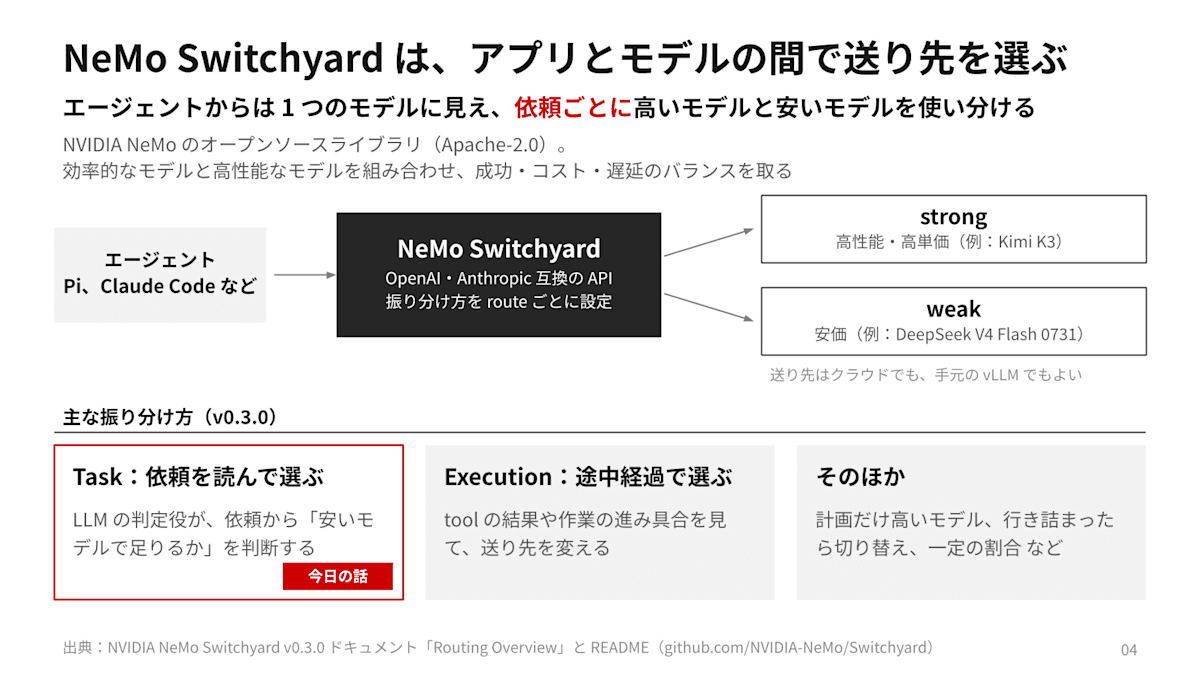
エージェントからは 1 つのモデルに見える。振り分け方は複数あり、講演で扱ったのは赤枠の「依頼を読んで選ぶ」方式。
NeMo Switchyard の設定にならって、高性能で単価の高いモデルを strong(今回は Kimi K3)、単価の安いモデルを weak(今回は DeepSeek V4 Flash 0731)と呼んでいます。モデルの優劣というより、役割分担の名前ですね。
エージェントに仕事を任せると、1 回の質問では終わりません。手元に残っていた実行ログでは、実装・レビュー・修正を 3 ラウンド回すあいだにツール呼び出しが 72 回走り、約 990 秒かかっていました。当時の確認値で 100 万トークンあたりの出力単価を比べると、strong の 15.00 USD に対して weak は 0.28 USD と 約 54 倍の開きがあります。毎回すべてを strong で受けていたら、利用料はあっという間に積み上がります。
では、安い weak はどこまで仕事をこなせるのでしょうか。評価用に用意した 12 件の仕事を両方に解かせ、モデル名を伏せて Claude に採点させてみました。
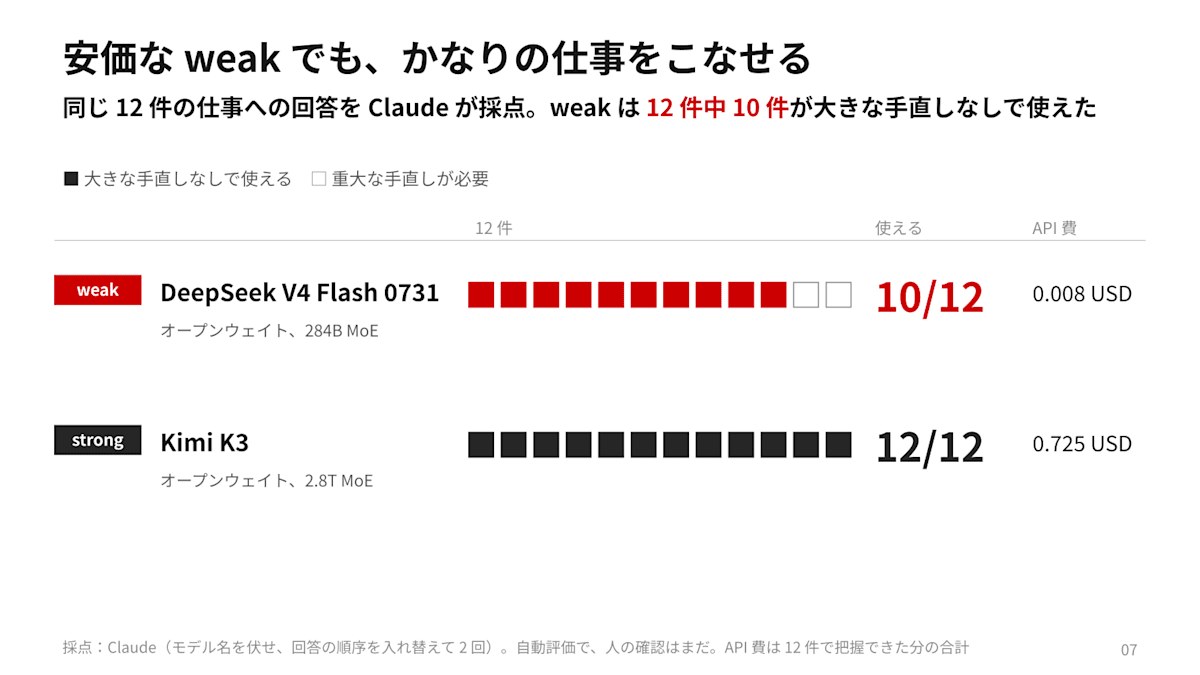
大きな手直しなしで使えた回答は、weak が 12 件中 10 件、strong が 12 件中 12 件。12 件合計の API 費用は 0.008 USD 対 0.725 USD。
結果は、weak でも 12 件中 10 件が大きな手直しなしで使える水準でした。一方で、経費の可否判定を含む問い合わせ設計やシステム移行手順の 2 件では力不足が出ています。
だからといって、無理に weak の比率を増やすのがゴールではありません。先ほどの 3 ラウンドの例を weak だけで回してみたところ、手戻りのたびに strong のレビュー代がかさんでしまいました。結果として、最初から strong 1 回で終わらせた場合と費用がほぼ変わらなかったのです。「weak では荷が重い 2 件」をどうやって入り口で見分けるかが、コストと品質を両立するカギになります。
判定役だけを 30B の Nemotron 3.5 Lightning に蒸留した
そこで選んだのが、LLM の判定役が依頼文を読んで「これは weak で足りるか」を見積もる方式です。最初は「自分が解けるかは、自分が一番よく分かるはず」という仮説を立てて、回答役の weak と同じ 284B の Flash 0731 に判定も任せていました。
ただ、判定役は本編の回答を作る前に毎回 1 度呼ばれます。284B のモデルを判定のためだけにローカルへ置くなら NVIDIA DGX Spark が 2 台埋まりますし、クラウド API 経由でも判定だけで中央値約 2.2 秒かかっていました。推論費用を節約したいのに、振り分けの関所が重すぎる状態ですね。
そこで、284B の教師モデルの判断を、総パラメータ数 30B(1 トークンごとに使う重みは 3B)の Nemotron 3.5 Lightning へ蒸留しました。
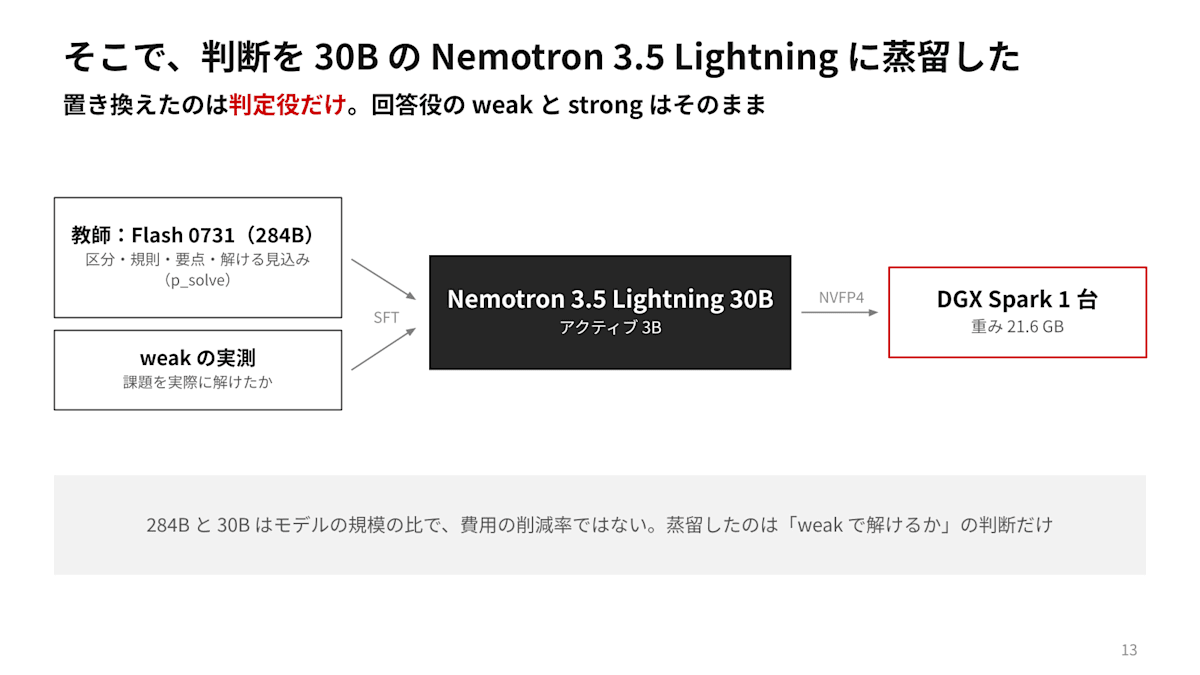
教師の判断と weak が実際に解けたかの実測を混ぜて SFT し、NVFP4 量子化で DGX Spark 1 台に載せている。
判定役には「weak で解けそうな見込み」を 0〜1 のスコア(p_solve)で出させ、閾値以上なら weak、未満なら strong へ送ります。教師の予想だけを丸写しすると教師の思い込みまで引き継いでしまうので、学習データ 1,775 件の一部には「実際に weak が課題を解けたか」の実測結果を混ぜました。学習から NVFP4 量子化までの計算は約 1 時間半で終わり、DGX Spark 1 台に収まる判定役ができあがりました。
30B に縮めても振り分けの精度は落ちなかった
284B の教師モデルと、追加学習した 30B の判定役を同じ条件で比べた結果が次の表です。
| 指標 | 教師 Flash 0731(284B) | SFT 済み Nemotron 3.5 Lightning 30B |
|---|---|---|
| 期待どおりの振り分け(実機 87 件、閾値 0.75) | 78/87 | 80/87 |
| 同上、閾値を 0.80 に調整した後 | 未測定 | 82/87 |
| weak が落とし strong が解いた 14 問を strong へ | 0/14 | 5/14 |
| 手元に置くのに要る機材 | DGX Spark 2 台 | DGX Spark 1 台 |
同じ閾値 0.75 で比べると、284B の教師が 78/87、30B の判定役が 80/87 でした。サンプル数が 87 件なので「教師を上回った」とまでは言えませんが、モデルを 10 分の 1 近くに縮めて DGX Spark 1 台へ載せても、振り分けの精度は大崩れしていません。
個人的に一番面白かったのは、表の 3 行目にある 14 問の結果です。これは Flash 0731 が 2 回続けて失敗し、Kimi K3 だけが解けた問題を学習データから外して取っておいたものです。つまり教師自身が解けない問題なのですが、教師の Flash 0731 はこの 14 問を 1 問も strong へ回せませんでした。「自分が解けるかは自分が一番分かる」という最初の仮説は、苦手を自覚できない場面ではあっさり崩れた形です。実測データを一部混ぜて学習させた 30B の判定役は、14 問中 5 問を strong へ逃がせていました。
仕事の流れに置くと「初回は慎重、修正は強気」なクセが見えた
単発の振り分け精度が分かっても、実際の仕事で元が取れるかは別問題です。そこで「実装 → レビュー → 修正(最大 3 ラウンド)」という一連の流れに NeMo Switchyard と判定役を組み込み、6 つの開発課題で試してみました。
1 回あたりの API 費用は、すべて weak の条件が 0.41 USD、すべて strong が 0.67 USD、判定役で振り分ける router が 0.54 USD と、ちょうど中間に収まりました。ただ、全体の集計以上に発見があったのは、判定ログの中身を 1 回ずつ追ってみたときです。
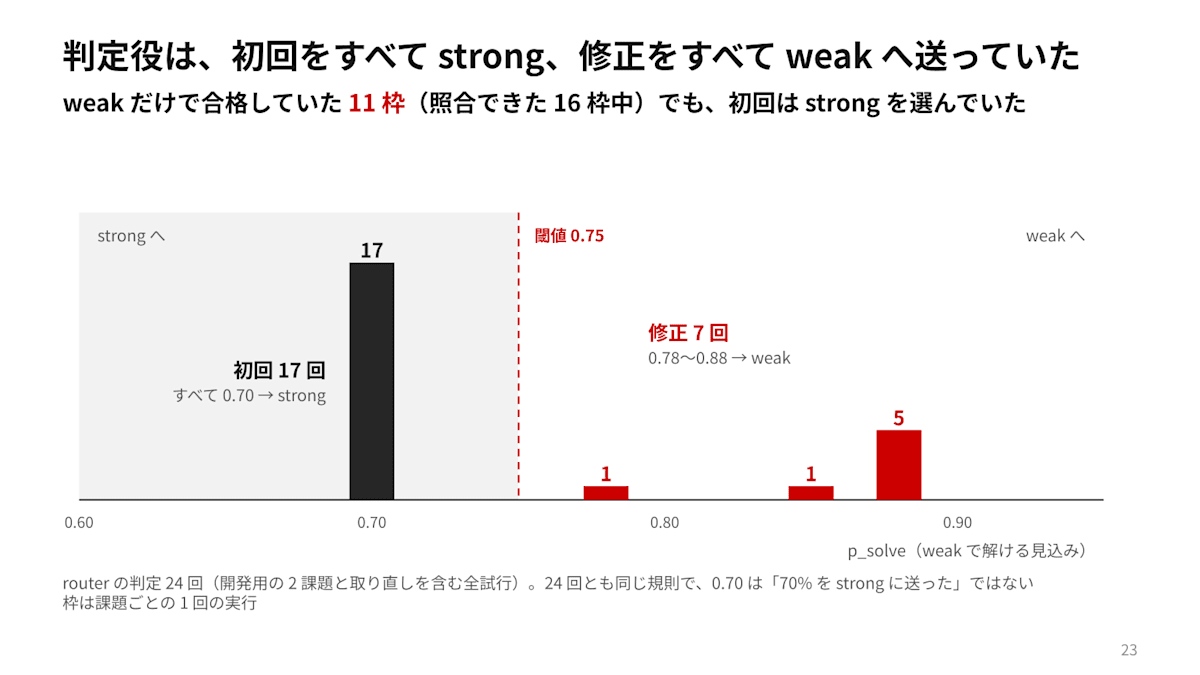
開発用の課題を含む全 24 回の判定分布。初回 17 回はすべてスコア 0.70 で strong、修正 7 回はすべて weak へ送られていた。
蓋を開けてみると、判定役は初回の実装 17 回をすべて見込みスコア 0.70 で strong へ送り、レビュー後の修正 7 回をすべて 0.78〜0.88 で weak へ送っていました。weak だけでも合格できていた課題まで、初回は軒並み安全側の strong に振っていたことになります。平均コストだけ眺めていると「うまく混ぜてくれたな」で終わってしまいますが、ログを掘るとこうした判定のクセが見えてきますね。
また、実際に動かしてみて初めて踏んだ制約もありました。仕事の途中で送り先のモデルが切り替わると、API 提供元の入力キャッシュ割引が効かなくなって入力単価が上がることがあります。修正ラウンドで会話履歴が伸び、判定役の入力上限を超えてしまった回もありました。精度以外のこうした運用上の論点も、講演ではあわせて共有しています。
同じ「修正して」でも会話の見せ方で判定が変わる
複数ターンのやりとりでは、「判定役にどこまで会話履歴を見せるか」でも挙動が大きく変わります。
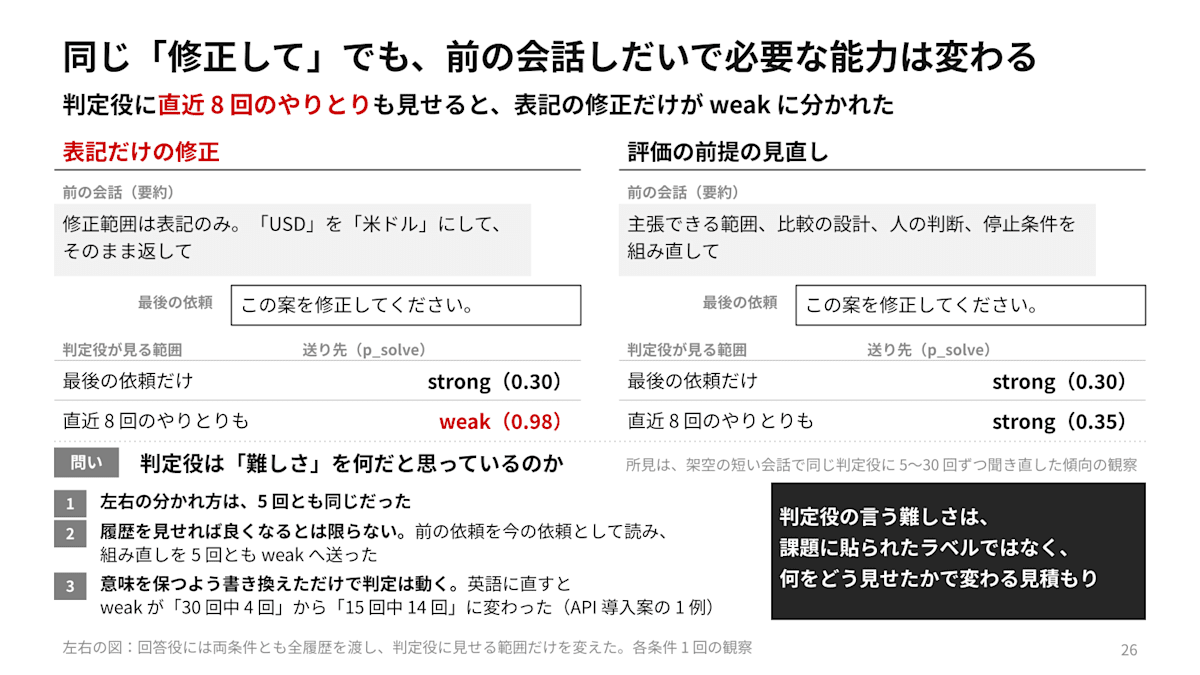
最後の依頼文は左右とも同じ。直近 8 回のやりとりも見せると、表記だけの修正は weak(0.98)に分かれ、評価の前提の見直しは strong(0.35)に残った。
たとえば最後のひと言が同じ「この案を修正してください」でも、直前の話が「USD を米ドルに直す表記修正」なのか「評価の前提からの組み直し」なのかで、必要なモデルの力は違います。最後の依頼文だけを見せるとどちらも strong 判定になりますが、直近 8 回のやりとりも見せると、表記修正だけがきれいに weak(見込み 0.98)へ分かれました。
ただ、履歴を見せれば万能かというと、そう単純でもありません。簡単な表記修正の直後に重い設計見直しを頼むと、直前のやりとりに引きずられて weak へ送ってしまうケースがありました。さらに、同じ意味の API 再設計の依頼を英語に書き換えただけで、weak 判定が 30 回中 4 回から 15 回中 14 回へ動く現象も起きています。登壇の 2 日前に手元の GPU で 1,860 判定ほど回し直してみたところ、前日は箇条書きへの書き換えで動いていた判定が、翌日は英語への書き換えで動くように入れ替わっていました。
特定のおまじないで weak に寄るというより、閾値付近では表層の言い回しだけでも判定が揺れる、というのが実態に近そうです。判定役が出す「難しさ」は課題に貼られた固定のラベルではなく、何をどう見せたかで変わる見積もりなのだと実感しました。
業務に当てはめるなら「確かめる手段がある仕事」から
講演の締めくくりでは、こうした性質を踏まえて実務へどう当てはめるかを、製造業の設備トラブル対応を例に整理しました(ここは設計案で、実機での測定前の段階です)。軸にしたのは「結果が合っているか確かめる手段があるか」という視点です。
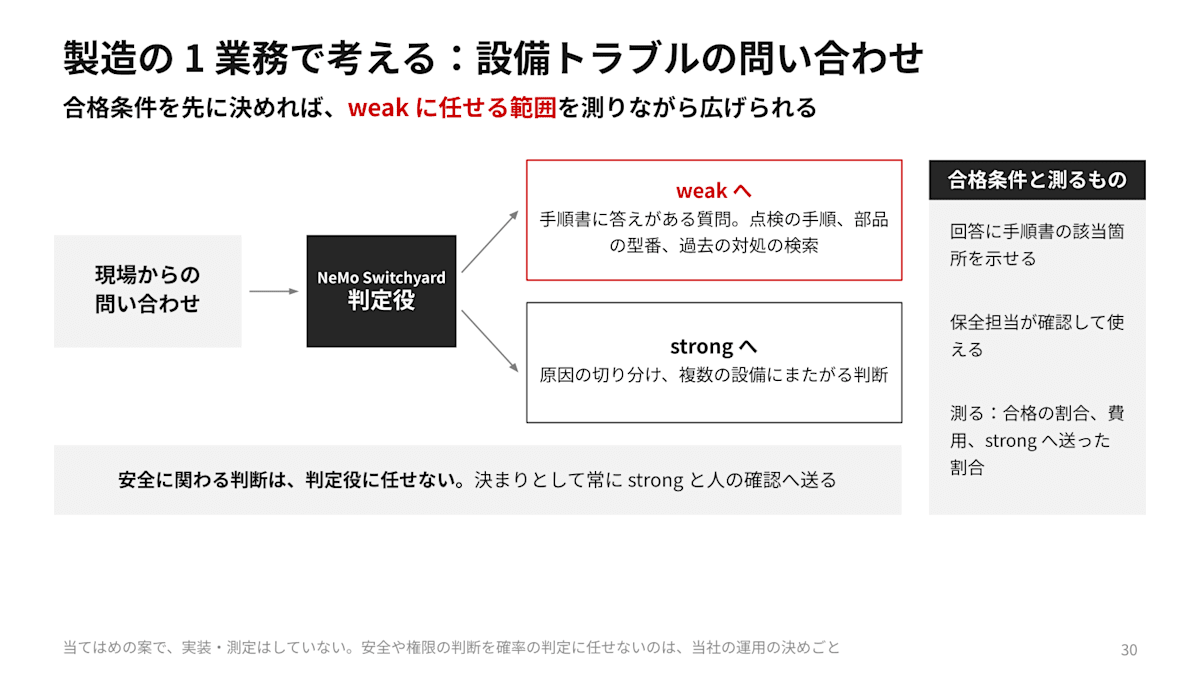
手順書に答えがある質問は weak へ、原因の切り分けや複数設備にまたがる判断は strong へ。安全に関わる判断は判定役に任せない。
手順書に答えが載っている点検手順や部品型番の確認は、回答に該当箇所を添えさせれば現場ですぐ裏が取れるので weak の候補になります。一方、複数設備にまたがる原因の切り分けは strong へ送ります。そして安全や権限に関わる判断は、確率で動く判定役には任せず、ルールとして常に strong と人の確認へ固定します。先に「どこまでできたら合格か」を決めておけば、品質と費用を測りながら少しずつ weak の担当範囲を広げていけますね。
まとめ
高いモデル一択をやめて、安いモデルで足りる仕事から移していくこと。その判定役は 284B から 30B に縮めて DGX Spark 1 台に置けること。そして単発の精度だけでなく、仕事全体の費用と判定ログまで追うこと。今回の講演でお伝えしたかったのはこの 3 点でした。
もちろん、今回の検証はまだ合成課題や短い会話が中心で、判定スコアの揺れなど残っている課題もあります。だからこそ、最初から自作ルーターやモデルの追加学習に飛びつく必要はないかなと思っています。まずは身近な 1 業務で合格ラインを決めて、安いモデルと高いモデルの合否と費用を比べるところから始めてみてください。差が見えてきたところが、判定役の出番です。
この記事では駆け足で紹介しましたが、講演本編では測定の前提や運用上の細かい論点もスライド付きで詳しく話しています。気になった方は、NVIDIA On-Demand のアーカイブから動画とスライドをぜひチェックしてみてください。
参考リンク
- Agentic AI Day Japan 2026 オンデマンド配信プレイリスト(動画・スライド)
- NVIDIA Agentic AI Day Japan 2026
- NVIDIA NeMo Switchyard — 振り分け方は
docs/routing_algorithms/overview.md - NVIDIA Nemotron 3.5 Lightning 30B-A3B
- Nemotron 3.5 Lightning を LoRA 事後学習で LLM ルーターの判定役に仕立ててみた(2026-08-16)
- Nemotron 3.5 Lightning の判定役を、Jev のように生成しない 1 トークン判定にしてみた(2026-09-23)
- 生成しない拡散モデル Nemotron Deciffusion 8B を DGX Spark で試してみた(2026-10-15)
- NVIDIA の新しい LLM ルーティング基盤 NeMo Switchyard を試してみた(2026-07-03)