NVIDIAの音声強調モデル「NemotronLabs RE-USE」を公式実装で動かしてみた(9.6Mパラメータで商用利用可)

こんちには。製造ビジネステクノロジー部の中村(@nokomoro3)です。
2026年10月22日に、NVIDIAから音声強調モデル「NVIDIA NemotronLabs RE-USE」がHugging Faceで公開されました。
雑音や残響、帯域制限などで劣化した音声を、1つのモデルで復元するモデルです。パラメータ数は9.6Mと小さく、ライセンスはOpenMDW-1.1で商用利用もできます。
RE-USEには、先に研究用として公開された非商用版や、リアルタイム処理向けのモデルもあり、名前が似ていて少し関係がわかりにくくなっています。
そこで本記事では、まずRE-USEのモデル群を整理し、そのうえで商用利用できるNemotronLabs版をNVIDIA L40Sで公式実装のまま動かし、各サンプリングレートでの速度とメモリ使用量を測りました。
結論
- モデル群
- RE-USEには、非商用の
nvidia/RE-USE、商用利用できるNVIDIA-NemotronLabs-RE-USEとその笑い声保持版、非商用でストリーミング向けのReal-time_RE-USEがある nvidia/RE-USEとNemotronLabs版は構造と設定が同じだが、学習データやモデルの重みが異なる
- RE-USEには、非商用の
- 動作確認
- L40Sで公式の推論スクリプトがそのまま動いた(公式の動作確認環境はA100)
- 環境構築では、torchとmamba_ssmのバージョンの組み合わせと、Pythonのヘッダファイルに注意が必要
- 処理速度と使用メモリ
- 5.1秒の音声の処理時間は、16kHzで0.15秒(RTF 0.030)、48kHzで0.46秒(RTF 0.090)
- 処理時間とGPUメモリはサンプリングレートにほぼ比例し、一括処理のGPUメモリは音声の長さにもほぼ比例する
- 30秒の16kHz音声では、一括処理でGPUメモリを5.3GiB使うのに対し、チャンク処理では0.9GiBで済んだ
- 注意点
- 今回公開された
NVIDIA-NemotronLabs-RE-USEは双方向Mambaのため、音声全体がそろってから処理するモデルで、ストリーミングには使えない - ストリーミング処理には、別モデルの
Real-time_RE-USEを使う必要がある(ただし非商用ライセンス) - 学習データに日本語は含まれていないため、精度は要確認
- 今回公開された
検証用コード
検証に使用したスクリプトは以下のリポジトリにあります。
RE-USEとは
モデルの特徴
RE-USEは、NVIDIAが開発したユニバーサル音声強調(Universal Speech Enhancement)のモデルです。
従来の音声強調モデルは、雑音除去、残響除去、帯域拡張のように劣化の種類ごとに作られることが多くありました。
これに対してユニバーサル音声強調は、さまざまな劣化を1つのモデルでまとめて復元することを目指しています。
モデルカードに記載されている特徴は以下のとおりです。
- 対応する劣化:加法性雑音、残響、クリッピング、帯域制限、コーデックによる劣化、パケットロス、低品質なマイク
- 対応するサンプリングレート:8、16、22.05、24、32、44.1、48kHz(入力と同じレートで出力する)
- 言語:言語に依存しない性能をうたっている(学習データは英語、ドイツ語、スペイン語、フランス語、中国語)
- 重なった発話:主話者を残し、ほかの話者を抑えるように学習されている
アーキテクチャは、畳み込みのエンコーダとデコーダの間に、時間方向のMambaと周波数方向のMambaを1組としたブロックを、30段重ねた構成です。
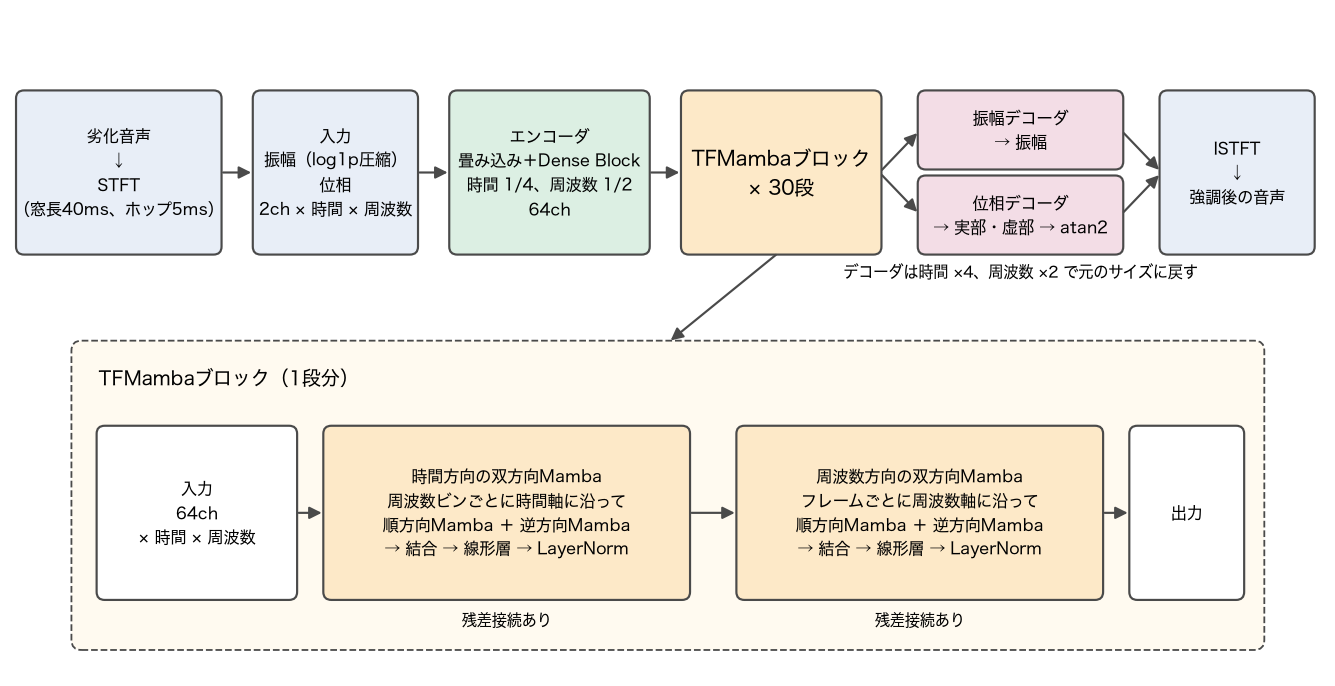
エンコーダで時間方向を1/4、周波数方向を1/2に縮めてからMambaに通し、2つのデコーダで元のサイズに戻します。
位相のデコーダは実部と虚部に相当する2つの値を出力し、atan2で位相に変換します。
入力はSTFT(短時間フーリエ変換)の振幅スペクトルと位相スペクトルで、モデルは強調後の振幅と位相の両方を推定し、逆周波数変換(ISTFT)で波形に戻します。
STFTの窓長とホップ幅(シフト長)は8kHzを基準にサンプリングレートに比例してサンプル数を増やすため、どのサンプリングレートでも1秒あたりのフレーム数は200で一定になります。
STFTでは周波数方向を一定の幅で区切り、区切った一つひとつを周波数ビンと呼びます。
RE-USEでは周波数ビンの幅が25Hzで、こちらもサンプリングレートによらず一定です。
そのため、サンプリングレートを上げると扱う周波数の上限が上がり、周波数ビンの数が増えます(16kHzで321個、48kHzで961個)。
詳細は以下の2本の論文を参照ください。
- Rethinking Training Targets, Architectures and Data Quality for Universal Speech Enhancement(NeurIPS 2026)
- One Model, Many Latencies: Universal Speech Enhancement for Diverse Real-Time Applications(IEEE SLT 2026)
RE-USEのモデル群
Hugging Faceには、RE-USEの名前を持つモデルが4つあります。
| リポジトリ | 公開日 | パラメータ数 | ライセンス | 用途 |
|---|---|---|---|---|
| nvidia/NVIDIA-NemotronLabs-RE-USE | 2026年10月22日 | 9.6M | OpenMDW-1.1(商用利用可) | 本記事の対象 |
| nvidia/NVIDIA-NemotronLabs-RE-USE-laughter | 2026年10月22日 | 9.6M | OpenMDW-1.1(商用利用可) | 笑い声を残したい場合 |
| nvidia/Real-time_RE-USE | 2026年4月14日 | 3.7M | NVIDIA One-Way Noncommercial(非商用) | ストリーミング処理 |
| nvidia/RE-USE | 2026年3月18日 | 9.6M | NVIDIA One-Way Noncommercial(非商用) | 研究開発用 |
nvidia/RE-USE のモデルカードには、商用利用する場合はNemotronLabs版を使うよう案内があります。
笑い声保持版は、学習データに笑い声などの発声を集めたVocalSoundを加えたモデルで、構造はNemotronLabs版と同じです。
Real-time_RE-USE は、ほかの3つとは別の構造を持つストリーミング向けのモデルです。
使う層の数(3〜12)と先読みするフレーム数(0〜2)の組み合わせで、1つのモデルを30通りの遅延設定で動かせます。
1フレームずつ入力して1フレームずつ出力する推論コードも付属しています。
同じ構造のモデルが非商用版と商用版に分かれている理由は、モデルカードに記載された学習データを比べると推測できます。
nvidia/RE-USE にあってNemotronLabs版にないデータセットは、以下の4つです。
| データセット | 用途 | ライセンス |
|---|---|---|
| EARS(約100時間) | 音声 | CC-NC 4.0 |
| WHAM! Noise(約80時間) | 雑音 | CC BY-NC 4.0 |
| FSD50K(約100時間) | 音声以外の音 | 全体はCC BYだが、CC BY-NCのクリップを含む |
| Free Music Archive(約200時間) | 音楽 | 楽曲ごとにアーティストが選んだライセンス(研究目的のデータセット) |
どれも、商用利用に何らかの制限があるデータセットです。
代わりにNemotronLabs版では、NVIDIAの社内データセット(Riva Speakers)が追加されています。
非商用である理由はモデルカードに明記されてないものの、商用利用に制限のあるデータを除き、社内データで補って学習し直したものがNemotronLabs版と推測されます。
NemotronLabs版の公開後、コミュニティによる変換版も次々に公開されています。
2026年11月6日時点で、NemotronLabs版の重みから変換されたものには以下があります。
| リポジトリ | 形式と実行環境 |
|---|---|
| audio-cpp/RE-USE-GGUF | audio.cpp用のGGUF(reuse-nemotronlabs-f32.gguf、reuse-laughter-f32.gguf) |
| sakasegawa/NVIDIA-NemotronLabs-RE-USE-GGUF | speech.cpp専用のGGUF |
| AILogDev/RE-USE-MLX-CoreML | MacとiPhone向けのMLXとCore ML(Swift SDKから利用、16kHzのみ) |
| litert-community/NVIDIA-NemotronLabs-RE-USE-LiteRT | Android向けのLiteRT |
| cdismus4/NVIDIA-NemotronLabs-RE-USE-WebGPU | ブラウザで動くWebGPU版 |
一方で、非商用の nvidia/RE-USE から変換されたものも残っています(appautomaton/re-use-semamba-mlx や、audio-cpp/RE-USE-GGUF の reuse-f32.gguf など)。
同じリポジトリに両方のファイルが置かれている場合もあるため、商用で使う場合は、変換元のモデルとファイルごとのライセンスを確認しておく必要がありそうです。
モデルカードのベンチマーク
モデルカードには、URGENT 2025 Challengeのnon-blindテストセットで、ほかのオープンなユニバーサル音声強調モデルと比べた結果が掲載されています。
以下は全体セットの結果で、数値はいずれもNVIDIAによる評価です。
| モデル | パラメータ数 | DNSMOS | NISQA | UTMOS | PESQ | STOI | SBERT | LPS | Spk | CAcc |
|---|---|---|---|---|---|---|---|---|---|---|
| 劣化音声(処理なし) | - | 1.84 | 1.69 | 1.56 | 1.34 | 0.50 | 0.74 | 0.61 | 0.73 | 81.29 |
| Sidon | 250M | 3.34 | 3.87 | 3.21 | 1.73 | 0.62 | 0.85 | 0.80 | 0.74 | 84.68 |
| UniPASE | 500M | 3.21 | 4.03 | 2.96 | 2.17 | 0.76 | 0.89 | 0.85 | 0.81 | 87.28 |
| NemotronLabs RE-USE | 9.6M | 3.29 | 4.33 | 2.94 | 2.57 | 0.78 | 0.88 | 0.85 | 0.86 | 89.17 |
指標は大きく3種類に分かれます。
- 音質の推定値:DNSMOS、NISQA、UTMOSは、人が聞いて付けた主観評価(MOS)を予測するモデルによるスコアで、元音声がなくても計算できる
- 元音声との一致度:PESQ、STOIは、劣化前のきれいな音声とどれだけ近いかを測る
- 内容と話者の保存:SBERT(SpeechBERTScore)、LPS(音素の一致度)、Spk(話者の類似度)、CAcc(OWSM v3.1による音声認識の文字正解率)
RE-USEは、音質の推定値では指標によって順位が分かれますが(NISQAは最も高く、DNSMOSとUTMOSはSidonを下回る)、元音声との一致度と、内容や話者の保存ではほぼすべての指標で最も良い結果です。
パラメータ数がSidonの約26分の1、UniPASEの約52分の1であることを考えると、小さなモデルで忠実さを保てている点が特徴だと言えそうです。
モデルカードには16kHz、44.1kHz、48kHzのサブセットごとの結果もあり、44.1kHzと48kHzのサブセットでは比較対象(Resemble Enhance、ClearVoice)をすべての指標で上回っています。
実行環境
それでは実行環境を整えていきます。
Brevのインスタンス
実行環境には、前回の日本語ASRの比較記事と同じく、NVIDIA BrevでL40Sを1基持つインスタンス(l40s-48gb.1x)を使いました。
以下がインスタンスを起動するコマンドです。
brev create cm-nakamura-re-use --type l40s-48gb.1x
モデルカードで動作確認されているGPUはA100(Ampere世代)ですが、L40S(Ada Lovelace世代)でも問題なく動きました。
インスタンスへは brev shell で接続できます。
brev shell cm-nakamura-re-use
環境のセットアップ、推論、速度測定はBrevのインスタンスに接続して実行し、入力音声の作成とスペクトログラムの描画は手元で行いました。
手元での準備
手元では、検証用のリポジトリを取得し、速度測定に使う入力音声を作っておきます。
入力音声は、モデルに付属するサンプル音声を各サンプリングレートにリサンプルしたものと、16kHzのサンプルを6回つないだ約30秒の音声です。
git clone https://github.com/cm-nakamura-shogo/blog-nvidia-nemotronlabs-re-use
cd blog-nvidia-nemotronlabs-re-use

# 付属のサンプル音声だけを、revisionを固定して取得する(models/original/noisy_audio)
uv run --no-project --with "huggingface_hub<2" python -c '
from huggingface_hub import snapshot_download
snapshot_download("nvidia/NVIDIA-NemotronLabs-RE-USE",
                  revision="31f82f2efad1095034492f236e8dac9239ba713b",
                  allow_patterns=["noisy_audio/*"], local_dir="models/original")'

# 入力音声を作る(work/inputs)
uv run --no-project --with numpy,soundfile,soxr==1.1.0 python scripts/make_inputs.py
--no-project を付けているのは、リポジトリの pyproject.toml がMac版(MLX)の依存関係を含んでおり、Apple SiliconのMac以外では解決できないためです。
手元とBrevのファイルのやり取り
手元とのファイルのやり取りには brev copy を使います。
手元からBrevへの送信は、スクリプトと入力音声を一時ディレクトリにまとめてから送るスクリプトにしています。
Brevから手元への取得は、結果を1つのファイルにまとめてから取ってきます。
# 手元 → Brev:スクリプトと入力音声を /home/ubuntu/re-use に送る
bash scripts/host/sync_to_brev.sh

# Brev → 手元:推論結果を1つのファイルにまとめてから取ってくる
brev exec cm-nakamura-re-use "cd /home/ubuntu/re-use && tar czf /tmp/torch.tgz work/torch"
brev copy cm-nakamura-re-use:/tmp/torch.tgz work/torch.tgz
tar xzf work/torch.tgz
sync_to_brev.sh の中身は、送り先のディレクトリを brev exec で作ってから、brev copy で送るだけです。
使い終わったら brev stop cm-nakamura-re-use でインスタンスを停止しておきます。
ソフトウェアのバージョン
各ソフトウェアのバージョンは以下の通りです。
| 項目 | バージョン |
|---|---|
| GPU | NVIDIA L40S(48GB) |
| NVIDIAドライバ | 565.57.01 |
| Python | 3.10(uvが管理するPython) |
| PyTorch | 2.6.0+cu124 |
| mamba_ssm | 2.2.4 |
| causal-conv1d | 1.5.0.post8 |
| モデルのrevision | 31f82f2efad1095034492f236e8dac9239ba713b |
モデルカードでは、Mambaの環境構築にSEMambaのリポジトリで配布されているDockerイメージが案内されています。
今回は、mamba_ssmとcausal-conv1dの公式リリースにあるビルド済みのwheelを使い、uvの仮想環境に直接インストールしました。
セットアップコマンド
前述のソフトウェアのバージョンをセットアップするコマンドは以下です。
ここからは、brev shell で接続したBrevのインスタンス上で実行します。
cd /home/ubuntu/re-use

# Brevには uv が入っていないため、最初にインストールする
curl -LsSf https://astral.sh/uv/0.13.4/install.sh | sh
export PATH="$HOME/.local/bin:$PATH"

uv venv --managed-python --python 3.10 work/.venv-gpu
source work/.venv-gpu/bin/activate

# 分割してインストールすると後段で torch が新しい版に上がるため、一括でインストールする
uv pip install \
  --extra-index-url https://download.pytorch.org/whl/cu124 \
  --index-strategy unsafe-best-match \
  "torch==2.6.0+cu124" "torchaudio==2.6.0+cu124" \
  "causal_conv1d @ https://github.com/Dao-AILab/causal-conv1d/releases/download/v1.5.0.post8/causal_conv1d-1.5.0.post8+cu12torch2.6cxx11abiFALSE-cp310-cp310-linux_x86_64.whl" \
  "mamba_ssm @ https://github.com/state-spaces/mamba/releases/download/v2.2.4/mamba_ssm-2.2.4+cu12torch2.6cxx11abiFALSE-cp310-cp310-linux_x86_64.whl" \
  einops safetensors soundfile numpy pyyaml librosa resampy "huggingface_hub<1" "transformers<5"
執筆時点で最新のmamba_ssm 2.3.2.post1はtriton 3.5以上を要求し、torch 2.6が要求するtriton 3.2と両立しません。
そのためtorch 2.6向けのwheelが配布されているmamba_ssm 2.2.4とcausal-conv1d 1.5.0.post8に下げました。
また、mamba_ssmを読み込むと、tritonが実行時に小さなC拡張をビルドします。
Brevのシステムにデフォルトで入っているPython 3.10には開発用ヘッダ(Python.h)がなく、このビルドが失敗します。
ヘッダを同梱しているuv管理のPython(--managed-python)で仮想環境を作り直すと動きました。
モデルのダウンロード
RE-USEのモデルは、revisionを固定してダウンロードしました(Brevの /home/ubuntu/re-use で、仮想環境を有効にした状態で実行します)。
python - <<'EOF'
from huggingface_hub import snapshot_download

snapshot_download(
    "nvidia/NVIDIA-NemotronLabs-RE-USE",
    revision="31f82f2efad1095034492f236e8dac9239ba713b",
    local_dir="models/original",
)
EOF
ここまでのセットアップ(uvのインストール、仮想環境の作成、パッケージのインストール、モデルのダウンロード)は、リポジトリの scripts/gpu/setup_brev.sh にまとめています。
推論の実行
公式スクリプトでの推論
リポジトリには、推論用のシェルスクリプトが2つ含まれています。
inference.sh:noisy_audio/の音声を1ファイルずつ丸ごと処理し、enhanced_audio/にFLACで保存するinference_chunk.sh:long_noisy_audio/の音声を5秒ずつ半分重ねて区切って処理し、結果をHann窓で重ね合わせる
inference_chunk.sh は長い音声向けで、モデルカードでは30秒を超える音声やGPUメモリが足りない場合にこちらを使うよう案内されています。
付属のサンプル音声は5.1秒と短いため、今回は inference.sh を実行しています。
cd models/original
sh inference.sh
Initializing Inference Process...
./noisy_audio/mic_test2.wav
処理結果
付属のサンプル(44.1kHz、5.1秒)について、処理前後のスペクトログラムを並べました。
図は、Brevから手元に取ってきた音声を、matplotlibの specgram(FFT長2048、重なり1536サンプル)で描いたものです。
処理後の音声には、後述の速度測定で出力した work/torch/rates/mic_test2_44100.wav を使っています(inference.sh の出力とは、コサイン類似度0.9999999で一致することを確認済みです)。
手元で、速度測定の結果を取ってきたあとに実行します。
uv run --no-project --with matplotlib,numpy,soundfile python scripts/plot_spectrogram.py \
  models/original/noisy_audio/mic_test2.wav work/torch/rates/mic_test2_44100.wav \
  --labels "入力(公式サンプル mic_test2.wav、44.1kHz)" "RE-USEの出力(公式実装、L40S)" \
  --out results/figures/mic_test2_official.png
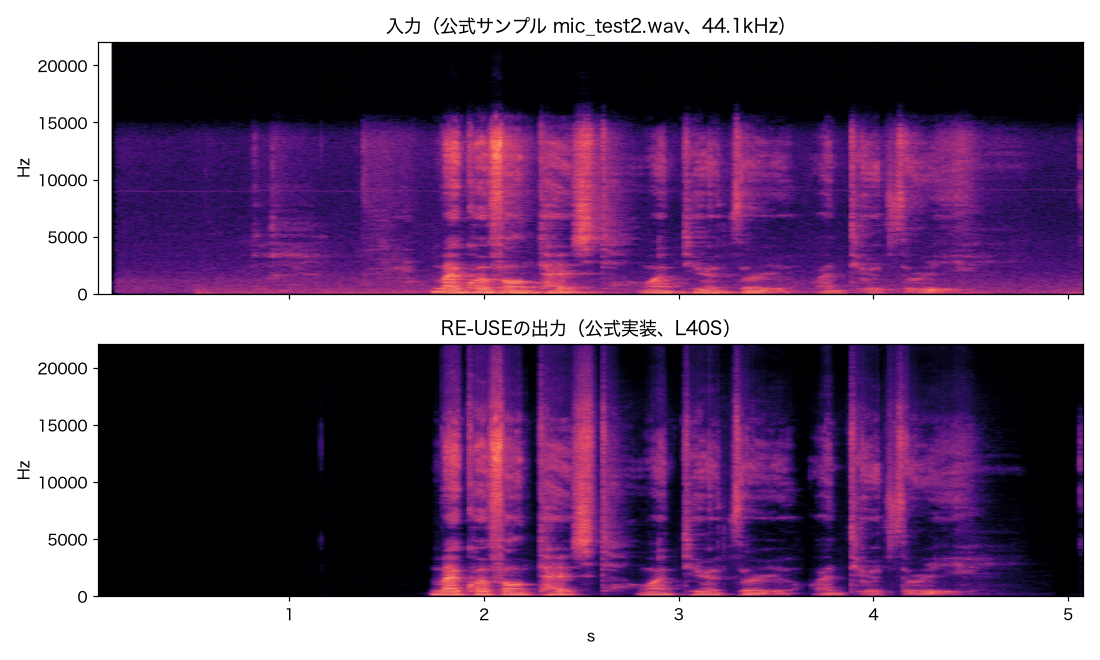
発話が始まる前(0〜1.7秒)の雑音と、発話の間の背景雑音がほぼ消えています。
入力に見える9kHz付近の横線(定常的なハム音)もなくなっていることがわかります。
もう1つ目に付くのは、高い周波数の成分です。
入力は約15kHzより上が切れていますが、出力には22kHz付近まで成分があります。
帯域拡張のオプション(--BWE)を指定していなくても、帯域が制限された入力に対しては、失われた高域を補って出力するようです。
動作オプション
inference.sh と inference_chunk.sh は、それぞれ inference.py と inference_chunk.py に引数を渡して呼び出すだけのスクリプトです。
inference.sh の中身は以下のとおりです。
CUDA_VISIBLE_DEVICES='0' python ./inference.py \
   --input_folder ./noisy_audio \
   --output_folder ./enhanced_audio \
   --config ./recipes/USEMamba_30x1_lr_00002_norm_05_vq_065_nfft_320_hop_40_NRIR_012_pha_0005_com_04_early_001.yaml \
   #--BWE 32000 \
指定できる引数は以下のとおりです。
| 引数 | 対象 | 意味 |
|---|---|---|
--input_folder |
両方 | 入力フォルダ。サブフォルダも含めて、中のファイルをすべて処理する(読めないファイルは警告を出して飛ばす) |
--output_folder |
両方 | 出力フォルダ。入力と同じフォルダ構成で、FLACとして保存する |
--config |
両方 | 学習時の設定ファイル(recipes/ 以下のYAML)。STFTの設定などをここから読む |
--BWE |
両方 | 帯域拡張の目標サンプリングレート(例:32000)。入力をこのレートにリサンプルしてから処理し、出力もこのレートになる |
--chunk_size_in_seconds |
チャンク処理のみ | 1区間の長さ(秒)。inference_chunk.sh の既定値は5 |
--hop_length_portion |
チャンク処理のみ | 区間をずらす幅の、区間長に対する割合。inference_chunk.sh の既定値は0.5(半分ずつ重なる) |
--BWE は、低いサンプリングレートの音声を高いレートで出力したい場合に使います。
たとえば8kHzの電話音声に --BWE 32000 を指定すると、32kHzにリサンプルしたうえでモデルに通すため、失われた高域を補った32kHzの音声として出力されます(今回は試していません)。
注意点が2つあります。
1つ目は、重みの読み込み先です。
inference.py は、ダウンロードしたフォルダの model.safetensors ではなく、SEMamba.from_pretrained("nvidia/NVIDIA-NemotronLabs-RE-USE") でHugging Face Hubから重みを取得します。
そのため、初回の実行にはネットワーク接続が必要で、ダウンロード時にrevisionを固定していても、推論で使われるのは実行時点のHubの最新(main)の重みです。
revisionを固定したい場合は、ローカルの model.safetensors を読み込むようにスクリプトを書き換える必要があります(今回の速度測定のスクリプトでは書き換えています)。
2つ目は、チャンク処理の出力フォルダです。
モデルカードには Long_enhanced_audio/ とありますが、inference_chunk.sh の実際の出力先は long_enhanced_audio/(小文字)です。
速度とメモリ使用量の測定
測定方法
速度を測るため、公式スクリプトと同じ処理を繰り返し行うスクリプト scripts/gpu/torch_reference.py を用意しました。
公式の inference.py との違いは、出力を16bitのFLACではなく32bit浮動小数点のWAVで保存する点、同じ入力を繰り返し処理して時間を測る点、TF32を無効にしている点です。
TF32(TensorFloat-32)は、Ampere世代以降のNVIDIA GPUが持つ演算形式で、FP32の行列積や畳み込みを、精度を落とす代わりに高速に計算します。
PyTorchの既定では、行列積では無効、cuDNNによる畳み込みでは有効になっています。
今回はFP32本来の精度で比べるため、どちらも無効にしました。
公式スクリプトの出力とは、コサイン類似度0.9999999で一致することを確認しています(差はFLACの量子化誤差程度)。
測定は、Brevの /home/ubuntu/re-use で次のスクリプトを実行して行いました。
各サンプリングレートでの測定、30秒の音声での一括処理とチャンク処理の比較、TF32を有効にした場合の測定、inference.sh の出力との照合をまとめて行います。
結果は work/torch/ と results/ に保存されます。
bash scripts/gpu/run_reference.sh
測定条件は以下のとおりです。
- 入力:付属のサンプルを、soxrで各サンプリングレートにリサンプルした音声(5.1秒)
- 計測範囲:STFTからモデルの推論、ISTFTまで(モデルのロードとファイルの読み書きは含まない)
- 回数:同じ入力を6回処理し、初回を除いた5回の中央値
- メモリ:PyTorchのアロケータが確保した最大量(
torch.cuda.max_memory_allocated) - 精度:FP32(TF32は無効)
RTF(Real Time Factor)は、処理時間を音声の長さで割った値です。
1より小さければ、音声の長さより短い時間で処理できます。
サンプリングレートごとの結果
| サンプリングレート | 処理時間 | RTF | GPUメモリ |
|---|---|---|---|
| 8kHz | 0.082秒 | 0.016 | 0.49GiB |
| 16kHz | 0.153秒 | 0.030 | 0.92GiB |
| 22.05kHz | 0.230秒 | 0.045 | 1.25GiB |
| 24kHz | 0.227秒 | 0.045 | 1.35GiB |
| 32kHz | 0.309秒 | 0.061 | 1.78GiB |
| 44.1kHz | 0.471秒 | 0.092 | 2.45GiB |
| 48kHz | 0.462秒 | 0.091 | 2.65GiB |
処理時間とGPUメモリは、どちらもサンプリングレートにほぼ比例しています。
前述のとおり、1秒あたりのフレーム数はサンプリングレートによらず一定で、周波数ビンの数だけがサンプリングレートに比例して増えるためです。
48kHzでもRTFは0.09で、音声の長さの10分の1以下の時間で処理できています。
参考として、行列積と畳み込みの両方でTF32を有効にした場合も測りましたが、処理時間の短縮は5〜18%にとどまりました。
長い音声での一括処理とチャンク処理
16kHzのサンプルを6回つないだ30.6秒の音声で、一括処理とチャンク処理(5秒ずつ半分重ねる、公式スクリプトの既定値)を比べました。
| 処理方法 | 処理時間 | RTF | GPUメモリ |
|---|---|---|---|
一括処理(inference.py 相当) |
1.15秒 | 0.038 | 5.28GiB |
チャンク処理(inference_chunk.py 相当) |
1.95秒 | 0.064 | 0.91GiB |
一括処理のGPUメモリは、5.1秒のときの0.92GiBから5.28GiBに増えており、音声の長さにほぼ比例しています。
チャンク処理は区間を半分ずつ重ねるため、処理する音声の量が約2倍になり、処理時間も約1.7倍になりました。
一方で、GPUメモリは音声の長さによらず5秒ぶんで済みます。
数分を超える音声を扱う場合や、GPUメモリが小さい環境では、チャンク処理を使うことでGPUメモリ消費量を抑えられそうです。
使用上の注意点
まず、NemotronLabs版はストリーミング処理に使えません。
時間方向のMambaが双方向で、未来側からも音声を参照するため、音声全体がそろわないと出力を確定できない構造です。
チャンク処理を使っても、5秒の区間がそろうまで待つことになります。
ストリーミング向けには Real-time_RE-USE がありますが、こちらは非商用ライセンスとなっています。
次に、重なった発話の扱いです。
主話者を残してほかの話者を抑えるように学習されているため、複数人が話す会議の録音などでは、主話者以外の声が弱まる可能性があります。
話者分離や議事録作成の前処理に使う場合は、事前に確認が必要です。
最後に、日本語は学習データに含まれていません。
言語に依存しない性能をうたっていますが、日本語での効果は自分で確かめる必要があります。
まとめ
NVIDIAの音声強調モデルNemotronLabs RE-USEについて、モデル群を整理し、公式実装をL40Sで動かしました。
9.6Mパラメータと小さく、48kHzの音声でもRTF 0.09で処理でき、商用利用もできるため、録音の品質改善や音声処理の前段に組み込みやすいモデルです。
モデル群の中では、nvidia/RE-USE とNemotronLabs版の重みが別物である点と、ストリーミング向けのモデルが非商用である点に注意が必要です。
日本語音声認識の前処理としての効果は不明(悪化する可能性もある)なのですが、人間が後で聞き直す際とかには有効に使えるかと思います。
本記事がご参考になれば幸いです。
参考リンク
- nvidia/NVIDIA-NemotronLabs-RE-USE(Hugging Face)
- nvidia/NVIDIA-NemotronLabs-RE-USE-laughter(Hugging Face)
- nvidia/RE-USE(Hugging Face)
- nvidia/Real-time_RE-USE(Hugging Face)
- Rethinking Training Targets, Architectures and Data Quality for Universal Speech Enhancement(arXiv)
- One Model, Many Latencies: Universal Speech Enhancement for Diverse Real-Time Applications(arXiv)
- state-spaces/mamba(GitHub)
- 前回の記事:NVIDIA L40Sで日本語対応ASRモデルを比較してみた