【RDS for PostgreSQL】Database Insights で負荷の高いクエリを見つけて index を張るまでの一連の流れを試してみた

Database Insights の使い方を学ぶために、わざと遅くなる状況を作って試してみました。
流れは以下のとおりです。
- index の無いテーブルに負荷をかける
- Database Insights で、負荷の高いクエリを見つける
- EXPLAIN で、負荷が高い理由を確認する
- index を追加して、同じ負荷で改善を確認する
RDS インスタンスの作成
以下の構成で RDS for PostgreSQL を作成しました。
| 項目 | 設定 |
|---|---|
| リージョン | ap-northeast-1(東京) |
| エンジン | PostgreSQL 17.10 |
| インスタンスクラス | db.m6g.large(2 vCPU / 8 GiB) |
| ストレージ | 汎用 SSD (gp3) 20 GiB |
| マルチ AZ | なし |
| モニタリング | Database Insights - 標準 |
また、RDS と同じ VPC 内に RDS アクセス用の EC2 も作っておきます。
EC2 には下記ブログを参考に PostgreSQL をインストールしておきます。(これをすることで EC2 から後述の pgbench ツールが使えるようになります。)
サンプルDBの作成
EC2 から RDS の接続先エンドポイントを指定して接続。
$ psql -h <RDSのエンドポイント> -U postgres -d postgres

...

postgres=> SELECT version();
                                                    version
---------------------------------------------------------------------------------------------------------------
 PostgreSQL 17.10 on aarch64-unknown-linux-gnu, compiled by aarch64-unknown-linux-gnu-gcc (GCC) 12.4.0, 64-bit
(1 row)
検証用のサンプル DB を作成します。
-- サンプル DB 作成
postgres=> CREATE DATABASE blog_sample_db;
CREATE DATABASE

-- DB 切り替え
postgres=> \c blog_sample_db
SSL connection (protocol: TLSv1.3, cipher: TLS_AES_256_GCM_SHA384, compression: off, ALPN: postgresql)
You are now connected to database "blog_sample_db" as user "postgres".

-- 注文テーブルを想定した 300 万行のテーブルを作成
-- ※ customer_id に index は作成しない(あとで index 無しの遅さを確認するため)
blog_sample_db=> CREATE TABLE orders AS
SELECT g AS order_id,                           -- 注文ID(連番)
       (random()*100000)::int AS customer_id,   -- 顧客ID(ランダム値)
       (random()*1000)::int AS amount           -- 金額(ランダム値)
FROM generate_series(1, 3000000) g;             -- 300 万行分を生成
SELECT 3000000

-- テーブルの統計情報(行数や値の分布)を更新
blog_sample_db=> ANALYZE orders;
ANALYZE

-- 作成した orders テーブルの最初と最後の3行を表示
blog_sample_db=> (SELECT * FROM orders ORDER BY order_id ASC  LIMIT 3)
UNION ALL
(SELECT * FROM orders ORDER BY order_id DESC LIMIT 3);
 order_id | customer_id | amount
----------+-------------+--------
        1 |       11846 |    803
        2 |       26822 |    597
        3 |       34804 |     29
  3000000 |       74301 |    440
  2999999 |       95633 |    494
  2999998 |       14675 |    828
(6 rows)

-- 行数と顧客ID数の確認
blog_sample_db=> SELECT count(*) AS 行数,
                        count(DISTINCT customer_id) AS 顧客id数
                        FROM orders;
  行数   | 顧客id数
---------+----------
 3000000 |   100001
(1 row)
現在 orders テーブルにはインデックスは作られていない状態です。
blog_sample_db=> \d orders
                 Table "public.orders"
   Column    |  Type   | Collation | Nullable | Default
-------------+---------+-----------+----------+---------
 order_id    | integer |           |          |
 customer_id | integer |           |          |
 amount      | integer |           |          |
負荷の想定状況
PostgreSQL 付属のベンチマークツール pgbench を使い、クライアントアプリから「顧客ID で注文を検索する」アクセスが続く状況を再現します。
orders テーブルの customer_id には index が無いため、検索のたびに 300 万行を全件読むことになり、RDS の負荷が上がるはずです。
 pgbench(アプリ利用者の代わり)
   ├─ 利用者1 ─┐
   ├─ 利用者2 ─┤  顧客IDで検索 ×繰り返し
   ├─  ...    ─┤ ───────────────▶  RDS(orders: index なし)
   └─ 利用者8 ─┘                    毎回300万行を読む → 負荷上昇
pgbench の準備
EC2 に PostgreSQL クライアントを入れていれば、pgbench も一緒に入っています。
$ which pgbench
/usr/bin/pgbench

$ pgbench --version
pgbench (PostgreSQL) 17.10
負荷をかけていく
検索用の SQL を作成
顧客IDをランダムに選び、その顧客の注文件数と金額合計を取得する SQL ファイルを作ります。
$ cat > ./search.sql <<'EOF'
\set cid random(1, 100000)
SELECT count(*), sum(amount) FROM orders WHERE customer_id = :cid;
EOF
pgbench を実行
pgbench を利用し、8 接続で 5 分間、前述の SQL ファイルの内容を繰り返し実行させます。
$ pgbench -h <RDSのエンドポイント> -U postgres -n -f ./search.sql -c 8 -j 2 -T 300 blog_sample_db
| オプション | 意味 |
|---|---|
| -f | 実行する SQL ファイル |
| -c 8 | 同時接続数 |
| -j 2 | pgbench のスレッド数 |
| -T 300 | 実行時間(秒) |
実行すると 5 分間カーソルが戻らず、終わると次の結果が表示されます。
$ pgbench -h <RDSのエンドポイント> -U postgres -n -f ./search.sql -c 8 -j 2 -T 300 blog_sample_db
Password:
pgbench (17.10)
transaction type: ./search.sql
scaling factor: 1
query mode: simple
number of clients: 8
number of threads: 2
maximum number of tries: 1
duration: 300 s
number of transactions actually processed: 3108
number of failed transactions: 0 (0.000%)
latency average = 773.183 ms
initial connection time = 99.782 ms
tps = 10.346840 (without initial connection time)
注目する項目は次の 3 つです。
number of transactions actually processed:5 分間で完了した検索処理は 3,108 回latency average:1 回あたりの平均は約 0.77 秒tps:1 秒あたり約 10 回
この値を、index 追加後と比較するための基準にします。
Database Insights で原因を特定する
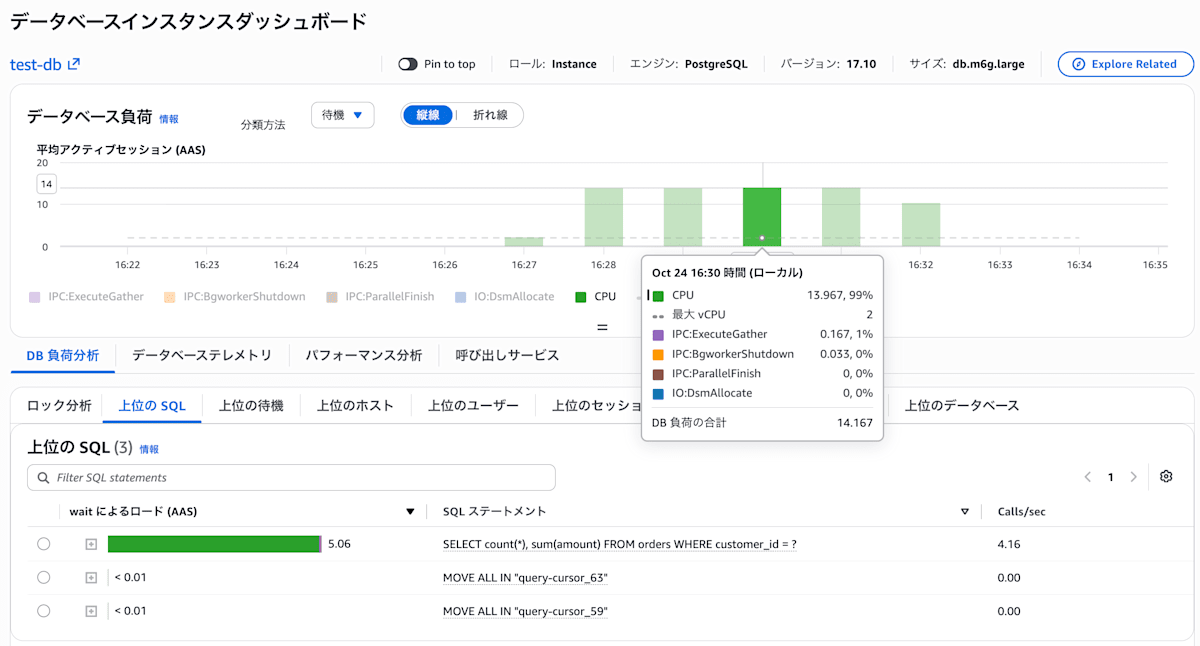
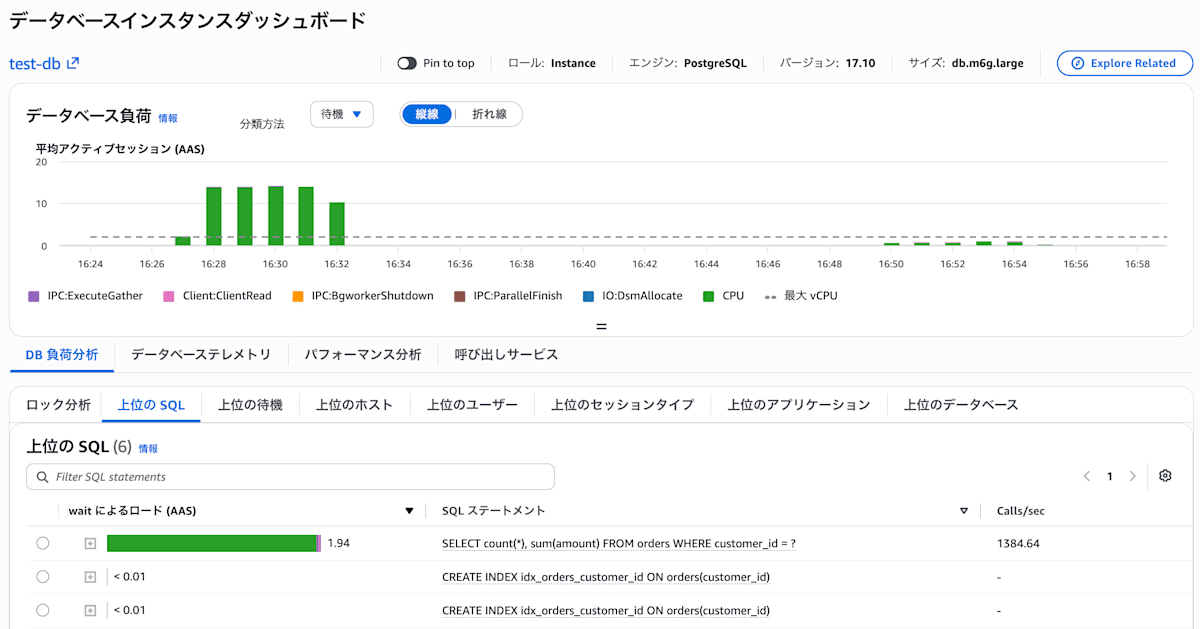
負荷をかけている間の、Database Insights のダッシュボードです。
まず DB 負荷を見る
画像上部のグラフが DB 負荷(平均アクティブセッション数)です。点線は RDS の vCPU 数(2)で、これを超えていると負荷が高い目安になります。
- 16:27 ごろから負荷が上がり、16:28〜16:31 は約 14 で推移
- 点線(vCPU 数 2)を大きく上回っている
- 16:30 の内訳は CPU が 13.967(99%)で、負荷の原因はほぼ CPU
次に「上位の SQL」で犯人を探す
画像下部の「上位の SQL」には、DB 負荷への寄与が大きい順にクエリが並びます。1 位は次のクエリです。
SELECT count(*), sum(amount) FROM orders WHERE customer_id = ?
? の部分には、実行ごとに異なる顧客IDがまとめて表示されます。2 位以降は 0.01 未満で、負荷はほぼこのクエリによるものだとわかります。
原因のクエリが特定できたので、次はなぜ負荷が高いのかを、EXPLAIN で実行計画を見て確認します。
EXPLAIN で実行計画を確認する
Database Insights では ? と表示されていたので、顧客ID に任意の値(今回は 12345) を指定して実行してみます。
blog_sample_db=> EXPLAIN (ANALYZE, BUFFERS)
SELECT count(*), sum(amount) FROM orders WHERE customer_id = 12345;
                                                           QUERY PLAN
---------------------------------------------------------------------------------------------------------------------------------
 Finalize Aggregate  (cost=32881.29..32881.30 rows=1 width=16) (actual time=96.479..97.499 rows=1 loops=1)
   Buffers: shared hit=16256
   ->  Gather  (cost=32881.07..32881.28 rows=2 width=16) (actual time=96.008..97.491 rows=3 loops=1)
         Workers Planned: 2
         Workers Launched: 2
         Buffers: shared hit=16256
         ->  Partial Aggregate  (cost=31881.06..31881.07 rows=1 width=16) (actual time=90.148..90.148 rows=1 loops=3)
               Buffers: shared hit=16256
               ->  Parallel Seq Scan on orders  (cost=0.00..31881.00 rows=13 width=4) (actual time=4.769..90.138 rows=9 loops=3)
                     Filter: (customer_id = 12345)
                     Rows Removed by Filter: 999991
                     Buffers: shared hit=16256
 Planning Time: 0.069 ms
 Execution Time: 97.541 ms
(14 rows)
上記結果で注目するのは次の 2 行です。
Parallel Seq Scan on orders:index を使わず、テーブルを先頭から全件読んでいる(Seq Scan = 全件スキャン)Execution Time: 97.541 ms:この 1 回のクエリ実行にかかった時間
customer_id に index が無いため、検索のたびに 300 万行を全て読んでいました。
この処理が繰り返し実行されたことで、CPU 負荷が高くなっていたとわかります。
index を追加する
前項の実行計画で全件スキャン(Seq Scan)になっていたため、
customer_id に index を作成し、テーブルの統計情報を更新します。
blog_sample_db=> CREATE INDEX idx_orders_customer_id ON orders(customer_id);
CREATE INDEX

blog_sample_db=> ANALYZE orders;
ANALYZE

blog_sample_db=> \d orders
                 Table "public.orders"
   Column    |  Type   | Collation | Nullable | Default
-------------+---------+-----------+----------+---------
 order_id    | integer |           |          |
 customer_id | integer |           |          |
 amount      | integer |           |          |
Indexes:
    "idx_orders_customer_id" btree (customer_id)
前項と同じ条件で、もう一度 EXPLAIN を実行します。
blog_sample_db=> EXPLAIN (ANALYZE, BUFFERS)
SELECT count(*), sum(amount) FROM orders WHERE customer_id = 12345;
                                                              QUERY PLAN
---------------------------------------------------------------------------------------------------------------------------------------
 Aggregate  (cost=125.15..125.16 rows=1 width=16) (actual time=0.065..0.066 rows=1 loops=1)
   Buffers: shared hit=26 read=3
   I/O Timings: shared read=0.009
   ->  Bitmap Heap Scan on orders  (cost=4.67..125.00 rows=31 width=4) (actual time=0.027..0.057 rows=26 loops=1)
         Recheck Cond: (customer_id = 12345)
         Heap Blocks: exact=26
         Buffers: shared hit=26 read=3
         I/O Timings: shared read=0.009
         ->  Bitmap Index Scan on idx_orders_customer_id  (cost=0.00..4.66 rows=31 width=0) (actual time=0.019..0.019 rows=26 loops=1)
               Index Cond: (customer_id = 12345)
               Buffers: shared read=3
               I/O Timings: shared read=0.009
 Planning:
   Buffers: shared hit=8 read=1
   I/O Timings: shared read=0.009
 Planning Time: 0.140 ms
 Execution Time: 0.102 ms
(17 rows)
変わった点は次の 2 つです。
Bitmap Index Scan on idx_orders_customer_id:作成した index を使って、条件に合う行を探しているExecution Time: 0.102 ms:97.541 ms から大きく短縮
全件を読む代わりに、index で必要な行だけを探すようになりました。
index 追加後に、もう一度負荷をかける
先ほどと同じ条件で、pgbench を再実行します。
$ pgbench -h <RDSのエンドポイント> -U postgres -n -f ./search.sql -c 8 -j 2 -T 300 blog_sample_db
5分間負荷をかけた結果は次のとおりです。
transaction type: ./search.sql
scaling factor: 1
query mode: simple
number of clients: 8
number of threads: 2
maximum number of tries: 1
duration: 300 s
number of transactions actually processed: 3032481
number of failed transactions: 0 (0.000%)
latency average = 0.791 ms
initial connection time = 95.526 ms
tps = 10111.459660 (without initial connection time)
注目する項目は、index 追加前と同じ 3 つです。
number of transactions actually processed:5 分間で完了した検索処理は 3,032,481 回(追加前は 3,108 回)latency average:1 回あたりの平均は約 0.79 ms(追加前は約 773 ms)tps:1 秒あたり約 10,111 回(追加前は約 10 回)
同じ条件で負荷をかけたところ、1 回あたりの検索時間が大きく短くなり、処理できる件数が大幅に増えました。
Database Insights で確認
index 追加後の Database Insights です。
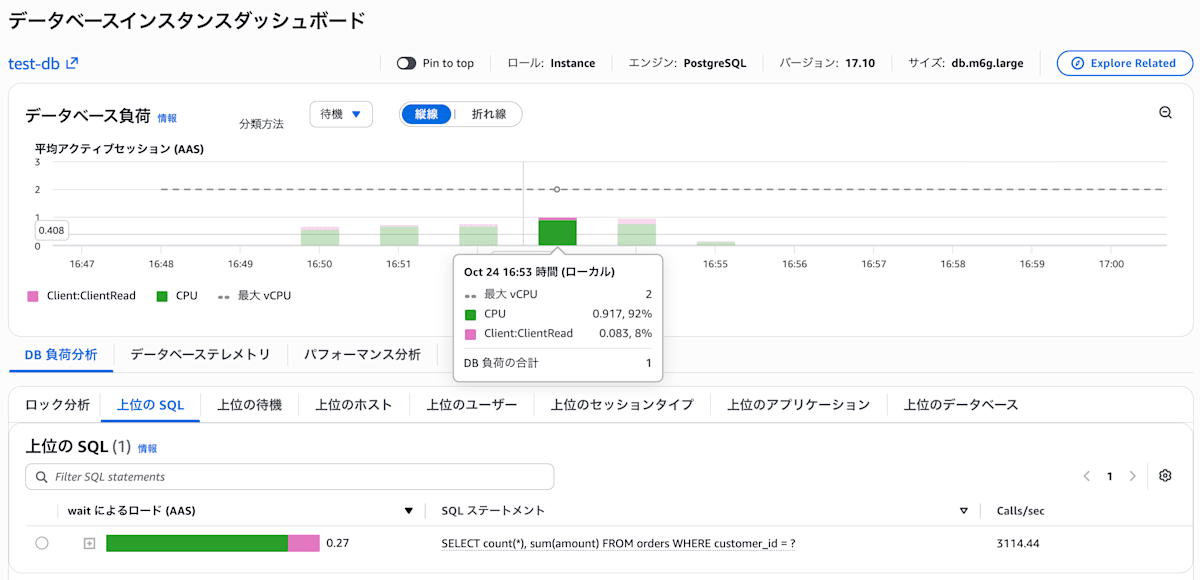
- DB 負荷は約 1 で、点線(vCPU 数 2)を下回っている
- 16:53 の内訳は CPU が 0.917(92%)
負荷をかける前後を、同じグラフで並べて見ると次のとおりです。
左の山が index 追加前(約 14)、右の小さな棒が index 追加後(約 1)です。
Before / After の比較
| 指標 | Before | After |
|---|---|---|
| EXPLAIN Execution Time | 97.541 ms | 0.102 ms |
| pgbench 平均レイテンシ | 773.183 ms | 0.791 ms |
| pgbench tps | 10.35 | 10,111 |
| DB 負荷(Database Insights) | 約 14 | 約 1 |
index 追加後は、5 分間の処理件数が 3,108 件から 3,032,481 件に増えています。pgbench は 1 回終わるとすぐ次を実行し続けるので、速くなった分だけ件数が増えます。それでも、1 回あたりの処理が軽くなったため、DB 負荷は下がりました。
終わりに
今回はシンプルな例ですが、Database Insights で負荷の高いクエリを見つけてそれを改善するという流れを一通り体験できました。
- Database Insights の「上位の SQL」で、負荷の原因となっているクエリを見つけた
- EXPLAIN で 当該クエリを見たことで、index が無く Seq Scan になっていることを発見できた
- index を追加すると、同じ負荷で DB 負荷が約 14 から約 1 に下がり、平均レイテンシは 773 ms から 0.79 ms になった
今後、DB のパフォーマンスに問題がありそうな時は、積極的に Database Insights を使っていき、改善をあれこれ試してみたいと思います。
本記事がどなたかのお役に立てば幸いです。
参考情報