Database Insights のスタンダードモードで、Amazon RDS for PostgreSQL のロック待ちとブロック元を確かめてみた

はじめに
テクニカルサポートの 片方 です。
Amazon CloudWatch Database Insights には、デフォルトのスタンダードモードと、追加料金のかかるアドバンストモードがあります(2026 年 10 月時点)。Amazon RDS for PostgreSQL のロック分析はアドバンストモードだけの機能ですが、スタンダードモードでも、ロック待ちは「データベース負荷」の待機イベントとして見えるはずです。
そこで、RDS for PostgreSQL の DB インスタンスで、コミットしないトランザクションが行をロックしたまま、ほかの 4 セッションが同じ行の更新を待つ状態を作りました。スタンダードモードのダッシュボードに何が出て何が出ないか、ブロックしている側をどう特定するかを確かめています。
構成
東京リージョンのデフォルト VPC に、RDS for PostgreSQL 18.3 の DB インスタンス inventory-pg(db.t4g.micro、gp3 20 GB、パブリックアクセス)を AWS CLI で作りました。Database Insights のモードは、スタンダード(DatabaseInsightsMode が standard)です。
作業端末から psycopg で接続します。セキュリティグループは、作業端末の IP アドレスからの TCP 5432 だけを許可しました。
ロック待ちを作るスクリプトの動きは、次のとおりです。
- セッション A:
BEGINの後にUPDATE stock SET qty = qty - 1 WHERE item_id = 1を実行し、コミットもロールバックもせずに、決めた秒数(1 回目は 900 秒、2 回目は 720 秒)保つ。 - セッション B〜E: 同じ行を
UPDATEして、A が終わるまで待つ。 - 監視: 別の接続から 60 秒ごとに、
pg_stat_activityとpg_blocking_pids()でブロックの関係を記録する。 - 後始末: 決めた秒数が過ぎたら A をロールバックし、B〜E の
UPDATEが通ることを確かめてから、B〜E もロールバックする(在庫の値は変えない)。
接続に失敗したときは、フルジッター付きの指数バックオフで、最大 5 回まで接続し直します。SQL は 1 回ずつ実行し、再試行はしません。
先に結論から
- ロック待ちは、「データベース負荷」の待機別の内訳に、
Lock:transactionidとLock:tupleとして表示されました。「上位の SQL」の件数は 2 でした。 - ブロックしている側のセッションは、「データベース負荷」には出ません。
idle in transactionのままで、クエリを実行していないためです。 - ブロック元は、
pg_stat_activityとpg_blocking_pids()でたどれました。待っている 4 セッションの先頭(Lock:transactionid)がセッション A にブロックされ、残りの 3 セッション(Lock:tuple)は先頭のセッションを待っていました。 - AWS CLI で
--enable-performance-insightsを付けずに作った DB インスタンスは、Amazon RDS Performance Insights が無効でした。再起動なしで後から有効にでき、スタンダードモードでは 7 日間の保持に追加料金はかかりません。
やってみた
次の順に進めました。
- DB インスタンスを作る
- ロック待ちを作るスクリプトを書く
- 1 回目のロック待ちの途中で、Performance Insights を有効にする
- 2 回目のロック待ちを作り、ダッシュボードを見る
1. DB インスタンスを作る
AWS CLI の create-db-instance で作りました。--database-insights-mode は指定していません。スタンダードモードは RDS のデフォルトなので、作った直後の describe-db-instances では、DatabaseInsightsMode が standard でした。一方、PerformanceInsightsEnabled は false でした。
2. ロック待ちを作るスクリプトを書く
検証に使った Python のスクリプトです。
"""inventory-pg にロック待ちを作る。

- セッション A:BEGIN → UPDATE stock SET qty = qty - 1 WHERE item_id = 1(コミットしない)を HOLD 秒保つ。
- セッション B〜E:同じ行を UPDATE して、A がコミットするまで待つ(Lock:transactionid の待機)。
- 待っている間、別の接続から pg_stat_activity と pg_blocking_pids() でブロック元を 60 秒ごとに記録する。
- 終わりに A をロールバックし、B〜E の UPDATE が通ることを確認してからロールバックする(在庫は変えない)。
- 再試行:接続は pgx.connect(指数バックオフ、最大 5 回)。SQL は手動の 1 回ずつで、再試行しない。

使い方: PGPASSWORD=... python lock_wait.py <ホスト> [HOLD 秒 = 900]
"""
import sys
import threading
import time

import psycopg

from pgx import connect

host = sys.argv[1]
hold = int(sys.argv[2]) if len(sys.argv) > 2 else 900

with connect(host) as c, c.cursor() as cur:
    cur.execute("CREATE TABLE IF NOT EXISTS stock (item_id int PRIMARY KEY, qty int NOT NULL)")
    cur.execute("INSERT INTO stock VALUES (1, 100), (2, 50) ON CONFLICT (item_id) DO NOTHING")
    cur.execute("SELECT * FROM stock ORDER BY item_id")
    print("stock:", cur.fetchall())

a = connect(host, autocommit=False)
with a.cursor() as cur:
    cur.execute("SELECT pg_backend_pid()")
    a_pid = cur.fetchone()[0]
    cur.execute("UPDATE stock SET qty = qty - 1 WHERE item_id = 1")
print(f"session A pid={a_pid}: UPDATE done, not committed. holding {hold}s")

t0 = time.time()
waiters = {}

def waiter(name):
    conn = connect(host, autocommit=False)
    with conn.cursor() as cur:
        cur.execute("SELECT pg_backend_pid()")
        waiters[name] = cur.fetchone()[0]
        ts = time.time()
        try:
            cur.execute("UPDATE stock SET qty = qty - 1 WHERE item_id = 1")
            print(f"session {name} pid={waiters[name]}: UPDATE returned after {time.time() - ts:.1f}s")
        except psycopg.Error as e:
            print(f"session {name}: ERROR {e.sqlstate} {str(e).strip()[:100]}")
    conn.rollback()
    conn.close()

threads = [threading.Thread(target=waiter, args=(n,), daemon=True) for n in "BCDE"]
for t in threads:
    t.start()
time.sleep(5)

mon = connect(host)
while time.time() - t0 < hold:
    with mon.cursor() as cur:
        cur.execute("""
            SELECT pid, state, wait_event_type, wait_event, pg_blocking_pids(pid) AS blocked_by,
                   left(query, 40) AS query, now() - query_start AS waiting
            FROM pg_stat_activity
            WHERE datname = 'postgres' AND query ILIKE 'UPDATE stock%'
            ORDER BY pid
        """)
        rows = cur.fetchall()
    print(f"[+{int(time.time() - t0)}s] pg_stat_activity:")
    for r in rows:
        print("   ", r)
    time.sleep(60)

print("rolling back session A")
a.rollback()
a.close()
for t in threads:
    t.join(timeout=30)
with connect(host) as c, c.cursor() as cur:
    cur.execute("SELECT * FROM stock ORDER BY item_id")
    print("stock after:", cur.fetchall())
pgx.connect は、psycopg.connect を包んだ関数です。接続に失敗したら、フルジッター付きの指数バックオフ(基準 1 秒、上限 16 秒)で、最大 5 回まで接続し直します。
docstring では B〜E を Lock:transactionid の待機としていますが、これは書いたときの予想です。実際には、Lock:transactionid になったのは先頭の 1 セッションだけで、残りの 3 セッションは Lock:tuple でした(確認してみたの表を参照)。
3. 1 回目のロック待ちの途中で、Performance Insights を有効にする
手順 1 のとおり、--enable-performance-insights を付けずに作った DB インスタンスでは、Performance Insights が無効でした。1 回目のロック待ち(900 秒)の途中で、次のコマンドで有効にしました。
aws rds modify-db-instance --db-instance-identifier inventory-pg \
  --enable-performance-insights --performance-insights-retention-period 7 --apply-immediately
再起動は無く、数秒で PerformanceInsightsEnabled が true になりました。スタンダードモードでは、7 日間までの保持に追加料金はかかりません。
Database Insights Standard モードを有効にすると、追加コストなしで最大 7 日間、詳細なデータベースおよびクエリごとのメトリクスが保持されます。
4. 2 回目のロック待ちを作り、ダッシュボードを見る
Performance Insights を有効にした後、1 回目が続いている間に、2 回目のスクリプト(720 秒)を起動しました。2 回目のセッション A も同じ行を UPDATE するので、1 回目のセッション A がロールバックするまでは、2 回目の A 自身がロックを待ちます。1 回目は、2 回目のスクリプトを起動してから約 5 分後に終わりました。
次の画像は、2 回目のスクリプトを起動してから 8 分ほど経ったときのインスタンスダッシュボードです。
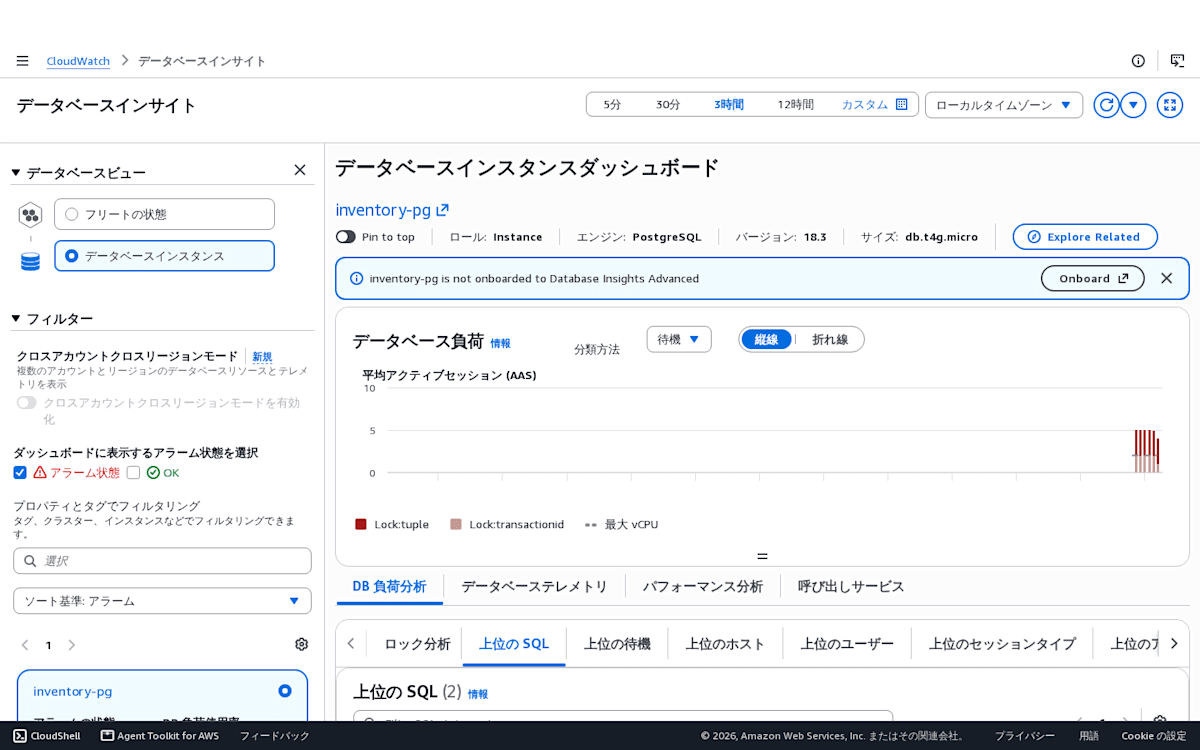
「データベース負荷」に、Lock:tuple と Lock:transactionid の 2 つの待機イベントが出ました。1 回目が終わった後の棒の平均アクティブセッションは 4 で、2 回目で待っている 4 セッションの分です。「DB 負荷分析」の「上位の SQL」の件数は 2 でした。
画面の上には、「inventory-pg is not onboarded to Database Insights Advanced」の案内と、「Onboard」のボタンが出ています。「ロック分析」のタブも表示されますが、Database Insights の機能の比較表では、SQL ロックの分析は、スタンダードモードではサポートされていません。
確認してみた
2 つの待機イベントの違い
Lock:transactionid は、別のトランザクションがすでに持っている行レベルのロックを待つときの待機イベントです。Lock:tuple は、別のバックエンドが同じタプルで競合するロックを持っていて、自分がタプルのロックの取得を待っているときの待機イベントです。
イベント
Lock:tupleは、バックエンドがタプルのロック取得を待っている間、別のバックエンドが同じタプルで競合するロックを保持していることを示します。
ブロックしている側を pg_stat_activity で特定する
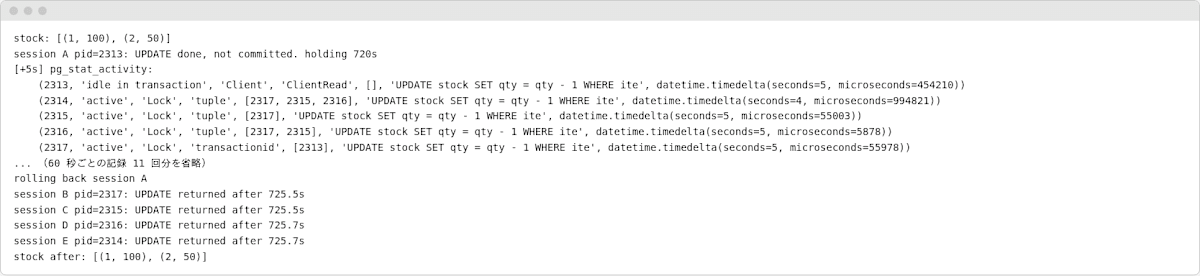
スタンダードモードの「データベース負荷」には、待っているセッションの待機イベントは出ますが、ロックを持っているセッションは出ません。次は、2 回目のスクリプトが 60 秒ごとに記録した pg_stat_activity と pg_blocking_pids() の結果です。
| セッション(pid) | state | wait_event | pg_blocking_pids |
|---|---|---|---|
| A(2313) | idle in transaction | Client / ClientRead | なし |
| B(2317) | active | Lock / transactionid | 2313 |
| C(2315) | active | Lock / tuple | 2317 |
| D(2316) | active | Lock / tuple | 2317、2315 |
| E(2314) | active | Lock / tuple | 2317、2315、2316 |
行ロックを持っているセッション A は idle in transaction で、待機イベントは Client:ClientRead(クライアントからの次の命令待ち)です。クエリを実行していないので、データベース負荷には出ません。
A のトランザクションを直接待っているのは B だけで、待機イベントは Lock:transactionid です。C・D・E は、B が取ったタプルのロックを待っているので Lock:tuple です。C・D・E の pg_blocking_pids には、B と、自分より前に並んだセッションの pid が入ります。
今回は、Lock:transactionid で待っているセッション B の pg_blocking_pids をたどると、idle in transaction のセッション A にたどり着きました。
なお、ドキュメントでは、アイドル状態のトランザクションがロックを持っている場合の診断に、pg_stat_activity と pg_locks の出力を使うよう案内されています。今回は、pg_locks の代わりに pg_blocking_pids() でブロックの関係を見ました。
アイドル状態のトランザクションが行レベルロックを取得した場合は、他のセッションがそのロックを取得するのを妨害する可能性があります。この状態は、待機イベント
Lock:transactionidの頻発につながります。問題を診断するには、pg_stat_activityそしてpg_locksからの出力を検証します。
ロールバックした後
A をロールバックすると、B〜E の UPDATE は 725.5〜725.7 秒で返りました。スクリプトは +5 秒から 60 秒ごとに記録し、720 秒を超えた最初の確認(+725 秒)で A をロールバックするので、720 秒より 5 秒ほど長くなっています。B〜E もロールバックしたので、stock の値は (1, 100)、(2, 50) のままでした。
まとめ
スタンダードモードでも、ロック待ちが起きていること自体は、「データベース負荷」ですぐに分かりました。Lock:transactionid と Lock:tuple の棒が積み上がるので、「行ロックで詰まっている」ことは一目瞭然です。
ただ、肝心の「誰が止めているのか」は出てきません。今回の原因は、idle in transaction のまま残ったセッション A です。クエリを実行していないので、負荷のグラフには現れません。結局、pg_stat_activity と pg_blocking_pids() で、待っている側の先頭からたどるのが近道でした。スタンダードモードで運用するなら、このクエリを手元に用意しておくと安心です。
もう 1 つ、AWS CLI で --enable-performance-insights を付けずに作った DB インスタンスでは、Performance Insights が無効でした。スタンダードモードがデフォルトでも、Performance Insights が有効になっているかは、一度確かめておくのがおすすめです。
本ブログが誰かの参考になれば幸いです。
参考資料
- CloudWatch Database Insights - Amazon CloudWatch
- Amazon RDS で Database Insights のスタンダードモードを有効にする - Amazon Relational Database Service
- Lock:transactionid - Amazon Relational Database Service
- Lock:tuple - Amazon Relational Database Service
- CloudWatch Database Insights の使用を開始する - Amazon CloudWatch
クラスメソッドオペレーションズ株式会社について
クラスメソッドグループのオペレーション企業です。
運用・保守開発・サポート・情シス・バックオフィスの専門チームが、IT・AIをフル活用した「しくみ」を通じて、お客様の業務代行から課題解決や高付加価値サービスまでを提供するエキスパート集団です。
当社は様々な職種でメンバーを募集しています。
「オペレーション・エクセレンス」と「らしく働く、らしく生きる」を共に実現するカルチャー・しくみ・働き方にご興味がある方は、クラスメソッドオペレーションズ株式会社 コーポレートサイト をぜひご覧ください。※2026年1月 アノテーション㈱から社名変更しました