[アップデート] Amazon S3 Vectorsの全文検索とハイブリッド検索が可能になりました!

はじめに
こんにちは、ラーメンが好きなコンサルティング部の神野です。
Amazon S3 Vectorsのハイブリッド検索と全文検索がリリースされました!
これは待望の・・・激アツアップデートですね!!
主な変更点をまとめていろいろ触ってみます!
Amazon Bedrock Knowledge Bases(以下KB)から使えるかの確認やOpenSearch ServerlessのKBとの比較も試しました。
主な変更点
S3 Vectorsのインデックスにベクトルと一緒に検索したいテキストもメタデータとして書き込めるようになりました!
QueryVectors APIの1回の呼び出しでベクトル検索と全文検索をまとめて実行できます。
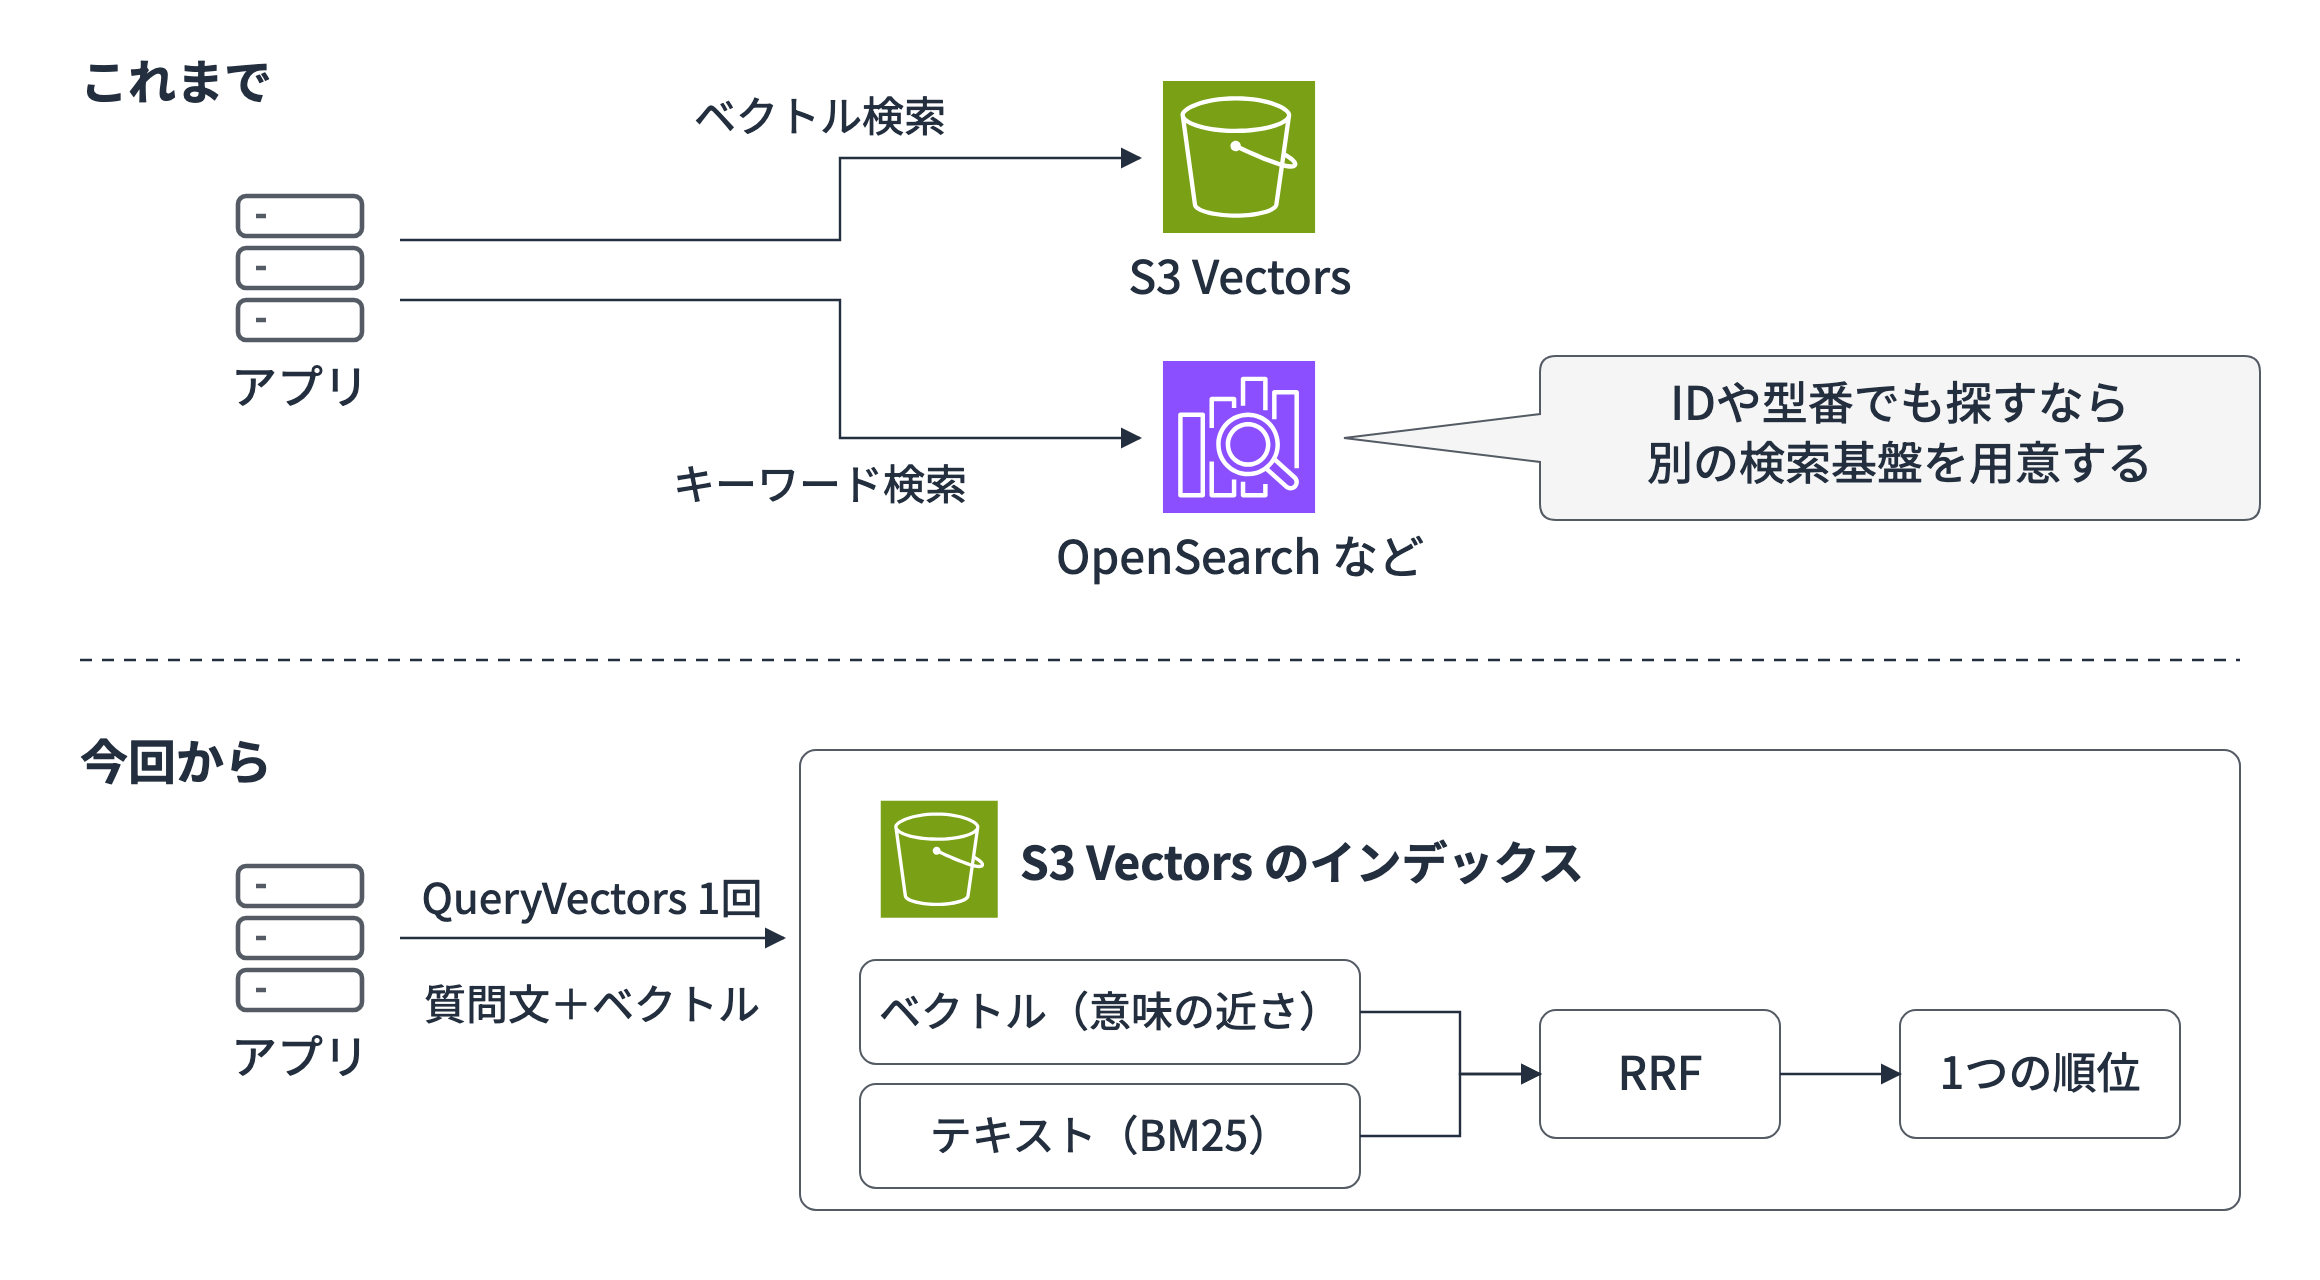
これまでのS3 Vectorsはベクトル検索のみだったので、エラーコードや型番のように字面の一致で探したい場合はOpenSearchなどを別に用意する、もしくは自前で実装する必要がありました。今回からはインデックスにテキストを入れておけばIDやコードでの検索も同じ呼び出しで済みます!(待っていたよ!!!!)
安くて手軽なS3 Vectorsのままハイブリッド検索までできるのは激アツですね!
QueryVectorsに何を渡すかで検索の種類が変わります。
| 渡すもの | 検索の種類 | 並び順の基準 |
|---|---|---|
質問のベクトル(queryVector) |
ベクトル検索 | ベクトルの距離 |
質問文(queryTexts) |
全文検索 | BM25のスコア |
| 両方 | ハイブリッド検索 | RRFで合算した順位 |
BM25やRRFって何?ってなりますよね。
BM25は質問の単語が一致した文書に付く点数です。ほかの文書にあまり出てこない単語の一致ほど高くなります。
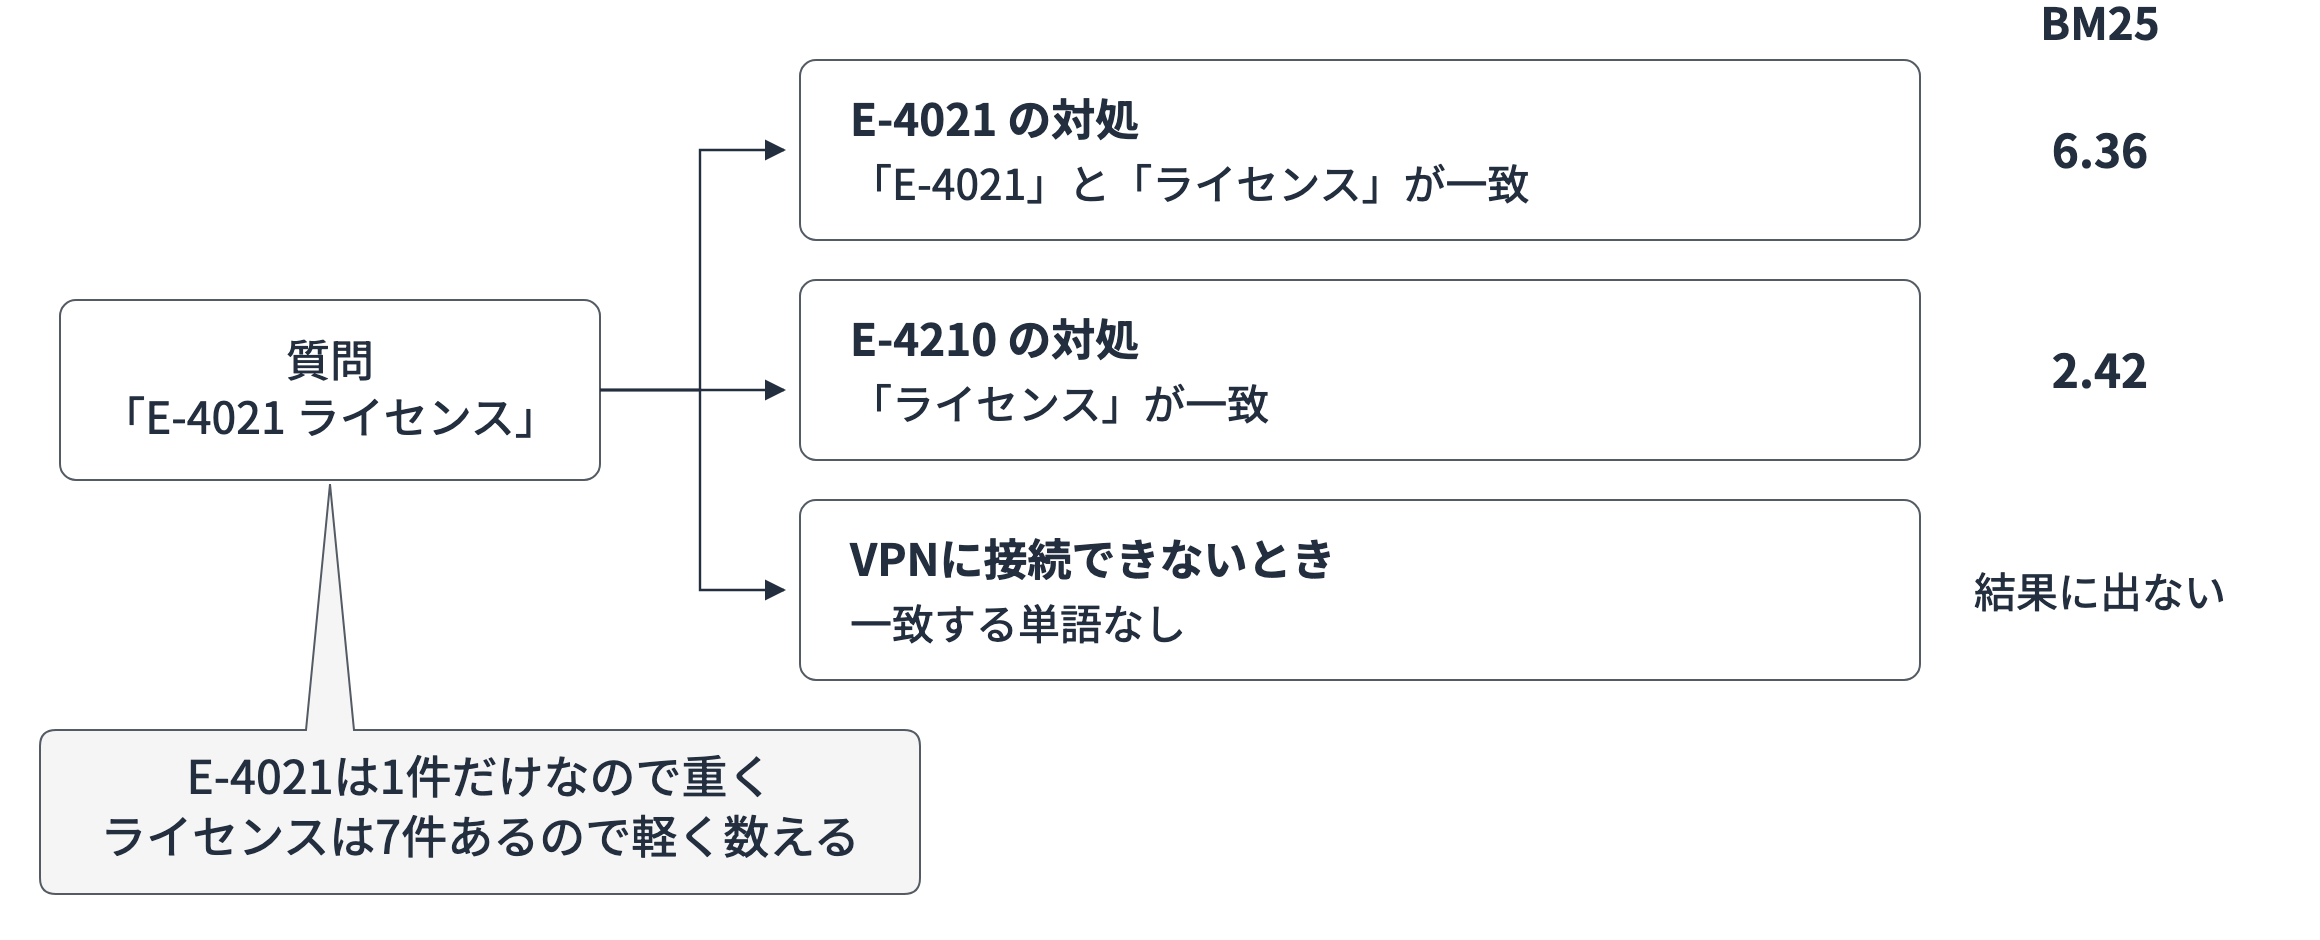
RRF(Reciprocal Rank Fusion)は2つの検索の順位に点数を付けて足し合わせる方法です。
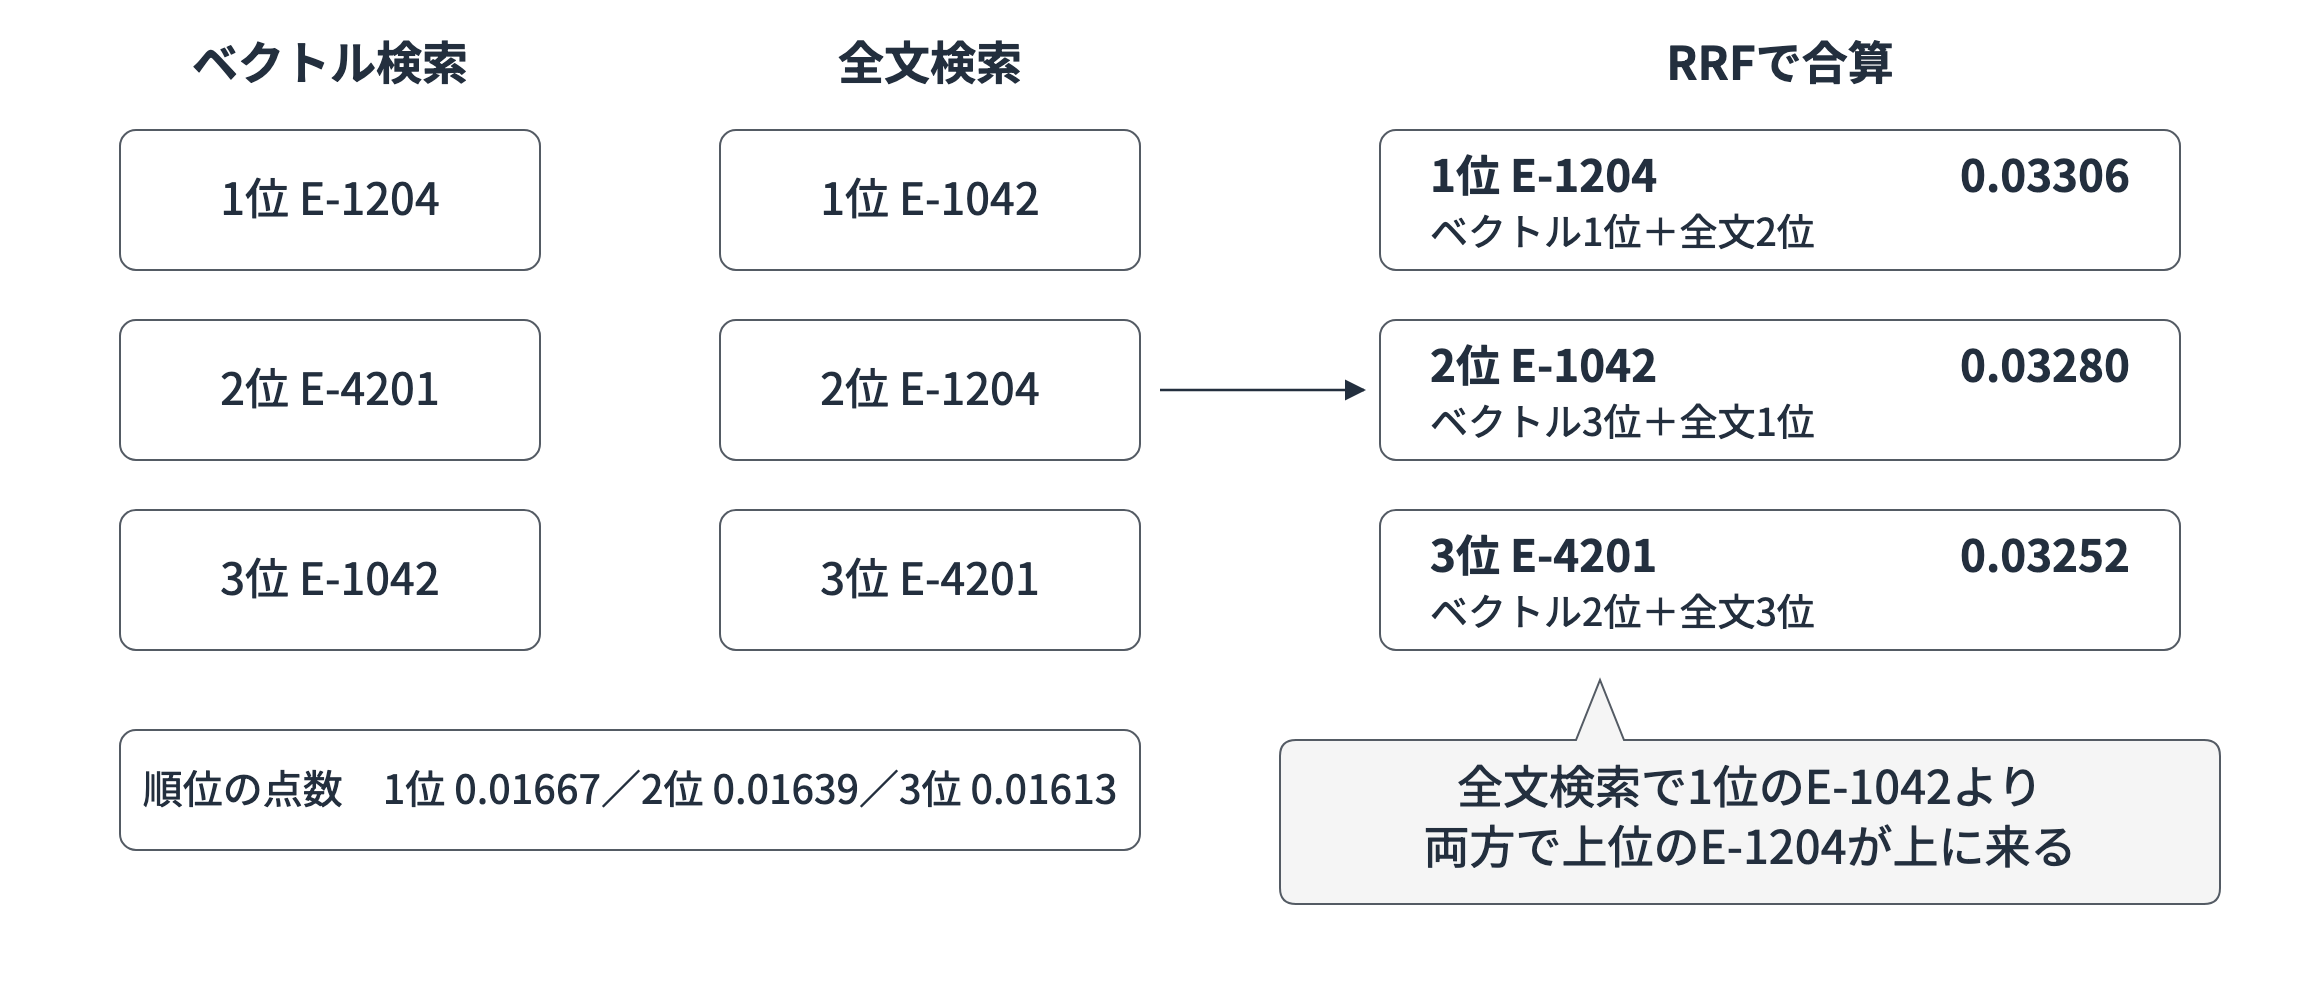
使う前に押さえておきたいポイント
使う前に押さえておきたいのは次のあたりです。
- 全文検索の対象にするキーは
textSearchConfigurationsで指定します。既存のインデックスへ後から追加もできます。 - アナライザー(テキストの区切り方)は標準か日本語(
ja)を含む10言語から選べますが後から変更できません。 - 使えるのはENHANCEDモードのインデックスです。CLASSICのインデックスはUpdateIndexModeで切り替えてから使います。
queryTextsを使うにはs3vectors:GetVectorsの権限も必要です。- S3 Vectorsが使えるすべての商用リージョンと中国リージョンで使えます。
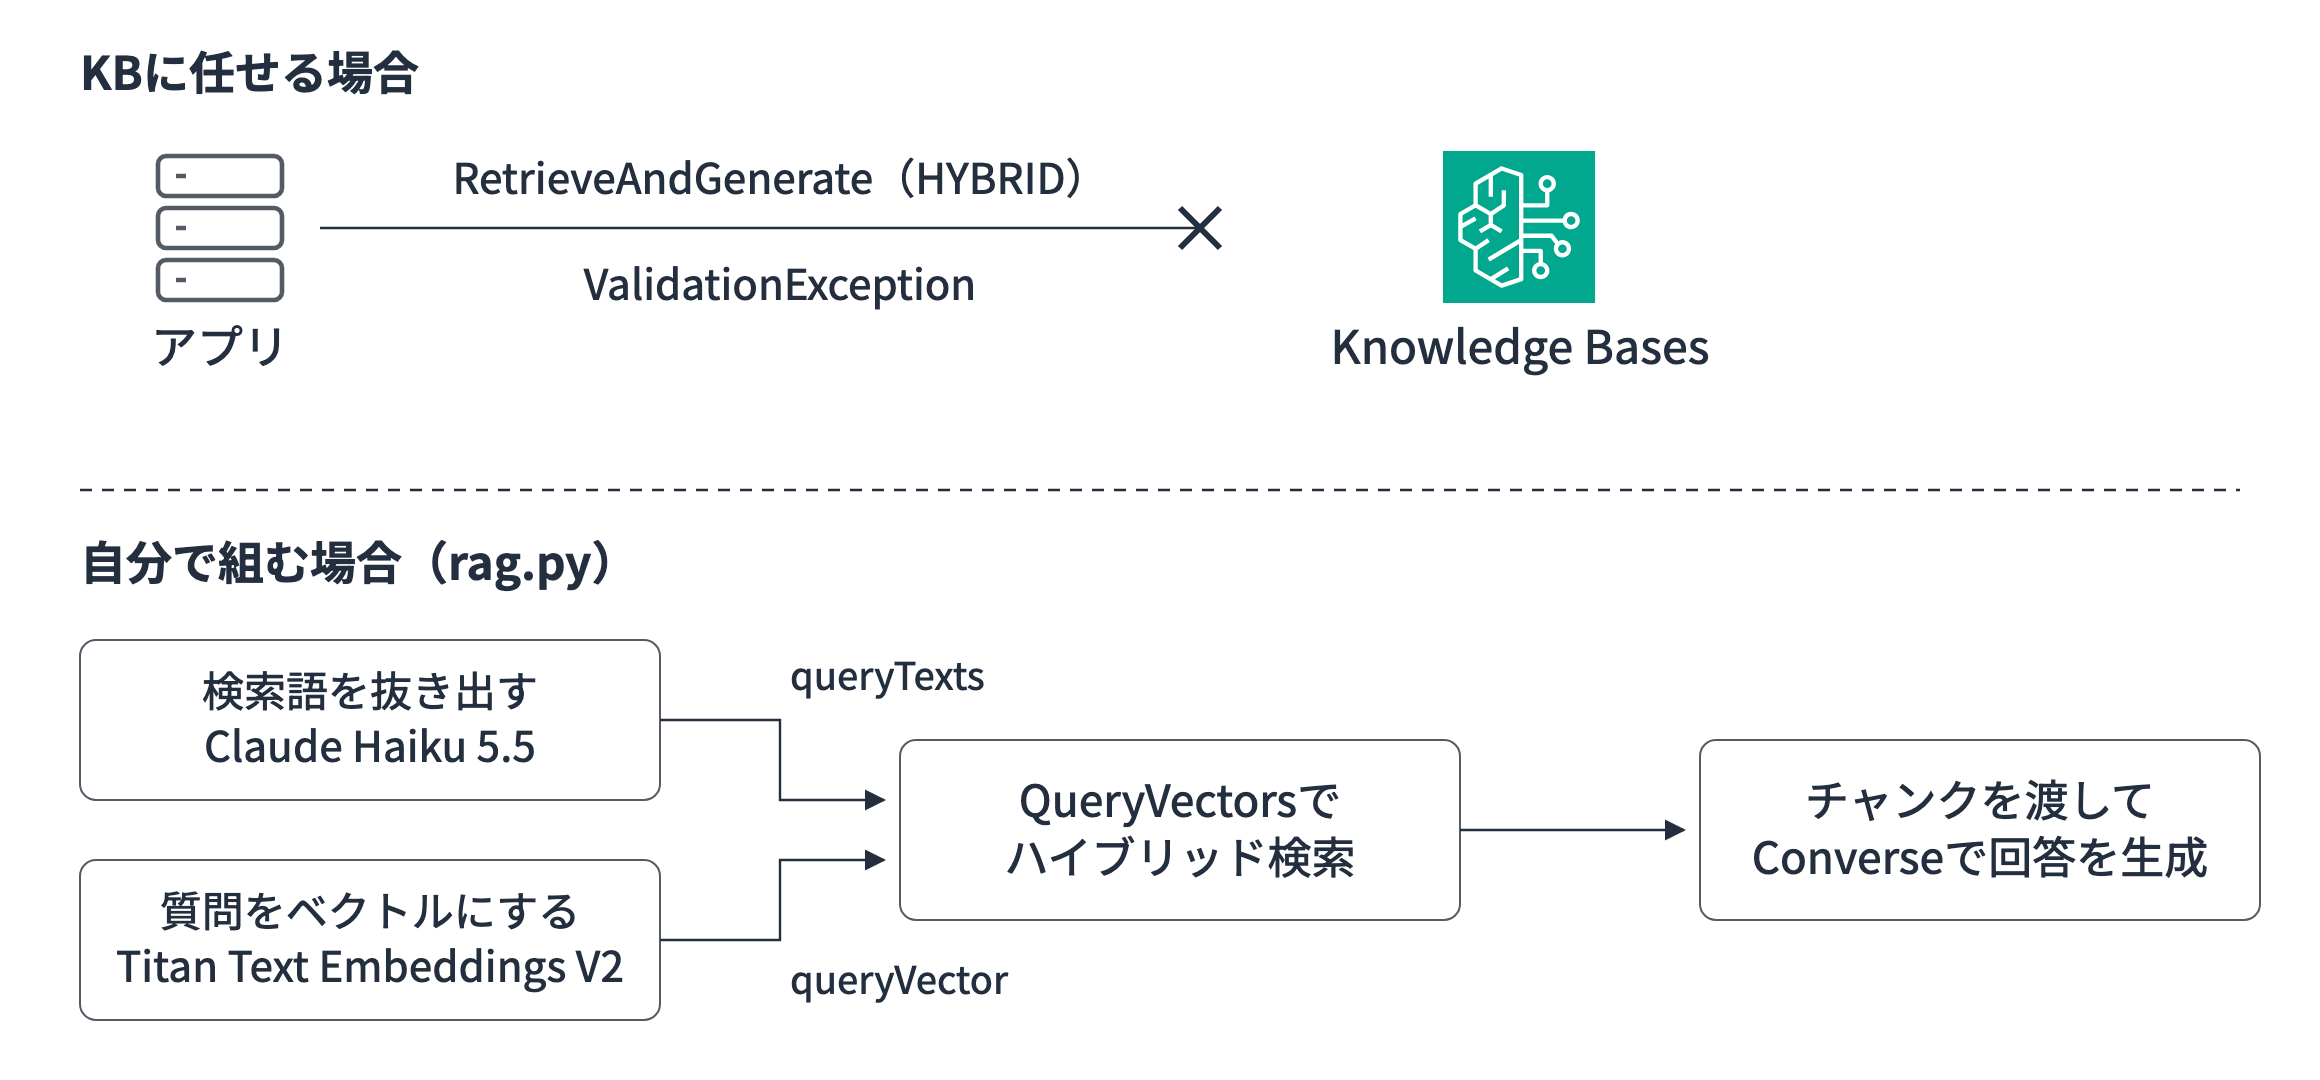
気になっていたKBからの利用はRetrieve APIでHYBRIDを指定するとエラーになりました(後半で紹介します)・・・少し残念・・・
前提
今回の前提は下記のとおりです。
| 項目 | バージョン・値 |
|---|---|
| リージョン | 東京(ap-northeast-1) |
| Python / uv | 3.14.6 / 0.13.6 |
| boto3 | 1.44.4 |
| 埋め込みモデル | Amazon Titan Text Embeddings V2(1024次元) |
ハイブリッド検索のパラメーターはboto3 1.44.4(2026年11月16日公開)から入っているのでこれ以降のバージョンを使いましょう!
uv init s3-vectors-hybrid-search --python 3.14
cd s3-vectors-hybrid-search
uv add 'boto3>=1.44.4' opensearch-py  # opensearch-pyはOpenSearchとの比較用
試験用データは社内ヘルプデスクを想定した33件(FAQ 23件・障害チケット10件)を用意しました。E-4012とE-4021・INC-20184とINC-21084のように数字の並びだけが違うコードやIDをわざと混ぜています。
データとクライアント(common.py)
import json

import boto3

REGION = "ap-northeast-1"
VECTOR_BUCKET = "hybrid-search-demo"
INDEX = "helpdesk"

s3vectors = boto3.client("s3vectors", region_name=REGION)
bedrock = boto3.client("bedrock-runtime", region_name=REGION)

# (キー, タイトル, 本文)
DOCS = [
    ("faq-e4012", "エラー E-4012 の対処", "E-4012 はライセンスサーバーとの通信がタイムアウトしたときに表示されます。社内プロキシでポート8443への通信を許可してください。"),
    ("faq-e4021", "エラー E-4021 の対処", "E-4021 はライセンスの有効期限が切れたときに表示されます。管理ポータルのライセンス画面から更新してください。"),
    ("faq-e4102", "エラー E-4102 の対処", "E-4102 はライセンスキーの形式が正しくないときに表示されます。ハイフンを含めて25文字のキーを入力し直してください。"),
    ("faq-e4120", "エラー E-4120 の対処", "E-4120 はライセンスが別のテナントに割り当てられているときに表示されます。管理者にテナントの割り当てを確認してもらってください。"),
    ("faq-e4201", "エラー E-4201 の対処", "E-4201 はライセンス情報の読み込みに失敗したときに表示されます。アプリを再インストールしてからサインインし直してください。"),
    ("faq-e4210", "エラー E-4210 の対処", "E-4210 はライセンスの同時利用数が上限に達したときに表示されます。使っていない端末からサインアウトしてください。"),
    ("faq-e1042", "エラー E-1042 の対処", "E-1042 はサインインのセッションが切れたときに表示されます。もう一度サインインしてください。"),
    ("faq-e1204", "エラー E-1204 の対処", "E-1204 は多要素認証のコードが一致しないときに表示されます。端末の時刻を自動設定にしてからコードを入力し直してください。"),
    ("faq-e2014", "エラー E-2014 の対処", "E-2014 はアップロードするファイルが大きすぎるときに表示されます。1ファイル2GB以下に分割してください。"),
    ("faq-e2041", "エラー E-2041 の対処", "E-2041 はファイル名に使えない文字が含まれているときに表示されます。記号を除いたファイル名に変更してください。"),
    ("faq-e2104", "エラー E-2104 の対処", "E-2104 は共有フォルダへのアクセス権がないときに表示されます。フォルダの所有者に編集権限を依頼してください。"),
    ("faq-e2140", "エラー E-2140 の対処", "E-2140 は同期先のフォルダが削除されたときに表示されます。同期の設定画面で新しいフォルダを選び直してください。"),
    ("faq-e2401", "エラー E-2401 の対処", "E-2401 はファイルが他の利用者に編集されているときに表示されます。編集が終わってから保存し直してください。"),
    ("faq-e2410", "エラー E-2410 の対処", "E-2410 は同期の競合が発生したときに表示されます。競合したファイルを開き、残す版を選んでください。"),
    ("faq-e5003", "エラー E-5003 の対処", "E-5003 は端末のディスク容量が不足して、ファイルの同期が停止したときに表示されます。不要なファイルを削除して空き容量を確保してください。"),
    ("faq-e5030", "エラー E-5030 の対処", "E-5030 はサーバーがメンテナンス中だったときに表示されます。メンテナンスの終了後に再度お試しください。"),
    ("faq-vpn", "VPNに接続できないとき", "在宅勤務でVPNに接続できない場合は、クライアントを再起動してから多要素認証のコードを入力し直してください。"),
    ("faq-password", "パスワードを忘れたとき", "パスワードを忘れた場合は、サインイン画面のリンクからリセット用のメールを受け取ってください。"),
    ("faq-kyoto", "京都オフィスの入館", "京都オフィスでは、1階の受付で社員証をかざして入館します。来客は前日までに受付システムで登録してください。"),
    ("faq-tokyo", "東京都内オフィスの入館", "東京都内の各オフィスでは、ゲートに社員証をかざして入館します。社員証を忘れた場合は警備室で仮カードを借りてください。"),
    ("faq-printer", "プリンターで印刷できないとき", "複合機で印刷できない場合は、プリンタードライバーを最新版に更新し、印刷キューに残ったジョブを削除してください。"),
    ("faq-expense", "経費精算の締め日", "経費精算は毎月25日が締め日です。領収書の画像を添付して、上長の承認を受けてください。"),
    ("faq-display", "画面が表示されないとき", "ノートPCの画面が表示されない場合は、外部ディスプレイのケーブルを外し、表示先の切り替えキーを押してください。"),
    # 障害チケット(本文にIDが1回だけ出てくる)
    ("INC-20418", "INC-20418", "INC-20418 朝9時ごろから在宅勤務の利用者がVPNに接続できなくなった。認証サーバーの証明書が期限切れになっていたため、証明書を更新して復旧した。影響は約40分で、再発防止として期限の監視を追加した。"),
    ("INC-20481", "INC-20481", "INC-20481 VPN装置のファームウェア更新後に一部の利用者で接続が切れやすくなった。装置のタイムアウト設定が初期値に戻っていたため、設定を元に戻して解消した。更新手順に設定の確認を追加した。"),
    ("INC-24018", "INC-24018", "INC-24018 経費精算システムで領収書の画像をアップロードできなくなった。ストレージの容量上限に達していたため、古い画像をアーカイブして空き容量を確保した。"),
    ("INC-24081", "INC-24081", "INC-24081 複合機から印刷できないという問い合わせが続いた。プリントサーバーの印刷キューが詰まっていたため、キューを削除してサービスを再起動した。"),
    ("INC-21048", "INC-21048", "INC-21048 社内ポータルの表示が遅くなった。検索インデックスの再構築が業務時間中に動いていたため、夜間に実行するようスケジュールを変更した。"),
    ("INC-21084", "INC-21084", "INC-21084 ファイル同期アプリで同期が止まる端末が増えた。端末のディスク容量が不足していたため、利用者に不要ファイルの削除を案内した。"),
    ("INC-28014", "INC-28014", "INC-28014 多要素認証のコードが合わずサインインできない利用者が出た。端末の時刻がずれていたため、時刻の自動設定を有効にするよう案内した。"),
    ("INC-28041", "INC-28041", "INC-28041 ライセンスの同時利用数が上限に達し、新しい端末でアプリを起動できなくなった。退職者の端末に割り当てが残っていたため、割り当てを解除した。"),
    ("INC-20148", "INC-20148", "INC-20148 会議室の予約システムに接続できなくなった。DNSの設定変更で名前解決に失敗していたため、レコードを修正して復旧した。"),
    ("INC-20184", "INC-20184", "INC-20184 メールの送信が遅延した。送信サーバーのキューが溢れていたため、サーバーを1台追加して処理を分散した。"),
]

def embed(text: str) -> list[float]:
    res = bedrock.invoke_model(
        modelId="amazon.titan-embed-text-v2:0",
        body=json.dumps({"inputText": text, "dimensions": 1024, "normalize": True}),
    )
    return json.loads(res["body"].read())["embedding"]
やってみた
早速やってみましょう!
全文検索を設定したインデックスを作る
まずはインデックスを作ります。
インデックスを作るときに全文検索するメタデータのキーを textSearchConfigurations に指定します。タイトルと本文は日本語アナライザーにしました。比較用に同じ本文を標準アナライザーで持つ body_std も用意しています。
s3vectors.create_index(
    vectorBucketName=VECTOR_BUCKET,
    indexName=INDEX,
    dataType="float32",
    dimension=1024,
    distanceMetric="cosine",
    metadataConfiguration={
        "nonFilterableMetadataKeys": ["body", "body_std"],
        # 全文検索の対象にするメタデータのキー
        "textSearchConfigurations": [
            {"metadataKey": "title", "language": "ja"},
            {"metadataKey": "body", "language": "ja"},
            {"metadataKey": "body_std"},  # 比較用(標準アナライザー)
        ],
    },
)
本文は絞り込みに使わないので nonFilterableMetadataKeys に入れています。書き込みはこれまでと同じPutVectorsでメタデータにテキストを渡します。
uv run setup.py
ENHANCED [{'metadataKey': 'body', 'language': 'ja', 'status': 'ACTIVE'}, {'metadataKey': 'body_std', 'status': 'ACTIVE'}, {'metadataKey': 'title', 'language': 'ja', 'status': 'ACTIVE'}]
作成直後から3つともACTIVE(検索できる状態)となりました。
setup.py
from common import DOCS, INDEX, VECTOR_BUCKET, embed, s3vectors

s3vectors.create_vector_bucket(vectorBucketName=VECTOR_BUCKET)

s3vectors.create_index(
    vectorBucketName=VECTOR_BUCKET,
    indexName=INDEX,
    dataType="float32",
    dimension=1024,
    distanceMetric="cosine",
    metadataConfiguration={
        "nonFilterableMetadataKeys": ["body", "body_std"],
        # 全文検索の対象にするメタデータのキー
        "textSearchConfigurations": [
            {"metadataKey": "title", "language": "ja"},
            {"metadataKey": "body", "language": "ja"},
            {"metadataKey": "body_std"},  # 比較用(標準アナライザー)
        ],
    },
)

# ベクトルと一緒に、全文検索するテキストをメタデータとして書き込む
s3vectors.put_vectors(
    vectorBucketName=VECTOR_BUCKET,
    indexName=INDEX,
    vectors=[
        {
            "key": key,
            "data": {"float32": embed(body)},
            "metadata": {"title": title, "body": body, "body_std": body},
        }
        for key, title, body in DOCS
    ],
)

index = s3vectors.get_index(vectorBucketName=VECTOR_BUCKET, indexName=INDEX)["index"]
print(index["indexMode"], index["metadataConfiguration"]["textSearchConfigurations"])
ハイブリッド検索のリクエストとレスポンス
ハイブリッド検索の基本の使い方を確認していきましょう。
queryVector と queryTexts を両方渡すとハイブリッド検索になります。returnScores を付けるとRRFの点数に加えて元になったBM25のスコアとベクトルの距離も返ってきます。
import json

from common import INDEX, VECTOR_BUCKET, embed, s3vectors

question = "E-1204 でサインインできない"
response = s3vectors.query_vectors(
    vectorBucketName=VECTOR_BUCKET,
    indexName=INDEX,
    topK=4,
    queryVector={"float32": embed(question)},  # ベクトル検索に使う質問のベクトル
    queryTexts=[{"metadataKey": "body", "text": question}],  # 全文検索に使う文字列
    returnMetadata=True,  # メタデータ(タイトルや本文)も返す
    returnScores=True,  # RRFの点数とBM25・距離を返す
)
response.pop("ResponseMetadata")
print(json.dumps(response, ensure_ascii=False, indent=2))
uv run hybrid_request.py
「E-1204 でサインインできない」で検索したレスポンスです。
{
  "vectors": [
    {
      "scores": {
        "fused": 0.03306011110544205,
        "bm25Scores": [
          { "metadataKey": "body", "score": 3.843895435333252 }
        ],
        "vectorDistance": 0.4152034521102905
      },
      "key": "faq-e1204",
      "metadata": { "title": "エラー E-1204 の対処", "body": "E-1204 は多要素認証のコードが一致しないときに…" }
    },
    ...
    {
      "scores": {
        "fused": 0.01587301678955555,
        "vectorDistance": 0.6260393261909485
      },
      "key": "INC-28014",
      "metadata": { "title": "INC-28014", "body": "INC-28014 多要素認証のコードが合わずサインインできない…" }
    }
  ],
  "distanceMetric": "cosine"
}
fused がRRFの点数で、この値が大きい順に並びます。
1件目のE-1204はベクトル検索で1位・全文検索で2位だったので bm25Scores と vectorDistance が両方付いています。
4件目のINC-28014はベクトル検索で4位の文書で、全文検索の上位には入っていません。そのため bm25Scores がなく fused もベクトル検索の順位1つ分の点数です。
3通りの検索で比べる
QueryVectorsに渡すものを変えて比べます。
def search(query: str, mode: str, field: str = "body", top_k: int = 3) -> list[dict]:
    params = {"vectorBucketName": VECTOR_BUCKET, "indexName": INDEX, "topK": top_k, "returnScores": True}
    if mode in ("vector", "hybrid"):
        params["queryVector"] = {"float32": embed(query)}  # ベクトル検索
    if mode in ("text", "hybrid"):
        params["queryTexts"] = [{"metadataKey": field, "text": query}]  # 全文検索
    return s3vectors.query_vectors(**params)["vectors"]
uv run search.py "E-4021 が表示された" "VPNの証明書が切れた障害" "E-1204 でサインインできない" \
  "INC-20184 の再発防止策" "INC-21084 の内容" "社外から社内ネットワークにつながらない"
各質問で1位に来た文書です。
| 質問 | 正解 | ベクトル | 全文 | ハイブリッド |
|---|---|---|---|---|
| E-4021 が表示された | E-4021 | ○ | ○ | ○ |
| VPNの証明書が切れた障害 | INC-20418 | ○ | ○ | ○ |
| E-1204 でサインインできない | E-1204 | ○ | × E-1042 | ○ |
| INC-20184 の再発防止策 | INC-20184 | ○ | × INC-20418 | ○ |
| INC-21084 の内容 | INC-21084 | × INC-20184 | ○ | × INC-20184 |
| 社外から社内ネットワークにつながらない | INC-20418 | ○ | × E-4012 | × INC-21048 |
実行結果(上位3件)
== E-4021 が表示された
vector  ['faq-e4021', 'faq-e4201', 'faq-e4012']
text    ['faq-e4021', 'faq-e1042', 'faq-e5030']
hybrid  ['faq-e4021', 'faq-e1042', 'faq-e4201']
== VPNの証明書が切れた障害
vector  ['INC-20418', 'INC-20481', 'faq-vpn']
text    ['INC-20418', 'INC-20481', 'faq-e1042']
hybrid  ['INC-20418', 'INC-20481', 'faq-e1042']
== E-1204 でサインインできない
vector  ['faq-e1204', 'faq-e4201', 'faq-e1042']
text    ['faq-e1042', 'faq-e1204', 'faq-e4201']
hybrid  ['faq-e1204', 'faq-e1042', 'faq-e4201']
== INC-20184 の再発防止策
vector  ['INC-20184', 'INC-20418', 'INC-20481']
text    ['INC-20418', 'INC-20184', 'INC-20148']
hybrid  ['INC-20184', 'INC-20418', 'INC-20148']
== INC-21084 の内容
vector  ['INC-20184', 'INC-21084', 'faq-e2104']
text    ['INC-21084', 'INC-20184', 'INC-20148']
hybrid  ['INC-20184', 'INC-21084', 'INC-20148']
== 社外から社内ネットワークにつながらない
vector  ['INC-20418', 'INC-21048', 'faq-vpn']
text    ['faq-e4012', 'INC-21048']
hybrid  ['INC-21048', 'INC-20418', 'faq-e4012']
全文検索は「サインイン」や「再発防止」といった単語の一致が強く出て外すことがありましたが、ハイブリッド検索はその2問で正解が1位になっていますね!
一方でINC-21084の質問はベクトル検索もハイブリッド検索も似たIDのINC-20184が1位でした。スコアを見ると2件は同点です。
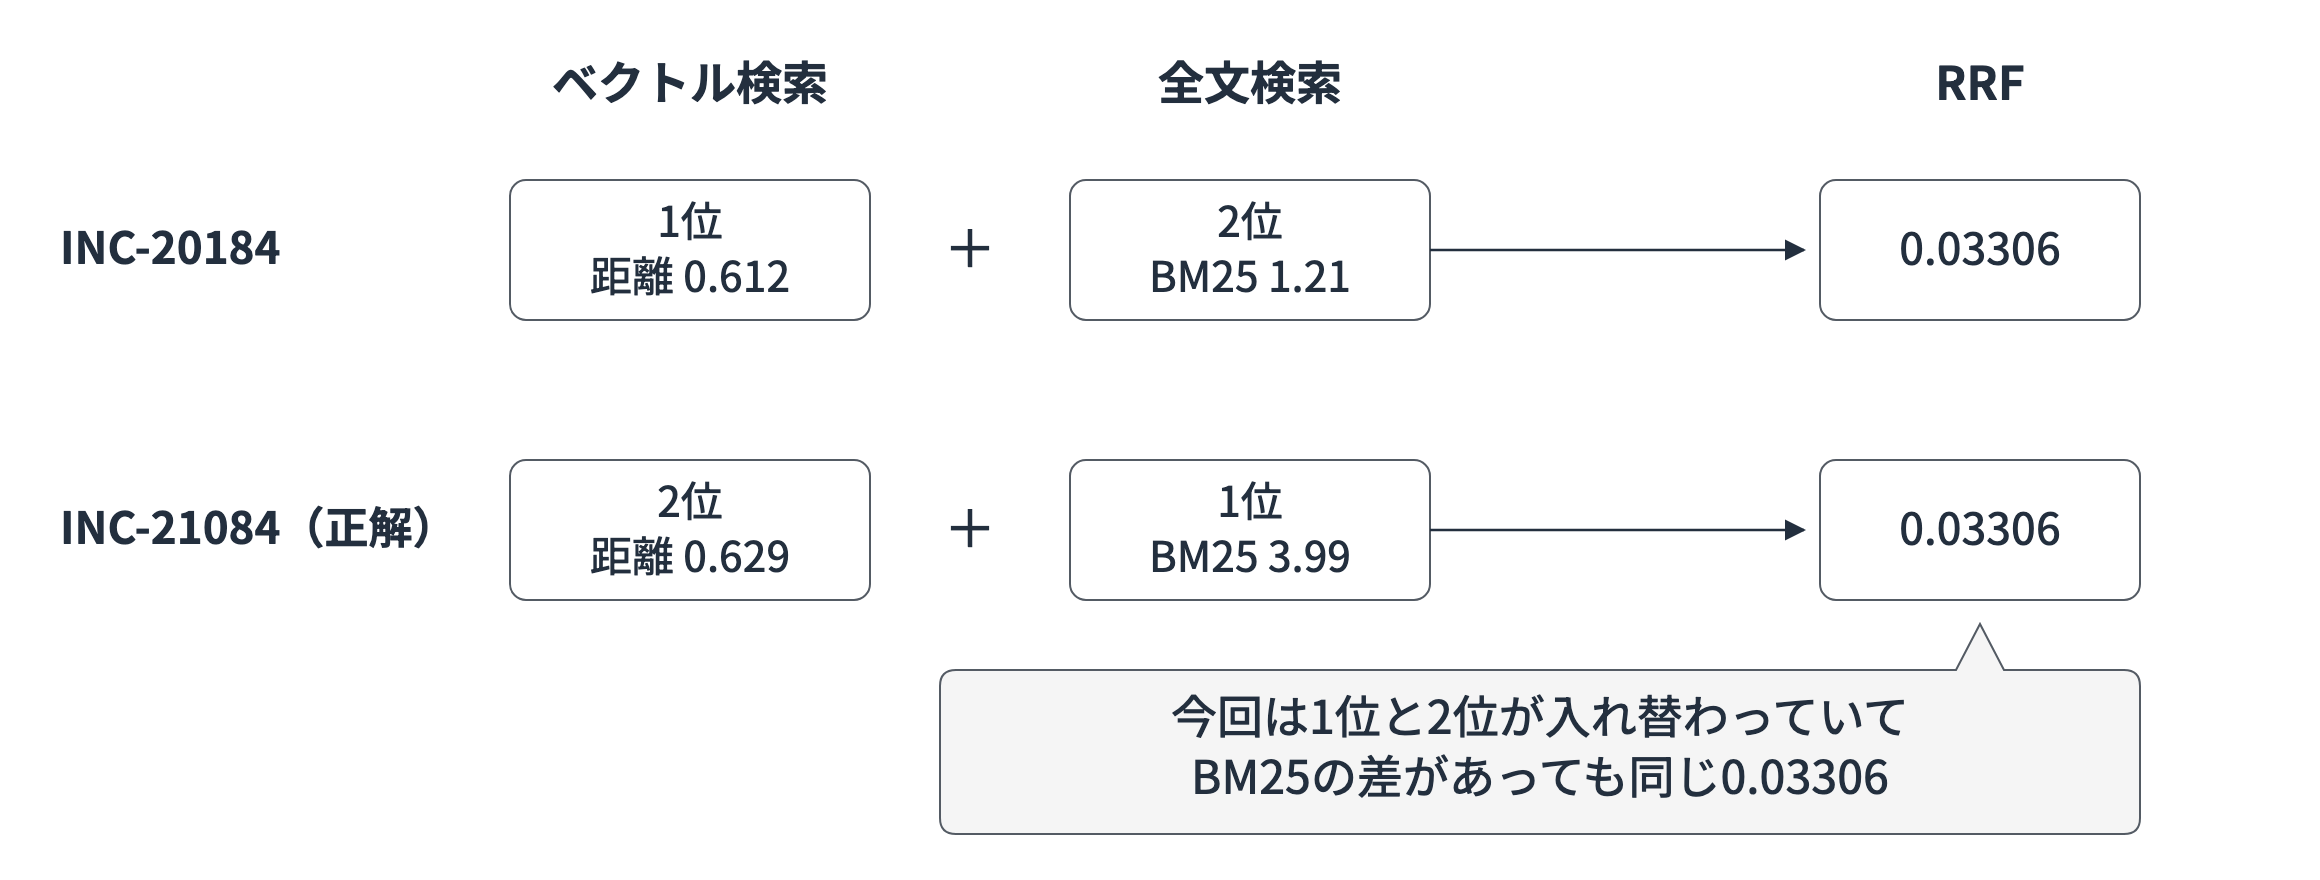
今回の2件はベクトル検索と全文検索で1位と2位が入れ替わっていて、BM25に3倍以上の差があっても fused はどちらも0.03306でした。ほかの質問でも順位の組み合わせが同じなら fused は同じ値だったので、スコアの大きさではなく順位で決まっているのかもしれないですね。(あくまで今回見た範囲でといった感じですが)
今回の6問ではハイブリッド検索の上位3件にすべて正解が入っていました!ただ33件と小さいデータなのでベクトル検索の上位3件にも正解は入っていてあまり違いがありませんでしたが、この辺りは実際に試してみてどこまでの精度かを確認されると良いですね。
20回ずつ測った中央値はベクトル検索97ms・全文検索90ms・ハイブリッド検索100msでした(埋め込みの時間は除く)。ハイブリッドにしても今回の速さはほとんど変わりませんでした。
スコアの確認・search.py・latency.py
for v in search("INC-21084 の内容", "hybrid"):
    print(v["key"], v["scores"])
INC-20184 {'fused': 0.03306011110544205, 'bm25Scores': [{'metadataKey': 'body', 'score': 1.2058157920837402}], 'vectorDistance': 0.6120521426200867}
INC-21084 {'fused': 0.03306011110544205, 'bm25Scores': [{'metadataKey': 'body', 'score': 3.9898414611816406}], 'vectorDistance': 0.629304826259613}
INC-20148 {'fused': 0.016129031777381897, 'bm25Scores': [{'metadataKey': 'body', 'score': 1.1749852895736694}]}
import sys

from common import INDEX, VECTOR_BUCKET, embed, s3vectors

def search(query: str, mode: str, field: str = "body", top_k: int = 3) -> list[dict]:
    params = {"vectorBucketName": VECTOR_BUCKET, "indexName": INDEX, "topK": top_k, "returnScores": True}
    if mode in ("vector", "hybrid"):
        params["queryVector"] = {"float32": embed(query)}  # ベクトル検索
    if mode in ("text", "hybrid"):
        params["queryTexts"] = [{"metadataKey": field, "text": query}]  # 全文検索
    return s3vectors.query_vectors(**params)["vectors"]

if __name__ == "__main__":
    for query in sys.argv[1:]:
        print(f"== {query}")
        for mode in ("vector", "text", "hybrid"):
            print(f"{mode:7s}", [v["key"] for v in search(query, mode)])
import statistics
import time

from common import INDEX, VECTOR_BUCKET, embed, s3vectors

query = "INC-21084 の内容"
vector = embed(query)  # 埋め込みの時間は含めない

for mode in ("vector", "text", "hybrid"):
    params = {"vectorBucketName": VECTOR_BUCKET, "indexName": INDEX, "topK": 3}
    if mode != "text":
        params["queryVector"] = {"float32": vector}
    if mode != "vector":
        params["queryTexts"] = [{"metadataKey": "body", "text": query}]
    s3vectors.query_vectors(**params)  # 1回目は捨てる
    times = []
    for _ in range(20):
        start = time.perf_counter()
        s3vectors.query_vectors(**params)
        times.append((time.perf_counter() - start) * 1000)
    print(f"{mode:7s} median {statistics.median(times):.0f}ms")
全文検索だけで探す
全文検索だけも今回からできるようになりました!
やり方として、queryVector を渡さずに queryTexts だけを渡すと全文検索のみになるので質問の埋め込みも要りません。
res = s3vectors.query_vectors(
    vectorBucketName=VECTOR_BUCKET, indexName=INDEX, topK=3, returnScores=True,
    queryTexts=[{"metadataKey": "body", "text": query}],
)
uv run text_only.py INC-21084 8443 "社外から社内ネットワークにつながらない"
INC-21084 [('INC-21084', 3.99), ('INC-20184', 1.21), ('INC-20148', 1.17)]
8443 [('faq-e4012', 3.12)]
社外から社内ネットワークにつながらない [('faq-e4012', 2.61), ('INC-21048', 2.48)]
「INC-21084」は正解がBM25 3.99で1位になりました!
IDそのもののようなキーワードで探すなら全文検索を使いたいですし、S3 VectorsだけでIDをピンポイントに検索できるようになったのは嬉しいですね!
「8443」では一致したE-4012の1件が返りました。言葉が違う「社外から〜」では正解が入らなかったので自然文の質問とは使い分けるのがよさそうです。
エラーメッセージに出てくる例外名でも試しました。AccessDeniedException などを含む文書を入れた一時インデックスで全文検索すると該当する1件がそれぞれ返りました。
AccessDeniedException [('err-access', 1.2)]
ValidationException [('err-validation', 1.2)]
TooManyRequestsException [('err-throttle', 1.2)]
AccessDenied []
単語単位で一致を見るので途中までの「AccessDenied」では見つかりません。ログやエラーの調べものにも使えそうです。
text_only.py・exception_search.py と search.py での比較
import sys

from common import INDEX, VECTOR_BUCKET, s3vectors

# queryVector を渡さず queryTexts だけで検索する(質問の埋め込みは作らない)
for query in sys.argv[1:]:
    res = s3vectors.query_vectors(
        vectorBucketName=VECTOR_BUCKET, indexName=INDEX, topK=3, returnScores=True,
        queryTexts=[{"metadataKey": "body", "text": query}],
    )
    print(query, [(v["key"], round(v["scores"]["bm25Scores"][0]["score"], 2)) for v in res["vectors"]])
"""例外名で全文検索できるか確かめる(一時インデックスを作って最後に消す)"""
from common import VECTOR_BUCKET, embed, s3vectors

INDEX = "exception-test"
DOCS = [
    ("err-access", "queryTexts を使った検索が AccessDeniedException になる場合は、s3vectors:GetVectors の権限を確認します。"),
    ("err-validation", "全文検索の設定が BUILDING の間に検索すると ValidationException になります。ACTIVE になるまで待ちます。"),
    ("err-throttle", "リクエストが多すぎると TooManyRequestsException が返るので、間隔を空けて再試行します。"),
    ("faq-vpn", "在宅勤務でVPNに接続できない場合は、クライアントを再起動してください。"),
]
s3vectors.create_index(
    vectorBucketName=VECTOR_BUCKET, indexName=INDEX, dataType="float32", dimension=1024, distanceMetric="cosine",
    metadataConfiguration={"nonFilterableMetadataKeys": ["body"], "textSearchConfigurations": [{"metadataKey": "body", "language": "ja"}]},
)
s3vectors.put_vectors(vectorBucketName=VECTOR_BUCKET, indexName=INDEX,
                      vectors=[{"key": k, "data": {"float32": embed(b)}, "metadata": {"body": b}} for k, b in DOCS])
try:
    for query in ["AccessDeniedException", "ValidationException", "TooManyRequestsException", "AccessDenied"]:
        res = s3vectors.query_vectors(vectorBucketName=VECTOR_BUCKET, indexName=INDEX, topK=3, returnScores=True,
                                      queryTexts=[{"metadataKey": "body", "text": query}])
        print(query, [(v["key"], round(v["scores"]["bm25Scores"][0]["score"], 2)) for v in res["vectors"]])
finally:
    s3vectors.delete_index(vectorBucketName=VECTOR_BUCKET, indexName=INDEX)
== INC-21084
vector  ['INC-20184', 'INC-21084', 'faq-e2104']
text    ['INC-21084', 'INC-20184', 'INC-20148']
hybrid  ['INC-20184', 'INC-21084', 'INC-20148']
日本語アナライザー(ja)を指定する
同じ本文を入れた body(ja)と body_std(標準)を全文検索で比べます。
uv run analyzer.py 京都 東京
京都 body [('faq-kyoto', 3.2)]
京都 body_std [('faq-kyoto', 5.33), ('faq-tokyo', 5.15)]
東京 body [('faq-tokyo', 2.9)]
東京 body_std [('faq-tokyo', 5.65), ('faq-kyoto', 2.67)]
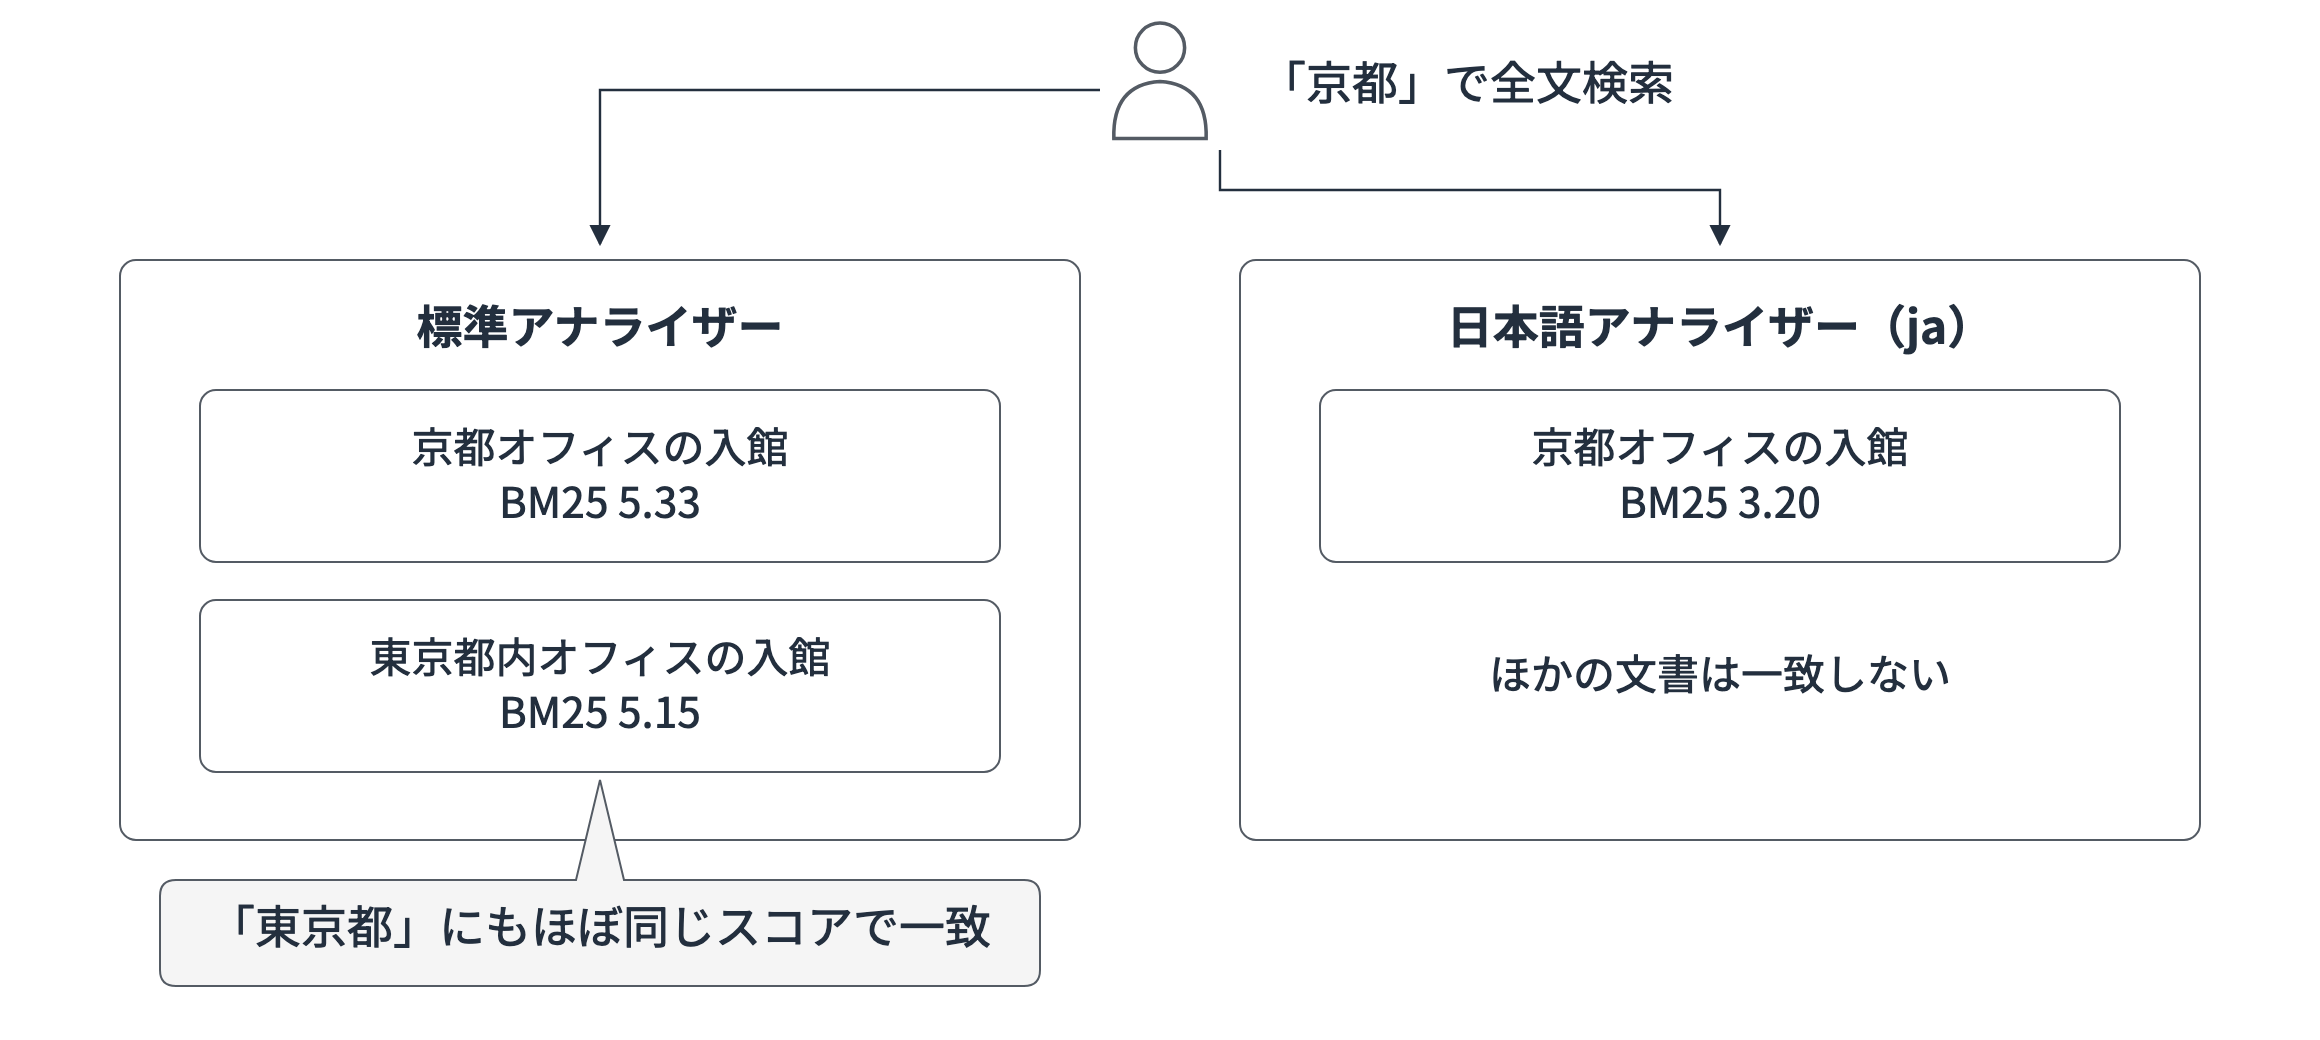
標準アナライザーでは「京都」で東京都内オフィスの文書もほぼ同点になりました。一方で、日本語アナライザーでは該当する1件だけが返りました!
アナライザーは後から変更できないので日本語の文書なら最初から language に ja を指定しておきましょう!
analyzer.py
import sys

from search import search

# 同じ本文を body(ja)と body_std(標準アナライザー)に入れてあるので、全文検索だけで比べる
for query in sys.argv[1:]:
    for field in ("body", "body_std"):
        hits = search(query, "text", field=field, top_k=4)
        print(query, field, [(v["key"], round(v["scores"]["bm25Scores"][0]["score"], 2)) for v in hits])
複数のフィールドをまとめて検索する
queryTexts には異なるメタデータキーを最大10個まで指定できます(1キーにつき1件)。タイトルと本文をまとめて検索するとBM25のスコアがフィールドごとに返ってきます。
queryTexts=[{"metadataKey": "title", "text": query}, {"metadataKey": "body", "text": query}],
multi_field.py と実行結果
from common import INDEX, VECTOR_BUCKET, embed, s3vectors

query = "京都 入館"
res = s3vectors.query_vectors(
    vectorBucketName=VECTOR_BUCKET, indexName=INDEX, topK=2, returnScores=True,
    queryVector={"float32": embed(query)},
    # タイトルと本文の両方を全文検索する(1キーにつき1件まで)
    queryTexts=[{"metadataKey": "title", "text": query}, {"metadataKey": "body", "text": query}],
)
for v in res["vectors"]:
    print(v["key"], v["scores"])
faq-kyoto {'fused': 0.03333333507180214, 'bm25Scores': [{'metadataKey': 'title', 'score': 5.800760269165039}, {'metadataKey': 'body', 'score': 5.881340026855469}], 'vectorDistance': 0.5470612049102783}
faq-tokyo {'fused': 0.032786883413791656, 'bm25Scores': [{'metadataKey': 'title', 'score': 2.329751968383789}, {'metadataKey': 'body', 'score': 2.4241280555725098}], 'vectorDistance': 0.7002952098846436}
既存のインデックスに後から全文検索を足す
全文検索の設定なしで作ったインデックスにもUpdateMetadataConfigurationで後から追加できます。
s3vectors.update_metadata_configuration(
    vectorBucketName=VECTOR_BUCKET, indexName=INDEX,
    add={"textSearchConfigurations": [{"metadataKey": "body", "language": "ja"}]},
)
   0s BUILDING
   An error occurred (ValidationException) when calling the QueryVectors operation: One or more metadataKeys in queryTexts cannot be queried until their status is ACTIVE
   5s ACTIVE
INC-21084
33件なら5秒後の確認でACTIVEになり、BUILDINGの間は全文検索がValidationExceptionで拒否されました。データ量によっては数分から数時間かかるのでGetIndexで status を確かめてから使います。
backfill.py
import time

from common import DOCS, VECTOR_BUCKET, embed, s3vectors

INDEX = "helpdesk-later"

# 全文検索の設定なしで作った既存のインデックスを用意する
s3vectors.create_index(
    vectorBucketName=VECTOR_BUCKET, indexName=INDEX, dataType="float32", dimension=1024,
    distanceMetric="cosine", metadataConfiguration={"nonFilterableMetadataKeys": ["body"]},
)
s3vectors.put_vectors(
    vectorBucketName=VECTOR_BUCKET, indexName=INDEX,
    vectors=[{"key": k, "data": {"float32": embed(b)}, "metadata": {"title": t, "body": b}} for k, t, b in DOCS],
)

# 後から body を全文検索の対象に追加する
s3vectors.update_metadata_configuration(
    vectorBucketName=VECTOR_BUCKET, indexName=INDEX,
    add={"textSearchConfigurations": [{"metadataKey": "body", "language": "ja"}]},
)

start = time.time()
while True:
    config = s3vectors.get_index(vectorBucketName=VECTOR_BUCKET, indexName=INDEX)["index"]["metadataConfiguration"]
    status = config["textSearchConfigurations"][0]["status"]
    print(f"{time.time() - start:4.0f}s {status}")
    if status == "ACTIVE":
        break
    try:
        s3vectors.query_vectors(vectorBucketName=VECTOR_BUCKET, indexName=INDEX, topK=3,
                                queryTexts=[{"metadataKey": "body", "text": "INC-21084"}])
    except s3vectors.exceptions.ValidationException as e:
        print("  ", e)
    time.sleep(5)

res = s3vectors.query_vectors(vectorBucketName=VECTOR_BUCKET, indexName=INDEX, topK=1,
                              queryTexts=[{"metadataKey": "body", "text": "INC-21084"}])
print(res["vectors"][0]["key"])
Knowledge Basesから使えるか確かめる
以前S3 VectorsのKBでRAGを作ったのでKBからハイブリッド検索できるかも試しました。
同じ33件をKBに取り込んでRetrieve APIの overrideSearchType にHYBRIDを指定します。
res = runtime.retrieve(
    knowledgeBaseId=kb_id,
    retrievalQuery={"text": query},
    retrievalConfiguration={"vectorSearchConfiguration": {
        "numberOfResults": top_k, "overrideSearchType": search_type}},
)
SEMANTIC ['INC-20184', 'INC-21084', 'faq-e2104']
HYBRID ERROR: An error occurred (ValidationException) when calling the Retrieve operation: HYBRID search type is not supported for search operation on index 2APPJQMZOZ. Retry your request with a different search type.
予想どおりValidationExceptionで拒否されました。KBのドキュメントでもハイブリッド検索に対応するベクトルストアはAmazon RDS・OpenSearch Serverless・MongoDBの3つです。
KBのインデックス側でチャンクの本文(AMAZON_BEDROCK_TEXT)を全文検索の対象にしても結果は同じでした。一方で同じインデックスに対してQueryVectorsを直接呼び出すとハイブリッド検索できました!
res = s3vectors.query_vectors(
    vectorBucketName=VECTOR_BUCKET, indexName="kb-index", topK=top_k, returnMetadata=True,
    queryVector={"float32": embed(query)},
    queryTexts=[{"metadataKey": "AMAZON_BEDROCK_TEXT", "text": query}],
)
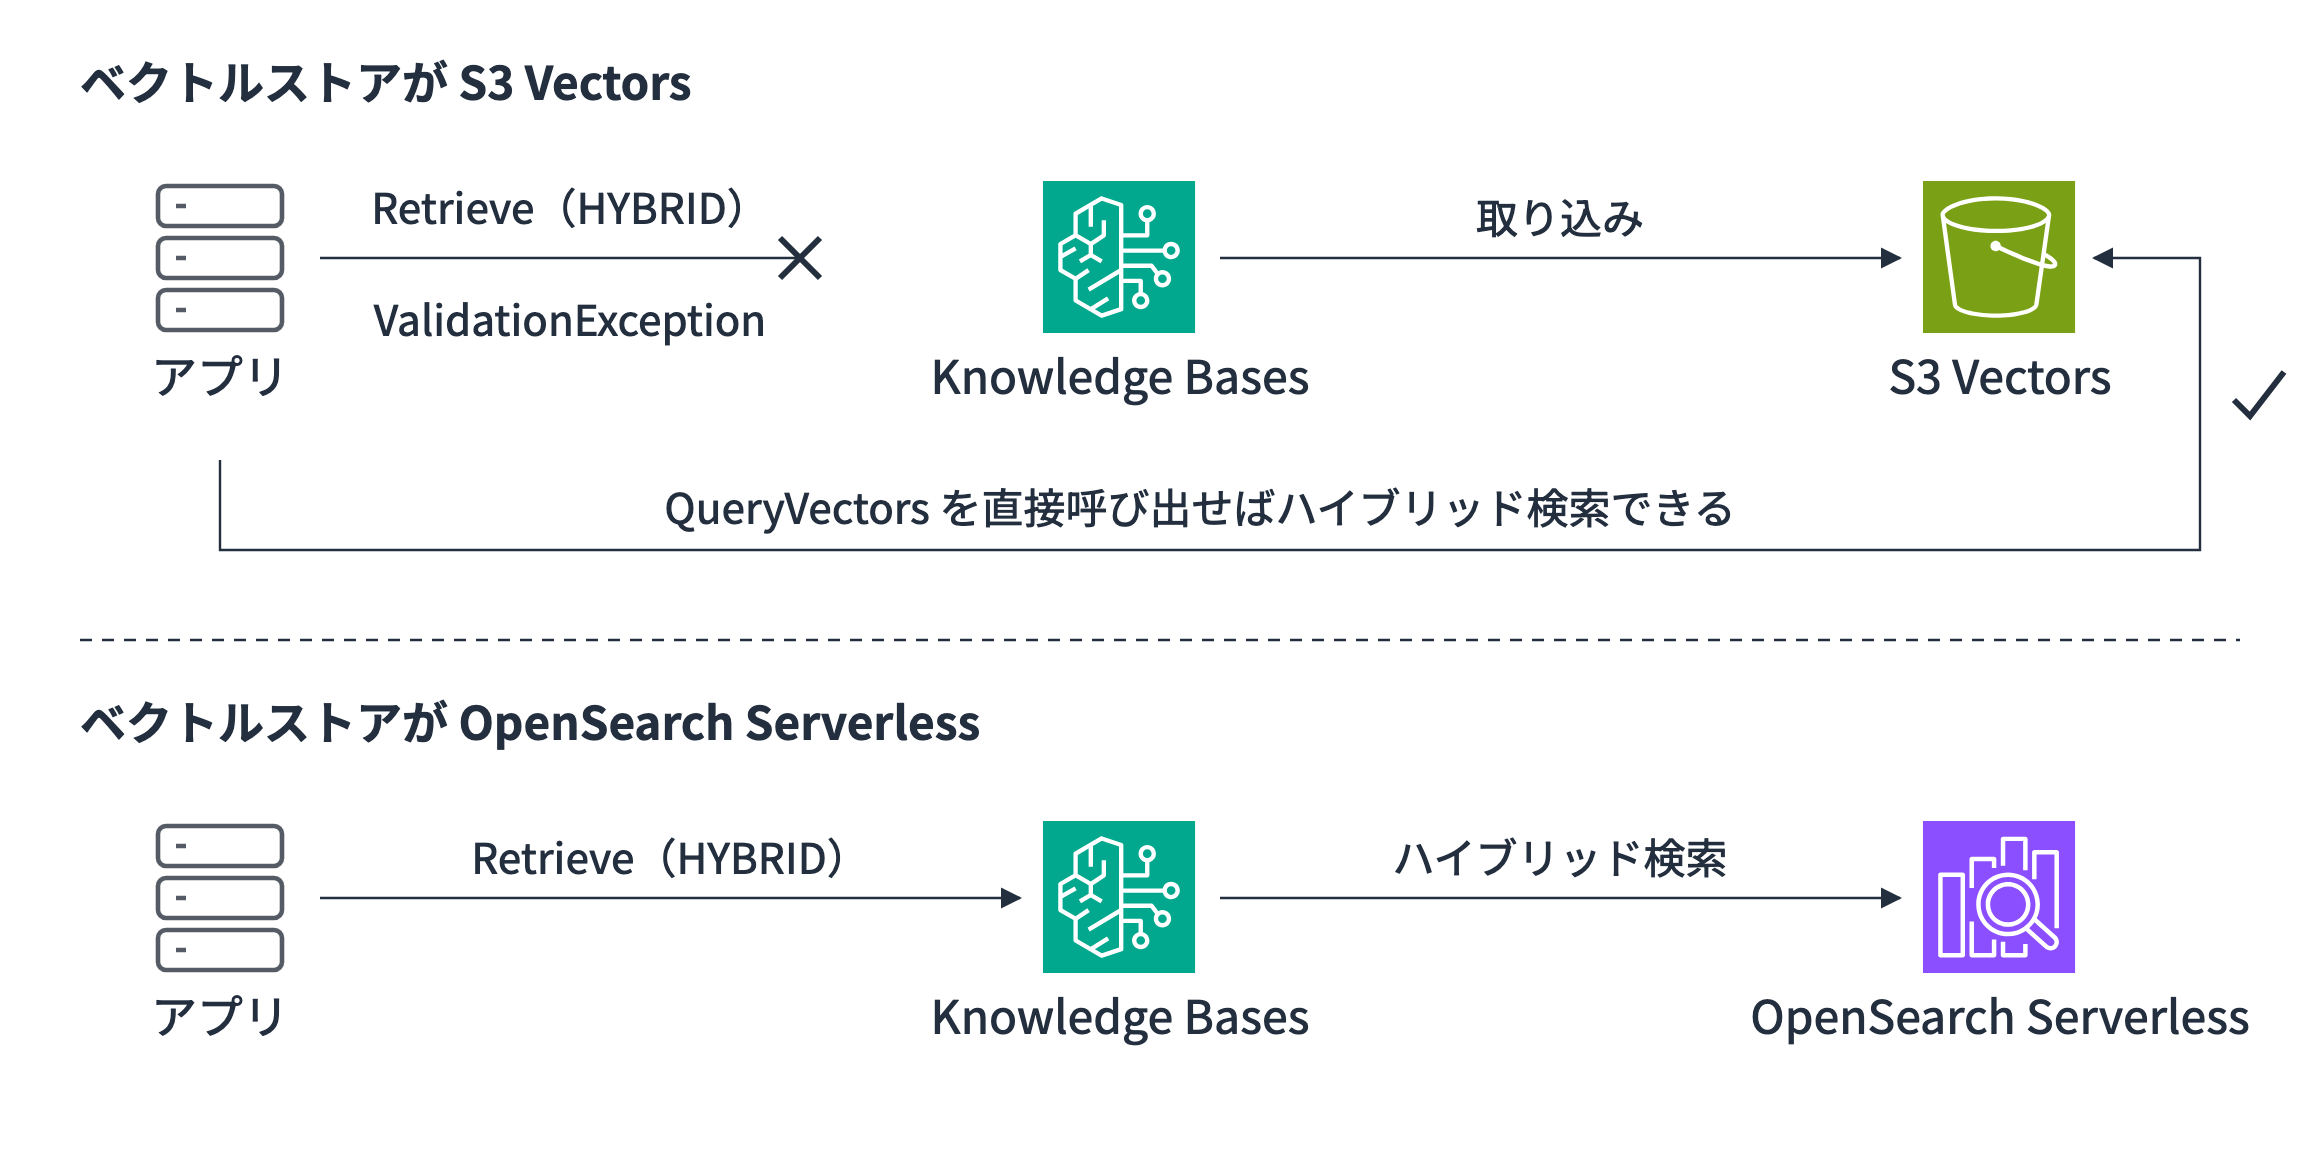
取り込みはKBに任せて検索はS3 Vectorsを直接呼び出す構成です。再同期したら設定維持されるのか気になったのですが特に問題ありませんでした!
この場合、質問のベクトル化とソースの場所(AMAZON_BEDROCK_METADATA)の取り出しはアプリ側で行います。自前でベクトル化するのは少し面倒ですが、ただ既存のKBに直接クエリをかけてハイブリッド検索できるのは良いですね!
OpenSearch ServerlessのKBと比べる
HYBRIDを指定できるOpenSearch ServerlessのKBにも同じ33件を取り込んで1位を比べました!
OpenSearch側のインデックスは本文に日本語のアナライザー(kuromoji)を指定し、S3 Vectorsの列は上のKBのインデックスにQueryVectorsを直接呼び出した結果です。
| 質問 | OpenSearch SEMANTIC | OpenSearch HYBRID | S3 Vectors ハイブリッド |
|---|---|---|---|
| INC-21084 の内容 | INC-20184 | INC-21084 ○ | INC-21084 ○ |
| INC-20184 の再発防止策 | INC-20184 ○ | INC-20184 ○ | INC-20418 |
| 社外から社内ネットワークにつながらない | INC-20418 ○ | INC-20418 ○ | INC-21048 |
| E-1204 でサインインできない | E-1204 ○ | E-1204 ○ | E-1204 ○ |
| 京都 | INC-20184 | 京都オフィスの入館 ○ | 京都オフィスの入館 ○ |
実行結果(上位3件)
== INC-21084 の内容
  OpenSearch KB SEMANTIC: ['INC-20184', 'INC-21084', 'faq-e2104']
  OpenSearch KB HYBRID  : ['INC-21084', 'INC-20184', 'faq-e2104']
  S3 Vectors  hybrid    : ['INC-21084', 'INC-20184', 'INC-20148']
== INC-20184 の再発防止策
  OpenSearch KB SEMANTIC: ['INC-20184', 'INC-20418', 'INC-20481']
  OpenSearch KB HYBRID  : ['INC-20184', 'INC-20418', 'INC-20481']
  S3 Vectors  hybrid    : ['INC-20418', 'INC-20184', 'INC-20148']
== 社外から社内ネットワークにつながらない
  OpenSearch KB SEMANTIC: ['INC-20418', 'INC-21048', 'faq-vpn']
  OpenSearch KB HYBRID  : ['INC-20418', 'INC-21048', 'faq-vpn']
  S3 Vectors  hybrid    : ['INC-21048', 'INC-20418', 'faq-e4012']
== E-1204 でサインインできない
  OpenSearch KB SEMANTIC: ['faq-e1204', 'faq-e1042', 'faq-e4201']
  OpenSearch KB HYBRID  : ['faq-e1204', 'faq-e1042', 'faq-e4201']
  S3 Vectors  hybrid    : ['faq-e1204', 'faq-e1042', 'faq-e4201']
== 京都
  OpenSearch KB SEMANTIC: ['INC-20184', 'faq-kyoto', 'INC-20481']
  OpenSearch KB HYBRID  : ['faq-kyoto', 'INC-20184', 'INC-20481']
  S3 Vectors  hybrid    : ['faq-kyoto', 'INC-20184', 'INC-20481']
OpenSearchのHYBRIDは5問とも1位が正解でした!
S3 Vectorsは2問で1位を外していて、「INC-20184 の再発防止策」は正解と同点(0.03306)です。「社外から〜」は両方の検索で上位に来た別の文書が1位になりました。上位3件にはどちらも全問で正解が入っていますが、今回の5問の1位だけで見るとOpenSearchのほうが正確でした。
S3 Vectorsは language に ja を指定すれば日本語向けになり、コレクションや3つのポリシーを用意するOpenSearch Serverlessより準備も軽く済むのでいいですね。
運用コスト的にもだいぶお安いのでまずはS3 Vectorsで十分かどうか検索したいデータで試すのが良いですね!
Knowledge Basesの検証に使ったコード
次の順に実行しました。KBのIDは kb_create.py の出力から取ります。
uv run kb_prepare.py                  # IAMロール・文書のS3バケット・S3 Vectorsのインデックス
uv run kb_create.py s3vectors         # S3 VectorsのKBを作って取り込む
uv run kb_retrieve.py <KBのID> "INC-21084 の内容"
uv run kb_enable_text_search.py       # KBのインデックスで全文検索を有効にする
uv run kb_setup_aoss.py               # OpenSearch Serverlessのコレクション(ACTIVEになるまで待つ)
uv run aoss_index.py                  # KB用のベクトルインデックスと区切り方の確認
uv run kb_create.py aoss              # OpenSearch ServerlessのKBを作って取り込む
uv run compare.py <OpenSearch ServerlessのKBのID> "INC-21084 の内容" "INC-20184 の再発防止策" \
  "社外から社内ネットワークにつながらない" "E-1204 でサインインできない" "京都"
"""KB用のIAMロール・文書のS3バケット・S3 Vectorsのインデックスを用意する"""
import json

import boto3

from common import DOCS, REGION, VECTOR_BUCKET, s3vectors

ACCOUNT = boto3.client("sts").get_caller_identity()["Account"]
SRC_BUCKET = f"hybrid-search-demo-src-{ACCOUNT}"
ROLE = "hybrid-search-demo-kb-role"
KB_INDEX = "kb-index"

s3 = boto3.client("s3", region_name=REGION)
s3.create_bucket(Bucket=SRC_BUCKET, CreateBucketConfiguration={"LocationConstraint": REGION})
for key, title, body in DOCS:
    if key.startswith("INC-"):  # 障害チケットは本文だけ(本文の先頭にIDがある)
        s3.put_object(Bucket=SRC_BUCKET, Key=f"tickets/{key}.txt", Body=body.encode())
    else:
        s3.put_object(Bucket=SRC_BUCKET, Key=f"faq/{key}.txt", Body=f"{title}\n{body}".encode())

# KBが作るメタデータ(本文とソース情報)はフィルター不要なので non-filterable にする
s3vectors.create_index(
    vectorBucketName=VECTOR_BUCKET, indexName=KB_INDEX, dataType="float32", dimension=1024,
    distanceMetric="cosine",
    metadataConfiguration={"nonFilterableMetadataKeys": ["AMAZON_BEDROCK_TEXT", "AMAZON_BEDROCK_METADATA"]},
)

iam = boto3.client("iam")
iam.create_role(
    RoleName=ROLE,
    AssumeRolePolicyDocument=json.dumps({"Version": "2012-10-17", "Statement": [{
        "Effect": "Allow", "Principal": {"Service": "bedrock.amazonaws.com"}, "Action": "sts:AssumeRole",
        "Condition": {"StringEquals": {"aws:SourceAccount": ACCOUNT}},
    }]}),
)
iam.put_role_policy(
    RoleName=ROLE, PolicyName="kb",
    PolicyDocument=json.dumps({"Version": "2012-10-17", "Statement": [
        {"Effect": "Allow", "Action": "bedrock:InvokeModel",
         "Resource": f"arn:aws:bedrock:{REGION}::foundation-model/amazon.titan-embed-text-v2:0"},
        {"Effect": "Allow", "Action": ["s3:GetObject", "s3:ListBucket"],
         "Resource": [f"arn:aws:s3:::{SRC_BUCKET}", f"arn:aws:s3:::{SRC_BUCKET}/*"]},
        {"Effect": "Allow", "Action": ["s3vectors:PutVectors", "s3vectors:GetVectors", "s3vectors:DeleteVectors",
                                       "s3vectors:QueryVectors", "s3vectors:GetIndex"],
         "Resource": f"arn:aws:s3vectors:{REGION}:{ACCOUNT}:bucket/{VECTOR_BUCKET}/index/{KB_INDEX}"},
        {"Effect": "Allow", "Action": "aoss:APIAccessAll",
         "Resource": f"arn:aws:aoss:{REGION}:{ACCOUNT}:collection/*"},
    ]}),
)
print("ok", SRC_BUCKET)
"""KBを作って文書を取り込む。引数: s3vectors | aoss"""
import sys
import time

import boto3

REGION = "ap-northeast-1"
ACCOUNT = boto3.client("sts").get_caller_identity()["Account"]
ROLE_ARN = f"arn:aws:iam::{ACCOUNT}:role/hybrid-search-demo-kb-role"
SRC_BUCKET = f"hybrid-search-demo-src-{ACCOUNT}"
EMBED_ARN = f"arn:aws:bedrock:{REGION}::foundation-model/amazon.titan-embed-text-v2:0"

kind = sys.argv[1]
if kind == "s3vectors":
    storage = {"type": "S3_VECTORS", "s3VectorsConfiguration": {
        "indexArn": f"arn:aws:s3vectors:{REGION}:{ACCOUNT}:bucket/hybrid-search-demo/index/kb-index"}}
else:
    coll = boto3.client("opensearchserverless", region_name=REGION).batch_get_collection(
        names=["hybrid-search-demo"])["collectionDetails"][0]
    storage = {"type": "OPENSEARCH_SERVERLESS", "opensearchServerlessConfiguration": {
        "collectionArn": coll["arn"], "vectorIndexName": "kb-index",
        "fieldMapping": {"vectorField": "embedding", "textField": "AMAZON_BEDROCK_TEXT_CHUNK",
                         "metadataField": "AMAZON_BEDROCK_METADATA"}}}

agent = boto3.client("bedrock-agent", region_name=REGION)
kb = agent.create_knowledge_base(
    name=f"hybrid-search-demo-{kind}", roleArn=ROLE_ARN,
    knowledgeBaseConfiguration={"type": "VECTOR", "vectorKnowledgeBaseConfiguration": {
        "embeddingModelArn": EMBED_ARN,
        "embeddingModelConfiguration": {"bedrockEmbeddingModelConfiguration": {"dimensions": 1024, "embeddingDataType": "FLOAT32"}}}},
    storageConfiguration=storage,
)["knowledgeBase"]
kb_id = kb["knowledgeBaseId"]
while agent.get_knowledge_base(knowledgeBaseId=kb_id)["knowledgeBase"]["status"] != "ACTIVE":
    time.sleep(5)
ds_id = agent.create_data_source(
    knowledgeBaseId=kb_id, name="faq-and-tickets",
    dataSourceConfiguration={"type": "S3", "s3Configuration": {"bucketArn": f"arn:aws:s3:::{SRC_BUCKET}"}},
)["dataSource"]["dataSourceId"]
job_id = agent.start_ingestion_job(knowledgeBaseId=kb_id, dataSourceId=ds_id)["ingestionJob"]["ingestionJobId"]
while True:
    job = agent.get_ingestion_job(knowledgeBaseId=kb_id, dataSourceId=ds_id, ingestionJobId=job_id)["ingestionJob"]
    if job["status"] in ("COMPLETE", "FAILED", "STOPPED"):
        break
    time.sleep(5)
print(kind, kb_id, job["status"], job.get("statistics"), job.get("failureReasons"))
import sys

import boto3

runtime = boto3.client("bedrock-agent-runtime", region_name="ap-northeast-1")

def retrieve(kb_id: str, query: str, search_type: str, top_k: int = 3):
    res = runtime.retrieve(
        knowledgeBaseId=kb_id,
        retrievalQuery={"text": query},
        retrievalConfiguration={"vectorSearchConfiguration": {
            "numberOfResults": top_k, "overrideSearchType": search_type}},
    )
    return [r["location"]["s3Location"]["uri"].rsplit("/", 1)[-1].removesuffix(".txt") for r in res["retrievalResults"]]

if __name__ == "__main__":
    kb_id, query = sys.argv[1], sys.argv[2]
    for search_type in ("SEMANTIC", "HYBRID"):
        try:
            print(search_type, retrieve(kb_id, query, search_type))
        except Exception as e:
            print(search_type, "ERROR:", e)
"""KBが使うS3 Vectorsのインデックスで、チャンクの本文を全文検索の対象にする"""
import time

from common import VECTOR_BUCKET, s3vectors

s3vectors.update_metadata_configuration(
    vectorBucketName=VECTOR_BUCKET, indexName="kb-index",
    add={"textSearchConfigurations": [{"metadataKey": "AMAZON_BEDROCK_TEXT", "language": "ja"}]},
)
while True:
    config = s3vectors.get_index(vectorBucketName=VECTOR_BUCKET, indexName="kb-index")["index"]["metadataConfiguration"]
    if config["textSearchConfigurations"][0]["status"] == "ACTIVE":
        break
    time.sleep(5)
print(config)
"""OpenSearch Serverless のコレクションを作る(KBの比較用)"""
import json

import boto3

REGION = "ap-northeast-1"
ACCOUNT = boto3.client("sts").get_caller_identity()["Account"]
COLLECTION = "hybrid-search-demo"
KB_ROLE_ARN = f"arn:aws:iam::{ACCOUNT}:role/hybrid-search-demo-kb-role"
ME_ARN = f"arn:aws:iam::{ACCOUNT}:role/<自分のロール名>"  # インデックスを作るIAMロールに置き換える

aoss = boto3.client("opensearchserverless", region_name=REGION)
aoss.create_security_policy(
    name=f"{COLLECTION}-enc", type="encryption",
    policy=json.dumps({"Rules": [{"ResourceType": "collection", "Resource": [f"collection/{COLLECTION}"]}], "AWSOwnedKey": True}),
)
aoss.create_security_policy(
    name=f"{COLLECTION}-net", type="network",
    policy=json.dumps([{"Rules": [{"ResourceType": "collection", "Resource": [f"collection/{COLLECTION}"]}], "AllowFromPublic": True}]),
)
aoss.create_access_policy(
    name=f"{COLLECTION}-data", type="data",
    policy=json.dumps([{
        "Rules": [
            {"ResourceType": "collection", "Resource": [f"collection/{COLLECTION}"], "Permission": ["aoss:*"]},
            {"ResourceType": "index", "Resource": [f"index/{COLLECTION}/*"], "Permission": ["aoss:*"]},
        ],
        "Principal": [KB_ROLE_ARN, ME_ARN],
    }]),
)
res = aoss.create_collection(name=COLLECTION, type="VECTORSEARCH", standbyReplicas="DISABLED")
print(res["createCollectionDetail"]["id"], res["createCollectionDetail"]["status"])
"""KB用のベクトルインデックスを作る(本文に日本語のアナライザー kuromoji を指定)"""
import time

import boto3
from opensearchpy import AWSV4SignerAuth, OpenSearch, RequestsHttpConnection

REGION = "ap-northeast-1"
coll = boto3.client("opensearchserverless", region_name=REGION).batch_get_collection(
    names=["hybrid-search-demo"])["collectionDetails"][0]
host = coll["collectionEndpoint"].removeprefix("https://")
client = OpenSearch(
    hosts=[{"host": host, "port": 443}], http_auth=AWSV4SignerAuth(boto3.Session().get_credentials(), REGION, "aoss"),
    use_ssl=True, connection_class=RequestsHttpConnection, timeout=60,
)
print(client.indices.create(index="kb-index", body={
    "settings": {"index": {"knn": True, "knn.algo_param.ef_search": 512}},
    "mappings": {"properties": {
        "embedding": {"type": "knn_vector", "dimension": 1024,
                      "method": {"name": "hnsw", "engine": "faiss", "parameters": {}, "space_type": "l2"}},
        "AMAZON_BEDROCK_TEXT_CHUNK": {"type": "text", "index": "true", "analyzer": "kuromoji"},
        "AMAZON_BEDROCK_METADATA": {"type": "text", "index": "false"},
    }},
}))

# 本文のフィールドで日本語がどう区切られるかを確認する(作成直後は見つからないので少し待つ)
time.sleep(30)
tokens = client.indices.analyze(index="kb-index", body={"field": "AMAZON_BEDROCK_TEXT_CHUNK", "text": "東京都内の京都オフィス"})
print([t["token"] for t in tokens["tokens"]])
"""同じ質問で KB(OpenSearch Serverless) と S3 Vectors のハイブリッド検索を比べる"""
import json
import sys

from common import VECTOR_BUCKET, embed, s3vectors
from kb_retrieve import retrieve

AOSS_KB = sys.argv[1]

def s3vectors_hybrid(query: str, top_k: int = 3):
    res = s3vectors.query_vectors(
        vectorBucketName=VECTOR_BUCKET, indexName="kb-index", topK=top_k, returnMetadata=True,
        queryVector={"float32": embed(query)},
        queryTexts=[{"metadataKey": "AMAZON_BEDROCK_TEXT", "text": query}],
    )
    names = []
    for v in res["vectors"]:
        source = json.loads(v["metadata"]["AMAZON_BEDROCK_METADATA"])["source"]["sourceLocation"]
        names.append(source.rsplit("/", 1)[-1].removesuffix(".txt"))
    return names

for q in sys.argv[2:]:
    print("==", q)
    print("  OpenSearch KB SEMANTIC:", retrieve(AOSS_KB, q, "SEMANTIC"))
    print("  OpenSearch KB HYBRID  :", retrieve(AOSS_KB, q, "HYBRID"))
    print("  S3 Vectors  hybrid    :", s3vectors_hybrid(q))
既存のKBで使えるようにする
既存のKBでもハイブリッド検索を使いたい…!という場合の手順も確認しておきましょう。
2026年9月30日より前に作ったバケットのインデックスは、切り替えていなければCLASSICモードです。
仮にCLASSICのまま全文検索を追加しようとすると拒否されます。
An error occurred (ValidationException) when calling the UpdateMetadataConfiguration operation: Text search is not supported for CLASSIC indexes. Update the index to ENHANCED before updating textSearchConfigurations.
そのため先にENHANCEDへ切り替えてから AMAZON_BEDROCK_TEXT を全文検索の対象に追加します。データの取り込み直しは要りません。
mode = s3vectors.get_index(**target)["index"]["indexMode"]
if mode == "CLASSIC":
    s3vectors.update_index_mode(**target, indexMode="ENHANCED")
s3vectors.update_metadata_configuration(
    **target, add={"textSearchConfigurations": [{"metadataKey": "AMAZON_BEDROCK_TEXT", "language": "ja"}]},
)
uv run migrate.py <ベクトルバケット名> <インデックス名>
indexMode: CLASSIC
indexMode: ENHANCED
5s {'metadataKey': 'AMAZON_BEDROCK_TEXT', 'language': 'ja', 'status': 'ACTIVE'}
切り替えは呼び出した直後に反映され、全文検索も5秒でACTIVEになりました。移行後もKBのRetrieveと同期はそのまま使えて、同期で追加した文書も全文検索の対象になりました。既存のKBでもすぐ試せるのは嬉しいですね!
migrate.py と検証用のKBを作るコード
"""既存のKBのインデックスでハイブリッド検索を使えるようにする
使い方: uv run migrate.py <ベクトルバケット名> <インデックス名>
"""
import sys
import time

from common import s3vectors

bucket, index = sys.argv[1], sys.argv[2]
target = {"vectorBucketName": bucket, "indexName": index}

# 2026年9月30日より前に作ったバケットのインデックスはCLASSICなので、先にENHANCEDへ切り替える
mode = s3vectors.get_index(**target)["index"]["indexMode"]
print("indexMode:", mode)
if mode == "CLASSIC":
    s3vectors.update_index_mode(**target, indexMode="ENHANCED")
    print("indexMode:", s3vectors.get_index(**target)["index"]["indexMode"])

# KBがチャンクの本文を入れている AMAZON_BEDROCK_TEXT を全文検索の対象にする
s3vectors.update_metadata_configuration(
    **target, add={"textSearchConfigurations": [{"metadataKey": "AMAZON_BEDROCK_TEXT", "language": "ja"}]},
)
start = time.time()
while True:
    config = s3vectors.get_index(**target)["index"]["metadataConfiguration"]["textSearchConfigurations"][0]
    if config["status"] == "ACTIVE":
        break
    time.sleep(5)
print(f"{time.time() - start:.0f}s", config)
検証では2026年9月30日より前に作ったベクトルバケットに一時インデックスを作ってKBをつなぎました(ロールと文書は kb_prepare.py で用意)。
uv run kb_prepare.py  # 前の手順で実行済みなら不要
uv run migration_kb_setup.py <古いベクトルバケット名>
"""移行の検証用に、2026年9月30日より前に作ったベクトルバケットへCLASSICのインデックスとKBを作る
使い方: uv run migration_kb_setup.py <古いベクトルバケット名> [cleanup]
"""
import json
import sys
import time

import boto3

from common import REGION, s3vectors

ACCOUNT = boto3.client("sts").get_caller_identity()["Account"]
OLD_BUCKET = sys.argv[1]
INDEX = "hybrid-migration-test"
ROLE = "hybrid-search-demo-kb-role"
INDEX_ARN = f"arn:aws:s3vectors:{REGION}:{ACCOUNT}:bucket/{OLD_BUCKET}/index/{INDEX}"
agent = boto3.client("bedrock-agent", region_name=REGION)
iam = boto3.client("iam")

if sys.argv[2:] == ["cleanup"]:
    # cleanup.py でKBを消した後に、古いバケットに作った一時インデックスだけを消す(バケットは消さない)
    s3vectors.delete_index(vectorBucketName=OLD_BUCKET, indexName=INDEX)
    print("deleted", INDEX)
    sys.exit()

s3vectors.create_index(
    vectorBucketName=OLD_BUCKET, indexName=INDEX, dataType="float32", dimension=1024,
    distanceMetric="cosine",
    metadataConfiguration={"nonFilterableMetadataKeys": ["AMAZON_BEDROCK_TEXT", "AMAZON_BEDROCK_METADATA"]},
)
print("indexMode:", s3vectors.get_index(vectorBucketName=OLD_BUCKET, indexName=INDEX)["index"]["indexMode"])

iam.put_role_policy(
    RoleName=ROLE, PolicyName="kb-migration",
    PolicyDocument=json.dumps({"Version": "2012-10-17", "Statement": [{
        "Effect": "Allow",
        "Action": ["s3vectors:PutVectors", "s3vectors:GetVectors", "s3vectors:DeleteVectors",
                   "s3vectors:QueryVectors", "s3vectors:GetIndex"],
        "Resource": INDEX_ARN,
    }]}),
)
time.sleep(10)

kb_id = agent.create_knowledge_base(
    name="hybrid-search-demo-migration", roleArn=f"arn:aws:iam::{ACCOUNT}:role/{ROLE}",
    knowledgeBaseConfiguration={"type": "VECTOR", "vectorKnowledgeBaseConfiguration": {
        "embeddingModelArn": f"arn:aws:bedrock:{REGION}::foundation-model/amazon.titan-embed-text-v2:0",
        "embeddingModelConfiguration": {"bedrockEmbeddingModelConfiguration": {"dimensions": 1024, "embeddingDataType": "FLOAT32"}}}},
    storageConfiguration={"type": "S3_VECTORS", "s3VectorsConfiguration": {"indexArn": INDEX_ARN}},
)["knowledgeBase"]["knowledgeBaseId"]
while agent.get_knowledge_base(knowledgeBaseId=kb_id)["knowledgeBase"]["status"] != "ACTIVE":
    time.sleep(5)
ds_id = agent.create_data_source(
    knowledgeBaseId=kb_id, name="faq-and-tickets",
    dataSourceConfiguration={"type": "S3", "s3Configuration": {"bucketArn": f"arn:aws:s3:::hybrid-search-demo-src-{ACCOUNT}"}},
)["dataSource"]["dataSourceId"]
job_id = agent.start_ingestion_job(knowledgeBaseId=kb_id, dataSourceId=ds_id)["ingestionJob"]["ingestionJobId"]
while (job := agent.get_ingestion_job(knowledgeBaseId=kb_id, dataSourceId=ds_id, ingestionJobId=job_id)["ingestionJob"])["status"] not in ("COMPLETE", "FAILED"):
    time.sleep(5)
print("KB:", kb_id, job["status"], job["statistics"]["numberOfNewDocumentsIndexed"])
ハイブリッド検索でRAGを組む
KBのRetrieveAndGenerateもHYBRIDを指定すると同じエラーになったので、回答の生成も自分で呼び出します。
質問から検索語を抜き出してハイブリッド検索し、取れたチャンクを参照情報にしてConverseで回答を生成します。今回はハイブリッド検索を行うため質問のベクトルも渡します。ベクトルはKBの取り込みと同じTitan Text Embeddings V2(1024次元)で作っています。
keywords = converse(KEYWORD_PROMPT + question)
hits = s3vectors.query_vectors(
    vectorBucketName=bucket, indexName=index, topK=3, returnMetadata=True,
    queryVector={"float32": embed(question)},
    queryTexts=[{"metadataKey": "AMAZON_BEDROCK_TEXT", "text": keywords}],
)["vectors"]
context = "\n\n".join(f"[{i}] {h['metadata']['AMAZON_BEDROCK_TEXT']}" for i, h in enumerate(hits, 1))
answer = converse(f"質問:\n{question}\n\n参照情報:\n{context}", SYSTEM_PROMPT)
全文検索には質問文ではなくLLMで抜き出した検索語を渡しています。書籍『Amazon Bedrock実践ガイド』のオンライン補足で23問を評価したときも、このほうが取得率は高くなりました。
移行したKBのインデックスで試します。
uv run rag.py <ベクトルバケット名> <インデックス名> "INC-21084 ではどんな対応をしましたか?"
検索語: INC-21084 対応
参照: ['INC-21084.txt', 'INC-20184.txt', 'INC-20148.txt']
回答: INC-21084 では、次の対応をしました。

- 原因:端末のディスク容量が不足していたことで、ファイル同期アプリの同期が止まっていました。
- 対応:利用者に不要ファイルの削除を案内しました。
問題なく正しいチケットの原因と対応まで答えられていますね!RetrieveAndGenerateの代わりに自分で処理を実装する必要はありますがそこまで難しくないので良いですね。
rag.py
"""KBのインデックスをハイブリッド検索して回答を生成する
使い方: uv run rag.py <ベクトルバケット名> <インデックス名> <質問>
"""
import json
import sys

from common import bedrock, embed, s3vectors

MODEL = "jp.anthropic.claude-haiku-5-5"
KEYWORD_PROMPT = "次の質問から、検索語として役立つ名詞・固有名詞・数字・記号だけをスペース区切りで出力してください。説明は不要です。\n質問: "
SYSTEM_PROMPT = "社内ヘルプデスクのアシスタントとして回答します。参照情報に根拠がある内容だけを答え、根拠がなければ分からないと答えてください。"

def converse(text: str, system: str | None = None) -> str:
    params = {"modelId": MODEL, "messages": [{"role": "user", "content": [{"text": text}]}],
              "inferenceConfig": {"maxTokens": 500}}
    if system:
        params["system"] = [{"text": system}]
    return bedrock.converse(**params)["output"]["message"]["content"][0]["text"].strip()

bucket, index, question = sys.argv[1], sys.argv[2], sys.argv[3]

# 検索語を抜き出して全文検索に、質問文のベクトルをベクトル検索に使う
keywords = converse(KEYWORD_PROMPT + question)
hits = s3vectors.query_vectors(
    vectorBucketName=bucket, indexName=index, topK=3, returnMetadata=True,
    queryVector={"float32": embed(question)},
    queryTexts=[{"metadataKey": "AMAZON_BEDROCK_TEXT", "text": keywords}],
)["vectors"]

# 取れたチャンクを番号付きの参照情報にして回答を生成する
context = "\n\n".join(f"[{i}] {h['metadata']['AMAZON_BEDROCK_TEXT']}" for i, h in enumerate(hits, 1))
answer = converse(f"質問:\n{question}\n\n参照情報:\n{context}", SYSTEM_PROMPT)

sources = [json.loads(h["metadata"]["AMAZON_BEDROCK_METADATA"])["source"]["sourceLocation"].rsplit("/", 1)[-1] for h in hits]
print("検索語:", keywords)
print("参照:", sources)
print("回答:", answer)
後片付け
作ったリソースをまとめて削除します。OpenSearch Serverlessは時間単位で課金されるので早めに消しておきます。
uv run cleanup.py
uv run migration_kb_setup.py <古いベクトルバケット名> cleanup  # 移行の検証で作った一時インデックス
cleanup.py
"""検証で作ったリソースを削除する"""
import time

import boto3

from common import REGION, VECTOR_BUCKET, s3vectors

ACCOUNT = boto3.client("sts").get_caller_identity()["Account"]
agent = boto3.client("bedrock-agent", region_name=REGION)
aoss = boto3.client("opensearchserverless", region_name=REGION)

# Knowledge Bases
# データソースの削除ではベクトルストアのデータも消すので、終わるまで待ってからベクトルストアとIAMロールを消す
for kb in agent.list_knowledge_bases()["knowledgeBaseSummaries"]:
    if kb["name"].startswith("hybrid-search-demo-"):
        kb_id = kb["knowledgeBaseId"]
        for ds in agent.list_data_sources(knowledgeBaseId=kb_id)["dataSourceSummaries"]:
            agent.delete_data_source(knowledgeBaseId=kb_id, dataSourceId=ds["dataSourceId"])
        while sources := agent.list_data_sources(knowledgeBaseId=kb_id)["dataSourceSummaries"]:
            if any(ds["status"] == "DELETE_UNSUCCESSFUL" for ds in sources):
                raise RuntimeError(f"データソースの削除に失敗しました: {kb_id}")
            time.sleep(5)
        agent.delete_knowledge_base(knowledgeBaseId=kb_id)
        while True:
            try:
                status = agent.get_knowledge_base(knowledgeBaseId=kb_id)["knowledgeBase"]["status"]
            except agent.exceptions.ResourceNotFoundException:
                break
            if status == "DELETE_UNSUCCESSFUL":
                raise RuntimeError(f"KBの削除に失敗しました: {kb_id}")
            time.sleep(5)

# OpenSearch Serverless
for c in aoss.batch_get_collection(names=["hybrid-search-demo"])["collectionDetails"]:
    aoss.delete_collection(id=c["id"])
for name, kind in [("hybrid-search-demo-enc", "encryption"), ("hybrid-search-demo-net", "network")]:
    try:
        aoss.delete_security_policy(name=name, type=kind)
    except aoss.exceptions.ResourceNotFoundException:
        pass
try:
    aoss.delete_access_policy(name="hybrid-search-demo-data", type="data")
except aoss.exceptions.ResourceNotFoundException:
    pass

# S3 Vectors(インデックスを消してからバケットを消す)
for index in s3vectors.list_indexes(vectorBucketName=VECTOR_BUCKET)["indexes"]:
    s3vectors.delete_index(vectorBucketName=VECTOR_BUCKET, indexName=index["indexName"])
s3vectors.delete_vector_bucket(vectorBucketName=VECTOR_BUCKET)

# 文書を置いたS3バケット
bucket = boto3.resource("s3", region_name=REGION).Bucket(f"hybrid-search-demo-src-{ACCOUNT}")
bucket.objects.all().delete()
bucket.delete()

# KB用のIAMロール
iam = boto3.client("iam")
for name in iam.list_role_policies(RoleName="hybrid-search-demo-kb-role")["PolicyNames"]:
    iam.delete_role_policy(RoleName="hybrid-search-demo-kb-role", PolicyName=name)
iam.delete_role(RoleName="hybrid-search-demo-kb-role")
print("done")
おわりに
S3 Vectors単体で全文検索とハイブリッド検索ができるようになったのは激アツなアップデートでした!ハイブリッド検索も含めてRAGを作りたいと思った際の第一候補になりそうです!
まずS3 Vectorsで試してみて、もし物足りない箇所があれば、Managed KBやOpenSearch含めて検討といったところな気がします!
本記事が少しでも参考になれば幸いです!最後までご覧いただきありがとうございましたー!