EKS でスケーラブルな LLM 推論基盤を作る

こんにちは、クラウド事業統括本部のイシザワです。今回は、EKS 上で負荷に応じて GPU ノードと推論エンジンが 0 台から増減する LLM の推論基盤を作ってみます。
データを外部に出せない、特定のモデルを使いたいといった理由で、オープンウェイトの LLM を自前で動かしたい場面があります。そのとき、Web アプリケーションと同じ発想でオートスケールを組んでよいのかが気になりました。
結論としては、道具立ては Web アプリケーションと同じまま、推論エンジン(モデルを動かすソフトウェア)の内部状態を外へ見せ、ルーター(ロードバランサーにあたる部分)とオートスケーラーがそれを読んで判断する形にすれば組めます。
この記事は概念実証として、動く構成を 1 つ示すことを目的にしています。計測した性能の数値は扱いません。Kubernetes と AWS は知っているものの、LLM を自分で動かしたことはない方を読者として想定しています。
Web サイトとのスケーリングの違い
LLM の 1 リクエストで起きていること
まず、LLM が 1 つのリクエストを処理する間に何が起きているかを押さえます。
LLM は文章をトークンという単位に区切って扱います。トークンは単語や文字の断片です。利用者が送る入力文はプロンプトと呼びます。
LLM はプロンプトを受け取ると、続きのトークンを 1 つ生成し、それを末尾に加えてまた次の 1 トークンを生成します。この 1 回分の処理を 1 ステップと呼びます。終わりを示すトークンが出るまでステップを繰り返すため、応答が完成するまでの時間はおおむね生成するトークン数に応じて伸びます。
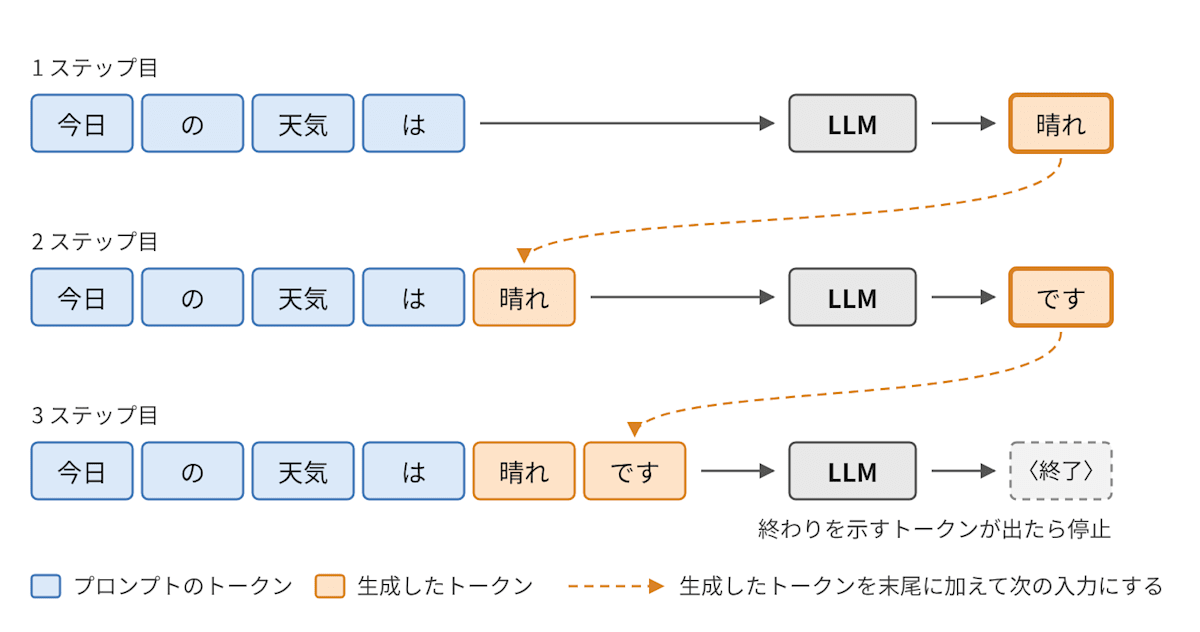
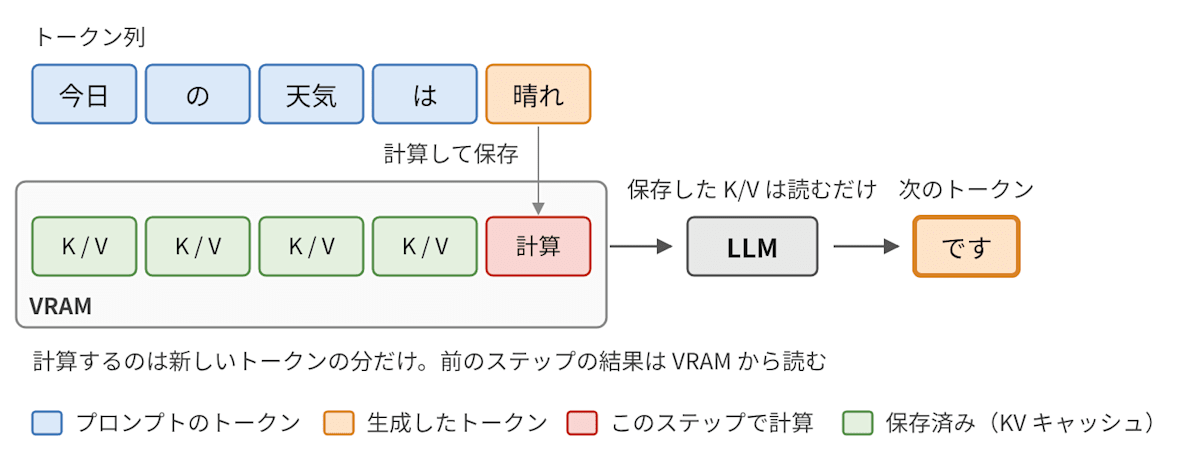
次のトークンを計算するには、プロンプトとそれまでに生成した全トークンの情報が必要です。素朴に実装すると、1 トークン生成するたびに全文を計算し直すことになります。
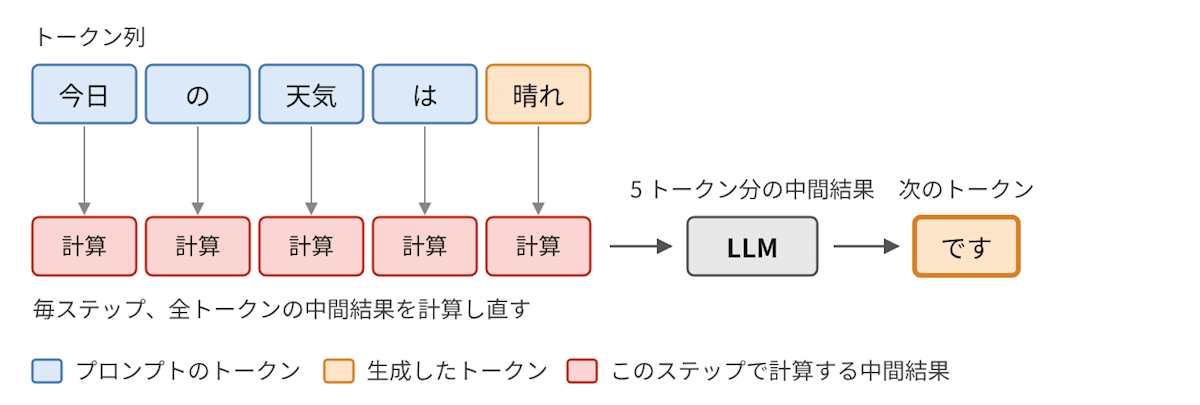
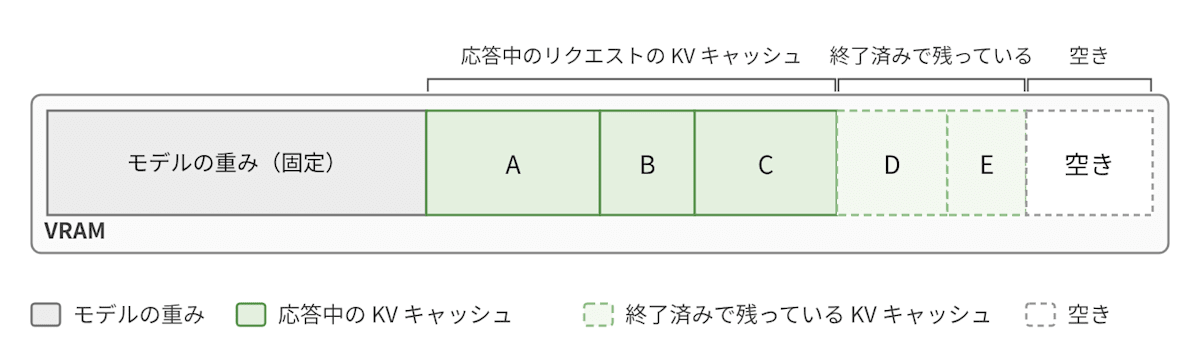
この計算し直しは、大部分が無駄になります。各トークンについて計算した中間結果は、後から変わらないためです。そのため、モデルを動かすソフトウェアである推論エンジンは、この中間結果を GPU メモリ(VRAM)に保存して使い回します。
この保存領域を KV キャッシュと呼びます。名前は、Key と Value という 2 種類の中間結果を保存することに由来します。
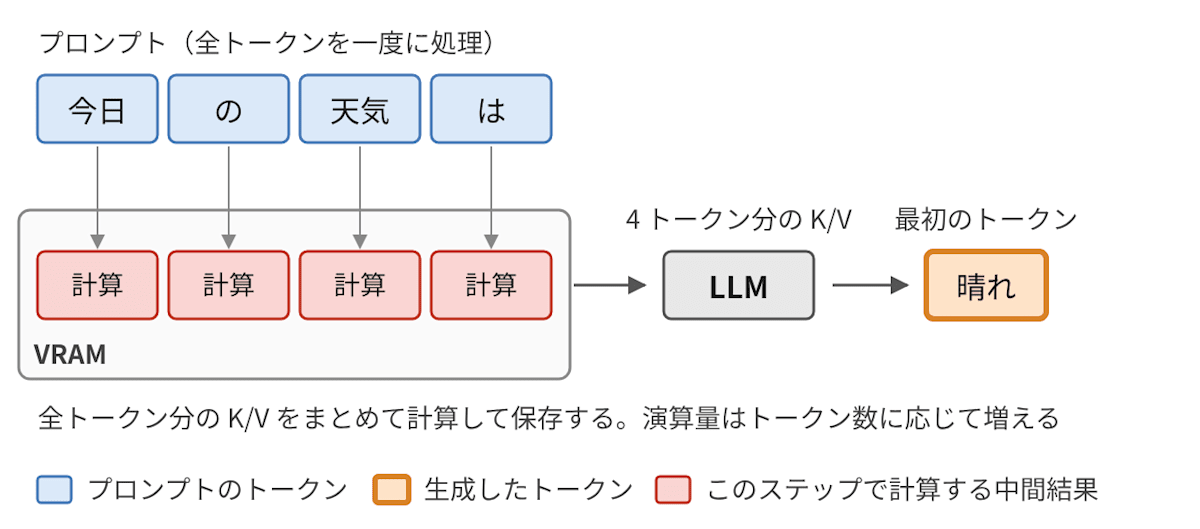
1 つのリクエストの処理は、2 つの段階に分かれます。最初の段階は Prefill と呼ばれ、プロンプト全体をまとめて処理して全トークン分の KV キャッシュを作り、最初のトークンを出します。トークン数に応じて増える演算が一度に実行されるので、GPU の演算能力を使う重い処理です。
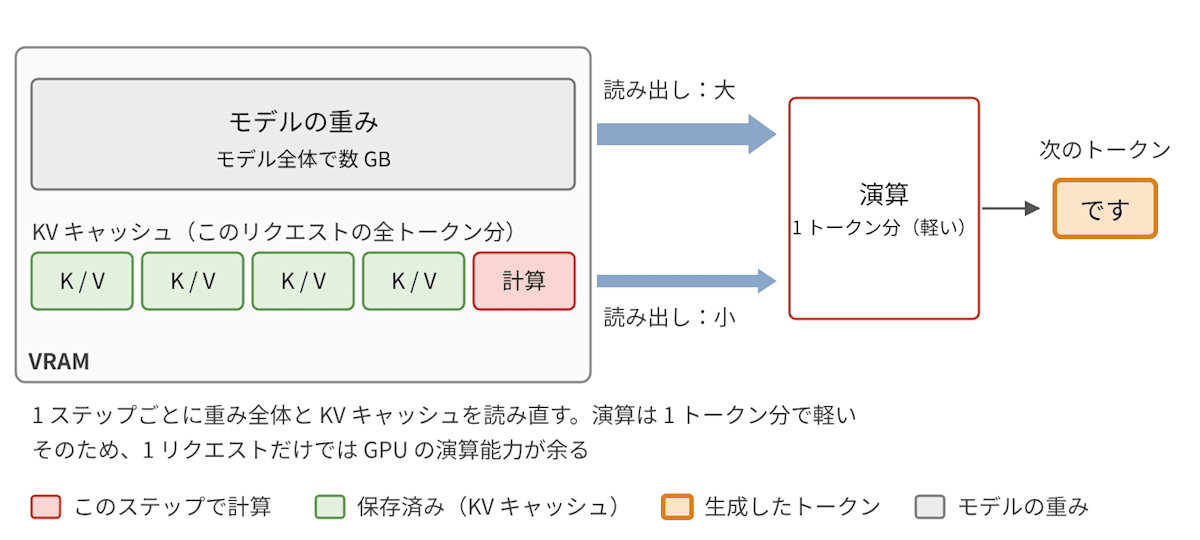
次の段階は Decode と呼ばれ、1 ステップに 1 トークンずつ生成します。各ステップでは、数 GB ある重み全体と、そのリクエストの KV キャッシュを VRAM から読み出し、新しいトークン 1 つ分を演算します。重みは学習済みのパラメーターで、モデルの本体にあたります。演算は少なく、読み出しに時間がかかるため、1 リクエストだけでは GPU の演算能力が余ります。
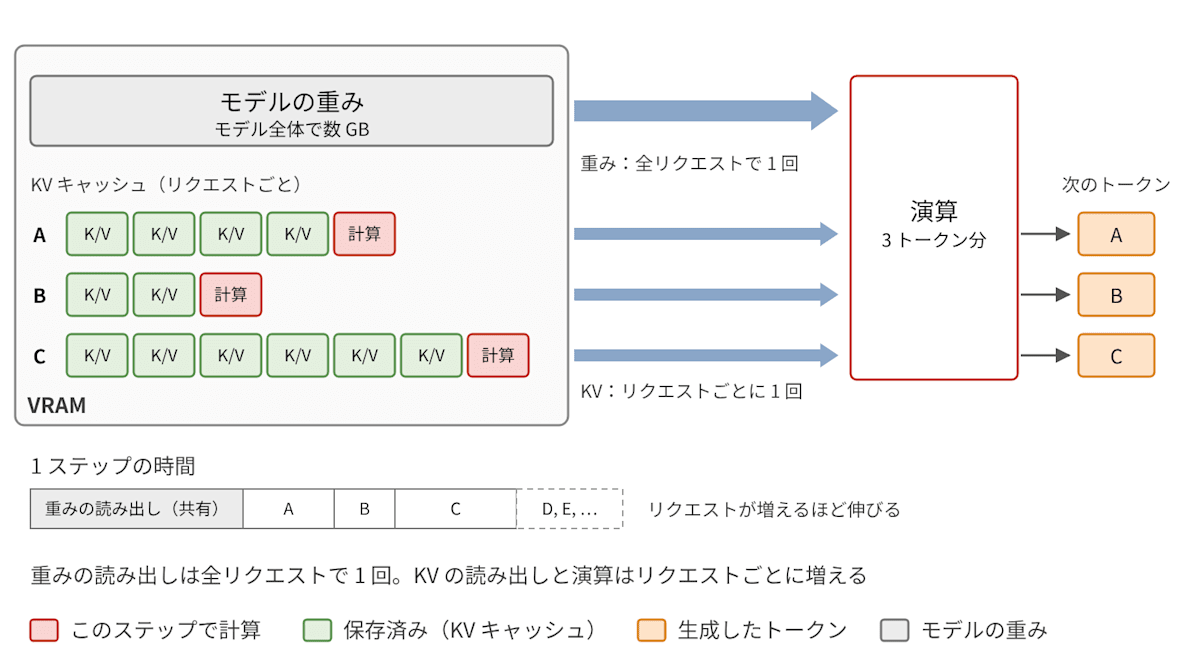
そこで推論エンジンは、複数のリクエストの Decode をまとめて 1 ステップで進めます。モデルの重みの読み出しは全リクエストで共有でき、リクエストごとに増えるのは KV キャッシュの読み出しと演算だけです。この仕組みで、推論エンジンは 1 台で多くのリクエストを同時に処理し、全体の処理量を増やします。一方で、同時に処理するリクエストが増えるほど 1 ステップは長くなります。
KV キャッシュには、スケーリングを考える上で大事な性質が 2 つあります。
1 つ目は、応答中は VRAM を占有し、文が長いほど KV キャッシュが大きくなることです。同時に処理できるリクエスト数の上限は、主に VRAM に収まる KV キャッシュの量で決まります。ただし、上限まで詰め込めばよいわけではありません。前述のとおり、同時に処理するリクエストが増えるほど 1 ステップは長くなるので、1 リクエストあたりの生成は遅くなります。
2 つ目は、応答の終了後もキャッシュを残して再利用できることです。主要な推論エンジンはこれをプレフィックスキャッシュとして実装しており、VRAM に空きがある限りキャッシュを保持し、足りなくなったときに古いものから消します。残っているキャッシュは次のリクエストでも使えるので、同じ書き出し(プレフィックス)のリクエストを同じエンジンに届けると、その部分の計算を省けます。
3 つの違い
ここまでを踏まえて、Web サイトとの違いを見ます。
llm-d は、LLM の推論基盤を Kubernetes 上に構築するオープンソースプロジェクトです。そのドキュメントは、従来の HTTP リクエストは速く均一で軽いという前提の上にラウンドロビンが成り立っていたと述べています。その上で、LLM のリクエストではその前提が 3 つとも成り立たないとしています。
Traditional HTTP requests are fast, uniform, and cheap. Standard round-robin request scheduling strategies balance this load well. LLM requests break all three assumptions. They are:
- Multi-turn - conversations and agentic tool loops send the same growing prefix repeatedly
- Slow - a single request can take over a minute generating tokens
- Non-uniform - range from 1000s of reasoning tokens to a 100k+ context tokens
参考)Deploy an Optimized Baseline | llm-d
1 つ目はマルチターンであることです。チャットでは会話の履歴を毎回まとめて送り直すので、同じプレフィックスに少しずつ継ぎ足したプロンプトが繰り返し届きます。エージェントのツール呼び出しも同様です。前述の KV キャッシュの 2 つ目の性質のとおり、前回と同じエンジンに届けばキャッシュを再利用でき、別のエンジンに届けば計算をやり直すことになります。
2 つ目は遅いことです。1 トークンずつ生成するため、1 リクエストが 1 分を超えることもあります。その間、接続は張られたままで、推論エンジンはそのリクエストの KV キャッシュを保持し続けます。Web サーバーのリクエストが数十ミリ秒で終わり、終われば何も残らないのとは対照的です。
3 つ目は不均一なことです。入力は数十トークンから 10 万トークン超まで、出力も数トークンから数千トークンまで幅があり、出力の長さは生成が終わるまで分かりません。同じ 1 リクエストでも処理量が大きく違うので、件数を数えるだけでは負荷を測れません。
スケーリングへの帰結
この 3 つの違いから、スケーリングの考え方に 2 つの帰結が導かれます。
1 つ目は、ルーティング先の選び方にラウンドロビンが向かないことです。マルチターンのリクエストは、同じプレフィックスのキャッシュを持つエンジンに届けてこそ計算を省けます。そのため、どのエンジンがどのプレフィックスのキャッシュを持っているか、どのエンジンに余裕があるかを見て選ぶ必要があります。
2 つ目は、負荷の指標に単位時間あたりの件数も、CPU や GPU の使用率も使えないことです。リクエストが遅く不均一なため、負荷の実体は処理中のリクエストの本数とその処理量であり、単位時間あたりの件数では測れません。CPU の使用率は、推論の主要な処理を GPU が担うため、負荷を反映しません。
GPU の使用率は、GPU 上で何らかの処理が実行されていた時間の割合です。Decode では、読み出しを待っている間も GPU は処理中として数えられるため、演算能力が余っていても使用率は高い値を示します。そのため、軽負荷でも飽和していても使用率は高くなり、両者を区別できません。
llm-d のオートスケーリングのドキュメントも、この点を明記しています。
During active token generation, GPU utilization can remain high whether a model server is lightly loaded or saturated.
参考)KEDA with EPP Metrics | llm-d
代わりに、推論の状態を知っているコンポーネントが出すメトリクスを使います。候補は、同時に処理している本数、待たせている本数、処理中のトークン数、予測したレイテンシーです。精密にするほど、本数ではなくトークン数で重み付けする方向になります。
この 2 つの帰結を踏まえて、推論エンジンに状態を外へ見せる責務を持たせ、Web の構成のルーターとオートスケーラーをその状態を読むものに置き換えたのが、次の章のアーキテクチャです。
ハイレベルなアーキテクチャ
全体像
前の章の 2 つの帰結を踏まえた構成の全体像が下図です。
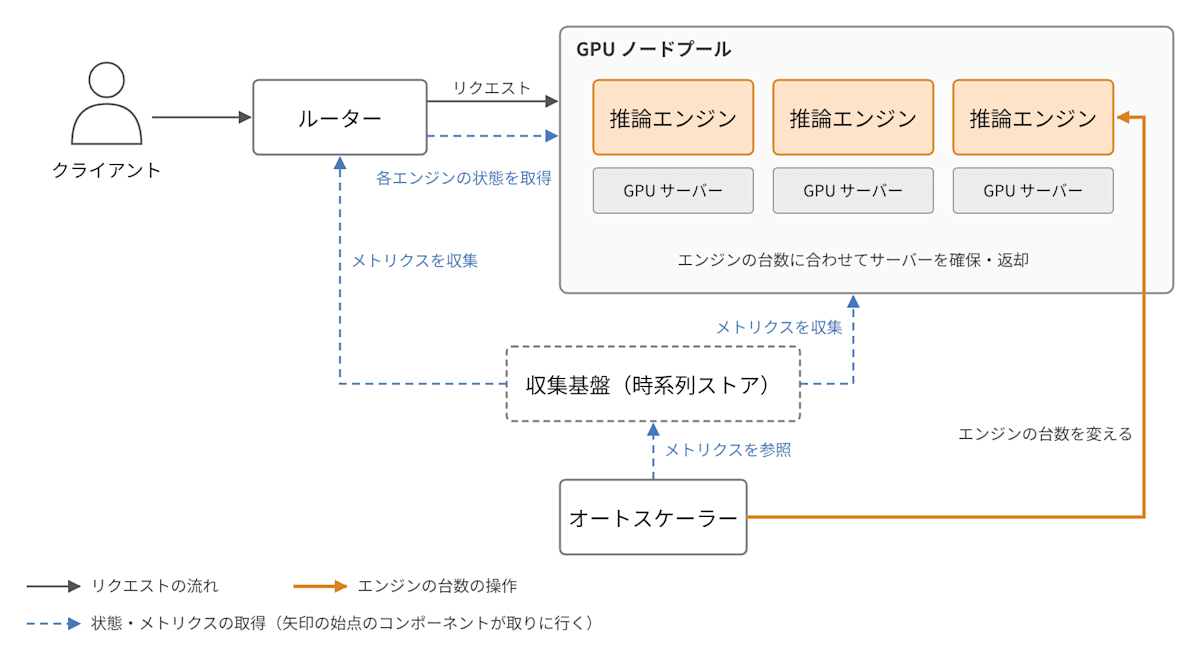
上段がリクエストの通り道です。クライアントからのリクエストはルーターを経由して、いずれかの推論エンジンに届きます。
下段が台数を変える仕組みです。オートスケーラーが推論エンジンの台数を決め、GPU ノードプールがその台数に合わせてサーバーを確保し、不要になれば返却します。
箱の並びは Web アプリケーションの構成と同じです。ルーターはロードバランサー、推論エンジンはアプリケーションサーバーにあたり、オートスケーラーとサーバーの増減という箱も同じです。
違いは、推論エンジンがステートフルなことにあります。Web のロードバランサーは、接続数や応答時間など、自分が観測できる情報からルーティング先を選べます。サーバーの内部を知る必要はありません。
推論エンジンは、処理中のリクエストとその KV キャッシュという状態を持ち、KV キャッシュは VRAM 上にあります。前の章で見たとおり、この状態が、どのエンジンに送るべきかと、各エンジンがどれだけ混んでいるかの両方を決めます。この状態は、外から観測しても分かりません。
そのため、推論エンジンは内部状態を外に見せ、ルーターとオートスケーラーはそれを読んで判断します。これが、冒頭で述べた「状態を読んで判断する」形です。キャッシュの所在については、エンジンが見せる方法のほかに、ルーターが自分のルーティングの履歴から推定する方法もあります。
図の破線の矢印は、状態やメトリクスを取りに行く向きを表します。ルーターは各エンジンの状態を直接取りに行き、オートスケーラーは、収集基盤がルーターと各エンジンから集めたメトリクスを読みます。収集基盤には Web の監視基盤をそのまま使えるため、この記事で取り上げるコンポーネントには含めず、図では破線の箱で描いています。
以降、推論エンジン、ルーター、オートスケーラー、GPU ノードプールの 4 つのコンポーネントを順に説明します。
推論エンジン
推論エンジンは、前の章で見た処理を担うコンポーネントです。モデルの重みを VRAM に載せ、複数のリクエストをまとめて 1 トークンずつ生成し、KV キャッシュをプレフィックスキャッシュとして使い回します。代表的な実装に vLLM があります。
このアーキテクチャでの推論エンジンの役割は、生成そのものに加えて、自分の状態を外から読める形にしておくことです。全体像で述べたとおり、ルーターとオートスケーラーはこの状態を読んで判断します。
外に見せる状態は、負荷と、読み込んでいるモデルの 2 種類です。負荷には、処理中のリクエスト数、受け付けてまだ処理を始めていないリクエスト数(以下、待ちリクエスト数)、KV キャッシュの使用率の 3 つの値があります。読み込んでいるモデルは、複数のモデルを置く場合に、指定されたモデルを持つエンジンへ送るために使います。これらはメトリクスとして公開され、読む側が定期的に取りに行きます。
もう 1 つの判断材料である、どのプレフィックスのキャッシュを保持しているかは、エンジンが通知する場合と、ルーターが自分のルーティングの履歴から推定する場合があります。
ルーター
ルーターは、すべてのリクエストが最初に通るコンポーネントです。Web のロードバランサーと同じ位置にありますが、前の章で見たとおりラウンドロビンが向かないため、ルーティング先を選ぶ判断材料が違います。
判断材料は 3 系統あります。
1 つ目は、各エンジンから取る負荷です。処理中のリクエスト数、待ちリクエスト数、KV キャッシュの使用率を、ルーターが定期的に取りに行きます。収集基盤を経由しないのは、ルーティング先の判断がリクエストごとに行われ、収集基盤の取得間隔では値が古くなるためです。
古い値で選ぶと、空いて見えるエンジンに次々と送ってしまい、負荷が偏ります。取得の合間の古さは、ルーター自身で補えます。ルーターは自分がどのエンジンへ何件送ったかを知っているので、取得した値へその後に送った件数を加えて補正できます。
2 つ目は、どのエンジンがどのプレフィックスのキャッシュを持っているか、という情報です。これを知る方式は 2 つあります。ルーターが「どのプレフィックスをどのエンジンに送ったか」の履歴から推定する方式と、エンジンからキャッシュの出入りの通知を受け取る方式です。推定する方式では、実際のキャッシュは容量を超えれば古いものから捨てられるため、推定が実態とずれることがあります。
3 つ目は、リクエストそのものの性質です。プレフィックスや、どのモデルを使うかといった情報です。
ルーターはこれらを組み合わせて、キャッシュを持っていて、かつ余裕のあるエンジンを選びます。
もう 1 つの役割は、すべてのエンジンが飽和して、新しいリクエストの処理をすぐに始められないときの扱いを決めることです。選択肢は 3 つあります。そのまま送ってエンジン内のキューで待たせるか、ルーターのキューに入れてエンジンに空きが出るまで保留するか、HTTP 429 や 503 のエラー応答をすぐに返すかです。
どれにするかは要件次第です。保留や拒否の順序には、リクエストの優先度を使えます。保留する場合でも、キューには容量の上限と保持期限があり、超えたリクエストにはエラー応答を返します。
オートスケーラー
オートスケーラーは、推論エンジンを何台動かすかを決めるコンポーネントです。「しきい値を超えたら台数を変える」という基本的な動きは Web のオートスケーラーと同じで、違いは、何を見るかと、どこから取るかにあります。
何を見るかは、前の章で述べたとおりです。CPU や GPU の使用率ではなく、同時に処理しているリクエスト数などの、推論の状態を知っているコンポーネントが出すメトリクスを使います。
どこから取るかについては、主にルーターが出すメトリクスを使います。ルーターはすべてのリクエストを通過させるため、エンジンの状態と無関係に需要を数えられます。ルーターがキューで保留する構成なら、飽和した後も保留した分を含めて数え続けられます。
一方、エンジン側のメトリクスは、飽和を示す補助になります。処理中のリクエスト数は飽和前から増えますが、飽和した後は上限で頭打ちになり、ルーターで保留した分はエンジンからは見えません。
待ちリクエスト数は、エンジンが飽和するまで 0 のままです。KV キャッシュの使用率は、リクエスト数よりも各リクエストの長さに左右されるため、需要の量を素直に表しません。
メトリクスは、収集基盤がルーターと推論エンジンから集め、オートスケーラーがそこから読みます。
ルーターと違って収集基盤を経由してよいのは、台数を変える判断が数十秒から分の単位の遅れを許容するからです。この時間スケールなら、収集基盤の取得間隔による遅れは問題になりません。また、しきい値の判定は一定期間の値を見て行うので、値を蓄積する収集基盤の方が向いています。
GPU ノードプール
GPU ノードプールは、推論エンジンを動かす GPU サーバーの集まりです。エンジンの台数に合わせてサーバーを確保し、不要になれば返却する仕組みを含みます。
推論エンジンは通常 GPU を占有するため、エンジンの増減はそのまま GPU の増減になります。GPU とサーバーの対応は構成によって異なり、1 台のエンジンが複数の GPU にまたがる構成や、1 台のサーバーに複数の GPU が載る構成もあります。
オートスケーラーがエンジンを増やしても、動かすサーバーがなければ起動できません。そのため、GPU ノードプールが用意する GPU の総量も、エンジンの台数に追従して増減しなければなりません。
GPU ノードプールは Web のサーバーの増減にあたりますが、GPU サーバーは近年の需要の増加もあり、CPU のみのサーバーと比べて調達の不確実性が大きくなっています。割当枠や在庫の制約を受けやすく、必要なときにすぐ確保できるとは限りません。
次の章では、この 4 つのコンポーネントを具体的な製品に置き換えた構成例を示します。
構成例
全体像
今回の構成は、次のリポジトリで公開しています。
前の章の 4 つのコンポーネントを具体的な製品に置き換えたのが、今回の構成です。EKS Auto Mode のクラスターに、下図のように配置しました。
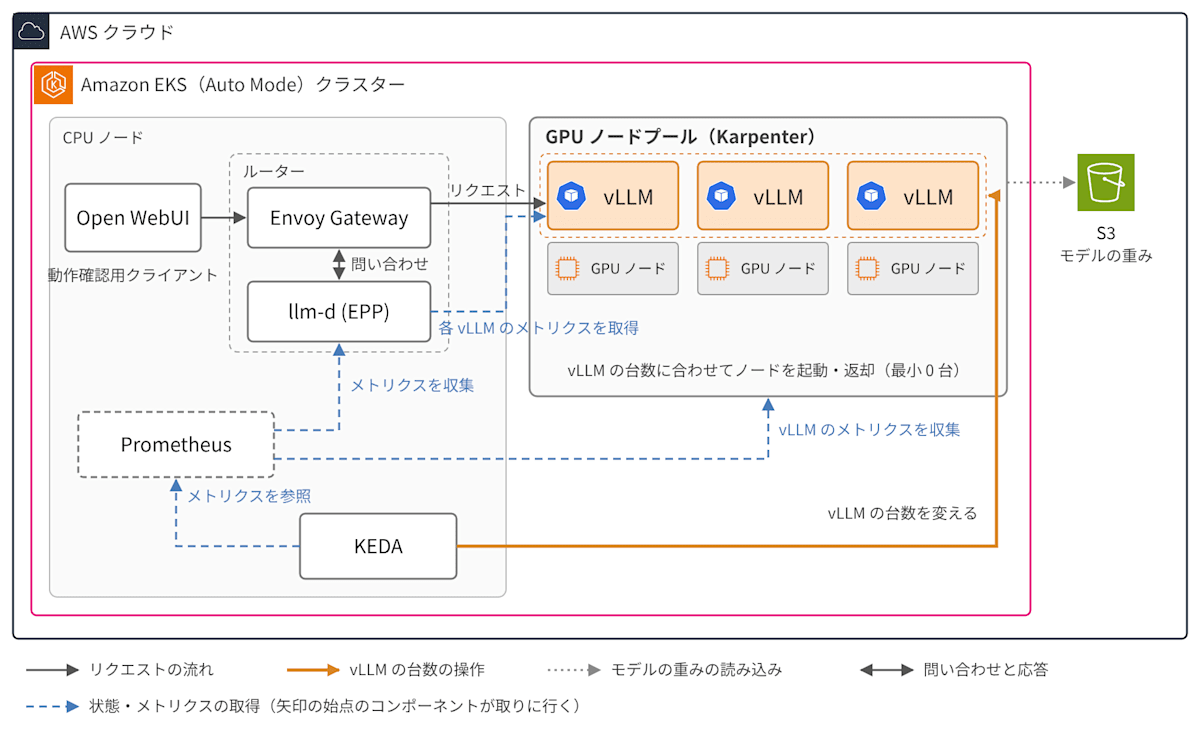
前の章の図と同じく、上段がリクエストの通り道で、下段が台数を変える仕組みです。
推論エンジンは vLLM です。モデルの重みは S3 から読み込みます。
ルーターは、Envoy Gateway と、llm-d プロジェクトの EPP(Endpoint Picker、ルーティング先を選ぶコンポーネント)の 2 つで実装します。Envoy Gateway 単体では EPP に問い合わせられないため、拡張である Agent Router を組み合わせます。Envoy Gateway がリクエストを受け付けて EPP に問い合わせ、EPP が選んだ vLLM へ転送します。Envoy Gateway と EPP の間のやり取りを定めているのが、Gateway API Inference Extension という仕様です。
オートスケーラーは KEDA です。前の章の収集基盤には、Prometheus を使います。
GPU ノードプールは、EKS Auto Mode に内蔵された Karpenter が担います。vLLM 以外のコンポーネントは CPU ノードで動き、GPU ノードだけが vLLM の台数に合わせて増減します。
今回の構成では、前提を 2 つ置いています。1 つ目は、vLLM 1 台(Pod 1 つ)が GPU 1 枚を占有し、GPU ノード 1 台に vLLM を 1 台だけ配置することです。2 つ目は、アクセスがない間は vLLM と GPU ノードの両方を 0 台まで減らすことです。2 つ目の前提は、概念実証としてどこまで台数を落とせるかを確かめるために置きました。
クライアントとして、動作確認用の Open WebUI を同じクラスターに置きました。
参考)Open WebUI
以降、製品ごとに、役割と他のコンポーネントとの関わりを説明します。
vLLM
vLLM は、前の章の推論エンジンにあたります。モデルには、GPU 1 枚の VRAM に重みが収まる小さめのオープンウェイトモデルとして、Qwen3-4B-Instruct-2507 を使います。
参考)vLLM
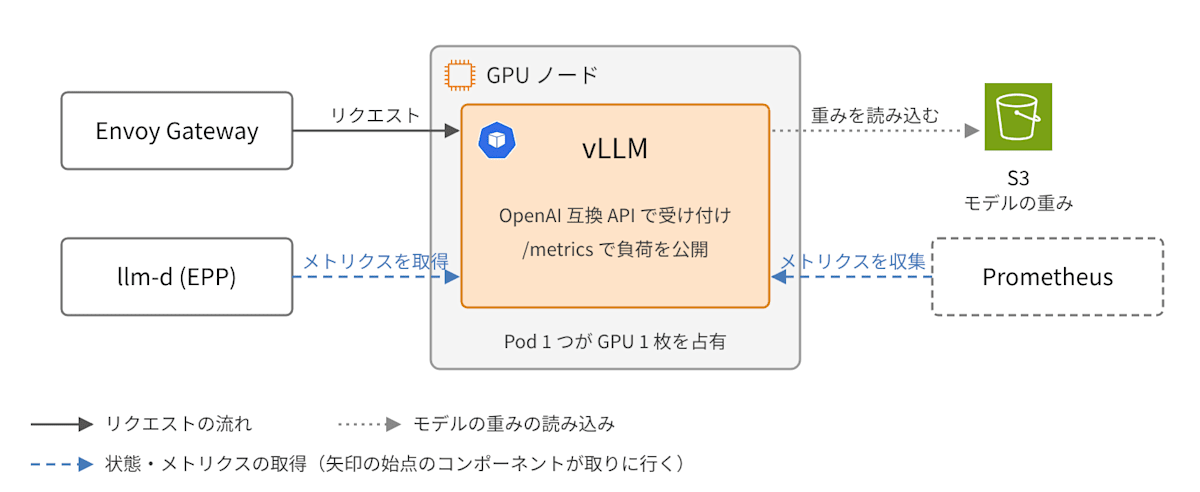
役割は、モデルの重みを VRAM に載せ、OpenAI の API と同じ形式で受け付けたリクエストの応答を生成することです。前の章で見た、複数のリクエストをまとめて処理する仕組みとプレフィックスキャッシュは、vLLM が標準で備えています。推論エンジンに vLLM を選んだのは、llm-d の既定の推論エンジンであり、前の章で挙げた負荷のメトリクスをそのまま公開しているからです。
リクエストは Envoy Gateway から届きます。どの vLLM が受けるかは EPP が決めるので、vLLM 自身は選びません。モデルの重みは、起動時に S3 のバケットから直接読み込みます。
外に出すのは、応答と、/metrics で公開するメトリクスです。メトリクスには処理中のリクエスト数、待ちリクエスト数、KV キャッシュの使用率が含まれ、EPP と Prometheus がそれぞれ取りに行きます。
スケーリングに関わる判断として、Pod 1 つが GPU 1 枚を要求し、GPU を 1 枚だけ持つインスタンスタイプを使う構成にしました。その結果、GPU ノード 1 台に Pod が 1 つだけ配置され、vLLM の増減がそのまま GPU ノードの増減になります。vLLM のレプリカ数は KEDA(内部で Kubernetes の HPA を使います)だけが管理し、Deployment には書きません。別の仕組みが同じ項目に値を書くと、HPA が設定した値と競合するためです。
GPU ノードは vLLM と一緒に増減するので、vLLM が起動するたびに、新しいノードがコンテナイメージとモデルの重みを取りに行きます。どちらも数 GB あり、取得に時間がかかります。そのため、イメージは ECR のプルスルーキャッシュに、重みは同じリージョンの S3 に置き、クラスターの近くから取るようにしました。
Gateway API Inference Extension
Gateway API Inference Extension は製品ではなく、前の章のルーターを Kubernetes 上で実装するための仕様です。Envoy Gateway と llm-d (EPP) はこの仕様に沿って動くので、先に仕様を説明します。
参考)Kubernetes Gateway API Inference Extension
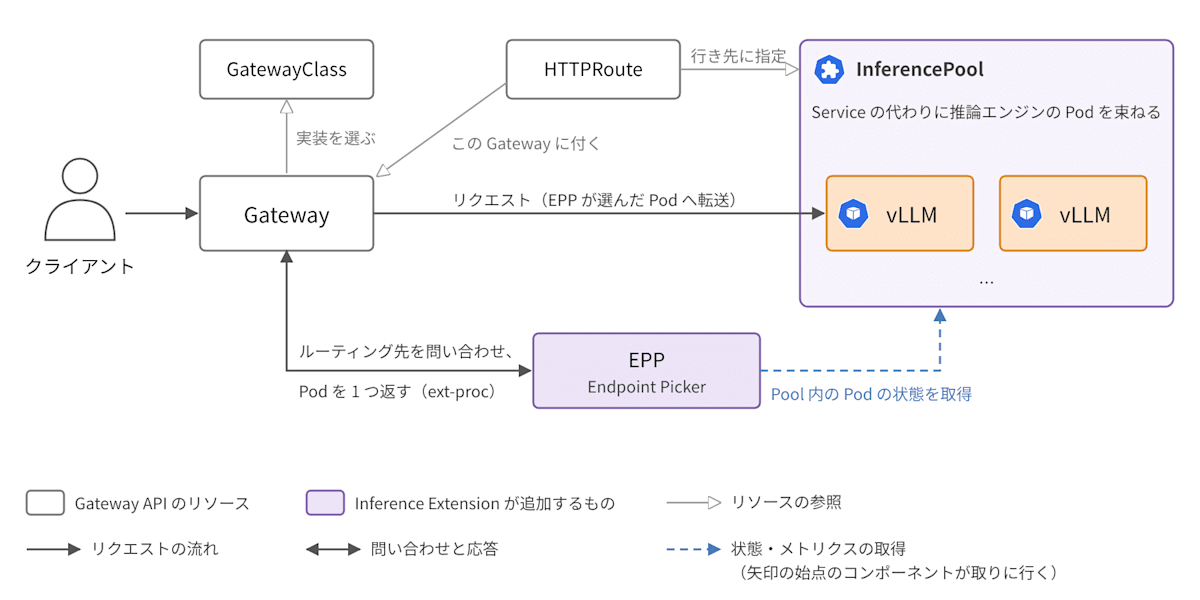
Gateway API は、Ingress の後継にあたる Kubernetes の仕様です。GatewayClass がどの実装を使うかを選び、Gateway がクラスターへの受け口を定め、HTTPRoute がリクエストの経路と行き先を定めます。
参考)Gateway API
Gateway API Inference Extension は、ここに推論向けの要素を 2 つ追加します。1 つ目は InferencePool というリソースで、推論エンジンの Pod を束ね、Service の代わりに HTTPRoute の行き先になります。Service との違いを、公式ドキュメントは次のように説明しています。
InferencePool represents a set of Inference-focused Pods and an extension that will be used to route to them. Within the broader Gateway API resource model, this resource is considered a "backend". In practice, that means that you'd replace a Kubernetes Service with an InferencePool. This resource has some similarities to Service (a way to select Pods and specify a port), but has some unique capabilities. With InferencePool, you can configure a routing extension as well as inference-specific routing optimizations.
参考)API Overview - Kubernetes Gateway API Inference Extension
InferencePool は、推論向けの Pod の集まりと、そこへルーティングするための拡張を表すリソースで、Gateway API では Service と同じバックエンドの位置にあります。Pod の選択とポートの指定は Service と同じですが、Service にはないルーティングの拡張と、推論向けの最適化を設定できます。Service のままでは、ルーティング先の判断を外部の拡張に委ねられません。
2 つ目は、その拡張にあたる EPP(Endpoint Picker)です。Gateway は InferencePool 宛てのリクエストを受けると EPP に問い合わせ、EPP が Pool の中からルーティング先の Pod を 1 つ選んで返します。EPP の責務は、公式ドキュメントで次のように定められています。
This extension is responsible for tracking key metrics on each model server (i.e. the KV-cache utilization, queue length of pending requests, active LoRA adapters, etc.) and routing incoming inference requests to the optimal model server replica based on these metrics.
参考)InferencePool - Kubernetes Gateway API Inference Extension
仕様が EPP に求めるのは、各推論エンジンのメトリクスを追い、それに基づいてルーティング先のレプリカを選ぶことです。前の章のルーターの判断材料とルーティング先の選択が、この責務にあたります。
前の章のルーターは、この仕様では Gateway と EPP の 2 つに分かれます。Gateway がリクエストの受け口と転送を、EPP がルーティング先の判断を受け持ちます。
仕様に含まれるのは、InferencePool などの CRD、Gateway と EPP の間のプロトコル、EPP の最小限の参照実装と適合試験です。プロトコルは、Envoy(Envoy Gateway が使うプロキシ)がリクエストごとに外部のサーバーへ処理を問い合わせる仕組み(ext-proc)に基づいています。
運用向けの本格的な EPP の実装は、仕様のリポジトリから llm-d のリポジトリに移っています。そのため、今回は EPP の実装に llm-d を使います。Gateway の実装には Envoy Gateway を使います。
参考)Release v1.6.0 · kubernetes-sigs/gateway-api-inference-extension
Gateway の実装は、Gateway API Inference Extension への対応をうたっているものから選びます。EKS で自前で運用できる候補には、Istio や agentgateway のほか、Agent Router と組み合わせた Envoy Gateway があります。
Envoy Gateway
この節で扱う Envoy Gateway は、前の章のルーターのうち、リクエストの受け口と転送にあたる部分です。実体は 3 つに分かれるので、先に区別します。
Envoy Gateway は Gateway API の実装で、Gateway や HTTPRoute のリソースを読み取って設定を作るコントローラーです。Envoy Proxy は、Envoy Gateway が起動するプロセスで、その設定を受け取ってリクエストを運びます。Agent Router は、Envoy Gateway に InferencePool を扱わせるための拡張で、Envoy AI Gateway から改名したプロジェクトです。
以降、転送する実体を指すときは Envoy Proxy と書きます。
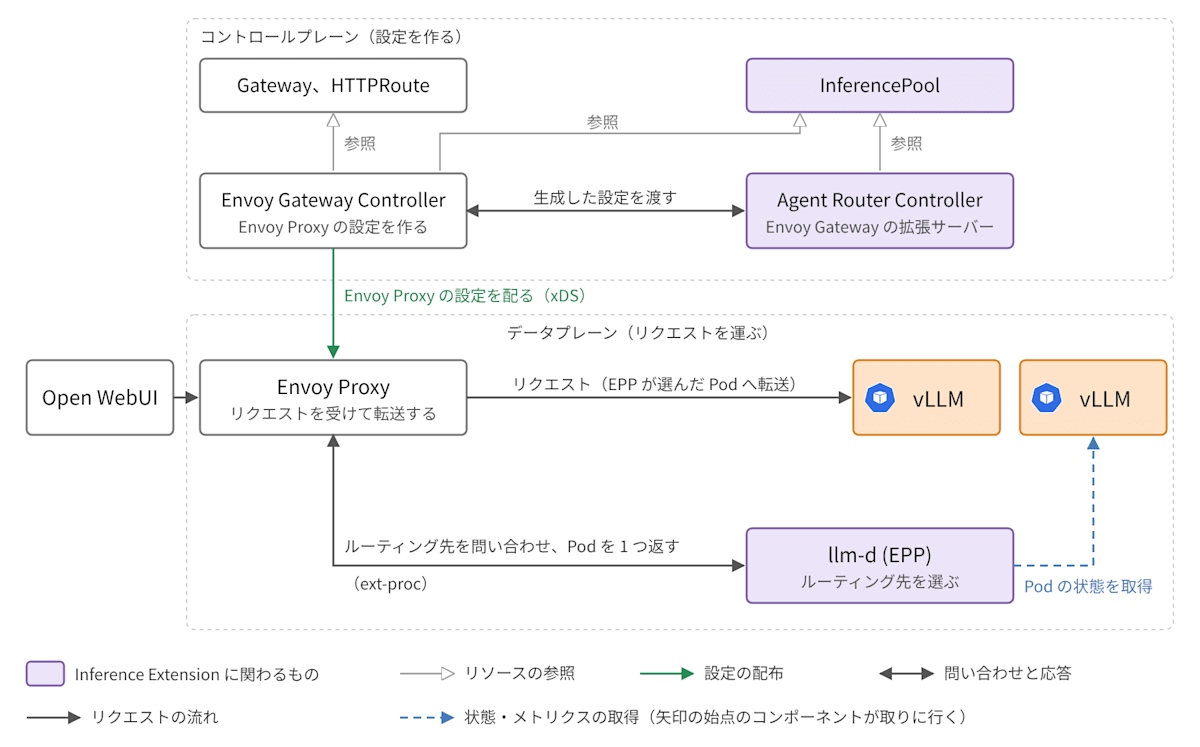
図では、コンポーネントをコントロールプレーンとデータプレーンに分けています。コントロールプレーンは、Kubernetes のリソースを読み取って Envoy Proxy の設定を作る側です。Envoy Gateway と Agent Router のコントローラーがここに入ります。データプレーンは、実際にリクエストを受けて運ぶ側で、Envoy Proxy と、リクエストごとに問い合わせを受ける EPP、転送先の vLLM がここに入ります。リクエストはコントロールプレーンを通りません。
Envoy Gateway は、InferencePool を行き先にした HTTPRoute の設定を標準では生成できません。そこで Agent Router を組み合わせます。Envoy Gateway と Agent Router の組み合わせが、Gateway API Inference Extension に対応した Gateway の実装にあたります。
Agent Router は、Envoy Gateway の拡張サーバーとして動きます。拡張サーバーは、Envoy Gateway が設定を生成するときに呼び出す外部のサーバーです。
Envoy Gateway can be configured to call an external server over gRPC with the xDS configuration before it is sent to Envoy Proxy. The external server can modify the provided configuration programmatically using any semantics supported by the xDS API.
Using an extension server allows vendors to add xDS configuration that Envoy Gateway itself doesn’t support with a very high level of control over the generated xDS configuration.
参考)Envoy Gateway Extension Server | Envoy Gateway
Envoy Gateway は、Envoy Proxy へ配るためのプロトコル(xDS)で表した設定を、配る前に gRPC で外部サーバーへ渡し、外部サーバーはその設定を書き換えて返せます。この仕組みで、Envoy Gateway 自身が対応していない設定をベンダーが追加できます。
Envoy Gateway は、設定で許可した InferencePool を読み取り、生成した設定と一緒に Agent Router へ渡します。Agent Router も InferencePool を読み取り、受け取った設定に、InferencePool 宛てのリクエストで EPP に問い合わせる設定を加えて返します。
Agent Router のドキュメントは、InferencePool の機能を次のように説明しています。
It integrates with the Gateway API Inference Extension to provide dynamic endpoint selection based on real-time metrics and availability.
参考)InferencePool Support | Agent Router
今回は、Envoy Gateway と Agent Router の 2 つのコントローラーを入れました。図の Envoy Gateway Controller と Agent Router Controller が、この 2 つです。Envoy Gateway の設定で Agent Router を拡張サーバーとして登録し、InferencePool をバックエンドの種類として許可しています。
Envoy Gateway 自体に、スケーリングに関わる判断はありません。関わるのは経路上のタイムアウトだけです。0 台からの起動を待つ間は、リクエストが経路上で保持されるためです。
llm-d (EPP)
llm-d は、Kubernetes 上の LLM 推論基盤を扱うプロジェクトで、ルーター、推論エンジン、KV キャッシュの管理、オートスケーリングなどの領域に分かれています。今回使うのは、そのうちルーターの EPP です。
llm-d (EPP) は、前の章のルーターのうち、ルーティング先の判断を受け持ちます。Gateway API Inference Extension の EPP の実装です。Envoy Proxy から ext-proc で問い合わせを受け、InferencePool の中から Pod を 1 つ選んで返します。
The EPP is the "brains" of an llm-d deployment. It is focused on two key objectives: Intelligent routing - selecting which model server pod within an InferencePool should process each inference request, using the internal state of model server pods (KV-cache utilization, prefix cache locality, request queue depth, and active request counts)
参考)Endpoint Picker (EPP) | llm-d
EPP は各 Pod の内部状態を使って、リクエストごとに Pod を選びます。内部状態とは、KV キャッシュの使用率とプレフィックスキャッシュの所在、待ちリクエスト数と処理中のリクエスト数です。前の章で挙げたルーターの判断材料と同じです。
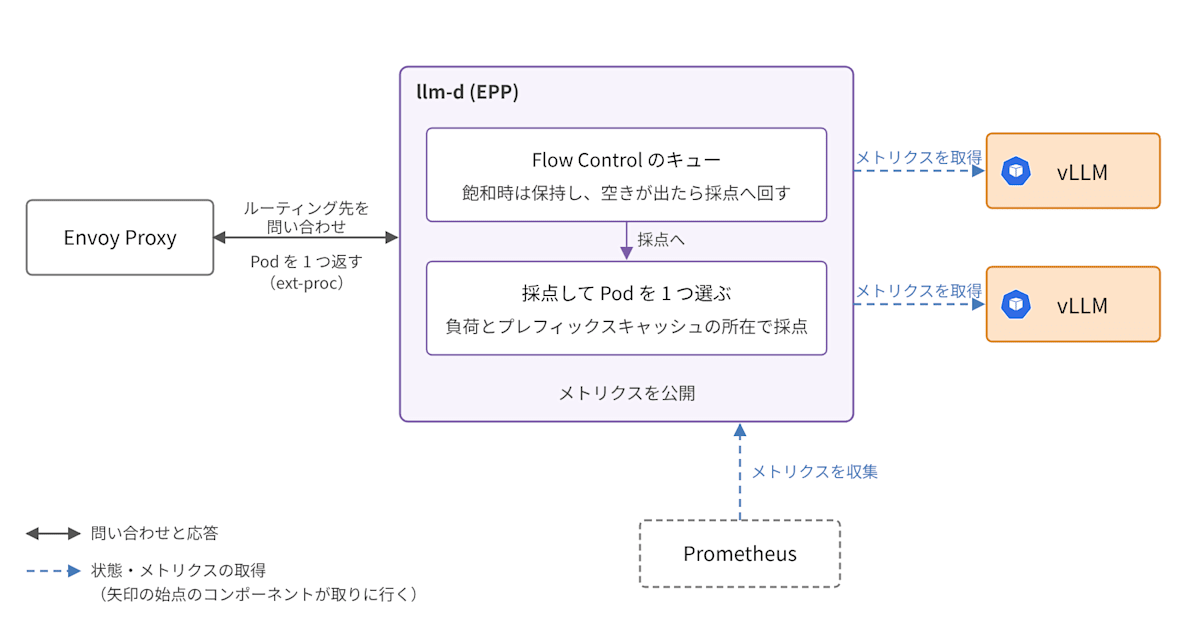
判断材料の取り方は、前の章で述べた 3 系統に対応します。各 vLLM の負荷は、EPP がその Pod のメトリクスを定期的に取りに行って把握します。プレフィックスキャッシュの所在は、今回は EPP が自分のルーティングの履歴から推定します。
Local Index: The EPP maintains an in-memory LRU index of which prefix hashes were recently sent to which Pods.
Learning: After a routing decision is made, the EPP updates its local index, assuming the selected Pod will now host that prefix.
Cons: Can diverge from actual model server state (e.g., if a Pod evicts a prefix due to memory pressure)
参考)Prefix-Cache Aware Routing | llm-d
EPP は、どのプレフィックスをどの Pod に送ったかを LRU の索引として持ち、送るたびに「その Pod がそのプレフィックスのキャッシュを持つ」とみなして索引を更新します。vLLM 側でキャッシュが追い出されると、索引と実態がずれます。vLLM からキャッシュのイベント通知を受け取る精密な方式もありますが、今回は使っていません。
3 つ目の判断材料であるリクエストの性質については、プロンプトのプレフィックスをキャッシュの推定に使います。モデルは 1 種類しか動かしていないので、モデルによる振り分けはありません。
今回の採点では、待ちリクエスト数、KV キャッシュの使用率、プレフィックスキャッシュの推定の 3 つを組み合わせ、合計点がもっとも高い Pod を選びます。
すべての vLLM が飽和したときの扱いには、前の章の 3 つの選択肢のうち、ルーターのキューで保留する方式を選びました。EPP の Flow Control を有効にすると、飽和を検知している間は Envoy Proxy にルーティング先を返さず、問い合わせをキューで保持します。Pod が 1 つもない状態も、送り先がないという点では同じ扱いで、キューで保持されます。
The Flow Control layer intercepts requests at the EPP and holds them in centralized, policy-aware queues when the backend pool is saturated.
Requests are subject to a configurable TTL (Time-To-Live); if a request remains in the queue past its TTL, it is expired and rejected, preventing the system from processing stale work.
キューには保持期限があり、期限を超えたリクエストは拒否されます。期限が切れた時点で Pod が 1 つもなければ 503、あれば 429 を返します。
Flow Control を有効にしたのは、飽和時の保留と、vLLM が 0 台のときの起動待ちを 1 つの仕組みで賄うためです。llm-d のオートスケーリングのガイドは、この使い方を次のように書いています。
EPP Flow Control enables scale-from-zero by buffering requests while no model server endpoint is ready.
参考)KEDA with EPP Metrics | llm-d
EPP 自身もメトリクスを公開します。KEDA が使うのは、EPP が数える処理中のリクエスト数と、Flow Control のキューの長さの 2 つです。どちらも Prometheus が収集します。
EPP が数える処理中のリクエスト数は、EPP がルーティング先を返し、Envoy Proxy が vLLM へ転送したリクエストのうち、応答がまだ返っていないものの数です。キューで待っているリクエストは含まれません。
Prometheus
Prometheus は、前の章で収集基盤と呼んだものにあたります。前の章では 4 つのコンポーネントに数えませんでしたが、オートスケーラーがメトリクスを読む経路なので、ここで役割を押さえておきます。
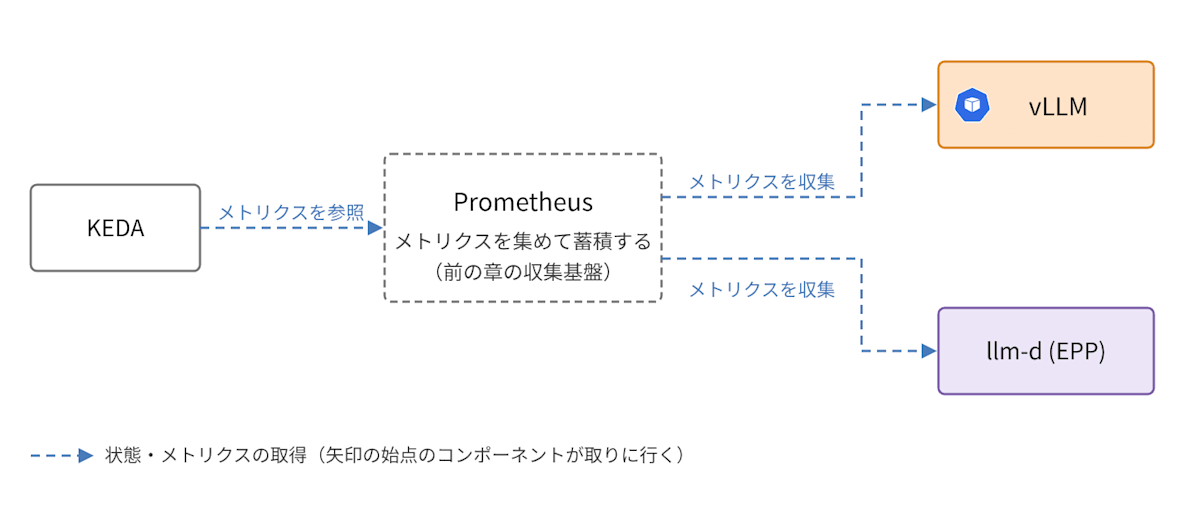
役割は、クラスター内の Pod からメトリクスを集めて蓄積し、問い合わせに答えることです。収集元は vLLM と EPP の 2 つで、どちらも Pod のアノテーションを手がかりに自動で見つけます。読む側は KEDA です。
前の章で述べたとおり、収集基盤には Web の監視基盤をそのまま使えます。今回も Prometheus 本体だけの最小構成で、推論向けの特別な設定はしていません。
KEDA
KEDA は、前の章のオートスケーラーにあたります。Prometheus のメトリクスを見て、vLLM の Deployment のレプリカ数を決めます。最小は 0 台です。
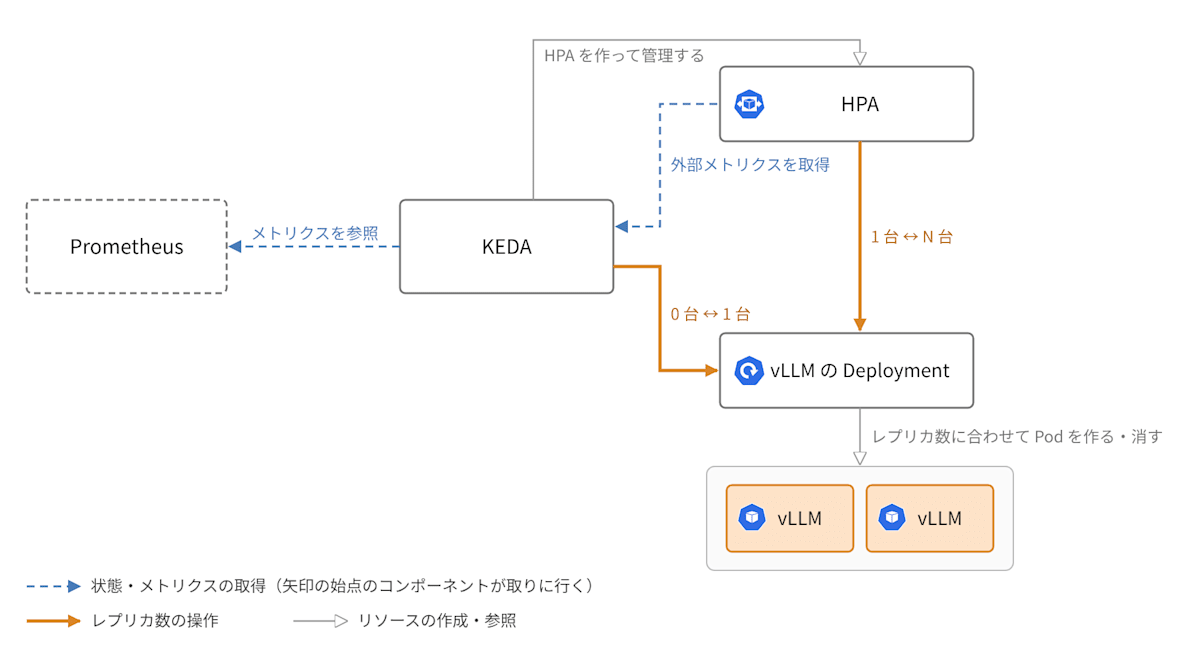
KEDA は、Kubernetes の HPA を自分で作って管理し、その HPA と役割を分担します。
KEDA feeds the HPA with external metrics, extending it beyond CPU and memory to any event source you can connect to.
Zero-to-one and one-to-zero scaling is handled directly by the keda-operator. When an event source becomes active, the operator brings the deployment up from zero replicas; when it goes idle again, the operator scales it back down to zero.
One-to-N and N-to-one scaling is delegated to the Horizontal Pod Autoscaler.
0 台と 1 台の間は KEDA 自身が切り替えます。1 台と N 台の間は HPA が決めます。HPA が見るメトリクスは CPU の使用率などではなく、KEDA が Prometheus の値を外部メトリクスとして提供したものです。
Deployment のレプリカ数が変わると、Kubernetes が Pod を作ったり消したりします。配置先のない Pod は Pending のまま、GPU ノードが用意されるのを待ちます。
トリガーは 2 本で、どちらも EPP のメトリクスです。HPA は複数のメトリクスから計算した台数のうち最大を採るので、どちらかのメトリクスがしきい値を超えれば台数が増えます。llm-d のオートスケーリングのガイドは、EPP のメトリクスを次のように分類しています。
EPP exposes that demand as metrics that map directly onto scaling decisions — reactive saturation signals (queued requests), proactive concurrency signals (running requests, in-flight tokens), and objective-relative signals (pool saturation, estimated latency against an SLO).
参考)KEDA with EPP Metrics | llm-d
1 本目は、EPP が数える処理中のリクエスト数です。ガイドの分類では飽和の前から動く先行的なメトリクスで、需要の増加を早く捉えます。
2 本目は、Flow Control のキューの長さです。分類では飽和してから動く反応的なメトリクスです。引用の queued requests はこの EPP のキューを指し、vLLM の待ちリクエスト数ではありません。今回は 0 台からの起動のために入れましたが、前の章で述べた、飽和した後に保留した分を数え続ける役割もこのメトリクスが担います。
vLLM が 0 台のときは、1 本目のメトリクスでは 1 台目を起動できません。処理中のリクエスト数は EPP がルーティング先を返した件数であり、送り先がなければ 0 のままだからです。一方、Flow Control のキューには、送り先がなくてもリクエストが溜まります。そこで、キューに入ったリクエストの数をきっかけに、0 台から 1 台に増やします。
負荷が止まると、レプリカ数は逆の順で戻ります。HPA が N 台から 1 台へ減らし、KEDA が 1 台から 0 台へ戻します。どちらも、メトリクスが一定期間下がり続けてから減らします。Pod が消えて空いた GPU ノードは、GPU ノードプールが返却します。
Karpenter
Karpenter は、前の章の GPU ノードプールにあたります。今回は、EKS Auto Mode に内蔵された Karpenter を使います。
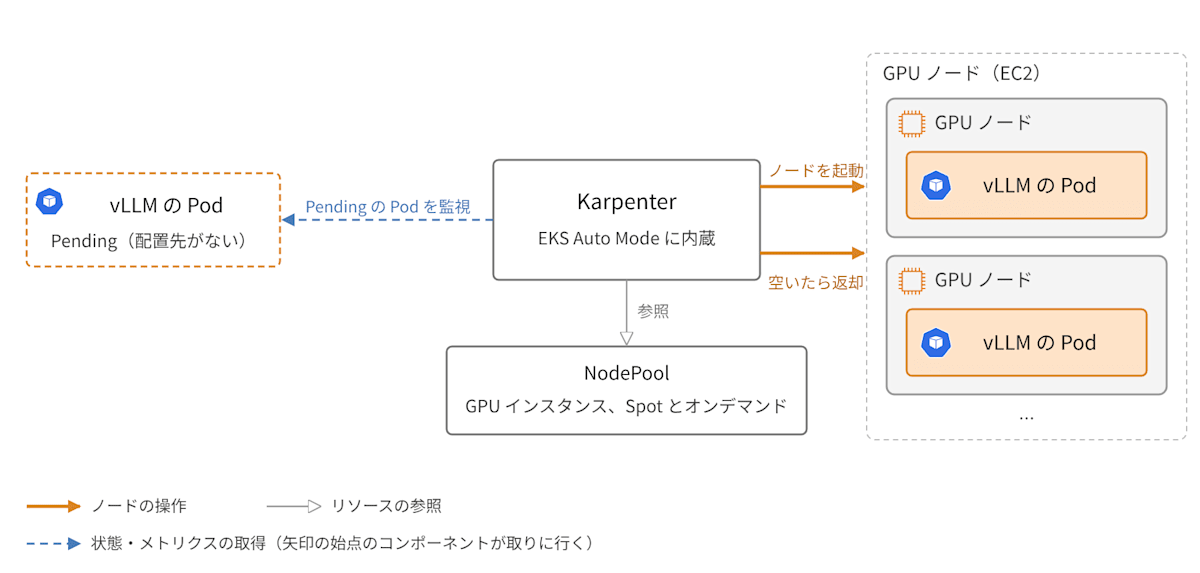
役割は、配置先のない Pod を見つけて GPU ノードを起動し、Pod がいなくなって空いたノードを返却することです。EKS Auto Mode のドキュメントは、この動きを次のように説明しています。
Relying on Karpenter auto scaling, EKS Auto Mode monitors for unschedulable Pods and makes it possible for new nodes to be deployed to run those Pods. As workloads are terminated, EKS Auto Mode dynamically disrupts and terminates nodes when they are no longer needed, optimizing resource usage.
参考)Automate cluster infrastructure with EKS Auto Mode - Amazon EKS
入力は、KEDA がレプリカ数を増やした結果として現れる Pending の Pod です。出力は、EC2 の GPU インスタンスです。前述のとおり GPU ノード 1 台に vLLM の Pod が 1 つなので、GPU ノードの台数は vLLM の台数と一致し、vLLM が 0 台になれば GPU ノードも 0 台になります。Envoy Gateway、EPP、KEDA、Prometheus、Open WebUI は CPU ノードで動き、GPU ノードが 0 台でも残ります。
NodePool は、起動するノードの条件を定める Karpenter のリソースです。NodePool には GPU のインスタンスタイプを指定し、Spot とオンデマンドの両方を許可しています。Spot を許可したのはコストを下げるためで、Spot を確保できないときはオンデマンドで起動します。
前の章で述べた GPU の調達の不確実性に備えるなら、NodePool に複数のインスタンスタイプを許可します。あるタイプの在庫や割当枠が足りないときに、別のタイプで起動できるからです。今回は概念実証なので、インスタンスタイプは 1 種類に絞っています。
EKS Auto Mode には、GPU ノードに必要な NVIDIA のドライバーとデバイスプラグインが組み込まれており、Spot の中断通知の処理も Auto Mode が行います。
Includes GPU support, with separate kernel drivers and plugins for NVIDIA and Neuron GPUs, enabling high-performance workloads.
Automatically handles EC2 Spot Instance interruption notices, EC2 instance health/scheduled maintenance events, and EC2 instance status check failures
参考)Automate cluster infrastructure with EKS Auto Mode - Amazon EKS
そのため、GPU ノードの準備を自前で整えずに済みます。
リクエストが vLLM に届くまで
ここまでのコンポーネントが 1 つのリクエストをどう扱うかを、vLLM が複数台ある通常の状態で追います。
EPP は、リクエストの有無にかかわらず、各 vLLM のメトリクスを定期的に取りに行っています。そのため、問い合わせを受けた時点で各 vLLM の直近の負荷を把握しています。
Open WebUI から送ったチャットは Envoy Proxy に届き、Envoy Proxy はリクエストのヘッダーと本文を EPP に渡して、ルーティング先を問い合わせます。EPP は InferencePool の中の vLLM を 1 台ずつ採点します。採点に使うのは、取得しておいた負荷と、プロンプトのプレフィックスをどの vLLM に送ったかの履歴から推定したキャッシュの所在です。
EPP はもっとも点が高い vLLM を Envoy Proxy に返し、同時に、llm-d (EPP) の節で見た履歴を更新します。同じ会話の次のターンはプレフィックスが同じなので、採点で同じ vLLM の点が高くなり、キャッシュを再利用できます。
Envoy Proxy は、返された vLLM にリクエストを転送し、応答をそのまま Open WebUI へ返します。すべての vLLM が飽和しているときは、EPP は vLLM を返さずに問い合わせをキューで保持し、空きが出てから返します。
0 台から応答が返るまで
次に、vLLM が 0 台の状態で届いたリクエストにどう応答するかを追います。
Open WebUI から送ったチャットは Envoy Proxy に届き、Envoy Proxy はリクエストのヘッダーと本文を EPP に渡してルーティング先を問い合わせます。vLLM が 0 台なので送り先がなく、EPP はこの問い合わせを Flow Control のキューで保持します。
Prometheus がキューの長さを収集し、KEDA がそれを見て Deployment のレプリカ数を 0 から 1 にします。作られた Pod は配置先の GPU ノードがなく Pending になり、それを検知した Karpenter が GPU ノードを起動します。
Pod がそのノードに配置され、vLLM が起動して重みを読み込みます。EPP は InferencePool の Pod の増減を監視しているので、準備ができた Pod を検知すると、キューで保持していた問い合わせにその Pod を返します。Envoy Proxy がリクエストを転送し、応答が返ります。
この間、リクエストは経路上のどこかで待ち続けています。そのため、経路上のタイムアウトはすべて、0 台からの起動にかかる時間より長くそろえなければなりません。今回延ばしたのは、次の 3 か所です。
- Open WebUI の HTTP クライアントのタイムアウト
- HTTPRoute のリクエストのタイムアウト
- EPP の Flow Control の保持期限
どれか 1 つでも短いと、vLLM の起動を待ちきれず、エラーが返ります。応答までの待ち時間に上限がある要件なら、待たせずにエラー応答を返し、クライアント側で再試行する選択もあります。
タイムアウトとは別に、vLLM の起動プローブにも、重みの読み込みが終わるまで再起動しない猶予が必要です。猶予が短いと、準備が整う前にコンテナが再起動され、いつまでも Ready になりません。
なお、Open WebUI は画面を開くたびにモデル一覧を取得します。この要求も InferencePool 宛てなので、そのままではキューに入り、KEDA が vLLM を起動してしまいます。これを防ぐため、モデル一覧の取得には Envoy Proxy が固定の内容を返すよう HTTPRoute で設定しています。
動作を確認します。Open WebUI には、Envoy Proxy のアドレスを OpenAI 互換の接続先として設定してあります。vLLM が 0 台の状態で Open WebUI を開くと、固定の応答に含めたモデル名が表示されます。
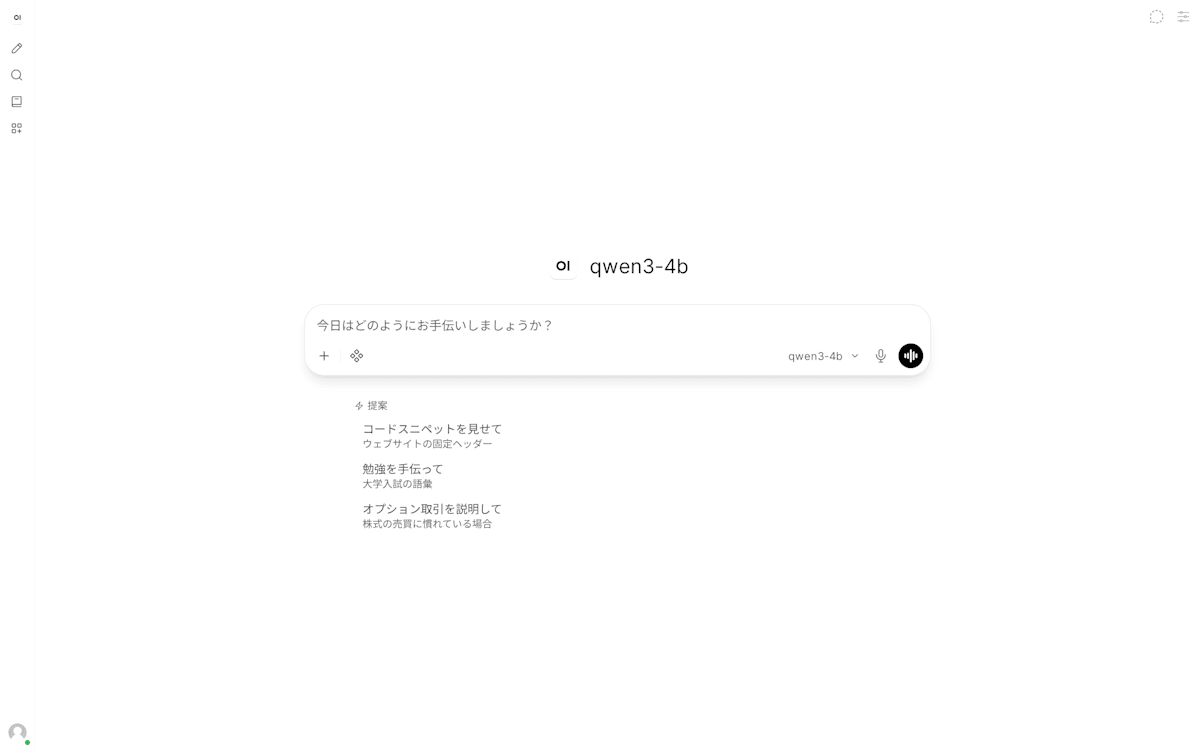
モデルが選択された状態です。
チャットを送信すると、応答が始まるまで待ちの状態が続きます。この間に、GPU ノードと vLLM が起動しています。
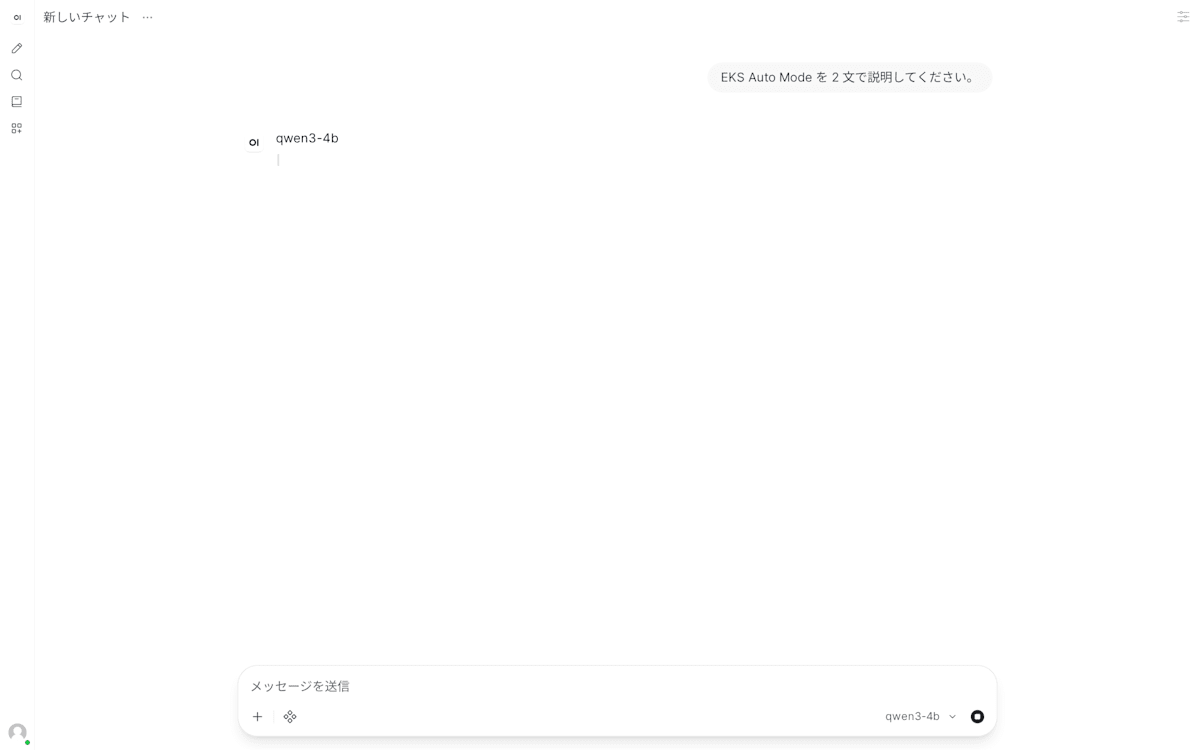
しばらく待つと、応答が表示されます。想定通り、0 台の状態からでも応答が返ってくることを確認できます。
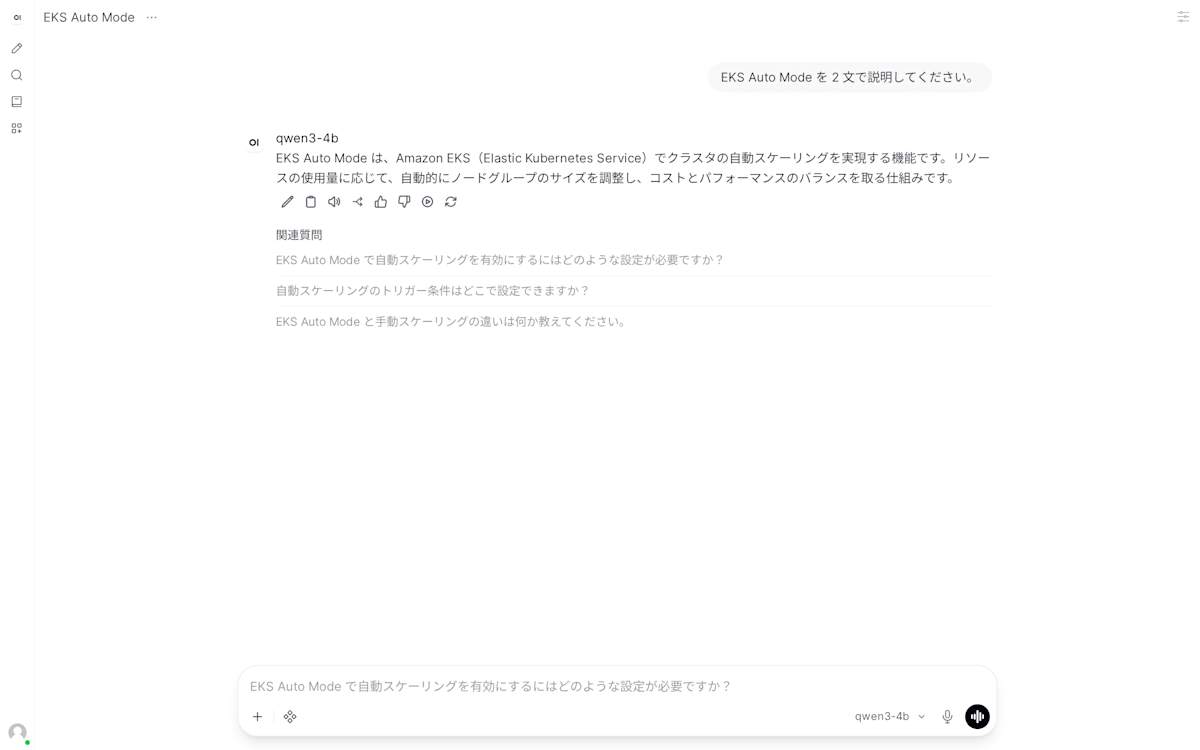
0 台から応答が返るまでには、ノードの起動、イメージと重みの取得、vLLM の起動が必要なので、数分かかります。チャットのような対話用途では、この待ち時間は利用者の体験を大きく損ないます。対話用途で使うなら、最小レプリカ数を 1 にして 0 台まで落とさない判断が現実的だと思います。0 台まで落とす構成は、バッチ処理や開発環境のように、待ち時間を許容できる用途に向きます。
発展的な内容
ここまでの構成は、llm-d が用意する機能のうち、ルーターの基本的な部分だけを使っています。llm-d のドキュメントには、この記事のコンポーネントをさらに拡張する機能が、検証済みの構成手順(Well-lit Paths)や運用ガイドとしてまとまっています。その中から、この記事の内容に続く話題を 5 つ取り上げます。
精密なプレフィックスキャッシュルーティング
この記事の EPP は、どのプレフィックスをどの vLLM に送ったかの履歴からキャッシュの所在を推定していました。精密な方式では、vLLM が KV キャッシュのブロックを確保したり追い出したりするたびにイベントを送ります。EPP はそれを購読して、各 Pod が実際に保持しているブロックの索引を作ります。
推定と実態のずれが小さくなる代わりに、処理が 1 つ加わります。索引は KV キャッシュのブロック(トークン列)単位で管理されるため、EPP は索引を引く前に、vLLM の API を呼んで全プロンプトをトークン化します。ルーターの判断材料を、推定から実測に置き換える拡張です。
参考)Enable Precise Prefix-Cache Aware Routing | llm-d
KV キャッシュの階層化と共有
この記事の vLLM は、VRAM からあふれたキャッシュを捨てていました。階層化では、追い出したブロックを CPU メモリや共有ファイルシステムへ退避し、必要になったら読み戻します。再計算より読み戻しの方が速い場合に効果があります。EPP の採点も、VRAM と CPU メモリの 2 つの階層を区別します。
さらに共有を有効にすると、ある vLLM が CPU メモリへ退避したキャッシュを別の vLLM が取り寄せられるので、キャッシュを持つ Pod へ送れなかったリクエストでも再計算を省けます。共有は階層化と精密なルーティングの両方を前提にしていて、ドキュメント上はまだ実験的な機能です。推論エンジンとルーターの両方にまたがる拡張です。
参考)Configure a Tiered Prefix Cache | llm-d
参考)Enable P2P Prefix Cache Sharing | llm-d
Prefill と Decode の分離
最初の章で見たとおり、Prefill はプロンプト全体を一度に処理する演算の重い段階で、Decode は 1 トークンずつ読み出しを繰り返す段階です。同じ vLLM で両方を処理すると、重い Prefill が進行中の Decode のステップを遅らせます。分離では、この 2 つを別々の vLLM の群に分け、Decode 側が Prefill 側の作った KV キャッシュをネットワーク越しに取り寄せます。
ルーターは 1 リクエストにつき Prefill 用と Decode 用の Pod を選びますが、Decode 側にキャッシュ済みの部分が多ければ Decode 用だけを選びます。性質の違う 2 つの処理を別々の台数で運用できるので、オートスケーラーにも関わります。キャッシュの転送が入るため、本番では高速なネットワークが推奨されています。推論エンジン、ルーター、オートスケーラーの 3 つにまたがる拡張です。
参考)Deploy Prefill/Decode Disaggregation | llm-d
参考)Disaggregated Serving | llm-d
レイテンシー予測によるルーティングとオートスケーリング
この記事では、ルーターは負荷とキャッシュの所在で採点し、オートスケーラーは処理中のリクエスト数とキューの長さを見ていました。llm-d には、完了したリクエストを学習データにして、最初のトークンまでの時間(TTFT)と出力 1 トークンあたりの時間(TPOT)を予測する仕組みがあります。ルーターはこの予測で Pod を採点し、応答時間の目標(SLO)がリクエストに指定されている場合は、目標に対して余裕のある Pod を優先します。目標を満たせないと予測したリクエストのうち、優先度の低いものだけを受付の時点で拒否できます。
オートスケーラー側では、予測または実測のレイテンシーが目標にどれだけ迫っているかを収集基盤で 1 つの値にまとめ、KEDA がその値からレプリカ数を計算します。ルーターとオートスケーラーの判断材料を、件数や使用率から応答時間の予測へ置き換える拡張です。
参考)Route Requests by Predicted Latency | llm-d
参考)Scale to Latency SLOs | llm-d
バッチと非同期処理
この記事の構成は、クライアントが応答を待つ同期の API を前提にしていました。バッチや非同期の処理では、クライアントは仕事を預けて、結果を後から受け取ります。llm-d には、この使い方のためのコンポーネントが 2 つあります。
Batch Gateway は OpenAI 互換の Batch API でジョブを受け付け、個々のリクエストに分解してルーターへ送ります。Async Processor はメッセージキューからリクエストを取り出し、メトリクスを見ながらルーターへ送る速さを調整します。どちらも、ルーターの手前でリクエストを溜めてから流す仕組みです。
参考)Process Batch and Async Requests | llm-d
まとめ
EKS Auto Mode の上に、GPU ノードと推論エンジンが 0 台から増減する LLM の推論基盤を構築してみました。
LLM の推論では、リクエストがマルチターンで、遅く、不均一です。そのため、ルーティング先の選び方にラウンドロビンが向かず、負荷の指標にも Web と同じものを使えません。
この 2 点を押さえれば、Web アプリケーションと同じ道具立てのまま、推論エンジンに状態を外へ見せる責務を持たせ、ルーターとオートスケーラーをその状態を読むものに置き換える形で組めます。Gateway の実装や推論エンジンを替えても、同じコンポーネント構成を取れると思います。一方で、0 台からの起動には時間がかかるので、最小レプリカ数は用途に応じて決める必要があります。
この記事が参考になれば幸いです。