型安全・低コスト・低遅延なJSON Modeのすごいやつ? - TypeSafe AIのJevをSDKから使ってみて、その仕組みを考えてみた

こんちには。製造ビジネステクノロジー部の中村(@nokomoro3)です。
今回はTypeSafe AIのJevについてご紹介します。
冒頭まとめ
- Jevは型安全で高速で安価なJSON Modeのようなもの
- Jevに思考する仕組みがあるわけではないため、正常な判断をさせるためにはLLMと同様にコンテキストが重要
- Jevが出力するスコアには数値的な裏付けがある(数値の大小に意味がある)ことも特徴の一つ
「判断に特化したモデル」と言われることが多いのですが「判断」だと「思考」をつかさどっているように思えてしまうので、実際には「判定(true/false)」「分類(ラベル分類)」「評価(スコア付け)」をコンテキスト(state)に基づいて行うモデルと理解した方が誤解が少ないように思います。
実際、Jevのアーキテクチャは既存のLLMと同じくTransformerベースのモデルとなっており、出力を自己回帰せずに一括実施することによるデコードの高速化(JSONを出力する以上、直前に何を出力したかは今の出力に無関係なはずなので)、入力される質問定義によるマスク行列の作成による型安全な出力、RLHF(人間の好みの学習)ではなくRLCDという数値の妥当性の学習を行うことによるスコア付けの裏付け強化が特徴であり、思考する仕組みがニューラルネットワークのアーキテクチャに盛り込まれているわけではないです。
そのためstateに与える状況の説明(コンテキスト)や質問定義の説明の重要性は従来のLLM使用時と変わらず同様です。
とはいえ、高速で低コストに状況判断に必要な情報を得られることは強力で、さまざまな活用方法が考えられます。とにかく低コストで低レイテンシなため、リアルタイムな状況判断に向いていると考えています。
- 高頻度なルーティング・仕分け
- サポートチケットや問い合わせ内容を、ミリ秒単位で適切な担当チームや後続処理に振り分ける
- PDFをページごとに判定し、「本当に画像OCRが必要なページだけ」を高価なVision APIに回す前段の仕分け機
- エージェントやパイプラインのガードレール
- エージェントが実行しようとしているコマンドやツール呼び出しが危険(破壊的)かどうかを瞬時に判定し、危険な場合のみブロックして人間に確認を求める
- ストリームデータやログの裏方監視
- 音声認識(STT)で逐次流れてくるテキストに対して、NGワードの有無や会話の炎上度合いをバックグラウンドで監視し続ける
一方でじっくり推論(Chain of Thought)させなければならないタスクをJevに任せるのはアンチパターンです。
そうした重たい処理はLLMに任せ、Jevはあくまで手前の「軽量な仕分け・安全弁」として配置するのが適しています。
使い始めるまで
以下で「Join Waitlist」を選択してウェイトリストにメールアドレスを登録します。
以下のようなメールが送られてくるのでアカウントを作成します。
進めると、以下のようなサービスの利用規約への同意画面が表示されます。
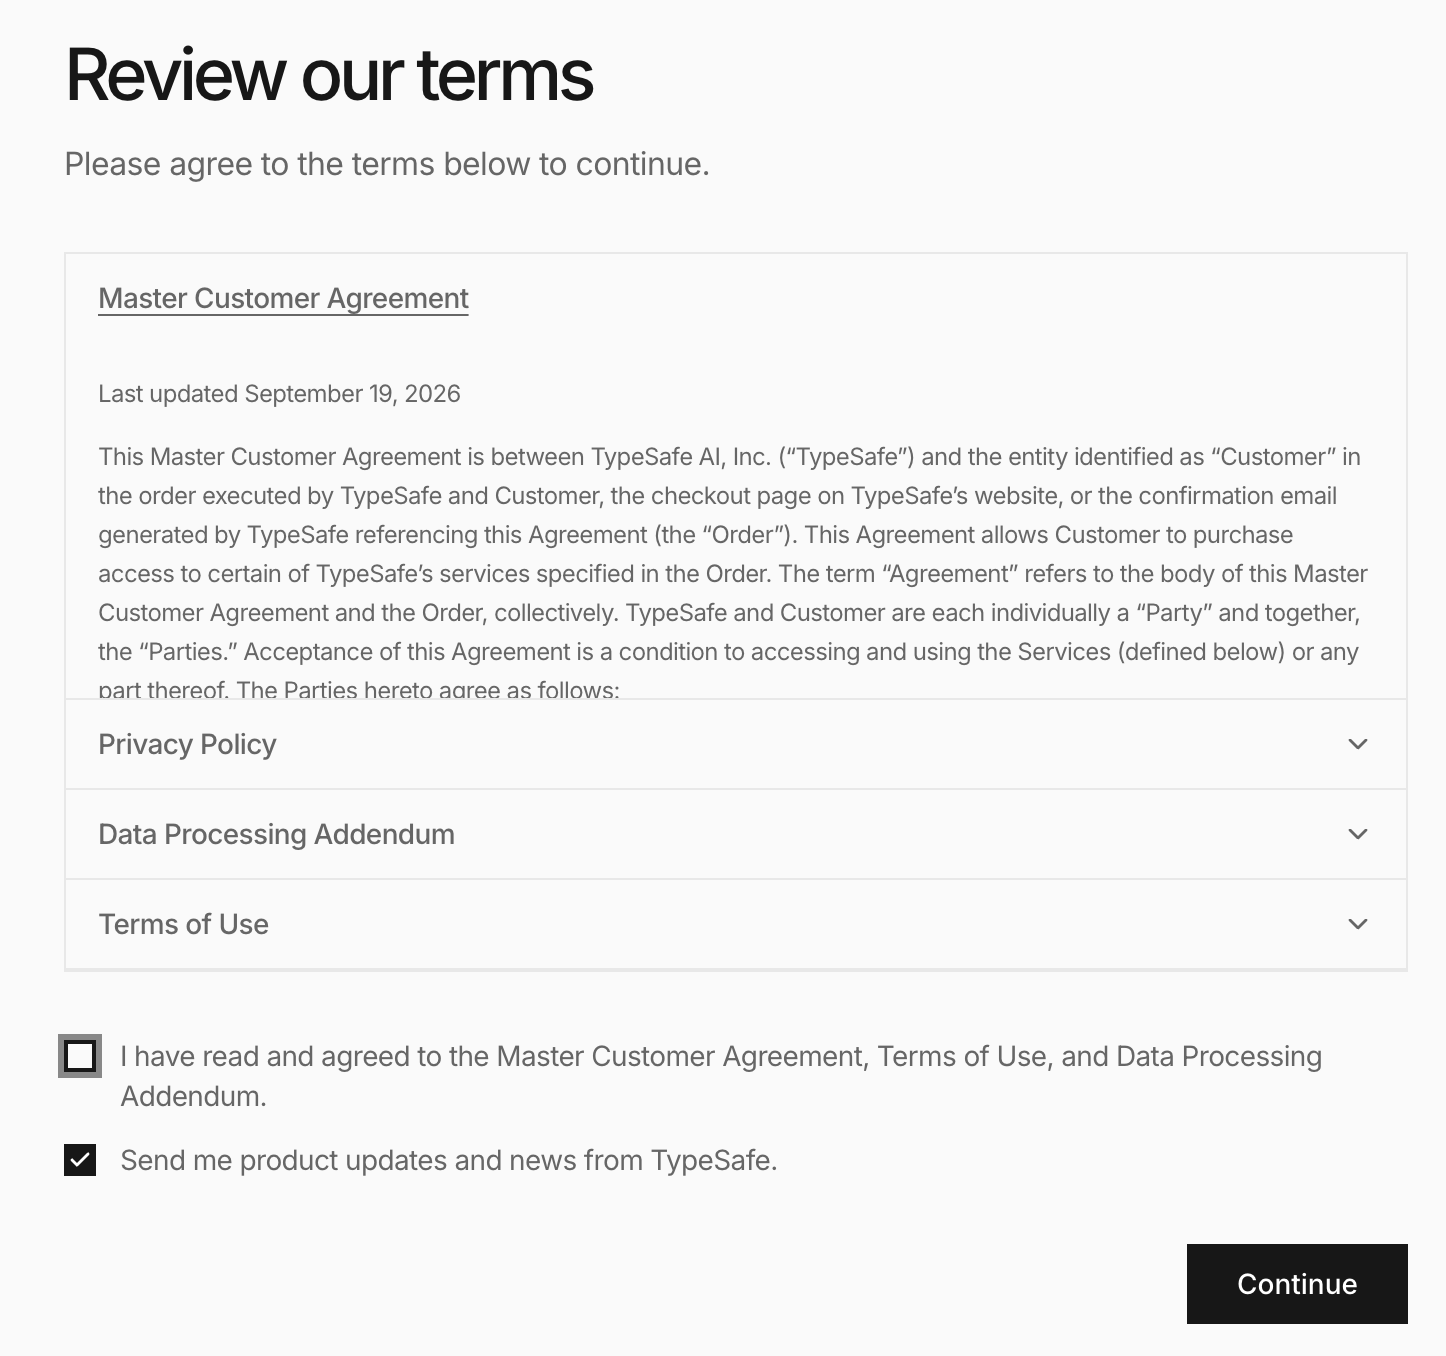
概要をまとめると以下のような感じです。
- 入力したプロンプト、データ、指示(Input)は、モデルのトレーニング・ファインチューニングには一切使用しない
- 個人データの「販売(Sale)」や行動ターゲティング広告目的の「共有(Share)」は行わない
- サーバーは米国(U.S.)にあり、日本や欧州など米国外からアクセスする場合、データは米国へ転送・保管される
- TypeSafeは、サービスの提供および顧客の指示に従う目的でのみ個人データを処理する
- データ処理は委託先されることがあり、委託先の一覧は公開されており、新しい委託先が追加される際は事前通知が行われる
問題なければチェックボックスにチェックを入れて「Continue」をクリックします。
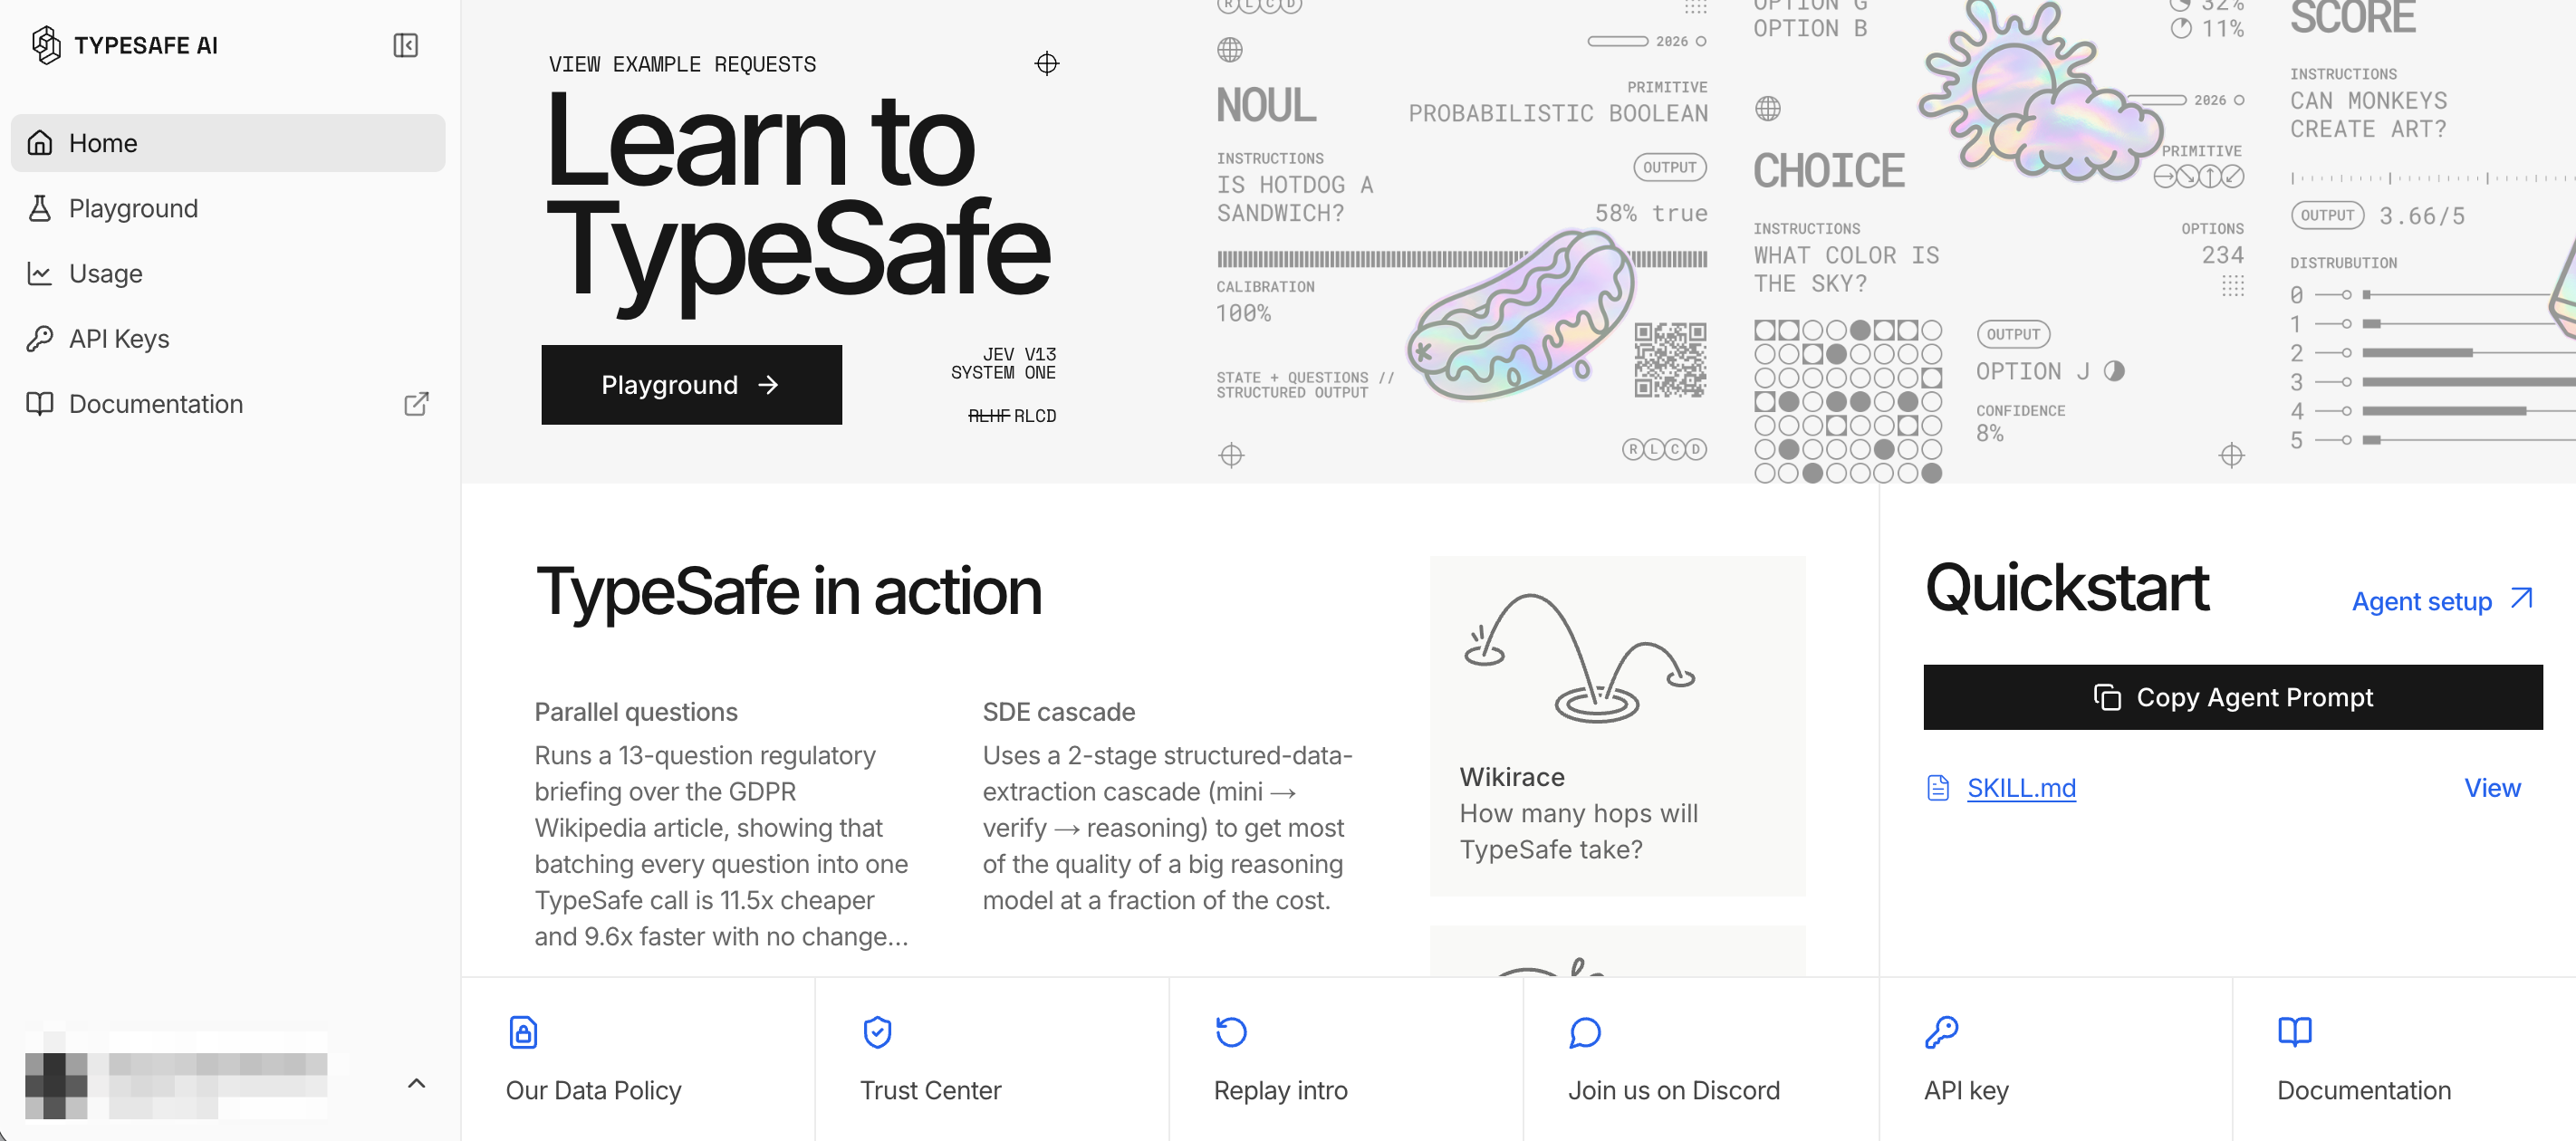
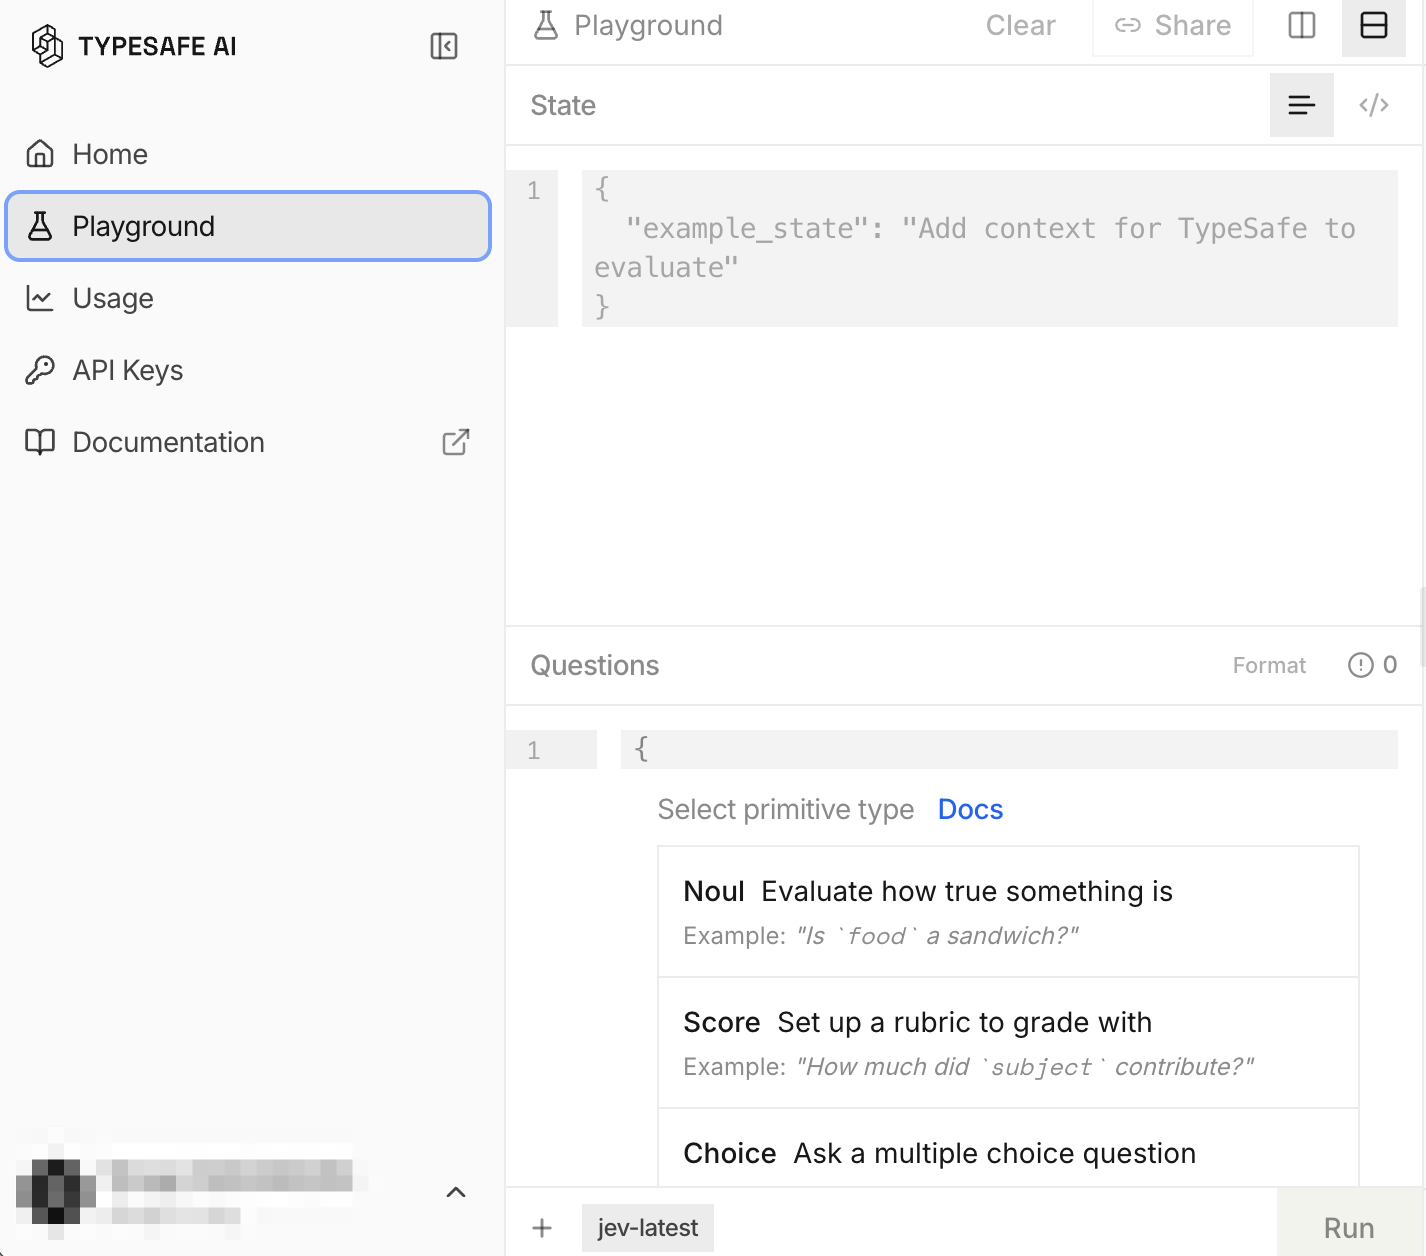
以下のような画面が表示されれば準備完了です。
使い方
プレイグラウンドを使う
先ほどの画面でプレイグラウンドとして使うことができます。
HTTPから使う
curlコマンドなどを使ってAPIキーを渡しながら呼び出すこともできます。
curl -X POST https://api.typesafe.ai/v1/systemone \
  -H "Authorization: Bearer $TYPESAFE_API_KEY" \
  -H "Content-Type: application/json" \
  -d @- <<'EOF'
  {
    "state": "Hi, I've been trying to connect my Stripe account for 3 days and the integration keeps failing. I'm losing sales. Please help ASAP.",
    "model": "jev-latest",
    "questions": {
      "urgency": {
        "type": "noul",
        "instructions": "Does this message express urgency?"
      }
    }
  }
EOF
SDKから使う
PythonやJavaScriptのSDKが公開されているため、それを使って呼び出すこともできます。
from typesafe_sdk import Choice, Noul, Score, TypeSafeClient

client = TypeSafeClient()

ticket = "Hi, I've been trying to connect my Stripe account for 3 days and the integration keeps failing. I'm losing sales. Please help ASAP."

response = client.system_one(
    state=ticket,
    questions={
        "department": Choice(
            instructions="Which team should handle this",
            criteria={
                "billing": "Payment or subscription issues",
                "technical": "Bugs or integration problems",
                "sales": "Pricing or account questions",
            },
        ),
        "frustration": Score(
            instructions="How frustrated the customer appears",
            criteria=[
                "Calm, just stating facts",
                "Frustrated but civil",
                "Very angry, strong language",
            ],
        ),
        "is_urgent": Noul(
            instructions="The message conveys urgency or time-sensitivity",
        ),
    },
)

print(response.answers["department"].choice)  # "technical"
print(response.answers["frustration"].score)  # 1.0
print(response.answers["is_urgent"].noul)     # 1.0
環境変数 TYPESAFE_API_KEY にAPIキーをあらかじめ設定しておきます。
既存のコーディングエージェントのスキルとして使う
Jevを使うためのスキルが公開されているため、そのプラグインを導入することで使用することができます。
以下はプラグインをセットアップするためのスキルです。
Install the TypeSafe skill. If you're in Claude Code, run `claude plugin marketplace add typesafe-ai/skills`,
then `claude plugin install typesafe@typesafe-ai`.
If you're in another agent, run `npx skills add typesafe-ai/skills --skill typesafe-ai` and select your agent.
Use one installation method. You can read the skill directly at https://github.com/typesafe-ai/skills/blob/main/skills/typesafe-ai/SKILL.md (raw: https://raw.githubusercontent.com/typesafe-ai/skills/main/skills/typesafe-ai/SKILL.md).
Then use the TypeSafe skill when working on this project.
スキルの詳細は以下からも確認できます。
実際に使ってみる
今回はPython SDKから使用してみます。
以下の画面からAPIキーを作成します。
APIキーを環境変数 TYPESAFE_API_KEY に設定します。
export TYPESAFE_API_KEY=your_api_key
uvやpipを使ってSDKをインストールします。
uv add typesafe-sdk
以下はユーザーからの問い合わせチケットの文面を入力(state)として、質問定義として「担当チーム」「苛立ちの度合い」「緊急性」を評価できるようにしたものです。
from typesafe_sdk import Choice, Noul, Score, TypeSafeClient, NoulCriteria
import msgspec, json

# ユーザーからの問い合わせ文(チケット)
ticket = "こんにちは。Stripeアカウントの連携を3日間試しているのですが、エラーが続いて連携できません。売上に影響が出て困っています。至急対応をお願いします。"

# 質問定義
questions = {
    # 1. Choice: 選択肢から担当チームを1つ選ぶ
    "department": Choice(
        instructions="どのチームがこの件を担当すべきか",
        criteria={
            "billing": "支払いまたはサブスクリプションに関する問題",
            "technical": "バグやシステム連携に関する問題",
            "sales": "料金プランやアカウントに関する質問",
        },
    ),
    # 2. Score: 顧客の苛立ちの度合いを段階的に評価する
    "frustration": Score(
        instructions="顧客がどれくらい苛立っているように見えるか",
        criteria=[
            "冷静で、事実のみを述べている",
            "苛立ってはいるが、丁寧さは保っている",
            "非常に怒っており、強い言葉遣いを使っている",
        ],
    ),
    # 3. Noul: 条件に当てはまるかどうか(Yes/No の確率)
    "is_urgent": Noul(
        instructions="メッセージから緊急性や時間的な切迫感が伝わってくるか",
        criteria=NoulCriteria(
            true="「至急」「本日中」などの期限が明記されている、または業務停止など即座の対応を要する問題が生じている",
            false="時間的な指定がない、または「お手すきの際に」「いつでも構いません」などの猶予が明記されている",
        ),
    ),
}

# 送信リクエストのペイロードをJSON化
request_payload = {
    "model": "jev-latest",
    "state": ticket,
    "questions": msgspec.to_builtins(questions)  # ここで Choice などを辞書に展開
}
print(json.dumps(request_payload, indent=2, ensure_ascii=False))

# 呼び出し
client = TypeSafeClient()
response = client.system_one(
    model=request_payload["model"],
    state=request_payload["state"],
    questions=questions
)

# JSON文字列としてインデント付きで整形して出力
json_bytes = msgspec.json.encode(response)
print(msgspec.json.format(json_bytes).decode("utf-8"))
質問定義はSDKが提供する専用の型オブジェクト(ChoiceやScoreなど)を使って定義することができます。JSONで記載するとこういう感じです。
{
  "model": "jev-latest",
  "state": "こんにちは。Stripeアカウントの連携を3日間試しているのですが、エラーが続いて連携できません。売上に影響が出て困っています。至急対応をお願いします。",
  "questions": {
    "department": {
      "type": "choice",
      "criteria": {
        "billing": "支払いまたはサブスクリプションに関する問題",
        "technical": "バグやシステム連携に関する問題",
        "sales": "料金プランやアカウントに関する質問"
      },
      "instructions": "どのチームがこの件を担当すべきか"
    },
    "frustration": {
      "type": "score",
      "criteria": [
        "冷静で、事実のみを述べている",
        "苛立ってはいるが、丁寧さは保っている",
        "非常に怒っており、強い言葉遣いを使っている"
      ],
      "instructions": "顧客がどれくらい苛立っているように見えるか"
    },
    "is_urgent": {
      "type": "noul",
      "instructions": "メッセージから緊急性や時間的な切迫感が伝わってくるか",
      "criteria": {
        "true": "「至急」「本日中」などの期限が明記されている、または業務停止など即座の対応を要する問題が生じている",
        "false": "時間的な指定がない、または「お手すきの際に」「いつでも構いません」などの猶予が明記されている"
      }
    }
  }
}
typeに3種類があり、choiceは選択肢から1つを選ぶ、scoreはスコアで評価する、noulはYes/Noの確率を判定する、というような使い分けができます。
instructionsについて
instructionsは、その質問でJevに「何を判断・評価させたいのか」という具体的な指示文を記載するための項目です。
choiceとnoulの場合、instructionsは必須の項目となっています。instructionsをもとに何をもって判断すべきなのかをJevに指示することができます。
scoreの場合、instructionsは必須ではありません(代わりにcriteriaが必須です)。ただし、評価の観点をinstructionsで補足することで判定精度を安定させることができると考えられます。
criteriaについて
また、各質問には評価基準となるcriteriaを定義できます。
choiceでは「各選択肢の具体的な説明」が記載できます。criteriaを使わない場合は選択肢だけを列挙するoptionsを使うことも可能です。
ただし、criteria未使用だと変数名やinstructionsのみをヒントにJevが処理するため、精度を上げるためには選択肢ごとにcriteriaをきちんと使用した方が良さそうです。(選択肢ごとの説明を書くにはcriteriaが必要)
scoreでは「レベルごとの状態(段階)」を渡すことができます。scoreの場合、criteriaは必須の項目となっており2個以上を記載する必要があります。
"Score rates content against 2 to 10 ordered, descriptive levels you write. criteria is an array of at least two labels, lowest to highest."
(Score は、ユーザーが記述した 2〜10 個の順序付き評価レベルに基づいて評価する。criteria は最低 2 つのラベルを最小から最大へと並べた配列である。)
またscoreの場合、criteriaの数によってスコアの範囲が決まることに注意しましょう。
| criteria に渡した要素数 ( |
スコアの範囲(最小 〜 最大) | レスポンスの legend |
|---|---|---|
| 2段階(例: 低 / 高) | 0.0 〜 1.0 | {"0": "低", "1": "高"} |
| 3段階(★今回の例) | 0.0 〜 2.0 | {"0": "冷静", "1": "苛立ち", "2": "激怒"} |
| 5段階(いわゆる5段階評価) | 0.0 〜 4.0 | {"0": "極低", "1": "低", "2": "中", "3": "高", "4": "極高"} |
| 10段階(仕様上の上限) | 0.0 〜 9.0 | {"0": "...", ..., "9": "..."} |
noulの場合でもcriteriaを使うことができ、「何をもって True(Yes)とし、何をもって False(No)とするのか」という境界条件を厳密に定義するために使われます。
stateについて
サンプルではstateには文字列を使いましたが、dictやlistを使うこともできます。
state = {
    "user_message": "二重請求されているようなので至急返金してください。",
    "user_tier": "Enterprise",
    "days_since_signup": 45
}
state = [
    {"role": "user", "content": "プランを解約したいです。"},
    {"role": "agent", "content": "承知いたしました。理由を教えていただけますか?"},
    {"role": "user", "content": "料金が高すぎるためです。"}
]
会話履歴をそのままstateに突っ込んで処理させることができるので便利そうです。
レスポンスについて
レスポンスは以下のような形式となります。
{
  "model": "jev-1.13.0",
  "usage": {
    "input_tokens": 696,
    "output_tokens": 73
  },
  "answers": {
    "department": {
      "type": "choice",
      "choice": "technical",
      "confidence": 0.81,
      "probabilities": {
        "billing": 0.13,
        "technical": 0.87,
        "sales": 0.0
      }
    },
    "frustration": {
      "type": "score",
      "score": 0.97,
      "confidence": 0.95,
      "legend": {
        "0": "冷静で、事実のみを述べている",
        "1": "苛立ってはいるが、丁寧さは保っている",
        "2": "非常に怒っており、強い言葉遣いを使っている"
      },
      "probabilities": {
        "0": 0.03,
        "1": 0.97,
        "2": 0.0
      }
    },
    "is_urgent": {
      "type": "noul",
      "noul": 0.96
    }
  }
}
choiceでは各選択肢ごとの確率値(probabilities)も返されるようです。
scoresの場合でも同様です、つまりscoreは連続値を直接予測しているのでは、3つの選択肢を定義した場合、それぞれを0,1,2の数値とみなし、probabilitiesで重みをかけて和を取った値をscoreとして返していると考えられます。
noulの場合も仕組みは同様と推測されます(noulの値しか帰らないのは、1から引けば逆のprobabilityがわかるためでしょう)
このprobabilitiesの個数が、後述するJevの仕組みである「スロット」の数と一致します。
confidenceについて
なおchoiceとscoreの場合、confidenceという信頼度を返します。
scoreとの違いがわかりにくいかと思いますが、confidenceは状況判断の難しさを表現していると考えれば良いと思います。
つまりconfidenceが低いというのは、説明(stateやinstruction、criteriaを含む)が不十分か、そもそも問題が難しいか、のいずれかということになります。
これはJevの特徴であるRLCDにより得られた大きな特徴の一つと考えられます。
なお、選択肢が2つの場合(Choiceで2択、またはScoreでcriteriaが2個の場合)は、数学的に自由度が1しかない(片方の確率が決まればもう片方も一意に決まる)ため、確信度(confidence)は事実上、確率の偏り(マージン)をそのまま反映した数値になります。そのため、confidenceが「確率分布の迷いのなさ」という独自の要約指標として真価を発揮するのは、選択肢が3つ以上の場合と整理しておくと良さそうです。
Jevの特徴
ここまでの挙動を踏まえ、Jevのアーキテクチャが通常のLLMとどこが異なるのかを説明します。
Encoderまでは同じ、Decoderが自己回帰ではなく一括出力
通常のLLMは、入力文をエンコードした後に「次に来る1単語」を一つ予測し、その次はそこまでに予測した内容をもとに再び「次に来る1単語」を予測し続ける自己回帰モデル(Autoregressive Model)です。
LLMにもJSON Modeはありますが、裏では{や"category": "billing"といった構文文字を1トークンずつ時間をかけて出力し、過去のキャッシュ(KVキャッシュ)を更新しながら何十回もループ処理(Decode)を回しています。GPUのメモリ帯域がボトルネックになるため、どうしても数秒〜十数秒の待ち時間が発生します。
対してJevは、テキストを1語ずつ吐き出すデコード層を完全に排除しています。
DecodeループもKVキャッシュの読み書きも存在しないため、GPU本来の並列計算性能をフルに発揮することができ、数十〜数百ミリ秒という低レイテンシを実現しています。
文章生成のループがない分、モデル側の処理時間としては入力コンテキストを一括処理するPrefill(入力長)に大きく依存する構造になっていると考えられます。
マスク行列による「原理的に型エラーがない」決定論的ゲート
従来の JSON Mode や Structured Outputs は、約10万語ある語彙辞書の中から「次はスキーマに合わない単語を出してはいけない」と外側から文法チェッカー(制約付きデコーディング)で誘導しているだけでした。そのため存在しない選択肢を出力したり、パースエラーを起こしたりするリスクが残ります(それでも最近はかなり稀ですが、それでも0%ではありません)。
一方、Jev の出力層にはそもそも語彙辞書への投射層がなく、「Hardware-Aware Parallel Sampler」と呼ばれる最大255枠の専用スロットが用意されています。
スロットは「質問の数」ではなく、「最終的に確率(probability)が割り当てられる候補の1つひとつ」に対して物理的に割り当てられていると考えられます。
- Choice: 定義した選択肢の数(2〜255枠)
- Score: 定義した criteria の段階数(2〜10枠)
- Noul: Yes / No の2枠
TypeSafe AI は並列サンプラーの厳密な内部実装を公開していませんが、GPUの並列計算の仕様や出力結果から逆算すると、以下のような仕組みで型安全性が担保されていると推測されます。
- 入力の分離とスロットの事前割り当て(プログラム側)
- リクエストされた質問定義(instructions や criteria)は、意味を解釈するために通常通り Transformer の Encoder に渡されます
- それと同時に、推論サーバー側のプログラムが質問定義の構造をパースし、「定義された順番通りに、各 probability 用のスロット(インデックス)を何番から何番まで割り当てるか」という対応マップを決定論的に作成します
- GPU による一括スコアリングとマスク処理(テンソル計算)
- GPU はテキスト生成を行うのではなく、割り当てられたスロットに対して並列にロジットを計算します
- この際、未使用のスロットにはプログラムが生成した
-\infty
- プログラムによる安全な解釈と構造化(プログラム側)
- モデルが出力するのは、各スロットの確率値(数値の配列)だけです。
- これを外側のプログラムが最初に作成した対応マップに沿って読み解き、「スロット0〜2は Choice の結果」「スロット3〜5は期待値を計算して Score の値」といった形で型安全に解釈し、最終的なレスポンスJSONを組み立てて返却します。
つまり「AI自身にJSONという文字列を書かせている」のではなく、「AIには決められたスロットの確率計算だけをやらせ、JSONへの組み立ては外側の決定論的なプログラムが担っている」という役割分担になっており、質問定義に基づくスロット管理とプログラムによる機械的な復元が行われるため、フォーマットの崩れや型エラーが原理的に発生しない設計になっていると考えられます。
複数質問を一度に並列評価する「Shared State Read」
Jev は、1つのコンテキスト(State)に対して複数の質問(Choice, Score, Noul)を定義した場合、State のエンコード結果(潜在表現)をすべての質問で共有します。
各質問はお互いに干渉せず、独立して完全並列に評価されます。そのため「質問を1つ投げても、5つまとめて投げても、処理時間(レイテンシ)はほとんど変わらない」という並列アーキテクチャならではの特徴を持っています。
RLCD(較正された決定のための強化学習)による数値の裏付け
ChatGPTなどの対話型モデルは、人間受けする自然な回答を作るためのRLHF(Reinforcement Learning from Human Feedback)で訓練されています。
RLHFを受けたモデルは「説得力があるように話すこと」を褒められて育つため、間違っている時でも自信満々にハッタリをかます(過信 / Overconfidence)というソフトウェア的には非常に厄介な性質を持ちます。そのため、プロンプトで「確信度を 0.0〜1.0 で出力して」と指示しても、返ってくる数値に統計的な根拠がありませんでした。
これに対してJevは、文章の流暢さではなくRLCD(Reinforcement Learning for Calibrated Decisions)という独自手法で訓練されています。
これにより「出力された確率やスコア」と「実際の正解率」が数学的に一致(較正 / キャリブレーション)するように最適化されています。
確信度が 0.8 と算出された場合は統計的にも約 80% 当たり、説明不足や難問で迷っている時は見栄を張らずに低い数値を正直に返します。
この「数値の裏付け」があるからこそ、エンジニアはプログラムの if 文でしきい値を設けて「高確信度なら全自動処理、低確信度なら人間にエスカレーション」という安全なフォールバック設計を組むことができます。
RLCDの限界に対する考察
ただし、ここで一つだけ注意点があります。
それは「RLCDの学習データや調整基準がブラックボックスである以上、そのキャリブレーションは自社独自のタスクでも成立するとは限らない」という点です。
これはベクトル検索(Embedding)による類似度計算の妥当性が、そのEmbeddingモデルがどのように訓練されたか(何と何を似ていると判断するように学習したのか)に依存して変わることと同様の現象です。
従来のLLMのように「完全に根拠のないハッタリ」より遥かに信頼できるのは確かですが、モデルが返してくる確率やスコアを絶対的な真理として鵜呑みにするのではなく、自社のタスクにおいても適合するかどうかを評価した上でプロダクションに採用することが、Jevを使い倒すための重要なポイントになります。
OSS版との違い
Jevの登場以降、オープンソースコミュニティでも「非自己回帰でロジットから直接確率を取り出す」というJevライクな実装やOSSモデル(OpenJevやLaya、MLXベースの軽量実装など)がいくつか登場しています。
これらの多くは、Qwenなどの既存の小型オープンLLMに対してテキスト生成(Decode)をさせず「入力後の1文字目に出力されるトークンのロジット(確率)だけを抜き出してSoftmaxをかける」というハックで模倣しているものが主流です。
1回のPrefillパスだけで終わらせるため、「数十ミリ秒で型付きの判定を返す」という外見上の挙動やレイテンシはかなり再現できています。ただし、本家Jevと完全に同等かというと以下の点で差があります。
- RLCDによるキャリブレーションの有無
- OSSの多くは既存のチャットモデルのロジットを流用しているため、モデル特有の過信(ハッタリ)が残っています。
- 「0.8という確率が出たときに、統計的にも真に80%当たっているか」という数値自体の信頼性(RLCDによる裏付け)までは再現できていません。
- アーキテクチャの特化度合い
- 本家Jevは語彙層を全廃し、最大255枠のスロットとマスク行列に特化した専用サンプラーを備えていますが、OSS版の多くは「通常のLLMの先頭トークンだけを読んでいる」状態です。
ローカル環境や自社サーバー内で閉じて安価・高速に動かしたい場合にはこれらのOSSも有用な選択肢ですが、「数値を信じて閾値設計ができるか」という信頼性の面では、本家Jevの学習プロセスにまだ一日の長があるのが現状です。
コストについて
Jev の料金体系は極めてシンプルで、以下のように入力トークンにのみ応じて料金が発生します。
- 入力トークン: 100万トークンあたり0.042USD(約6円)
- 出力トークン: 完全無料($0.00)
従来のLLMは「出力トークン単価が入力の数倍高い」のが通例でしたが、Jev には文字列を出力するという概念そのものがないため、出力に対する課金が存在しません。
前述の「Shared State Read」の特性と合わせると、「大きなコンテキスト(State)を1つ用意し、聞きたい質問を10個でも20個でもまとめて1回のリクエストでぶつける」ことで、トークン費用もレイテンシも最小化できるという強力なコストメリットがあります。
まとめ
Jevを深掘りしてみると「文章を生成してJSONフォーマットを守らせる」という従来のやり方をやめ「そもそも文章を出力できない物理構造(固定スロットとマスク行列)にしておく」という割り切ったアーキテクチャであることが分かりました。
要点を振り返ると以下の通りです。
- 実態: 思考するAIではなく、文脈(state)と基準(criteria)に基づいて判定・分類・評価を行うモデル
- メリット: デコードを全廃したことによる低レイテンシ、出力トークン無料の低コスト、原理的に100%崩れない型安全性
- 注意点: 思考のステップを踏めないためコンテキストの設計が重要であり、出力されるスコアや確信度も自社タスクに合わせた評価が必要
従来のLLMを置き換えるものではありませんが、ルーティングやガードレールといった「普通のプログラムのIF文に近い判定」を高速・安価に任せるコンポーネントとして、非常に扱いやすい選択肢だと感じます。
興味のある方は、まずはウェイトリストに登録してプレイグラウンドやSDKで触ってみてはいかがでしょうか。
本記事が参考になれば幸いです。