「その判定、LLM じゃなくていい」というタイトルで DevelopersIO 2026 Tokyo で登壇しました #devio2026

こんにちは、けーまです。
2026年10月24日に開催された DevelopersIO 2026 Tokyo で登壇しました。
この記事では、当日お話しした内容をスライドに沿ってまとめます。
来られなかった方はもちろん、会場で聞いてくださった方の振り返り用としても読んでいただけるとうれしいです。
1. 登壇概要
その判定、LLM じゃなくていい ― Decision Model で「迷ったら人間」を設計する
けーま(川田 圭真)(AI事業本部 / エンジニア)|20分LLMは優秀ですが、利用コストの高さが多くの企業で課題になっています。しかも、LLMに「この答え、どれくらい自信ある?」と聞くと一応数字は返してくれるものの、その確信度はまったく当てになりません。そんな中、2026年9月15日にTypeSafe社がJevを発表したことを機に、確率付きで型安全な判断を返す「Decision Model」の活用議論が広がりました。先行事例ではブラウザ自動化や開発者向けエージェントでの検証が目立ちますが、業務の現場で求められるのは、誤判定を可能な限り避けたい業務への適用です。本セッションでは、迷ったときだけ人間にエスカレーションする閾値設計を取り上げ、書類判定などの現場業務にDecision Modelを組み込んで、判定の精度を高めながらコストも下げる実践的なアプローチをお話しします。
引用元: DevelopersIO 2026 Tokyo <AIxクラウド技術祭> #devio2026 - connpass
2. 登壇資料
今回の発表は、分類や判定のたびに大きな LLM を呼んでいる方や、LLM の答えをどこまで信じてよいか迷っている方に向けた内容です。
持ち帰ってほしいこととして、次の3つを挙げました。
-
Decision Model と普通の LLM の違い
-
確率で「迷ったら人間」に回す設計
-
閾値を自分のデータで決める手順
3. 課題:確認する人がボトルネック
書類処理では、処理の性質ごとにプログラム・AI・人へ役割を分けるのが一般的です。
決まった手順で処理できる部分はプログラム、多少間違ってもよい部分は AI、絶対にミスできない部分は人(Human in the Loop)が担当します。
そして、この中で一番時間がかかるのが人のチェックです。
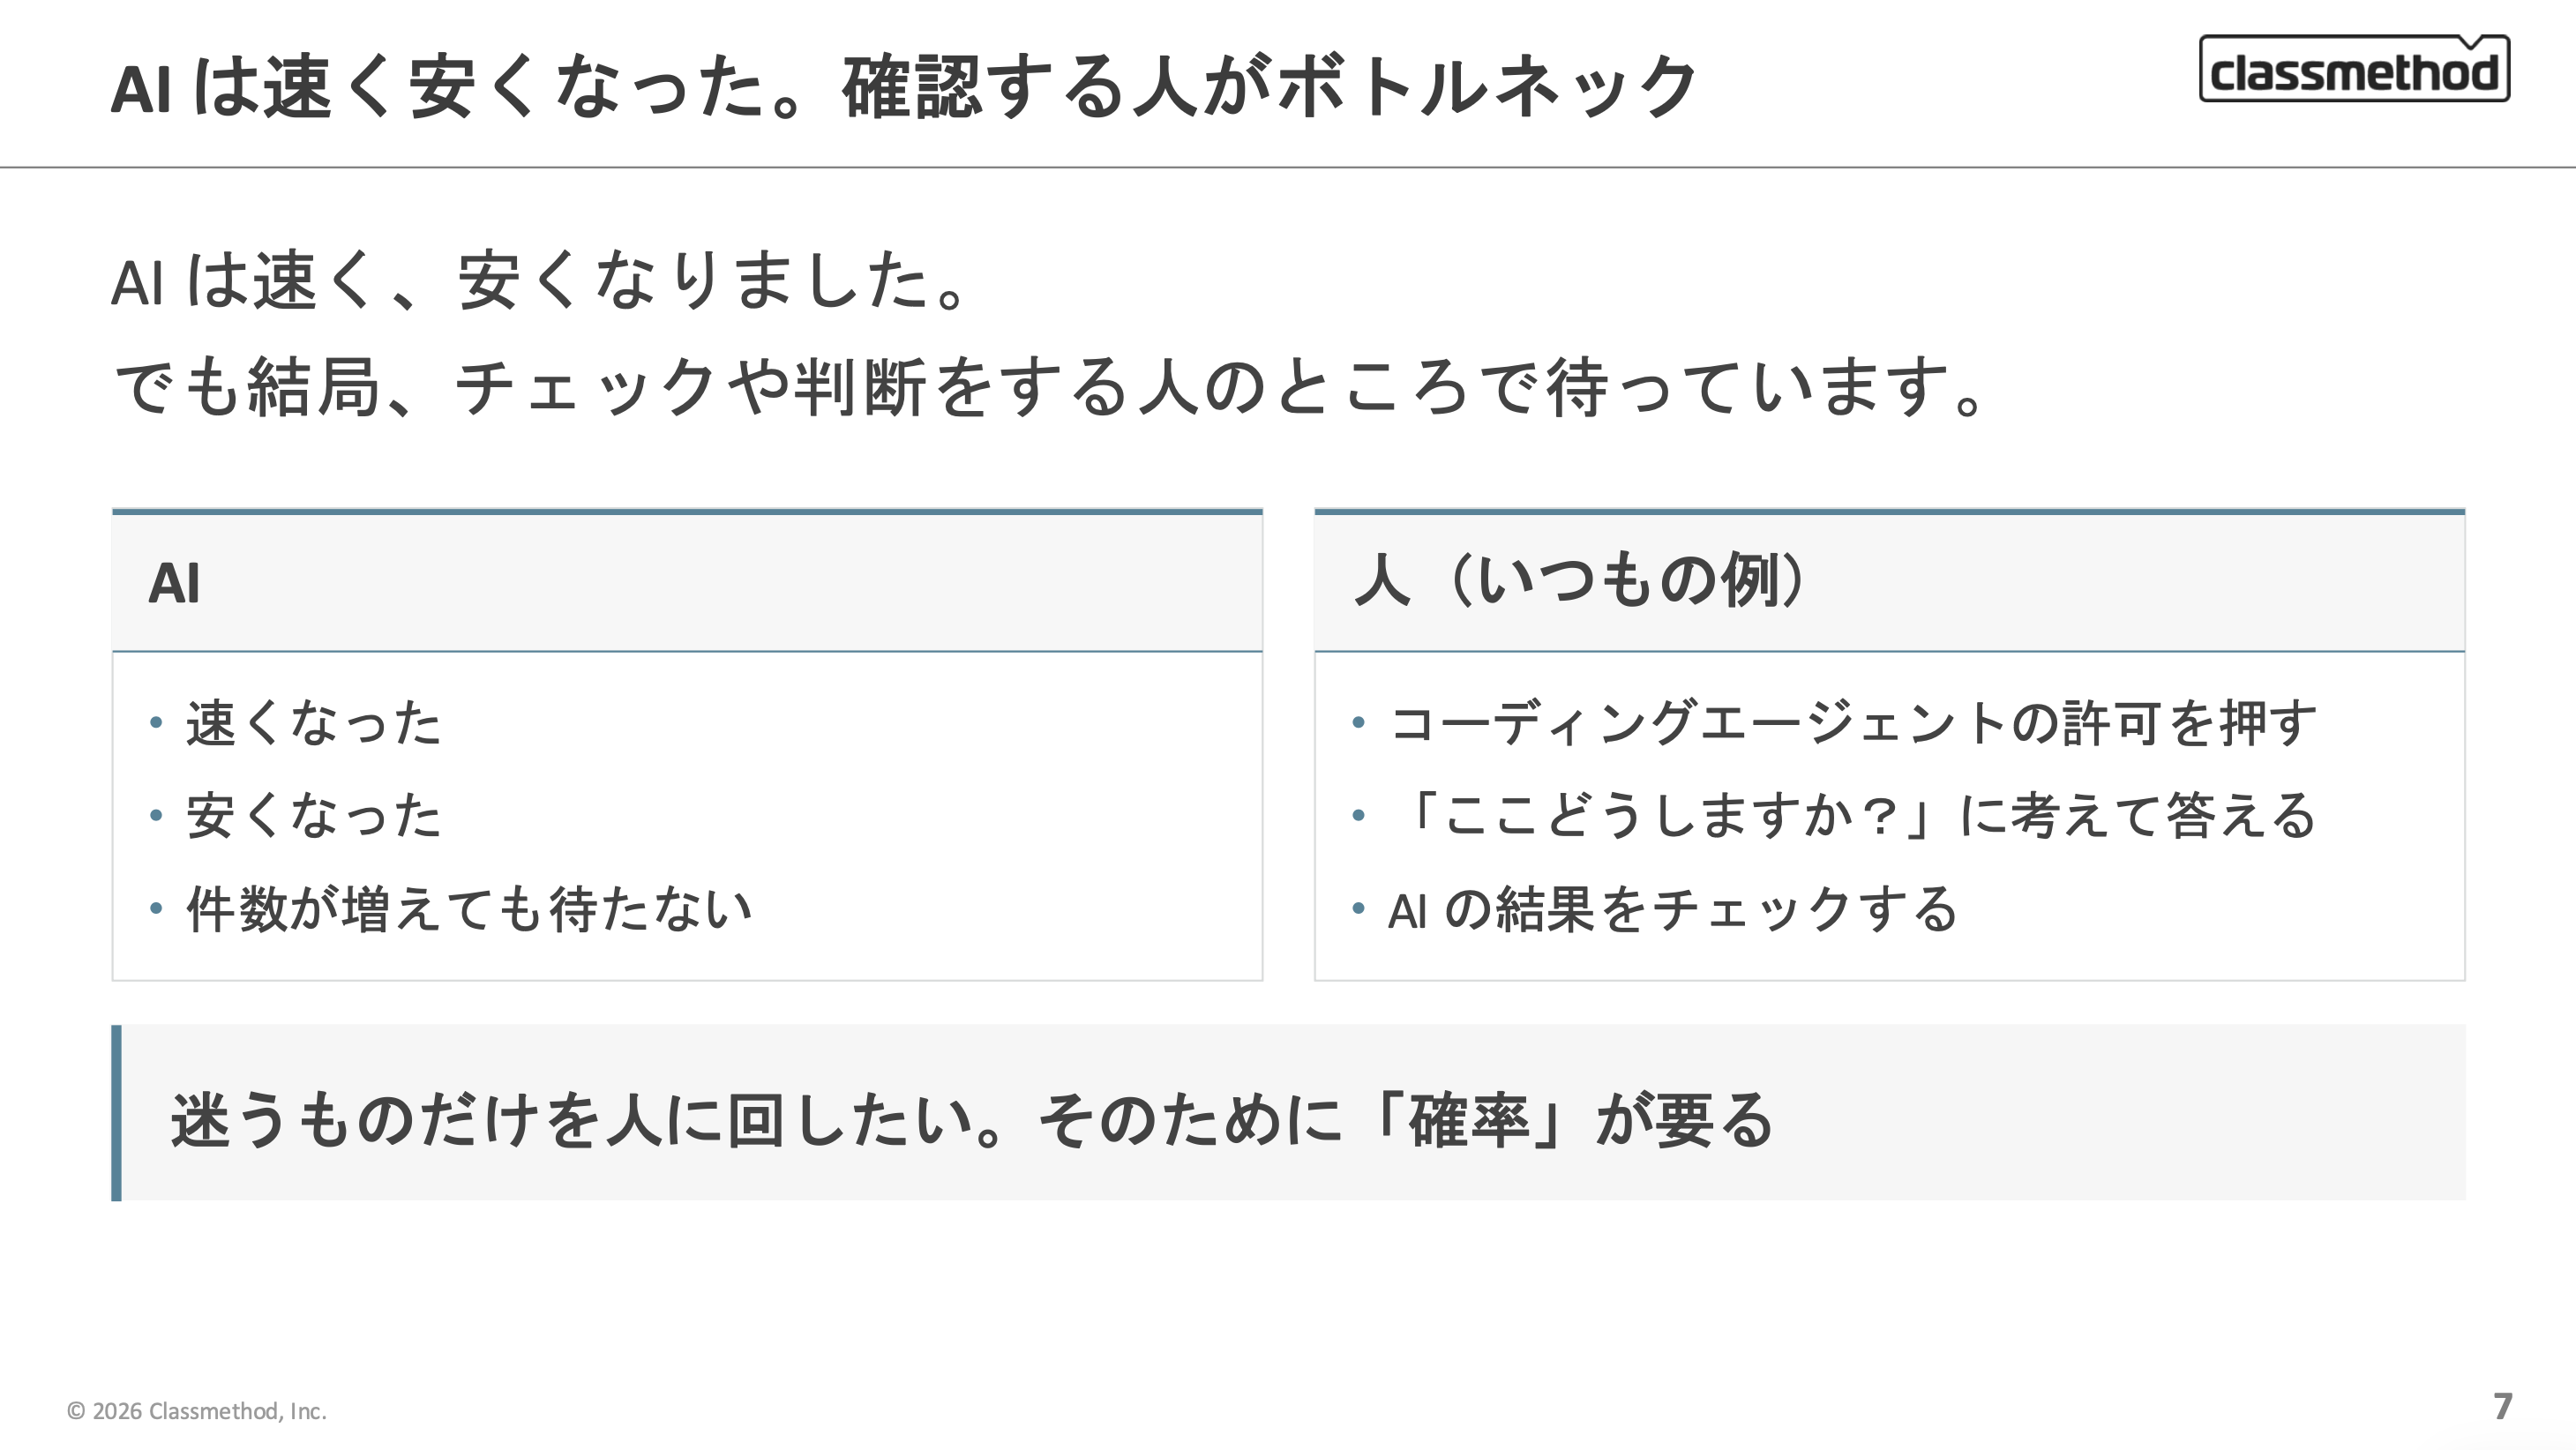
AI は速く、安くなりました。
それでも、コーディングエージェントの許可を押したり、「ここどうしますか?」に答えたり、AI の結果をチェックしたりする場面では、結局人のところで待っています。
迷うものだけを人に回すには、AI の答えに「確率」が必要です。
4. Decision Model とは
4.1 Yes の確率を返すモデル
Decision Model は、質問に Yes/No で答え、「Yes である確率」(0〜1)を返すモデルです。
一般的な LLM のように文章を生成することはありません。
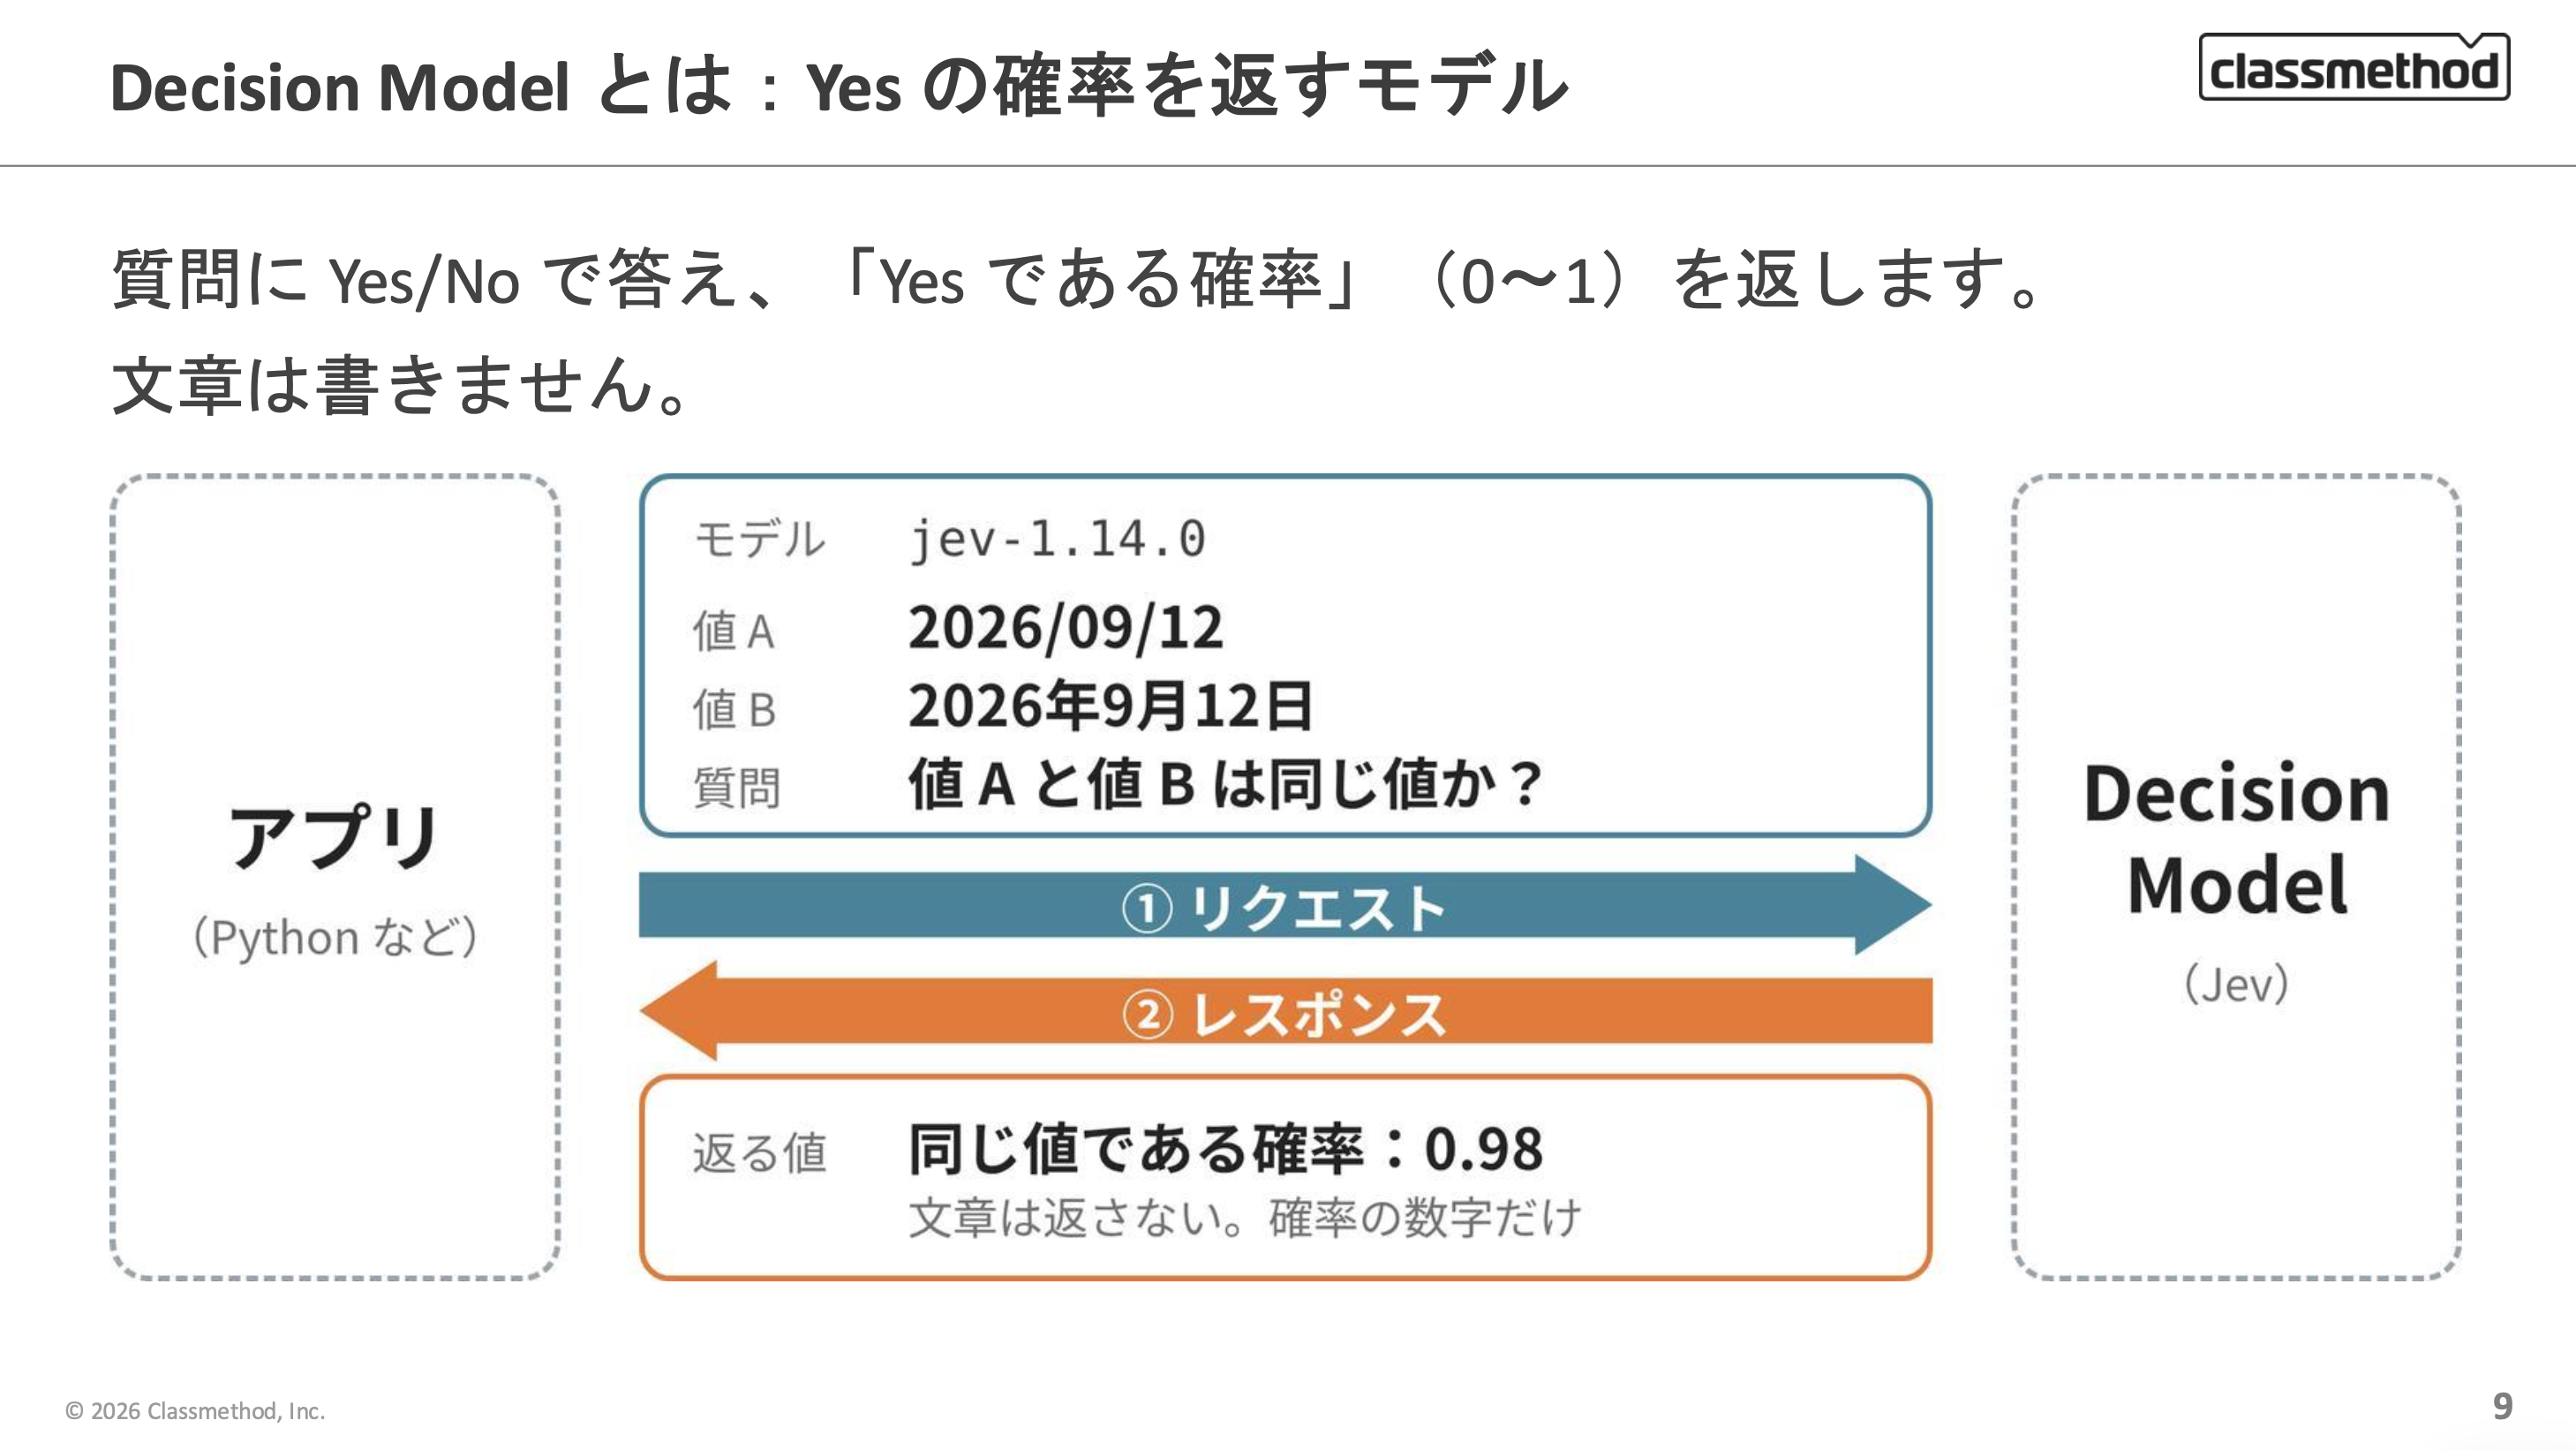
コードにすると、これくらいの量で書けます。
TypeSafe の Jev に、2つの値が同じかどうかを聞く例です。
import os, requests
KEY = os.environ["TYPESAFE_API_KEY"]

def ask(a, b):  # 2 つの値が「同じ」である確率を返す
    res = requests.post(
        "https://api.typesafe.ai/v1/systemone",
        headers={"Authorization": f"Bearer {KEY}"},
        json={"model": "jev-1.14.0",                  # バージョンを固定
              "state": {"value_a": a, "value_b": b},  # 比べる 2 つの値
              "questions": {"same": {"type": "noul",  # Yes の確率で答える
                  "instructions": "Is value_a the same value as value_b?"}}})
    return res.json()["answers"]["same"]["noul"]

print(ask("2026/09/12", "2026年9月12日"))  # → 0.98(同じ値である確率)
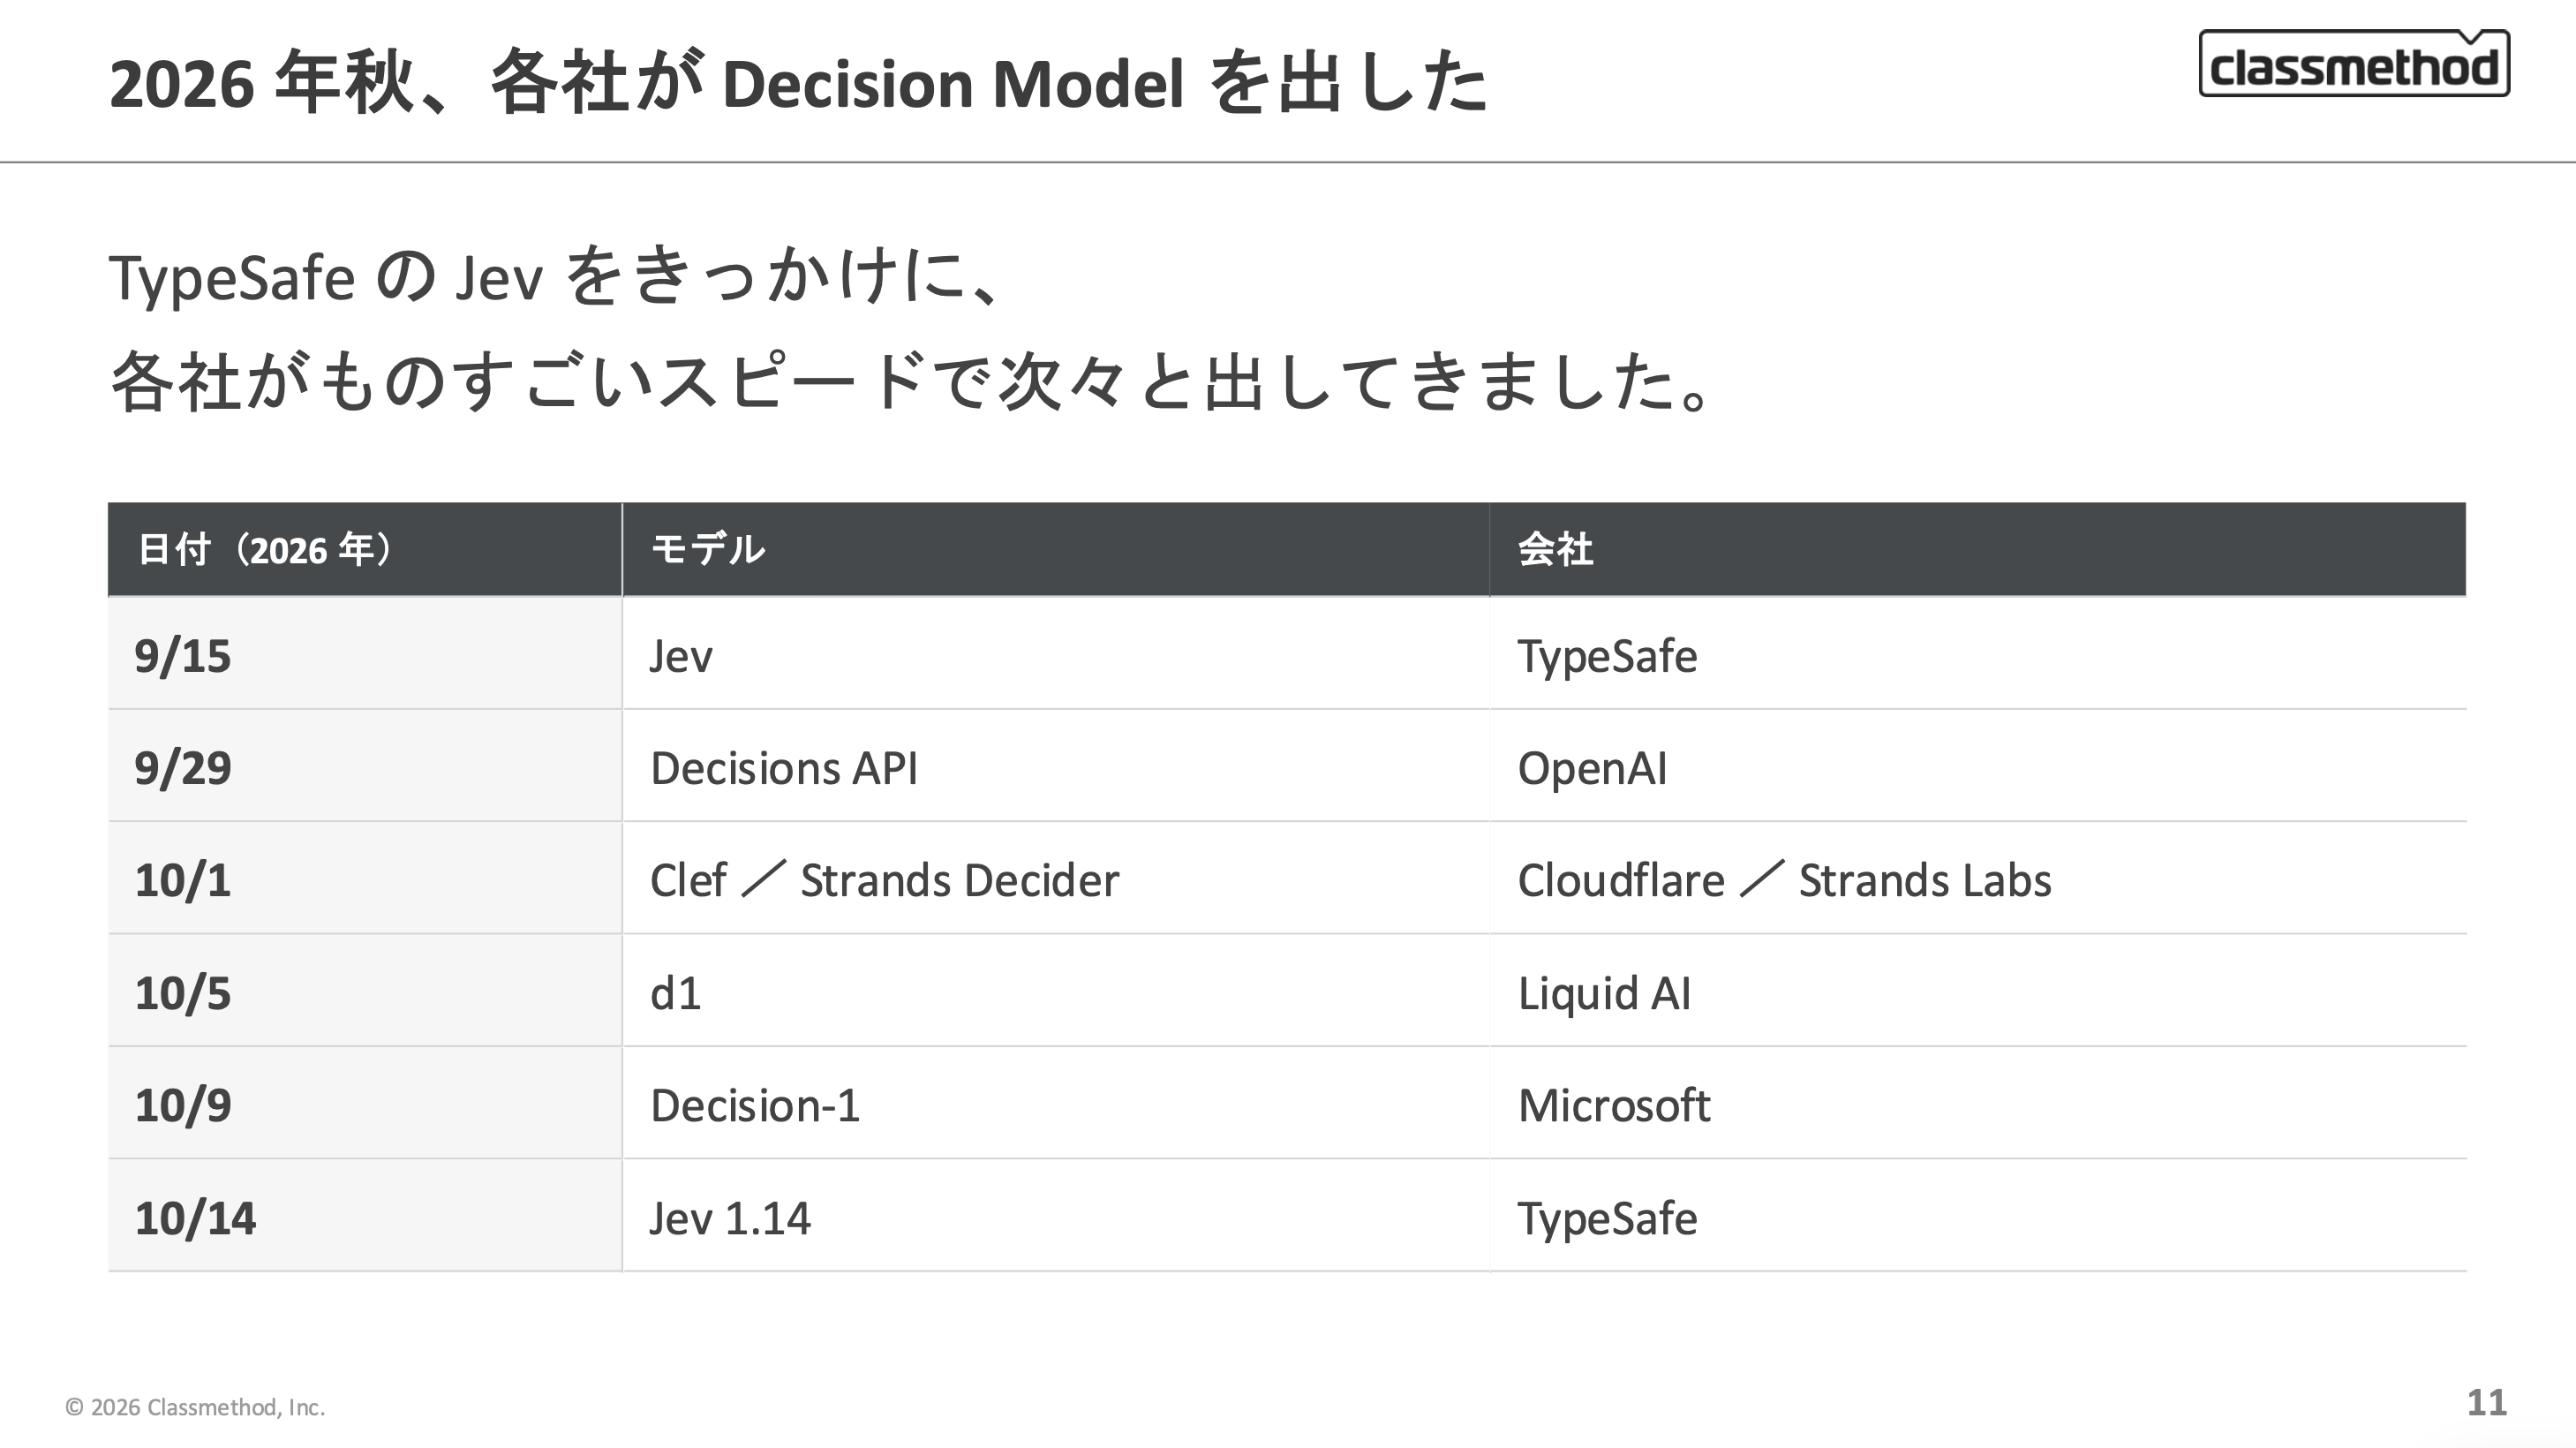
4.2 2026年秋、各社が Decision Model を出した
TypeSafe の Jev をきっかけに、各社が次々と Decision Model を出しました。
4.3 特徴とできること
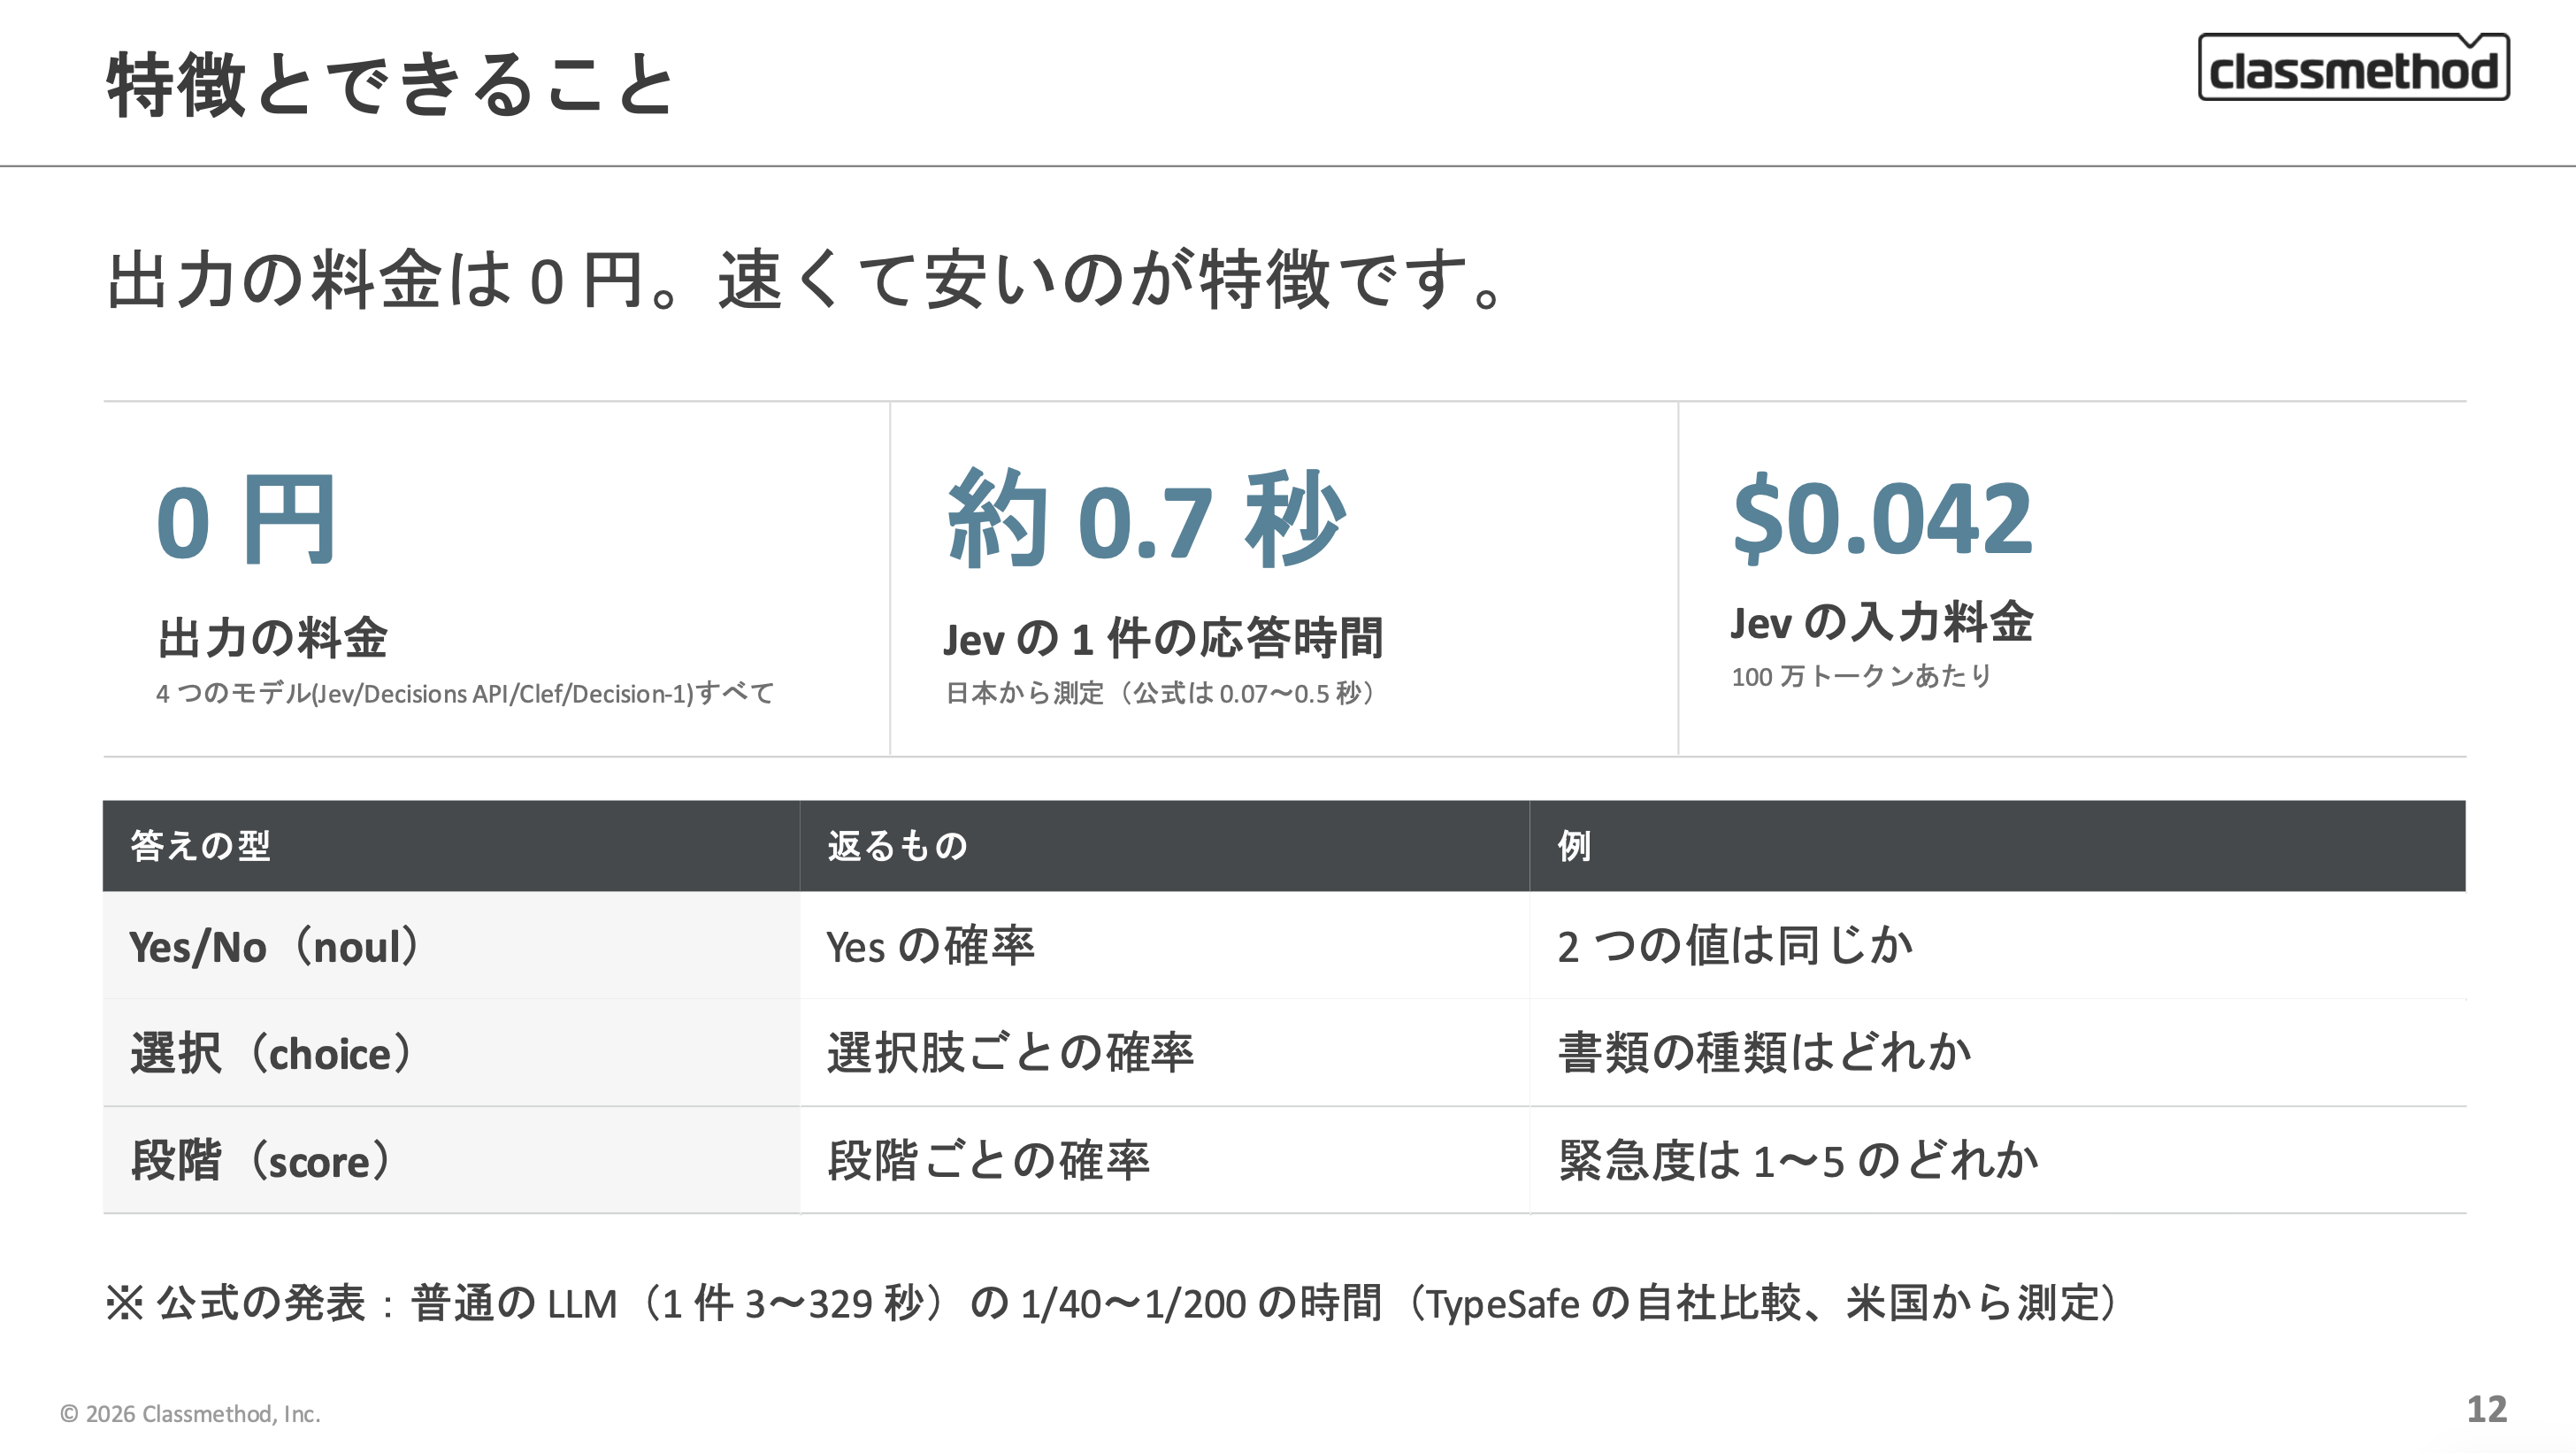
出力の料金は 0 円で、速くて安いのが特徴です。
返せる答えの型には、Yes/No(noul)、選択(choice)、段階(score)の3つがあります。
当日は、4つのモデル(Jev・Decisions API・Clef・Decision-1)がどのサービスから使えて、どのリージョンで処理されるかも紹介しました。
日本だけで処理できると公式に書いてある経路はありません。
詳しくは Speaker Deck の13枚目を参照してください。
5. 具体例:2つの値が同じ意味かを Jev に聞く
5.1 確率を見る
2枚の書類から取った値の組を 107 件用意し、「書き方が違っても同じ値か」を Jev に聞きました。
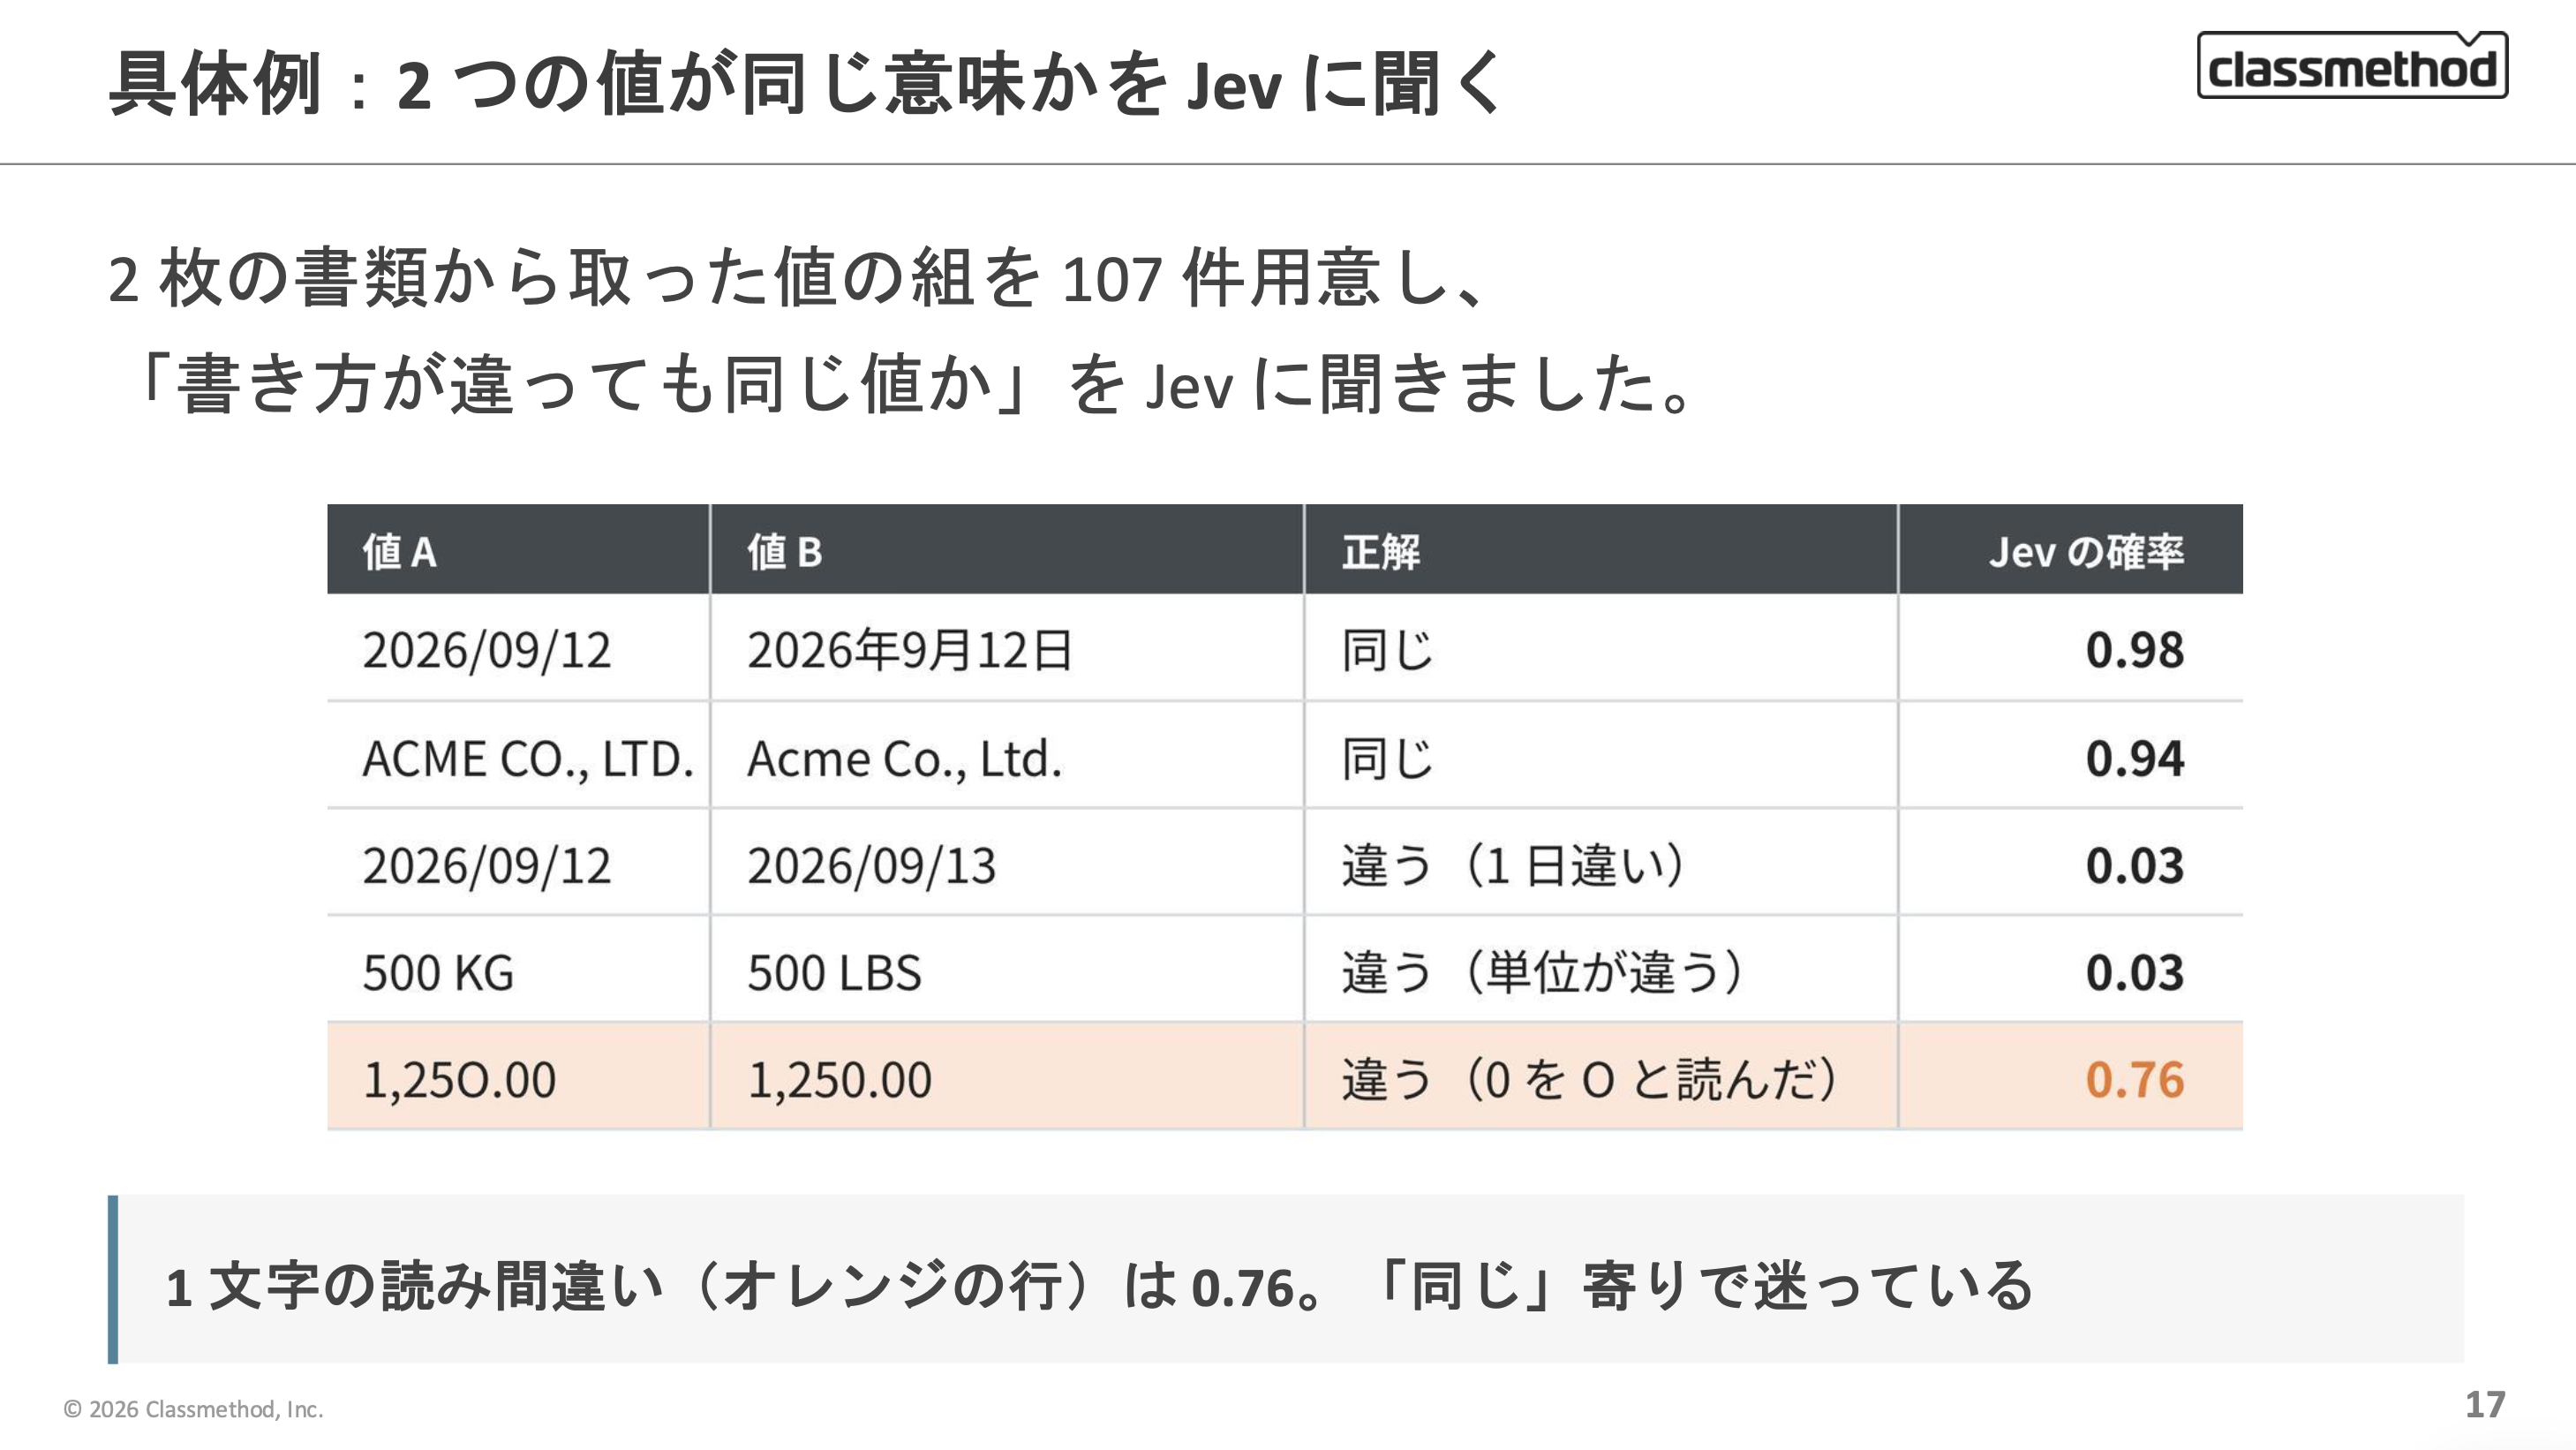
日付の書き方の違いや会社名の大文字・小文字は「同じ」、1日違いや単位違いは「違う」とはっきり答えています。
一方で、1文字の読み間違い(オレンジの行)は 0.76 で、「同じ」寄りではあるものの迷っています。
5.2 閾値で振り分ける
確率が 0.8 以上なら「同じ」、0.2 以下なら「違う」とし、その間の迷っているものだけを人が判断します。
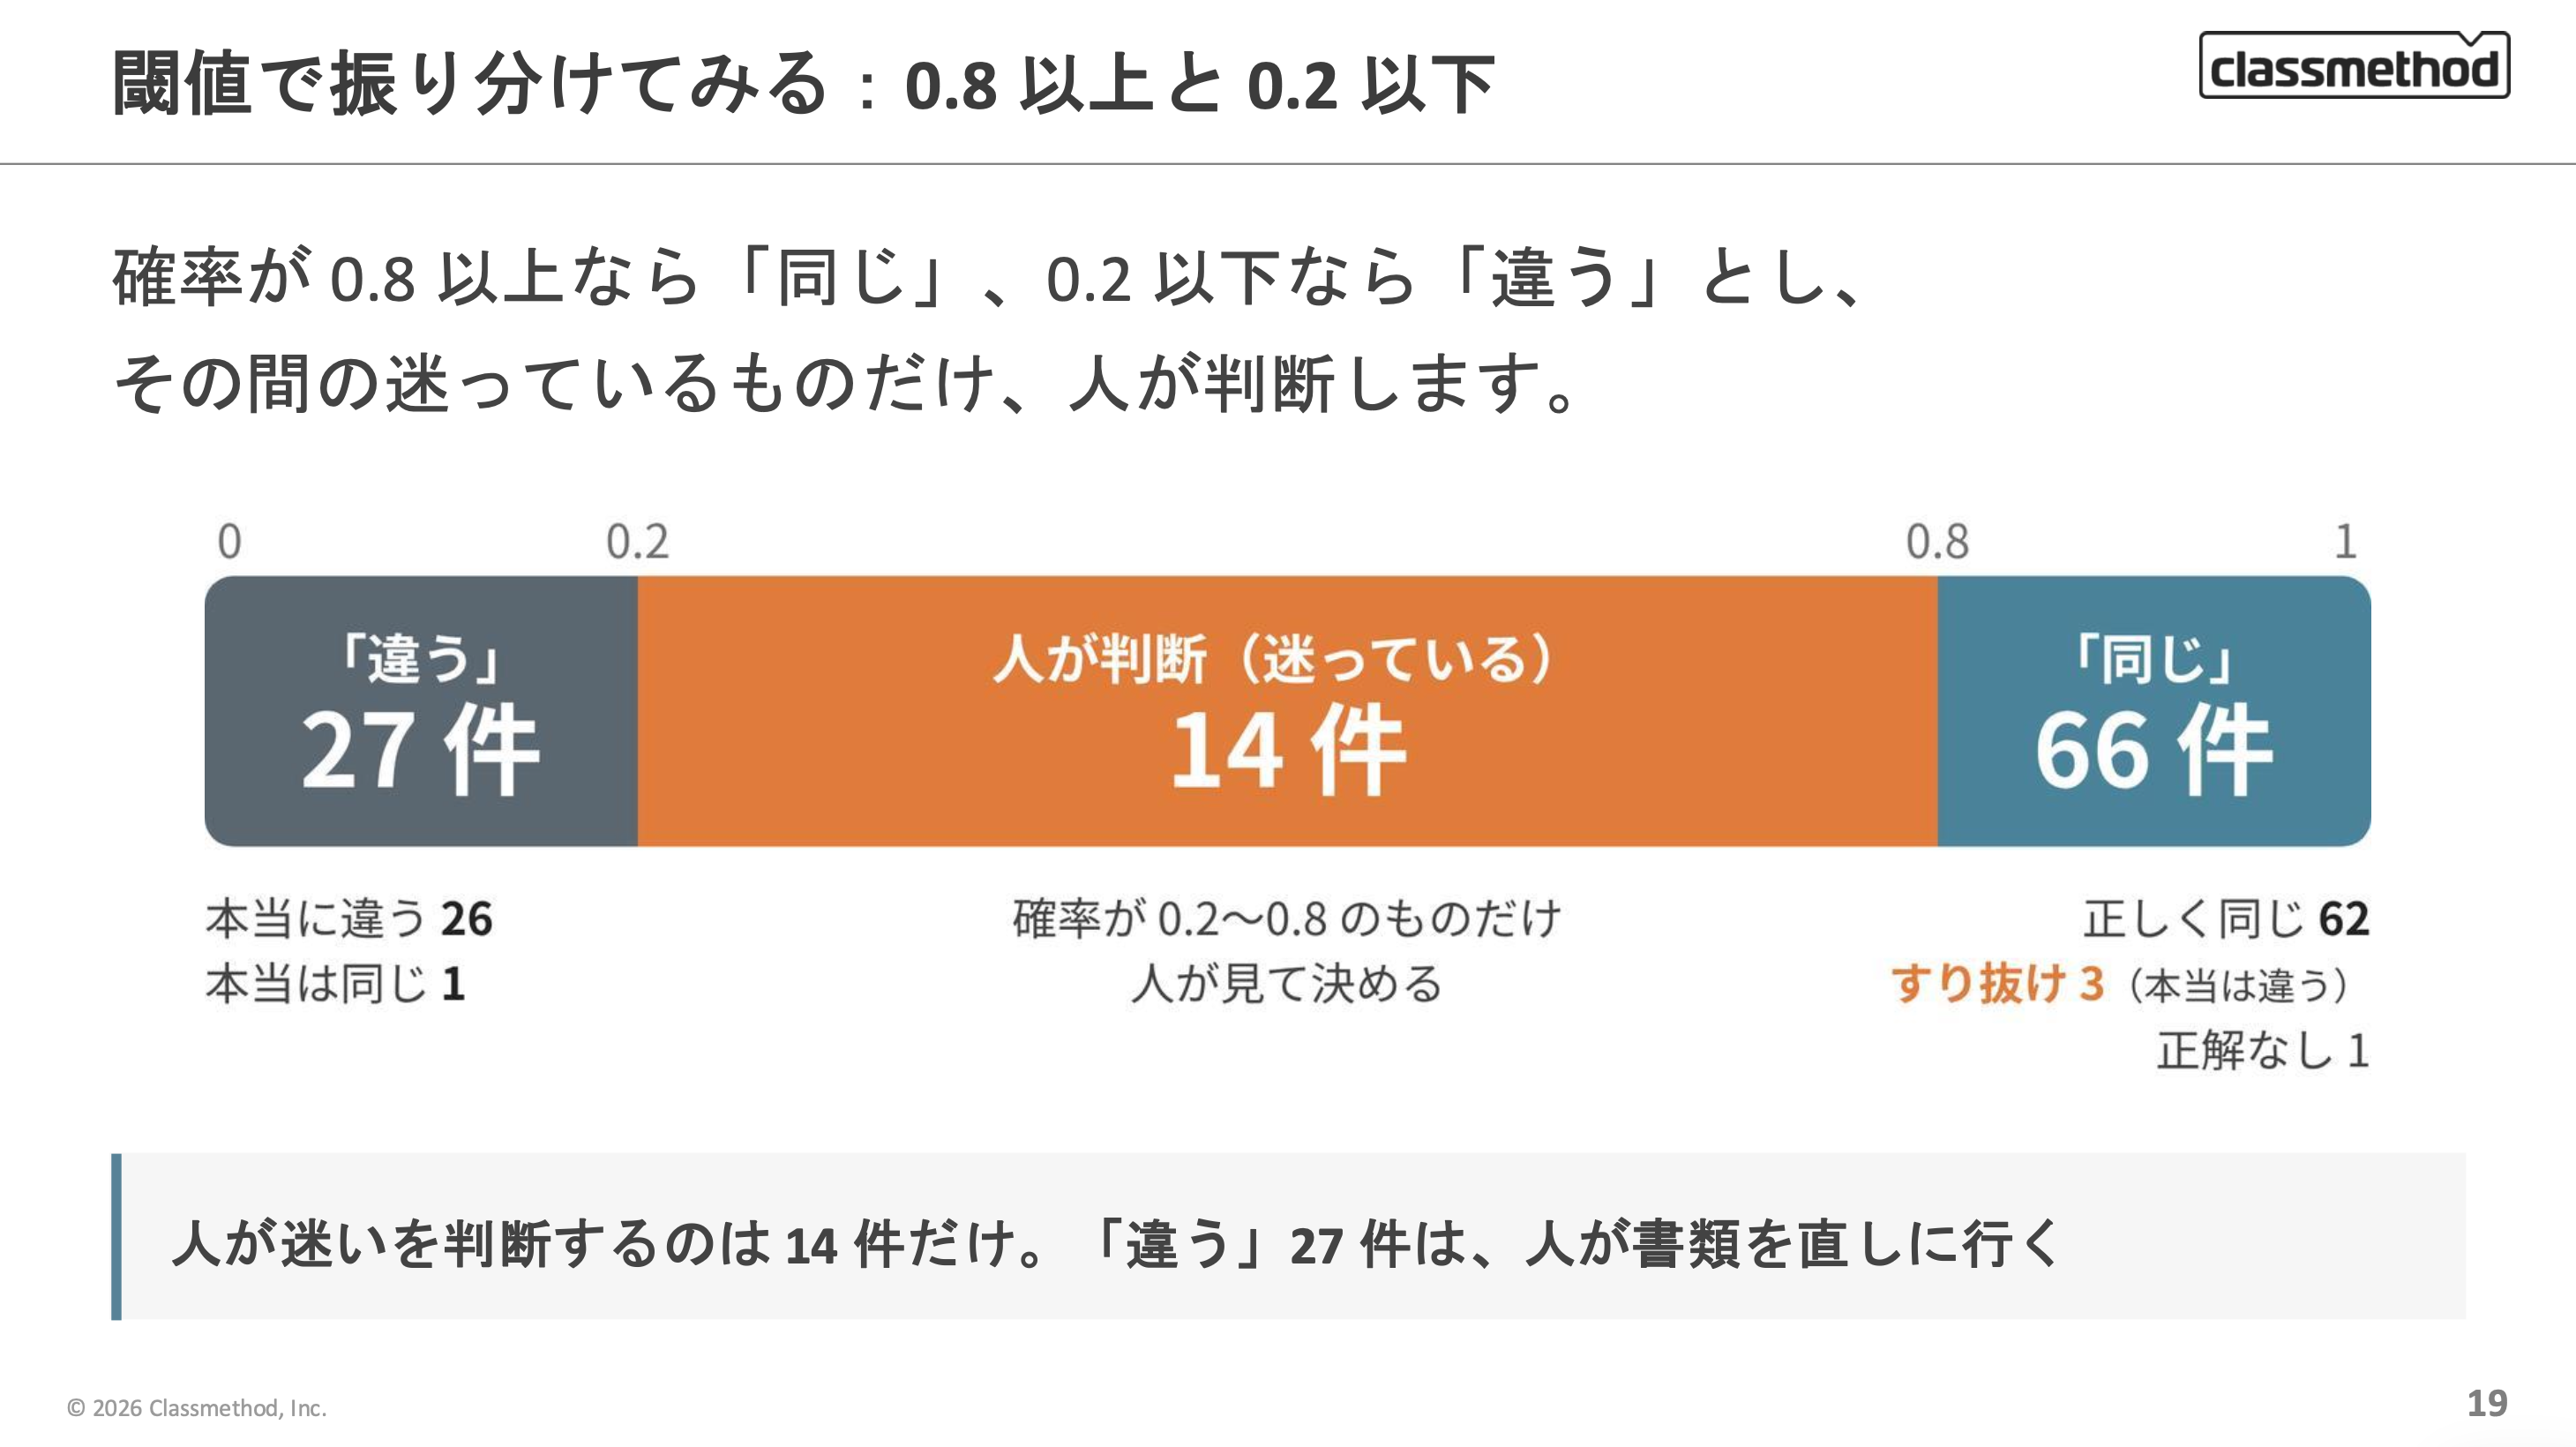
人が迷いを判断するのは 14 件だけで済みます。
「違う」と判定された 27 件は、人が書類を直しに行きます。
6. 普通の LLM に同じことをさせると
6.1 料金と速さ
同じ 107 件を Gemini 3.8 Flash にも解かせてみました。
Jev の費用は約 19 分の 1、応答時間は半分以下でした。
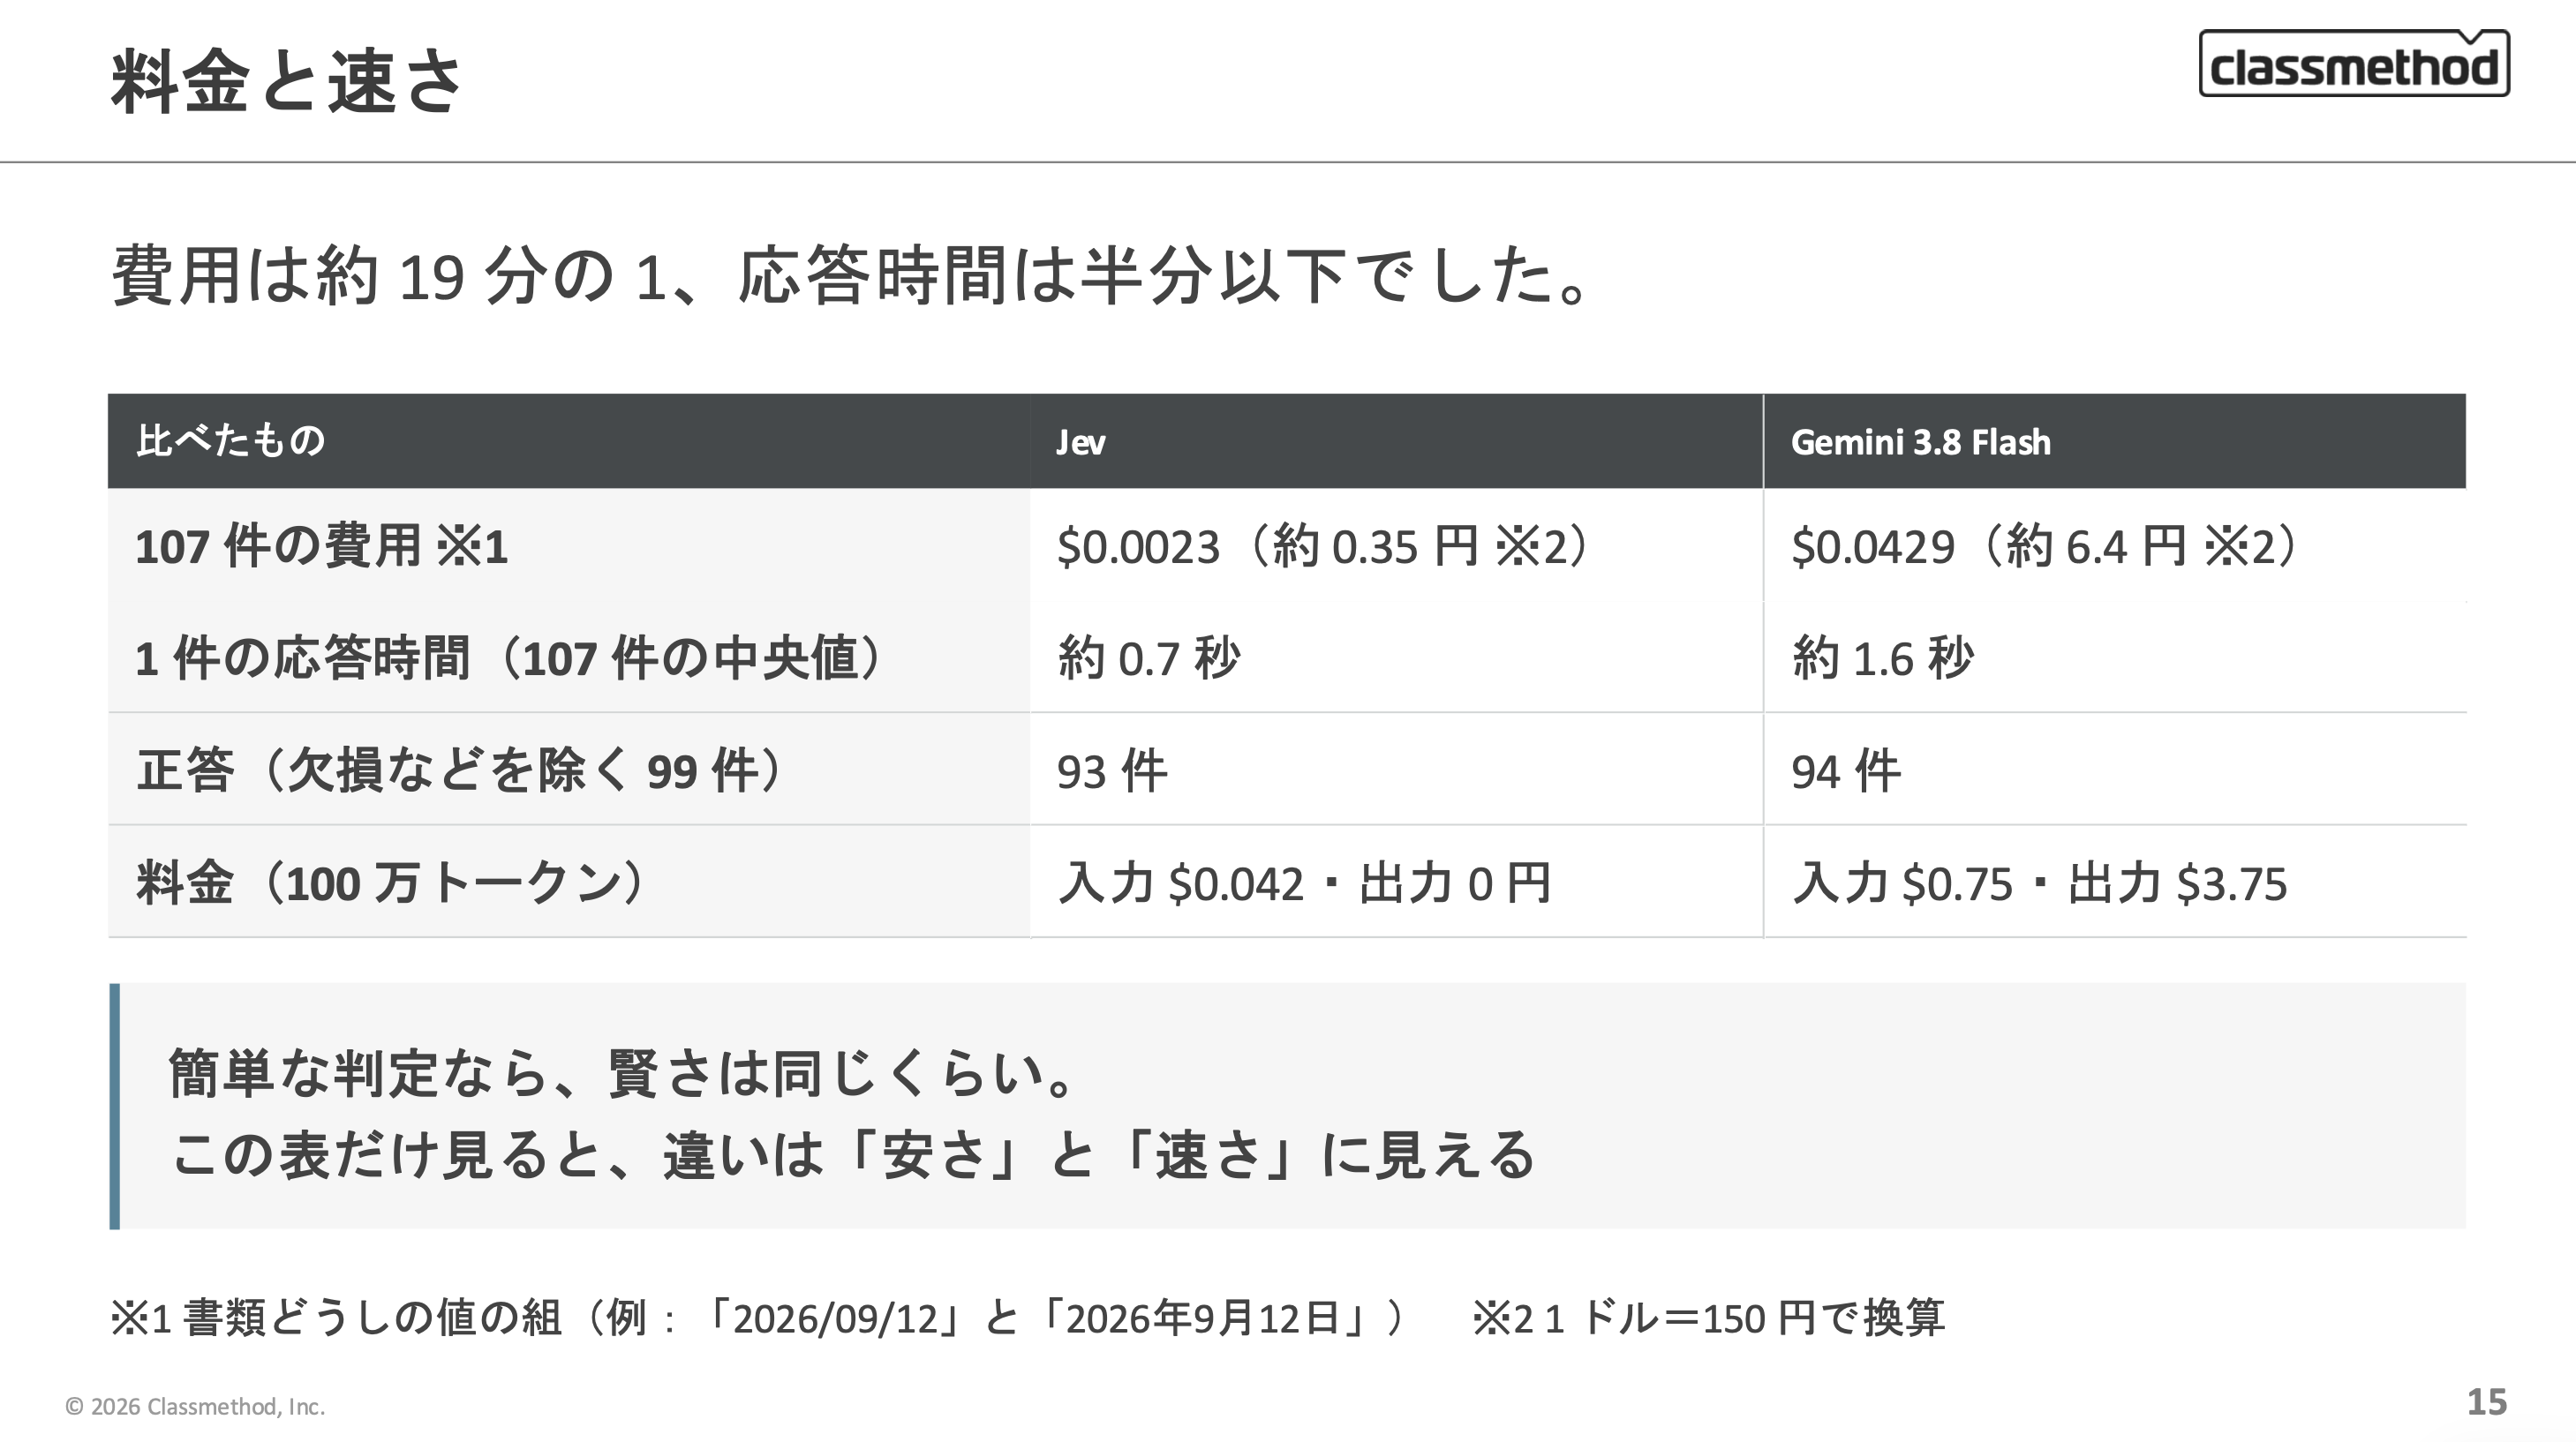
正答は 93 件と 94 件で、簡単な判定なら賢さは同じくらいです。
この表だけ見ると、違いは「安さ」と「速さ」に見えます。
6.2 確率の出方
本当の違いは確率の出方にあります。
「同じ値である確率」を聞くと、Gemini は 0 か 1 しか答えません。
対して Jev は、0.3 や 0.7 のような中間の値も返します。
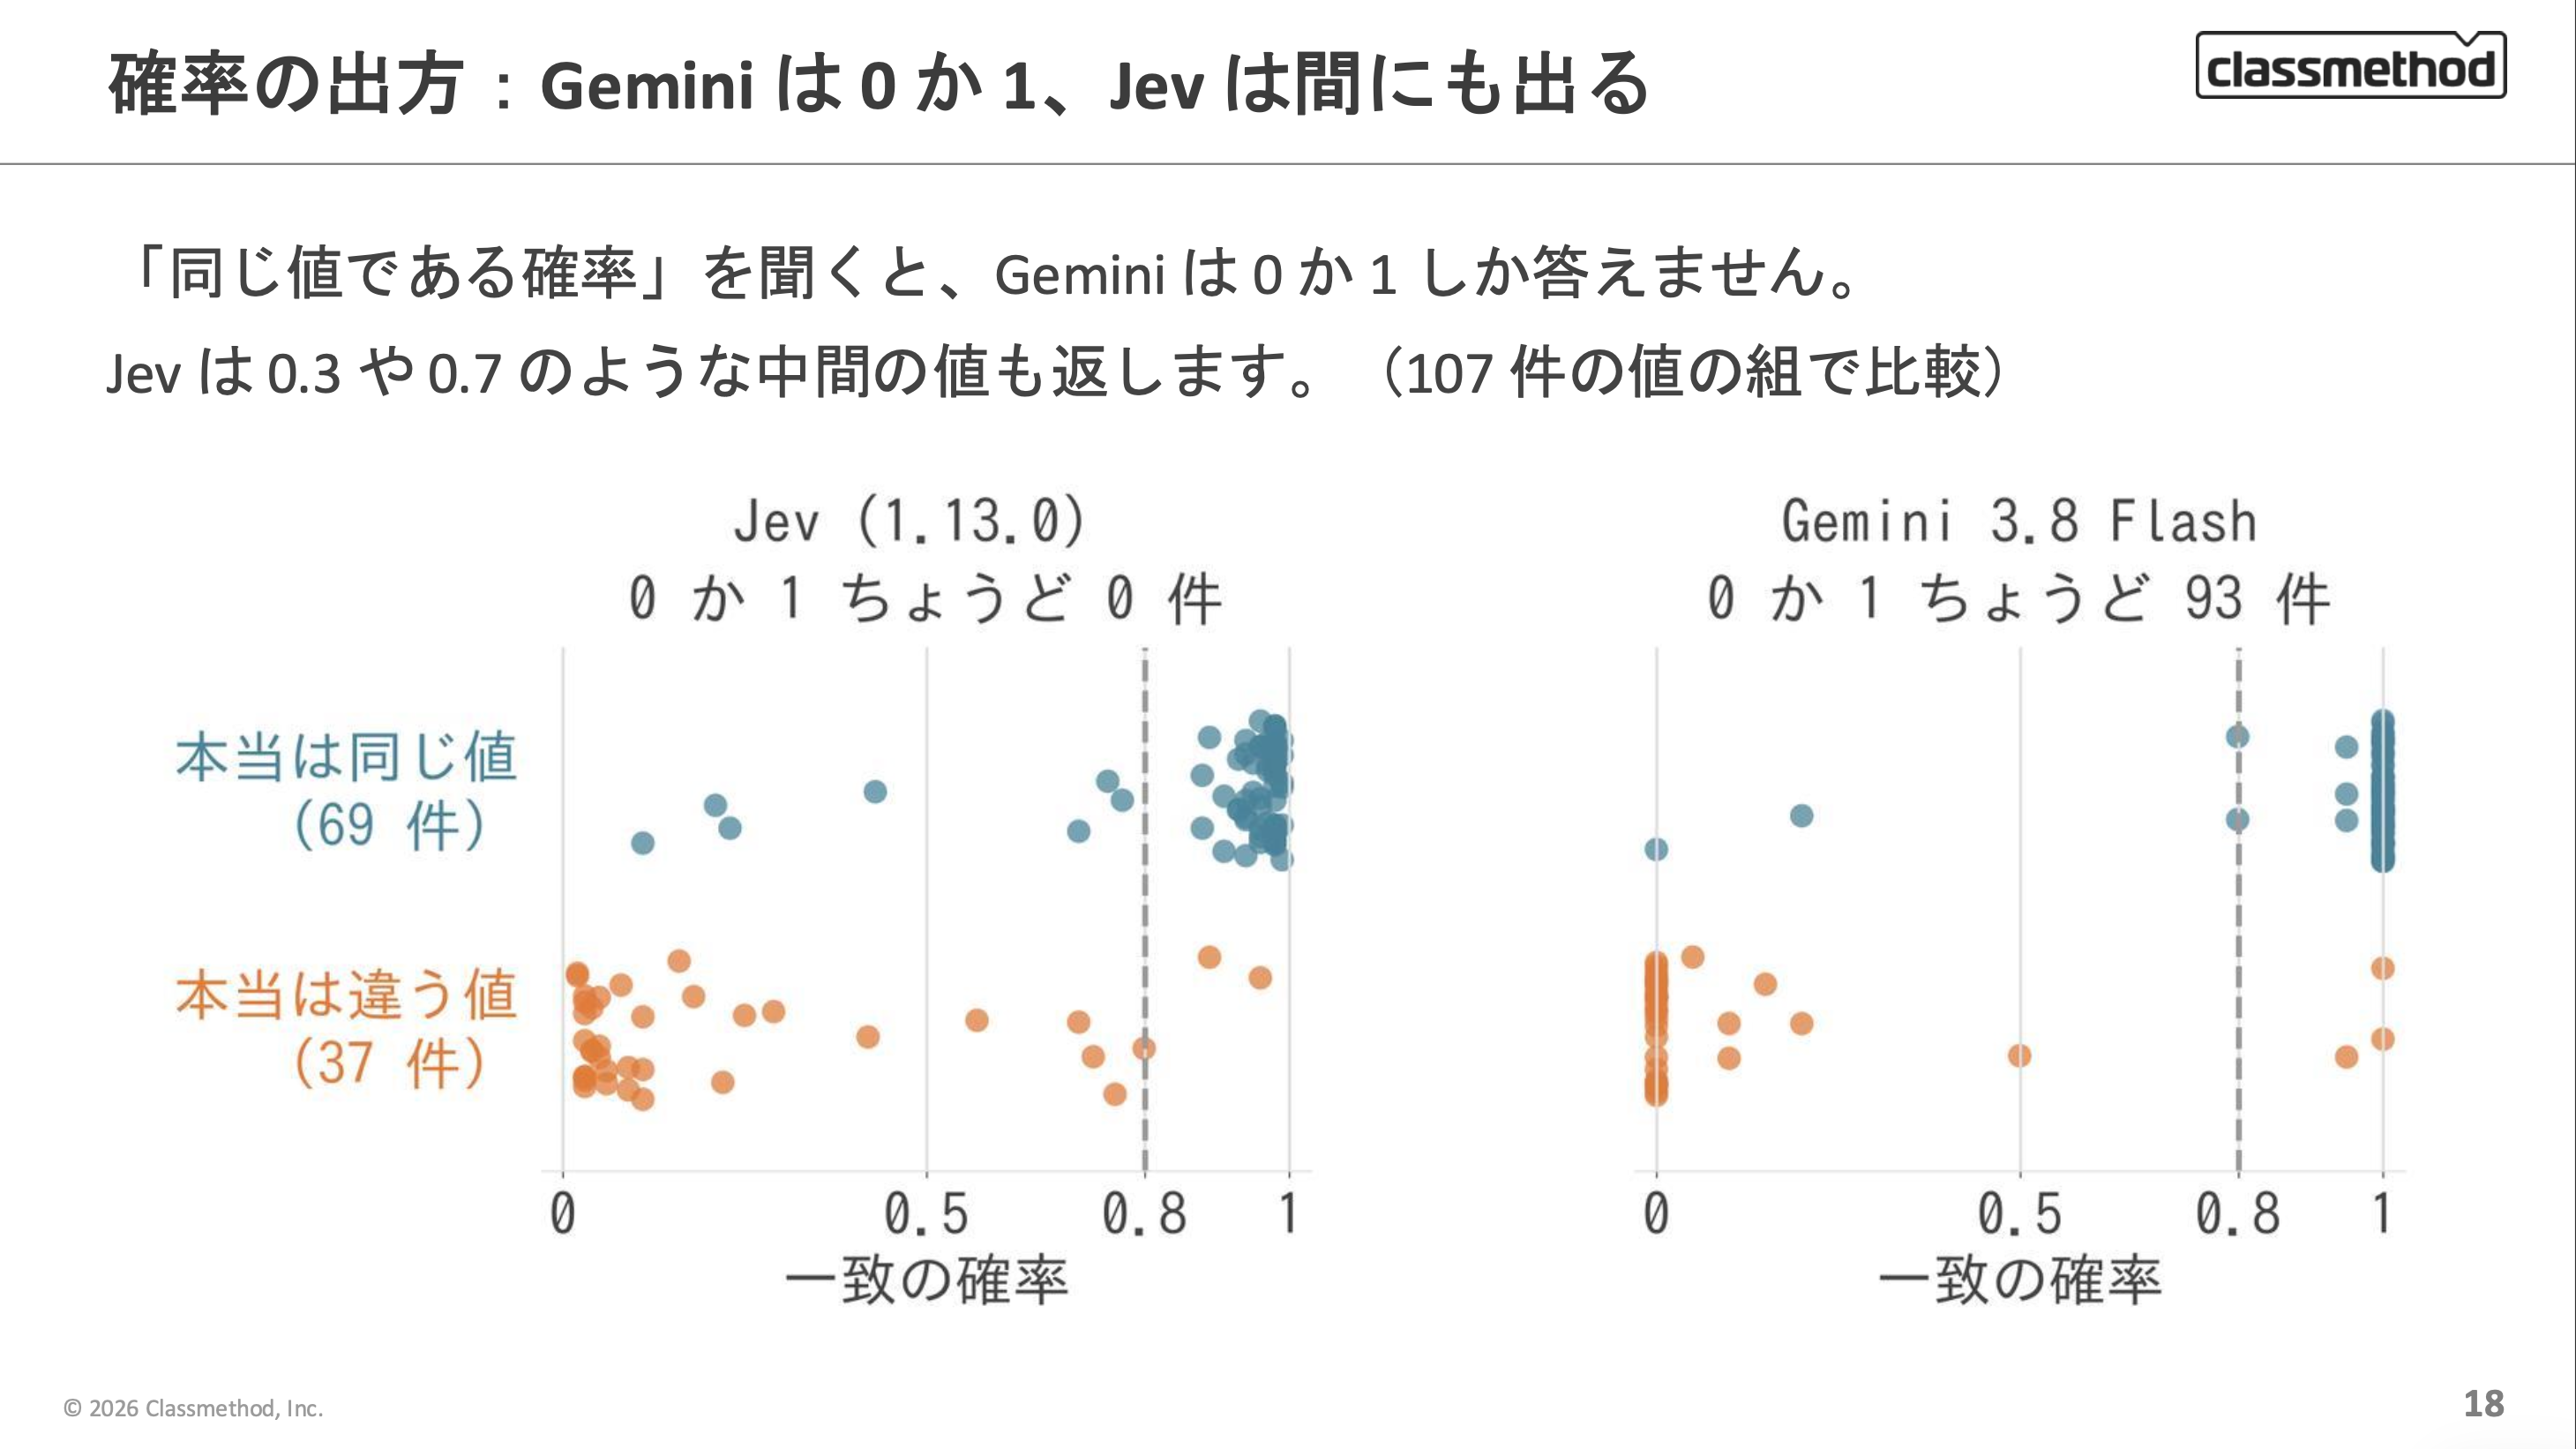
0 か 1 しか返らないと、「迷ったら人間」に回すための閾値を置けません。
7. 閾値をどう決めるか
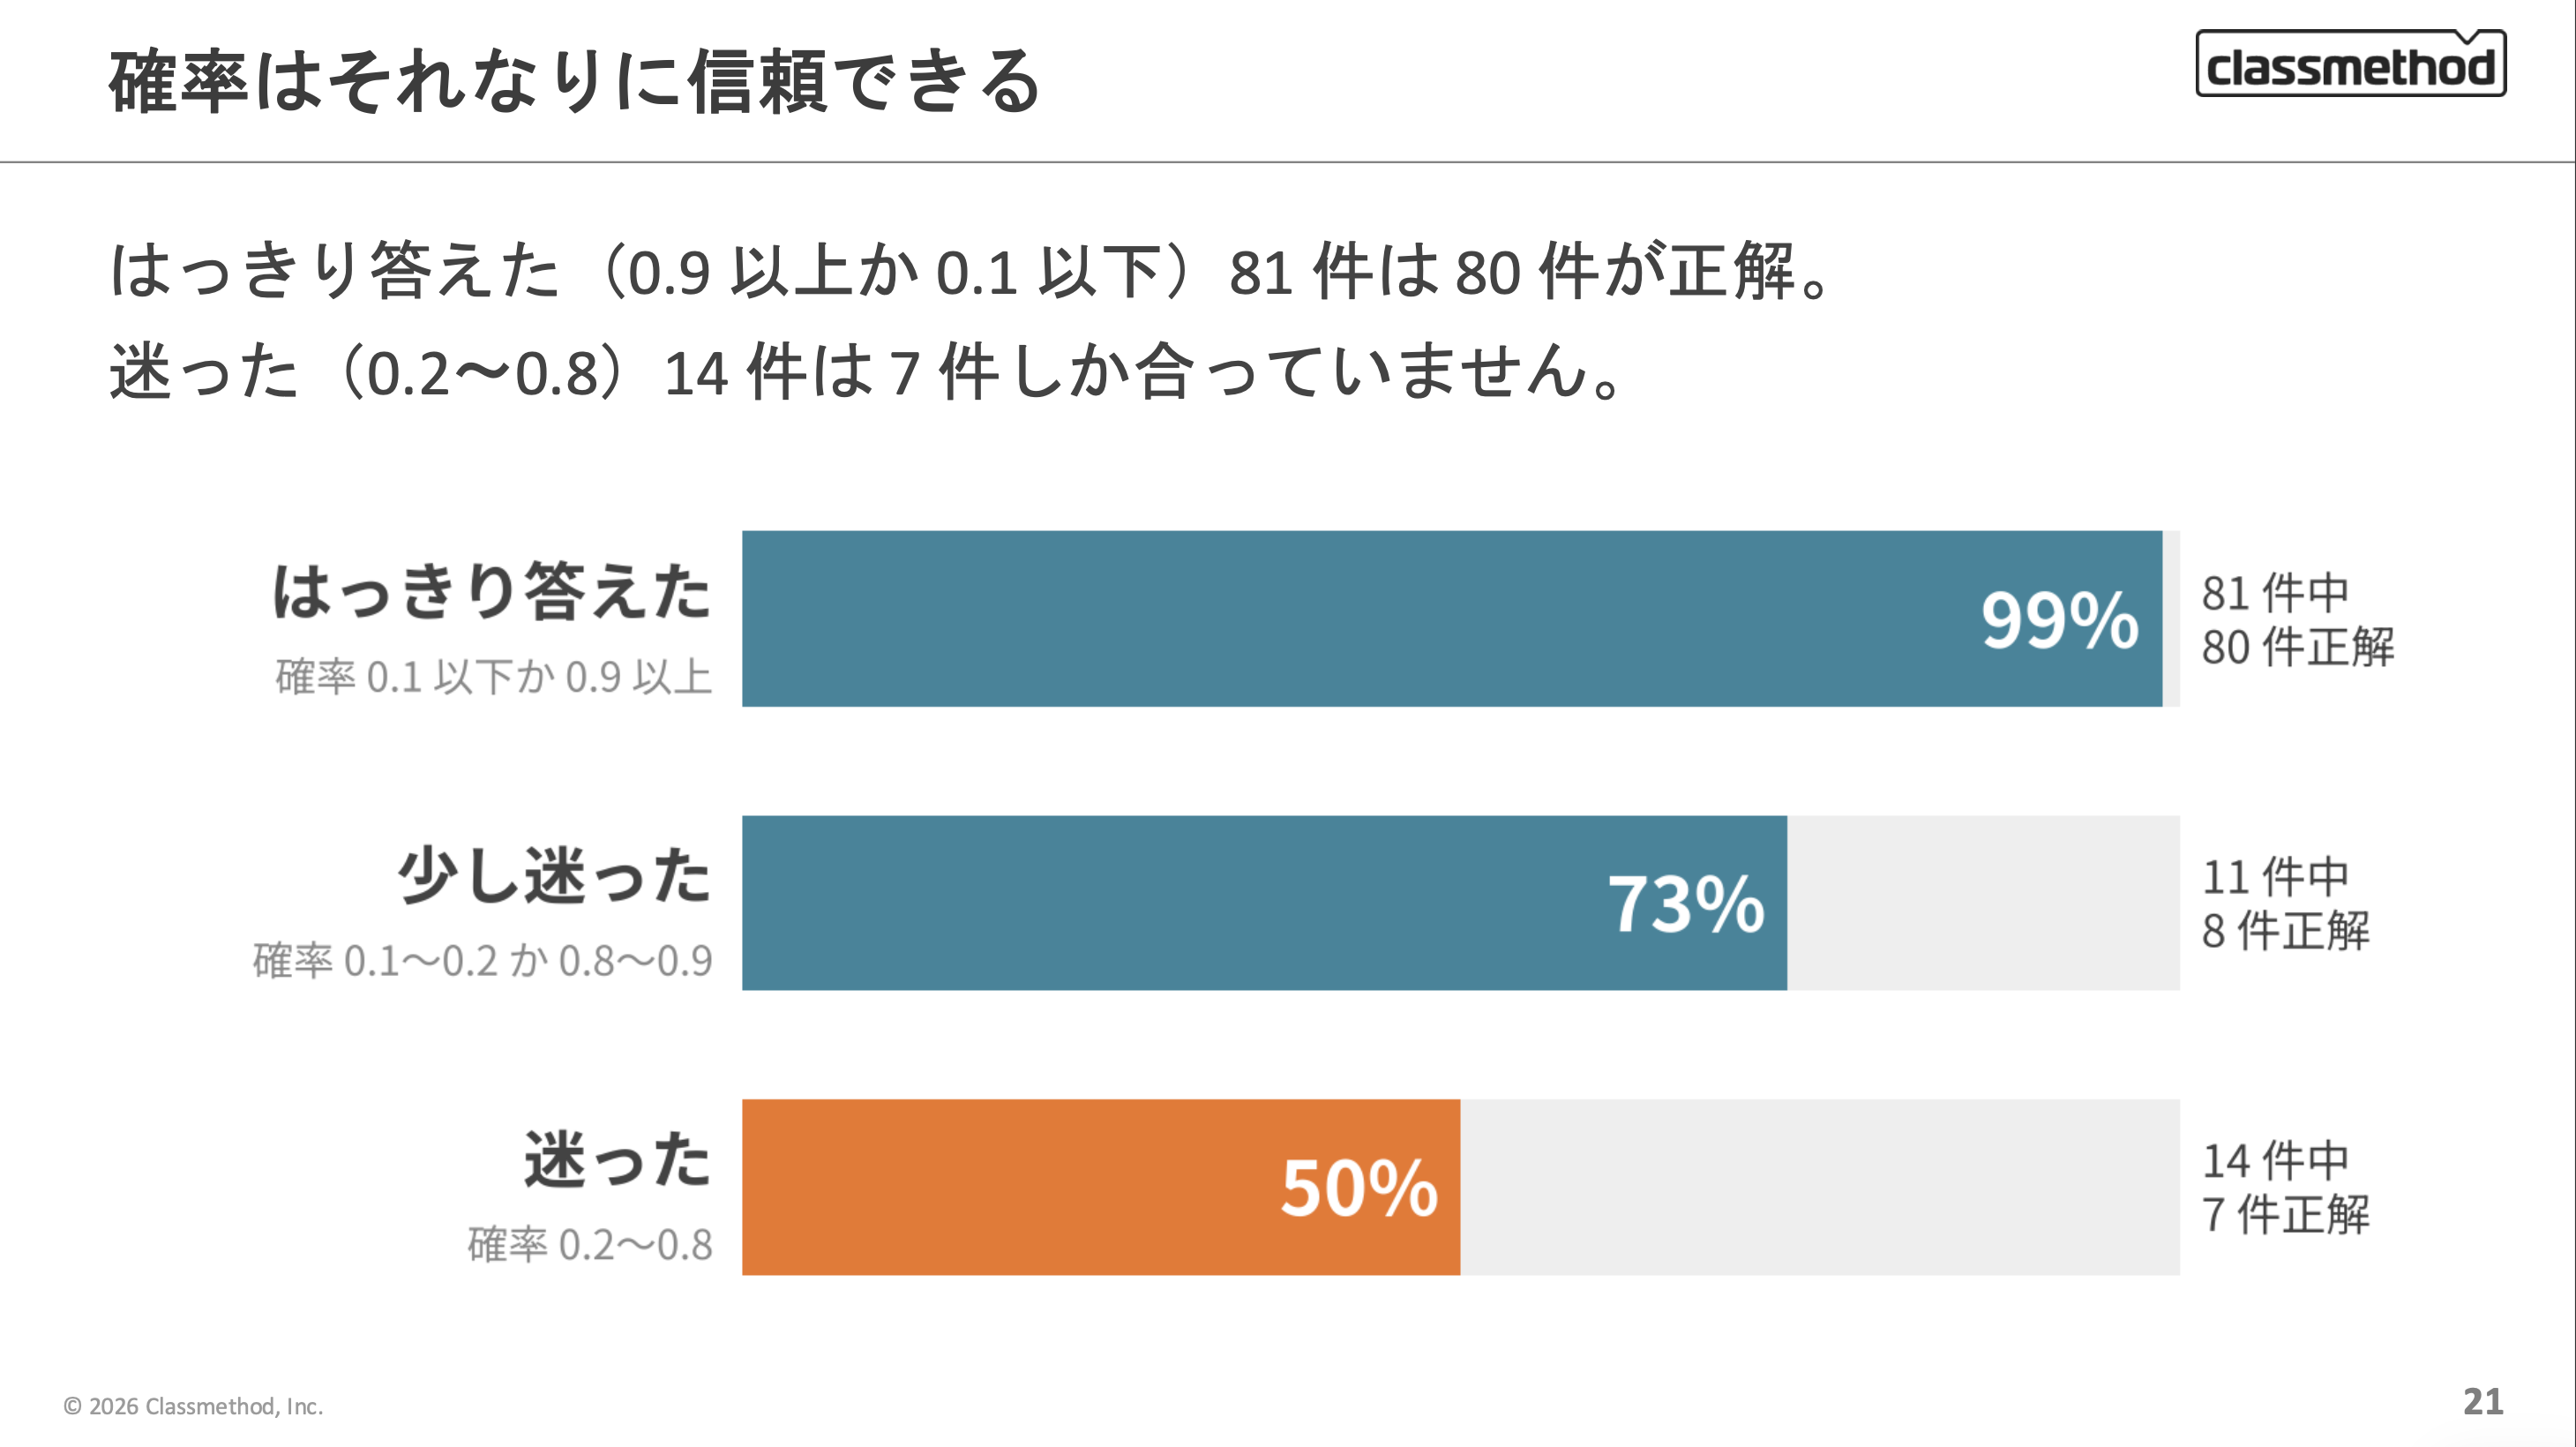
7.1 確率はそれなりに信頼できる
はっきり答えた(0.9 以上か 0.1 以下)81 件は、80 件が正解でした。
迷った(0.2〜0.8)14 件は、7 件しか合っていません。
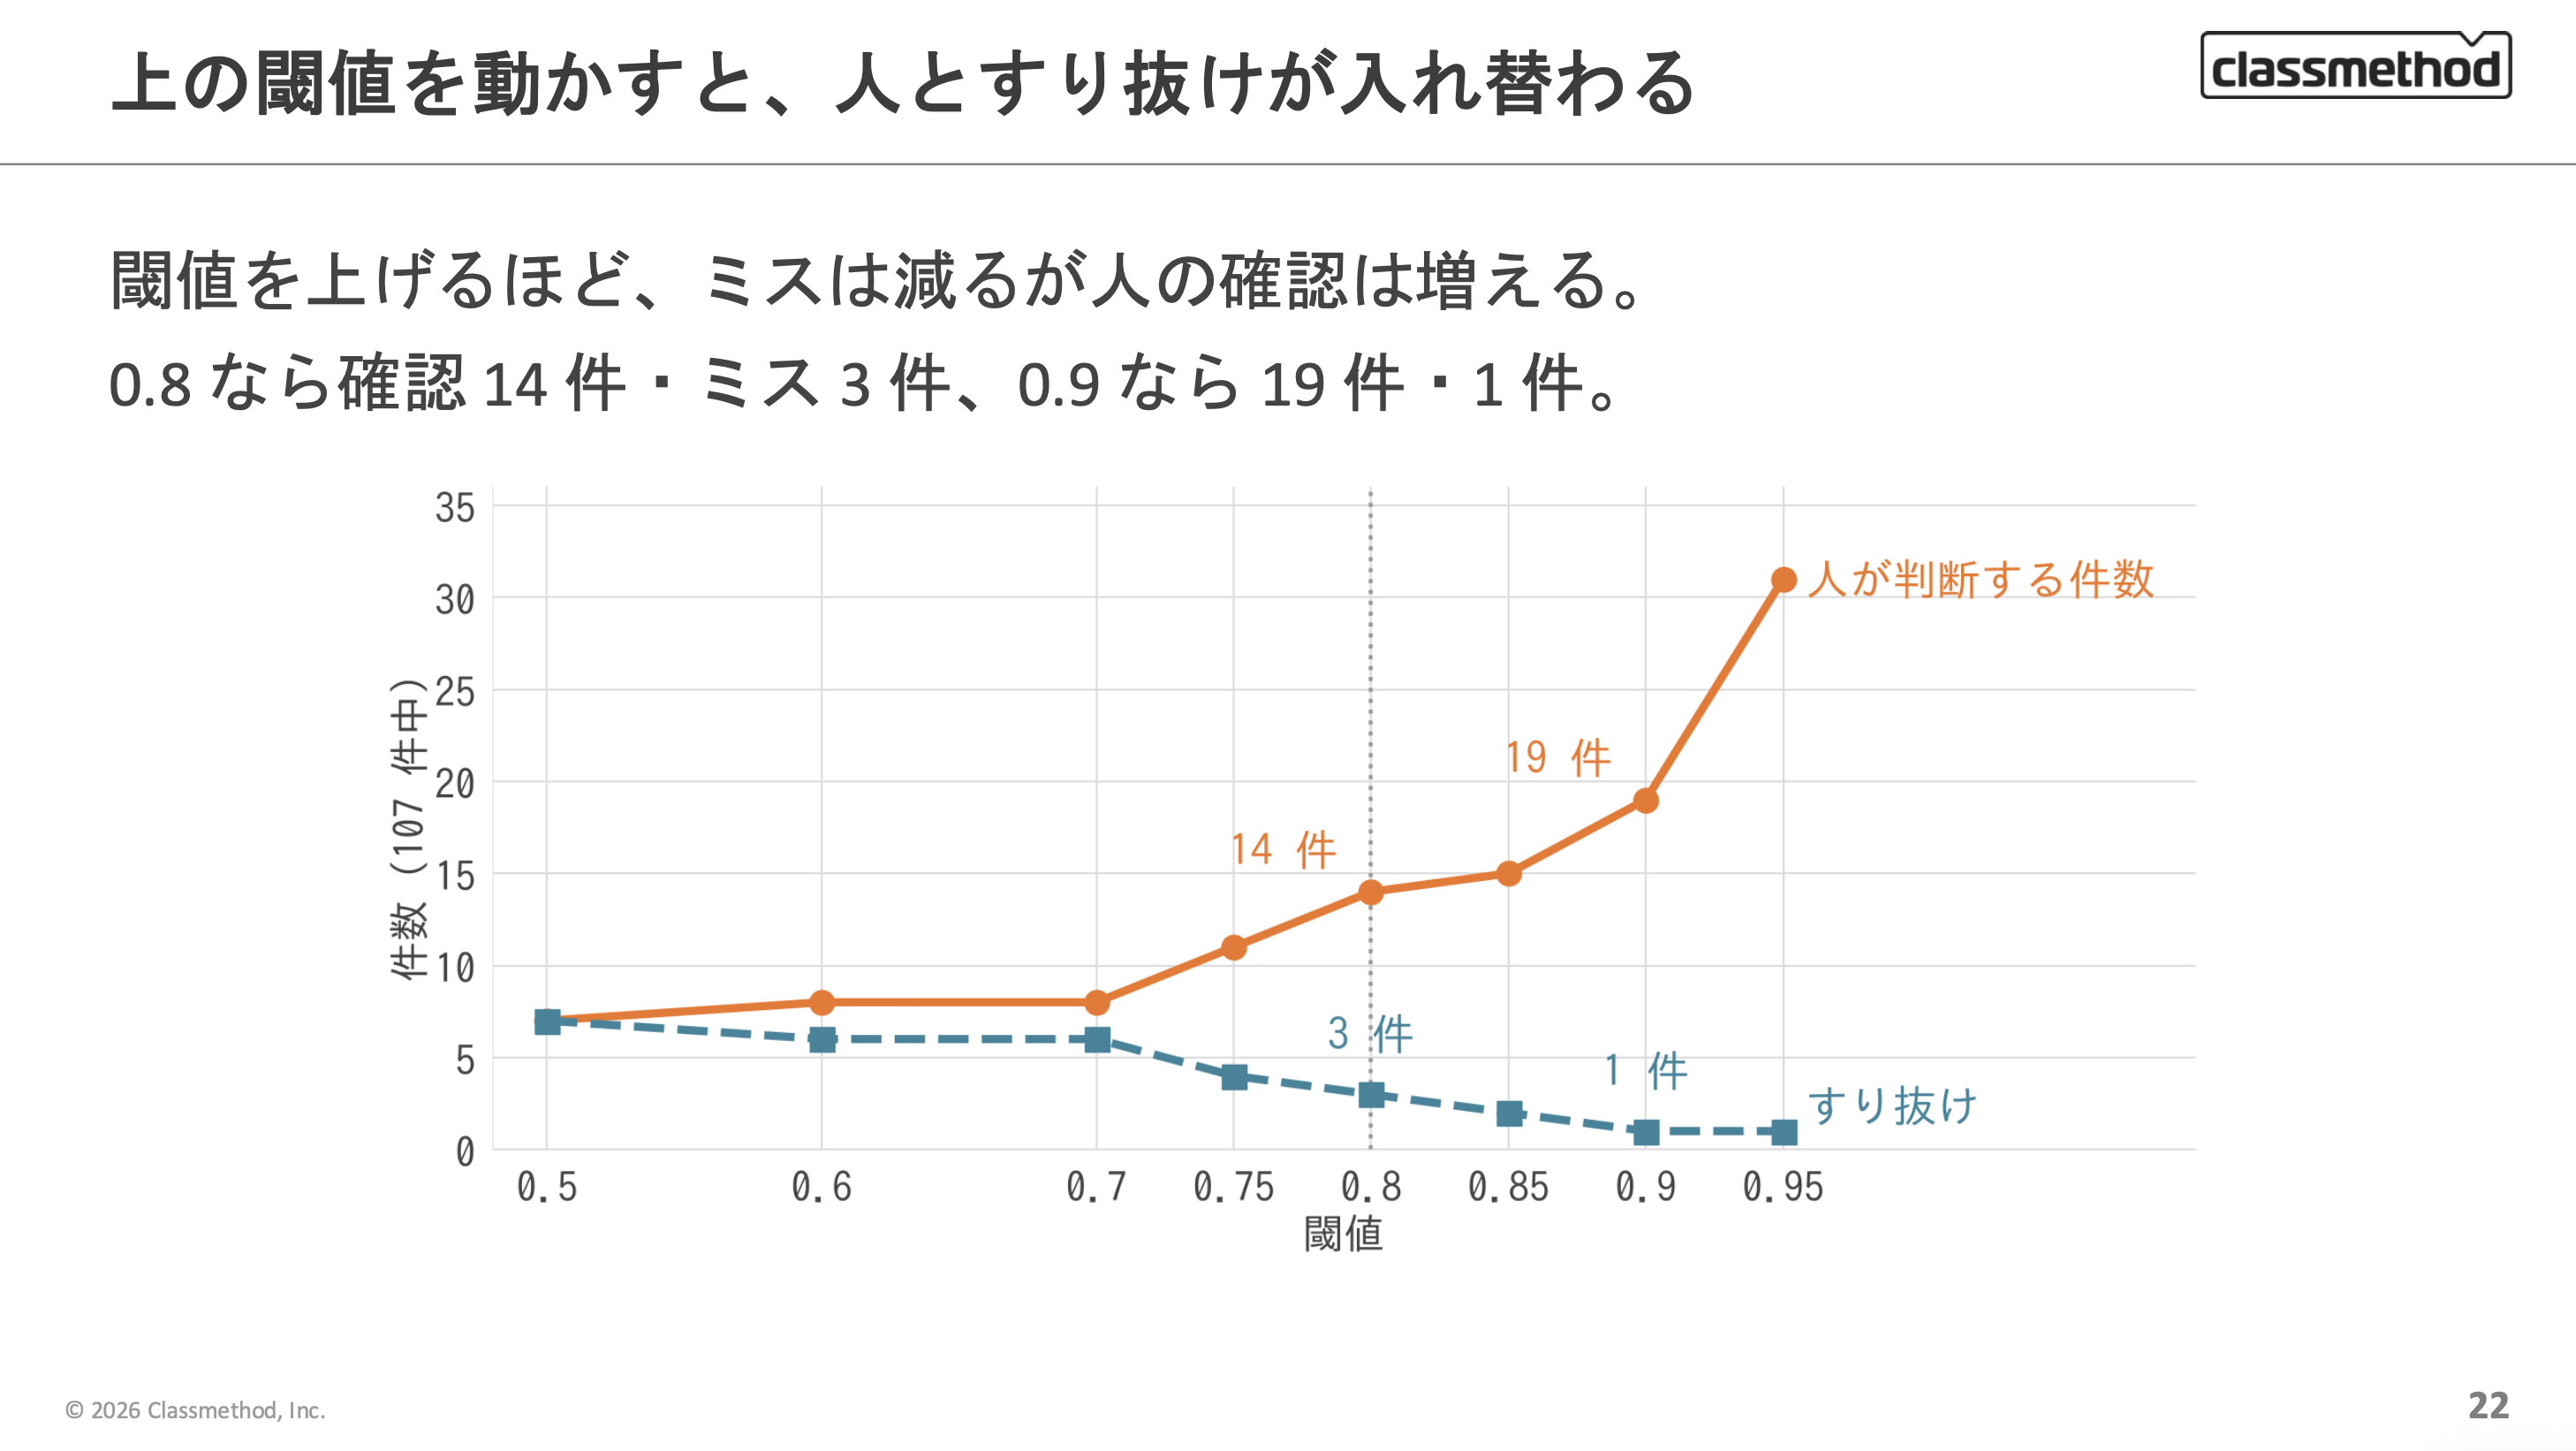
7.2 上の閾値を動かすと、人とすり抜けが入れ替わる
閾値を上げるほどミスは減りますが、そのぶん人の確認は増えます。
0.8 なら確認 14 件・ミス 3 件、0.9 なら確認 19 件・ミス 1 件でした。
7.3 バージョンが変わると確率も動く
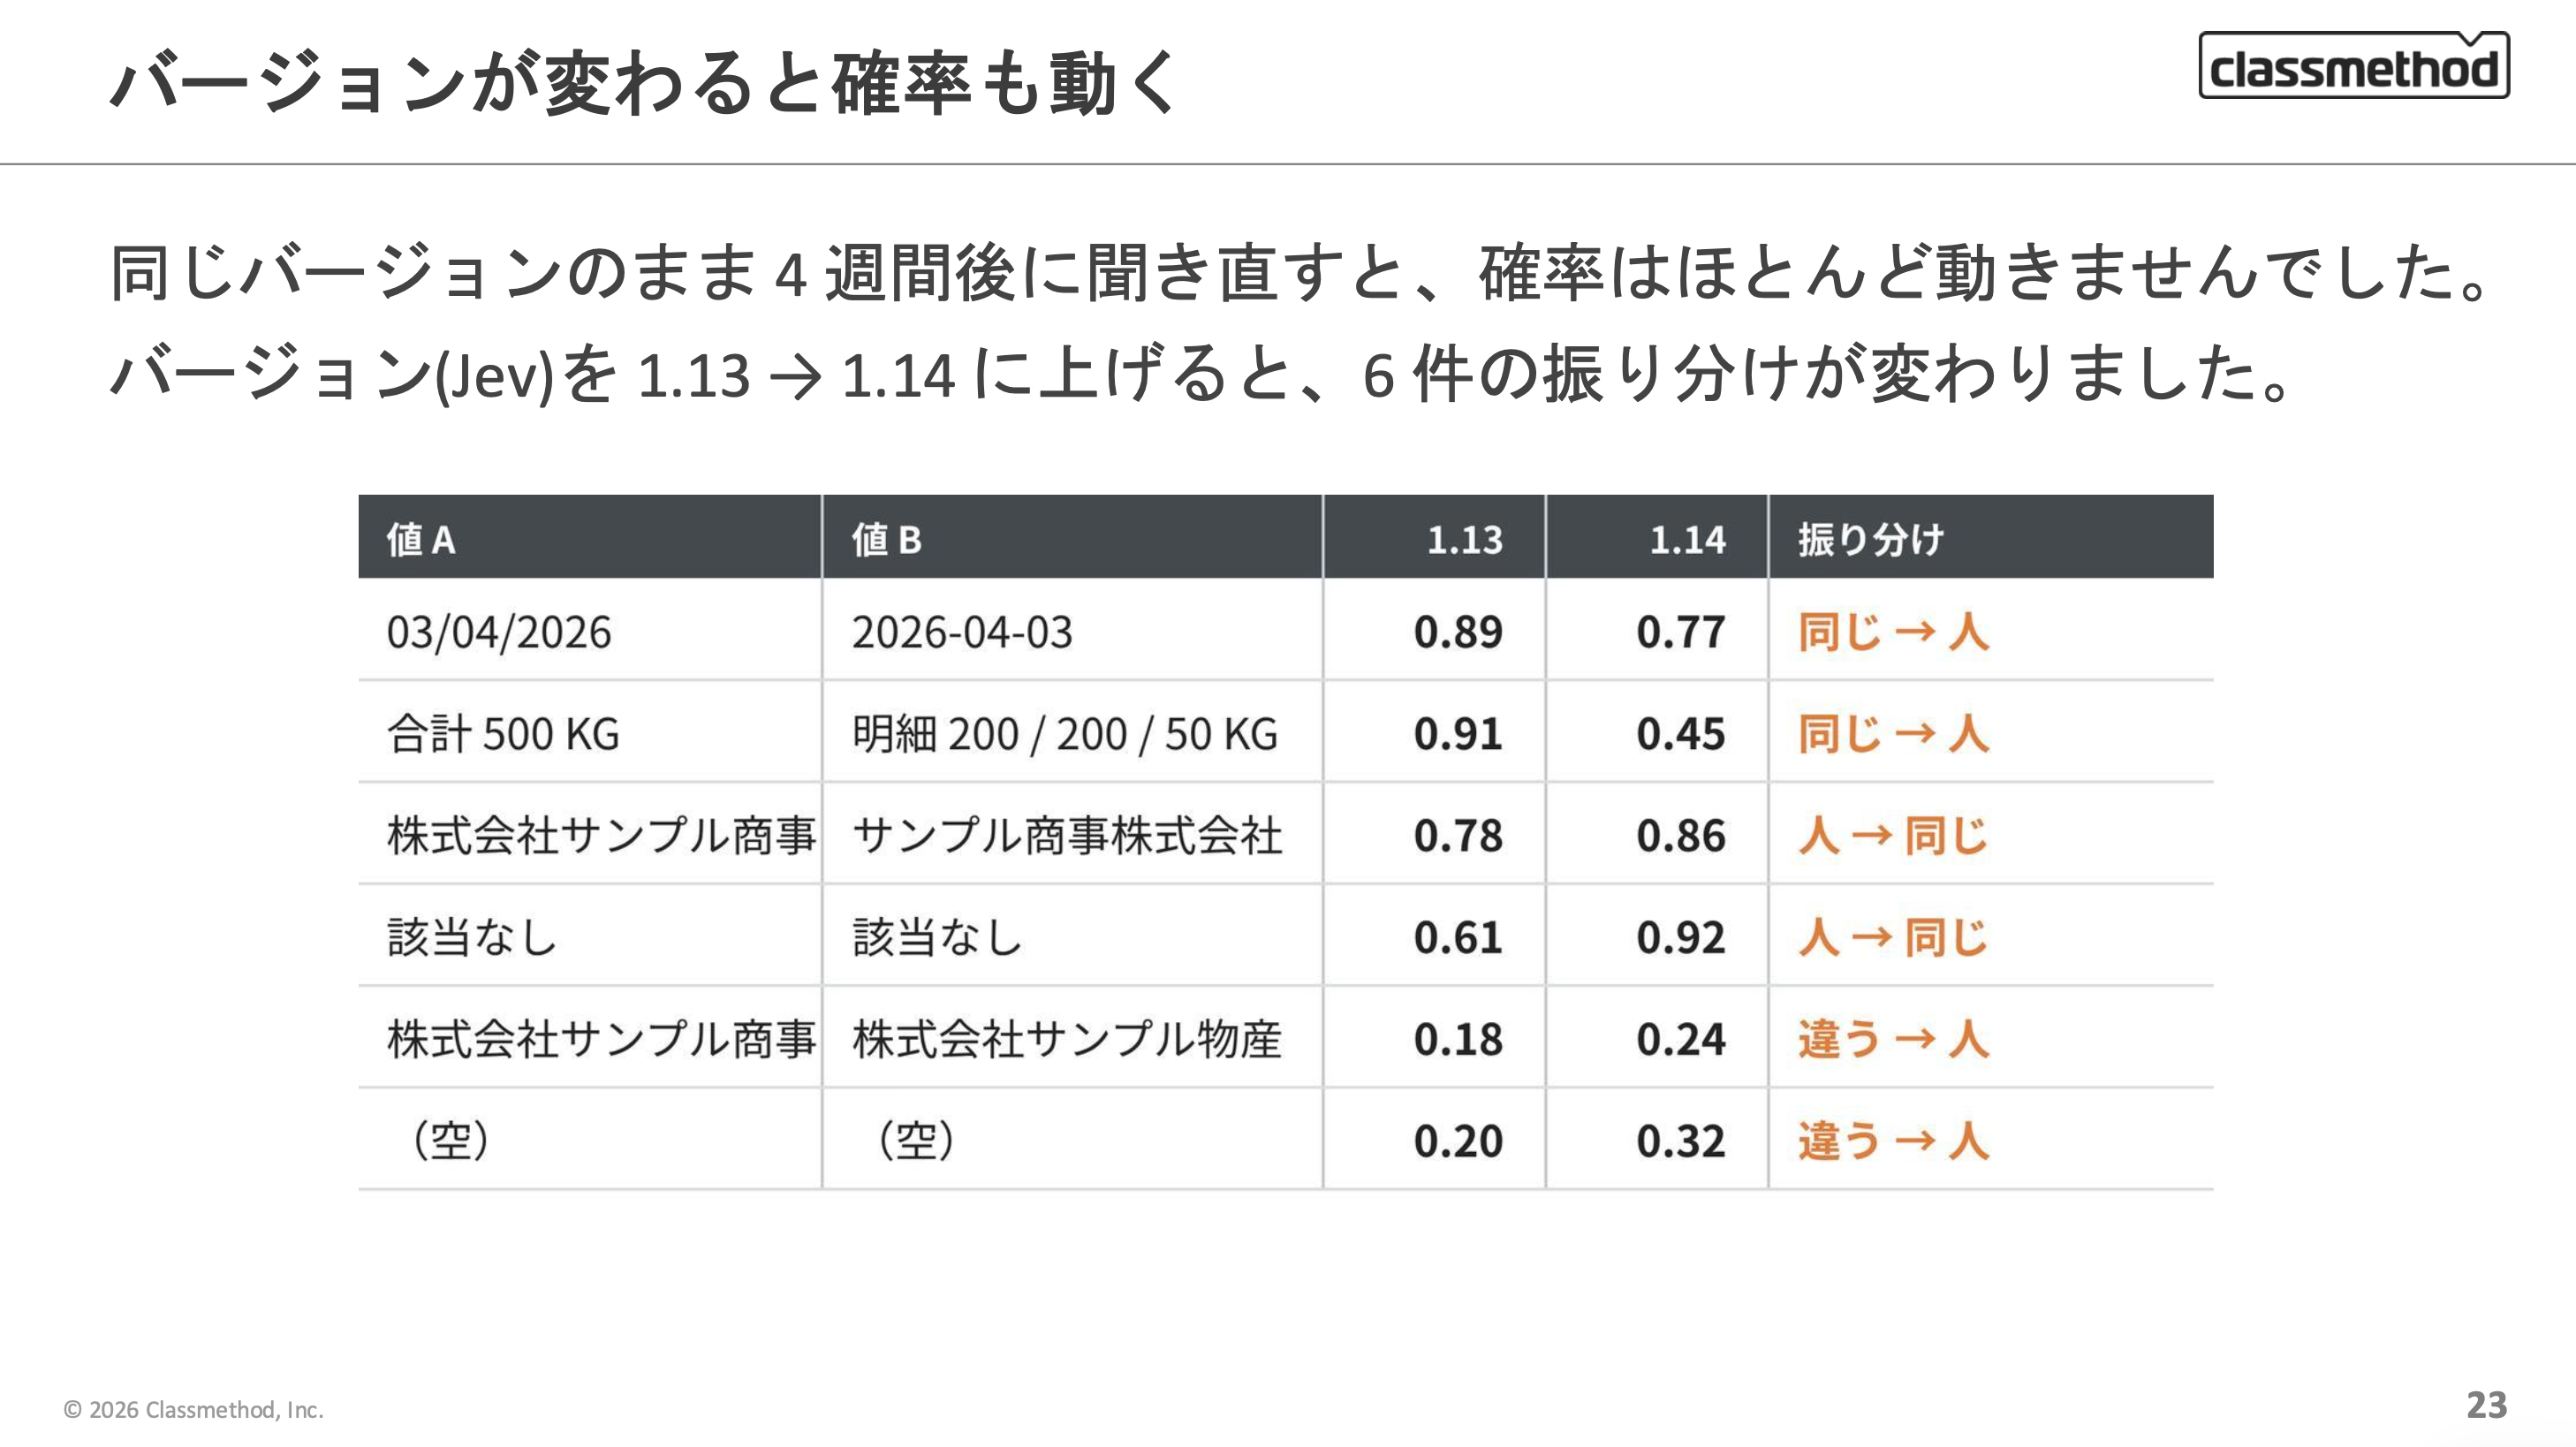
同じバージョンのまま4週間後に聞き直すと、確率はほとんど動きませんでした。
一方、Jev を 1.13 から 1.14 に上げると、6 件の振り分けが変わりました。
7.4 閾値の決め方
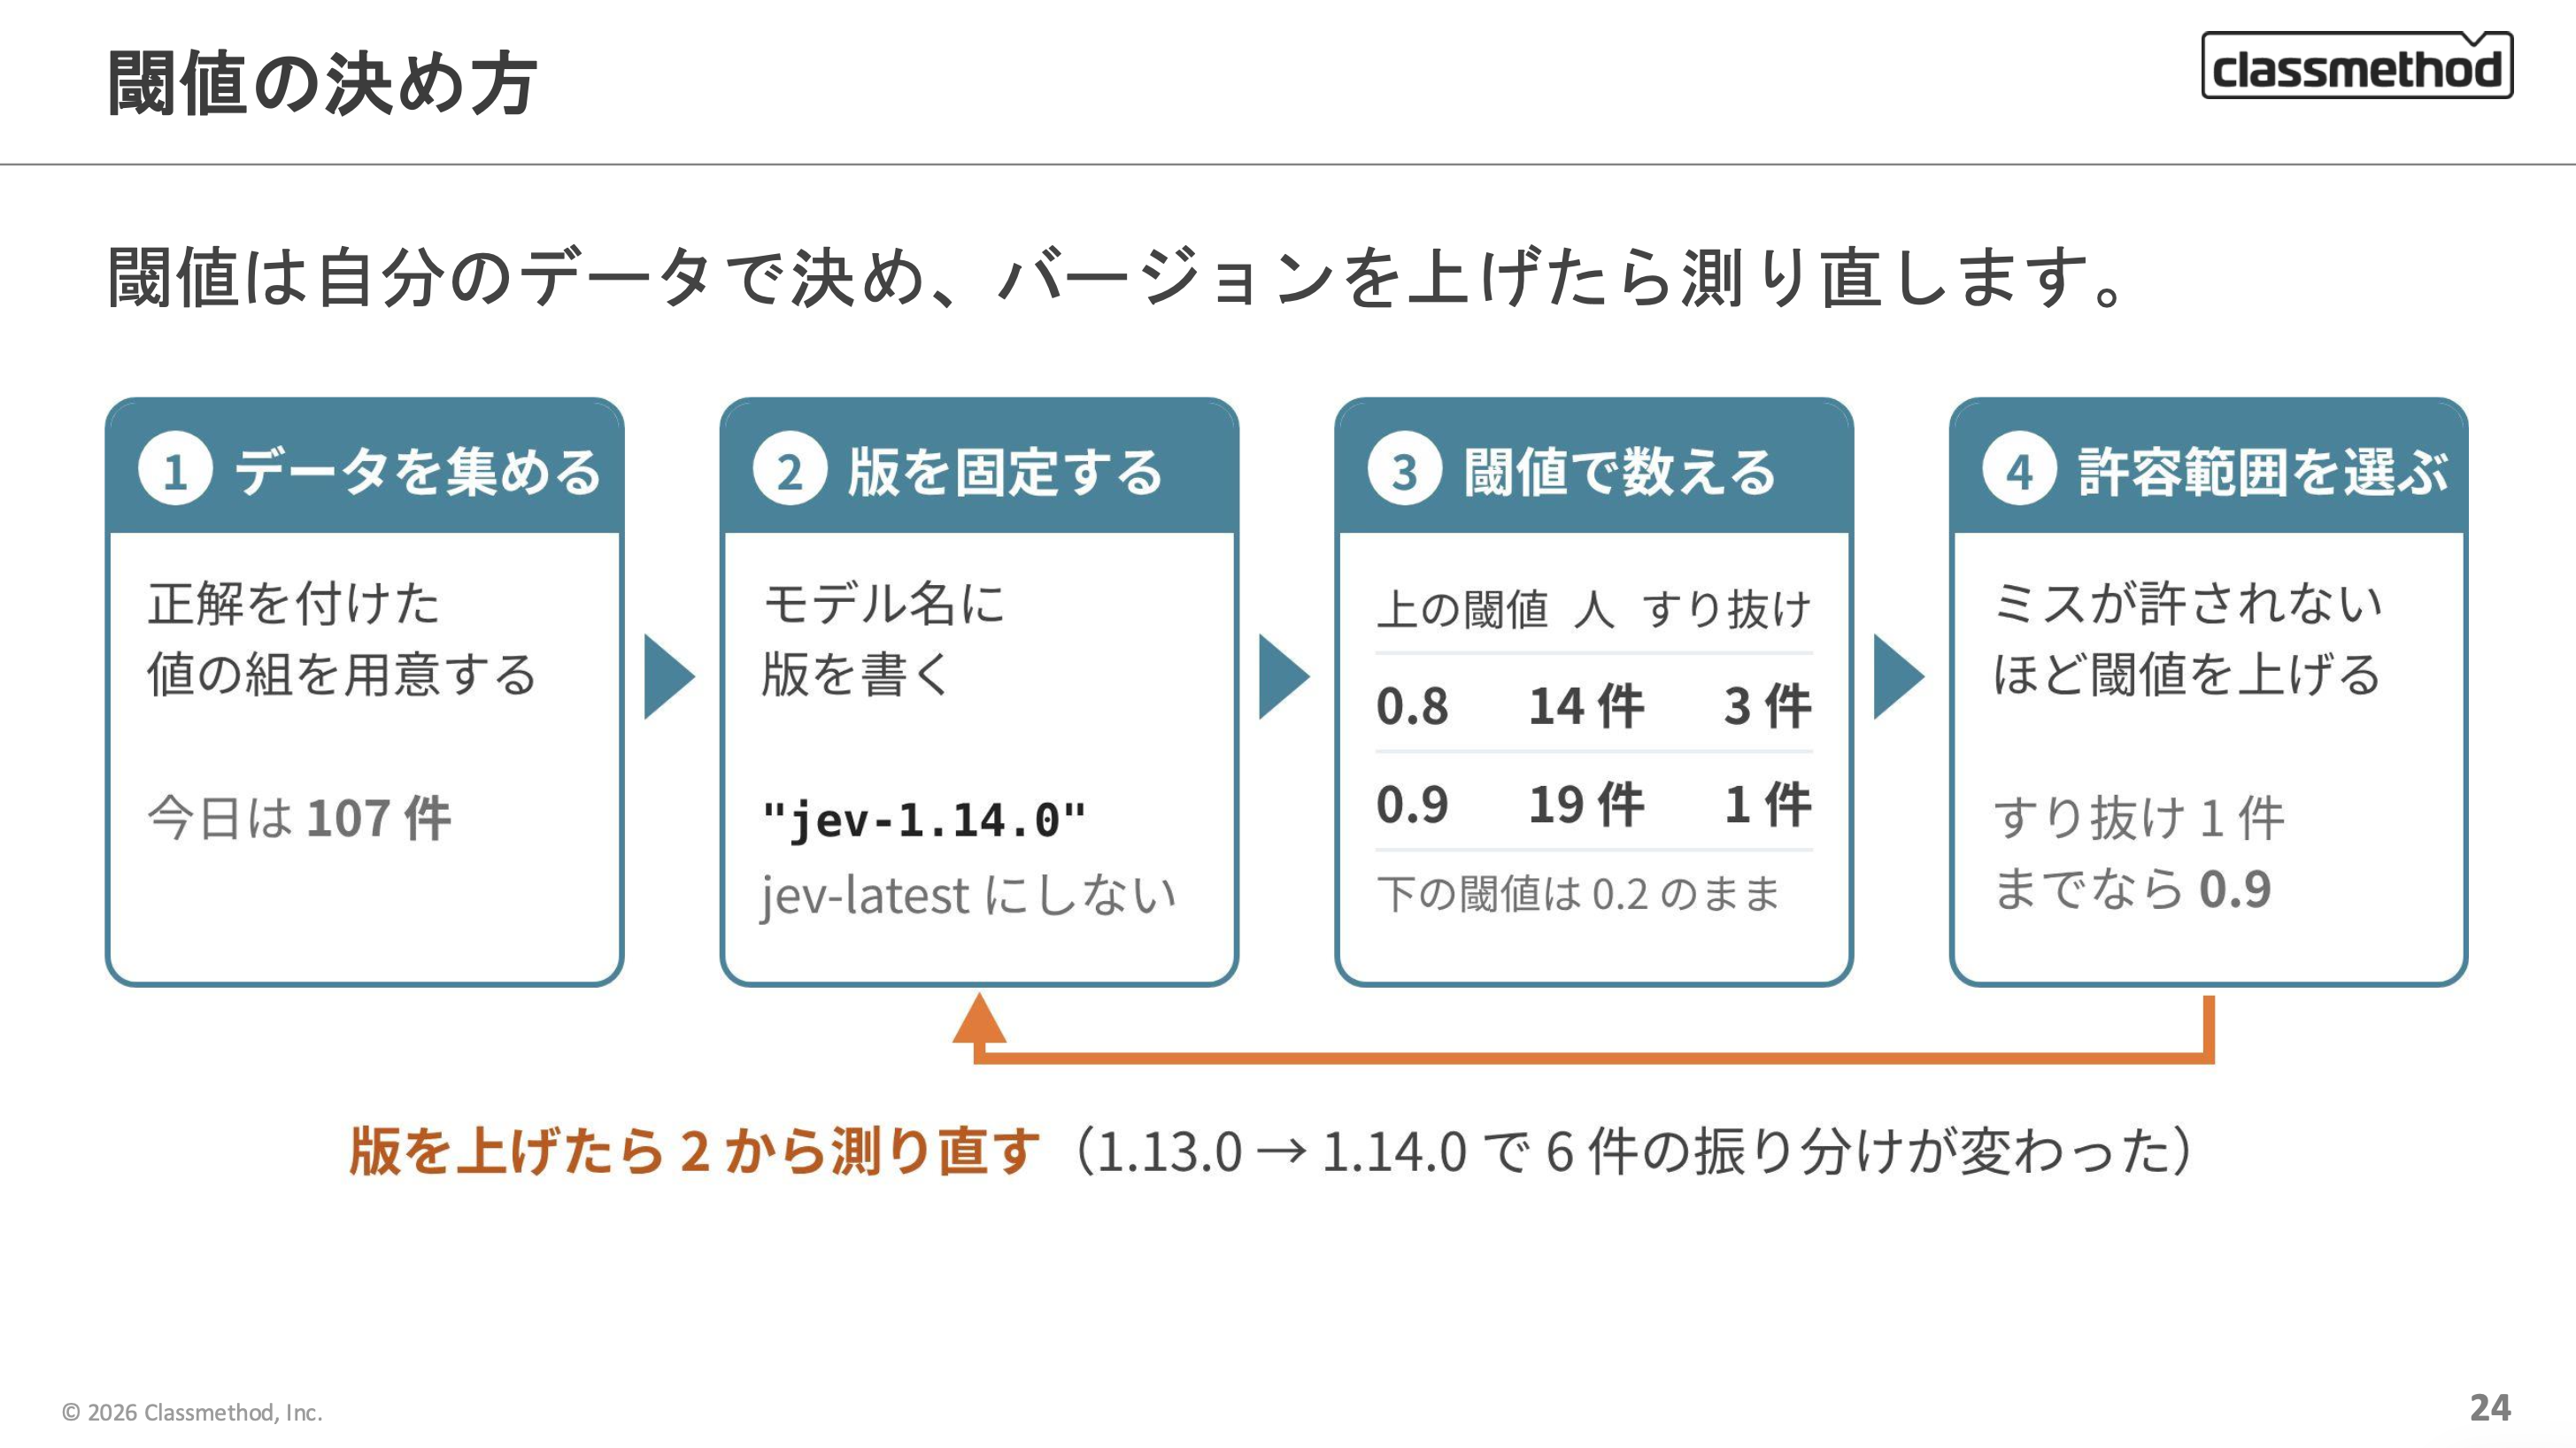
閾値は自分のデータで決め、バージョンを上げたら測り直します。
-
データを集める:正解を付けた値の組を用意します(今回は 107 件)
-
版を固定する:モデル名に
jev-1.14.0のように版を書き、jev-latestのような指定は避けます -
閾値で数える:上の閾値ごとに、人の確認件数とすり抜けを数えます
-
許容範囲を選ぶ:ミスが許されない業務ほど閾値を上げます(すり抜け 1 件までなら 0.9)
8. まとめ
セッションのまとめは次のとおりです。
-
LLM は答えを返す。Decision Model は「Yes である確率」を返す
-
確率で「AI に任せる」「人が見る」を分けられるかも?
-
閾値は自分のデータで決める。ミスを許せないなら閾値を上げる
-
モデルのバージョンを変えたら測り直す
最後に伝えたかったのは「AI の結果を全部見るのをやめて、迷うものだけ人へ」です。
スライドの付録には、製品ごとの比較や使ってみて感じたことを載せています。
検証の詳細は、私の DevelopersIO の記事一覧にまとめています。