[アップデート] Amazon Quick のアプリでデータセットのライブデータが使えるようになったので、Direct Query と SPICE で比べてみた

クラウド事業統括本部の石川です。Amazon Quick のアプリ(Apps)から Quick のデータセットをライブで参照できるようになりましたので、Direct Query と SPICE で表示がいつ更新されるかの違いを試してみました。
Amazon Quick のアプリは、作りたいアプリを自然言語で伝えると、エージェントが Web アプリケーションを作成してデプロイする機能です。Apps の GA 時点で書かれた DevelopersIO の記事では「現時点では QuickSight のデータセットやトピックとの連携機能はサポートされておりません」と説明されていました。
AWS のブログによると、これまでアプリにデータセットの数値を表示しても、その値はエージェントがアプリを作成した時点のもので、公開時点のスナップショットのまま変わりませんでした。
今回のアップデートで、アプリが Quick のデータセットに直接クエリできるようになりました。アプリを開くたびにデータセットへクエリが発行され、そのクエリはアプリ利用者本人の Quick 権限で実行されます。データセットに設定済みの行レベルセキュリティ(RLS)と列レベルセキュリティ(CLS)は、アプリ利用者ごとに適用されます。
アプリでデータセットのライブデータを使う機能とは
アプリにデータセットを追加するときは、アプリエディタのエージェントにデータセット名を伝えます。データソースを選ぶ専用のメニューはありません。エージェントはデータセットを探してカラムを把握し、アクセスの承認を求めます。承認するとビジュアルが作成され、公開(Publish)するとアプリ利用者が使えるようになります。アプリ利用者は、初めてアプリを開いたときにデータセットごとの同意プロンプトを 1 回承認します。
アプリを共有しても、データは共有されません。アプリ利用者には、アプリが使う各データセットの読み取り権限(またはデータセットを含むフォルダの共有)が別途必要です。
主な仕様と制限は以下のとおりです。
| 項目 | 内容 |
|---|---|
| 対応データセット | 単一テーブルのデータセット。SPICE と、Direct Query(Redshift、Athena、Aurora PostgreSQL、PostgreSQL、Databricks、S3 Tables) |
| 非対応 | マルチテーブル(データモデル)、composite / child データセット、ソースをまたいで JOIN するデータセット。トピック・ダッシュボード・分析はライブデータソースにできない |
| アカウント・リージョン | データセットとアプリは同じアカウント・同じリージョンであること |
| 参照するバージョン | データセットの公開済みバージョン |
| データ鮮度 | SPICE と S3 Tables は最大 12 時間キャッシュされ、SPICE のリフレッシュ完了で更新される。Direct Query はキャッシュされず、開くたびにソースへクエリする |
| 再読み込み | リフレッシュボタンはなく、ページを読み込むたびにクエリを再実行する。ヘッダーの「最終更新日」はアプリを最後に編集した日付で、データの鮮度ではない |
| ライブデータを閲覧できるロール | Admin、Author、Admin Pro、Author Pro、Reader Pro(Reader Pro は有効化されている場合のみ)。Reader と Restricted Reader は不可 |
| 公開範囲 | ライブデータを使うアプリは public にできない |
| 行数 | 1 ビジュアルあたり最大 50,000 行。超えた場合は先頭 50,000 行だけが表示される |
| データセットの変更 | カラム名や型の変更、データセットの置換・削除をすると、該当するビジュアルが警告なく動かなくなる |
| Apps の対応リージョン | 米国東部(バージニア北部)、米国西部(オレゴン)、欧州(アイルランド)、アジアパシフィック(シドニー) |
AWS のブログには、次の注意点も書かれています。
- 同じデータソースの Direct Query データセット同士、または SPICE データセットは 1 つのアプリで併用できますが、異なるソースの Direct Query データセットは同じアプリで併用できません
- ビルダー自身の RLS でデータが 0 件になる場合、そのデータセットではアプリを作成できません
アプリを開いたときの処理の流れを図にすると、以下のようになります。図中の Athena へのクエリは、後述の検証で Athena のクエリ履歴から確認した内容です。
やってみた
前提条件
- AWS アカウント(Amazon Quick Enterprise edition、ID リージョンは ap-northeast-1)
- Quick ユーザー: IAM 型、ロールは ADMIN_PRO
- 検証リージョン: us-east-1(Apps の対応リージョン。アプリとデータセットはこのリージョンに作成)
- データソース: Amazon Athena(workgroup は primary)+ Amazon S3 の CSV
Quick の ID リージョンは東京ですが、アプリもデータセットも us-east-1 に作成して検証しました。
検証の構成
同じ Athena テーブルを読む Direct Query データセットと SPICE データセットを用意し、1 つのアプリに並べて表示します。
検証用データを準備する
営業案件の CSV(18 行)を S3 に配置し、Glue Data Catalog にテーブルを作成しました。CSV の全内容は以下のとおりです。
deal_id,region,stage,owner,amount,close_date
D-001,AMER,Closed Won,Alice,120000,2026-07-15
D-002,AMER,Negotiation,Bob,85000,2026-10-20
D-003,AMER,Proposal,Alice,64000,2026-11-05
D-004,AMER,Prospecting,Carol,30000,2026-12-10
D-005,AMER,Closed Won,Bob,98000,2026-08-28
D-006,AMER,Negotiation,Carol,150000,2026-10-31
D-007,EMEA,Closed Won,Dieter,72000,2026-07-30
D-008,EMEA,Proposal,Emma,56000,2026-11-12
D-009,EMEA,Negotiation,Dieter,110000,2026-10-15
D-010,EMEA,Prospecting,Fatima,25000,2026-12-20
D-011,EMEA,Closed Won,Emma,67000,2026-09-10
D-012,EMEA,Proposal,Fatima,43000,2026-11-25
D-013,APJ,Closed Won,Hiro,90000,2026-08-05
D-014,APJ,Negotiation,Mei,76000,2026-10-22
D-015,APJ,Proposal,Hiro,51000,2026-11-18
D-016,APJ,Prospecting,Arjun,22000,2026-12-03
D-017,APJ,Closed Won,Mei,105000,2026-09-25
D-018,APJ,Negotiation,Arjun,48000,2026-10-28
Athena で集計し、後でアプリの表示と比べるための値を確認しました。
SELECT region, count(*) AS deals, sum(amount) AS amount
FROM pipeline_deals
GROUP BY region
ORDER BY region;
| region | deals | amount |
|---|---|---|
| AMER | 6 | 547000 |
| APJ | 6 | 392000 |
| EMEA | 6 | 373000 |
合計は 18 件、1,312,000 です。
Quick のデータソースとデータセットを作成する
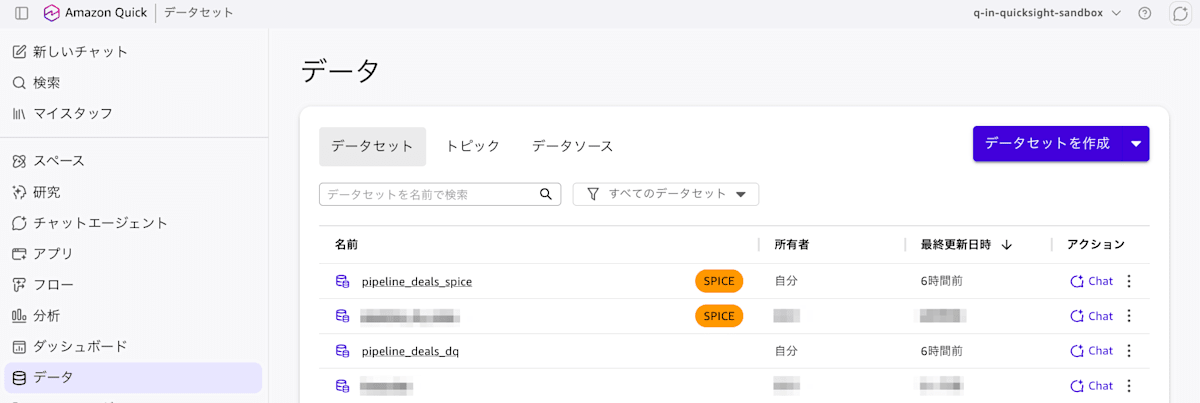
Athena のデータソースを作成し、同じテーブルから Direct Query と SPICE の 2 つのデータセットを作成しました。
アプリを作成する
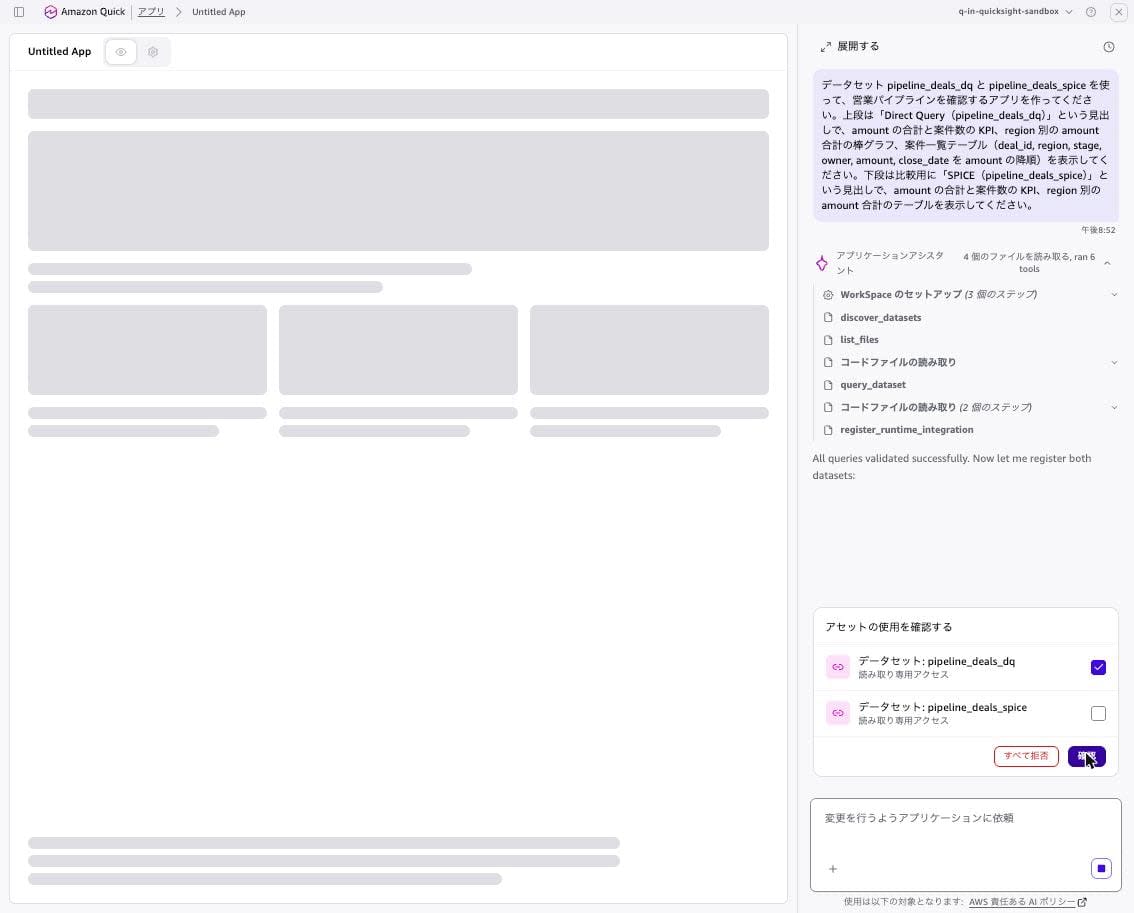
Quick の左メニューで「アプリ」を開き、プロンプト欄に作りたいアプリを入力しました。データセット名と、使うカラム名を指定しています。
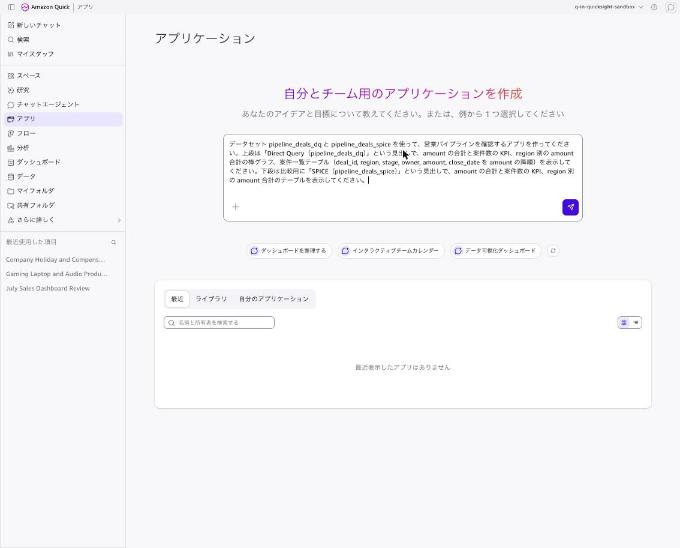
データセット pipeline_deals_dq と pipeline_deals_spice を使って、営業パイプラインを確認するアプリを作ってください。上段は「Direct Query(pipeline_deals_dq)」という見出しで、amount の合計と案件数の KPI、region 別の amount 合計の棒グラフ、案件一覧テーブル(deal_id, region, stage, owner, amount, close_date を amount の降順)を表示してください。下段は比較用に「SPICE(pipeline_deals_spice)」という見出しで、amount の合計と案件数の KPI、region 別の amount 合計のテーブルを表示してください。
送信するとアプリエディタが開き、エージェントが discover_datasets、list_files、query_dataset などのツールを実行しました。続いて「アセットの使用を確認する」というプロンプトがデータセットごとに表示されました。「アクションの詳細を表示する」を開くと、エージェントが検証のために実行する SQL が JSON で表示されます。
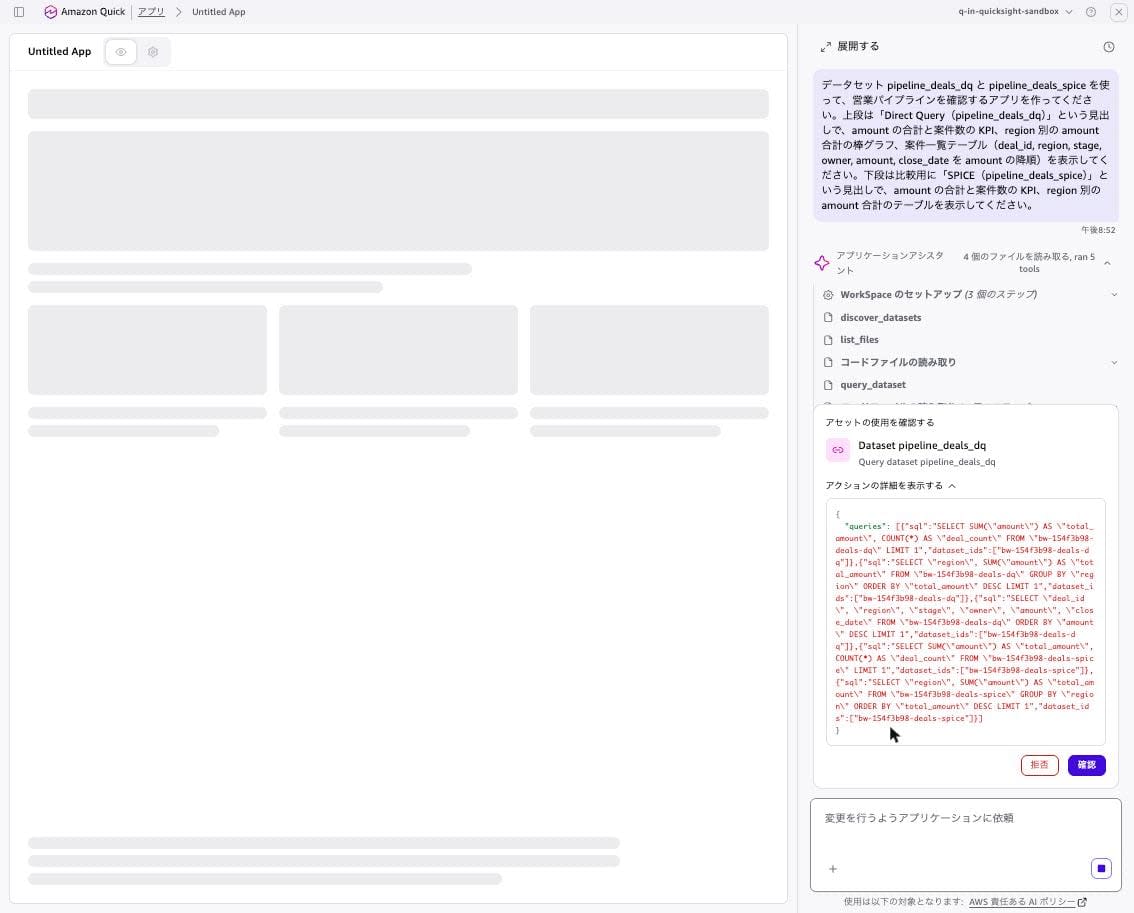
{
  "queries": [
    {"sql": "SELECT SUM(\"amount\") AS \"total_amount\", COUNT(*) AS \"deal_count\" FROM \"bw-154f3b98-deals-dq\" LIMIT 1", "dataset_ids": ["bw-154f3b98-deals-dq"]},
    {"sql": "SELECT \"region\", SUM(\"amount\") AS \"total_amount\" FROM \"bw-154f3b98-deals-dq\" GROUP BY \"region\" ORDER BY \"total_amount\" DESC LIMIT 1", "dataset_ids": ["bw-154f3b98-deals-dq"]},
    {"sql": "SELECT \"deal_id\", \"region\", \"stage\", \"owner\", \"amount\", \"close_date\" FROM \"bw-154f3b98-deals-dq\" ORDER BY \"amount\" DESC LIMIT 1", "dataset_ids": ["bw-154f3b98-deals-dq"]},
    {"sql": "SELECT SUM(\"amount\") AS \"total_amount\", COUNT(*) AS \"deal_count\" FROM \"bw-154f3b98-deals-spice\" LIMIT 1", "dataset_ids": ["bw-154f3b98-deals-spice"]},
    {"sql": "SELECT \"region\", SUM(\"amount\") AS \"total_amount\" FROM \"bw-154f3b98-deals-spice\" GROUP BY \"region\" ORDER BY \"total_amount\" DESC LIMIT 1", "dataset_ids": ["bw-154f3b98-deals-spice"]}
  ]
}
FROM 句にはテーブル名ではなくデータセット ID が書かれ、末尾に LIMIT 1 が付いています。pipeline_deals_dq の確認画面でしたが、pipeline_deals_spice を対象とする 4・5 件目のクエリも含まれていました。pipeline_deals_dq と pipeline_deals_spice のそれぞれについて「確認」を押すと、エージェントは「All queries validated successfully」と表示し、register_runtime_integration を実行しました。
すると、もう一度「アセットの使用を確認する」が表示されました。今度は、2 つのデータセットへの「読み取り専用アクセス」をチェックボックスで選ぶ画面です。pipeline_deals_dq にはチェックが入っていましたが、pipeline_deals_spice のチェックは外れていたため、チェックを入れてから「確認」を押しました。チェックを外したまま進めた場合の動作は、今回は確認していません。
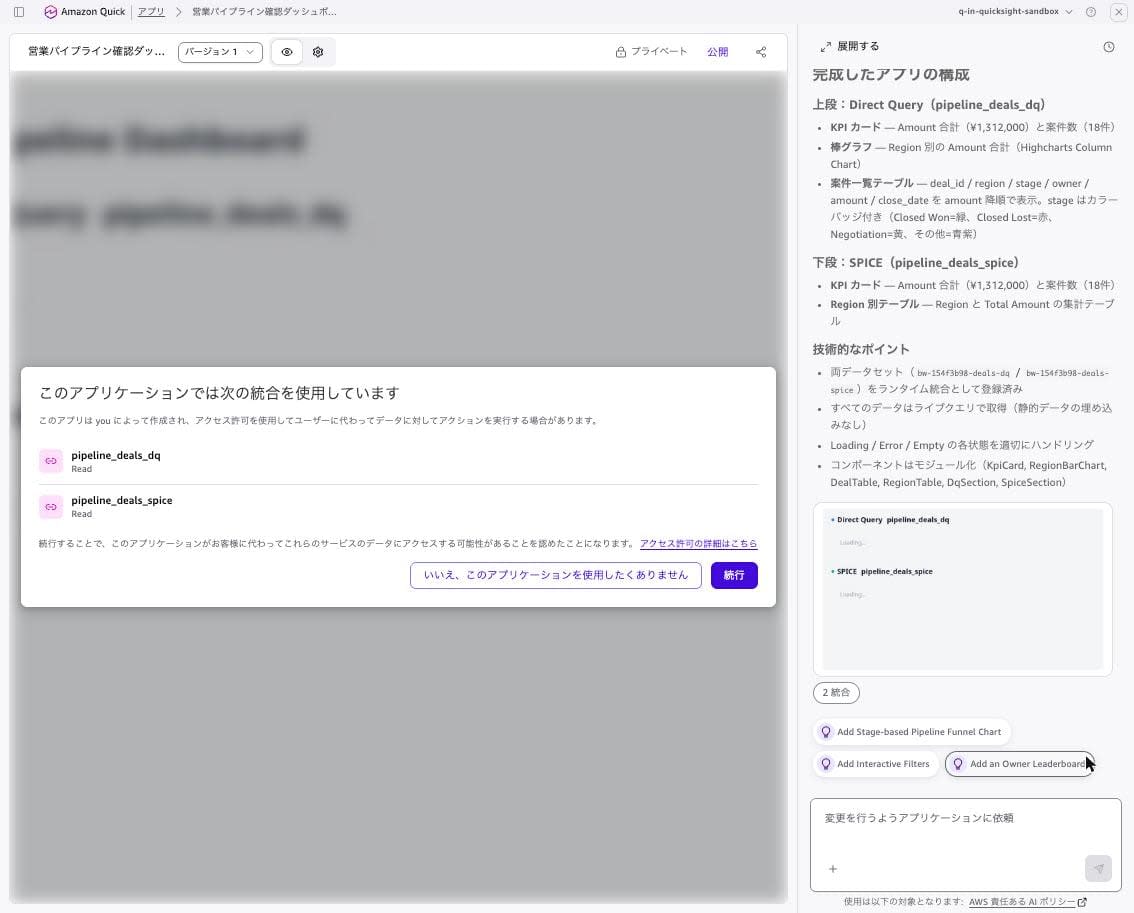
プロンプトを送信してから約 5 分でアプリが完成しました。プレビューには「このアプリケーションでは次の統合を使用しています」というダイアログが表示され、2 つのデータセットが「Read」として表示されています。「続行」を押すとデータが表示されました。
右上の「公開」からアプリを公開し、公開版の URL(.../apps/<アプリ ID>/view/app)を開きました。共有の設定はしていないため、ヘッダーには「Only me」と表示されています。
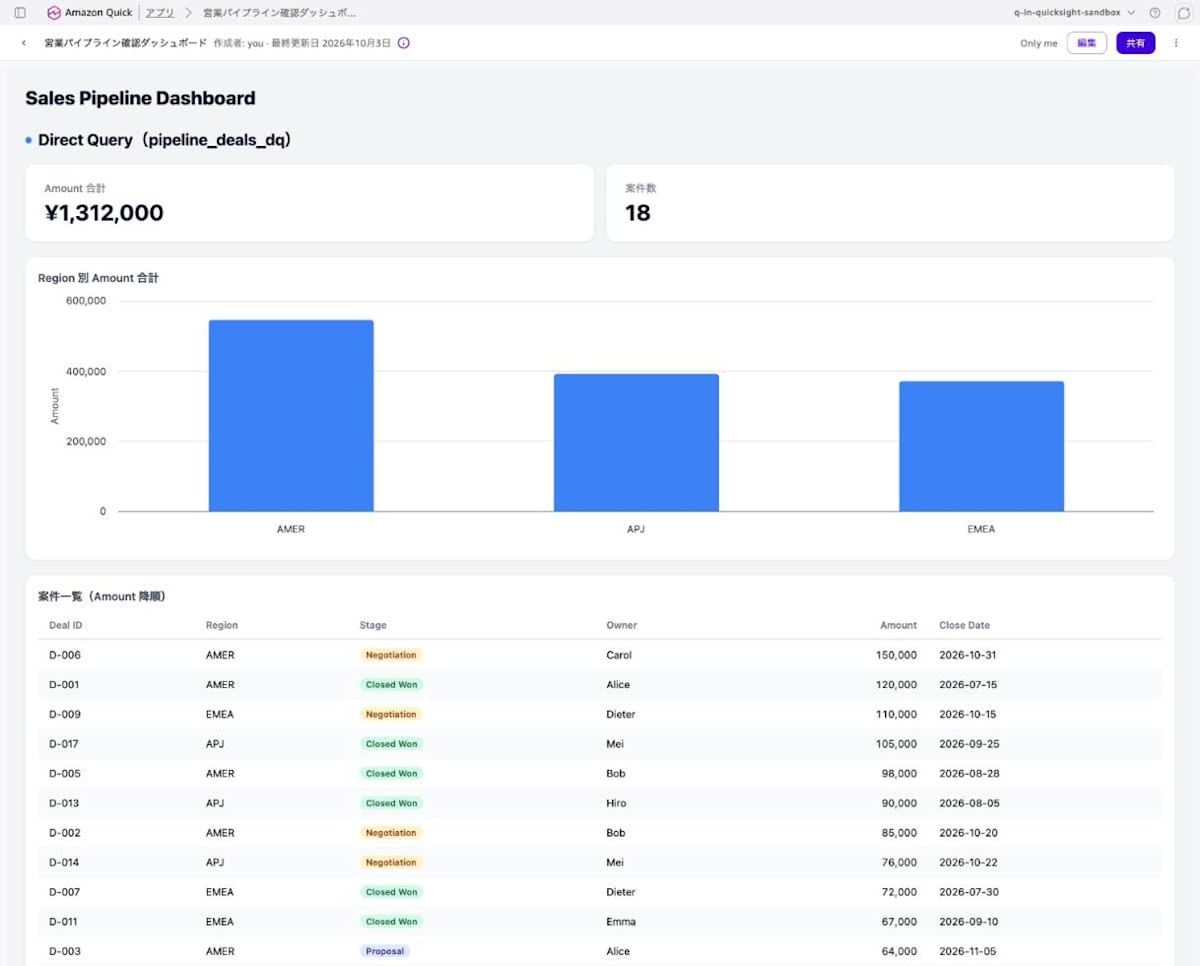
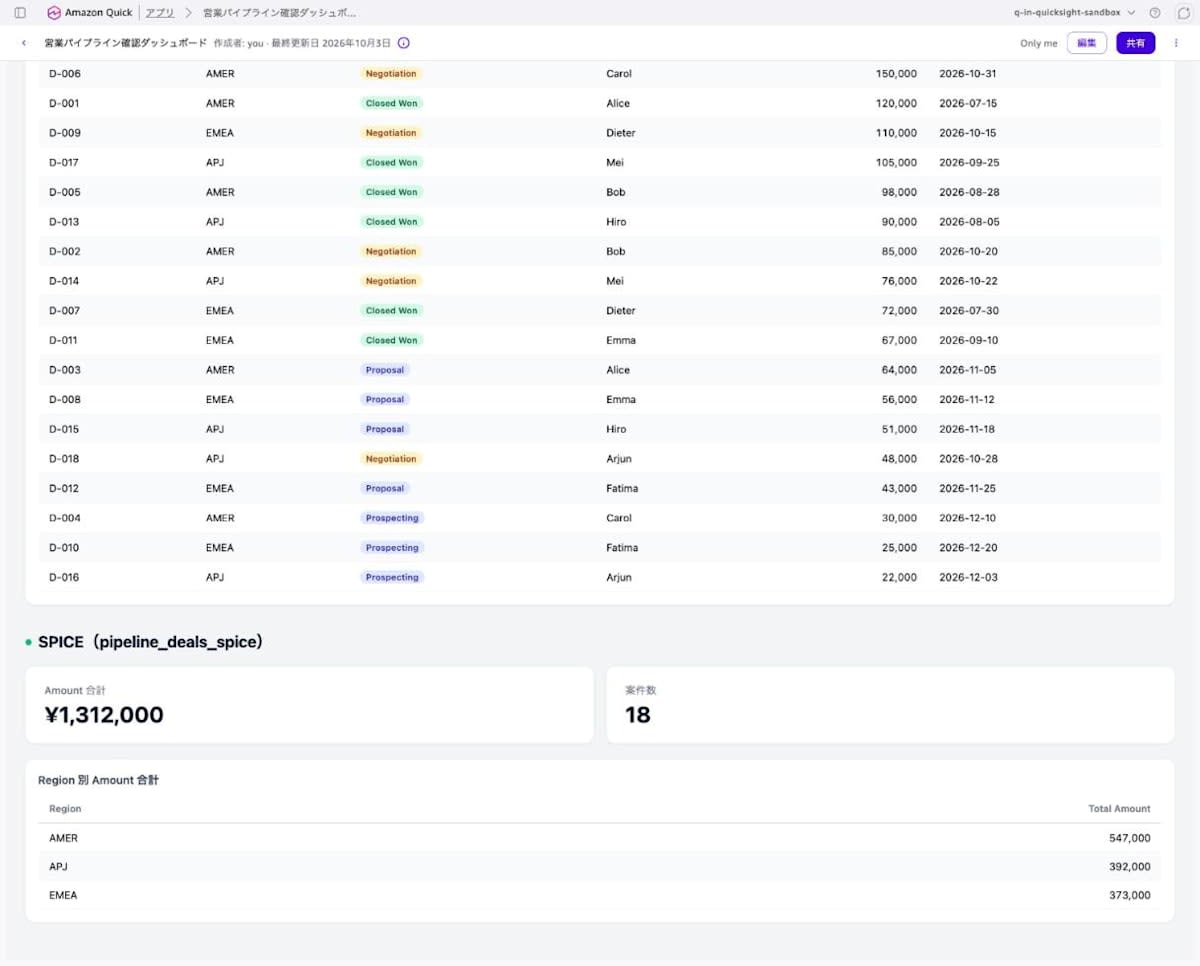
Direct Query 側・SPICE 側ともに Amount 合計が ¥1,312,000、案件数が 18 件で、Athena で集計した値と一致しました。データには通貨の情報を持たせていませんが、エージェントは金額に「¥」を付けて表示しました。公開版を開いたときに同意プロンプトは表示されませんでした。同じユーザーがプレビューで同意済みだったためと考えられます。
データを追加して鮮度を比較する
S3 に新しい案件を 1 行追加しました。
deal_id,region,stage,owner,amount,close_date
D-019,APJ,Closed Won,Hiro,200000,2026-10-03
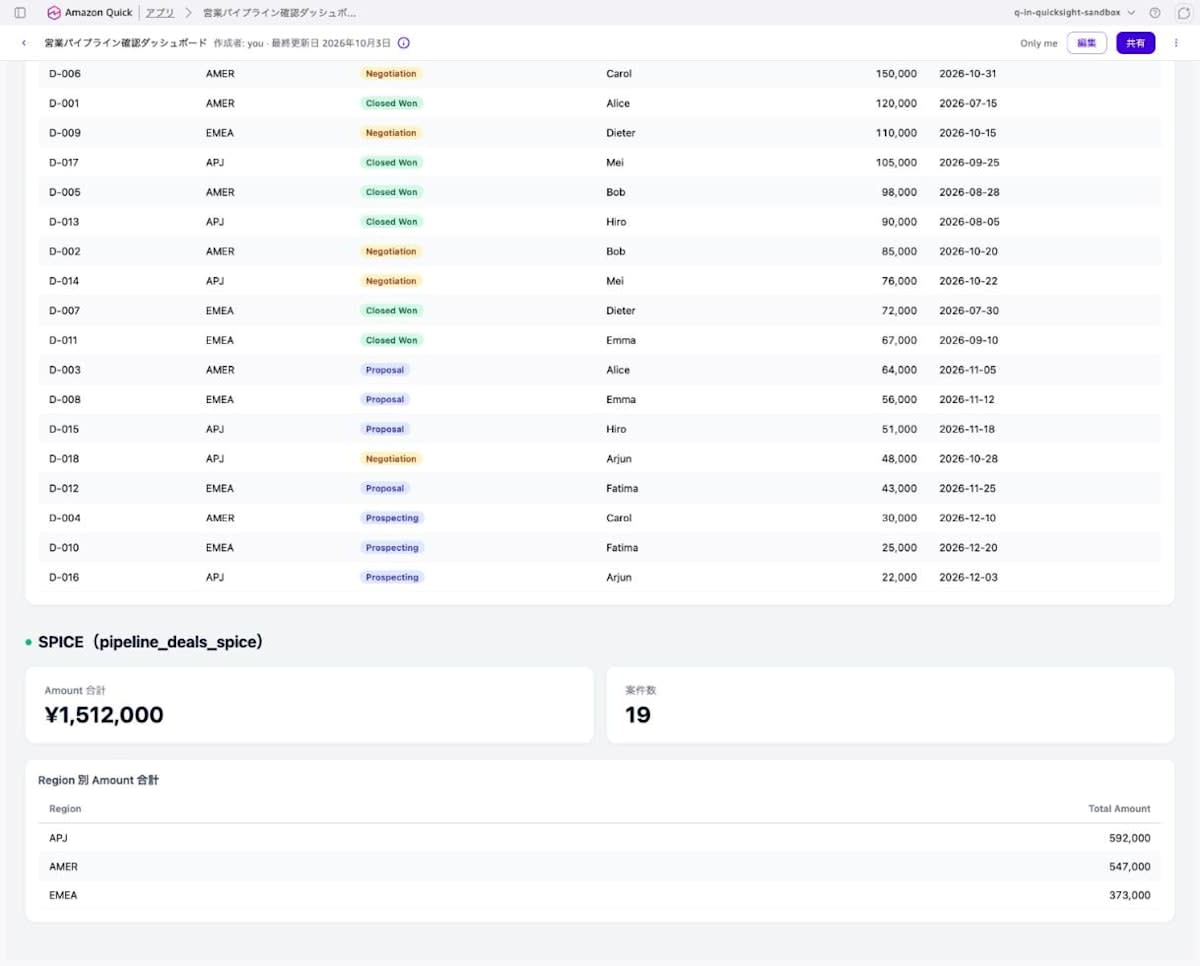
公開版のアプリを再読み込みすると、Direct Query 側は Amount 合計が ¥1,512,000、案件数が 19 件に変わりました。棒グラフは APJ が最も大きくなり、案件一覧の先頭に D-019 が表示されています。
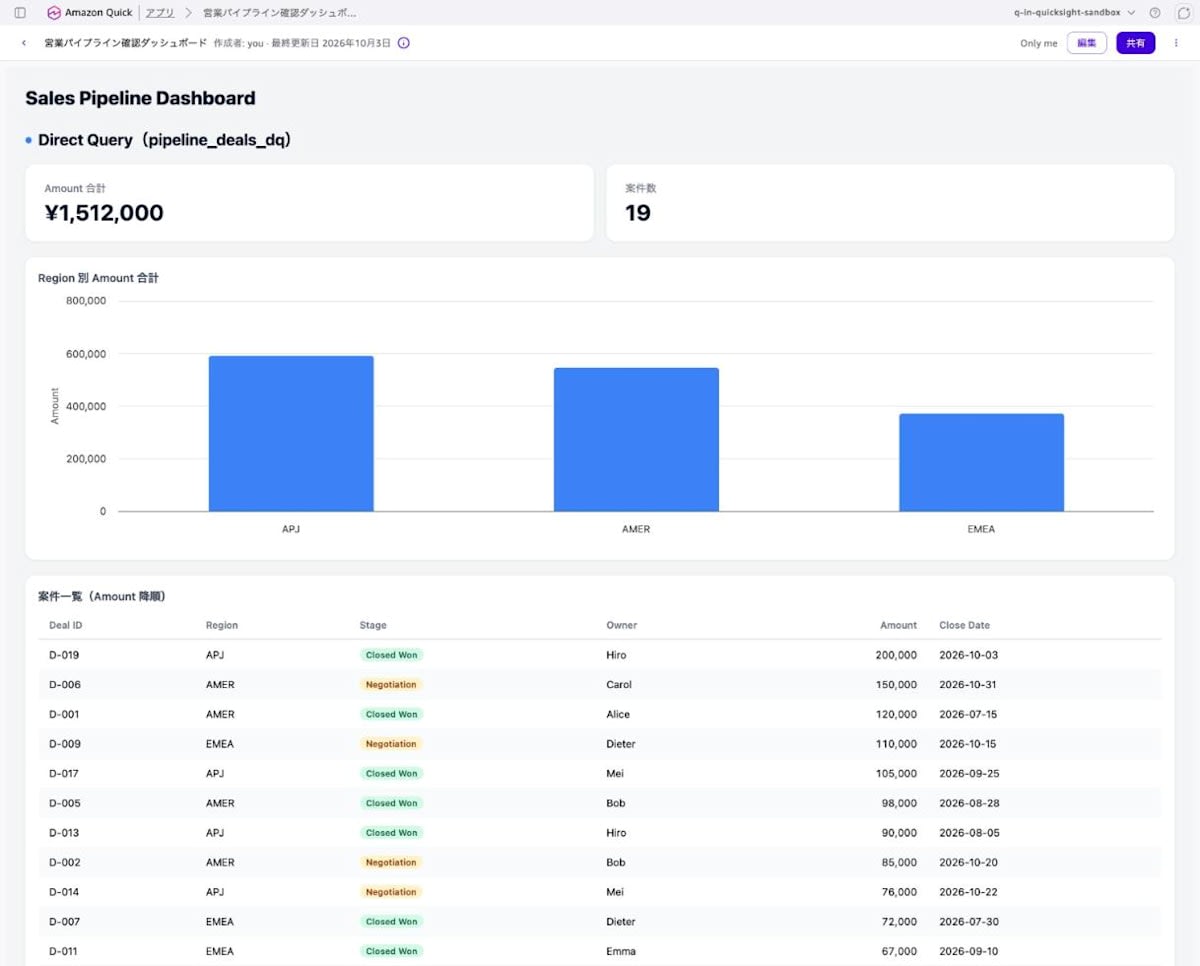
一方、同じ画面の SPICE 側は ¥1,312,000 / 18 件のままでした。
このとき Athena のクエリ履歴を確認すると、アプリを読み込むたびに /* Quick Suite <UUID> */ というコメント付きのクエリが 3 本発行されていました。3 本は Direct Query 側のビジュアル(KPI、棒グラフ、案件一覧)に対応しています。
/* Quick Suite f549bfbf-179e-4306-a7f9-1ee76d1cf671 */
SELECT SUM("amount") AS "total_amount", COUNT(*) AS "deal_count"
FROM "AwsDataCatalog"."blogwriter_quick_live_154f3b98"."pipeline_deals"
LIMIT 50000
| 発行時刻(UTC) | 契機 | クエリの末尾 | スキャン量 |
|---|---|---|---|
| 11:53:31 | エージェントによるデータセットの探索 | LIMIT 1 |
845 バイト |
| 11:54:31 | 同意後の SQL 検証(3 本) | LIMIT 1 |
845 バイト |
| 11:57:56 / 11:58:34 / 11:58:58 | プレビュー・公開版の表示(各 3 本) | LIMIT 50000 |
845 バイト |
| 11:59:54 | S3 に 1 行追加した後の再読み込み(3 本) | LIMIT 50000 |
934 バイト |
S3 に追加した後のクエリはスキャン量が 845 バイトから 934 バイトに増えており、増えた 89 バイトは追加した deals_002.csv のサイズです。公開後のクエリに付く LIMIT 50000 は、ドキュメントに書かれている「1 ビジュアルあたり最大 50,000 行」と同じ値です。SPICE 側のビジュアルを表示しても、Athena へのクエリは発行されていませんでした。
続いて、SPICE データセットを手動でリフレッシュしました。以下のプログラムは、取り込みを開始し、完了するまで待ってから結果を表示します。取り込みの完了後にアプリを再読み込みすると、SPICE 側も ¥1,512,000 / 19 件になりました。
| タイミング | Direct Query 側 | SPICE 側 |
|---|---|---|
| アプリ公開直後 | ¥1,312,000 / 18 件 | ¥1,312,000 / 18 件 |
| S3 に 1 行追加して再読み込み | ¥1,512,000 / 19 件 | ¥1,312,000 / 18 件 |
| SPICE リフレッシュ後に再読み込み | ¥1,512,000 / 19 件 | ¥1,512,000 / 19 件 |
ヘッダーの「最終更新日 2026年10月3日」は、データが変わっても変化しませんでした。ドキュメントのとおり、この日付はアプリの最終編集日です。
考察
Direct Query は再読み込みで反映、SPICE はリフレッシュ後に反映
Direct Query のデータセットは、S3 にデータを追加した直後の再読み込みで表示が変わりました。SPICE のデータセットは、リフレッシュ(CreateIngestion)が完了するまで表示が変わりませんでした。アプリに表示したい数値の更新頻度に合わせて、Direct Query と SPICE を選ぶ必要があります。ドキュメントによると SPICE の結果は最大 12 時間キャッシュされますが、今回はリフレッシュの完了直後に反映されました。キャッシュが残り続ける条件は、今回の検証では確認していません。
表示のたびに Direct Query ビジュアルの数だけクエリが発行される
Direct Query 側では、アプリを読み込むたびにビジュアル 3 つ分のクエリが Athena に発行されました。Athena はスキャンしたデータ量に応じて課金されるため、Direct Query のデータセットを使うアプリでは、閲覧回数とビジュアル数に比例してクエリの実行回数が増えます。閲覧者が多いアプリや、スキャン量の大きいテーブルを使う場合は、集計済みのテーブルを使う、または SPICE を選ぶといった検討が必要です。
同意の画面は 3 種類
ビルドからプレビューまでに、次の 3 種類の確認画面が表示されました。
- データセットごとの「アセットの使用を確認する」(詳細を開くと検証用 SQL が見える)
- 実行時に使うデータセットの「読み取り専用アクセス」の登録(チェックボックス形式。今回は SPICE 側のチェックが初期状態で外れていた)
- プレビュー時の「このアプリケーションでは次の統合を使用しています」
2 のチェックボックスは、すべてにチェックが入っているかを確認してから「確認」を押すことをおすすめします。
東京リージョンのデータセットは使えない
Apps の対応リージョンに東京リージョンは含まれていません。また、データセットとアプリは同じリージョンにある必要があり、リージョンをまたぐデータセットは参照できません。そのため、東京リージョンにある既存のデータセットは、現時点ではアプリから使えません。今回の検証では、ID リージョンが東京の Quick アカウントで、アプリとデータセットを us-east-1 に作成しました。
今後に期待すること
- Apps の東京リージョン対応
- マルチテーブル(データモデル)のデータセットへの対応
- アプリを作成する API と、アプリが使うデータセットを API で取得する手段
最後に
Amazon Quick のアプリから Quick のデータセットをライブで参照できるようになり、Direct Query のデータセットでは、アプリを再読み込みするだけで最新のデータが表示されることを確認しました。ドキュメントによると、クエリはアプリ利用者本人の Quick 権限で実行されるため、データセットに設定済みの RLS と CLS もアプリ利用者ごとに適用されます。
一方で、Apps は東京リージョンに対応していないこと、Direct Query では閲覧のたびにソースへクエリが発行されることは、設計時に確認しておく必要があります。既存の Quick Sight のデータセットを使ってアプリを作りたい方は、まずはデータセットが対応リージョンにあるか、単一テーブルのデータセットかを確認してから試してみてください。
合わせて読みたい