[アップデート] AgentCore GatewayがBedrockのInvokeModel APIとモデルのフォールバックに対応したので試してみた

はじめに
こんにちは、腰痛がひどいコンサル部の神野です。
毎日ストレッチすると少しずつよくなっている気がします。
ところで、Amazon Bedrock AgentCore Gatewayの推論ターゲットがBedrockのInvokeModel・InvokeModelWithResponseStream APIに対応しました!あわせてGatewayのルールには、モデル名で振り分ける条件(matchModels)とサーキットブレーカー付きのフォールバックも追加されています。
GatewayのBedrock用コネクタはMantleしか対応していなかったので、嬉しい内容ではないでしょうか!
フォールバックも含めて今回は両方とも試してみます!
アップデート内容
Bedrock Runtimeのコネクタ対応
推論ターゲットはGatewayの背後にBedrockやOpenAIなどのLLMプロバイダーを置いて1つの入り口から各種LLMを呼び出せる機能です。以前の記事で試したときは、Bedrockのモデルを呼ぶにはBedrock Mantleしか対応していませんでした。
今回からはBedrock Runtimeのinvoke_modelなどにも対応しました!
障害時の扱い強化
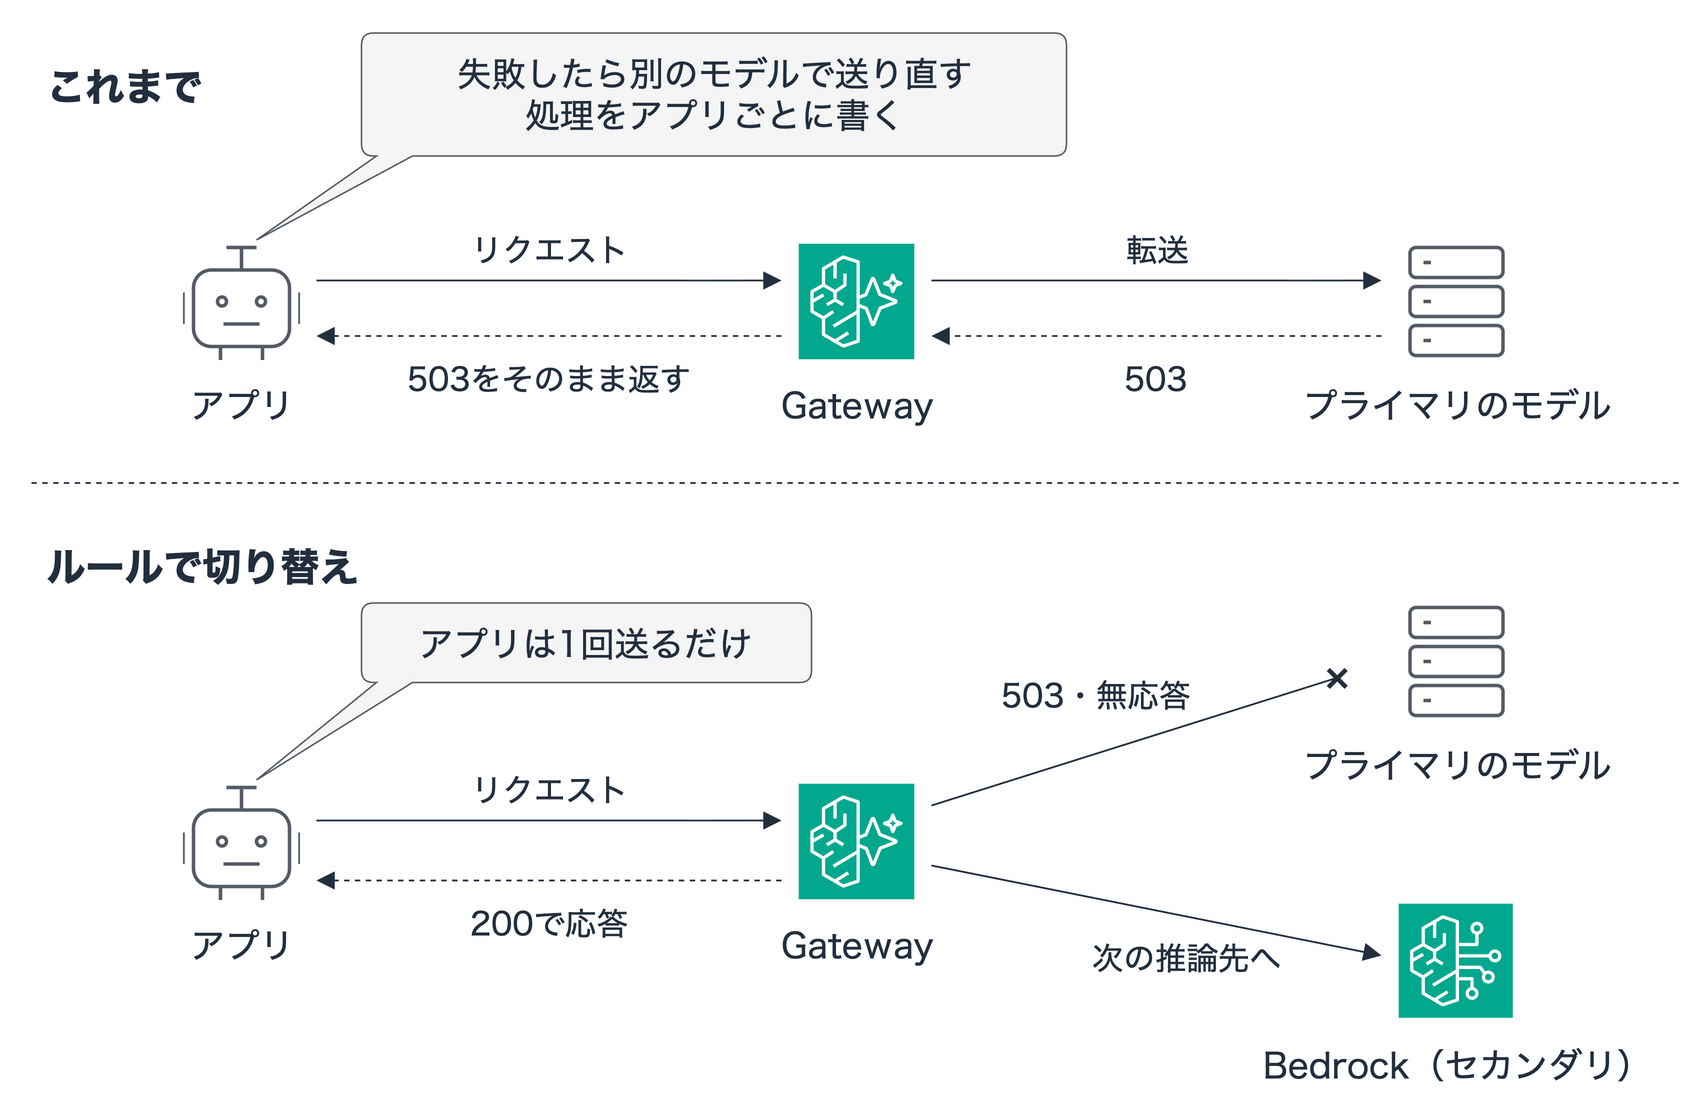
もう1つは障害時の扱いです。これまではプライマリのプロバイダーが503を返したり無応答になったりすると、エラーはそのまま呼び出し元のアプリへ返るため、別のモデルで送り直したい場合はアプリごとにリトライと切り替えの処理を書く必要があります。
そこでアップデートでフォールバック機能が入ったことで、切り替え先の順番と条件をGatewayのルールに書くだけで済むようになりました!プライマリのモデルが失敗したときはGatewayがセカンダリのターゲットへ送り直してくれるので、アプリ側は特に意識する必要がありません。なお切り替え先には、送るリクエスト本文と同じ形式で呼べるモデルを選ぶ必要があります。
ちなみに失敗が続くプライマリをしばらく飛ばすサーキットブレーカーもGateway側に備わっていて、自前で状態を管理しなくて済むのも助かりますね。
もう少し具体的にアップデート内容を見ていきましょうか。
追加された設定
InvokeModel API
Gatewayの /inference の下にBedrockと同じ形のパスが追加されました。
| BedrockのAPI | Gatewayのパス |
|---|---|
| InvokeModel | /inference/model/{model}/invoke |
| InvokeModelWithResponseStream | /inference/model/{model}/invoke-with-response-stream |
呼び出し方や変換の対応表は下記のドキュメントにまとまっています。
あわせて bedrock-runtime コネクタが追加されています。これをターゲットにするとBedrock Runtimeのモデルを呼べます。モデルの一覧をBedrockから取得するので、Gatewayの実行ロールには bedrock:InvokeModel などに加えて bedrock:List* の権限が必要です。
2026年10月25日時点では、コンソールで推論ターゲットを追加するときのコネクターにBedrock Runtimeはまだ表示されていませんでした・・・
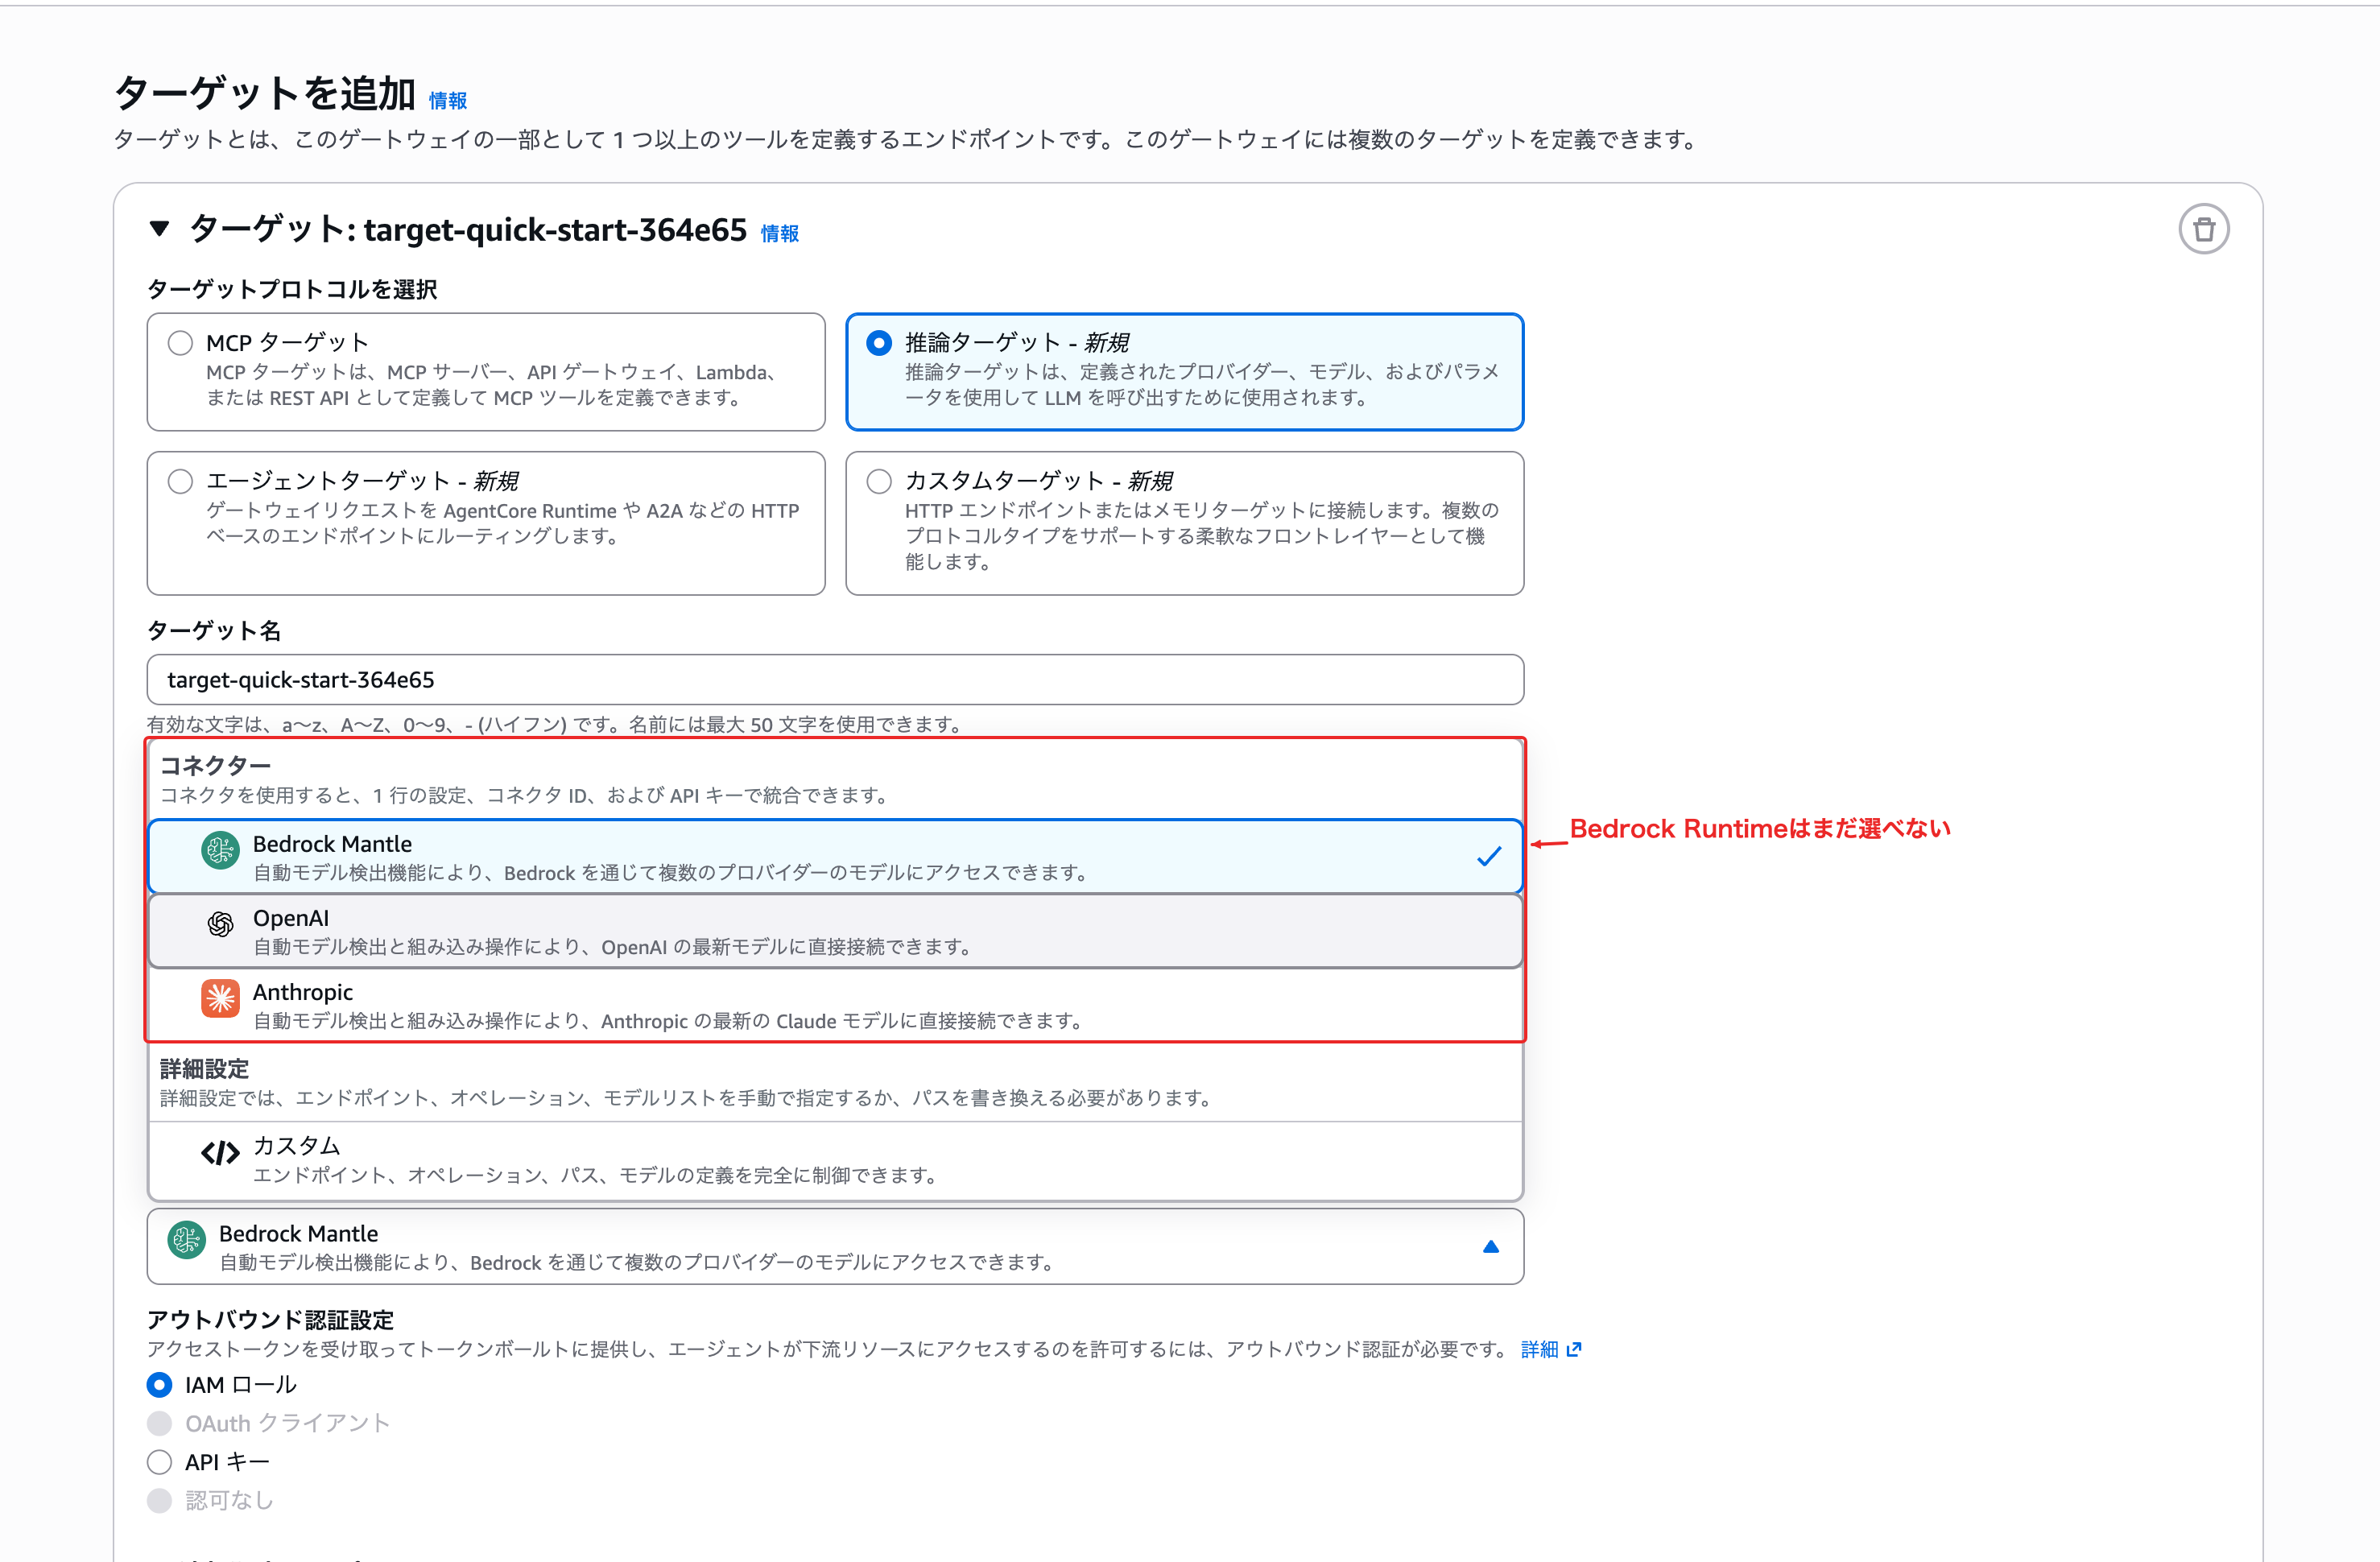
そのためSDKやCLIから作成します。boto3ならコネクタIDに bedrock-runtime を指定するだけでシンプルに作れます。
import boto3

client = boto3.client("bedrock-agentcore-control", region_name="us-east-1")
client.create_gateway_target(
    gatewayIdentifier="<GATEWAY_ID>",
    name="bedrock-runtime",
    credentialProviderConfigurations=[{"credentialProviderType": "GATEWAY_IAM_ROLE"}],
    targetConfiguration={"inference": {"connector": {"source": {"connectorId": "bedrock-runtime"}}}},
)
ルールの条件と動作
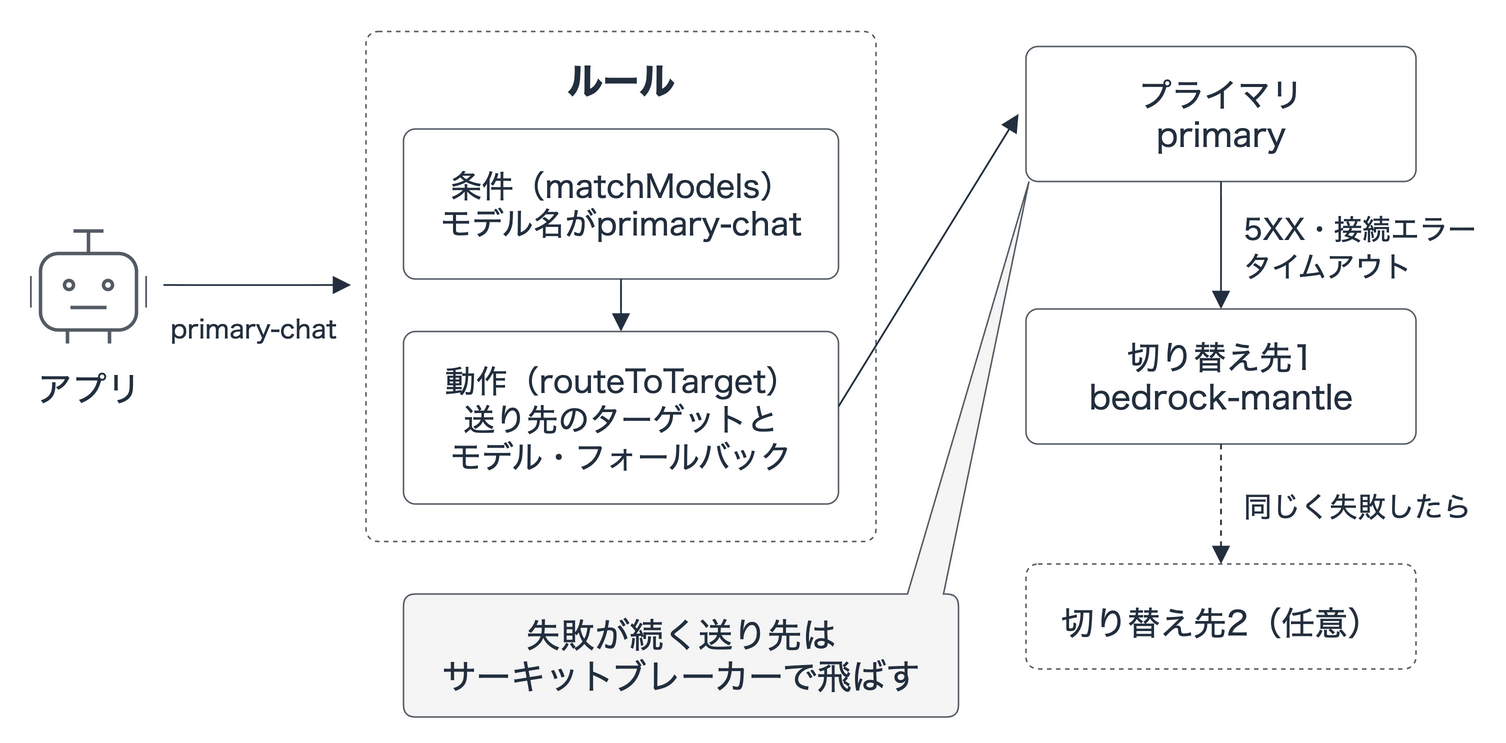
Gatewayのルールは条件(conditions)に合うリクエストへ動作(actions)を適用する仕組みです。
モデルでの振り分けとフォールバックの説明は下記のドキュメントに、各項目の詳しい仕様はAPIリファレンスにまとまっています。
モデル名で振り分ける条件
条件にmatchModelsが追加され、リクエストのモデル名でルールを適用できるようになりました。比較方法は完全一致の StringEquals か、* や ? を使える StringLike(こちらがデフォルト)から選べます。1つの条件に100個まで並べられて、どれか1つに一致すれば動作が実行されます。
conditions=[{
    "matchModels": {
        "anyOf": [
            {"value": "primary-chat", "operator": "StringEquals"},  # 完全一致
            {"value": "team-*"},  # operator を省略すると StringLike
        ]
    }
}]
送り先のモデルを差し替える
staticRoute(とweightedRouteの各振り分け先)に model が追加されました。指定するとリクエストのモデル名をこのモデルIDに差し替えてターゲットへ送ります。省略した場合はリクエストのモデル名がそのまま使われます。
actions=[{
    "routeToTarget": {
        "staticRoute": {
            "targetName": "bedrock-mantle",
            "model": "openai.gpt-oss-120b",  # このモデルIDに差し替えて送る
        }
    }
}]
フォールバック
同じく staticRoute と weightedRoute の各振り分け先に fallback が追加されました。
fallback の具体的な設定項目は下記のとおりです。
| 項目 | 内容 |
|---|---|
| targetFallback | プライマリが失敗したときに順番に試す切り替え先。1〜2個まで。ターゲット名と任意のモデルIDを指定する |
| triggerOn | 切り替える条件。省略すると5XX・接続エラー(CONNECTION_ERROR)・最初の1バイトのタイムアウト(FIRST_BYTE_TIMEOUT)・ルーティング不可(UNROUTABLE)で切り替える |
| firstByteTimeoutMilliseconds | 応答の最初の1バイトが届くまで待つ時間。50〜900,000ミリ秒。省略するとタイムアウトしない |
| circuitBreaker | 失敗が続く切り替え先を一時的に飛ばすかどうか。デフォルトは ENABLED |
triggerOnでは、どのHTTPステータスコードが返ったら切り替えるかを 429 のような個別の値か 5XX のような範囲で指定します。切り替え先ごとにも triggerOn とタイムアウトを書けます。
"staticRoute": {
    "targetName": "primary",
    "fallback": {
        "triggerOn": {
            "statusCodes": ["429", "5XX"],
            "errors": ["CONNECTION_ERROR", "FIRST_BYTE_TIMEOUT", "UNROUTABLE"],
        },
        "firstByteTimeoutMilliseconds": 3000,
        "circuitBreaker": {"mode": "ENABLED"},
        "targetFallback": [
            {"targetName": "bedrock-mantle", "model": "openai.gpt-oss-120b"},
        ],
    },
}
また、ドキュメントには次の点も書かれていました。
- ストリーミングで応答が返り始めた後は切り替えない
- Gatewayの呼び出し料金は試行ごとにかかる。プライマリで失敗してセカンダリで成功したリクエストは2回分になる
- どのターゲットが応答したかは呼び出し元には返らない。Gatewayが出力するルーティングのログには記録される
アップデート内容をふんわりと理解したところで早速試してみましょう!
前提
今回は下記の環境で試しました。
| 項目 | 内容 |
|---|---|
| リージョン | us-east-1(バージニア北部) |
| Python / パッケージ管理 | 3.14 / uv |
| boto3 | 1.43.118以降を想定(検証時はPyPIのミラーに未反映だったため、1.43.115に1.43.118のAPIモデルを重ねて実行) |
| Gateway | AgentCore Gateway(AWS_IAM認証) |
| プライマリ | 推論プロバイダーターゲット(障害を再現するLambda関数) |
| セカンダリ | 推論コネクタターゲット(Bedrock Mantle)、openai.gpt-oss-120b |
| InvokeModel用 | 推論コネクタターゲット(Bedrock Runtime)、Claude Haiku 4.5 |
プライマリのプロバイダーを本当にエラーにすることはできないので、OpenAI互換のChat Completionsを返すダミーのプロバイダーをLambda関数で作りました。環境変数で次の3つの状態を切り替えます。
| 状態 | 動作 |
|---|---|
| ok | 「primaryからの応答です」を返す |
| error | 503を返す |
| slow | 10秒待ってから応答する |
プライマリは固定の文言を返し、セカンダリのBedrockからはモデルの応答が返ります。返ってきた本文とモデル名でどちらが応答したかを判別できます。
検証環境の準備
作業用のプロジェクトを作成します。
uv init --no-readme agentcore-gw-fallback
cd agentcore-gw-fallback
uv python pin 3.14
uv add 'boto3>=1.43.118' requests
Gatewayのサービスロールには次の権限を付けます。Bedrock・Mantleの呼び出し権限と、Bedrock Runtimeコネクタがモデル一覧を取得するための bedrock:List* 権限、プライマリに付けるAPIキーをAgentCore Identityから取り出す権限です。Lambdaの実行ロールも作成します。
ACCOUNT_ID=$(aws sts get-caller-identity --query Account --output text)

# Gatewayのサービスロール
aws iam create-role \
  --role-name fallback-demo-gateway-role \
  --assume-role-policy-document "{
    \"Version\": \"2012-10-17\",
    \"Statement\": [{
      \"Effect\": \"Allow\",
      \"Principal\": {\"Service\": \"bedrock-agentcore.amazonaws.com\"},
      \"Action\": \"sts:AssumeRole\",
      \"Condition\": {\"StringEquals\": {\"aws:SourceAccount\": \"${ACCOUNT_ID}\"}}
    }]
  }"

aws iam put-role-policy \
  --role-name fallback-demo-gateway-role \
  --policy-name inference-permissions \
  --policy-document "{
    \"Version\": \"2012-10-17\",
    \"Statement\": [
      {
        \"Effect\": \"Allow\",
        \"Action\": [\"bedrock:InvokeModel\", \"bedrock:InvokeModelWithResponseStream\", \"bedrock:List*\"],
        \"Resource\": \"*\"
      },
      {
        \"Effect\": \"Allow\",
        \"Action\": \"bedrock-mantle:*\",
        \"Resource\": \"arn:aws:bedrock-mantle:*:${ACCOUNT_ID}:project/*\"
      },
      {
        \"Effect\": \"Allow\",
        \"Action\": [\"bedrock-agentcore:GetWorkloadAccessToken\", \"bedrock-agentcore:GetResourceApiKey\"],
        \"Resource\": \"*\"
      },
      {
        \"Effect\": \"Allow\",
        \"Action\": \"secretsmanager:GetSecretValue\",
        \"Resource\": \"arn:aws:secretsmanager:us-east-1:${ACCOUNT_ID}:secret:bedrock-agentcore-identity!*\"
      }
    ]
  }"

# プライマリを模したLambdaの実行ロール
aws iam create-role \
  --role-name fallback-demo-primary-role \
  --assume-role-policy-document '{
    "Version": "2012-10-17",
    "Statement": [{
      "Effect": "Allow",
      "Principal": {"Service": "lambda.amazonaws.com"},
      "Action": "sts:AssumeRole"
    }]
  }'

aws iam attach-role-policy \
  --role-name fallback-demo-primary-role \
  --policy-arn arn:aws:iam::aws:policy/service-role/AWSLambdaBasicExecutionRole
プライマリを模したLambda関数です。環境変数 MODE で状態を切り替えます。
import json
import os
import time

def handler(event, context):
    mode = os.environ.get("MODE", "ok")
    body = json.loads(event.get("body") or "{}")
    print(json.dumps({"mode": mode, "model": body.get("model"), "path": event.get("rawPath")}))

    if mode == "error":
        return {"statusCode": 503, "body": json.dumps({"error": {"message": "primary is unavailable"}})}
    if mode == "slow":
        time.sleep(10)

    return {
        "statusCode": 200,
        "headers": {"Content-Type": "application/json"},
        "body": json.dumps({
            "id": "chatcmpl-primary",
            "object": "chat.completion",
            "model": body.get("model"),
            "choices": [{
                "index": 0,
                "message": {"role": "assistant", "content": "primaryからの応答です"},
                "finish_reason": "stop",
            }],
        }),
    }
関数と関数URLを作成します。関数URLは認証なしで公開されるので検証後に必ず削除してください。
ACCOUNT_ID=$(aws sts get-caller-identity --query Account --output text)

(cd primary && zip -q ../primary.zip app.py)

aws lambda create-function \
  --function-name fallback-demo-primary \
  --runtime python3.13 \
  --handler app.handler \
  --timeout 15 \
  --role arn:aws:iam::${ACCOUNT_ID}:role/fallback-demo-primary-role \
  --zip-file fileb://primary.zip \
  --environment 'Variables={MODE=ok}' \
  --region us-east-1

aws lambda wait function-active-v2 --function-name fallback-demo-primary --region us-east-1

aws lambda create-function-url-config \
  --function-name fallback-demo-primary \
  --auth-type NONE \
  --region us-east-1

aws lambda add-permission \
  --function-name fallback-demo-primary \
  --statement-id public-url \
  --action lambda:InvokeFunctionUrl \
  --principal '*' \
  --function-url-auth-type NONE \
  --region us-east-1

aws lambda add-permission \
  --function-name fallback-demo-primary \
  --statement-id public-invoke \
  --action lambda:InvokeFunction \
  --principal '*' \
  --invoked-via-function-url \
  --region us-east-1
Gatewayと3つの推論ターゲットを作成します。プロバイダーターゲットは認証情報の設定が必須だったため、ダミーのAPIキーを登録して付けています(Lambda側では使いません)。プライマリは primary-chat というモデル名を扱うターゲットにしました。
import sys
import time

import boto3

PRIMARY_URL = sys.argv[1].rstrip("/")  # Lambda関数URL
account_id = boto3.client("sts").get_caller_identity()["Account"]
client = boto3.client("bedrock-agentcore-control", region_name="us-east-1")

gateway = client.create_gateway(
    name="fallback-demo-gateway",
    roleArn=f"arn:aws:iam::{account_id}:role/fallback-demo-gateway-role",
    protocolType="MCP",
    authorizerType="AWS_IAM",
)
gateway_id = gateway["gatewayId"]
print(gateway_id, gateway["gatewayUrl"])

while client.get_gateway(gatewayIdentifier=gateway_id)["status"] != "READY":
    time.sleep(5)

# プライマリに付けるAPIキー(検証用のダミー値)
api_key = client.create_api_key_credential_provider(
    name="fallback-demo-primary-key",
    apiKey="dummy-key",
)

# プライマリ:障害を再現するためのLambda(OpenAI互換のChat Completionsを返す)
client.create_gateway_target(
    gatewayIdentifier=gateway_id,
    name="primary",
    credentialProviderConfigurations=[
        {
            "credentialProviderType": "API_KEY",
            "credentialProvider": {
                "apiKeyCredentialProvider": {
                    "providerArn": api_key["credentialProviderArn"],
                    "credentialLocation": "HEADER",
                    "credentialParameterName": "Authorization",
                    "credentialPrefix": "Bearer ",
                }
            },
        }
    ],
    targetConfiguration={
        "inference": {
            "provider": {
                "endpoint": PRIMARY_URL,
                "operations": [
                    {"path": "/v1/chat/completions", "models": [{"model": "primary-chat"}]}
                ],
            }
        }
    },
)

# セカンダリ:Bedrock Mantleコネクタ
client.create_gateway_target(
    gatewayIdentifier=gateway_id,
    name="bedrock-mantle",
    credentialProviderConfigurations=[{"credentialProviderType": "GATEWAY_IAM_ROLE"}],
    targetConfiguration={"inference": {"connector": {"source": {"connectorId": "bedrock-mantle"}}}},
)

# InvokeModel用:Bedrock Runtimeコネクタ
client.create_gateway_target(
    gatewayIdentifier=gateway_id,
    name="bedrock-runtime",
    credentialProviderConfigurations=[{"credentialProviderType": "GATEWAY_IAM_ROLE"}],
    targetConfiguration={"inference": {"connector": {"source": {"connectorId": "bedrock-runtime"}}}},
)

# すべてのターゲットがREADYになるまで待つ
while True:
    statuses = {t["name"]: t["status"] for t in client.list_gateway_targets(gatewayIdentifier=gateway_id)["items"]}
    if all(status == "READY" for status in statuses.values()):
        break
    time.sleep(5)
print(statuses)
bash setup_iam.sh
bash deploy_primary.sh
uv run setup.py <Lambda関数URL>
Gatewayの /inference/v1/chat/completions へSigV4署名付きでリクエストし、ステータス・所要時間・応答したモデル名・本文の先頭を表示するスクリプトです。<GATEWAY_ID> は setup.py の出力に置き換えます。
import json
import sys
import time

import boto3
import requests
from botocore.auth import SigV4Auth
from botocore.awsrequest import AWSRequest

GATEWAY_URL = "https://<GATEWAY_ID>.gateway.bedrock-agentcore.us-east-1.amazonaws.com"
credentials = boto3.Session().get_credentials()

def call(model):
    body = {
        "model": model,
        "max_tokens": 512,
        "messages": [{"role": "user", "content": "こんにちは"}],
    }
    req = AWSRequest(
        method="POST",
        url=f"{GATEWAY_URL}/inference/v1/chat/completions",
        data=json.dumps(body),
        headers={"Content-Type": "application/json"},
    )
    SigV4Auth(credentials, "bedrock-agentcore", "us-east-1").add_auth(req)
    start = time.time()
    res = requests.post(req.url, data=req.body, headers=dict(req.headers), timeout=60)
    elapsed = time.time() - start
    try:
        data = res.json()
        summary = data.get("model"), (data["choices"][0]["message"]["content"] or "")[:30]
    except Exception:
        summary = res.text[:120]
    print(f"{res.status_code} {elapsed:5.2f}s {summary}")

if __name__ == "__main__":
    model = sys.argv[1]
    for _ in range(int(sys.argv[2]) if len(sys.argv) > 2 else 1):
        call(model)
プライマリの状態を切り替えるスクリプトと、プライマリのLambdaが呼ばれた回数をログから数えるスクリプトです。
# 使い方: bash set_mode.sh ok|error|slow
aws lambda update-function-configuration \
  --function-name fallback-demo-primary \
  --environment "Variables={MODE=$1}" \
  --region us-east-1 > /dev/null
aws lambda wait function-updated-v2 --function-name fallback-demo-primary --region us-east-1
# 使い方: bash count_primary.sh <開始のUNIX時刻> <終了のUNIX時刻>
aws logs filter-log-events \
  --log-group-name /aws/lambda/fallback-demo-primary \
  --start-time $(( $1 * 1000 )) \
  --end-time $(( $2 * 1000 )) \
  --filter-pattern '"mode"' \
  --region us-east-1 \
  --query 'length(events)'
準備ができたら試していきましょう!
Bedrock SDKのInvokeModelでGatewayを呼ぶ
まずはInvokeModelを試してみましょう!
boto3のbedrock-runtimeクライアントを作るときに endpoint_url をGatewayの /inference に向ければOKです。
import json
import sys

import boto3

from call import GATEWAY_URL

# 接続先をGatewayの/inferenceに向けるだけ。認証はいつものSigV4
client = boto3.client(
    "bedrock-runtime",
    region_name="us-east-1",
    endpoint_url=f"{GATEWAY_URL}/inference",
)

CLAUDE = "us.anthropic.claude-haiku-4-5-20251001-v1:0"
claude_body = json.dumps({
    "anthropic_version": "bedrock-2023-05-31",
    "max_tokens": 128,
    "messages": [{"role": "user", "content": "こんにちは。一言で返して"}],
})

def invoke():
    response = client.invoke_model(modelId=CLAUDE, body=claude_body, contentType="application/json")
    data = json.loads(response["body"].read())
    print(data["model"], data["content"][0]["text"])

def stream():
    body = json.dumps({
        "anthropic_version": "bedrock-2023-05-31",
        "max_tokens": 256,
        "messages": [{"role": "user", "content": "AgentCore Gatewayについて3文で説明して"}],
    })
    response = client.invoke_model_with_response_stream(
        modelId=CLAUDE, body=body, contentType="application/json"
    )
    for event in response["body"]:
        chunk = json.loads(event["chunk"]["bytes"])
        if chunk["type"] == "content_block_delta":
            print(repr(chunk["delta"]["text"]))
        else:
            print(chunk["type"])

if __name__ == "__main__":
    {"invoke": invoke, "stream": stream}[sys.argv[1]]()
Claude Haiku 4.5をInvokeModelとInvokeModelWithResponseStreamで呼びます。
uv run invoke_model.py invoke
uv run invoke_model.py stream
anthropic.claude-haiku-4-5-20251001-v1:0 こんにちは!
'ータの'
'流'
'通'
'を効'
'率的'
'に制'
'御します。企'
'業が'
(中略)
'運用性を'
'実'
'現します。'
content_block_stop
message_delta
message_stop
どちらもそのまま動きました!Gatewayで集約できるようになっていますね。
次にフォールバック機能を試してみましょうか。
ルールなしでプライマリが失敗するとどうなるか
まずは比較のために、ルールを作らずにプライマリを503の状態にして呼び出します。
bash set_mode.sh error
uv run call.py primary-chat 3
503  1.21s {"error": {"message": "primary is unavailable"}}
503  1.08s {"error": {"message": "primary is unavailable"}}
503  0.87s {"error": {"message": "primary is unavailable"}}
デフォルトのルーティングではリクエストが primary-chat を扱うターゲットへそのまま送られるため、そのまま503が返ってきます。
ここをフォールバックでどう変わるか確認してみましょう!
matchModelsとフォールバックのルールを作る
primary-chat へのリクエストをプライマリへ送り、失敗したらBedrock Mantleの openai.gpt-oss-120b へ切り替えるルールを作ります。
import time

import boto3

client = boto3.client("bedrock-agentcore-control", region_name="us-east-1")

rule = client.create_gateway_rule(
    gatewayIdentifier="<GATEWAY_ID>",
    priority=100,
    description="primary-chatが失敗したらBedrockのgpt-oss-120bへ切り替える",
    conditions=[
        {"matchModels": {"anyOf": [{"value": "primary-chat", "operator": "StringEquals"}]}}
    ],
    actions=[
        {
            "routeToTarget": {
                "staticRoute": {
                    "targetName": "primary",
                    "fallback": {
                        "targetFallback": [
                            {"targetName": "bedrock-mantle", "model": "openai.gpt-oss-120b"}
                        ],
                    },
                }
            }
        }
    ],
)
while client.get_gateway_rule(gatewayIdentifier="<GATEWAY_ID>", ruleId=rule["ruleId"])["status"] != "ACTIVE":
    time.sleep(5)
print(rule["ruleId"], "ACTIVE")
プライマリ側はモデルを指定していないので、リクエストの primary-chat がそのまま送られます。切り替え先には model を指定してBedrock側で扱えるモデルIDに差し替えています。triggerOnは省略したので、デフォルトの条件に含まれる503(5XX)で切り替わります。
uv run create_rule.py
950fdf64-bfef-4309-9b76-9bbf9b04c263 ACTIVE
ACTIVE になったら、プライマリを503のままにして同じリクエストを送ってみます。
uv run call.py primary-chat 3
200  1.74s ('openai.gpt-oss-120b', 'こんにちは!ご用件や質問がありましたら、遠慮なくどうぞ。😊')
200  1.57s ('openai.gpt-oss-120b', 'こんにちは!ご用件や質問がありましたら、何でもお知らせくださ')
200  1.93s ('openai.gpt-oss-120b', 'こんにちは!今日はどのようなお手伝いができるでしょうか?🙂')
切り替わりましたね!呼び出し側のコードは何も変えていませんが、フォールバック先のgpt-oss-120bから200で応答が返ってきました。
プライマリを ok に戻すとすぐ元の応答に戻りました。
bash set_mode.sh ok
uv run call.py primary-chat 2
200  1.39s ('primary-chat', 'primaryからの応答です')
200  0.90s ('primary-chat', 'primaryからの応答です')
プライマリに反応がない場合はタイムアウトで切り替える
プロバイダーの障害はいつも5XXを返すとは限らず、応答が返らないまま待たされるケースも想定されます。そこでプライマリを10秒待たせる状態にして、最初の1バイトを3秒待っても来なければ切り替える設定を試します。
ルールの更新では作成時の設定に firstByteTimeoutMilliseconds と circuitBreaker を追加して呼び出します。サーキットブレーカーは後で比較するので引数で切り替えられるようにしました。
import sys
import time

import boto3

client = boto3.client("bedrock-agentcore-control", region_name="us-east-1")
GATEWAY_ID = "<GATEWAY_ID>"
RULE_ID = sys.argv[1]
breaker = sys.argv[2] if len(sys.argv) > 2 else "ENABLED"

client.update_gateway_rule(
    gatewayIdentifier=GATEWAY_ID,
    ruleId=RULE_ID,
    priority=100,
    description="primary-chatが失敗・3秒無応答ならBedrockのgpt-oss-120bへ切り替える",
    conditions=[
        {"matchModels": {"anyOf": [{"value": "primary-chat", "operator": "StringEquals"}]}}
    ],
    actions=[
        {
            "routeToTarget": {
                "staticRoute": {
                    "targetName": "primary",
                    "fallback": {
                        "firstByteTimeoutMilliseconds": 3000,  # 追加
                        "circuitBreaker": {"mode": breaker},  # 追加
                        "targetFallback": [
                            {"targetName": "bedrock-mantle", "model": "openai.gpt-oss-120b"}
                        ],
                    },
                }
            }
        }
    ],
)
time.sleep(5)
while client.get_gateway_rule(gatewayIdentifier=GATEWAY_ID, ruleId=RULE_ID)["status"] != "ACTIVE":
    time.sleep(5)
print("ACTIVE")
まずはサーキットブレーカーを無効にして試します。
uv run update_rule.py <RULE_ID> DISABLED
bash set_mode.sh slow
uv run call.py primary-chat 3
200  4.57s ('openai.gpt-oss-120b', 'こんにちは!今日はどんなことをお手伝いできますか?😊')
200  4.73s ('openai.gpt-oss-120b', 'こんにちは!どのようなお手伝いが必要ですか?お気軽に教えてく')
200  4.73s ('openai.gpt-oss-120b', 'こんにちは!本日はいかがでしょうか?何かお手伝いできることが')
3秒でプライマリを打ち切り、約4.7秒でセカンダリの応答が返りました!
サーキットブレーカーの有無を比べる
プライマリからしばらく反応がない状況で毎回3秒待ちたくはないですよね。そこでサーキットブレーカーを有効にすると、失敗が続くターゲットをしばらく飛ばして最初からセカンダリへ送るようになります。
同じ遅延障害の状態で20回続けて呼び出し、所要時間とプライマリのLambdaが呼ばれた回数を比べてみました。
import sys
import time

import call

results = []
start = time.time()
for i in range(int(sys.argv[1])):
    t = time.time()
    call.call("primary-chat")
    results.append(time.time() - t)
print(f"合計 {time.time() - start:.1f}s / 1回あたり " + " ".join(f"{r:.1f}" for r in results))
# 無効のまま20回呼び出し、ログの取り込みを待ってからその区間の呼び出し回数を数える
START=$(date +%s); uv run breaker_test.py 20; END=$(date +%s)
sleep 60
bash count_primary.sh $START $END

# 有効にして同じことを行う
uv run update_rule.py <RULE_ID> ENABLED
START=$(date +%s); uv run breaker_test.py 20; END=$(date +%s)
sleep 60
bash count_primary.sh $START $END
合計 93.5s / 1回あたり 4.2 4.5 4.7 4.5 4.7 4.9 4.7 4.6 4.3 4.6 5.2 4.6 5.7 4.5 4.8 4.5 4.7 5.1 4.4 4.4
20
合計 70.1s / 1回あたり 4.8 4.9 5.1 4.4 4.5 4.7 4.5 4.4 4.5 4.6 5.0 1.5 1.3 3.1 1.4 1.2 2.7 1.3 1.3 4.7
12
| プライマリが呼ばれた回数 | 20回の合計時間 | |
|---|---|---|
| サーキットブレーカー無効 | 20回 | 93.5秒 |
| サーキットブレーカー有効 | 12回 | 70.1秒 |
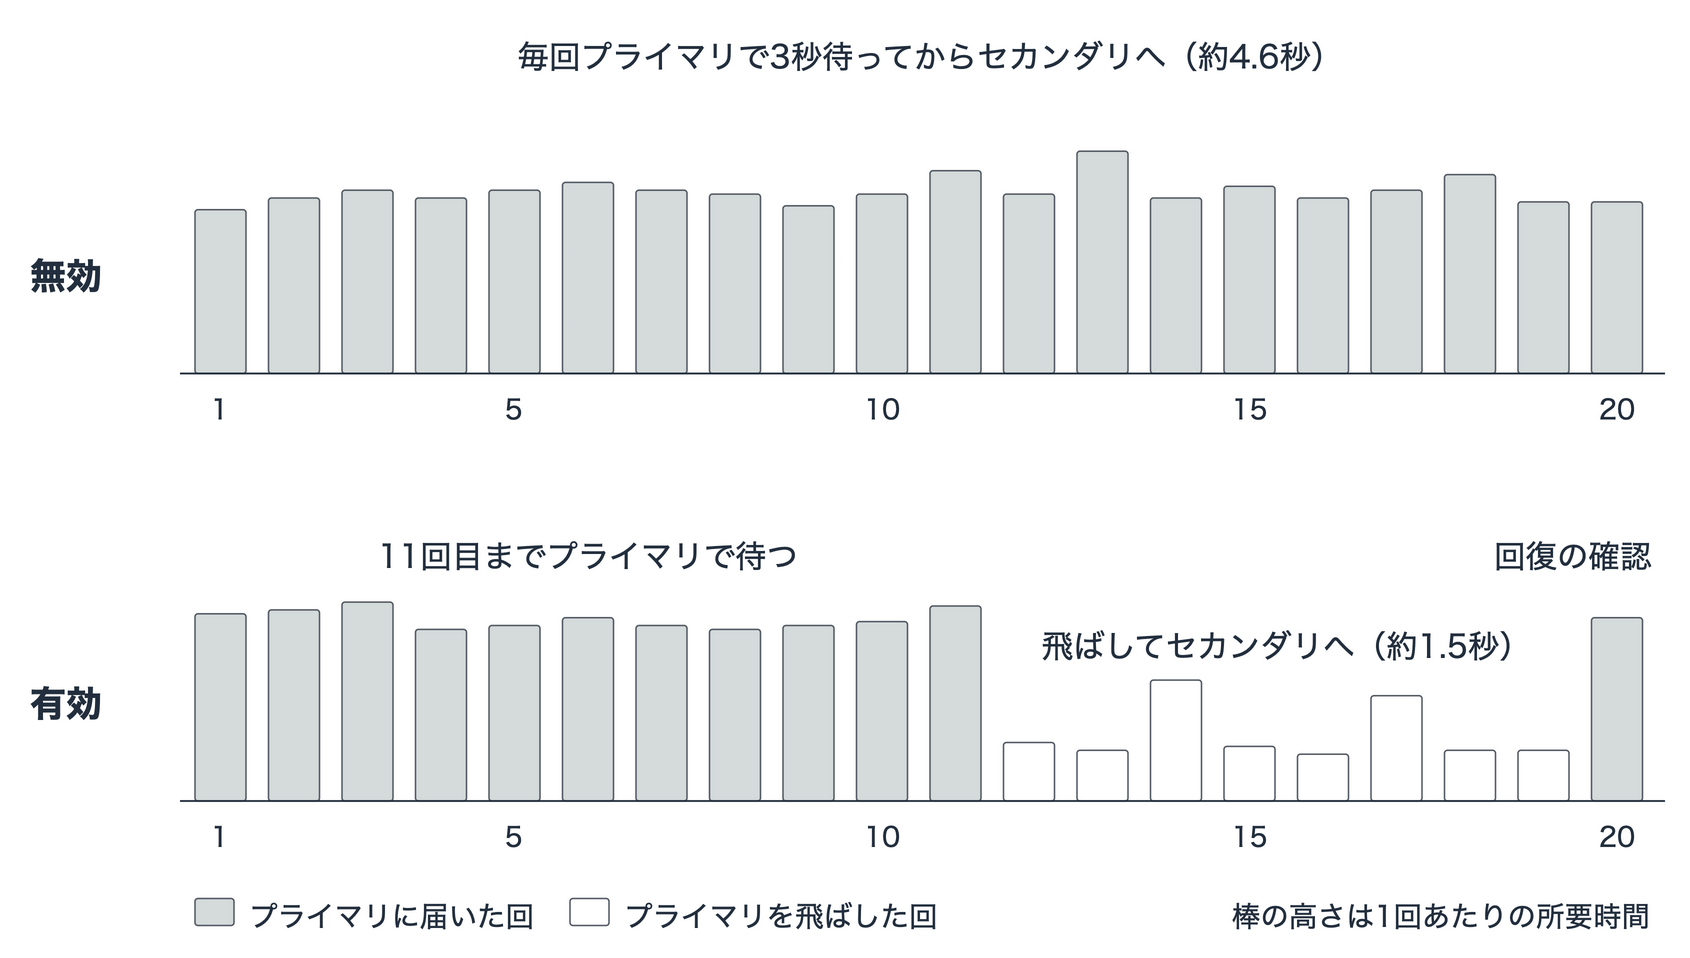
サーキットブレーカーが機能していますね!
ちなみに何回失敗すると開くのかはドキュメントに記載がなく設定もできませんでした・・・
ある程度失敗が続くと開く仕組みのようで、今回は10〜11回ほどでした。
ワイルドカードとモデルの差し替えで別名を作る
フォールバックとは別にmatchModelsの StringLike とモデルの差し替えを組み合わせると、どのターゲットにもない名前をBedrockのモデルに対応付けられます。team- で始まるモデル名をすべてgpt-oss-120bで処理するルールを作ってみます。
その前に、サーキットブレーカーの検証で slow のままのプライマリを ok に戻し、正常な応答に戻ったことを確認しておきます。
bash set_mode.sh ok
uv run call.py primary-chat
200 1.25s ('primary-chat', 'primaryからの応答です')
import time

import boto3

client = boto3.client("bedrock-agentcore-control", region_name="us-east-1")

rule = client.create_gateway_rule(
    gatewayIdentifier="<GATEWAY_ID>",
    priority=50,
    description="team-で始まるモデル名をBedrockのgpt-oss-120bで処理する",
    conditions=[
        {"matchModels": {"anyOf": [{"value": "team-*", "operator": "StringLike"}]}}
    ],
    actions=[
        {
            "routeToTarget": {
                "staticRoute": {
                    "targetName": "bedrock-mantle",
                    "model": "openai.gpt-oss-120b",
                }
            }
        }
    ],
)
while client.get_gateway_rule(gatewayIdentifier="<GATEWAY_ID>", ruleId=rule["ruleId"])["status"] != "ACTIVE":
    time.sleep(5)
print(rule["ruleId"], "ACTIVE")
ルールを作る前後でリクエストを送った結果を比較してみます。
404 0.79s {"error":{"message":"Model 'team-standard' not found on any target.","type":"not_found_error","code":"404"}}
team-standard: 200  2.64s ('openai.gpt-oss-120b', 'こんにちは!今日はどのようなお手伝いが必要ですか?気になるこ')
team-fast:     200  1.31s ('openai.gpt-oss-120b', 'こんにちは!ご機嫌いかがですか?何かお手伝いできることがあれ')
primary-chat:  200  0.98s ('primary-chat', 'primaryからの応答です')
ルール作成前は「どのターゲットにもない」と404でしたが、作成後は team- で始まる名前がgpt-oss-120bで処理されました。条件に合わない primary-chat はこれまでどおりプライマリが応答しています。
アプリには team-standard のような別名を指定しておき、実際のモデルIDはGatewayのルールで決めるという使い方ができそうです。モデルを入れ替えるときにアプリの設定を変えなくて済むのは嬉しいですね!使えそうです!
注意点
ほかにもストリーミングやレート制限、Policyとの組み合わせを別途試してみました。以下は今回の検証環境で確認した挙動です。設定と詳しい検証結果は別の記事にまとめる予定です。
- ストリーミングでも、プライマリが503ならセカンダリに切り替わってそのままストリーミングで届く。ただしプライマリが返し始めた後に落ちると切り替わらず、途中で終わる(今回はエラーのイベントも届かなかった)
- Gateway自身のレート制限による429や、Policyの拒否による403ではフォールバックしない。triggerOnに入れても同じ
- レート制限とPolicyは切り替え先でも評価される。セカンダリのターゲットを制限していると、プライマリの503の後にセカンダリで止まる
- Policy EngineをENFORCEで付けると、ストリーミングの応答が最後にまとめて届いた
- InvokeModelに guardrailIdentifier を付けると、変換が入る経路(Bedrock以外のプロバイダー)は400で拒否される
- Converse APIはGateway経由だと400だった。対応しているのはInvokeModelとInvokeModelWithResponseStreamの2つ
後片付け
ルール・ターゲット・Gateway・APIキーを削除してから、Lambda関数とIAMロールを削除します。Lambdaの関数URLは認証なしで公開しているので忘れずに削除しましょう。
import time

import boto3

client = boto3.client("bedrock-agentcore-control", region_name="us-east-1")
GATEWAY_ID = "<GATEWAY_ID>"

for rule in client.list_gateway_rules(gatewayIdentifier=GATEWAY_ID)["gatewayRules"]:
    client.delete_gateway_rule(gatewayIdentifier=GATEWAY_ID, ruleId=rule["ruleId"])
for target in client.list_gateway_targets(gatewayIdentifier=GATEWAY_ID)["items"]:
    client.delete_gateway_target(gatewayIdentifier=GATEWAY_ID, targetId=target["targetId"])
while client.list_gateway_targets(gatewayIdentifier=GATEWAY_ID)["items"]:
    time.sleep(5)
client.delete_gateway(gatewayIdentifier=GATEWAY_ID)
client.delete_api_key_credential_provider(name="fallback-demo-primary-key")
aws lambda delete-function --function-name fallback-demo-primary --region us-east-1
aws logs delete-log-group --log-group-name /aws/lambda/fallback-demo-primary --region us-east-1

aws iam delete-role-policy --role-name fallback-demo-gateway-role --policy-name inference-permissions
aws iam delete-role --role-name fallback-demo-gateway-role
aws iam detach-role-policy --role-name fallback-demo-primary-role \
  --policy-arn arn:aws:iam::aws:policy/service-role/AWSLambdaBasicExecutionRole
aws iam delete-role --role-name fallback-demo-primary-role
uv run cleanup.py
bash cleanup.sh
おわりに
またしてもGatewayの幅が広がったアップデートでしたね!
フォールバックや振り分けはGatewayらしくいい機能なんじゃないでしょうか!
本記事が少しでも参考になれば幸いです。最後までご覧いただきありがとうございました!