[小ネタ] Strands AgentsからAgentCore Gatewayの推論ターゲットを呼び出してみた

はじめに
こんにちは、ラーメンが好きなコンサル部の神野です。
Strands AgentsからAgentCore Gatewayの推論ターゲットを使ってみたいと思ったことはないですか? 私はふとした瞬間に使ってみたいと思いました!
Strands AgentsはデフォルトでConverse APIを使用するものの、推論ターゲットはConverse APIに対応していないのでそのままでは使えません。ただGatewayにLLMを集約したなら作るAIエージェントもそこから呼び出したいですよね・・・!
そこで今回は小ネタとして、AnthropicModelとOpenAIResponsesModelから呼び出してみます。
ちなみに、推論ターゲットに関する内容は以前の記事で紹介しているので、必要に応じて合わせてご参照ください!
それではやっていきましょう!
構成
今回の構成はこんな感じです。
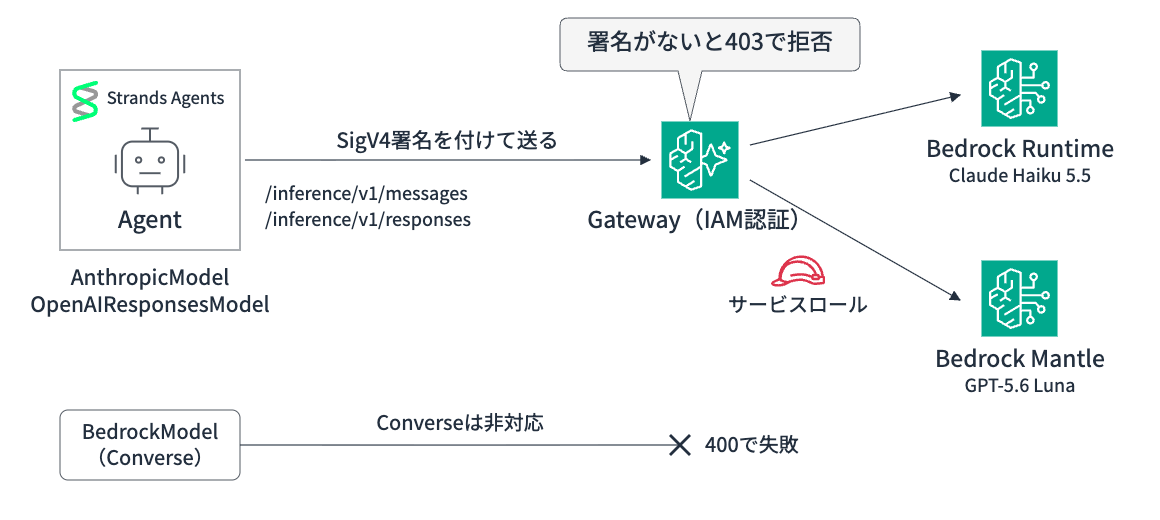
Strandsのモデルクラスが使うHTTPクライアントにSigV4署名を付ける処理を差し込み、Gatewayの推論エンドポイントへ送ります。GatewayにはBedrock RuntimeとBedrock Mantleの2つのターゲットを設定し、サービスロールで呼び出します。
Haiku 5.5はRuntimeターゲット、GPT-5.6 LunaはMantleターゲットから呼び出します。
公式ドキュメントにも、推論ターゲットはOpenAI SDKやAnthropic SDKからそのまま使えると書かれています。Strandsのこの2つのモデルクラスは中で各SDKを使っているので、接続先と認証さえ合わせれば動くはずです!
前提
今回は下記の環境で試しました。
| 項目 | 内容 |
|---|---|
| リージョン | us-east-1(バージニア北部) |
| Python / パッケージ管理 | 3.13 / uv |
| strands-agents | 1.62.0 |
| anthropic / openai | 0.125.0 / 2.54.0 |
| boto3 | 1.43.118 |
| Gateway | AgentCore Gateway(AWS_IAM認証) |
| ターゲット | 推論コネクタターゲット(Bedrock Runtime、Bedrock Mantle) |
| モデル | Claude Haiku 5.5(us.anthropic.claude-haiku-5-5)、GPT-5.6 Luna(openai.gpt-5.6-luna) |
事前に検証環境は作っておきましょう!
スクリプトを実行するIAMユーザーまたはロールには、対象Gatewayへの bedrock-agentcore:InvokeGateway を許可しておきます。
検証環境の準備
作業用のプロジェクトを作成します。
uv init --python 3.13 strands-gw-inference
cd strands-gw-inference
uv add 'strands-agents[anthropic,openai]==1.62.0' 'boto3>=1.43.118' httpx
GatewayのサービスロールにはBedrockとMantleの呼び出し権限を付けます。Bedrock Runtimeのコネクタはモデル一覧の取得に bedrock:List* も使います。
ACCOUNT_ID=$(aws sts get-caller-identity --query Account --output text)

aws iam create-role \
  --role-name strands-gw-inference-role \
  --assume-role-policy-document "{
    \"Version\": \"2012-10-17\",
    \"Statement\": [{
      \"Effect\": \"Allow\",
      \"Principal\": {\"Service\": \"bedrock-agentcore.amazonaws.com\"},
      \"Action\": \"sts:AssumeRole\",
      \"Condition\": {\"StringEquals\": {\"aws:SourceAccount\": \"${ACCOUNT_ID}\"}}
    }]
  }"

aws iam put-role-policy \
  --role-name strands-gw-inference-role \
  --policy-name inference \
  --policy-document "{
    \"Version\": \"2012-10-17\",
    \"Statement\": [
      {
        \"Effect\": \"Allow\",
        \"Action\": [\"bedrock:InvokeModel\", \"bedrock:InvokeModelWithResponseStream\", \"bedrock:List*\"],
        \"Resource\": \"*\"
      },
      {
        \"Effect\": \"Allow\",
        \"Action\": \"bedrock-mantle:*\",
        \"Resource\": \"arn:aws:bedrock-mantle:*:${ACCOUNT_ID}:project/*\"
      }
    ]
  }"
GatewayとBedrock Runtime・Bedrock Mantleのコネクタターゲットを作成します。最後に表示されるURLを以降のスクリプトで使います。
import time

import boto3

account_id = boto3.client("sts").get_caller_identity()["Account"]
client = boto3.client("bedrock-agentcore-control", region_name="us-east-1")

gateway = client.create_gateway(
    name="strands-inference-gateway",
    roleArn=f"arn:aws:iam::{account_id}:role/strands-gw-inference-role",
    protocolType="MCP",
    authorizerType="AWS_IAM",
)
gateway_id = gateway["gatewayId"]
while client.get_gateway(gatewayIdentifier=gateway_id)["status"] != "READY":
    time.sleep(5)

# Bedrock Runtime と Bedrock Mantle のコネクタターゲットを設定する
for name in ("bedrock-runtime", "bedrock-mantle"):
    target = client.create_gateway_target(
        gatewayIdentifier=gateway_id,
        name=name,
        credentialProviderConfigurations=[{"credentialProviderType": "GATEWAY_IAM_ROLE"}],
        targetConfiguration={"inference": {"connector": {"source": {"connectorId": name}}}},
    )
    while (
        client.get_gateway_target(gatewayIdentifier=gateway_id, targetId=target["targetId"])["status"]
        != "READY"
    ):
        time.sleep(5)

print(gateway["gatewayUrl"].removesuffix("/mcp"))
bash setup_iam.sh
uv run setup.py
export GATEWAY_URL=<setup.pyが表示したURL>
環境ができたので試してみましょう!
SigV4署名を付けるHTTPクライアント
Anthropic SDKとOpenAI SDKはどちらもhttpxで通信しているので、httpxのAuthとして署名処理を作ります。あわせてSDKのクライアントがクローズされてもHTTPクライアントはクローズしない KeepOpenAsyncClient を用意し、署名付きのHTTPクライアントはこれで作ります。
クローズしない理由は後ほど説明します!
import boto3
import httpx
from botocore.auth import SigV4Auth
from botocore.awsrequest import AWSRequest

class GatewaySigV4Auth(httpx.Auth):
    """Gatewayへのリクエストに SigV4 署名を付ける httpx の Auth"""

    requires_request_body = True

    def __init__(self, region: str = "us-east-1"):
        self.region = region
        self.session = boto3.Session()

    def auth_flow(self, request: httpx.Request):
        # SDK が付ける API キー用のヘッダーは Gateway では使わないので外す
        for name in ("authorization", "x-api-key"):
            request.headers.pop(name, None)

        aws_request = AWSRequest(
            method=request.method,
            url=str(request.url),
            data=request.content,
            headers={"content-type": request.headers.get("content-type", "application/json")},
        )
        credentials = self.session.get_credentials().get_frozen_credentials()
        SigV4Auth(credentials, "bedrock-agentcore", self.region).add_auth(aws_request)
        request.headers.update(dict(aws_request.headers))
        yield request

class KeepOpenAsyncClient(httpx.AsyncClient):
    """SDK のクライアントがクローズされても、HTTP クライアントはクローズせずに使い続ける"""

    async def aclose(self) -> None:
        # SDK がクローズしようとしても何もしない
        pass

    async def close_for_real(self) -> None:
        # 使い終わったら自分で呼んでクローズする
        await super().aclose()

def signed_http_client() -> KeepOpenAsyncClient:
    return KeepOpenAsyncClient(auth=GatewaySigV4Auth())
どちらのSDKもAPIキーを指定しないとエラーになるので、ダミーの値を渡しておきます。Anthropic SDKはこのダミーの値を x-api-key ヘッダーに、OpenAI SDKは Authorization ヘッダーに入れて送信します。
Gatewayの認証にはSigV4署名を入れた Authorization ヘッダーを使うので、SDKが付けたこれらのヘッダーは署名の前に外しています。
まずはAnthropicModelから呼び出しを試してみます!
AnthropicModelから呼び出す
一応エージェントには天気を返すダミーのツールを持たせて天気を質問する想定とします。
from strands import tool

@tool
def get_weather(city: str) -> str:
    """指定した都市の天気を返します"""
    return f"{city}は晴れ、気温は18度です"
AnthropicModelではclient_argsに接続先と署名付きのHTTPクライアントを渡します。Anthropic SDKは base_url の後ろに /v1/messages を付けるので、base_url はGatewayの /inference までを指定します。
Haiku 5.5は us.anthropic.claude-haiku-5-5 で呼び出します。
import os

from strands import Agent
from strands.models.anthropic import AnthropicModel

from sigv4_auth import signed_http_client
from tools import get_weather

GATEWAY_URL = os.environ["GATEWAY_URL"]

model = AnthropicModel(
    client_args={
        "base_url": f"{GATEWAY_URL}/inference",
        "api_key": "unused",
        "http_client": signed_http_client(),
    },
    model_id="us.anthropic.claude-haiku-5-5",
    max_tokens=1024,
)

agent = Agent(model=model, tools=[get_weather])
agent("東京と大阪の天気を教えて")
uv run agent_claude.py
Tool #1: get_weather

Tool #2: get_weather
東京と大阪の天気は、どちらも晴れで、気温は18度です。
ツールを2回呼んでから回答していますね! Strandsは応答をストリーミングで受け取っているので、ストリーミングもGateway経由でそのまま動いています!
次にOpenAIのモデルも試してみます!
OpenAIResponsesModelから呼び出す
GPT-5.6 LunaはResponses APIで呼び出します。
StrandsではOpenAIResponsesModelを使います。OpenAI SDKは base_url の後ろに /responses を付けるので、base_url は /inference/v1 までにします。
import asyncio
import os

from strands import Agent
from strands.models.openai_responses import OpenAIResponsesModel

from sigv4_auth import signed_http_client
from tools import get_weather

GATEWAY_URL = os.environ["GATEWAY_URL"]

async def main():
    http_client = signed_http_client()
    model = OpenAIResponsesModel(
        client_args={
            "base_url": f"{GATEWAY_URL}/inference/v1",
            "api_key": "unused",
            "http_client": http_client,
        },
        model_id="openai.gpt-5.6-luna",
    )
    agent = Agent(model=model, tools=[get_weather])
    try:
        await agent.invoke_async("東京と大阪の天気を教えて")
    finally:
        # エージェントを使い終わったら HTTP クライアントをクローズする
        await http_client.close_for_real()

asyncio.run(main())
uv run agent_gpt.py
Tool #1: get_weather

Tool #2: get_weather
- 東京:晴れ、18℃
- 大阪:晴れ、18℃
こちらもツールを2回呼んで回答できました!
補足 HTTPクライアントをクローズしない理由
なぜCloseしていないかをここで少し深ぼってみます。
署名だけ付けた普通の httpx.AsyncClient を渡すと失敗するのです・・・
agent_gpt_closed.py
import os

import httpx
from strands import Agent
from strands.models.openai_responses import OpenAIResponsesModel

from sigv4_auth import GatewaySigV4Auth
from tools import get_weather

GATEWAY_URL = os.environ["GATEWAY_URL"]

# 比較用:普通の httpx.AsyncClient に署名だけ付けて渡す
model = OpenAIResponsesModel(
    client_args={
        "base_url": f"{GATEWAY_URL}/inference/v1",
        "api_key": "unused",
        "http_client": httpx.AsyncClient(auth=GatewaySigV4Auth()),
    },
    model_id="openai.gpt-5.6-luna",
)

agent = Agent(model=model, tools=[get_weather])
agent("東京と大阪の天気を教えて")
Tool #1: get_weather
Tool #2: get_weather
    raise RuntimeError("Cannot send a request, as the client has been closed.")
RuntimeError: Cannot send a request, as the client has been closed.
ツールを呼ぶところまでは進み、ツールの結果を返す2回目のリクエストで「クライアントがクローズされている」エラーになりました。
原因はOpenAIResponsesModelがclient_argsを扱う仕組みにあります。今回使用したStrands Agents 1.62.0ではclient_argsからリクエストのたびにOpenAIクライアントを作り使い終わるとクローズしています。
async with openai.AsyncOpenAI(**self._resolve_client_args()) as client:
    try:
        response = await client.responses.create(**request)
OpenAIクライアントは毎回新しく作られますが、client_argsに入れたHTTPクライアントは同じものが毎回渡されます。OpenAIクライアントをクローズすると中のHTTPクライアントもクローズされるので、2回目のリクエストではクローズ済みのHTTPクライアントが渡されて失敗していました。
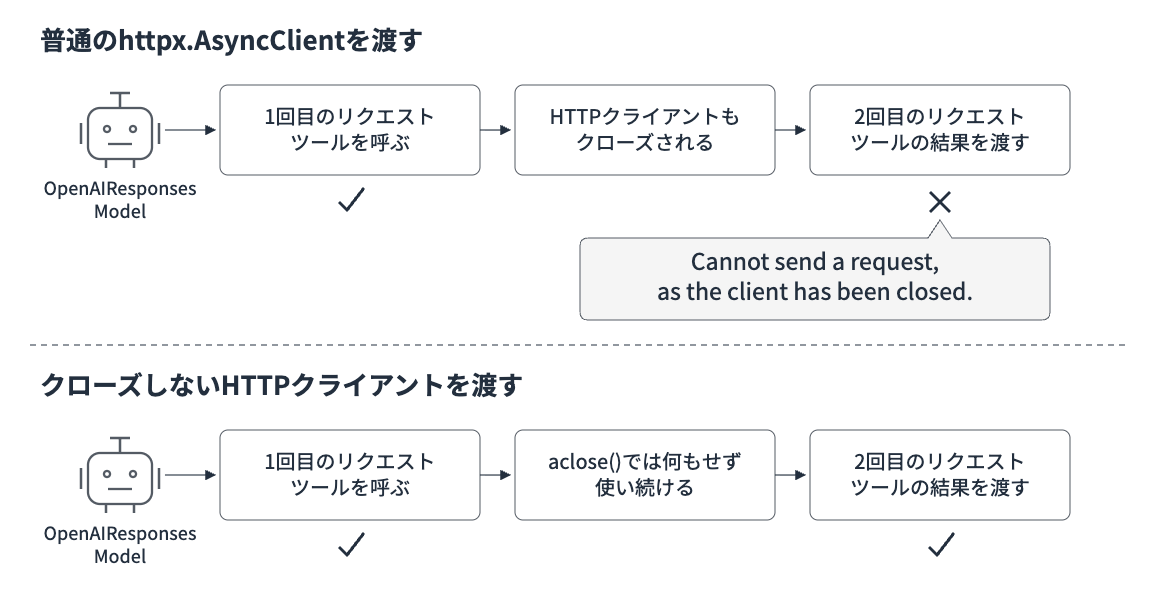
そこでOpenAIResponsesModelにはOpenAIクライアントを直接渡す引数がないので、HTTPクライアント側でクローズしないようにしました!
KeepOpenAsyncClient は aclose() で何もしないので、同じHTTPクライアントを2回目以降も使い続けられます。その代わりSDK経由ではクローズできなくなるので、最後にクローズするための close_for_real() を別に用意しました。
ちなみにAnthropicModelはモデルの作成時にクライアントを1回だけ作って使い続けるので、クローズしない作りにしなくても動きます。
複数のモデルをまとめて使うなら
Gatewayにモデルを集約するとStrands側も1つの書き方でまとめたくなりますよね・・・!!
今回はRuntimeとMantleの2つのターゲットがあるので、両方を活かしてどう組むとよいかを試しました。
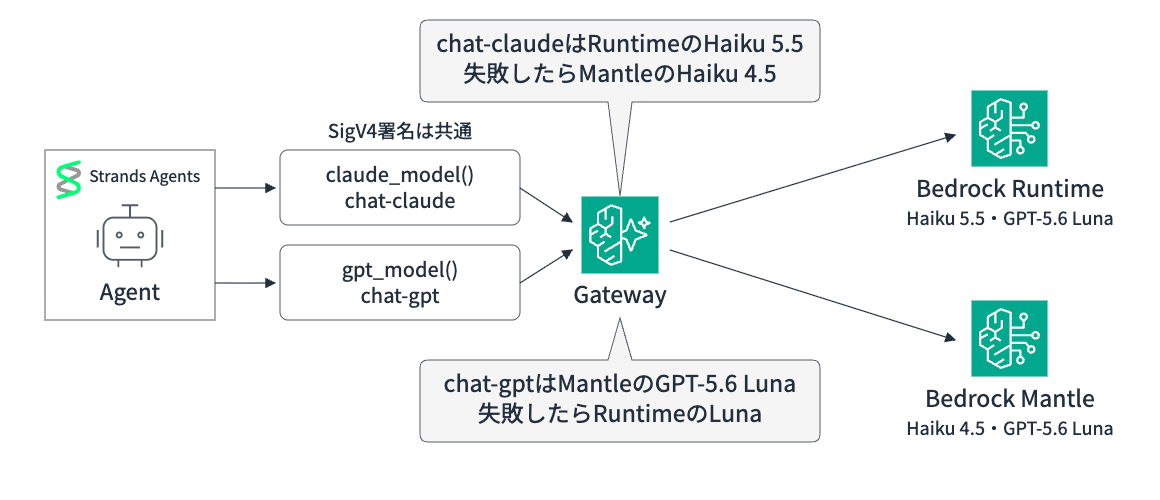
形式ごとにモデルを作る関数を用意する
ClaudeはAnthropic Messages形式、GPT-5.6 LunaはResponses形式で呼ぶので、Strands側ではモデルを作る関数を形式ごとに分けました。Gatewayはリクエスト本文の形式までは変換しないので、モデルに合った形式で呼ぶ必要があります。
import os

from strands.models.anthropic import AnthropicModel
from strands.models.openai_responses import OpenAIResponsesModel

from sigv4_auth import signed_http_client

GATEWAY_URL = os.environ["GATEWAY_URL"]

def claude_model(model_id: str = "chat-claude") -> AnthropicModel:
    """Anthropic Messages 形式で呼ぶモデル"""
    return AnthropicModel(
        client_args={"base_url": f"{GATEWAY_URL}/inference", "api_key": "unused", "http_client": signed_http_client()},
        model_id=model_id,
        max_tokens=1024,
    )

def gpt_model(model_id: str = "chat-gpt") -> OpenAIResponsesModel:
    """OpenAI Responses 形式で呼ぶモデル"""
    return OpenAIResponsesModel(
        client_args={"base_url": f"{GATEWAY_URL}/inference/v1", "api_key": "unused", "http_client": signed_http_client()},
        model_id=model_id,
    )
関数にはこの後説明するルールの論理名を渡すようにしています。
論理名とフォールバックはGatewayのルールに任せる
エージェントのコードに具体的なモデルIDを書かず chat-claude のような論理名で呼ぶ形にしておくと送り先の変更をGateway側だけで済ませられます。
今回はClaude系とGPT系で論理名を2つ作り、それぞれ切り替え先を設定しました。切り替え先は同じ形式で呼べるモデルにしています。
chat-claudeはRuntimeのHaiku 5.5へ送り、失敗したらMantleのHaiku 4.5へ切り替えるchat-gptはMantleのLunaへ送り、失敗したらRuntimeのLunaへ切り替える
引数で最初の応答までの待ち時間(firstByteTimeoutMilliseconds)を変えられるようにしておきます。
import os
import sys
import time

import boto3

client = boto3.client("bedrock-agentcore-control", region_name="us-east-1")
gateway_id = os.environ["GATEWAY_URL"].removeprefix("https://").split(".")[0]
timeout_ms = int(sys.argv[1]) if len(sys.argv) > 1 else 30000

# 論理名ごとに、プライマリとフォールバック先(同じ形式で呼べるモデル)を決める
RULES = {
    "chat-claude": (
        {"targetName": "bedrock-runtime", "model": "us.anthropic.claude-haiku-5-5"},
        {"targetName": "bedrock-mantle", "model": "anthropic.claude-haiku-4-5"},
    ),
    "chat-gpt": (
        {"targetName": "bedrock-mantle", "model": "openai.gpt-5.6-luna"},
        {"targetName": "bedrock-runtime", "model": "us.openai.gpt-5.6-luna"},
    ),
}

existing = {
    r["conditions"][0]["matchModels"]["anyOf"][0]["value"]: r["ruleId"]
    for r in client.list_gateway_rules(gatewayIdentifier=gateway_id)["gatewayRules"]
}

for priority, (name, (primary, secondary)) in enumerate(RULES.items(), start=10):
    params = dict(
        gatewayIdentifier=gateway_id,
        priority=priority,
        conditions=[{"matchModels": {"anyOf": [{"value": name, "operator": "StringEquals"}]}}],
        actions=[{
            "routeToTarget": {
                "staticRoute": {
                    **primary,
                    "fallback": {"firstByteTimeoutMilliseconds": timeout_ms, "targetFallback": [secondary]},
                }
            }
        }],
    )
    if name in existing:
        rule_id = existing[name]
        client.update_gateway_rule(ruleId=rule_id, **params)
    else:
        rule_id = client.create_gateway_rule(**params)["ruleId"]
    while client.get_gateway_rule(gatewayIdentifier=gateway_id, ruleId=rule_id)["status"] != "ACTIVE":
        time.sleep(3)
    print(name, "ACTIVE", timeout_ms)
応答の model を見ると、どのターゲットのモデルが答えたかが分かります。待ち時間を50ミリ秒にしてプライマリ側をわざとタイムアウトさせ、切り替わるかを確認しました。
check_rules.py
import asyncio
import os

from anthropic import AsyncAnthropic
from openai import AsyncOpenAI

from sigv4_auth import signed_http_client

URL = os.environ["GATEWAY_URL"]
anthropic = AsyncAnthropic(base_url=f"{URL}/inference", api_key="unused", http_client=signed_http_client())
openai = AsyncOpenAI(base_url=f"{URL}/inference/v1", api_key="unused", http_client=signed_http_client())

async def main():
    # 応答の model を見ると、どのターゲットのモデルが答えたかが分かる
    r = await anthropic.messages.create(model="chat-claude", max_tokens=50, messages=[{"role": "user", "content": "こんにちは"}])
    print("chat-claude ->", r.model)
    r = await openai.responses.create(model="chat-gpt", input="こんにちは")
    print("chat-gpt    ->", r.model)

asyncio.run(main())
uv run setup_rules.py && uv run check_rules.py
uv run setup_rules.py 50 && uv run check_rules.py
chat-claude ACTIVE 30000
chat-gpt ACTIVE 30000
chat-claude -> claude-haiku-5-5
chat-gpt    -> openai.gpt-5.6-luna
chat-claude ACTIVE 50
chat-gpt ACTIVE 50
chat-claude -> claude-haiku-4-5-20251001
chat-gpt    -> us.openai.gpt-5.6-luna
通常はRuntimeのHaiku 5.5とMantleのLunaが答え、50ミリ秒にするとMantleのHaiku 4.5とRuntimeのLunaに切り替わりました! Responses APIの経路でもフォールバックが有効になっていますね。
論理名を渡したエージェントも動かしてみます。
from strands import Agent

from gateway_models import claude_model, gpt_model
from tools import get_weather

# エージェントには論理名だけを渡す
for name, model in (("chat-claude", claude_model()), ("chat-gpt", gpt_model())):
    agent = Agent(model=model, tools=[get_weather], callback_handler=None)
    result = agent("東京と大阪の天気を教えて")
    calls = result.metrics.tool_metrics["get_weather"].call_count
    print(f"== {name}(ツール呼び出し {calls} 回)")
    print(str(result).strip(), "\n")
uv run setup_rules.py && uv run agent_logical.py
== chat-claude(ツール呼び出し 2 回)
東京と大阪の天気は、どちらも晴れで気温は18度です。

== chat-gpt(ツール呼び出し 2 回)
- 東京:晴れ、18℃
- 大阪:晴れ、18℃
待ち時間を50ミリ秒にして、フォールバック先に切り替わった状態でも動かしてみます。
uv run setup_rules.py 50 && uv run agent_logical.py
== chat-claude(ツール呼び出し 2 回)
東京と大阪の天気情報です:
**東京**
- 天気:晴れ
- 気温:18度
**大阪**
- 天気:晴れ
- 気温:18度
両都市とも晴れており、気温も同じ18度です。過ごしやすい天気が続いているようです。

== chat-gpt(ツール呼び出し 2 回)
- 東京:晴れ、18℃
- 大阪:晴れ、18℃
どちらもツールを2回呼んで回答していました!フォールバックも問題なく動いていたのでエージェント側は何も変えずに、送り先と切り替えをGatewayで決められるのが良いですね。
Strandsから複数のモデルをGateway経由で使うなら次の形を意識するとよさそうです・・・!
- 認証とGatewayの入口は1つにして、モデルを作る関数はAPIの形式ごとに用意する
- エージェントには論理名を渡し、送り先とフォールバックはGatewayのルールで決める
- フォールバック先は同じ形式で呼べるモデルにする
これはあくまで一案なので使い方によってはもっといい組み方もありそうでいろいろ試してみると面白いと思います!!
後片付け
ルール・ターゲット・GatewayとIAMロールを削除します。
import os
import time

import boto3

client = boto3.client("bedrock-agentcore-control", region_name="us-east-1")
gateway_id = os.environ["GATEWAY_URL"].removeprefix("https://").split(".")[0]

for rule in client.list_gateway_rules(gatewayIdentifier=gateway_id)["gatewayRules"]:
    client.delete_gateway_rule(gatewayIdentifier=gateway_id, ruleId=rule["ruleId"])
for target in client.list_gateway_targets(gatewayIdentifier=gateway_id)["items"]:
    client.delete_gateway_target(gatewayIdentifier=gateway_id, targetId=target["targetId"])
while client.list_gateway_targets(gatewayIdentifier=gateway_id)["items"]:
    time.sleep(5)
client.delete_gateway(gatewayIdentifier=gateway_id)
print("deleted", gateway_id)
uv run cleanup.py
aws iam delete-role-policy --role-name strands-gw-inference-role --policy-name inference
aws iam delete-role --role-name strands-gw-inference-role
おまけ JWT認証の場合
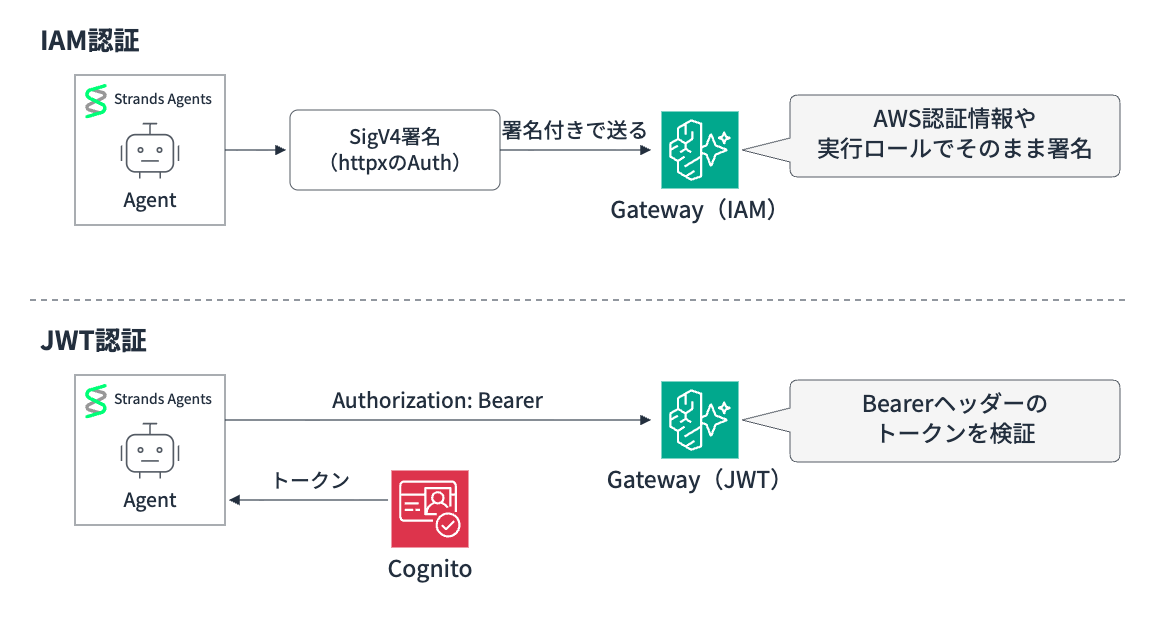
GatewayのインバウンドをJWT認証にした場合も試してみました。Cognitoのマシン間認証(client credentials)で発行したアクセストークンを使います。推論ターゲットの設定はIAMのときと同じです。
検証環境の準備(JWT)
IAMロールは本編の setup_iam.sh で作成したものを使います。本編の後片付けで削除した場合は作り直してください。CognitoのユーザープールとJWT認証のGatewayを作成し、接続情報を jwt_env.json に保存します。
import json
import time
import uuid

import boto3

region = "us-east-1"
account_id = boto3.client("sts").get_caller_identity()["Account"]
cognito = boto3.client("cognito-idp", region_name=region)
client = boto3.client("bedrock-agentcore-control", region_name=region)

# Cognito:client credentials でトークンを発行する設定
pool = cognito.create_user_pool(PoolName="strands-gw-jwt-pool")["UserPool"]
pool_id = pool["Id"]
domain = f"strands-gw-jwt-{uuid.uuid4().hex[:8]}"
cognito.create_user_pool_domain(Domain=domain, UserPoolId=pool_id)
cognito.create_resource_server(
    UserPoolId=pool_id, Identifier="gateway", Name="gateway",
    Scopes=[{"ScopeName": "invoke", "ScopeDescription": "invoke gateway"}],
)
app = cognito.create_user_pool_client(
    UserPoolId=pool_id, ClientName="strands-agent", GenerateSecret=True,
    AllowedOAuthFlows=["client_credentials"], AllowedOAuthScopes=["gateway/invoke"],
    AllowedOAuthFlowsUserPoolClient=True,
)["UserPoolClient"]

gateway = client.create_gateway(
    name="strands-inference-gateway-jwt",
    roleArn=f"arn:aws:iam::{account_id}:role/strands-gw-inference-role",
    protocolType="MCP",
    authorizerType="CUSTOM_JWT",
    authorizerConfiguration={
        "customJWTAuthorizer": {
            "discoveryUrl": f"https://cognito-idp.{region}.amazonaws.com/{pool_id}/.well-known/openid-configuration",
            "allowedClients": [app["ClientId"]],
        }
    },
)
gateway_id = gateway["gatewayId"]
while client.get_gateway(gatewayIdentifier=gateway_id)["status"] != "READY":
    time.sleep(5)

for name in ("bedrock-runtime", "bedrock-mantle"):
    target = client.create_gateway_target(
        gatewayIdentifier=gateway_id,
        name=name,
        credentialProviderConfigurations=[{"credentialProviderType": "GATEWAY_IAM_ROLE"}],
        targetConfiguration={"inference": {"connector": {"source": {"connectorId": name}}}},
    )
    while client.get_gateway_target(gatewayIdentifier=gateway_id, targetId=target["targetId"])["status"] != "READY":
        time.sleep(5)

json.dump({
    "gateway_url": gateway["gatewayUrl"].removesuffix("/mcp"),
    "gateway_id": gateway_id,
    "pool_id": pool_id,
    "domain": domain,
    "client_id": app["ClientId"],
    "client_secret": app["ClientSecret"],
}, open("jwt_env.json", "w"))
print("ok", gateway_id)
uv run setup_jwt.py
トークンを取得する関数です。
import json

import httpx

env = json.load(open("jwt_env.json"))

def get_token() -> str:
    res = httpx.post(
        f"https://{env['domain']}.auth.us-east-1.amazoncognito.com/oauth2/token",
        data={"grant_type": "client_credentials", "scope": "gateway/invoke"},
        auth=(env["client_id"], env["client_secret"]),
    )
    res.raise_for_status()
    return res.json()["access_token"]

GATEWAY_URL = env["gateway_url"]
GatewayのJWT認証は Authorization: Bearer ヘッダーのトークンを使用します。
Anthropic SDKは api_key を x-api-key ヘッダーで送るので、トークンは auth_token に渡します。OpenAI SDKは api_key をBearerで送るので、そのまま api_key に渡せます。
from strands import Agent
from strands.models.anthropic import AnthropicModel

from jwt_token import GATEWAY_URL, get_token
from tools import get_weather

model = AnthropicModel(
    client_args={
        "base_url": f"{GATEWAY_URL}/inference",
        "auth_token": get_token(),  # Authorization: Bearer で送られる
    },
    model_id="us.anthropic.claude-haiku-5-5",
    max_tokens=1024,
)

agent = Agent(model=model, tools=[get_weather])
agent("東京と大阪の天気を教えて")
from strands import Agent
from strands.models.openai_responses import OpenAIResponsesModel

from jwt_token import GATEWAY_URL, get_token
from tools import get_weather

model = OpenAIResponsesModel(
    client_args={
        "base_url": f"{GATEWAY_URL}/inference/v1",
        "api_key": get_token(),  # Authorization: Bearer で送られる
    },
    model_id="openai.gpt-5.6-luna",
)

agent = Agent(model=model, tools=[get_weather])
agent("東京と大阪の天気を教えて")
uv run agent_claude_jwt.py
uv run agent_gpt_jwt.py
どちらもツールを2回呼んで回答まで進みました! HTTPクライアントを自分で渡す必要はないので、OpenAIResponsesModelもクローズしないHTTPクライアントなしで動きます。
ざっとIAM認証とJWT認証の違いをまとめておきます。
| IAM認証 | JWT認証 | |
|---|---|---|
| Strands側のコード | SigV4署名のhttpx Authが必要 | トークンを渡すだけ |
| AnthropicModel | client_argsに http_client |
client_argsに auth_token |
| OpenAIResponsesModel | クローズしないHTTPクライアントを渡す | client_argsのままで動く |
| 別に用意するもの | AWS認証情報や実行ロールで済む | IdPとトークンの取得処理 |
JWTのほうがシンプルですね!
ただトークンはモデルの作成時に1回渡しているだけなので、長く動かすエージェントでは期限(Cognitoのアクセストークンはデフォルトで1時間)が切れる前に作り直す処理など考慮が必要ですね。
後片付け(JWT)
import json
import time

import boto3

env = json.load(open("jwt_env.json"))
client = boto3.client("bedrock-agentcore-control", region_name="us-east-1")
gateway_id = env["gateway_id"]
for target in client.list_gateway_targets(gatewayIdentifier=gateway_id)["items"]:
    client.delete_gateway_target(gatewayIdentifier=gateway_id, targetId=target["targetId"])
while client.list_gateway_targets(gatewayIdentifier=gateway_id)["items"]:
    time.sleep(5)
client.delete_gateway(gatewayIdentifier=gateway_id)

cognito = boto3.client("cognito-idp", region_name="us-east-1")
cognito.delete_user_pool_domain(Domain=env["domain"], UserPoolId=env["pool_id"])
cognito.delete_user_pool(UserPoolId=env["pool_id"])
uv run cleanup_jwt.py
rm jwt_env.json
aws iam delete-role-policy --role-name strands-gw-inference-role --policy-name inference
aws iam delete-role --role-name strands-gw-inference-role
おわりに
Strands AgentsからAgentCore Gatewayの推論ターゲットの呼び出しが無事できました!一癖はありますが、まぁできなくないって感じですね・・・!このあたりがネイティブ統合されるとグッと使いやすくなりそうですね!
また複数のモデルをまとめるときは、APIの形式ごとにモデルを作る関数を分けてGatewayのルールで振り分けるのが扱いやすそうな印象でした!
本記事が少しでも参考になれば幸いです。最後までご覧いただきありがとうございました!