Claude Code や Codex を使った開発において AI のための仕組みを再発明しないようにしている話

はじめに
Claude Code や Codex を普段の開発で使ううち、エージェントの失敗には決まった型があると感じてきています。前提を取り違えたり、報告を積み上げて最新の状態を見失ったり、あるいは、用語の指す対象がずれたり、着手の順番を誤ったりといった具合です。
こういった失敗が起こるたび、エージェントのためにそれ専用の仕組みを新しく作りたくなります。私自身もいくつかの方法を試してきました。しかしながら、最近は新しい仕組みを作るよりも、エンジニアが昔から続けてきた手法をまず検討するべきだ という考えに落ち着いています。用語・制約・要件・仕様・設計・進行状態などをドキュメントに残して情報の種類ごとに集約し、ほかの場所からはそこを参照する……いわば参照透過的に扱う手法です。
任天堂の開発者だった横井軍平氏は、かつて「枯れた技術の水平思考」という考え方を残しました。十分に普及して扱いやすくなった技術を別の用途へ転用して新しい価値を生む考え方です。本記事では、エージェントとの開発でも同じ発想が役に立つという話を、私が実践している手法も紹介しつつ執筆できればと思います。あわせて、論文や先行事例で紹介されているやり方と比べて、私のやり方との違いにも触れます。
なお、AI コーディングエージェント向けの課題管理ツール Beads を使ったタスク管理については、以前に次の 2 本の記事で紹介しました。本記事では、そこで報告した実例にも触れます。
対象読者
- Claude Code や Codex を業務の開発で使い始め、エージェントが意図どおりに動かないことに悩んでいる方
- エージェント向けの記憶や引き継ぎの仕組みを自作しようとしている方
参考
- gastownhall/beads (GitHub)
- 横井軍平ゲーム館 (筑摩書房)
- Documenting Architecture Decisions (Michael Nygard, 2011)
- Coding agents love decision records (Duncan Davidson, 2026)
- Ubiquitous Language (Martin Fowler, 2006)
- How Claude remembers your project (Claude Code Docs)
- Best practices for Claude Code (Anthropic)
- Critical-Path Planning and Scheduling (James E. Kelley, Morgan R. Walker, 1959)
- Ubiquitous language for AI plans (AgentPatterns.ai)
- Lost in Context Compaction: When LLM Systems Drop Side Constraints (arXiv:2608.11242)
- Evaluating AGENTS.md: Are Repository-Level Context Files Helpful for Coding Agents? (arXiv:2602.11988)
背景
AI エージェントは、ひとつの作業として完結している場では、非常に優秀です。ところが作業をまたいで情報を扱う場面では、同じ型の失敗を繰り返します。
振り返れば、こうした失敗はエージェントに特有のものではありません。人間のチームでも昔から同じ形の失敗が起きています。私が実際に繰り返し出会ってきたエージェントの失敗 4 つと、それぞれに対応する人間のチームの失敗を並べてみます。
| # | エージェントの失敗 | 対応する人間のチームの失敗 |
|---|---|---|
| 1 | 手段と要件の取り違え | 打ち合わせで出た案が、いつの間にか決定事項として扱われる |
| 2 | 追記による記述の混在 | Slack の会話をそのまま記録として扱い、現在有効な発言を誰も判別できなくなる |
| 3 | 呼び名の混同 | 用語の定義がなく、同じ言葉が別のものを指す |
| 4 | 根拠のない着手順 | 依存関係と優先度を設計しないまま、手近なタスクから着手する |
失敗が新しくないのであれば、対策もまずは昔からある手法から探すのがよいはずです。私たちエンジニアは、情報の残し方と進行状況の管理という問題にずっと向き合ってきました。その蓄積をエージェントとの開発にもまずは持ち込んでみるのがよいと考えています。
同じことを感じている開発者は海外にもいます。Apache Tomcat や Apache Ant を作った Duncan Davidson 氏は、後で紹介する ADR について次のように述べています。
Like many tools built for human software teams, ADRs work remarkably well for coding agents too.
人間のソフトウェアチームのために作られた多くの道具と同じく、ADR はコーディングエージェントにも驚くほどよく機能すると言っています。
実践している手法
ここからは、4 つの失敗のそれぞれについて、私のやり方を紹介し、論文や先行事例のやり方と比べた違いを示します。私のやり方は効果を数値で測ったものではないため、運用の例として読んでください。
1. 手段と要件の取り違え
エージェントに「こういうことがしたい」と伝えると、具体的な計画を立ててくれます。たとえば AI は「Cloudflare を使えばこのように実現できます」と提案してくれます。ここで私が「それだと、本当にやりたいことができませんよね」と返すと、エージェントは「Cloudflare で実現する方法を調べます」と答えます。私は Cloudflare を使えとは言っていません。エージェントは自分で提案した手段を要件と取り違え、スコープを縮めてしまいました。
人間のチームでも、打ち合わせで誰かが出した案がいつの間にか決定事項として扱われることがあります。
そこで私は判断を記録し、確定・仮置き・未決の 3 つに分けています。あわせて、判断の根拠として日付と承認者を残しています。
## 確定
| 内容 | 根拠 |
| --- | --- |
| 通知はメールで送る | 2026-10-01 越井が承認 |

## 仮置き
| 内容 | 確定の条件 |
| --- | --- |
| 配信基盤に Cloudflare Workers を使う | 2026-10-15 の検証で要件を満たせば確定。判断は越井 |

## 未決
| 内容 | 判断の時期 |
| --- | --- |
| 通知の再送の要否 | 運用の担当者との打ち合わせ後 |
エージェントには、自分が提案した手段を仮置きとして記録させ、確定は人が行うと決めておきます。こうしておけば、手段と要件がドキュメントの上で区別されます。提案が要件を満たさないと分かったときにも、仮置きの手段を外して要件から考え直すよう指示できます。
判断の記録には、ADR (Architecture Decision Record) という定番の形式があります。Michael Nygard 氏が 2011 年に提案したもので、決定ごとに「提案中」「承認済み」「非推奨」「置き換え済み」などの状態を付け、背景・決定・結果を書きます。状態で区別するという点は私のやり方と同じですが、まだ決まっていない論点を「未決」として並べておく欄は、ADR にはありません。
違いは、古くなった決定の扱いです。Davidson 氏は、エージェントが ADR を人間以上に固く守り、すでに古くなった決定にまで従い続けた例を報告しています。そのため、AGENTS.md の中で「承認済みの ADR に従うことと同時に、作業と食い違ったら止まって相談し、変更を提案する」よう指示しているそうです。決定を疑ってよいという許可をエージェントに明示的に与える点は、私のやり方にも取り入れる余地がありそうです。
2. 追記による記述の混在
エージェントに進捗の管理を頼むと、コメントをひたすら追記していく挙動が起こりがちです。古い記述の後ろに訂正が足され、その後ろにさらに補足が足されます。「はじめに」セクションで紹介した 2 本目の記事では、Beads の notes を 25 リポジトリで集計し、合計が約 55 万文字に達していたことと、誤った数値の後ろに訂正だけを追記した例を報告しました。
これは、人間でいうところの、たとえば Slack の会話をそのまま記録として扱ったときに起きる問題と同じです。現在も有効な発言は、会話をさかのぼって読み直さないと分かりません。読み手が人間であってもエージェントであっても、コンテキストが汚染されて、正しく最新の記述を判別できなくなります。
そこで私は、「現在の状態を書く場所」と「経緯を残す場所」を分けるようにしました。GitHub Issue の本文のような現在の状態を表す場所では、原則として既存の記述をエージェントに書き直させています。
たとえば、通知機能の Issue の本文に追記を重ねると、次のようになります。
- 09/28 通知は Slack で送る方針
- 10/01 訂正: 通知はメールで送る
- 10/03 補足: 配信基盤は Cloudflare Workers が候補
- 10/06 訂正: 配信基盤の検証は 10/10 ではなく 10/15 に実施
最新の方針を知るには、全行を読んで訂正を頭の中で当てはめる必要があります。同じ内容を、現在の状態だけに書き直すと次のようになります。
## 現在の状態
- 通知はメールで送る (decisions.md の確定事項)
- 配信基盤は Cloudflare Workers を仮置き。10/15 の検証で確定する
- ブロッカー: なし

## 経緯
- 通知手段と配信基盤の比較検討: docs/reports/2026-10-03-notification.md
本文には現在有効な内容だけが残り、比較検討の経緯は調査レポートから参照できます。
ただし、判断の根拠や検証の証跡まで書き直しで消してはいけません。残す価値がある経緯は、書き直す前に調査レポートなど別の場所へ移させます。旧版のドキュメントも消さずに冒頭で現行ではないと宣言しておき、ドキュメントと実装のずれは、見つけた時点で 1 つのファイルに書き出させています。
私の場合、調査レポートはリポジトリの docs/reports ディレクトリに Markdown ファイルとして置いています。コードと一緒に Git で管理されるので、Issue からもエージェントからもファイルのパスで参照できます。先ほどの Issue の例でいえば、書き直す前に訂正の経緯をこのディレクトリのレポートへ移させます。
# 通知手段と配信基盤の比較検討

## 通知手段
- 09/28 時点では Slack で送る方針だった
- 10/01 に、利用者の多くが Slack を使っていないと分かり、メールに変更した。越井が承認

## 配信基盤
- 候補は Cloudflare Workers と AWS Lambda
- 検証は 10/10 の予定だったが、検証用アカウントの準備が遅れ、10/15 に延期した
方針が変わって古くなった設計書は消さずに、冒頭で「現行ではない」と宣言し、現行の文書へ案内します。
> この文書は現行ではありません。2026-10-01 に通知手段を Slack からメールへ変更しました。現行の設計は docs/design/notification-v2.md を参照してください。

# 通知機能の設計 v1
(以下、当時の本文をそのまま残す)
ドキュメントと実装のずれは、見つけた時点で次のようなファイルに 1 行ずつ書かせ、解消したら行を削除させます。
| 箇所 | ドキュメントの記述 | 実装の状態 | 対応 |
| --- | --- | --- | --- |
| 通知の送信元アドレス | noreply@example.com から送る | 開発用のアドレスのまま | 実装を直す |
| 通知の再送 | 記述なし (decisions.md では未決) | 失敗時に 1 回だけ再送する | 未決の判断が出たら、ドキュメントか実装をそろえる |
このファイルを見れば、まだ残っているずれを一覧で把握できます。
ちなみに「現在の状態と経緯を分ける」という考え方は、文献とも共通しているようです。Davidson 氏は、エージェントに決定記録を更新させると、経緯を残そうとして追記が積み重なると報告しています。
違いは、経緯の置き場所です。Davidson 氏は、記録には現在の本文だけを持たせ、変更履歴は Git の履歴に任せています。Nygard 氏の ADR では、決定を書き換えず、新しい記録で置き換えたうえで、古い記録に「置き換え済み」と印を付けて残しています。私は、経緯を調査レポートへ移しています。置き場所は三者三様ですが現在の状態を読みやすく保ちながら経緯も失わないという目的は共通しています。
3. 呼び名の混同
Codex は私のことを「利用者」と呼びがちです。放置すると、GitHub のコメントに「この進め方を利用者が承認した」のように書きます。
ところが、開発しているプロダクトにも「利用者」がいます。依頼者である「私」と、プロダクトの「エンドユーザー」を、同じ「利用者」という言葉で呼んでしまうのです。この Issue を後から読んだ人には、承認した人物を判別できません。
ドメイン駆動設計では、開発者と利用者が共有する厳密な言葉を育てることを「ユビキタス言語」と呼びます。Martin Fowler 氏は、Eric Evans 氏のこの考え方を紹介する中で、その理由について次のように述べています。
rigorous, since software doesn't cope well with ambiguity.
ソフトウェアはあいまいさにうまく対処できないため、言葉は厳密である必要があるという意味です。
そこで私は用語集を 1 か所に置き、ほかのドキュメントでは定義しないようにしています。用語集には登場人物も含め、エージェントには固有の名前で書かせています。
| 用語 | 定義 |
| --- | --- |
| 越井 | 本プロジェクトの開発者。作業の依頼と承認を行う |
| 利用者 | 開発しているアプリケーションを使うエンドユーザー |
| 仮置き | 確定の条件を満たすまで暫定で採用する判断 |
ほかのドキュメントでは用語を定義し直さず、用語集を参照させます。判断に ID を振る運用もありますが、必須ではないと考えています。大事なのは、定義が 1 か所にあり、ほかのドキュメントがそこを参照していることです。
エージェントに用語集を持たせる考え方は、先行事例にもありました。AgentPatterns.ai では、エージェントは機能を計画するたびに名前を作り出すため、用語集と少数の ADR で言葉を固定するよう勧めています。ただし、用語集は必要になってから作ることと、コードの変化が速いプロジェクトでは用語集が古くなり、エージェントが古い記述に従ってしまうことも注意点として挙げています。
ただし、登場人物まで用語集に入れる例は、今回調べた範囲では見当たりませんでした。 一方で、用語集が古くなる危険への備えは、私のやり方にも取り入れる余地がありそうです。
4. 根拠のない着手順
エージェントに次のタスクを選ばせると「簡単ですぐ終わるから」「ID が小さいから」といった理由で場当たり的に着手することがあります。人間のチームでも、依存関係と優先度を決めないまま手近なタスクから始め、後から手戻りが出るのはよくある失敗です。
私は、依存関係と優先度の設計自体をエージェントに任せています。タスク同士の依存関係と最優先のタスクを洗い出させ、進め方として提示させます。私はその進め方をレビューし、承認してから着手させます。簡単であることや ID の順番は、着手の理由にしないように伝えています。
GitHub で管理する場合は、まず優先度のラベルを、判断の基準を説明文に書いたうえで作らせます。基準は「いつまでにやるか」ではなく、「顧客への提供にどう影響するか」で決めます。たとえば、次のリリースで顧客に提供する機能をブロックするものは P1、提供はブロックしないが運用に手作業が発生するものは P2 です。基準がラベル自体に書いてあれば、エージェントも人間も同じ基準で優先度を判断できます。
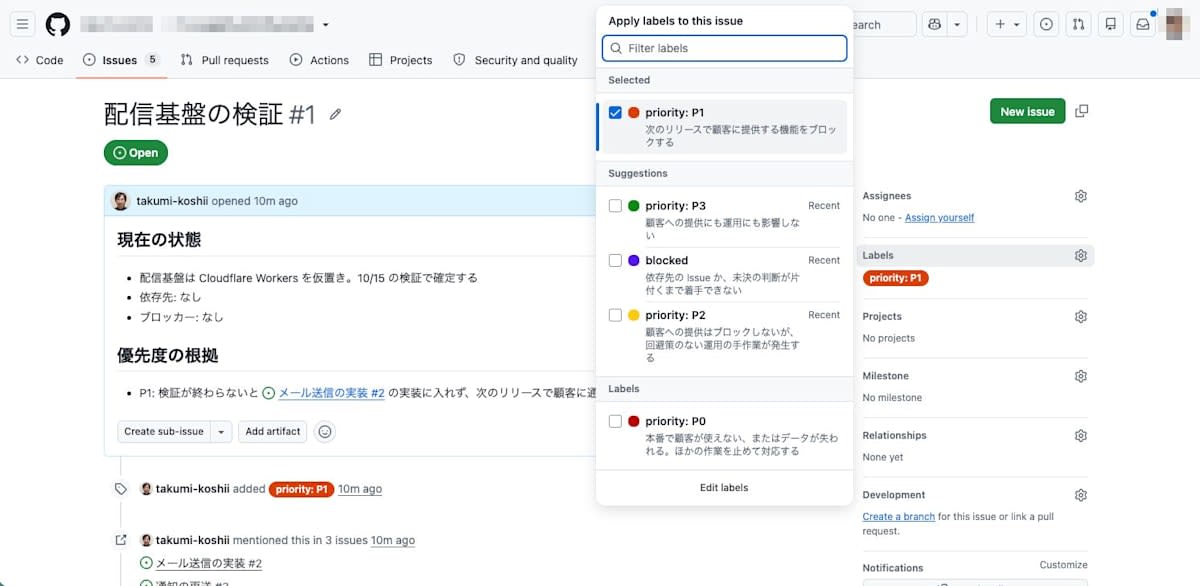
そのうえで、各 Issue に優先度と依存先を付けさせ、進め方を 1 つの Issue にまとめて提示させます。
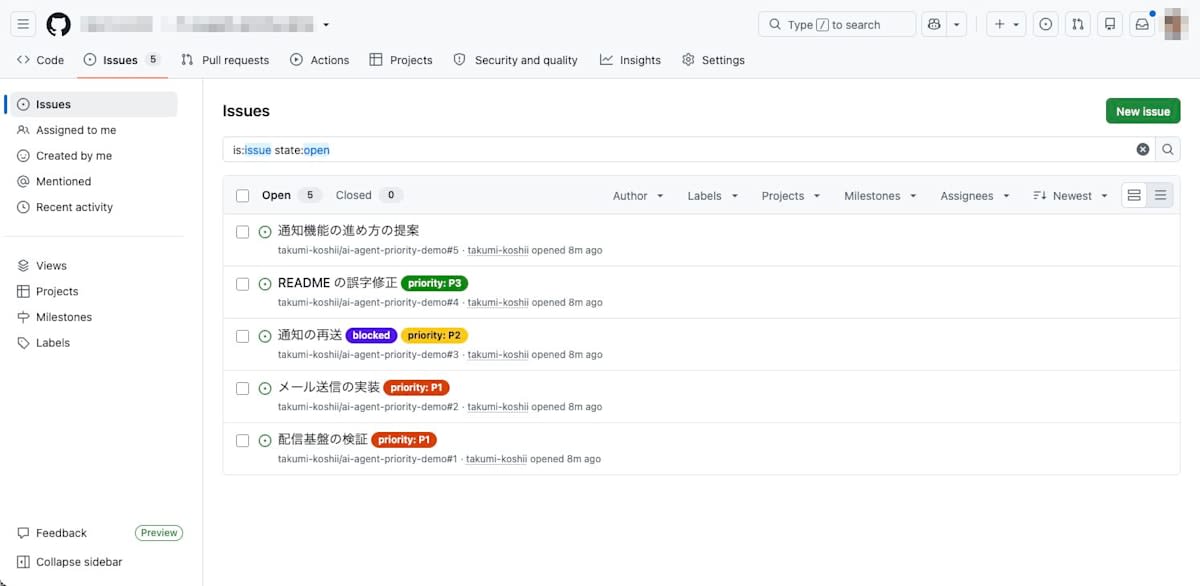
たとえば上の例では、#4 の README の誤字修正は、すぐ終わる作業ですが、顧客への提供にも運用にも影響しないため最後に回されています。また、#3 の再送の Issue は、再送の要否が未決のため blocked のラベルも付いています。
依存関係から作業の順序を決める手法としては、1959 年に James E. Kelley 氏と Morgan R. Walker 氏が発表したクリティカルパス法が古典です。ただし、この設計をエージェントに任せるやり方を論じた文献は、今回の調査では見つかりませんでした。
4 つの手法に共通する指示
どの手法でも、エージェントに 2 つの指示を添えています。作業の開始時に情報を集約したドキュメントを読ませることと、判断や状態が変わった時点でそのドキュメントを更新させることです。
ドキュメントに情報を集約しても、読まれなければ意味がありません。 「はじめに」セクションで紹介した 1 本目の記事では、判断を記録したものの次のセッションに渡らない場所に書いていたために、決着済みの議論を蒸し返した例を報告しました。情報は、エージェントに確実に読まれる場所に書くことが大切です。
一方で、読ませる量については、私のやり方と異なる結果を示した論文もあります。ETH Zurich などのグループは、AGENTS.md のような文脈ファイルをエージェントに与えても、タスクの成功率は全般には上がらず、推論のコストが平均で 20% 以上増えたと報告しています。同じ論文は、標準的でないコーディングの慣行を指定するには役立つとも述べています。
Anthropic のベストプラクティスでも、CLAUDE.md にはコードから読み取れないことだけを書くよう勧めています。 私は用語・制約・要件・仕様・設計・進行状態を幅広く残していますが、残す範囲とエージェントに毎回読ませる量とは、分けて考える必要がありそうです。
ツールの選び方
ここまでの手法は、特定のツールに依存しません。Backlog でも GitHub でも Jira でも実践できます。私がツールに求める条件は、「AI Ready」であり、同時に「人間 Ready」であることです。 つまり、エージェントにとっても人間にとっても使いやすいことです。
人間にとっての使いやすさとして重視しているのは、一覧で状況を瞬時に把握できることです。Backlog のガントチャートのように視覚的に状況をつかめれば、情報を受け取る側の認知負荷が下がり、業務が速く進みます。エージェントにとっても同じで、必要十分な情報を最も速く得られるツールが適しています。
私は現在、タスクの状態の管理に Beads を使っています。Beads では、課題どうしの依存関係を扱い、着手できる課題と止まっている課題を区別できます。新しい技術に見えますが、本質は Issue 管理という枯れた手法を、エージェントがコマンドで扱いやすい形にしたものだと捉えています。
文献と比較してみて得た気づき
私の手法を文献と比べてみると、「判断を記録すること」「情報の置き場所を 1 つに決めてほかから参照すること」という核の部分は共通していました。違いは、「判断の状態の分け方」「経緯の置き場所」「エージェントに読ませる量」といった細部です。核が共通しているのは、エージェントの失敗の多くが、人間のチームが昔から抱えてきた問題と同じ形をしているからだと考えています。
一方で細部は、モデルの性能やプロジェクトの事情に左右される、流動的な部分だとも考えています。 Davidson 氏が報告した古い決定に固執する傾向についても、文脈ファイルの効果を測った論文の結果についても、その時点のモデルでの観察結果です。本記事で紹介した私のやり方も、非常に具体に寄った「いまの私にとってのベスト」にすぎません。今後変わることを受け入れながら、その時々で一番よい方法を模索し続ける態度が大事だと考えています。
正直に言えば、本記事の内容は相当具体に寄っているため、来年には役に立たなくなっているかもしれません。 それでも、この時点で考えていたことが残っていれば、後から当時の思考を見直す材料になると思います。ADR が決定の背景を残すのと同じように、本記事も 2026 年 10 月時点の私の判断の記録として残しておくことにします。
まとめ
エージェントとの開発で起きる失敗の多くは、人間のチームで昔から起きてきた失敗と同じ形をしていると感じています。エージェント向けの新しい仕組みを作る前に、まずはチームで既に使っている Issue 管理やドキュメントの使い方を見直してみてください。そのうえで、用語・制約・要件・仕様・設計・進行状態をドキュメントに残して情報の種類ごとに集約し、エージェントには、コードから分からない決定や用語を中心に、作業の開始時に読ませ、変化があった時点で書き直させることをおすすめします。細部のやり方は、論文や先行事例も参考にしながら、モデルの変化に合わせて見直し続けてください。本記事が、エージェントとの開発の進め方を考える際の参考になれば幸いです。