サブエージェントを増やしすぎていたら、Claude公式が挙げる失敗パターンに当てはまっていた話
こんにちは。リテールアプリ共創部の中村です。
みなさんは、Claude Code などのエージェント機能を使うとき、サブエージェント(特定の役割を持つ子エージェント)をどんな基準で分けていますか?
私は普段の開発フローを自動化しようと自作スキルを作っているのですが、設計・テスト作成・実装・レビューと工程ごとに役割を分けていたら、いつの間にか最大12体まで増えてしまっていました。
最初は「役割がきれいに分かれていて見通しが良いな」と思っていたのですが、だんだんと「前工程の情報をどうやって次のエージェントに落とさず引き継ぐか」というルール作りばかりに追われるようになっていました。
そんなとき、Anthropic が公開した記事「Building agents: When to fold subagents into your main agent loop」を読んだところ、自分の構成が、記事で挙げられている失敗パターン(工程ごとに分けると、引き継ぎのたびに情報が抜け落ちる)に当てはまっていることに気づきました。
そこで今回は、記事の内容を参考にしながら自作スキルを整理・統合してみた話をまとめます。
目次
- 読んだ記事の要点
- 見直す対象:自作の開発フロースキル
- 自作スキルの棚卸しと判断基準
- 実際に見直した内容
- あえて分けたままにしたところ
- やってよかったこと
- まとめ
1. 読んだ記事の要点
記事の主なテーマは、「サブエージェントをむやみに増やさず、1つのメインループにまとめたほうが、品質・コスト・応答速度のバランスが良くなりやすい」という考え方です。
(※元記事は、Claude Platform でエージェントを作るチーム向けの記事です。今回は、その考え方を個人の Claude Code のスキルに当てはめています)
サブエージェント自体を否定しているわけではなく、有効な場面を以下の3つに絞ることが推奨されていました。
- 文脈(コンテキスト)の肥大化による性能低下が実際に計測されたとき
- 使い捨ての独立した文脈で、並行して進めたい作業があるとき
- 1体のエージェントだとツールの選択に迷ったり、指示同士が競合したりするとき
特にハッとさせられたのが、「問題の種類(工程)」ではなく「文脈(持っている情報)」で分けるべき という指摘です。
「機能実装」「テスト作成」「レビュー」のように工程ごとにエージェントを分割してしまうと、引き継ぎのたびに情報が抜け落ちて「伝言ゲーム」になりやすいとのことでした。
また、細かい手順や判断基準は「スキル(指示文)」に持たせつつ、承認ゲートのような「破られると困る制約」は指示文任せにせず、ツールやハーネス(エージェントを動かす仕組み)の側に持たせるのがよい、とされています。Claude Code では、権限設定がこれに当たると考えました。
2. 見直す対象:自作の開発フロースキル
今回見直したのは、GitHub の課題(Issue)を起点に設計からプルリクエスト(PR)作成までを一気通貫で進める自作スキルです。自分自身は要所での壁打ちや承認に集中し、実作業はエージェントに任せるスタイルを目指しています。
2-1. 全体の流れと4つの承認ゲート
工程は5つあり、途中に4つの承認ゲートを挟んでいます。
| 工程 | やること | 完了の承認ゲート |
|---|---|---|
| Issue | 課題の本文やリンク先を読む | — |
| 設計 | 設計書を作って壁打ちし、設計レビューを受ける | ゲート1:設計の承認 |
| テストリスト | 設計書の決定事項からテスト項目を洗い出し、レビューを受ける | ゲート2:テストリストの承認 |
| 実装 | テスト項目ごとに実装を進め、実装後のレビューを受ける | ゲート3:コミット・push の承認 |
| PR | PR の草案を作り、承認後に PR 作成と CI の確認 | ゲート4:PR 作成の承認 |
ゲートでは、人が明示的に OK を出すまで、次の工程や GitHub への書き込みに進まないようにしています。
2-2. 見直し前の構成(メイン以外に最大12体)
これまでは、以下のように細かく役割を分けていました。
- メイン(指揮者):担当の起動、ゲートの承認、判断、コミット・push・PR 作成を担当
- チームメイト(設計・テスト・実装):人と直接壁打ちしながら進める担当
- サブエージェント(読み込み・各種レビュー):成果物を読み、指摘を返す担当
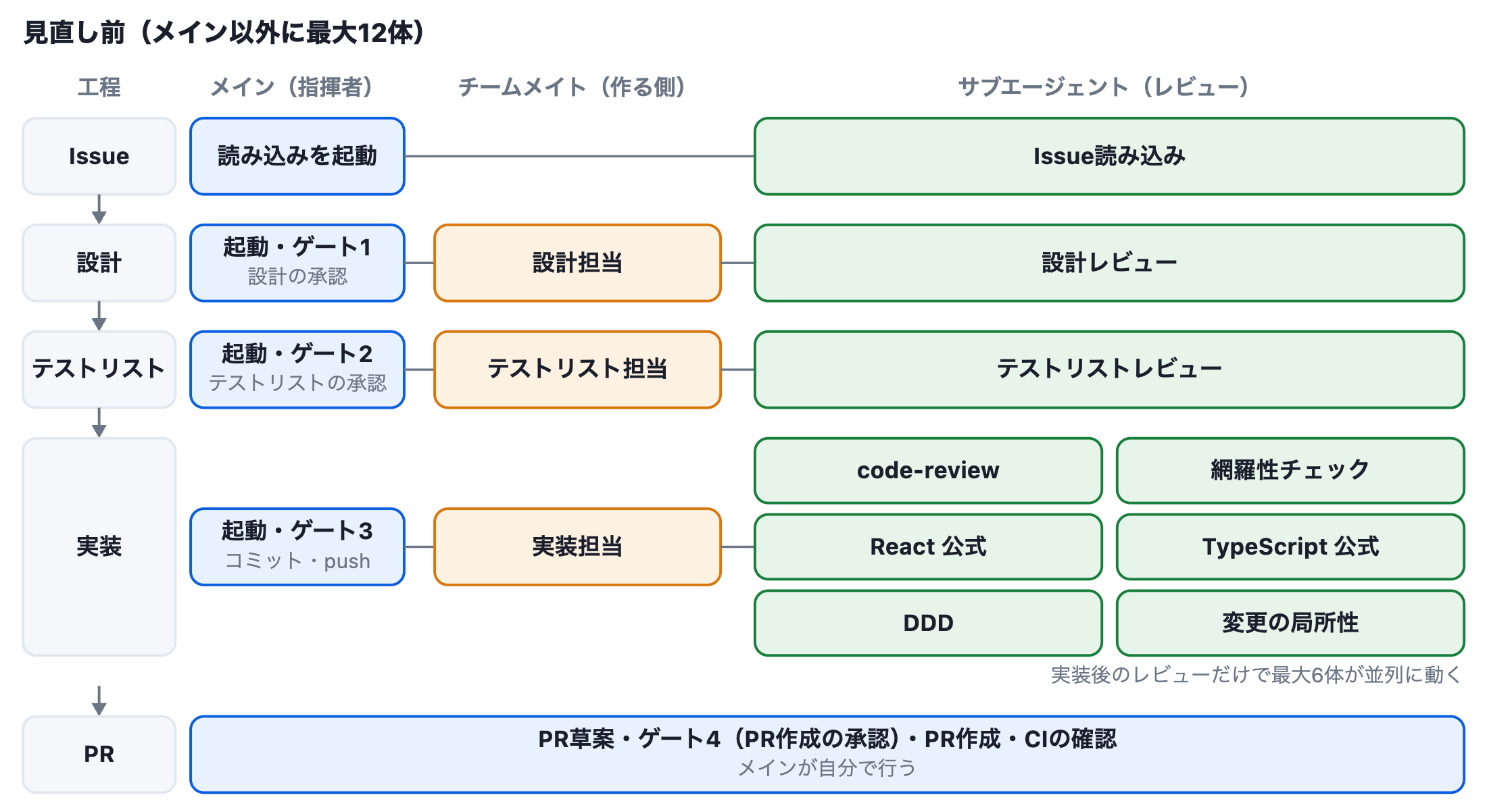
図1:見直し前の構成
2-3. 引き継ぎの課題
各担当は前工程の会話ログを持たない作りにしていたため、工程間は「状態メモ」と成果物(設計書や差分)だけで引き継いでいました。
しかし、情報が抜け落ちないようにするためのルール(何をどこにメモするかなど)がどんどん増えていき、運用の負担を感じていました。
3. 自作スキルの棚卸しと判断基準
手元の設定を確認したところ、このスキルだけで最大12体のエージェントが動く状態になっていました。そこで、記事の内容を参考に「残すか・まとめるか」のシンプルな判断基準を作ってみました。
- 問い1:文脈の違いで分けられているか?
- 成果物だけを独立して検証するなど、前後の文脈が不要で短い結果だけを返せばよいもの → 【残す】
- 問い2:記事にある「3つの場面」に当てはまるか?
- 情報量が多すぎてパンクする、使い捨ての並列処理、指示の矛盾がある → 【残す】
- 当てはまらない(単に工程やレビュー観点だけで分けている) → 【メインや共通スキルに統合】
4. 実際に見直した内容
基準をもとに見直した結果がこちらです。
| 担当 / 役割 | 分け方の理由 | 判断 |
|---|---|---|
| 各種レビュー役 | 独立した視点での検証(入力と出力が明確) | 残す |
| 観点別レビュー(React/TS 等) | 観点で分けていただけ | 1体に統合 |
| チェックリスト | 主に実装後のレビューで参照していた | 作る側と全レビューで共通参照 |
| Issue の読み込み | 要約による伝言ゲーム化 | メインが直接読む |
| コミット等の承認 | 指示文だけで制限していた | ツールの権限設定で制御 |
① 観点別の5体を「チェックリストレビュー役」1体に統合
以前は React、TypeScript、DDD、変更の局所性、網羅性の5つを別々のエージェントで動かしていました。ただ、これらは「同じ差分コードを読み、同じタイミングで動く」ため、分けておく理由は薄いと考えました。
そこで、観点ごとのチェックリストを参照ファイルとして読み込む「チェックリストレビュー役」1体に集約しました。実装後のレビュー体制は、公式のコードレビューと合わせて 6体から 2体へとスリム化できています。
② チェックリストを「段階的」に再利用
レビュー役を1体にまとめたことで、チェックリストを共通の参照ファイルとして扱いやすくなりました。
せっかくなら実装後だけでなく、設計やテストリストの段階でも同じ観点を活かしたいと考えました。
ただし、毎回すべての項目を読み込ませると情報量が多すぎて精度が落ちる心配があります。そこで、記事で紹介されていた「段階的な情報の開示」(必要になったときに、必要な分だけ読み込む)の考え方を参考に、フェーズごとに必要な節だけを読み込む形にしました。
- 設計の段階:アーキテクチャや状態管理など、設計書レベルで見る項目だけ
- テストリストの段階:設計判断の検証・対称性・集約の不変条件など、テスト観点の項目だけ
- 実装後:書き方を含む、実装段階の項目すべてをチェック
コードを書く前の設計段階で構造的な違和感に気づきやすくなるため、手戻りを減らす効果も期待できそうです。
また、レビューで初めて指摘されて手戻りが発生するのを防ぐため、設計や実装を担当する「作る側」のエージェントにも、同じ段階の同じ節をあらかじめ読ませるようにしています。実装担当は作業が長く文脈が膨らみやすいので、まず「明確な違反」の節から読ませています。
③ 承認ゲートは指示文ではなく「ツールの権限」で制御
「ユーザーが確認していない内容で PR を作らない」というルールを、これまではスキルの指示文だけで守らせようとしていました。
しかし、安全に関わるルールは、プロンプトよりも仕組みで守るほうが安心だと感じています。Claude Code の権限設定を見直し、書き込みを伴う操作(PR 作成や git push など)は、人の確認を挟む設定に寄せました。
具体的には、gh コマンドはまとめて許可したまま、書き込みを伴うものだけを ask(実行前に確認を出す)に足しています。Claude Code の権限ルールは deny → ask → allow の順に評価されるので、より広い allow があっても、ask に当たれば確認が表示されます。
{
  "permissions": {
    "allow": ["Bash(gh *)"],
    "ask": [
      "Bash(git commit *)",
      "Bash(git push *)",
      "Bash(gh pr create *)",
      "Bash(gh pr edit *)",
      "Bash(gh issue create *)",
      "Bash(gh issue comment *)"
    ]
  }
}
(※ほかにも書き込みを伴う gh のサブコマンドがあれば、同じように ask に足します)
※設定を変えたら、実際に gh pr create を呼ぶ場面で確認が出るかを、実機で一度確かめておくと安心です。
見直し後の全体像
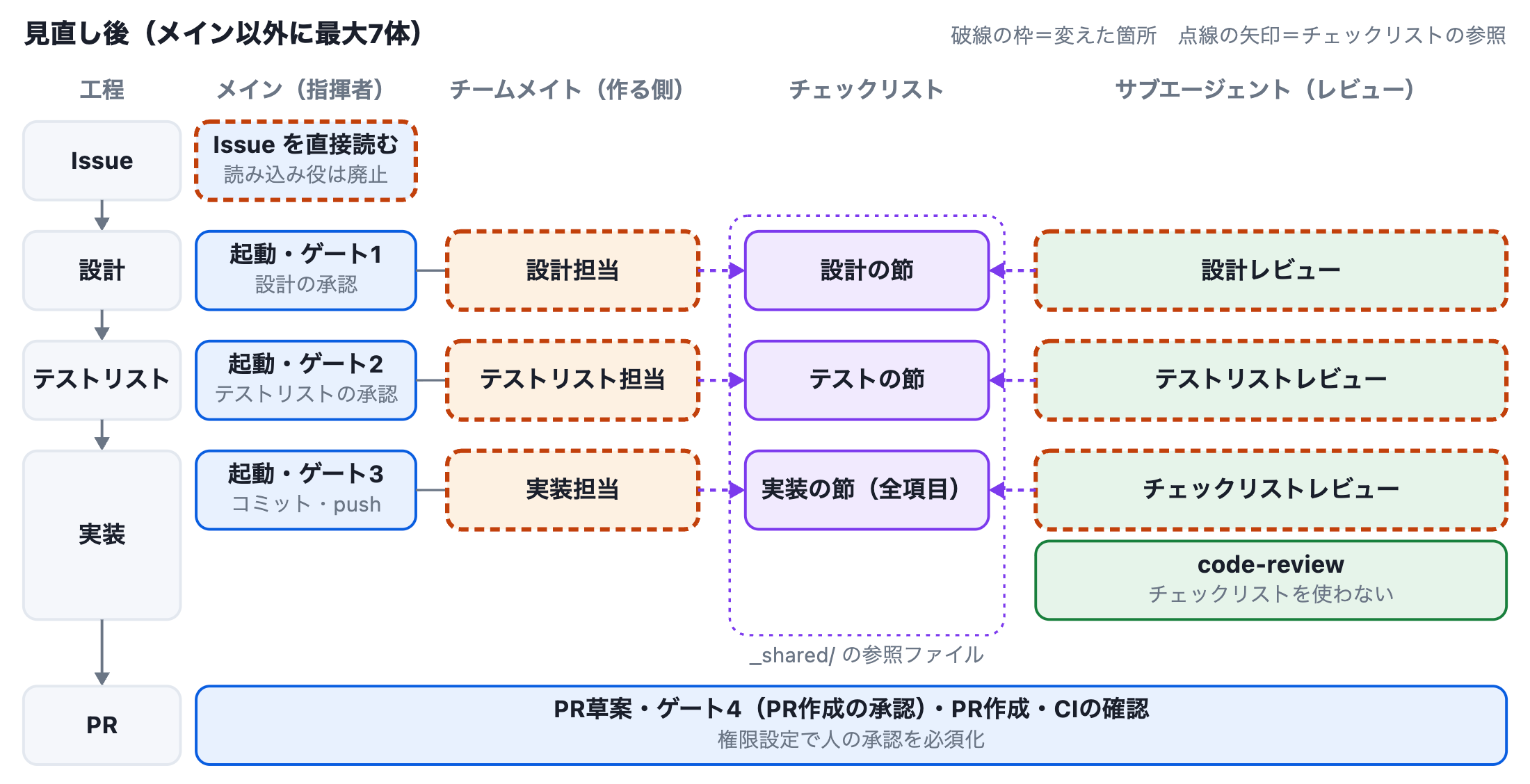
図2:見直し後の構成。作る側とレビューが、同じチェックリストの同じ節を参照する
5. あえて分けたままにしたところ
元記事の例では「機能実装とテスト作成は同じエージェントで行う」パターンも紹介されていましたが、今回のスキルではあえて分けたままにしています。
主な理由は以下の2点です。
- 設計書をもとに先行して洗い出すため:実装コードを見てからテストを作るのではなく、設計書の決定事項からテスト項目を洗い出す流れにしているため、情報の欠落が起きにくいと考えています。
- 実装都合のバイアスを避けるため:作る本人がテスト項目を考えると、「実装しやすい正常系」に引っ張られやすい印象があるためです(役割としては、独立した検証役に近いと考えています)。
このあたりはチームの開発思想や個人のやりやすさにもよる部分だと思うので、実際の感触を見ながら調整していくのが良さそうです。
6. やってよかったこと
まだ見直しを反映したばかりですが、棚卸しをしてみてよかったと感じている点は、次の3つです。
- 残すか・まとめるかを決める物差しができた
これまでは「役割が違うから分ける」という感覚で担当を増やしていました。「文脈で分けているか」という基準ができたことで、新しく担当を足したくなったときにも、同じ問いで判断できるようになりました。 - 指示文だけで守っていたルールに気づけた
設定を見直す中で、ghコマンドをまとめて許可していたため、PR や Issue の作成はスキルの指示文だけで止めていたことに気づきました。普段使っているだけでは、なかなか気づけなかったと思います。 - 同じ観点を書く場所が1つになった
テストの抜けを見る観点が、実装前のレビューと実装後のレビューの両方に別々に書かれていました。チェックリストにまとめたことで、観点を直すときに触る場所が1つで済むようになりました。
一方で、元記事はサブエージェントを1体ずつ統合しながら評価することを勧めていますが、今回はいくつかの変更をまとめて入れてしまいました。統合したことで見落としが増えていないか、応答が速くなったかといった効果は、まだ測れていません。これから実際の開発で使いながら確かめていき、気になる点があればその都度スキルを直していこうと思います。
7. まとめ
サブエージェントは役割を明確にできる便利な仕組みですが、増やしすぎると引き継ぎのコストや管理の手間が増えてしまいがちです。
- 「問題の種類(工程)」ではなく「文脈」で分ける
- 同じ情報を参照する作業はなるべくまとめ、共通のチェックリストなどで対応する
- 安全に関わるルールは指示文任せにせず、ツールの権限設定などで守る
エージェントの構成が複雑になってきて手綱を握りづらくなってきた方は、一度「本当に文脈が分かれているか?」という視点で整理してみてはいかがでしょうか。