Amazon Connect AIエージェントのエージェントアシスタントでは、オーケストレーションタイプ指定時にも回答の推奨タイプが動くことをログから確認してみた

はじめに
Amazon Connect AIエージェントには、エージェントへのアシスタントとして、手動検索タイプ、回答の推奨タイプ、オーケストレーションタイプがあります。
エージェントアシスタントでは、顧客発話をトリガーにクリック可能な推奨インテントを表示する「回答の推奨」と、エージェントが質問文を入力して実行する「手動検索」のように、利用方法によって処理の流れが異なります。
エージェントアシスタントでオーケストレーションタイプを利用する場合、フローブロックの「コネクトアシスタント」にて、AIエージェントにオーケストレーションタイプを指定します。
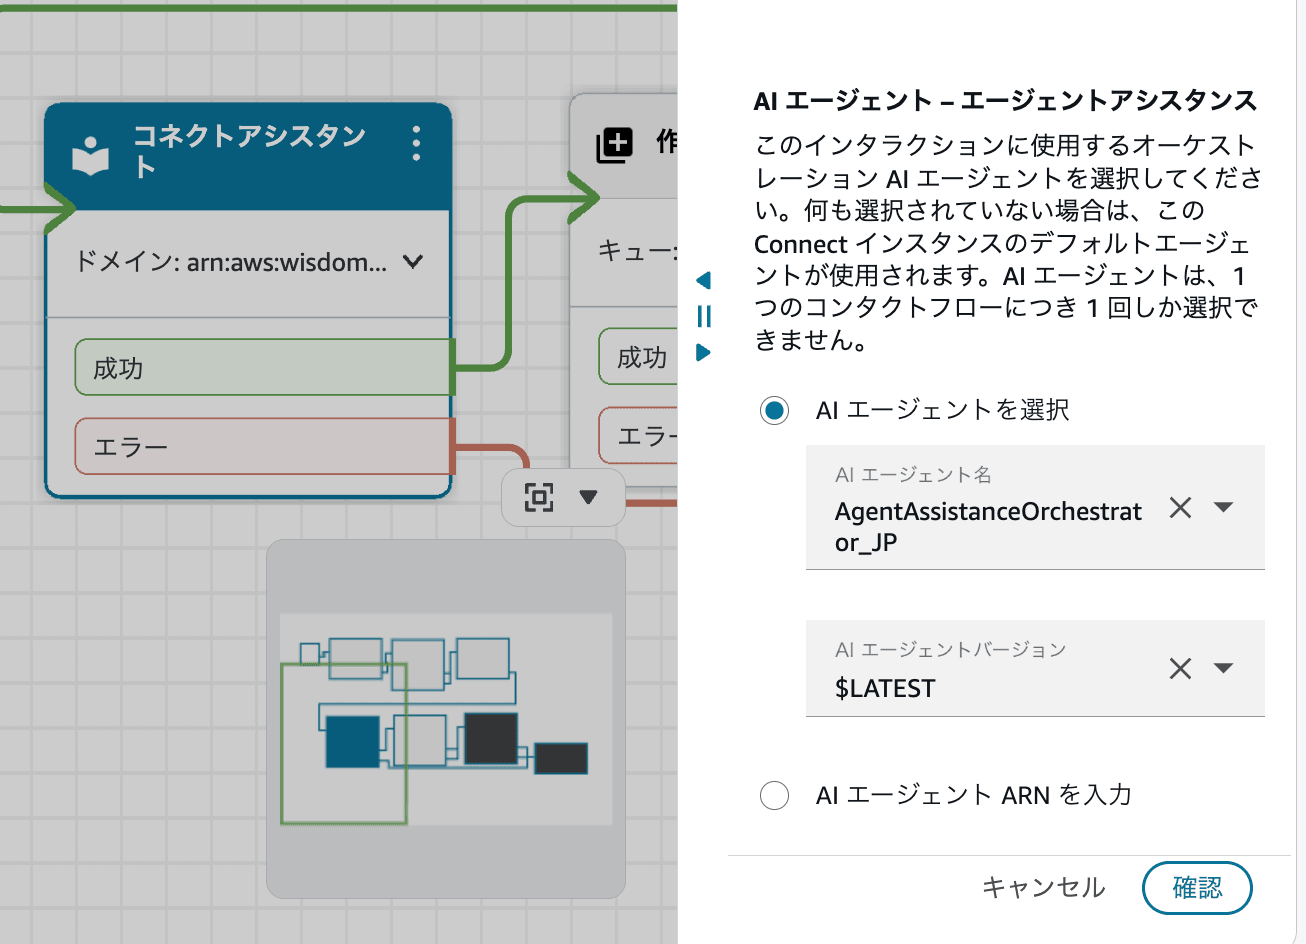
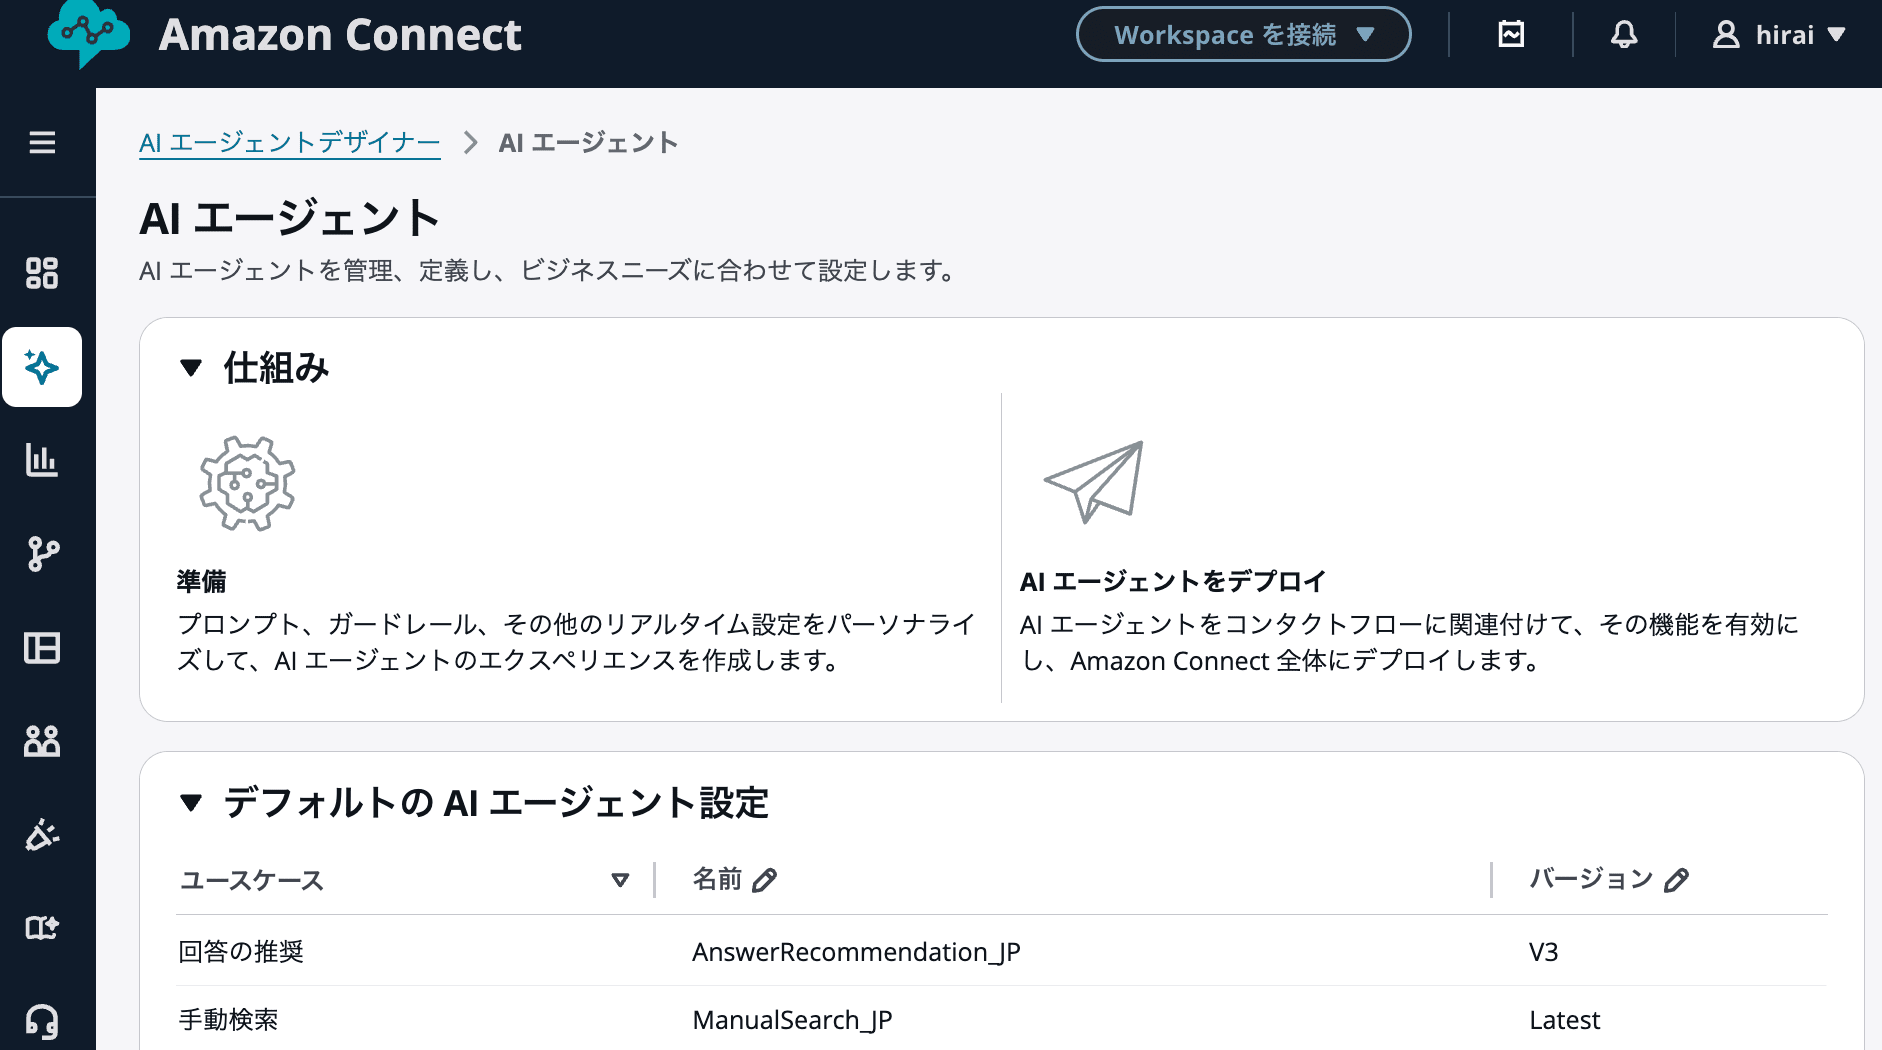
オーケストレーションタイプを指定しない場合は、「デフォルトの AI エージェント設定」に設定されている、利用方法に応じたAIエージェントが利用されます。例えば、回答の推奨では回答の推奨タイプ、手動検索では手動検索タイプのAIエージェントが利用されます。
以前の記事では、エージェントへのアシスタント用途におけるオーケストレーションタイプのAIエージェントについて、プロンプト内容を確認しました。
そのため、フローの「コネクトアシスタント」ブロックでオーケストレーションタイプのAIエージェントを指定した場合、エージェントアシスタントの処理はすべてオーケストレーションタイプ側で完結するものだと思っていました。
実際、オーケストレーションタイプのAIエージェントを指定した状態でエージェントが手動検索を実行した場合、ログ上では手動検索タイプではなく、オーケストレーションタイプのAIエージェントのみが実行されていました。
一方で、顧客発話をトリガーにクリック可能な推奨インテントが表示される「回答の推奨」では、オーケストレーションタイプのAIエージェントを指定している場合でも、一部処理で回答の推奨タイプのAIエージェントが利用されていました。
最初にログを見たときは、オーケストレーションタイプを指定しているのに、なぜ回答の推奨タイプのプロンプトが呼び出されているのか分からず、少し混乱しました。
本記事では、オーケストレーションタイプ指定時のエージェントアシスタントについて、手動検索と回答の推奨で内部的な動きがどのように異なるのかをログから確認します。
回答の推奨タイプの特徴
まず、回答の推奨タイプの特徴を整理します。
回答の推奨タイプでは、役割の異なるAIプロンプトが順番に実行されます。
AWSドキュメントでは、デフォルトのAIプロンプトとして、IntentLabelingGeneration、QueryReformulation、AnswerGeneration が用意されていることが記載されています。
IntentLabelingGeneration: エージェントと顧客間の発話を分析し、顧客のインテントを特定して要約します。生成されたソリューションでは、エージェントがインテントを選択できるように、エージェントワークスペースの Connect Assistant パネルにインテントのリストが表示されます。
QueryReformulation: エージェントと顧客間の会話のトランスクリプトを使用して、ナレッジベースで関連する記事を検索し、顧客の問題を解決します。顧客が直面している問題を要約し、重要な発話を含めます。
AnswerGeneration: ナレッジベースのドキュメントと抜粋を使用して、クエリに対する回答を生成します。生成されたソリューションにより、エージェントは顧客のインテントに対処するための簡潔なアクションを実行できます。
回答の推奨タイプは、主に以下の3つのAIプロンプトで構成されます。
IntentLabelingGenerationQueryReformulationAnswerGeneration
それぞれの役割は以下です。
IntentLabelingGeneration- 会話履歴から顧客の意図を抽出します。
QueryReformulation- 抽出された意図や会話履歴をもとに、ナレッジベース検索に適したクエリを生成します。
AnswerGeneration- 生成された検索クエリとナレッジベース検索結果をもとに、エージェント向けの回答を生成します。
このように、回答の推奨タイプは、1つのAIプロンプトがすべてを判断するのではなく、3つのAIプロンプトによるパイプラインとして動作します。
また、IntentLabelingGeneration と QueryReformulation では会話履歴が使われています。一方で、最後の AnswerGeneration では、会話履歴そのものではなく、検索クエリとナレッジベース検索結果をもとに回答が生成されます。
そのため、最終的な回答は基本的に「検索結果の要約」に近い形になります。
回答の推奨の場合
ここからは、実際のログで回答の推奨タイプの動きを確認します。
顧客発話がTranscriptに記録される
顧客が以下のように発話します。
[CUSTOMER] 先週購入したワイヤレスイヤホンを返品したいのですが、開封して一度使ってしまいました。返品は可能でしょうか?
ログには TRANSCRIPT_UTTERANCE として記録されます。
{
  "event_type": "TRANSCRIPT_UTTERANCE",
  "utterance": "[CUSTOMER] 先週購入したワイヤレスイヤホンを返品したいのですが、開封して一度使ってしまいました。返品は可能でしょうか?"
}
トリガー判定が行われる
次に TRANSCRIPT_TRIGGER_DETECTION_MODEL_INVOCATION が実行されます。
1回目の発話では、is_valid_trigger が false でした。
{
  "event_type": "TRANSCRIPT_TRIGGER_DETECTION_MODEL_INVOCATION",
  "issue_probability": "0.17269864210704816",
  "is_valid_trigger": false
}
同じ内容の発話が再度入ると、今度は is_valid_trigger が true になりました。
{
  "event_type": "TRANSCRIPT_TRIGGER_DETECTION_MODEL_INVOCATION",
  "issue_probability": "0.9336058061891412",
  "is_valid_trigger": true
}
このログから、顧客発話が入るたびに必ず回答の推奨が表示されるわけではなく、内部的にトリガー判定が行われていることが分かります。
IntentLabelingGenerationが実行される
トリガーが有効になると、IntentLabelingGeneration に相当する GENERATIVE_INTENT_DETECTION が実行されます。
ログでは、TRANSCRIPT_LARGE_LANGUAGE_MODEL_INVOCATION の prompt_type が GENERATIVE_INTENT_DETECTION になっていました。
{
  "event_type": "TRANSCRIPT_LARGE_LANGUAGE_MODEL_INVOCATION",
  "prompt_type": "GENERATIVE_INTENT_DETECTION",
  "model_id": "apac.amazon.nova-lite-v1:0"
}
このプロンプトでは、会話履歴が入力として渡されています。
出力は以下のようになっていました。
<malice>no</malice>
<specific>yes</specific>
<intent>先週購入した開封済みのワイヤレスイヤホンの返品可能性について尋ねています。</intent>
ここで、顧客の発話内容から「顧客が何を求めているか」が抽出されています。
QueryReformulationが実行される
次に QueryReformulation に相当する BEDROCK_KB_QUERY_REFORMULATION が実行されます。
{
  "prompt_type": "BEDROCK_KB_QUERY_REFORMULATION"
}
このプロンプトでも会話履歴が渡され、ナレッジベース検索用のクエリが生成されます。
出力は以下です。
<query>顧客は先週購入したワイヤレスイヤホンを返品したいと希望していますが、開封し一度使用してしまったため、返品が可能かどうか尋ねています。</query>
推奨インテントが表示される
その後、TRANSCRIPT_RECOMMENDATION が出力されます。
{
  "event_type": "TRANSCRIPT_RECOMMENDATION",
  "intent": "先週購入した開封済みのワイヤレスイヤホンの返品可能性について尋ねています。"
}
この内容が、エージェントワークスペース上に表示されるクリック可能な推奨インテントに相当します。
AnswerGenerationが実行される
エージェントが推奨インテントをクリックすると、AnswerGeneration に相当する BEDROCK_KB_GENERATIVE_ANSWER が実行されます。
{
  "prompt_type": "BEDROCK_KB_GENERATIVE_ANSWER"
}
このプロンプトには、以下が渡されていました。
- 検索クエリ
- ナレッジベース検索結果
- ロケール
一方で、会話履歴そのものは AnswerGeneration の入力には渡されていません。
入力構造としては、以下のような形です。
<search_results>
  <search_result>
    <content>返品・交換ポリシー...</content>
    <source>1</source>
  </search_result>
</search_results>

<query>
顧客は先週購入したワイヤレスイヤホンを返品したいと希望していますが、開封し一度使用してしまったため、返品が可能かどうか尋ねています。
</query>

<locale>ja_JP</locale>
生成された回答は以下です。
開封・使用済みのワイヤレスイヤホンの場合、お客様都合による返品は衛生商品のためお受けできません。ただし、初期不良が原因の場合は、商品到着後30日以内であれば交換が可能です。商品に不具合がある場合は、カスタマーサポートまでご連絡ください。
回答の推奨タイプでは、以下のようなパイプラインで処理されていることがログから確認できました。
Transcript
  ↓
Trigger Detection
  ↓
IntentLabelingGeneration
    ※回答の推奨タイプのAIエージェント
  ↓
QueryReformulation
    ※回答の推奨タイプのAIエージェント
  ↓
Recommendation表示
  ↓
エージェントが推奨インテントをクリック
  ↓
AnswerGeneration
    ※回答の推奨タイプのAIエージェント
  ↓
担当者向け回答を生成
オーケストレーションタイプの特徴
次に、オーケストレーションタイプの特徴を整理します。
回答の推奨タイプが IntentLabelingGeneration、QueryReformulation、AnswerGeneration の3つのAIプロンプトによるパイプラインで動作するのに対して、エージェントアシスタント向けのオーケストレーションタイプでは、AgentAssistanceOrchestration が中心になります。
AWSドキュメントでは、AgentAssistanceOrchestration について以下のように説明されています。
AgentAssistanceOrchestration: カスタマーサービスエージェントが顧客の問題を解決できるように AI アシスタントを設定します。エージェントからの利用可能なツールとリクエストに厳密に基づいて、顧客の問題に応じてアクションを実行できます。
https://docs.aws.amazon.com/ja_jp/connect/latest/adminguide/default-ai-system.html
回答の推奨タイプでは、意図抽出、検索クエリ生成、回答生成が別々のAIプロンプトで行われます。
一方、オーケストレーションタイプでは、1つのオーケストレーション用AIプロンプトの中で、会話履歴を参照し、必要に応じてツールを呼び出し、最終回答を生成します。
ログ上でも、オーケストレーションタイプの応答生成では prompt_type が ORCHESTRATION になっていました。
{
  "prompt_type": "ORCHESTRATION"
}
また、オーケストレーションタイプでは、プロンプトの中に会話履歴が背景情報として渡されていました。
## 背景情報
以下は担当者とお客様の会話です。
担当者からの依頼に答えるために必要な場合のみ参照してください。
参照する場合は「お客様との会話によると」と明示してください。

<conversation>
[CUSTOMER] 返品にかかる時間を教えてください 返品ポリシーを教えてください
</conversation>
回答の推奨タイプでは、最終回答生成時にTranscript全体が直接渡されていませんでした。
一方、オーケストレーションタイプでは、会話履歴が背景情報としてプロンプトに含まれています。
オーケストレーションタイプを指定した場合
ここからは、フローの「コネクトアシスタント」ブロックで、オーケストレーションタイプのAIエージェントを指定した場合のログを確認します。
顧客発話後に回答の推奨タイプの処理が動く
オーケストレーションタイプのAIエージェントを指定している場合でも、顧客発話からクリック可能な推奨インテントが表示されるまでの段階では、回答の推奨タイプの処理が動いていました。
例えば、以下の発話を行います。
[CUSTOMER] 返品にかかる時間を教えてください。
[CUSTOMER] 返品ポリシーを教えてください。
ログを見ると、まず TRANSCRIPT_TRIGGER_DETECTION_MODEL_INVOCATION が実行されています。
{
  "event_type": "TRANSCRIPT_TRIGGER_DETECTION_MODEL_INVOCATION",
  "is_valid_trigger": true
}
その後、回答の推奨タイプと同じように GENERATIVE_INTENT_DETECTION が実行されています。
{
  "event_type": "TRANSCRIPT_LARGE_LANGUAGE_MODEL_INVOCATION",
  "prompt_type": "GENERATIVE_INTENT_DETECTION"
}
出力されたintentは以下です。
<intent>返品の時間と返品ポリシーについて教えてください。</intent>
さらに BEDROCK_KB_QUERY_REFORMULATION も実行されます。
{
  "prompt_type": "BEDROCK_KB_QUERY_REFORMULATION"
}
出力は以下です。
<query>お客様は返品にかかる時間を知りたいと尋ねており、返品ポリシーについても説明を求めています。</query>
つまり、オーケストレーションタイプのAIエージェントを指定していても、顧客発話から推奨インテントを作るところまでは、回答の推奨タイプの仕組みが使われていました。
推奨インテントのクリック後にOrchestrationが動く
推奨インテントをクリックした後、ログに TRANSCRIPT_ORCHESTRATION_MESSAGE が出てきます。
{
  "event_type": "TRANSCRIPT_ORCHESTRATION_MESSAGE",
  "ai_agent_orchestration_use_case": "Connect.AgentAssistance",
  "participant": "CUSTOMER",
  "values": [
    {
      "type": "text",
      "value": "返品の時間と返品ポリシーについて教えてください。"
    }
  ]
}
さらに、オーケストレーションタイプのAIエージェントによる応答生成が行われています。
{
  "event_type": "TRANSCRIPT_AGENTIC_MESSAGE",
  "prompt_type": "ORCHESTRATION",
  "model_id": "jp.anthropic.claude-sonnet-4-5-20250929-v1:0"
}
ここから先は、回答の推奨タイプの AnswerGeneration ではなく、オーケストレーションタイプのAIエージェントが応答を生成しています。
OrchestrationがRetrieveツールを呼び出す
オーケストレーションタイプでは、必要に応じてツールを呼び出します。
今回のログでは、Retrieve ツールが呼び出されていました。
{
  "type": "tool_use",
  "name": "Retrieve",
  "arguments": {
    "retrievalQuery": "返品ポリシー 返品にかかる時間 返品期間"
  }
}
その後、ツール結果としてナレッジベース検索結果が返ります。
{
  "type": "tool_result",
  "name": "Retrieve",
  "status": "success"
}
そして、最終的にオーケストレーションタイプのAIエージェントが回答を生成します。
お客様との会話によると、返品にかかる時間と返品ポリシーについてのお問い合わせですね。以下の内容をご案内ください。

返品可能条件:
・商品到着後14日以内
・未使用・未開封の商品(タグ付き)
・レシートまたは納品書がある場合

・商品到着・検品後、3-5営業日で返金処理
・クレジットカードの場合、締日により翌月になる場合あり
この回答は、回答の推奨タイプの AnswerGeneration よりも、担当者向けの支援メッセージに近い形になっています。
オーケストレーションタイプ指定時の流れ
ログから整理すると、オーケストレーションタイプを指定した場合の流れは以下です。
Transcript
  ↓
Trigger Detection
  ↓
IntentLabelingGeneration
    ※回答の推奨タイプのAIエージェント
  ↓
QueryReformulation
    ※回答の推奨タイプのAIエージェント
  ↓
Recommendation表示
  ↓
エージェントが推奨インテントをクリック
  ↓
Orchestration
    ※オーケストレーションタイプのAIエージェント
  ↓
必要に応じてRetrieveツールを実行
  ↓
担当者向け回答を生成
図にすると、以下のようなイメージです。
顧客発話
  |
  | トリガー判定
  v
回答の推奨タイプの処理
  |
  | IntentLabelingGeneration
  | QueryReformulation
  v
クリック可能な推奨インテント
  |
  | エージェントがクリック
  v
オーケストレーションタイプのAIエージェント
  |
  | 会話履歴を背景情報として利用
  | 必要に応じてRetrieveツールを実行
  v
担当者向け回答
クリック後の回答生成時間について
今回のログでは、顧客発話から推奨インテントが表示されるまでの処理は、回答の推奨タイプのみの場合も、オーケストレーションタイプを指定した場合も、どちらも回答の推奨タイプのAIエージェントが利用されていました。
そのため、発話から推奨表示までの時間は、タイプ差として比較するポイントではありません。
違いが出るのは、エージェントが推奨インテントをクリックした後の回答生成です。
回答の推奨タイプのみの場合、クリック後は AnswerGeneration によってKB回答が生成されます。
一方、オーケストレーションタイプを指定した場合、クリック後は Orchestration が実行され、必要に応じて Retrieve ツールを呼び出しながら回答を生成します。
今回のログでは、クリック後の回答生成時間は以下のようになりました。
| パターン | クリック後の処理 | 回答生成までの時間 |
|---|---|---|
| 回答の推奨タイプのみ | AnswerGeneration |
約0.5〜0.7秒 |
| オーケストレーションタイプ指定時 | Orchestration と Retrieve ツール実行 |
約9〜18秒 |
回答の推奨タイプのみの場合、エージェントが推奨インテントをクリックしてからKB回答が表示されるまで、おおむね約0.5〜0.7秒でした。
一方、オーケストレーションタイプを指定した場合は、推奨インテントをクリックした後に、オーケストレーションタイプのAIエージェントが処理を進めるため、最終回答の生成まで約9〜18秒かかっていました。
ログを確認すると、遅くなる主な理由は、オーケストレーションタイプでは ORCHESTRATION の呼び出しが複数回直列に行われているためでした。
例えば、返品ポリシーに関するログでは、推奨表示後に以下のような流れになっていました。
推奨インテント表示
  ↓
ORCHESTRATION
  ※最初の応答を生成
  ↓
ORCHESTRATION
  ※Retrieveツールを選択
  ↓
Retrieveツール実行
  ↓
ORCHESTRATION
  ※ツール結果を受け取って最終回答を生成
実際のログでは、以下のようなイベントが順番に出力されていました。
TRANSCRIPT_ORCHESTRATION_MESSAGE
TRANSCRIPT_AGENTIC_MESSAGE
TRANSCRIPT_ORCHESTRATION_MESSAGE
TRANSCRIPT_AGENTIC_MESSAGE
tool_use Retrieve
tool_result Retrieve
TRANSCRIPT_ORCHESTRATION_MESSAGE
TRANSCRIPT_AGENTIC_MESSAGE
特に時間がかかっていたのは、Retrieve ツールの結果を受け取った後、最終回答を生成する ORCHESTRATION の部分でした。
一例では、Retrieve の tool_result が返った後、最終回答の TRANSCRIPT_ORCHESTRATION_MESSAGE が出力されるまでに約11秒かかっていました。
tool_result Retrieve
  ↓ 約11秒
最終回答の ORCHESTRATION 出力
別のログでも、tool_result 後の最終回答生成に約7〜8秒かかっていました。
つまり、オーケストレーションタイプでは、回答の推奨タイプのように1回の AnswerGeneration で回答を返すのではなく、以下の処理が直列に積み重なります。
- 何をするか判断する
- 必要なツールを選ぶ
Retrieveツールを実行する- ツール結果を含めて最終回答を生成する
この「考える、ツールを選ぶ、ツール結果を見て回答する」というオーケストレーションのオーバーヘッドが、クリック後の回答生成時間に影響していました。
単純なナレッジ検索と要約で十分なケースでは、回答の推奨タイプのみの方がクリック後の回答表示は高速です。一方で、会話履歴を踏まえた回答や、複数ツールを使うような柔軟な支援を行いたい場合は、オーケストレーションタイプを検討することになります。
回答の推奨タイプとオーケストレーションタイプの比較
今回の検証で見えた違いを整理します。
| 観点 | 回答の推奨タイプ | オーケストレーションタイプ指定時 |
|---|---|---|
| AIプロンプト構成 | 3つのAIプロンプトで構成 | 基本的に1つのオーケストレーション用AIプロンプトで構成 |
| 推奨インテントの自動生成 | 回答の推奨タイプが実施 | 回答の推奨タイプが実施 |
| 推奨インテントクリック後の回答生成 | AnswerGeneration が実施 |
Orchestration が実施 |
| 回答生成時のTranscript利用 | 直接は渡されない | 背景情報として渡される |
| ナレッジ検索 | QueryReformulation 後に検索 |
Orchestration が Retrieve ツールを呼び出す |
| 回答の性質 | 検索結果の要約に近い | 担当者支援メッセージに近い |
| ツール利用 | 固定的なRAGパイプライン | 必要に応じてツールを選択して実行 |
| クリック後の回答生成時間 | 約0.5〜0.7秒 | 約9〜18秒 |
| 速度面の特徴 | 単純なKB回答は高速 | 複数回の推論やツール実行により時間がかかる |
| 文脈を踏まえた表現 | やや苦手 | 可能 |
最後に
今回は、Amazon Connect AIエージェントのエージェントアシスタントについて、オーケストレーションタイプを指定した場合の内部動作をログから確認しました。
オーケストレーションタイプを指定した場合、手動検索では、ログ上、手動検索タイプではなくオーケストレーションタイプのAIエージェントのみが実行されていました。
一方で、顧客発話をトリガーにクリック可能な推奨インテントを表示する回答の推奨では、推奨インテントの生成段階で回答の推奨タイプのAIエージェントが利用され、クリック後の回答生成でオーケストレーションタイプのAIエージェントが利用されていました。
手動検索
  オーケストレーションタイプ

回答の推奨
  推奨インテント生成: 回答の推奨タイプ
  クリック後の回答生成: オーケストレーションタイプ
また、クリック後の回答生成時間にも差がありました。回答の推奨タイプのみの場合は約0.5〜0.7秒でしたが、オーケストレーションタイプでは複数回の ORCHESTRATION 呼び出しと Retrieve ツール実行により、最終回答まで約9〜18秒かかっていました。
単純なナレッジ検索と要約で十分な場合は回答の推奨タイプのみ、会話履歴を踏まえた支援やツールを使った柔軟な処理が必要な場合はオーケストレーションタイプを検討するとよさそうです。