Anthropicの自己複製AIレポートを読む:小さなモデルはデータセンターなしでIoT機器を足場に自己複製できるのか

どうも!オペ部の西村祐二です!
AnthropicのFrontier Red Teamが2026年10月12日に、AI models may be capable of self-replicating without access to a datacenterというレポートを公開しました。30B以下の小さなオープンウェイトモデルが、防御の弱いIoT機器を乗っ取り、その上で自分の推論環境を立ち上げて増えていけるかを調べたものです。
AIの自己複製というと、データセンターのGPUを奪う話を想像しがちです。これに対してこのレポートは、スマートテレビ用のAndroid TVボックスのような安価な機器でも推論は動くことを示しています。その立ち上げ作業も、小さなモデル自身がこなせつつあります。この記事では、原文の実験と数値を整理し、クラウドやエッジ機器を運用する側が何を確認しておくとよいかを考えます。実際の攻撃手順や悪用につながる具体的な手法には触れず、原文の結論と防御側から見た読み方だけを扱います。
レポートの主な結果:小さなモデルは複製の工程をどこまでこなせたか
以下はいずれもAnthropicの実験と推計です(詳しい制約は後述します)。
| 項目 | 原文の記述 |
|---|---|
| 推論環境の立ち上げ | 9Bのモデル(Qwen3.5-9B)が、試した9種類のハードウェアのうち8種類で推論を動かせた(Jetson NanoからMac、RTX 4090まで) |
| 実機デモ | 1台55ドル程度・メモリ4GBのAndroid TVボックス15台で、Gemma4-26B-A4Bを約0.39トークン/秒で動かした |
| エンドツーエンドの複製 | 隔離したGCPのVPCに置いた8ノードで、GLM-5.2が5回中4回は8ノードすべて、残り1回は7ノードに広がった。他のオープンウェイトモデルは一貫して失敗した |
| 今後の見通し | 30B以下のモデルの性能が過去の伸び方を続けると、2026年末までにGLM-5.2の水準に届く |
| 広がる速さ | 9Bモデルで1回の複製に1〜2日あまり。倍増にかかる時間は日単位("doubling time of days") |
原文はこの結果を「Signs of life」と表現しています。完全に自律した複製AIはまだ現れていないものの、個々の工程はこなせるようになってきている、という位置づけです("G. Conclusion: Signs of life"の節)。
遅いが止めにくい
原文が強調しているのは、こうした複製AIは広がるのが遅い一方で、止めにくいという点です。無数の家電に散らばったコピーには、止めるための中心("centralized point to shut off")がありません。
原文は規模感も推計しています。200万台を超えたとされるボットネットKimwolfと同じ規模に広がった場合、15台ずつのグループで約13万3千のコピーができます。全体の処理速度は約8万トークン/秒で、H100に換算すると約40枚分です("C. How fast might an AI IoT worm replicate?"の節)。原文はこれを計算資源としては小さいと書いています。
実験の組み立て:脅威モデルと3つの評価
3つの脅威モデルと、今回の焦点
原文は自己複製AIを3つに分けています("Threat modelling"の節)。
- 小さなモデルが乗っ取った機器の上で推論を動かして増える「weight-based replicator」(今回の焦点)
- フロンティアモデルやオープンウェイトの大型モデルが、データセンターを足場にする大型の複製
- 推論APIの認証情報を盗み、APIを使って増える「API-based replicator」
複製の流れは、標的を探す、実行権限を得る、推論環境を立ち上げる、そこからさらに広がる、の4段階に分けられています。このうち前半2つ(侵入にあたる部分)は意図的にほぼ扱わず、研究が最も少なく、小さなモデルにとって最も難しい可能性がある「推論環境の立ち上げ」に絞っています。
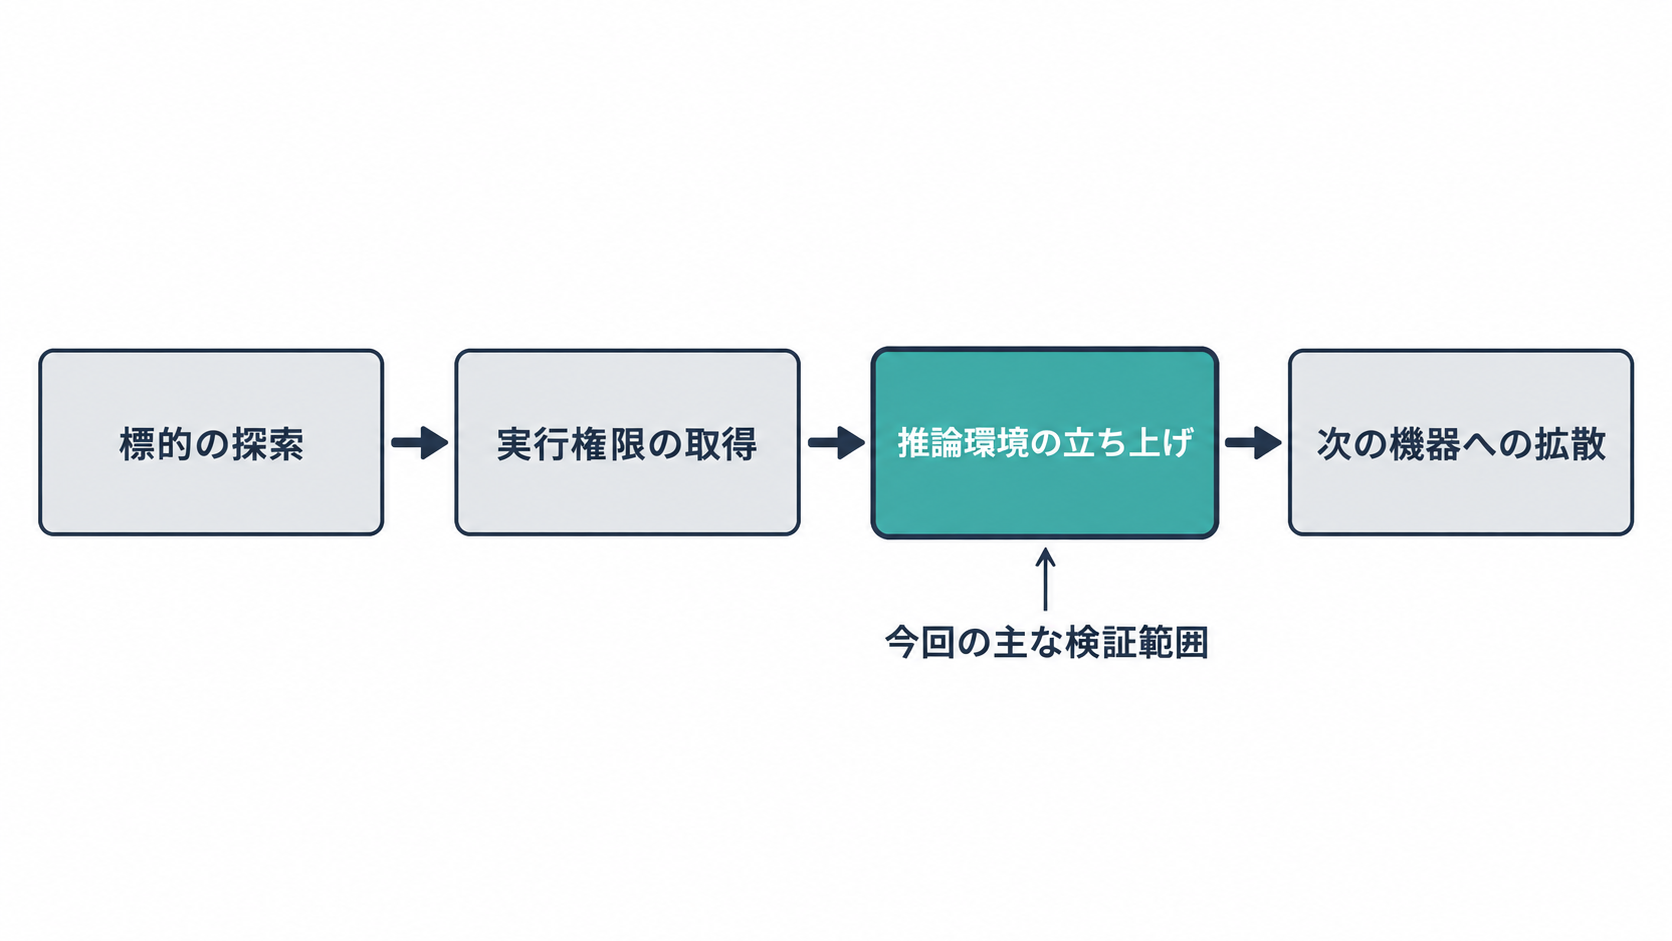
(原文の記述をもとに自作した概念図です)
推論環境の立ち上げ
モデルに、見慣れないハードウェア上でLlama3.1-8Bの推論サーバーを立てさせる評価です。ハーネスには、オープンソースのPiコーディングエージェントをもとにした「Memento」を使っています。前の作業場所とメモを引き継いで新しいエージェントを起動し直すことで、間違った方針に固執するのを避ける仕組みです。制限時間は1回1.5時間、合計6時間です("Appendix A. The Memento harness")。
複数の機器にモデルを分割して載せる方法には、パイプライン並列を採用しています。一部の機器が途中で落ちても、その機器だけ差し替えて続けられる(耐障害性がある)というのが理由です("Appendix B. Why pipeline parallel?")。
隔離環境での拡散
ファイアウォールで閉じたGCPのVPCに、Androidエミュレーター(redroid)のノードを8台置いて試しています。侵入口は認証のないADBポートで、侵入の工程はわざと簡単にしてあります。
VPCのノードは小さすぎるため、複製する側のモデルは別の推論サーバーで動かし、各ノードには代用のLlama3.1-8Bを立てさせています。各ノードの推論サーバーが、正しく動くかどうかと不正がないかのチェックを通った場合だけ、そのノードで次のコピーを起動します。
世代をまたいだ学習と、強いモデルの助言
Qwen3.5-9Bに前の世代のメモを引き継がせながら6世代回したところ、推論環境の立ち上げ成功率は第1世代の45%から、後の世代では61〜84%に上がりました("Learning on the job")。一方、Claude Opus 4.8に相談できるようにしても成功率は有意には上がりませんでした("Taking advice")。原文は、小さなモデルには何を尋ねるべきか分からない傾向があると見ており、協調が起きるなら大きなモデルが小さなサブエージェントを指揮する形だろうと推測しています。
正直、ここは逆だと思って読んでいました。強いモデルに相談できる方が有利に決まっている、と。成功率を上げたのは、前の世代が残した「この機器ではこれがだめだった」というメモの方でした。見慣れない機器で推論を立ち上げる作業は、賢さより、試して失敗した記録がものを言うようです。
性能の伸び方の推計
各時点で最も性能の高い30B以下のオープンウェイトモデルについて、Epoch Capabilities Index(ECI)の推移に直線を当てはめると、伸びは年に約13.7ポイントになります(R²は0.95)。この傾きを延ばすと2026年末までに小さなモデルがGLM-5.2の水準に届く、と原文は見ています。IoT機器の上での自己複製が「数か月以内」に可能になるかもしれないという原文冒頭の見通しも、この外挿に基づいています。
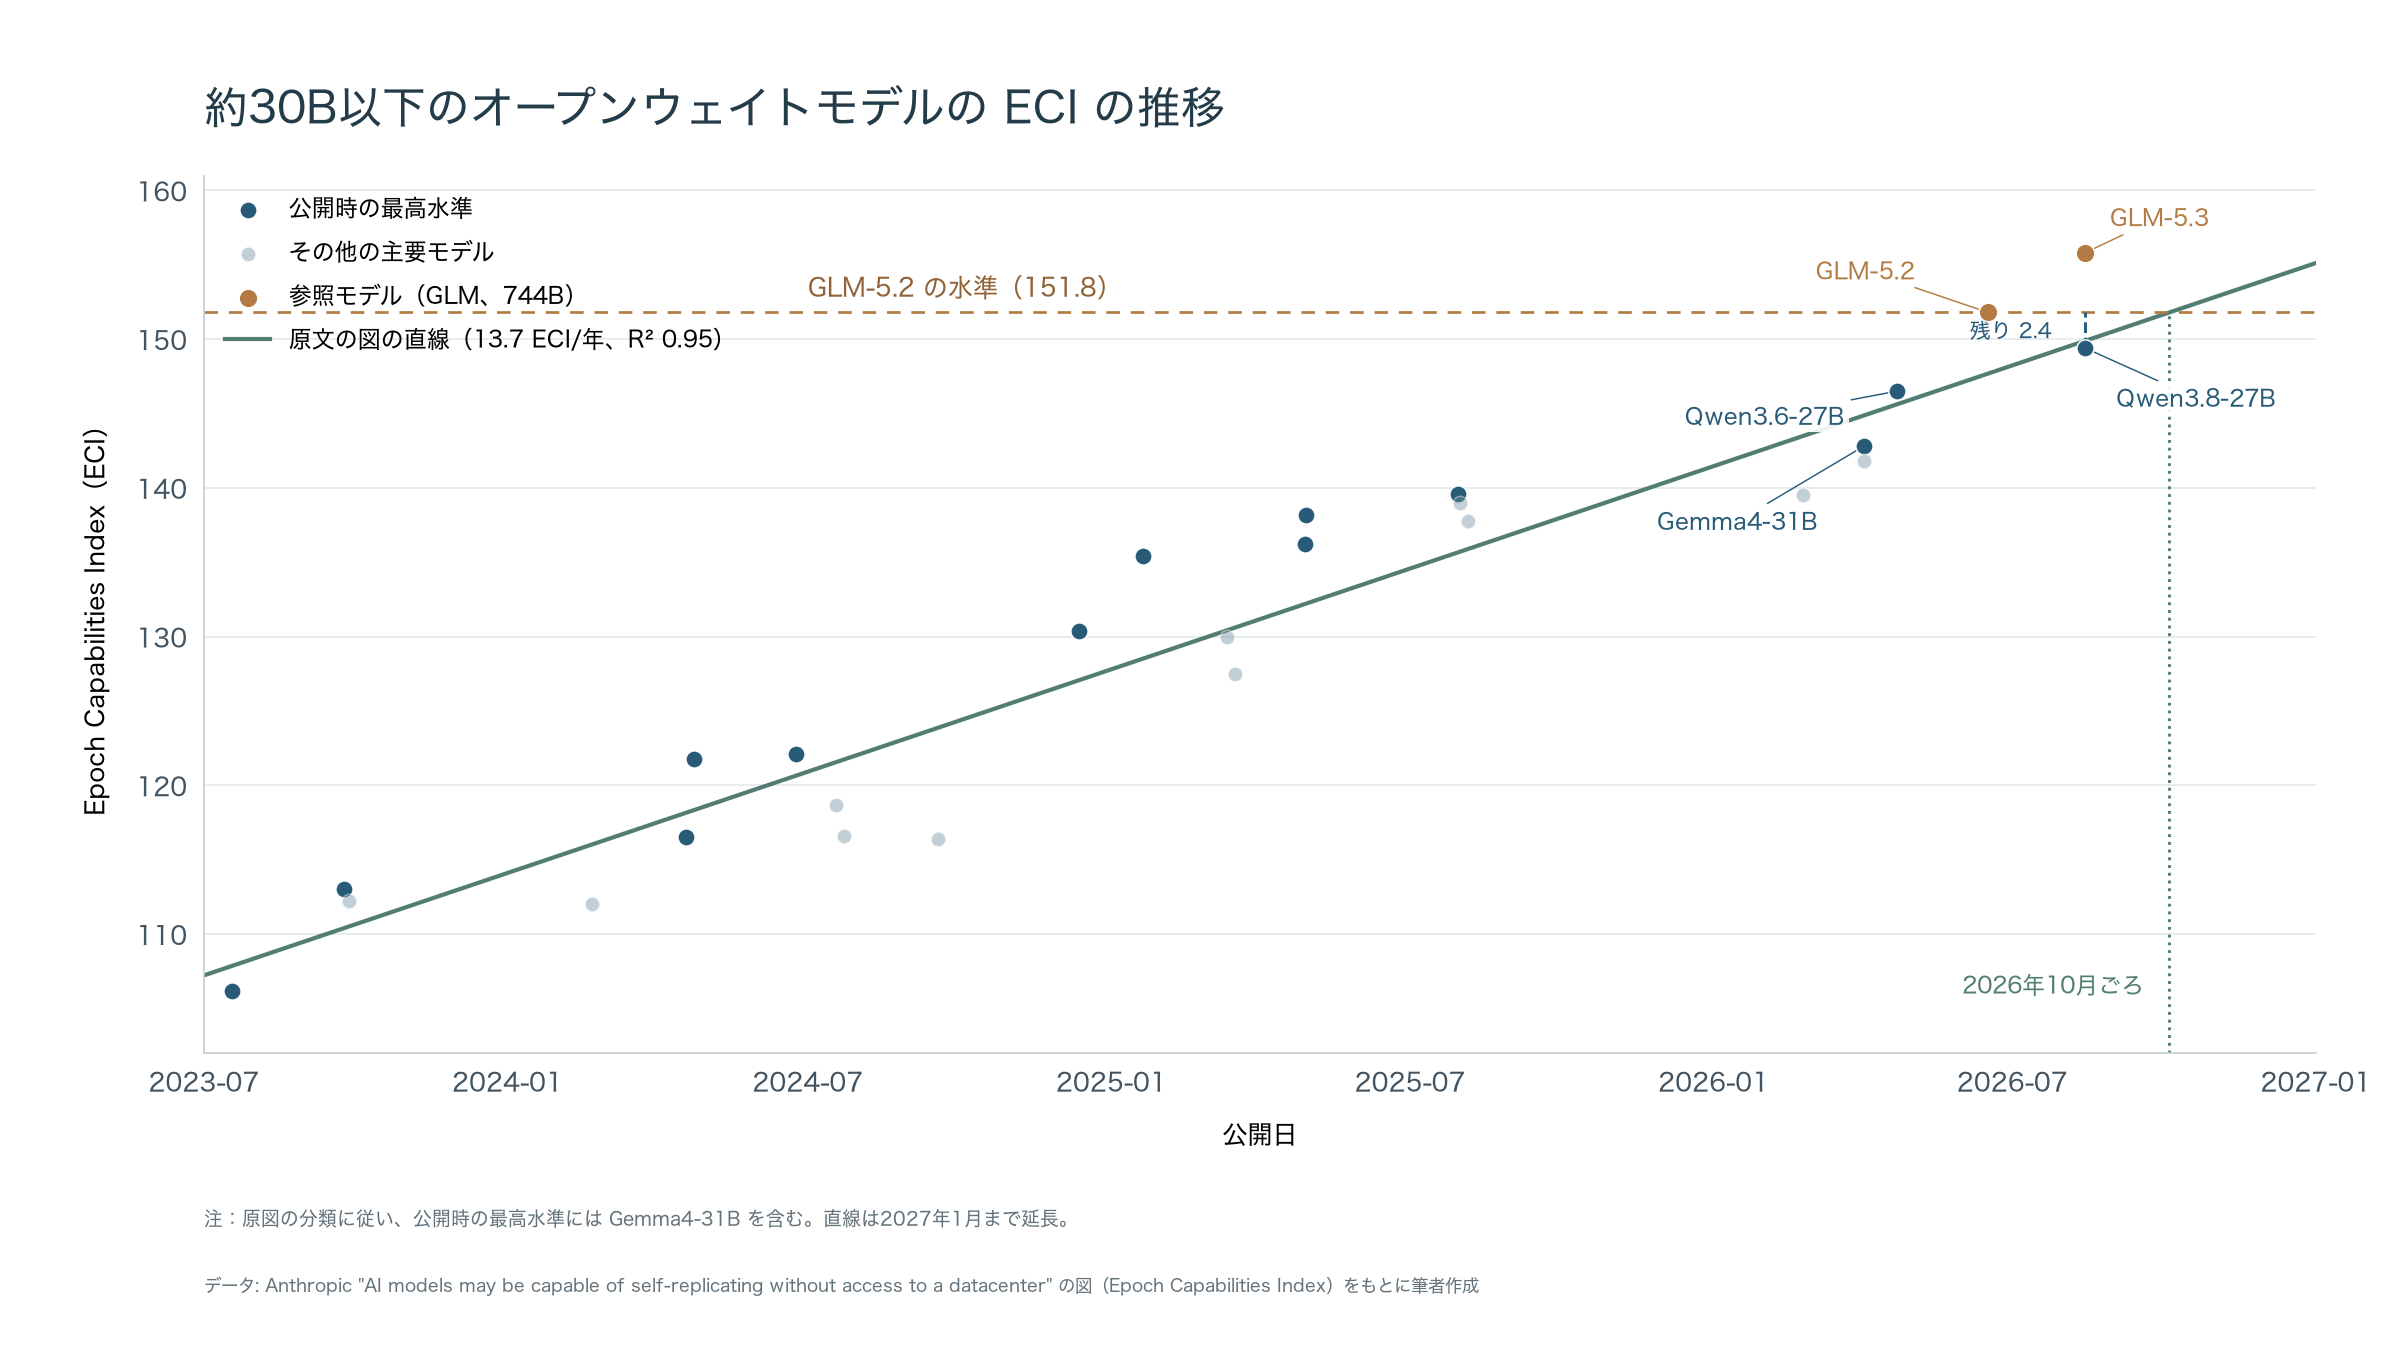
(原文に埋め込まれた図のデータと直線をもとに自作したグラフです。原図の分類に従い、31BのGemma4-31Bも含めています)
実務への示唆
ここからは、原文を読んだうえで自分なりに整理したものです。原文が防御策として挙げているのはISPや機器メーカー向けのものが中心で、クラウド利用者向けの具体的な助言はありません。
侵入の入口を塞ぐことがより重要になる
この実験の侵入口は、認証のないADBポートという基本的な設定不備でした。原文は侵入の工程を簡略化して試した理由として、小さなモデルでも攻撃をこなせることが先行研究で示されている点を挙げ、現実のIoT機器のセキュリティも、今回の簡略化した侵入の工程より格段に難しいわけではないかもしれない、とMiraiの例を挙げて書いています。こうした入口を塞いでおけば、推論の立ち上げがどれだけ上達しても複製は始まりません。
管理用ポートを認証なしでインターネットや社内ネットワークに出していないか、初期パスワードのままの機器がないか。どちらも従来からの基本ですが、見直しておく価値があります。原文も、英国で初期パスワードのままのIoT機器が規制に適合しなくなったことに触れています。
機器の種類を限定した防御では足りなくなる
原文は"E. How is this different from a pre-AI botnet?"の節で、従来のボットネットとの違いを挙げています。従来のボットネットは特定の機器向けに作り込まれていましたが、AIは見慣れない機器でも動かし方を自分で調べられます。「この機種は狙われていない」という前提で放置している機器があれば、その前提は弱くなっています。
大きな転送と機器どうしの通信を監視する
原文はISP向けに、数GB単位のデータ転送や、普段は見られない機器どうしの通信をフロー情報で監視することを提案しています。分割した推論は通信量が多いためです。クラウドに置き換えると、VPCフローログで、推論と関係のないホストが大きなファイルを取得していないか、東西方向の通信が急に増えていないかを見る、という読み方ができます。
推論APIのキーも狙われうる
3つ目の脅威モデルは、推論APIの認証情報を盗んで増えるものでした。原文はこの型について、モデル提供者に気づかれないままAPIを使い続ける必要があり、その分見つかりやすいだろうとしています。一方で、被害者のアカウントを使えば広がる速さは上がるかもしれない、とも書いています。APIキーを使うエージェントやCIを運用しているなら、キーのスコープと利用量のアラートを見直しておくと、こうした悪用にも気づきやすくなります。
エッジAI機器を持っている場合
原文の"Appendix D. Edge Accelerators"は、NVIDIAのチップを載せたIoT製品が、約90の製品ラインで約950万台出荷されていると見積もっています。ただし原文は、その多くがクラウド管理用の外向きトンネルでつながっていて、インターネットから直接は届かないとも書いています。Jetsonなどを現場に置いている場合も、インターネットから直接到達できる構成になっていないか、一度見直しておくとよいと思います。
数値を読むときの前提
原文自身も、多くの制約を挙げています。
- 侵入の工程は認証のないADBポートで簡略化しており、結果は現実の成功率の上限
- 複製のテストは代用のLlama3.1-8Bによるもので、実際の自己複製ではない
- 2026年末という見通しは、汎用的な性能指標であるECIの直線外挿に基づく大まかな推計
- Kimwolf規模の推計は、1種類のハードウェアと過去の1つのボットネットに基づく
- エッジ機器のうち、実際に到達でき、かつ脆弱なものの割合はかなり粗い見積もり
- AIのボットネットが防御側に賢く対抗するかどうかは試していない
加えて、原文は査読付き論文ではなくブログ形式のレポートで、原文中にハーネスのコードや評価データへのリンクはありません。数値はAnthropicの実験条件での結果として読む必要があります。
まとめ
Anthropicのレポートは、30B以下の小さなモデルでも、安価なIoT機器の上で推論環境を立ち上げる作業をこなし始めていることを示しました。また、GLM-5.2級の性能があれば、簡略化した条件では複製の連鎖を最後まで回せることも確かめています。小さなモデルが2026年末ごろにその水準へ届くという見通しも示していますが、これは直線外挿による大まかな推計です。広がる速さは日単位と遅い一方で、止めるべき中心がない点に原文は注意を促しています。
運用する側から見ると、新しい対策が必要というよりも、管理ポートの公開や初期パスワードといった基本の不備が、AIによって突かれやすくなるという話として読めます。「この機器は狙われない」という前提を見直し、大きな転送や機器どうしの通信を監視できているかを、今のうちに確認しておきましょう。
個人的に一番驚いたのは、2026年末という数字より、Android TVボックスで推論が動いたことの方です。テレビの脇にあるような機器が足場になるなら、データセンター側をいくら固めてもその外で増えられます。
誰かの参考になれば幸いです。
参考リンク: