【iOS 27】パスポートと免許証を撮って宿泊者名簿の下書きにする機能を作って、iPhone 15 Proで測ってみた

こんにちは。リテールアプリ共創部で事業企画を担当しているかめだです。
別記事で、ホテルの事前チェックインについて書きました。宿泊者が予約後にスマホで氏名や住所を入力する仕組みは広がっている一方、外国人宿泊者のパスポートの確認と名簿への転記は、当日フロントの仕事として残っています。そこで、送る前に宿泊者のiPhoneの中でパスポートや運転免許証の券面を読み、本人が確認してから名簿の項目として送る設計を考えました。
エンジニアではない私ですが、今回は実際にAIを使ってアプリを作って、手元の iPhone 15 Pro で精度と速度を測ってみました。合成したパスポート画像で仕組みが動くことを確かめたあと、私と家族の実物の書類で測っています。
先に、前回の仮説への答え
前回の記事で「こうすれば成立するはず」と書いたことを4つに分け、実物のパスポート2点と運転免許証1点で答えます。パターンを4通り試し、最後に結果の数字を載せます。
| 前回の仮説 | 答え |
|---|---|
| パスポートと運転免許証を見分けられる | 見分けられました(54/54)。ただし写真をそのままAIモデルに渡す流れでは、原寸の免許証を18回中14回「パスポート」と誤判定しました。文字認識した文字列に手がかりになる言葉があるか、パスポート番号の形や国名があるかで判定するルールに変えるとすべて正解となりました |
| 券面から名簿の項目(パスポートは氏名・国籍・パスポート番号、免許証は氏名・住所)が取れる | パスポートは読み取れました。姓と名は36回中30回、国籍とパスポート番号は33回一致し、間違った値は1回も出ませんでした。残りは空欄になり、本人が入力するか撮り直します。免許証の氏名は18回中3回で、6条件のうち2条件でしか読めません |
| 機械読取の2行(MRZ)が読める | 読めました(24/36)。AIモデルでは、埋める文字の個数を毎回間違えます。文字認識の枠をつなぎ、埋める文字と検査数字を計算で作り直すと、36回中24回で検算が通りました |
| 読めない項目は空欄で残る | 残りました。検算の通った機械読取がなく3項目そろわない写真は、結果を出さず撮り直しを求める作りにしました |
問いを2つに分けて、結論を先に書きます。
1つ目。Apple Intelligence の端末内モデルに券面の写真を渡して名簿を埋めるサービスは、成立しません。 写真を丸ごと渡すと、パスポートの姓は36回中15回、番号は12回しか合いませんでした。機械読取の2行は1回もうまくいきませんでした。
2つ目。パスポートを撮って名簿の下書きを作るサービス自体は、成立します。 氏名・国籍・パスポート番号が取れ、間違った値は1回も出ませんでした。かかった時間は1.2秒です。ただし機能としては iOS 13 からある文字認識と、検査数字や値の形というルールで、Apple Intelligence ではありません。最後までAIモデルに残っていた、認識した文字列の振り分けもルールに置き換えたところ、精度は同じで誤読が消え、かかった時間は10秒前後から1.2秒になりました。
免許証は見送りです。6条件のうち読めたのは2条件で、加えて読めた値の正しさを機械で確かめる手立てが券面にありません。「本人確認書類を撮れば名簿ができる」という形では出せず、パスポートに絞った機能になります。
フロントに残っている、パスポートの確認と名簿への転記
宿泊者名簿には氏名・住所・連絡先を書き、国内に住所のない外国人には国籍とパスポート番号を加え、パスポートの写しを保存します。事前チェックインで氏名や連絡先は先に受け取れても、パスポートを確認し、コピーを取り、名簿に転記する作業はチェックインの時間帯に集中して残ります。
上の4点を確かめるために、前回の設計どおりにアプリを組みました。
業務の背景と法令上の区分は、前回の記事事前チェックインで、宿泊者がパスポートを撮って名簿を自分で埋めるに書いています。
種別を先に判定して、項目の定義を切り替える画面を作った
作った画面は4段です。券面の写真を選ぶ、書類の種別を判定する、種別ごとの項目に下書きが入る、元の券面と並べて確認して送る。パスポートには住所が無いので、パスポートを撮った宿泊者には住所の入力欄を出します。連絡先と到着日・出発日は券面に無いので、どちらでも本人が入力します。
iOS 27 からは、画像をそのままAIモデルへ渡せます(Attachment で画像をプロンプトに添付する)。受け取る型を先に決めておけば、その型で返ってきます。前回の記事で「どちらの書類が撮られたかをまず判定してから、それぞれの項目に振り分ける」と書いた手順を、そのまま型にしました。
@Generable
enum DocumentKind {
    case passport        // パスポート
    case driversLicense  // 運転免許証
    case other           // どちらでもない
}

@Generable
struct KindJudgement {
    @Guide(description: "写っている書類の種別。passport はパスポート(PASSPORT の表記、顔写真、下部に < を含む2行)。driversLicense は日本の運転免許証(横長のカード。氏名・住所・交付・番号の欄と「まで有効」の色の帯)。other はどちらでもない")
    var kind: DocumentKind
}

@Generable
struct PassportFields {
    @Guide(description: "姓。ローマ字の行を券面の表記どおりに写す。読めなければ nil")
    var surname: String?
    @Guide(description: "名。ローマ字の行を券面の表記どおりに写す。読めなければ nil")
    var givenNames: String?
    @Guide(description: "国籍。Nationality の欄の表記どおりに写す。読めなければ nil")
    var nationality: String?
    @Guide(description: "パスポート番号。Passport No. の欄の表記どおりに写す。読めなければ nil")
    var passportNumber: String?
}

@Generable
struct LicenseFields {
    @Guide(description: "氏名。券面の表記どおりの漢字。読めなければ nil")
    var name: String?
    @Guide(description: "住所。券面の表記どおり。複数行なら1行につなげる。読めなければ nil")
    var address: String?
}
読めない項目は nil で受けます。Optional はそのまま @Generable で通りました。呼び出しは2段です。まず KindJudgement を受け、種別に応じて PassportFields か LicenseFields を受けます。「どちらでもない」なら手入力の画面に戻します。画像に付けたラベルは、指示文の中でも同じ文字列で名指しします。
動かしてみた
iPhone 15 Pro の実機で、合成したパスポートと免許証を読ませた確認画面です。
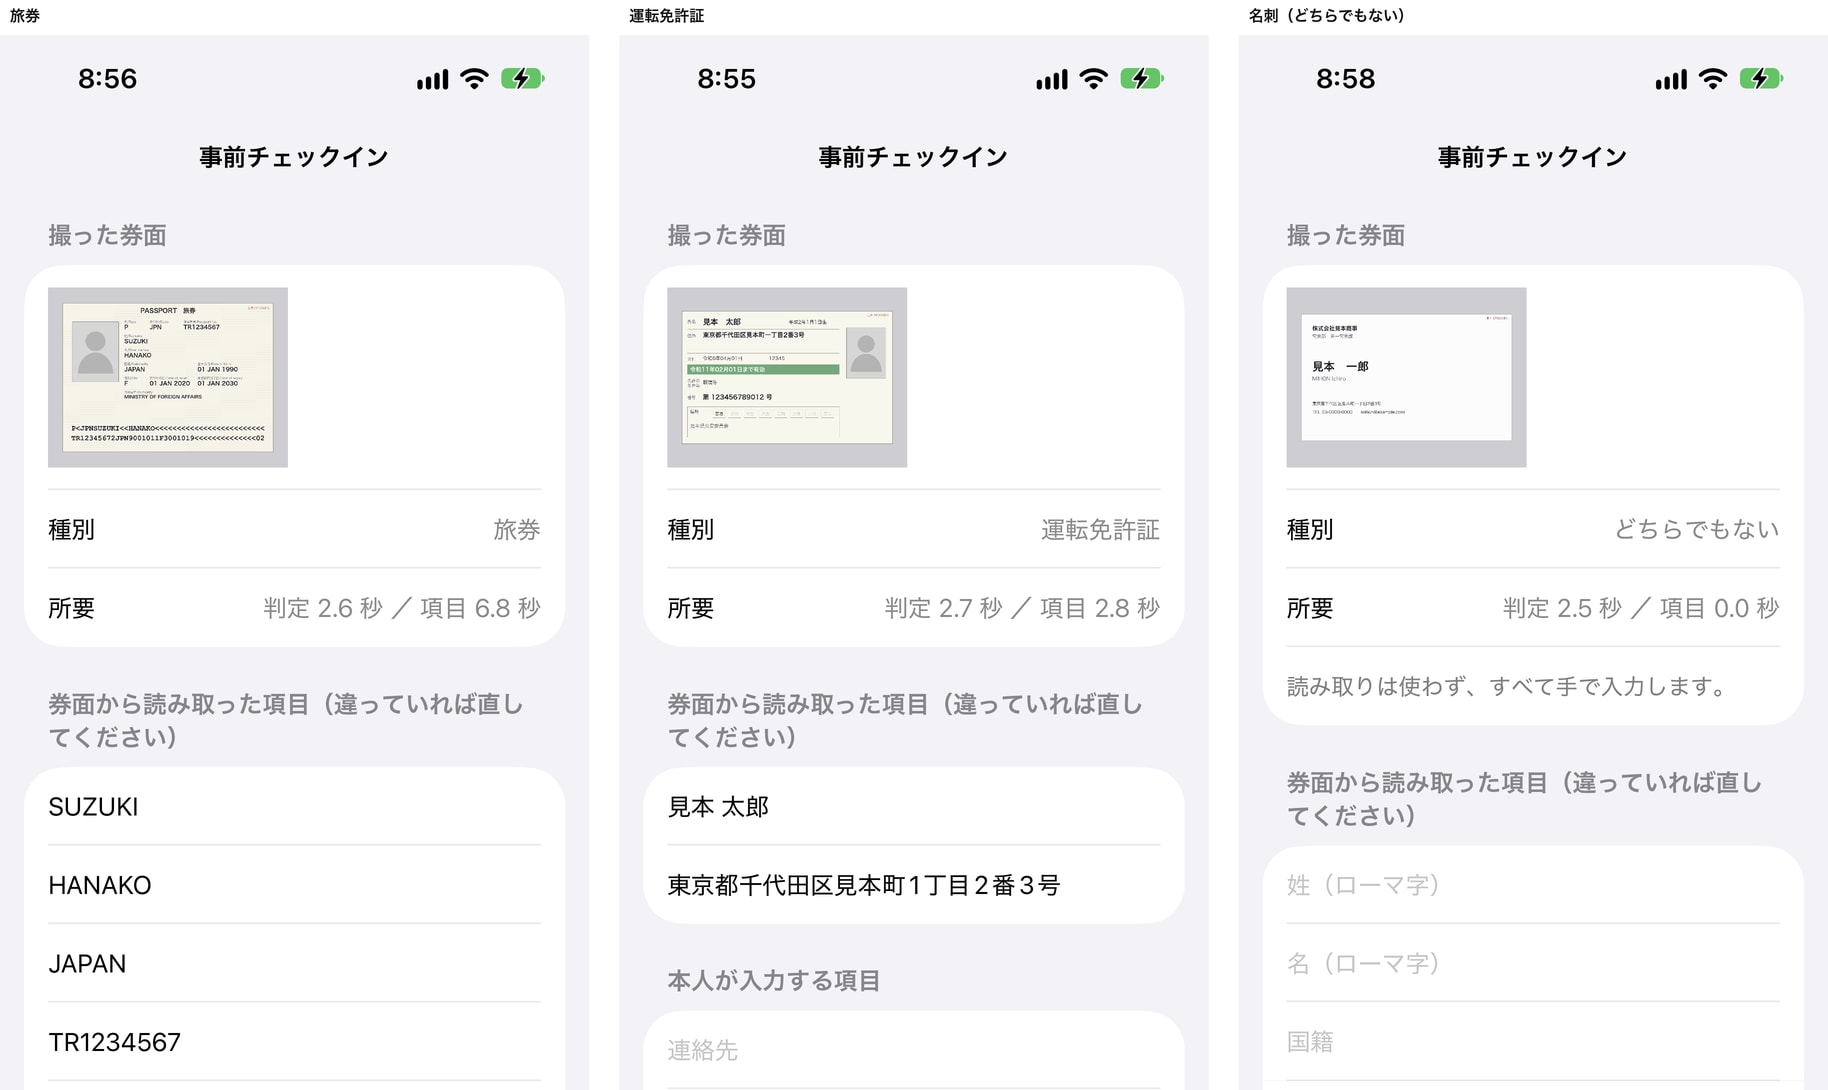
こんな感じで、パスポートなら姓・名・国籍・パスポート番号の欄に、免許証なら氏名・住所の欄に下書きが入ります。名刺を渡すと「どちらでもない」となり、手入力の画面に進みます。画面の券面は、仕組みの確認に使った合成の見本です。実物の券面は載せません。実物ではどこまで崩れるんだろうな、という気持ちで次の検証に進みました。
実物のパスポートと免許証では、どこまで崩れたか
私と家族のパスポート2点と、運転免許証1点で試しました。6条件(明るい室内、低照度、傾き15度、手ぶれ、反射、机の上)で撮り、カメラの原寸と2メガ画素に縮小した2通りで各3回、計108回です。画像、氏名、番号は載せません。正解は券面と照合してあります。
| 見たもの | 実物・原寸 |
|---|---|
| パスポートの種別判定 | 36/36 |
| 免許証の種別判定 | 4/18 |
| パスポートの姓 | 15/36 |
| パスポートの名 | 11/36 |
| パスポートの国籍 | 30/36 |
| パスポート番号 | 12/36 |
| 機械読取2行目の英数字部分 | 1/36 |
パスポートの種別判定だけはすべて正解でしたが、姓は半分、名は3分の1、番号は3分の1しか一致しませんでした。 文字が大きく平面で背景が均一な合成の見本では姓・名・国籍が全て一致していたので、実物の文字の小ささ、ラミネートの光沢と地紋、写真の中で券面が占める面積の小ささが影響していると考えられます。
間違え方には法則がありました。パスポート番号の誤りの半分は、正しい9文字の後ろに機械読取の検査数字や続きの文字が付きました。名の誤りは、正しい綴りの末尾に毎回同じ2文字を足していました。揺れではなく、同じ誤りを繰り返すので、何回か読ませて多数決を取る対策は使えません。傾き15度のパスポートは12回中0回で全滅し、原寸の免許証は18回中14回が「パスポート」と判定されました。免許証をパスポートとして読ませたときには、券面に無いローマ字氏名が返ってきます。種別を取り違えると、モデルは無い項目を作ってしまいます。前回の記事に「読み取れなかった項目は空欄のまま残す」と書きましたが、空欄で残るのは種別の判定が合っているときだけです。2メガ画素のパスポートを机の上で撮った1回では、項目の抽出が止まりました。応答は Response may contain sensitive or unsafe content でした。実在の本人確認書類を読ませると、Apple 側の安全のための判定に当たることがあります。
崩れた原因が、モデルの限界なのか渡し方なのかを切り分けてみました。合成券面は券面が画面の9割を占め、実物の写真では2割前後です。モデルは画像を内部で縮小するので、券面が小さいほど文字がつぶれます。そこで文字認識で得た文字の位置から券面の範囲を切り出し、画面の4〜5割を占める大きさにして渡し直しました。
| 見たもの | そのまま渡す | 切り出して渡す |
|---|---|---|
| 免許証の種別判定 | 4/18 | 17/18 |
| パスポートの姓 | 15/36 | 24/36 |
| パスポートの名 | 11/36 | 14/36 |
| パスポートの国籍 | 30/36 | 36/36 |
| パスポート番号 | 12/36 | 15/36 |
| 機械読取2行目 | 0/36 | 0/36 |
渡し方に難しいところがあったなと感じています。切り出すと種別判定と国籍は全て正解になり、免許証をパスポートと誤判定していたのは券面が小さかったためと分かります。それでも名は14/36、番号は15/36で、誤り方も同じです。番号は正しい9文字の後ろに余分が付き、名は末尾に同じ2文字が付きます。文字が見えていないのではなく、読み取る範囲を区切れなかったので、ここがモデルの限界と考えます。
前回の判断表に当てると「特定の項目でほぼ毎回直しが要る」に該当し、この作りのままなら「見送る」の列です。
文字の認識をVisionに任せ、AIには振り分けだけをさせた
さて、間違え方を見ると、文字認識と振り分けのどちらで落ちたかが分かれます。30億パラメータのモデルは、細かい文字を1文字ずつ正確に読み取る業務が苦手です。一方で、どの文字列がどの項目かという判断はできています。
そこで役割を分けました。文字の認識はiOSに以前からある文字認識の仕組み(Vision)に任せ、認識した文字列の一覧だけをモデルに渡して、種別と項目の振り分けをさせます。画像はモデルに渡しません。機械読取の2行はモデルを通さず、認識結果から形式で拾って埋め直し、検査数字で検算します。
import Vision

/// 文字認識。日英・補正ありと、英語のみ・補正なし(機械読取と番号の照合用)の2回かける
static func recognize(_ image: CGImage) throws -> [String] {
    let request = VNRecognizeTextRequest()
    request.recognitionLevel = .accurate
    request.recognitionLanguages = ["ja-JP", "en-US"]
    request.usesLanguageCorrection = true
    try VNImageRequestHandler(cgImage: image, options: [:]).perform([request])
    // 上から下、左から右に並べて文字列にする
    return (request.results ?? [])
        .sorted { abs($0.boundingBox.midY - $1.boundingBox.midY) > 0.015
                  ? $0.boundingBox.midY > $1.boundingBox.midY
                  : $0.boundingBox.minX < $1.boundingBox.minX }
        .compactMap { $0.topCandidates(1).first?.string }
}

// モデルには文字列の一覧だけを渡す
let lines = try recognize(cgImage)
let response = try await session.respond(
    to: "次の文字列の一覧から、姓・名・国籍・パスポート番号を選んでください。\n" + lines.enumerated().map { "\($0.offset + 1). \($0.element)" }.joined(separator: "\n"),
    generating: PassportFields.self)
この作りを3回直しました。1回目は文字列を渡すだけ。2回目は、種別を手がかり語のルールで先に決めました。「運転免許証」「公安委員会」「PASSPORT」「機械読取の行」があるかで判定し、割れたときだけモデルに聞きます。パスポート番号は、検算が通った機械読取の番号を優先しました。3回目は、姓・名も検算が通った機械読取から取るようにしました。無ければ「Surname」「Given names」の欄名の直後の行をルールで取り、どちらも無いときだけモデルに聞きます。
/// 埋め文字の個数だけが崩れた2行目を、規定の位置に < を補って44文字にそろえる
static func repairLine2(_ raw: String) -> String {
    let t = normalize(raw)
    guard t.count != 44, t.count >= 30 else { return t }
    let chars = Array(t)
    let head = String(chars[0..<28]), tail = String(chars[(chars.count - 2)...])
    guard String(chars[28..<(chars.count - 2)]).allSatisfy({ $0 == "<" }) else { return t }
    return head + String(repeating: "<", count: 14) + tail
}

/// 重み 7,3,1 の繰り返しで検査数字を求める(ICAO 9303)。数字はそのまま、A〜Z は 10〜35、< は 0
static func checkDigit(_ s: String) -> Int? {
    let weights = [7, 3, 1]
    var sum = 0
    for (i, c) in s.enumerated() {
        guard let v = value(c) else { return nil }
        sum += v * weights[i % 3]
    }
    return sum % 10
}
実物3点を原寸で各3回読ませた結果です。
| 見たもの | 写真をそのまま渡す | Vision 1回目 | Vision 2回目 | Vision 3回目 |
|---|---|---|---|---|
| 所要の中央値 | 9.5秒 | 4.1秒 | 2.8秒 | 2.7秒 |
| 打ち切り・エラー | 12回 | 0 | 1 | 2 |
| パスポートの姓 | 15/36 | 24/36 | 25/36 | 30/36 |
| パスポートの名 | 11/36 | 25/36 | 25/36 | 30/36 |
| パスポートの国籍 | 30/36 | 36/36 | 35/36 | 36/36 |
| パスポート番号 | 12/36 | 19/36 | 35/36 | 36/36 |
| 機械読取2行目が完全一致し検算合格 | 0/36 | 12/36 | 12/36 | 12/36 |
| 免許証の種別判定 | 4/18 | 4/18 | 12/18 | 12/18 |
| 免許証の氏名(判定できた回) | 0/4 | 0/4 | 0/12 | 0/12 |
パスポートは、文字認識をVisionに任せてルールで振り分けると実用の水準に近づきました。 番号と国籍は全て一致、姓・名は30/36、かかった時間は写真を渡す作りの3分の1以下で、打ち切りも消えました。
姓・名を出所別に見ると、機械読取から取った22回と欄名のルールで取った9回は全て正しい値でした。外したのはモデルに選ばせた時だけです(41回中24回一致)。モデルを最後の手段にするほど、全体の精度が上がります。
機械読取の2行は、Visionなら読めます。36回中12回で2行が完全に一致し、検算も通りました。取れなかった回はVisionが2行を1行に繋げたり < を落としたりしていますが、取れた回は全て正しいので、検算が通れば信じてよい値です。モデルに読み取らせた場合は、英数字は正しくても埋め文字 < の個数を毎回間違え、< を70個以上返し続けて60秒の打ち切りに当たる回もありました。繰り返しの多い文字列を書かせるのは、この大きさのモデルに向きません。
iOS 27 の標準の文字読み取りツール(OCRTool)をモデルに持たせる作りも試しました(AI にツールを持たせる)。かかった時間が約4倍になるだけで、一致率は変わりませんでした。Vision を直接呼んで文字列を渡す作りとは別物です。
検算が通らない回は、正しく読めた番号でも「不合格(読み直しか手入力)」と表示します。名簿に誤りは入りませんが、宿泊者の手間は増えるので、通る率を上げる撮り方の誘導が次の課題です。
写真の大きさは、この作りでは原寸のほうがよい結果でした。2メガ画素に縮小すると姓・名が25/36、番号が30/36に落ちます。券面を切り出してから渡すのも逆効果で、番号が27/36、機械読取が6/36に落ちました。文字の位置から切り出す方式は、認識しきれなかった行を切り落とします。パスポートは切り出さずに渡します。
免許証で残った問題
では、免許証です。写真をそのままAIモデルに渡す作りでは種別の判定が18回中4回でした。文字認識の結果から手がかり語を探すルールに変えると全て正解しますが、氏名は18回中3回しか読めません。
読めない理由は選び方ではなく、文字認識のところにあります。認識結果の文字列に正しい氏名が含まれていたのは6条件のうち2条件(明るい室内と机の上)だけでした。残る4条件では、人名の漢字がそもそも認識されません。手ぶれでは認識された枠が10個、低照度では11個まで落ちます。読めている条件では50個を超えます。
券面を切り出して拡大しても、鮮明にしたりコントラストを変えたりしても、この4条件は読めるようになりませんでした。読める条件では何をしても読め、読めない条件では何をしても読めません。撮り方の誘導で条件そのものを変えるしかない、というのが今の見立てです。
もう1つ、免許証には照合の手立てがありません。パスポートの機械読取は検査数字を持つので、読めた値が正しいかをアプリ側で確かめられます。免許証は検査数字も値の再掲もないので、確かめられません。そこで、別々の読みが2つ以上一致したときだけ答えを出す作りにしました。氏名の誤読は0回になりましたが、住所は反射の条件で3回誤りが残っています。免許証は、人が券面と照合する前提でしか使えません。
読みきれない原因を、認識結果の枠まで降りて調べた
ここまでで、姓と名は6回に1回外れ、機械読取は3回に1回しか読めていませんでした。渡し方の工夫では限界と感じたため、原因を先に特定することにしました。実物の写真18枚を手元のMacで文字認識にかけ、枠の位置、読み取った文字、2番目と3番目の候補まで全部書き出して、1枚ずつ目で見ています。
原因は4つありました。
1つ目は、機械読取の行が複数の枠に割れていたことです。文字認識は券面の下2行を1個から5個の枠に分けます。アプリは枠を1行ずつ見ていたので、44文字の形にならず捨てていました。同じ高さの枠をつないでから見ると、12枚のうち8枚で2行目が復元できます。
2つ目は、埋め文字の数を読もうとしていたことです。記号の連続は毎回違う長さで認識されます。短いときは28文字、長いときは92文字でした。機械読取の2行目は文字の位置が決まっているので、埋め文字14文字と末尾2桁の検査数字は読まずに計算できます。正解との差が出ていた位置を数えると、毎回42番目と43番目、つまり検査数字そのものでした。読もうとしていたのは、計算で出せる数字だったわけです。
3つ目は、欄名が崩れるので完全一致で探せないことです。実物の認識結果は「姓/Surnams」「M/Surname」「発行け/Authority」のように崩れます。「Surname」という文字列を含むかで探すと見つかりません。編集距離2まで許して照合すると見つかります。
4つ目は、値をモデルに読み取らせていたことです。値そのものは、文字認識の枠の文字としてほぼ正しく出ていました。姓・名・国籍・番号のいずれも、12枚のうち10枚から12枚で、正解と完全に一致する枠が認識結果の中に存在します。落ちていたのは読み取りの精度ではなく、どの枠を使うかの組み立てでした。
前処理の効き目も総当たりで測りました。欄を切り出したうえで、拡大率を3通り、画像の補正を5通り試しました。補正はなし、鮮鋭化、コントラストと鮮鋭化、ノイズ除去と鮮鋭化、トーンカーブです。これに認識の言語2通りと言語補正2通りを掛け合わせ、1つの欄につき30通りから60通りかけています。
当たり外れは1つも変わりませんでした。 領域が正しければ全部の設定で当たり、領域がずれていれば全部の設定で外れます。文字の傾きから回転量を求めて水平に直す処理も、パスポートの一致率を上げませんでした。画像をきれいにしても読める範囲は広がらず、変えられるのは位置決めだけでした。
原因をつぶすと、AIモデルを使わずに読めた
では、4つの原因に対策を入れた作りを組みました。AIモデルは呼びません。
写真を3通りに作り分けて文字認識にかけます。そのまま、傾きを直したもの、券面を切り出して拡大したものです。次に同じ高さの枠をつないで行にします。機械読取の2行目は、先頭28文字の構造を形で拾い、埋め文字と末尾2桁の検査数字を計算して作り直し、検算が通ったものだけ採ります。姓・名・国籍・パスポート番号は、機械読取、欄名の直下の枠の文字、値の形の3つから候補を集め、機械読取と欄名が一致したものを最優先、次に多数決で決めます。パスポート番号は英字2文字と数字7桁、国籍は国名の語であることを必ず確かめます。検算の通った機械読取がなく、3項目そろわない写真は答えを出さず、撮り直しを求めます。
同じ実物3点を、同じ6条件、各3回で測り直した結果です。
| 項目 | 一致 | 誤読 | 空欄 |
|---|---|---|---|
| 種別判定 | 54/54 | 0 | 0 |
| 姓 | 30/36 | 0 | 6 |
| 名 | 30/36 | 0 | 6 |
| 国籍 | 33/36 | 0 | 3 |
| パスポート番号 | 33/36 | 0 | 3 |
| 機械読取の2行目(検算合格) | 24/36 | 0 | 12 |
| 免許証の氏名 | 3/18 | 0 | 15 |
| 免許証の住所 | 6/18 | 3 | 9 |
かかった時間は中央値1.2秒、最大1.8秒です。エラーと打ち切りはありません。同じ数字が2回の測定で再現しました!
作りを並べます。
| 項目(36回) | 写真を丸ごと渡す | 文字認識の結果から選ばせる | 項目ごとに切り出して読み取らせる | ルールだけ |
|---|---|---|---|---|
| 姓 | 15 | 30(誤読6) | 12 | 30(誤読0) |
| 名 | 11 | 30(誤読6) | 15 | 30(誤読0) |
| 国籍 | 30 | 36 | 33 | 33(誤読0) |
| パスポート番号 | 12 | 36 | 24 | 33(誤読0) |
| 機械読取の検算合格 | 0 | 12 | 12 | 24 |
| 所要の中央値 | 9.5秒 | 2.7秒 | 6.3秒 | 1.2秒 |
姓と名は同じ数で、誤読が6回から0回に減りました。機械読取は2倍に増えました。かかった時間は半分以下です。国籍とパスポート番号だけは、文字認識とモデルの作りが3回多く取れています。その3回は手ぶれの写真で、ルールだけの作りは「読めない」と答えて撮り直しに回しました。当たった値の差ではなく、当て推量を止めた差です。
外国のパスポートでも動くかを、合成の券面5か国(日本・ドイツ・スペイン・韓国・英国)で確かめました。最初は国籍とパスポート番号が15回中3回しか取れませんでした。誤読を止めるために入れた「パスポート番号は英字2文字と数字7桁」「国籍は JAPAN」という確かめ方が、日本の様式に寄っていたためです。ドイツやスペインの番号は形が違います。検算の通った機械読取から来た値は日本の様式で弾かないように直すと、15回中12回になりました。実物の日本のパスポートの数字は変わりません。機械読取は国際標準なので、様式差はここで吸収できます。
宿泊者名簿では、空欄より誤った値のほうが困ります。空欄は本人が気づいて入力しますが、もっともらしい誤りは気づかずに送られます。誤読を0にできたことが、この作り直しでいちばん大きい変化でした。
この業務で、Apple Intelligence で輝けるか?
輝けません。もっと踏み込んで言うと、この業務では要りませんでした。
というのも、券面の文字を読むところは、iOS 13 からある文字認識のほうが確実だからです。どの文字がどの項目かを決めるところも、機械読取の検査数字、欄名の位置、値の形というルールで決められました。最後までモデルに残っていたのは「認識した文字列のどれがどの項目か」の振り分けでしたが、それもルールに置き換えたところ、精度は同じで誤読が消え、かかった時間は半分以下になりました。
パスポートに限れば、券面の写真1枚から名簿の下書きを端末の中だけで作るサービスは成立します。読めた値は機械読取の検査数字で裏が取れるので、アプリ側で正しさを確かめられます。
免許証は見送りです。理由は精度だけではありません。免許証には検査数字も値の再掲もないので、読めた値が正しいかを機械では確かめる手立てがありません。人が券面と照合する前提でしか使えず、その前提だと下書きの価値は小さくなります。加えて6条件のうち読めたのは2条件で、手ぶれ・低照度・傾き15度では文字認識のところで人名の漢字が取れませんでした。
出せるものと出せないものを分けて書きます。パスポートを撮って氏名・国籍・パスポート番号の下書きを作る機能は出せます。誤った値は出ず、読めないときは撮り直しか手入力に回ります。免許証を含めた「本人確認書類を撮れば名簿ができる」機能は出せません。まだ言えないのは外国人宿泊者のパスポートでの精度で、合成の券面5か国では届きましたが、実物は日本のパスポート2冊しか測っていません。このサービスの相手は外国人宿泊者なので、ここが最大の未確認事項です。宿泊者が自分で撮る場面での撮り直しの率と、手入力との時間差も測っていません。
前回の記事では「券面の写真をそのまま渡す機能と、文字を読み取る標準のツールを組み合わせると、券面の写真1枚から名簿の下書きを端末の中だけで作れる」と書きました。端末の中だけで作れる、は正しい。ただし「券面の写真をそのまま渡す機能」は要りませんでした。前回の記事はこの点を直します。
この結論は、連載のほかの記事の作り方にも及びます。写真の文字を端末内モデルに読ませる仮説は、この結果を受けて見直しました。このあとの検証の記事では、文字にするところは文字認識と音声認識に任せ、AIモデルにはルールでは書けない部分(書き直し・要約・抜き出し・タグ付け)だけをさせて測っています。
想定される効果と、次に試すこと
かかった時間は、写真をそのままAIモデルに渡す作りでパスポート1枚10秒前後、文字認識に任せる作りで2.7秒、ルールだけの作りで1.2秒でした。確認画面には「文字を読み取り、名簿の項目に振り分けています」と出します。
前回の判断表に照らすと、こうなります。
| 前回の判断表の行 | この検証で分かったこと |
|---|---|
| フロントで名簿を直した割合(項目別) | 実物のパスポートで、ルールだけの作りなら誤った値は出ない。姓・名は6回に1回、国籍と番号は12回に1回が空欄になり、本人が入力するか撮り直す。免許証の氏名は本人が入力する |
| 重大な誤り(パスポート番号や国籍の取り違え) | 実物のパスポート36回で0回。機械読取の検算が通った24回は番号・生年月日・有効期限の裏が取れている |
| 確認画面から送信まで進んだ割合 | 測っていない。宿泊者を交えた次の段階で数える |
| チェックイン1件の所要時間 | 読み取りは1.2秒。手入力との比較は次の段階 |
次に確かめるのは、券面を枠に合わせて水平に撮らせる誘導と反射を避ける案内を入れ、撮り直しに回った写真が減るかを同じ3点で測り直します。免許証は、人名の漢字が文字認識に含まれない原因(文字の小ささ、券面の地紋、撮り方)の切り分けが先です。実物は3点だけなので、件数を増やす必要もあります。各国のパスポートの様式差、非ラテン文字だけのパスポート、旧様式の免許証、上位機種の大きいモデルも見ていません。
よくある質問
実物3点での結果を、そのまま現場に当てはめてよいですか。
当てはめられません。3点だけの結果で、個体差を含みます。各国のパスポートの様式差や旧様式の免許証も見ていません。仕組みとしてどこで崩れ、どう作れば届くかを確かめた段階のものです。
AIモデルを使わず、文字認識とルールだけで済むのではありませんか。
済みました。パスポートについては、ルールだけの作りが姓・名で同じ数、機械読取で2倍、かかった時間で半分以下、誤読は0という結果になりました。モデルを残す理由として様式差の吸収を考えていましたが、日本のパスポート2点ではルールが外れた回に当て推量をさせるより、撮り直しを求めるほうが安全でした。各国の様式を集めて測り直すまでは、ルールだけで進めます。
iPhone 15 Pro で動くなら、どの端末でも動きますか。
ルールだけの作りはAIモデルを呼ばないので、Apple Intelligence に対応していない端末でも動きます。必要なのは iOS 13 からある文字認識だけです。写真をAIモデルに渡す作りと比べたときの利点が、ここにもあります。
参考
- 「Apple Intelligence でアプリづくりは何が変わるのか(AFM 3 の全体像)」(DevelopersIO) https://dev.classmethod.jp/articles/afm3-introduction/
- 「Attachment で画像をプロンプトに添付する(Foundation Models の画像入力)」(DevelopersIO) https://dev.classmethod.jp/articles/afm3-image/
- 「AI にツールを持たせる(OCRTool・バーコード・端末内検索)」(DevelopersIO) https://dev.classmethod.jp/articles/afm3-tool/
- Apple公式(WWDC2026): https://developer.apple.com/videos/play/wwdc2026/241/
- Apple Developer Documentation, VNRecognizeTextRequest: https://developer.apple.com/documentation/vision/vnrecognizetextrequest
- ICAO Doc 9303 Machine Readable Travel Documents, Part 3(検査数字の計算) https://www.icao.int/publications/pages/publication.aspx?docnum=9303
同じような検証、皆さんの現場でもぜひ試してみてください!
では、おつかめ!
--
クラスメソッドでは、既存スマホアプリをFlutterでiOS/Android同時に作り直し、バックエンドはAWSで再構築する「AI駆動アプリリニューアル」を提供しています。現行アプリの仕様読み解きから設計・実装まで生成AIを組み込んだ開発プロセスで進めるため、レガシー化したアプリのリニューアルを短い期間で作り直します。
サービス詳細・お問い合わせはこちら