【iOS 27】売場の写真を欠品あり・なしに仕分ける機能を作って、iPhone 15 Proで測ってみた

こんにちは。リテールアプリ共創部で事業企画を担当しているかめだです。
前回、売場の写真を「欠品あり」「欠品なし」に仕分けてから本部へ送る設計について書きました。大手チェーンの店舗スタッフが売場の棚を撮って本部に送り、本部が届いた写真を一枚ずつ目で確認している業務です。撮ったその場でiPhoneの中のAIが「欠品あり」か「欠品なし」かを見立てておけば、本部が先に見る写真を絞れる、という設計でした。
今回は実際にアプリを組み、iPhone 15 Proで精度を測ってみました。使ったのは、公開されている店舗の棚の写真と、私が自宅で撮った本棚の写真です。
先に、前回の仮説への答え
では、前回の記事で設計として書いたことを3つに分け、答えます。
| 前回の仮説 | 答え |
|---|---|
| 店舗で撮った時点で「欠品あり」か「欠品なし」かを見立てておけば、本部が先に見る写真を絞れる | 店舗の棚の写真29枚で、見立ては88.5%正しく、合格線の8割を越えました。欠品のない棚を「欠品あり」にしたことは1回もありません |
| 答えの選択肢を「欠品あり」「欠品なし」の2つに決めておく | 答えの形は崩れませんでした。どの作りでも、エラーや候補の外の答えは0回です |
| 画像の理解は、棚に空きがあるかどうかという粗い見立てには向く | 棚の大半が空いた写真には向きます。一部の段だけが空いた棚は外しやすく、自宅の本棚では合格線に届きませんでした |
店舗の棚の写真では、欠品あり・なしの見立ては合格ラインに届きました! 作りの調整に使っていない29枚を各3回、87回見立てて、77回が正解でした。外したのはすべて、欠品のある棚を「欠品なし」と答えた回でした。本部の側から見ると、「欠品なし」と仕分けた写真の中に欠品が混じることがあり、「欠品あり」と仕分けた写真には誤りがありません。
写真をそのままモデルに渡し、2つの答えから選ばせた
作った仕組みは単純です。エンジニアではない私でも、迷わず組めるくらいの単純さでした。棚の写真をそのままAIモデルに渡し(Attachment で画像をプロンプトに添付する(Foundation Models の画像入力))、答えは「欠品あり」「欠品なし」の2つから選ばせます。
@Generable
struct ShelfCheck {
    @Guide(description: "棚に、商品が置かれていない空いた場所があるか。空いた棚板や区画が見えれば「欠品あり」。商品で埋まっていれば「欠品なし」", .anyOf(["欠品あり", "欠品なし"]))
    var stock: String
}
欠品ありと答えても、どの商品が欠けているかは答えさせません。商品名はモデルの知識になるため、前回の記事の設計どおり、商品の特定は本部担当者と棚割データに任せます。
段ごとに見させる作りも比べました。棚の段を上から1段ずつ「埋まっている」「空きがある」で答えさせ、どれか1段でも空きがあれば、写真全体を欠品ありとします。この組み合わせの判断はルールが行います。
@Generable
struct ShelfLevel {
    @Guide(description: "この段の埋まり具合。棚板の端から端まで商品が並んでいれば「埋まっている」。商品の置かれていない棚板が見える区画があれば「空きがある」", .anyOf(["埋まっている", "空きがある"]))
    var fill: String
}

@Generable
struct ShelfLevels {
    @Guide(description: "写っている棚の段を、上から順に1段ずつ", .maximumCount(8))
    var levels: [ShelfLevel]
}
端末の中で見立てを終える理由は、呼び出す回数の多さです。というのも、全国の店舗で毎日何度も棚を撮る前提だと、クラウドのAIに一枚ずつ判定させた場合、呼び出しの回数がそのまま費用になるからです。この理由は前回の記事から変えていません。
測り方
さて、合格ラインは、欠品の見立て(欠品あり・なし)の8割以上が正しいことです。人が直す前提で、一から見るより速いかを根拠に、測る前に決めました。
写真は3組です。
| 組 | 枚数 | 使い方 |
|---|---|---|
| 見本の店舗の棚 | 6枚(欠品あり3・欠品なし3) | 作りを直しながら試すのに使った |
| 確かめ用の店舗の棚 | 29枚(欠品あり18・欠品なし11) | 見本とは別に集めた。作りの調整には使っていない |
| 自宅の本棚 | 6枚(欠品あり3・欠品なし3) | 私が撮った |
店舗の棚の写真は、どちらの組もウィキメディア・コモンズで公開されている写真です。私が店舗で撮ったものではありません。正解は、どの組も測る前に1枚ずつ目で見て決めました。棚板の上に何も置かれていない区画があれば欠品ありです。正解を決めきれない写真と、人物が大きく写る写真は外しています。それぞれの写真を各3回見立てさせました。
この場面は、最初は食事の写真から食べたものを記録する仮説でした。ここで一度つまずいています。料理の見分けを4通りのパターンで試してみましたが、最高47%にとどまり、決めていたルール(同じ画像の理解の次点の場面に差し替える)に従って、棚の欠品に差し替えています。見本の店舗の棚6枚では、写真をそのまま渡す作りが88.9%で、検証に進みました。
店舗の棚の写真29枚で測った結果
作りの調整に使っていない29枚で測った結果です。
| 作り | 見立ての正答 | 欠品ありの写真 | 欠品なしの写真 | 所要の中央値 |
|---|---|---|---|---|
| 写真をそのまま渡す | 77/87 = 88.5% | 44/54 | 33/33 | 1.92秒 |
| 段ごとに見させ、ルールで組み合わせる | 66/87 = 75.9% | 33/54 | 33/33 | 2.42秒 |
写真をそのまま渡す作りが合格しました。欠品なしの写真は、どちらの作りでもすべて正解でした。
当たった形と間違えた形を、模式図にしました。
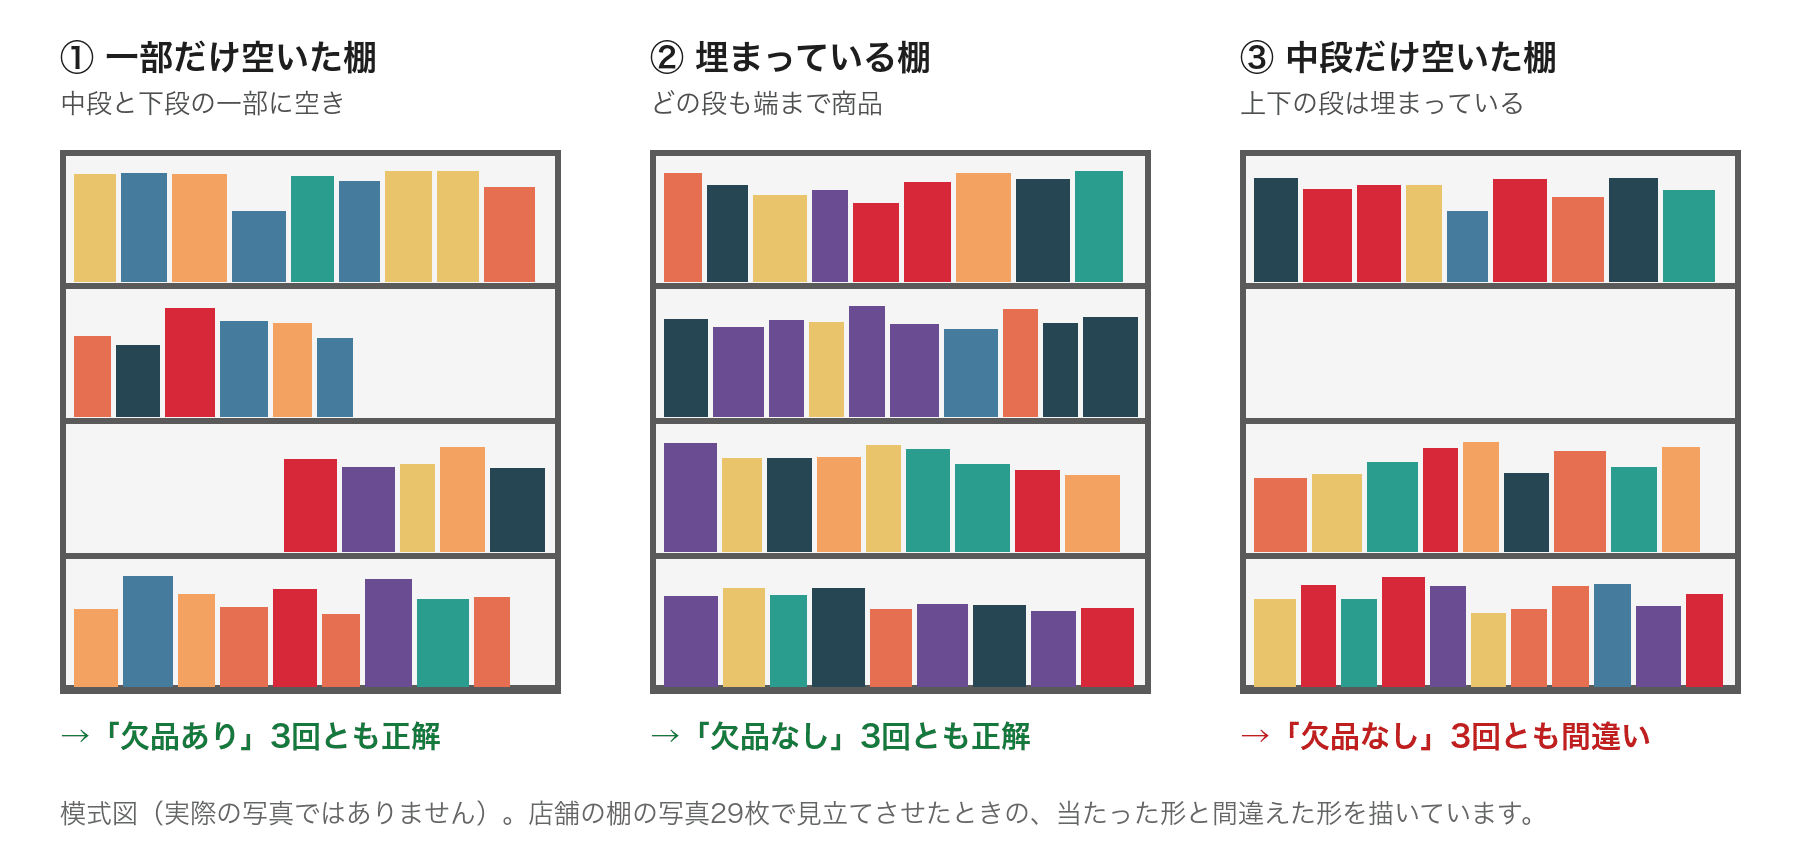
①のように一部の段だけが空いた棚も、3回とも「欠品あり」と答えました。②の埋まっている棚は、3回とも「欠品なし」です。
外した10回を1枚ずつ見ると、6回は中段だけが空いた2枚でした。上下の段には商品が並び、真ん中の段だけが空いている棚を、3回とも「欠品なし」と答えています。写真全体としては埋まって見えるんだろうな、という間違え方です。図の③がこの形です。残りの4回は、棚の大半が空いた写真3枚で、それぞれ1〜2回外しました。
段ごとに見させる作りは、かえって悪くなりました。空いた段も「埋まっている」と答える回が多く、欠品ありの写真を54回中21回外しています。
自宅の本棚では届かなかった
こんな感じで、自宅の本棚6枚でも写真の渡し方を変えた作りを5通り試しました。
| 作り | 見本の店舗の棚 | 自宅の本棚 |
|---|---|---|
| 写真をそのまま渡し、欠品あり・なしを聞く | 16/18 = 88.9% | 10/18 = 55.6% |
| 段ごとに埋まり具合を答えさせ、空きのある段が1つでもあれば欠品あり | 測っていない | 10/18 = 55.6% |
| 写真を横3つに区切って1枚ずつ聞き、どれかが欠品ありなら欠品あり | 16/18 = 88.9% | 9/18 = 50.0% |
| 写真を縦2×横3の6つに区切って聞く | 15/18 = 83.3% | 12/18 = 66.7% |
| 売場や商品の言葉を使わず「棚板の上に何も置かれていない場所はあるか」と聞く | 9/18 = 50.0% | 9/18 = 50.0% |
本棚でここまで外すとは、考えていませんでした。5通りとも、本棚では合格ラインの8割に届きませんでした。欠品なしの本棚3枚はほぼ正しく答え、欠品ありの3枚を、上段がほぼ空の本棚も含めて「欠品なし」と答えています。
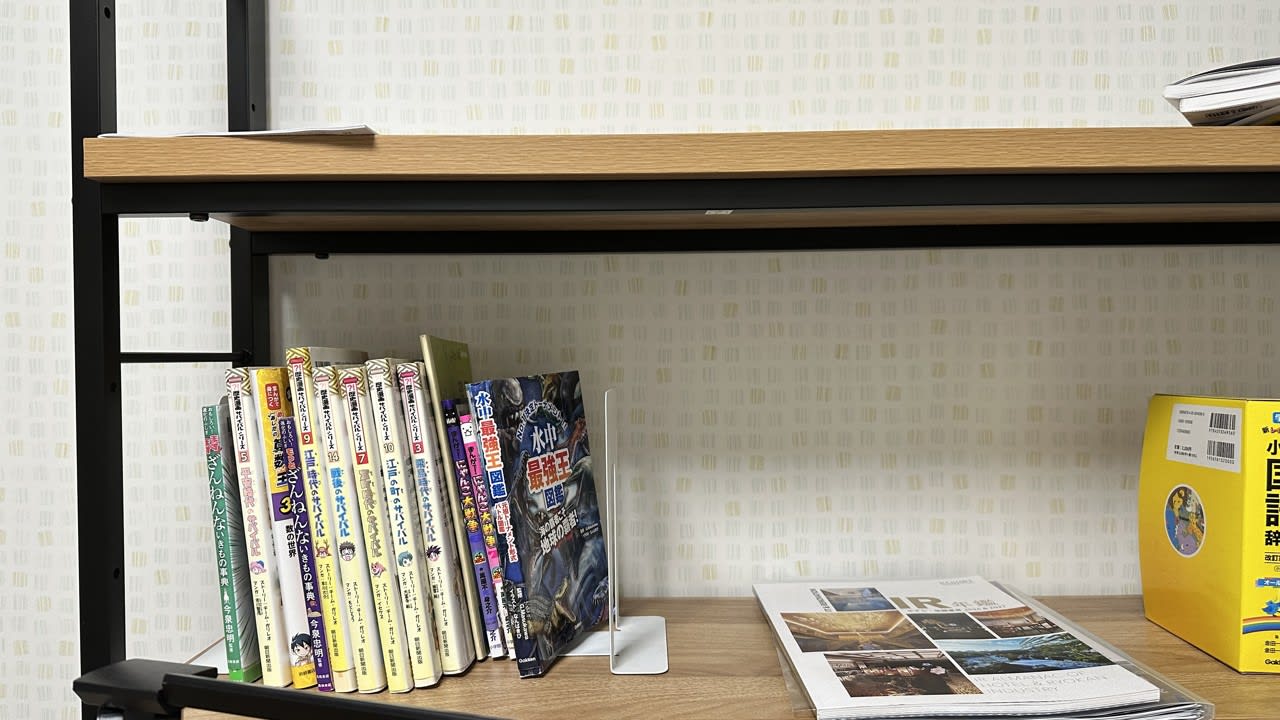
私が自宅で撮った本棚です。上段がほぼ空で、下段の右側も空いていますが、写真をそのまま渡す作りでは3回とも「欠品なし」と答えました。
間違え方は、店舗の棚で中段だけ空いた写真を外したときと同じ向きです。縦2×横3に区切った作りは本棚で最もよい結果でしたが、6回モデルを呼ぶため、かかった時間は中央値13.50〜15.95秒でした。
本棚は売場ではないので、この結果を店舗の棚の精度として読むことはしません。ただし、空いた区画が写真の一部にしかないと見落とす、という弱みは、店舗の棚と本棚の両方に出ています。
ルールだけでは、この判定はできないのか?
できません。棚の写真から空きを見つけるところには、文字も数字もないので、ルールでは書けません。だからこの場面は、画像の理解が輝きます。ルールは、段ごとの答えを1つの結論にまとめることと、商品名を答えさせないことに限られます。
この業務で、Apple Intelligence で輝けるか?
輝けます。店舗の棚の写真で、欠品あり・なしの見立ては合格ラインを越え、欠品のない棚を「欠品あり」にした回はありませんでした。
モデルは、写真を見て「欠品あり」か「欠品なし」かを選ぶことです。どの商品が欠けているか、補充や発注をどうするかは、本部担当者が写真と棚割データを見て判断します。モデルが「欠品なし」と仕分けた写真にも欠品が混じることがあるので、「欠品なし」の写真を本部が見ない運用にはしません。先に見る順番を決めるための見立てです。
まだ言えないのは、私が店舗で撮った写真での精度です。今回の店舗の棚の写真は公開されているもので、棚の大半が空いた写真が多く含まれます。売場で日常的に起きる欠品は、1つの区画だけが空く形が多いと考えられ、そこはこの作りが外しやすい形です。
次に試すこと
なので、次は撮影の許可を取った店舗で、スタッフが実際に撮る角度と距離で棚を撮り、測り直します。1つの区画だけが空いた写真の件数を増やし、その形での正答を分けて数えます。iPhone 15 Proより大きいモデルを使える端末でも試します(AFM3の5モデルと対応端末の範囲で)。
よくある質問
「欠品なし」と仕分けた写真は、本部で見なくてよいですか。
よくありません。店舗の棚の写真では、欠品のある棚を「欠品なし」と答えた回が54回中10回ありました。見立ては、本部が先に見る写真の順番を決めるために使います。
写真を区切って細かく見させれば、精度は上がりますか。
今回は上がりませんでした。段ごとに見させるパターンは店舗の棚で75.9%に下がり、縦2×横3に区切るパターンは本棚で66.7%までで、かかった時間が中央値13.50〜15.95秒に伸びました。写真をそのまま1回渡す作りが、精度と所要の両方で最もよい結果でした。
どの商品が欠けているかまで、AIに答えさせないのはなぜですか。
商品名はモデルの知識になり、実際の棚割と一致する保証がないためです。前回の記事の設計どおり、欠品あり・なしの2択にとどめ、商品の特定は本部担当者と棚割データに任せます。
参考
- Apple Developer Documentation, Foundation Models: https://developer.apple.com/documentation/foundationmodels
- Apple公式(WWDC2026): https://developer.apple.com/videos/play/wwdc2026/241/
- Wikimedia Commons(確かめに使った店舗の棚の写真の出典): https://commons.wikimedia.org/
同じように画像の見立てを試したい方は、ぜひ今回の測り方を参考にしてみてください!
では、おつかめ!
--
クラスメソッドでは、既存スマホアプリをFlutterでiOS/Android同時に作り直し、バックエンドはAWSで再構築する「AI駆動アプリリニューアル」を提供しています。現行アプリの仕様読み解きから設計・実装まで生成AIを組み込んだ開発プロセスで進めるため、レガシー化したアプリのリニューアルを短い期間で作り直します。
サービス詳細・お問い合わせはこちら