[Amazon Bedrock] 設備が止まった。マニュアルと過去トラブル履歴を組み合わせたトラブル対応アシスタントを、50 問で評価しながら作ってみました

1 はじめに
製造ビジネステクノロジー部の平内(SIN)です。
設備が止まったとき、手がかりになる情報には、取扱説明書(マニュアル)や過去のトラブル対応の記録があると思います。マニュアルには正式な手順が、記録には「前回はこう直した」という現場の知見が残っていることがあります。中には、マニュアルどおりに対応しても直らず、過去の記録に本当の原因が書かれていた、ということも現場ではあるのではないでしょうか。
そこで今回は、この 2 種類の情報源を組み合わせて答えるトラブル対応アシスタントを想定し、Amazon Bedrock で作ってみました。情報をどのように扱えば、有効なレスポンスを得ることができるのかを 5 段階で組み替えながら、同じ 50 問で評価してみました。また、最後に、別のモデルで作った未知の 50 問でも確認してみました。
先に結論を述べると、次のようになっています。
| 段階 | やったこと | 正答(50 問中) |
|---|---|---|
| 1 | マニュアルと履歴を 1 つの Knowledge Base に入れて検索 | 32 |
| 2 | マニュアルと履歴を分けて、両方を必ず検索 | 44 |
| 3 | 何をどう検索するかを、エージェントに任せる | 47 |
| 4 | 段階 2 の検索を土台に、足りないときだけエージェントが追加検索 | 45〜47 |
| 5 | 段階 4 に、症状だけの相談への対策を追加 | 47〜49 |
段階 3〜5 は 3 回実行した範囲です。
いちばん効いたのは、2 種類の情報源を分けて両方を必ず引く段階 2 でした。この伸びは、別のモデルで作り直した未知の 50 問でも確認できています。一方、段階 3 以降の差は、未知の 50 問でははっきりしませんでした。
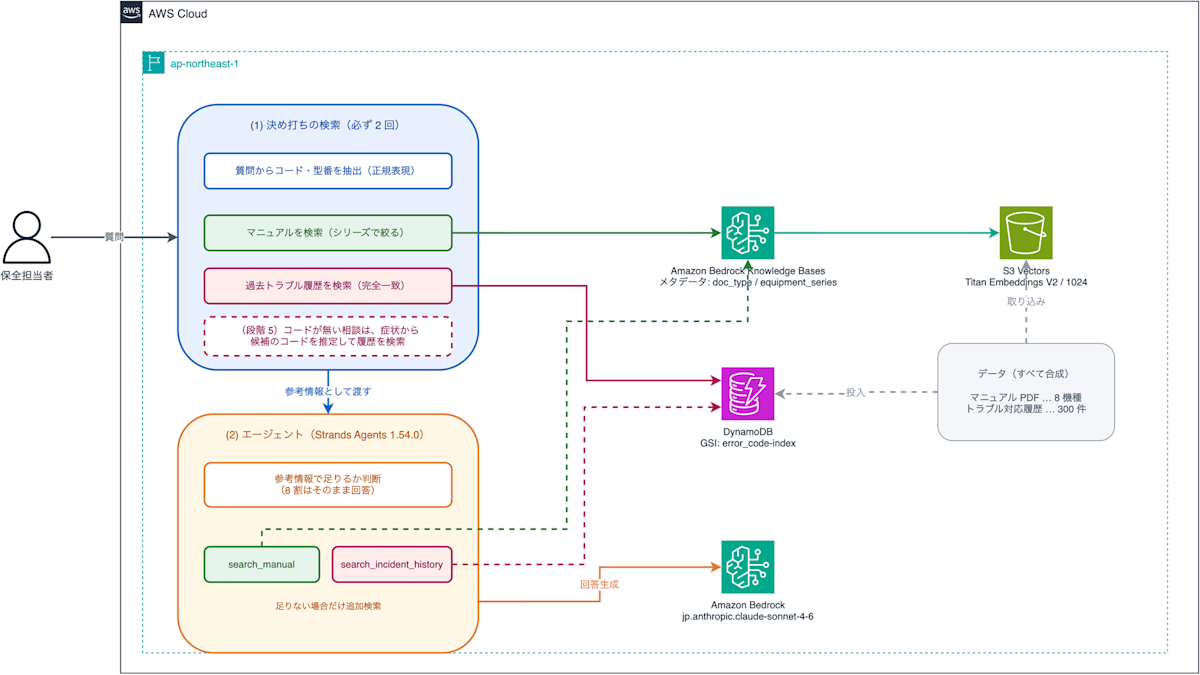
構成は以下のとおりです。点線の部分は、段階 5 で足した処理(コードの無い相談で、症状から候補のコードを推定して履歴を引く)です。
本稿はあくまで、LLMで用意した仮想データを元にした検証であることをご了承ください。
2 取扱説明書(マニュアル)とトラブル対応記録
すべて合成データです。機器型番(NX-SV200 など)は架空で、実在する製品とは関係ありません。
| データ | 規模 | 作り方 |
|---|---|---|
| マニュアル | 8 機種(サーボアンプ 2・圧縮機 2・コンベア・ロボット・油圧プレス・射出成形機) | Claude で作成した Markdown を WeasyPrint で PDF 化 |
| トラブル対応履歴 | 300 件 | 正解になる 40 件と、残り 260 件を、どちらも Claude で作成 |
マニュアル(PDF にする前の Markdown)と履歴 300 件は、GitHub で確認できます。
Github data/manuals/
Github data/incidents/incidents.json
生成した 260 件は、機種・型番・エラーコード・原因をマニュアルのアラーム一覧から抽選し、Claude には文章だけを書かせました。こうすると、マニュアルに無いコードや機種の組み合わせが混ざりません。
また、現場で実際に迷いそうな状況を、意図的に仕込んでみました。
| 仕込み | 内容 |
|---|---|
| 同じコードが機種で別の意味 | E-42 は 6 機種、E-24 は 5 機種で、それぞれ別の異常を指す |
| 近いコード | 射出成形機に E-24(ヒーター断線)・E-240(温調機通信)・E-420(ノズル温度) |
| 互換性のない似た部品 | NX-FAN-60B(旧型アンプ用)と NX-FAN-60C(新型アンプ用) |
| アラームの出ない不具合 | 蛇行センサが無い仕様のコンベアで、ベルトが片寄っても止まらない |
| マニュアルに無い現場対処 | 取説は「ケーブルの導通確認」だけだが、実際はコネクタへのクーラント侵入が原因 |
5 章で使用した未知の評価データは、これとは、また別に作成しています。
3 評価に使った設問
(1) 設問の作り方
先に正解になる履歴 40 件とマニュアルの該当箇所を決め、そこから逆算して質問文を書きました。質問文は、マニュアルの言い回しを避け、「アラームで止まった」のように現場で口頭で相談する言葉にしています。50 問すべてを GitHub に置いています。
Github eval/questions.json
(2) 8 つの種別
| 種別 | 問数 | 例 | 何を確かめるか |
|---|---|---|---|
| コード引き(型番あり) | 6 | NX-SV300-15B、非常停止のあと E-42 が出て復帰できない。どこを見ればいい? | 型番とコードから、その機種での意味と処置に到達できるか |
| コード引き(シリーズ名のみ) | 4 | SV200 で E-17 が何回も出る。前にも同じことあった? | 枝番の無いシリーズ名でも、過去の事例を引けるか |
| 症状のみ | 8 | 冬場、朝一番だけ SV200 の送り軸がアラームで止まる。暖まると出なくなる。 | コードが分からない相談から、原因の候補に届くか |
| 手順系 | 8 | AC2200 のセパレータエレメントの交換周期と品番は? | マニュアルの手順・数値・部品番号を返せるか |
| 横断 | 10 | NX-SV200-10B の E-42 について、過去の対応事例と、該当部品の交換手順を教えてください。 | 履歴とマニュアルの両方を使って答えられるか |
| 型番取り違え | 6 | E-42 って、SV200 と SV300 で同じ意味? | 機種によってコードや部品が違うことを区別できるか |
| 誤った前提 | 4 | IM20-100 で E-42 が出た。対処を教えて。 | 質問の前提の誤り(この機種に E-42 は無い)を指摘できるか |
| 該当なし | 4 | NX-RB6 の E-73 はどういう異常ですか? | 存在しない情報を作らず、「見つからない」と答えられるか |
差がつくと考えた「横断」は多めに、誤った処置の案内につながる「誤った前提」「該当なし」は少数でも必ず入れました。
(3) 設問のデータ構造
1 問は次のような JSON です。
{
  "id": "Q01",
  "category": "コード引き(型番あり)",
  "question": "NX-SV300-15B、非常停止のあと E-42 が出て復帰できない。どこを見ればいい?",
  "expected": "SV300 の E-42 はダイナミックブレーキ回路異常(温度ではない)。DB 抵抗(10±1Ω)を測り、正常なら DB リレー NX-DBR-30 を交換。過去事例も DB リレー接点溶着。",
  "must_include": [
    "DB",
    "NX-DBR-30"
  ],
  "gold_incidents": [
    "INC-2026-0512-001"
  ],
  "gold_manual": [
    {
      "series": "NX-SV300",
      "contains": "E-42 発生時の詳細手順"
    }
  ]
}
expected が採点の基準になる正解の回答です。gold_incidents(正解の根拠になる履歴の ID)と gold_manual(正解の根拠になるマニュアルの箇所)は、検索が根拠を拾えたかの判定に使います。gold_manual は、NX-SV300 のマニュアルのチャンクに「E-42 発生時の詳細手順」が含まれていれば命中、という書き方です。
(4) 採点の方法
回答は expected を基準に 3 値で採点しました。
| 採点 | 基準 |
|---|---|
| ◎ | 正しい原因・処置に到達している(表現の違いは問わない) |
| △ | 一部は正しいが、要点の一部が欠けている、または根拠が不足している |
| × | 誤答、要点に届いていない、存在しない情報を作っている、前提の誤りを見逃している |
expected の括弧書き(Q01 なら「(温度ではない)」など)は補足として扱い、欠けていても減点しません。このルールは結果を見る前に決めています。一次採点は回答とは別のモデル(Claude Opus 4.8)で行い、◎ 以外を中心に私が見直しました。
あわせて、正解の根拠(gold_incidents と gold_manual)のうち、検索結果に入っていた割合も計算しています。回答の出来とは別に、検索がうまくいったかを見るための指標です。
4 5 段階で作り込む
5 つの段階の違いは、次のとおりです。
| 段階 1 | 段階 2 | 段階 3 | 段階 4 | 段階 5 | |
|---|---|---|---|---|---|
| エージェント | 使わない | 使わない | Strands Agents | 同じ | 同じ |
| 検索対象 | マニュアルと履歴を 1 つの Knowledge Base に混ぜて入れる | マニュアルは Knowledge Base、履歴は DynamoDB に分ける | 段階 2 と同じ | 同じ | 同じ |
| 最初の検索(プログラムが実行) | 質問文で 1 回検索(上位 5 件) | マニュアル・履歴を 1 回ずつ必ず検索 | 無い | 段階 2 と同じ | 段階 2 と同じ。ただしコードの無い相談では、履歴の引き方を変える |
| マニュアルの引き方 | (混ぜて検索) | 意味検索。質問から抜き出した機種シリーズで絞り、上位 5 件 | エージェントが検索文と機種を決めて意味検索 | 最初は段階 2 と同じ | 最初は段階 2 と同じ |
| 履歴の引き方 | (混ぜて検索) | エラーコード・型番の完全一致。コードが無ければシリーズの履歴を新しい順に 15 件 | エージェントがコード・型番を決めて完全一致 | 最初は段階 2 と同じ | コードが無い場合は、症状の文章で意味検索(5 件)し、さらに LLM が推定した候補コード(最大 3 つ)で完全一致(各 15 件) |
| 追加の検索 | 無い | 無い | エージェントが何回でも判断 | 足りないときだけエージェントが判断 | 同じ |
| 判断の基準 | — | — | ツールの docstring | docstring+「足りないときだけ」の基準 | 同じ |
評価に使った 50 問での、各段階の結果です。段階 3〜5 は 3 回実行した各回の値です。
| 段階 1 | 段階 2 | 段階 3 | 段階 4 | 段階 5 | |
|---|---|---|---|---|---|
| 正答(50 問中) | 32 | 44 | 47 / 47 / 47 | 47 / 47 / 45 | 49 / 48 / 47 |
| 横断(10 問) | 3 | 10 | 10 / 10 / 10 | 10 / 10 / 9 | 10 / 10 / 10 |
| 型番取り違え(6 問) | 4 | 4 | 4 / 6 / 5 | 6 / 6 / 6 | 6 / 5 / 5 |
| 症状のみ(8 問) | 4 | 6 | 7 / 6 / 7 | 6 / 6 / 6 | 8 / 8 / 8 |
| 正解の根拠を拾えた割合 | 0.38 | 0.64 | 0.71〜0.72 | 0.66 | 0.71〜0.72 |
| ツール呼び出し(1 問平均) | — | — | 1.94 回 | 0.29 回 | 約 0.22 回 |
(1) 段階 1:1 つの Knowledge Base に全部入れる
マニュアル PDF と履歴を 1 つの Knowledge Base に入れ(チャンク戦略・パーサーはデフォルト)、質問で 1 回検索しました。
エラーコードで引く質問は 10 問すべて正答でした。一方、「過去の事例と、交換手順を両方教えて」という横断質問は 10 問中 3 問でした。落とした 7 問のうち 6 問は、検索結果の上位 5 件にマニュアルが 1 件も入っていませんでした。検索件数を 15 件に増やしても、横断は 4 問にとどまりました。
(2) 段階 2:情報源を分けて、両方を必ず検索する
マニュアル(Knowledge Base を機種シリーズで絞る)と履歴(DynamoDB の完全一致)を、プログラムで 1 回ずつ必ず検索しました。
Github scripts/run_eval_v2.py
# 要点抜粋
def retrieve(config, question):
    code, model, series = extract(question)   # 質問からコード・型番を正規表現で抜き出す
    # マニュアル: Knowledge Bases を doc_type=manual と機種シリーズで絞って検索
    manual = kb_retrieve(question, 5, "manual", series)
    if config == "c3":
        # 履歴: DynamoDB でエラーコード・型番の完全一致
        return manual + ddb_incidents(code, model, series), 2
    if config == "c4":
        # 履歴: Knowledge Bases を doc_type=incident と機種シリーズで絞って検索
        return manual + kb_retrieve(question, 5, "incident", series), 2
横断質問が 10 問すべて正答になりました。履歴をベクトル検索(シリーズで絞る)に替えても同じ 44 問で、完全一致かベクトル検索かで差は出ませんでした。どちらも機種シリーズで絞っているので、効いているのは絞り込みのほうだと考えています。
この方式では、 2 つの弱点を見つけました。1 つは、質問から機種を正規表現で抜き出すため、「E-42 って、SV200 と SV300 で同じ意味?」では最初の SV200 しか拾えなかったことです。もう 1 つは、コードの無い「冬場、朝一番だけ SV200 の送り軸がアラームで止まる」では、履歴を新しい順に並べるしかなく、正解の事例に届かなかったことです。
(3) 段階 3:検索をツールにして、エージェントに任せる
2 つの検索を Strands Agents のツールにして、何をどう検索するかを LLM に判断させました。
Github agent/maintenance_agent.py
# 要点抜粋
@tool
def search_manual(query: str, equipment_series: str | None = None) -> str:
    """設備マニュアルから、作業手順・仕様値・部品番号・交換周期・アラームの意味を意味検索する。
    「過去に実際どう直したか」は別ツール search_incident_history が担当する。
    """

@tool
def search_incident_history(error_code: str | None = None,
                            equipment_model: str | None = None) -> str:
    """過去のトラブル対応履歴を、エラーコードや設備型番の完全一致で検索する。
    「E-42 が出た」のようにエラーコードが明示された質問では、必ず最初にこれを呼ぶ。
    equipment_model: NX-SV300-15B のような型番、または NX-SV300 のようなシリーズ名。
        シリーズ名だけ分かっている場合はそのまま渡してよい(前方一致で検索する)。
    """
エージェントは docstring を読んでツールを選ぶので、docstring がそのまま検索の設計になります。「どの粒度の値を渡すか」まで書いておくのがポイントになりました(6 章で補足します)。
3 回とも 47 問で、「SV200 と SV300 の比較」は両方の機種を検索しに行って正答しました。一方、回によって結果が揺れる設問が 4 問ありました。「CV100-07N でベルトが蛇行してるのに E-42 が出ない」(07N は蛇行センサの無い仕様で、正常)は × / ◎ / × でした。入力トークンは段階 2 の約 1.8 倍になりました。
(4) 段階 4:決め打ちの土台に、エージェントの追加検索を足す
段階 2 の検索を必ず実行し、その結果をエージェントに渡して、足りないときだけツールで追加検索させました。判断の基準は、システムプロンプトに書いています。
# 要点抜粋
HYBRID_ADDENDUM = """
## 最初に渡される参考情報
- まず参考情報で答えられるかを確認する。答えられる場合はツールを呼ばずに回答してよい。
- 次の場合だけ、ツールで追加検索する。
  - 質問に複数の機種・シリーズが出てくるのに、参考情報が一部の機種しか含んでいない
  - 質問の前提(コード・部品・機種)が参考情報と食い違っていて、確認が必要
  - 参考情報に質問の答えが見当たらない
"""
型番取り違えは 3 回とも 6 問すべて正答になり、回によって揺れた設問は 4 問から 2 問に減りました。150 回答のうち 122 回はツールを呼ばずに答え、参考情報が片方の機種しか含まない場合などだけ、追加で検索していました。
症状だけの相談は弱いままでした。エージェントは「足りない」と判断して追加検索していましたが、コードが無いと、履歴のツールはシリーズの新しい順に 15 件を返すことしかできず、正解に届きませんでした。
(5) 段階 5:症状だけの相談に対策する
コードの無い相談に限り、履歴の検索を 2 つ足しました。症状の文章での意味検索(5 件)と、マニュアルのアラーム一覧を LLM に渡して候補のコードを最大 3 つ挙げさせ、そのコードごとに完全一致で引く検索(各 15 件)です。「冬場、朝一番だけ…」では、候補として E-55・E-47・E-17 が返り、正解の E-55 が含まれていました。
# 要点抜粋
if config == "c7":
    if code:
        return manual + ddb_incidents(code, model, series), 2
    # 症状だけの相談: 履歴を症状の文章で意味検索し、
    # さらにコード表から推定した候補コードごとに完全一致でも引く
    items = manual + kb_retrieve(question, 5, "incident", series)
    for c in candidate_codes(question, series):   # アラーム一覧から候補コードを推定
        items += ddb_incidents(c, model, series)
この形に落ち着くまでに、2 回やり直しています。
| 試した方式 | 結果 |
|---|---|
| 候補コードの完全一致を 5 件までにする | 冬場の問いで、正解の履歴を拾えなかった。同じ型番・コードの履歴が 6 件あり、正解は一番古い記録だったため、5 件の枠から外れた |
| 候補コードで絞ってから、症状の文章で意味検索する | かえって悪化した。候補の 3 コードのうち、他のコードの記録が上位に来た。類似度も 0.45〜0.52 程度に固まり、「冬場、朝一番」と「早朝の初回起動」の近さを区別できていなかった |
| 候補コードごとに、完全一致で 15 件まで引く(採用) | 症状だけの 8 問すべてで、正解の履歴を拾えた |
症状だけの 8 問は、3 回ともすべて正答になりました。ただし、この対策は評価に使った 50 問を見ながら決めたものです。本来の効果は、5 章の未知の 50 問で確かめます。
5 別のモデルで作った未知の 50 問で確かめる
段階 1〜5 の作り込みは、すべて同じ 50 問を見ながら進めました。作り込みがこの 50 問に合わせただけになっていないかを確かめるため、作り手のモデルを Qwen3 235B に変えて、評価データを丸ごと作り直しました。
設備(溶接機・数値制御工作機械・検査装置・乾燥炉の計 8 シリーズ)、マニュアル、履歴 300 件、設問 50 問のすべてを Qwen3 235B に作らせ、種別の内訳は評価に使った 50 問と揃えています。Knowledge Base と DynamoDB のテーブルは別に作り、検索と回答の処理は変えていません。
Github eval/questions_holdout.json
| 段階 | 評価に使った 50 問 | 未知の 50 問 |
|---|---|---|
| 1 | 32 | 37 |
| 2 | 44 | 47 |
| 3 | 47 / 47 / 47 | 49 / 48 / 48 |
| 4 | 47 / 47 / 45 | 50 / 49 / 50 |
| 5 | 49 / 48 / 47 | 49 / 48 / 50 |
分かったことは 3 つです。
1. 段階 1 から 2 の伸びは、未知の 50 問でも出た。 「2 つの情報源を分けて、両方を必ず引く」効果は、作り込みに使った 50 問に限った話ではなさそうです。
2. 段階 3 以降の差は、はっきりしなかった。 どれも 48〜50 問で、ほぼ上限に達しています。このデータでは優劣は言えませんでした。
3. 段階 5 の対策は、効果を確かめられなかった。 Qwen が作った症状だけの質問は、すべて枝番付きの型番(例: NX-WL100-03C)を含んでいました。1 型番あたりの履歴は平均 12.5 件(8〜18 件)で、型番で絞って新しい順に 15 件を渡すと 8 問すべてで正解の履歴が入り、段階 2 でも 8 問すべて正答していました。シリーズ名だけで相談する「冬場、朝一番だけ SV200 の…」のような状況が、そもそも含まれていなかったことになります。
なお、未知の 50 問は評価に使った 50 問より易しくなっていました。質問にマニュアルの言葉が入りやすく、「該当なし」のコードも E-999 のような明らかな架空の番号でした。モデルを変えて、設問の難しさを揃えるのは難しいと感じました。
6 検証中に気づいたこと
(1) 小さな評価セットでは、エージェントの効果を大きく見積もっていた
実は最初、履歴 24 件・マニュアル 4 機種・15 問で同じ比較をしていました。そのときは「エージェントでしか解けない横断質問がある」という結果に見えていました。
規模を広げ、「両方を必ず引く」決め打ちの構成を比較対象に加えたところ、その横断質問はエージェントなしで解けました。比較対象を置かずに評価すると、改善の理由を取り違えることがありそうです。
(2) 完全一致検索は、引数の粒度がずれると 0 件を返す
最初の小さな評価セットで、「NX-SV200 で E-17 が繰り返し出る」という問いの点数が急に落ちました。履歴検索を呼んでいるのに「該当する履歴は見つかりませんでした」と返しています。
原因は引数の粒度でした。質問にはシリーズ名「NX-SV200」しか無く、エージェントはそれを型番の引数に渡していました。DynamoDB のキーは EQUIP#NX-SV200-08A のような枝番付きなので、完全一致では 1 件も当たりません。
{'error_code': 'E-17'}                                    → 2 件
{'error_code': 'E-17', 'equipment_model': 'NX-SV200'}     → 0 件
{'error_code': 'E-17', 'equipment_model': 'NX-SV200-08A'} → 2 件
枝番の有無を見て前方一致に切り替え、docstring にも「シリーズ名だけならそのまま渡してよい」と書いて解消しました。ベクトル検索なら近いものを拾えますが、完全一致はずれを吸収しません。ツールの実装側で粒度のずれを受け止めておくのが安全だと感じました。
(3) エージェントの呼び出しが 120 秒でタイムアウトする
段階 3 の計測を最初に流したとき、3 回とも途中で次のエラーで止まりました。
urllib3.exceptions.ReadTimeoutError: AWSHTTPSConnectionPool(host='bedrock-runtime.ap-northeast-1.amazonaws.com', port=443): Read timed out.
止まる設問は毎回違っていました。Strands Agents の Bedrock クライアントは、読み取りタイムアウトの既定が 120 秒です。応答のストリーミングが一時的に止まると、ここで例外になります。
model = BedrockModel(
    model_id=MODEL_ARN, region_name=REGION, temperature=0,
    boto_client_config=Config(read_timeout=300, retries={"max_attempts": 3, "mode": "adaptive"}),
)
読み取りタイムアウトを 300 秒に延ばし、評価側でも設問単位の再試行と途中保存を入れたところ、以降は 1 度も止まらずに完走しました。長い計測を回す場合は、最初から設定しておくと良いかも知れません。
(4) 採点モデルの判定は、そのまま使えなかった
段階 1〜4 の一次採点を見直したところ、500 件中 16 件に訂正が必要でした。うち 7 件は採点モデルの事実誤認で、たとえば次のようなものです。
- 回答が「過去に 14 件の事例がある」と書いたのを「件数の捏造」と判定。実際には該当する履歴が 17 件あり、回答は検索で渡された範囲を正しく数えていた
- 回答がマニュアルどおりの手順を書いたのを「手順の順序が違う」と判定
見直しでは、「結果を見てから採点基準を変えない」を原則にしています。正解の回答の括弧書きは補足として扱い、欠けていても減点しない、というルールを先に決めて、全構成に同じように適用しました。
7 最後に
5 段階の結果をまとめます。
| 段階 | 評価に使った 50 問 | 未知の 50 問 | 入力トークン(1 問平均) | 応答時間(1 問平均) |
|---|---|---|---|---|
| 1 | 32 | 37 | 1,458 | 6.9 秒 |
| 2 | 44 | 47 | 3,732 | 8.3 秒 |
| 3 | 47 | 48〜49 | 約 6,700 | 約 13 秒 |
| 4 | 45〜47 | 49〜50 | 約 6,800 | 11〜19 秒 |
| 5 | 47〜49 | 48〜50 | 約 5,900 | 約 12 秒 |
正答の数です。段階 3〜5 は 3 回実行した範囲です。トークンと応答時間は、評価に使った 50 問での値です。
今回のデータで分かったことは、次の 4 点です。
- マニュアルと履歴を分けて、両方を必ず引くだけで大きく伸びた。この伸びは未知の 50 問でも出た
- エージェントに「追加で何を調べるか」だけを任せた段階 4 では、機種の取り違えを含む問いで 3 回とも満点だった(段階 5 では 6 / 5 / 5)。ただし未知の 50 問では、段階 3〜5 の差は見えなかった
- 症状だけの相談は、候補のコードを推定してから完全一致で引くと拾えた。効果は未知の 50 問ではまだ確かめられていない
- 作り込みに使った評価セットだけで判断すると、良く見えやすい。決め打ちの構成や未知のデータのような比較対象を置くと、読み違えにくい
社内マニュアルと問い合わせ履歴のように、性質の違う 2 種類のデータを扱う場面でのたたき台になれば嬉しいです。
コードとデータは以下に置いています。
bedrock-maintenance-knowledge-rag-agent