Claude Security プラグインで実案件のリポジトリをまるごとスキャンした結果を実数値から確認してみた

リテールアプリ共創部のるおんです。
最近、情報漏洩のニュースが相次いでいることもあり、社内で「まだ脆弱性診断を受けていない案件に、 Claude Security を回してみよう」という話になりました。そこで、私が担当している あるwebアプリ案件のリポジトリ全体 を、Claude Code の Claude Security プラグインでスキャンしてみました。
この記事では、 インストールから実行までの手順 と、 実案件の規模のリポジトリで回すと、どれくらいの時間・トークン・コストがかかるのか 、そして Claude Security が中で何をしているのか を、実際の記録をもとに整理します。
「Claude Security を自分の案件でも回してみたいけど、どれくらい重いのか見当がつかない」という方の判断材料になればと思います。
先に結論
- 約7.4万行(TypeScript / JavaScript、744ファイル)のリポジトリ全体を effort
mediumでスキャンして、 79分 ・ エージェント199体 ・ API 料金換算で約87ドル でした - 使われたモデルは、リポジトリの地図づくり(Inventory)の1体だけ Sonnet 5 、残りはすべて Opus 5.5 (セッションのモデル)
- 入力トークンは約1.37億と大きく見えますが、 そのうち約93%がキャッシュ読み込み でした。コストの半分以上は「キャッシュ書き込み」です
- 時間とトークンの大半は、 脆弱性の探索(Research) と 検証の投票(Panel) の2工程で使われていました
- 結果は 13件(Critical 0 / High 0 / Medium 8 / Low 5) 。候補は60件出ていて、 独立した検証者の投票で13件まで絞られて います
- 実案件で回すなら、 作業コピーを分けること と 結果ファイルの扱い(機微な情報を含む) に注意が必要です
| 項目 | 値 |
|---|---|
| 対象 | 744ファイル(TS/JS で約7.4万行)。サーバー・Web・管理画面・CDK・GitHub Actions |
| effort | medium |
| 所要時間 | 79分 |
| エージェント数 | 199体 + セッション本体 |
| モデル | Opus 5.5(Inventory のみ Sonnet 5) |
| 入力トークン | 約1億3,706万(うちキャッシュ読み込み約1億2,701万) |
| 出力トークン | 約58万 |
| API 料金換算 | 約87ドル |
| 結果 | 13件(Critical 0 / High 0 / Medium 8 / Low 5) |
Claude Security プラグインとは
Claude Security プラグインは、Claude Code のセッションの中で、複数のエージェントに セキュリティ研究者のチーム として脆弱性を探させるプラグインです。
ドキュメントでは、次のように説明されています。
A team of Claude agents maps your architecture, builds a threat model, hunts for vulnerabilities, and independently reviews every finding before writing the report.
1回のスキャンが「アーキテクチャの把握 → 脅威モデル → 探索 → 独立した検証」の順に進むことは書かれていますが、 実際にどれくらいのエージェントが、どれくらいの時間で動くのか までは書かれていません。今回はそこを実測しました。
やってみた
前提条件
ドキュメントに書かれている前提条件は次のとおりです。
- 有料プラン(Pro / Max / Team / Enterprise)、API、またはサードパーティのプロバイダー経由の Claude Code
python3(3.9 以上)がPATHにあること- 変更範囲のスキャンやパッチ作成には Git が必要
A paid plan, Anthropic API access, or a third-party provider, for the dynamic workflows the scan uses to orchestrate its agents.
スキャンは Dynamic workflows という仕組みで複数のエージェントを動かします。Team / Enterprise プランでは、 組織の Claude Code の管理設定で Dynamic workflows が無効になっていると、スキャンが始まりません 。その場合は、組織の管理者に有効にしてもらう必要があります。
インストール:CLI からコマンド1つ
Claude Code を起動して、次のコマンドを実行します。
/plugin install claude-security@claude-plugins-official
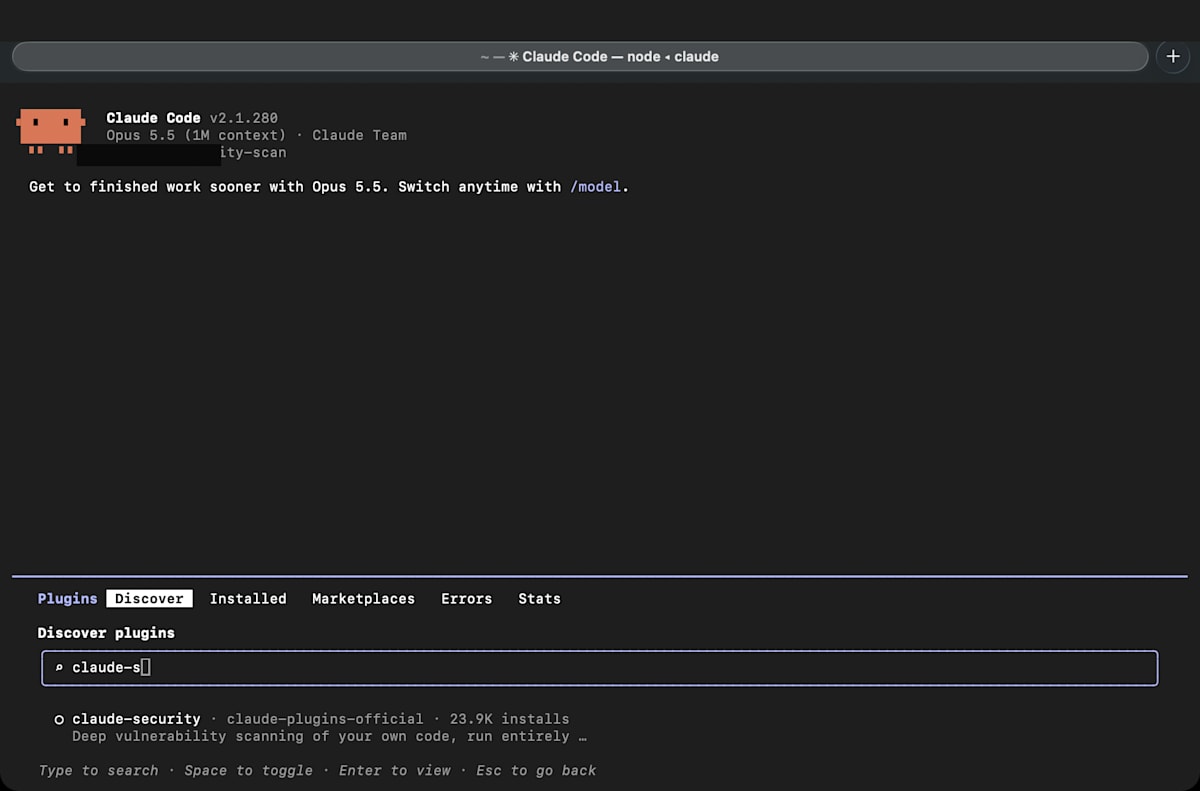
インストールの範囲(自分だけ / このリポジトリの全員 / このリポジトリで自分だけ)を選ぶとインストールされます。最後に Run /reload-plugins to apply. と出たら、 /reload-plugins を実行すれば今のセッションで使えるようになります。
シェルから直接入れることもできます。
claude plugin install claude-security@claude-plugins-official
準備:お客様のコードを汚さない
普段の作業ブランチに結果フォルダが混ざらないよう、 main の最新を別フォルダに出してからスキャンしました。
git worktree add --detach ~/security-scan origin/main
cd ~/security-scan
claude
実行:/claude-security → Scan codebase
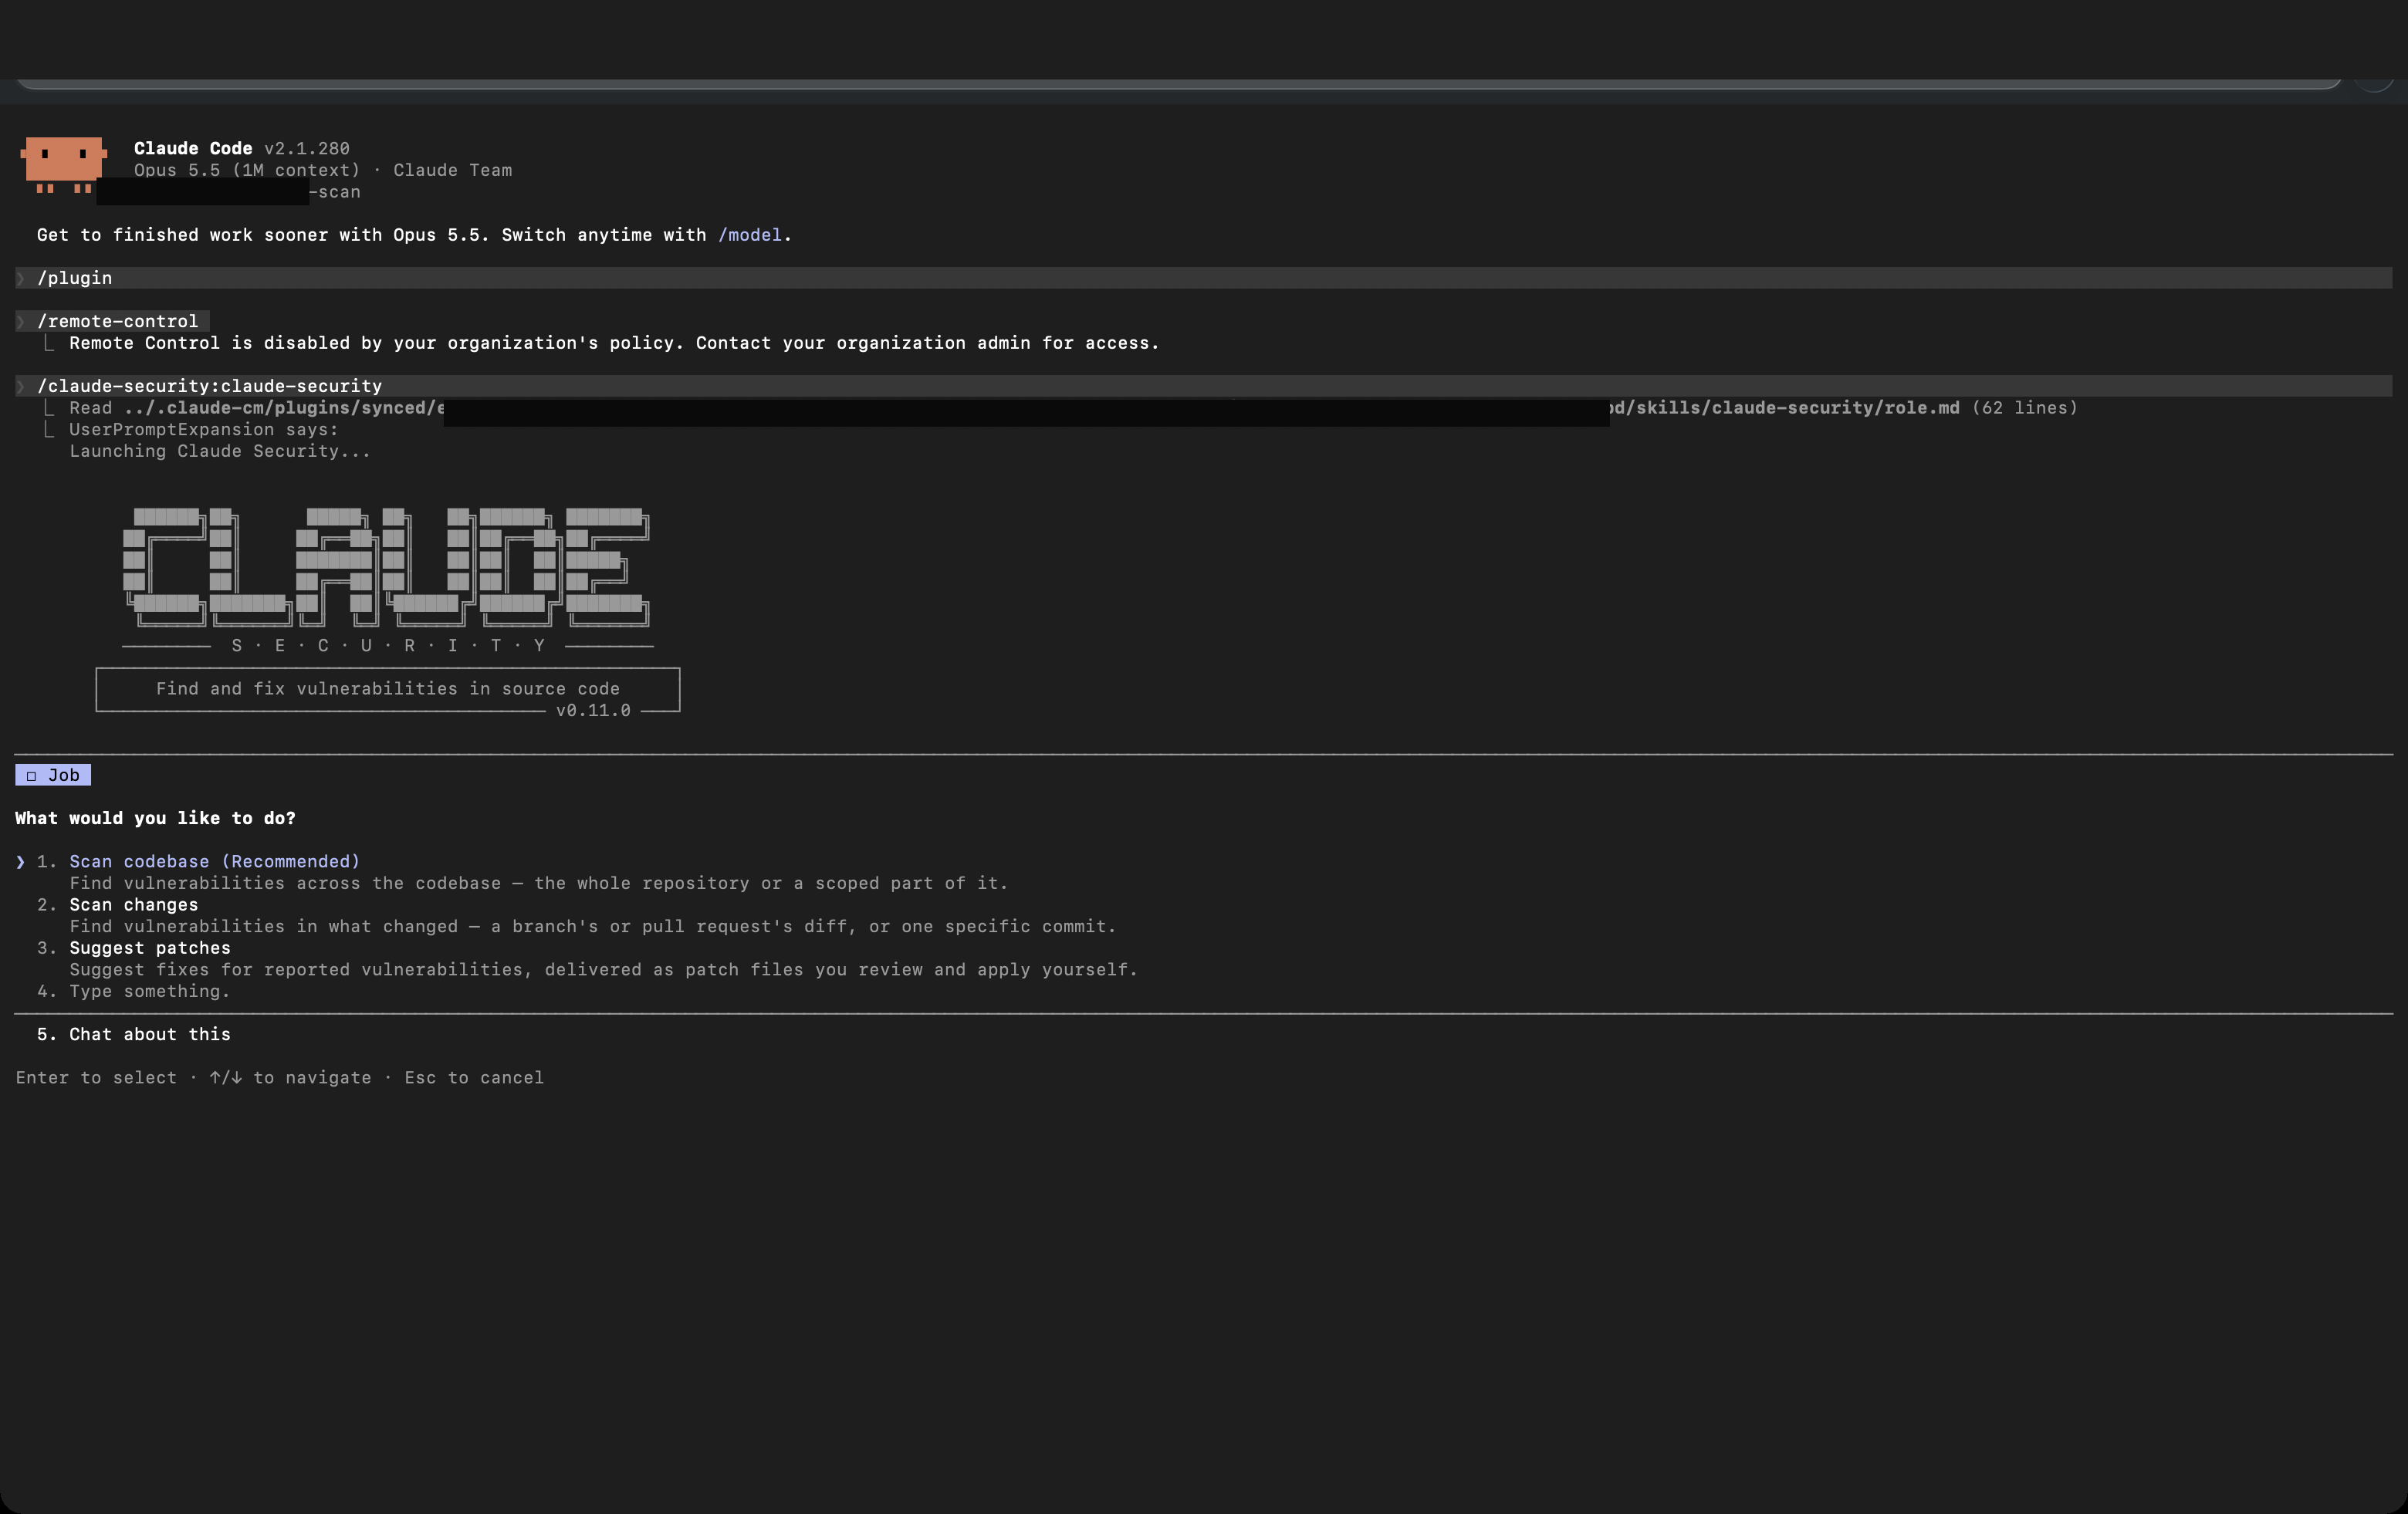
/claude-security を実行すると、まずやりたいことを聞かれます。
「Scan codebase」を選ぶと、プラグインがリポジトリを一通り数えたうえで、範囲を提案してくれます。
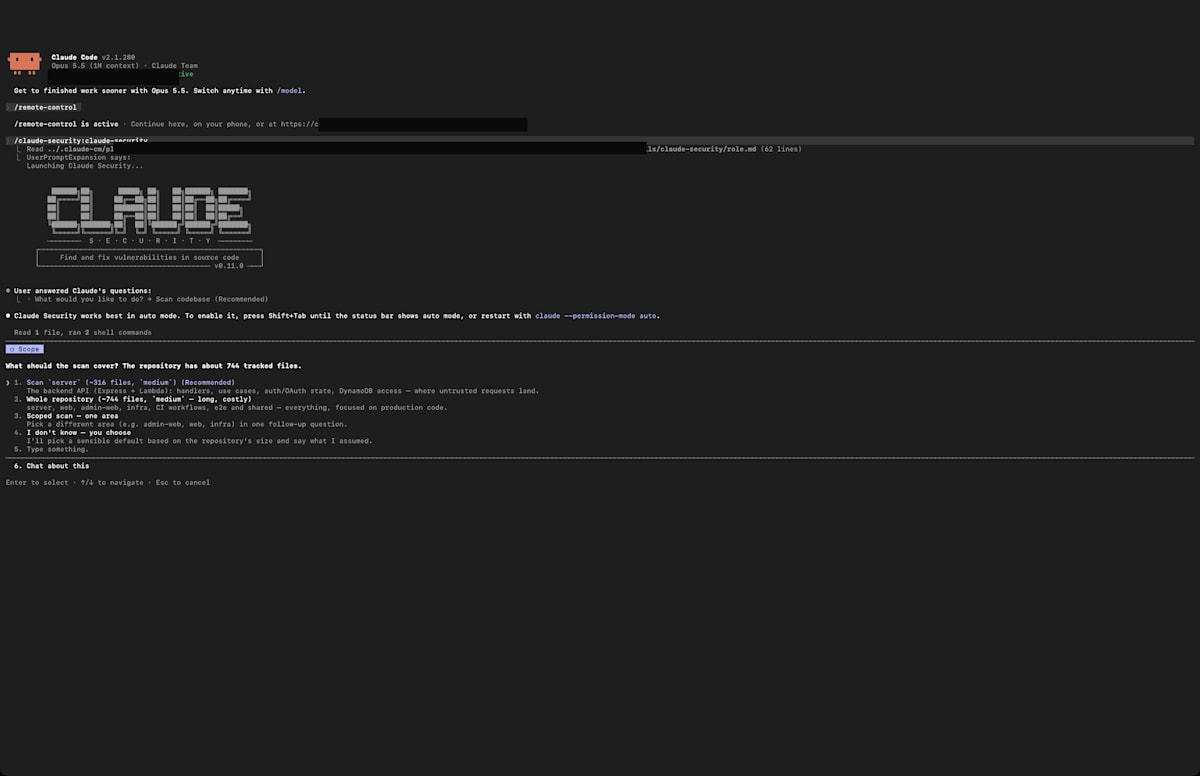
| 選択肢 | 内容 |
|---|---|
Scan server(約316ファイル)(Recommended) |
信頼できない入力を受けるバックエンド API |
| Whole repository(約744ファイル、long, costly) | サーバー・Web・管理画面・インフラ・CI など全部 |
| Scoped scan — one area | 別の一部分を選ぶ |
| I don't know — you choose | リポジトリの規模からおまかせ |
おすすめは「サーバーだけ」でしたが、今回は CDK や GitHub Actions まで見たかったので Whole repository を選びました。「long, costly」と正直に書いてあるのがいいですね。
最後に「時間がかかり、トークンも多く使う。終わるまで Claude Code を開いたままにする必要がある」という確認が出て、 Yes を押すまでは何も始まりません 。
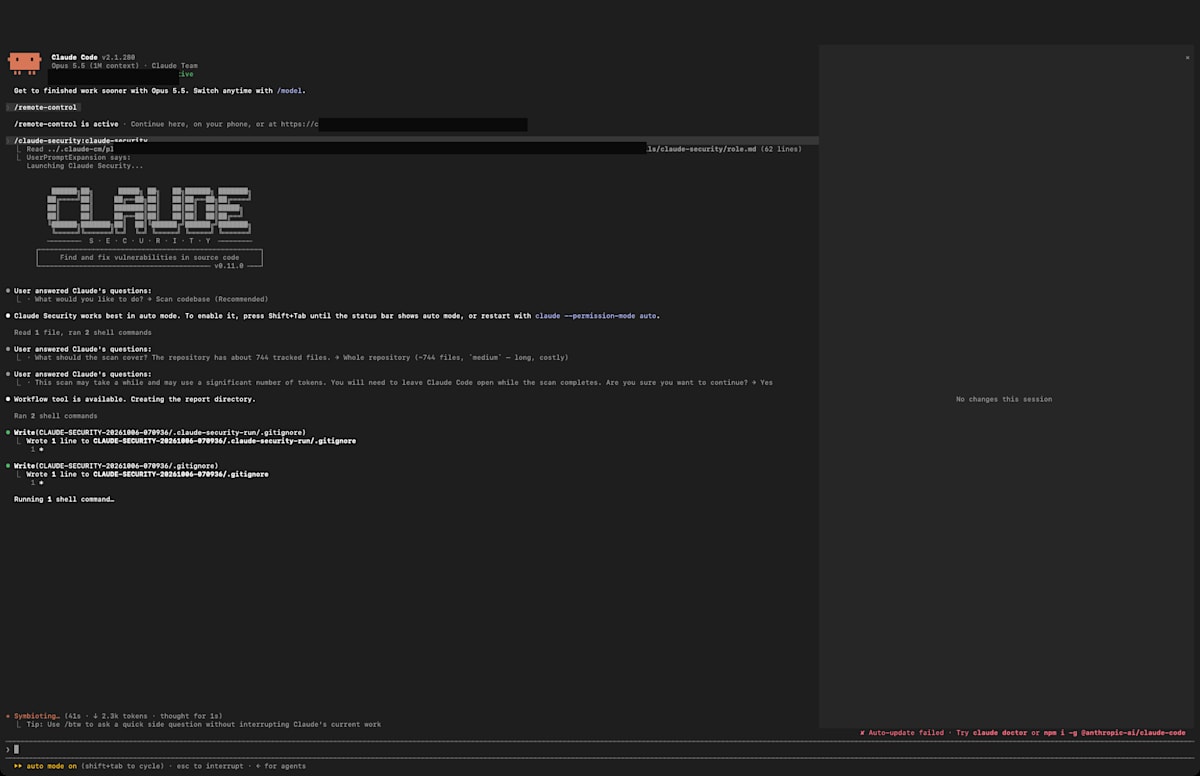
実行中の様子
スキャンが始まると、セッション本体は Dynamic workflows の進み具合を30秒おきに確認しながら待つ 状態になります。ターミナルの下部には、全体の進捗が出続けます。
144/199 agents done · 57m 20s · ↓ 8.9m tokens · ⚠ Large workflow · /workflows to stop

途中で ⚠ Large workflow という表示が出ますが、これは「エージェントが25体を超えた」などの目安を超えたときの 注意表示 で、止まるわけではありません。
When a workflow schedules more than 25 agents, or its projected token total passes 1.5 million, its progress line in the task panel below the input box shows a
Large workflowwarning.
結果ファイル
完了すると、リポジトリの中に日時付きのフォルダができ、4つのファイルが書き出されます。
CLAUDE-SECURITY-20261006-070936/
├── .gitignore                                ← 中身は「*」。うっかりコミットされない
├── CLAUDE-SECURITY-RESULTS.md                ← 人が読むレポート
├── CLAUDE-SECURITY-RESULTS.jsonl             ← 同じ内容の機械向け(1行1件)
├── CLAUDE-SECURITY-RESULTS.sarif             ← GitHub のコードスキャン等に取り込める SARIF
└── CLAUDE-SECURITY-REVISION-95dfc2562ed1.json ← どのコミットを、どの設定で、どこまで見たかの記録
レポートは、セッションの言語に合わせて日本語で書かれていました。
Claude Security は中で何をしていたか
Workflow が起動したエージェントの記録(transcript)には、どの工程(フェーズ)のエージェントだったかが残っています。これを集計すると、スキャンの流れがよく見えます。
| 工程 | 何をしているか | エージェント | 時間 | モデル |
|---|---|---|---|---|
| Inventory | 744ファイルを約25ファイルずつの担当範囲に分ける(今回は22範囲) | 1 | 約2分 | Sonnet 5 |
| Threat model | 担当範囲ごとに脅威モデルを作る | 21 | 約6分 | Opus 5.5 |
| Research | 担当範囲 × 観点ごとに脆弱性を探す | 64 | 約34分 | Opus 5.5 |
| Sweep | 全体を横断して見直す | 2 | 約3分 | Opus 5.5 |
| Panel | 候補ごとに3つの観点の検証者が独立に投票する | 111 | 約32分 | Opus 5.5 |
検証の仕組み:60件の候補から13件へ
個人的に一番おもしろかったのが、この検証の工程です。レポートの最後に、流れがそのまま書かれていました。
- Research と Sweep で挙がった候補は 60件
- 重複を除いて 37件
- 37件それぞれを、 到達できるか(REACHABILITY)・影響(IMPACT)・防御(DEFENSES) の3つの観点を持つ検証者が独立に投票(合計 111票 )
- 3票中2票以上 の確認が得られたものだけを報告し、残りの24件は誤検知として落とす
結果として報告されたのは13件で、そのうち全会一致(3/3)が9件、2/3 が4件でした。2/3 のものは confidence が medium までに抑えられ、調査担当が HIGH と見積もった2件は、検証者の評価に合わせて MEDIUM に下げられていました。
「見つけたものを全部出す」のではなく、 別のエージェントに反証させて、生き残ったものだけを出す 作りです。レポートを読む側の負担がかなり違うと感じました。
「見ていない」範囲も正直に書かれる
レポートには、どこを見て、どこを見ていないかも書かれていました。
- テスト・スナップショット・Storybook・E2E・ロックファイルなどは、理由付きで 意図して対象外
- 担当範囲内の追跡ファイル635件のうち、最後まで読まれたのは425件。残りは「参考扱いで未読」と申告されたものと、誰も触れなかったもの(今回は18件、ほぼテストファイル)
- トップレベルのディレクトリは、すべて「検査した」か「意図して外した」のどちらかに入っている
なので、指摘が無い場所は「見ていない」ではなく 「見たうえで指摘なし」 と読める、と明記されています。また、 どの指摘もコードを読んで判断したもので、攻撃を実際に試したものではない ことも書かれています。
結果(件数と重さのみ)
| 重さ | 件数 |
|---|---|
| Critical | 0 |
| High | 0 |
| Medium | 8 |
| Low | 5 |
| 合計 | 13 |
レポート上では、13件が5つの根本原因にまとめられていました。各指摘には、影響・場所・攻撃の筋書き・前提条件・修正案・検証の票数がセットで書かれていて、そのままチームの修正タスクに落とせる粒度です。
社内で気になっていた 「CDK のようなインフラのコードも見られるのか」 については、CDK と GitHub Actions も担当範囲に入っていて、実際にその領域からも指摘が出ていました。
コストの内訳
トークン
| 工程 | 入力トークン | 出力トークン |
|---|---|---|
| Inventory(Sonnet 5) | 約29万 | 約1万 |
| Threat model | 約820万 | 約9万 |
| Research | 約7,881万 | 約28万 |
| Sweep | 約225万 | 約2,000 |
| Panel | 約3,253万 | 約15万 |
| セッション本体(待機・取りまとめ) | 約1,499万 | 約5万 |
| 合計 | 約1億3,706万 | 約58万 |
入力の約93%はキャッシュ読み込みでした。同じ前提(プラグインの指示や担当範囲の情報)を、たくさんのエージェントが使い回しているためです。
もう1つおもしろかったのが、 セッション本体が待っているだけで約1,500万トークン を使っていたことです。30秒おきに「結果が届いたか」を確認するたびに、それまでの会話をキャッシュから読み直しているためで、ほぼすべてがキャッシュ読み込みでした。
API 料金に換算すると
Team プランは定額なので実際の追加請求はありませんが、 同じことを API で行ったらいくらか を、公式の料金で換算しました。
| 内訳 | 金額 |
|---|---|
| キャッシュ書き込み(5分) | 約49.6ドル |
| キャッシュ読み込み | 約25.4ドル |
| 出力 | 約11.6ドル |
| キャッシュ書き込み(1時間)・新規入力 | 約0.9ドル |
| 合計 | 約87ドル |
ざっくり 1,000行あたり約1.2ドル 、 1ファイルあたり約12セント という感覚です。キャッシュ書き込みが一番大きいのは、エージェントごとに新しい文脈を作るたびに書き込みが発生するためだと考えています。
実案件で回すときの注意点
- お客様との合意を先に 。スキャン結果には、攻撃の筋書きや、場合によってはインフラの識別子まで含まれます。「結果をどう伝えるか」「見つかったものの直し方・費用の扱い」を、回す前に決めておくのがおすすめです
- 作業コピーを分ける 。
git worktreeでmainの最新を別フォルダに出せば、作業中のブランチに影響しません - 結果ファイルは手元にとどめる 。フォルダには自動で
.gitignoreが付きますが、チームに共有するときも、共有先を案件メンバーに絞ります - まずは範囲を絞る選択肢もある 。全体で79分・約87ドル相当でした。初回はおすすめどおり「サーバーだけ」から始めて、手応えを見て広げるのも手です
- Claude Code を閉じない・スリープさせない 。スキャン中は開いたままにしておく必要があります。今回は Claude Code 側でスリープを防いでくれていました(ターミナルのタイトルに
caffeinateと出ていました) - Team / Enterprise プランなら組織設定を確認 。Dynamic workflows が無効だと動きません
おわりに
約7.4万行のリポジトリを、79分・199体のエージェント・API 換算で約87ドルでスキャンできました。
数字だけ見ると「重い」ですが、中身を見ると、 担当範囲に分けて並列に探し、別のエージェントの投票で反証させ、生き残ったものだけを出す という、人がセキュリティ診断でやっていることをそのまま組織化した作りでした。見ていない範囲まで正直に書かれていたのも、レポートを信頼するうえで大事なポイントだと感じます。
脆弱性診断の会社に頼むのと置き換えるものではありませんが、 まだ診断を受けていない案件に、まず1回回してみる という使い方には十分見合うと思いました。
以上、どなたかの参考になれば幸いです。
参考