見積書の突き合わせチェックをCopilotに任せられるか、手動添付とワークフローの2つの方法で検証してみた

概要
こんにちは、クラスメソッド製造ビジネステクノロジー部の田中聖也です。
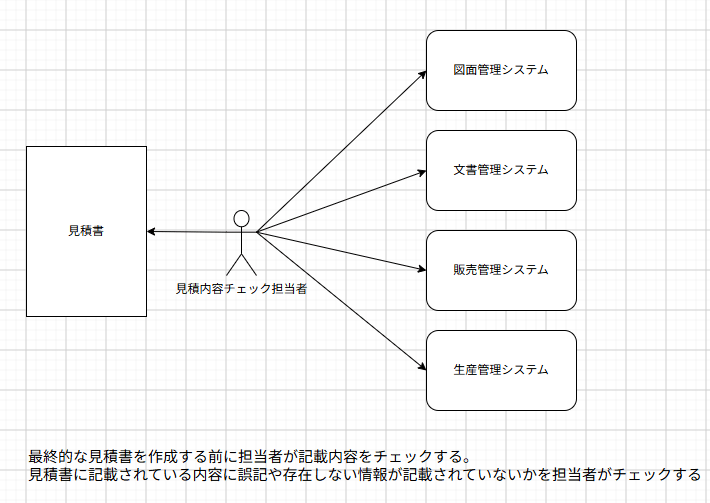
調達部などが保守部品の見積書案をチェックする業務で、過去の納入実績・購入仕様書の改訂状況・注釈のルールを、人が複数のシステムから手作業で引っ張ってきて突き合わせている、という話を伺いました。
参照先が生産系・図面系に分散していて、「どのデータをどこから持ってくるか」を特定するところが一番大変とのことでした。
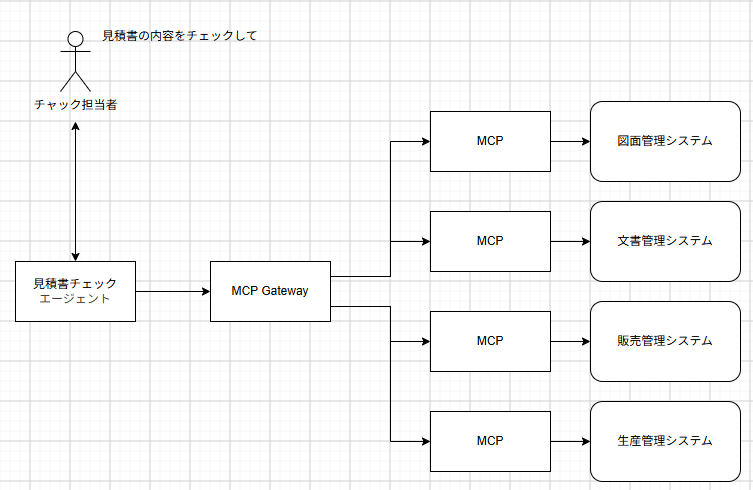
本番の構想は、各システムをMCP(Model Context Protocol)のゲートウェイ経由でつなぐ形がいいかなと考えています。
ただ、そこは権限設計や認証認可の整理に時間がかかって実装までの道のりは長いです。
なので今回は、データ取得の部分(MCP)をいったん切り離して、判定ロジックが生成AIで成立するのかだけを先に検証してみました。
検証の前提
対象としたデータ
押出機の周辺装置に使うメカニカルシール部品の見積、という設定で一式を作りました。
| 項目 | 値 |
|---|---|
| メーカー | サンプル機械工業株式会社(架空) |
| 対象部品 | サイドフィーダ用メカニカルシール部品 |
| 引合番号 | QSPB100001AA |
| 発行年月日 | 2026/7/10 |
| 購入仕様書番号(旧版) | PB100-200-0010 |
| 購入仕様書番号(最新) | PB100-200-0450 |
| 購入仕様書番号(存在しない) | PB100-200-0100 |
用意したファイルは、判定対象の見積書案と、参照側のマスタ4種類です。
| ファイル | 形式 | 役割 |
|---|---|---|
| 見積書案_QSPB100001AA | xlsx / pdf | 判定対象 |
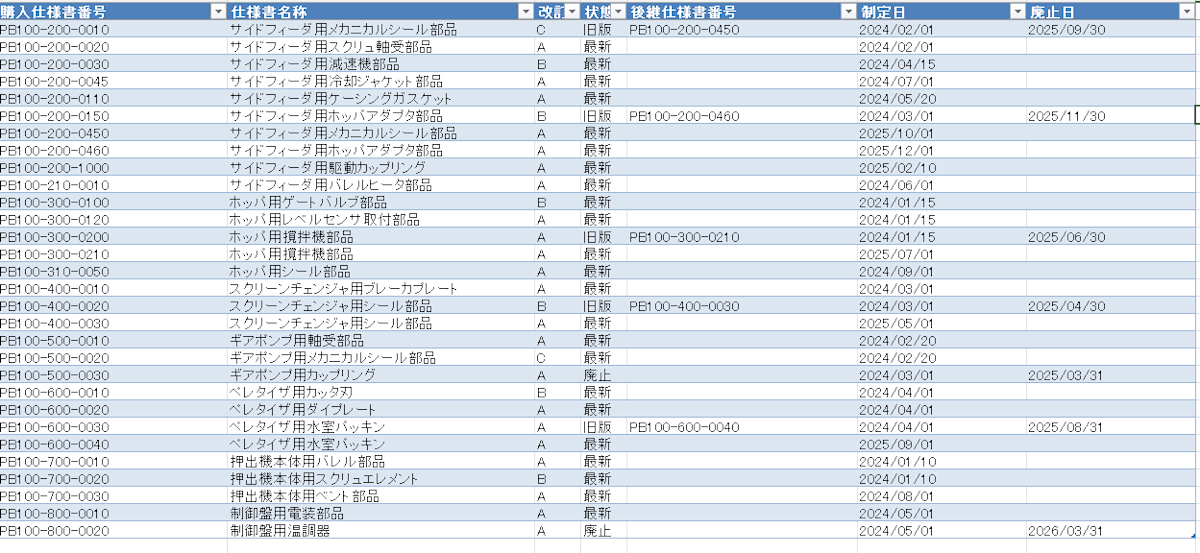
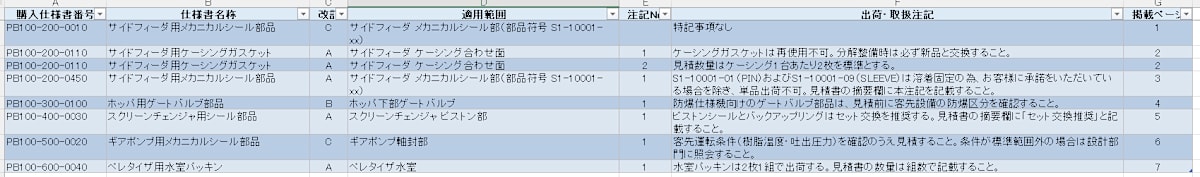
| 購入仕様書マスタ | xlsx / csv | 仕様書の実在・改訂・後継情報 |
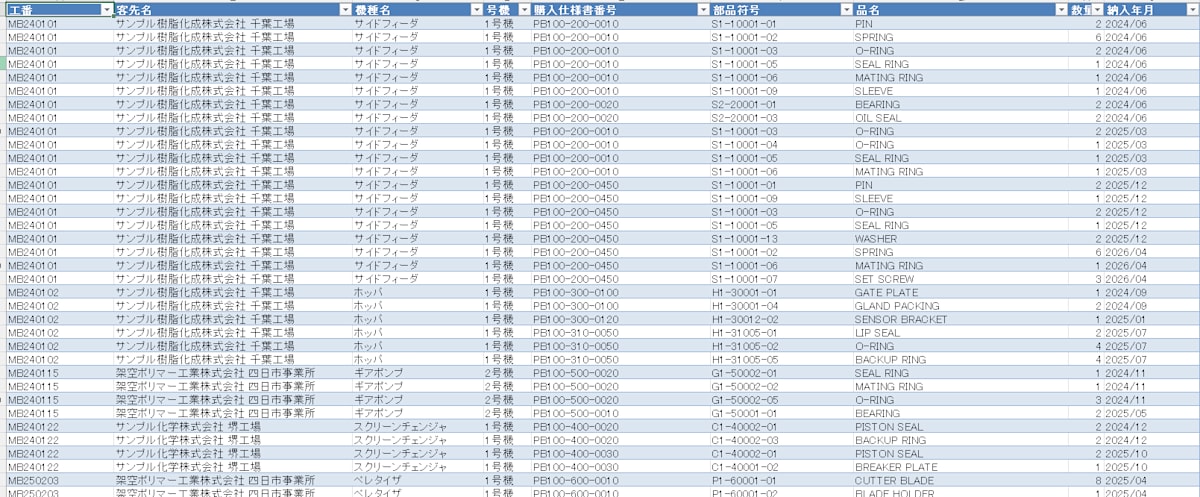
| 納入実績 | xlsx / csv | 工番ごとの納入実績 |
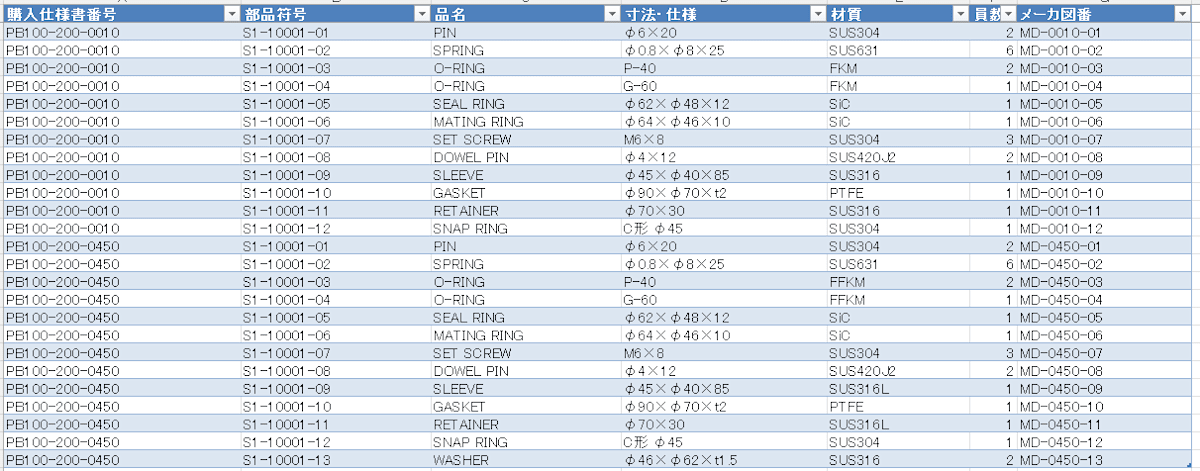
| 部品構成表 | xlsx | 仕様書ごとの部品構成 |
| 注釈ルール集 | 仕様書ごとの出荷・取扱注記 |
xlsxを正として、同じ内容のcsvとpdfを読み取り精度の比較用に用意しています。
見積書案
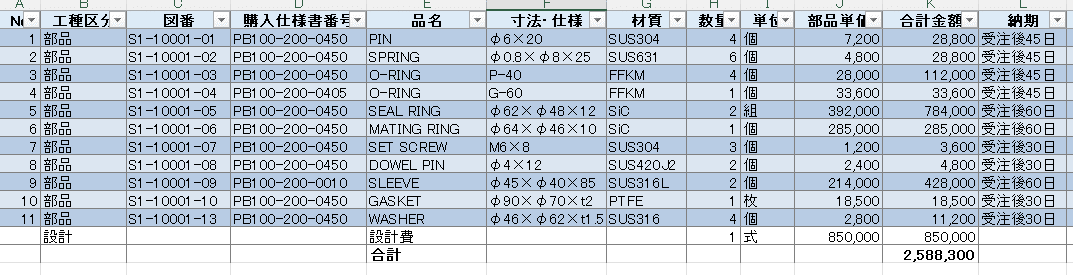
購入仕様書マスタ
部品構成表
納入実績
注釈ルール
※この記事で扱うデータはすべて架空です。
仕込んだ異常と正常系
採点できるように、正解が分かっている異常を4件だけ仕込みました。
| No | 異常の内容 |
|---|---|
| 異常1 | 明細の仕様書番号が PB100-200-0100 (マスタ未登録。正しくは 0010 の手打ちミス想定) |
| 異常2 | PB100-200-0010 は旧版で、後継の PB100-200-0450 が同一工番で納入実績あり |
| 異常3 | PB100-200-0450 の注釈ルール(単品出荷不可)が、摘要欄に書かれていない |
| 異常4 | ヘッダの元工番にサイドフィーダの納入実績がない |
あわせて、正しく書けている行を2行まぎれ込ませています。
ここを指摘したら誤検知(本来は問題ない行をAIが間違って問題ありと判定すること)としてカウントします。
評価基準
先に合格ラインを決めてから回しました。
| 指標 | 定義 | 目標 |
|---|---|---|
| 検知率 | 仕込んだ異常4件のうち検知できた件数 | 3/4 以上 |
| 誤検知 | 正常系2行を指摘した件数 | 0 |
| 根拠の妥当性 | 指摘の根拠として正しいファイル・行を挙げているか | 全指摘で妥当 |
| 再現性 | 同じプロンプトを3回投げたときの結果の一致 | 3回とも同じ検知 |
「検知できたけど根拠が違う」は不合格扱いにしています。本番では人が根拠まで確認できないので、ここは厳しめに見ました。
※CopilotのモデルはすべてOpusで統一しています。
方法1: Copilot Chat にファイルを手動添付する
Microsoft 365 Copilot のチャットに、OneDrive 上のファイルを「コンテンツを追加」で選んで添付し、チェック用のプロンプトを投げます。
エージェントも知識ソースも使っていません。
ポイントは、1つのチェックにつき会話を1つ立てることです。
添付ファイルは会話中ずっと参照され続けるので、同じ会話で複数のチェックを回すと後半の判定が崩れてきます。
プロンプト側では、以下を共通の方針にしました。
| 方針 | 狙い |
|---|---|
| 明細の全行を表で出力させる | 取りこぼしと誤検知を行単位で採点できるようにする |
| 番号は完全一致で照合させる | 似た番号を同じものとして読ませない |
| 判定の基準日を発行年月日に固定する | 「旧版」「廃止」の判断を日付で行わせる |
| 根拠にファイル名と行番号を必須にする | 根拠の妥当性を採点するため |
| 添付外の知識で補完することを禁止する | 一般論で埋めた回答を検知と取り違えないため |
| 参照できなかったファイルの明記を求める | 読めていないのに回答を作る挙動を検出するため |
最後の「参照できなかったファイルがある場合は、推測で回答せず『ファイル名: 参照不可』と明記してください」は入れておく必要があります。
これが無いと、読めていないのにそれらしい回答が返ってきて、検証結果が汚れます。
3つのチェック
判定は1回1観点に分けて、3つのチェックにしています。要求元から「5項目を一度に判定する必要はなく、3回に分けて少しずつ訂正していく形でも可」という意向をもらっていたためです。
| チェック | 確認すること | 添付ファイル | 狙った異常 |
|---|---|---|---|
| チェック1 | 購入仕様書番号の妥当性(マスタに実在するか、最新版か) | 見積書案、購入仕様書マスタ、部品構成表 | 異常1・2(No.13〜17は指摘しない) |
| チェック2 | 元工番の妥当性(納入実績と整合しているか) | 見積書案、納入実績 | 異常4 |
| チェック3 | 注釈ルールの適用(摘要欄に必要な注記があるか) | 見積書案、注釈ルール集(PDF)、購入仕様書マスタ | 異常3(正常系のNo.13・14は指摘しない) |
3つの添付パターン
この3つのチェックを、添付するファイルの形式を変えて3パターン回しました。見積書案の形式と、参照データの形式の組み合わせです。
| パターン | 見積書案 | 参照データ | 確かめたいこと | 回数 |
|---|---|---|---|---|
| 1 | xlsx | xlsx | 基準。判定ロジックが成立するか、同じプロンプトで結果がぶれないか | 12回 |
| 2 | xlsx | csv | 参照データをcsvにしても、同じ異常を同じ根拠で検知できるか | 4回 |
| 3 | xlsx | 見積書案をPDFにしても、表の構造を崩さずに読めるか | 3回 |
パターン2・3を入れたのは、要求元との打ち合わせで「該当するデータを1箇所に集約して、PDFやCSVを生成AIに読み込ませて同じ検知ができるか試す」ことになったためです。実際の業務データがどの形式で手に入るかは分からないので、形式が変わっても判定が成り立つかを先に見ておきたかった、というわけですね。xlsxを正、csvとpdfは比較用として、内容は完全に同じものを用意しています。
パターン1: xlsx × xlsx(基準になる組み合わせ)
- 目的: 判定ロジックが生成AIで成立するかの確認と、再現性(同じプロンプトで同じ検知になるか)の確認
- 内容: 見積書案・参照データともにxlsxを添付。チェック1・2・3(前提あり)・3(前提なし)をそれぞれ3回、毎回新しい会話で実施(計12回)。チェック3の「前提あり・なし」は後述
| チェック | 回数 | 狙った異常の検知 | 誤検知 |
|---|---|---|---|
| チェック1 | 3 | 異常1・2が3/3 | 0 |
| チェック2 | 3 | 異常4が3/3 | 0 |
| チェック3(前提あり) | 3 | 異常3が3/3 | 0 |
| チェック3(前提なし) | 3 | 異常3が3/3 | 0 |
12回すべてで、狙った異常をきちん検知しました!!(誤検知も0)
紛らわしい番号を混ぜたマスタにも、別客先の工番にも引っかかりませんでした。
根拠もおおむね正しかったです。
マスタの改訂・廃止日・後継番号、部品構成表の材質、注釈ルール集のページ番号、納入実績の行番号を元データと突き合わせましたが、ずれていたのは行範囲の引用が1件だけでした(パターン2で後述)。
同じ条件を3回投げて、狙った異常の検知は毎回同じでした。
ぶれたのは、採点対象外の行や付随する項目の判定です。
たとえばチェック2の「見積対象の機種」の判定は、3回で要確認・OK・NGと割れました。チェック3の採点対象外の行(No.8・9)も、要確認・OK・OKでした。
素のCopilotだったので難しいかなと思っていたのですが、想定以上の実力でした。
パターン2: 見積書案xlsx × 参照データcsv
- 目的: 参照データがcsvでも、xlsxと同じ異常を同じ根拠で検知できるかの確認。Copilot自身は「CSVの解析(要約・集計・異常値検出・複数CSVの比較など)が可能」と答えていたので、その自己申告が本当かを実測したかった
- 内容: 購入仕様書マスタと納入実績をcsv(UTF-8、BOM付き、xlsxと同一内容)に差し替えて添付。チェック1(マスタ)を2回、チェック2(納入実績)を1回、チェック3(マスタ)を1回、いずれも新しい会話で実施(計4回)
- 結果: 4回すべてで狙った異常を検知、誤検知は0。判定内容はxlsxと同等
読めるか読めないかではなく、読めた前提で同じ根拠にたどり着けるかを見たかったのですが、そこも問題ありませんでした。
ただ、気になった点が2つあります。
- 行番号の引用のずれが1件: チェック2で、旧版の仕様書の行範囲を「10〜21行目」と引用していました(正しくは10〜13行目で、14〜21行目は後継の仕様書)。検知自体は合っていますが、根拠としては不正確です
- 材質違いの行の判定がぶれた: チェック1で、番号を直すと材質が変わる行(No.2・3・11)の判定が、1回目はNG、2回目は要確認でした
パターン3: 見積書案pdf × 参照データxlsx
- 目的: 判定対象の見積書をPDFにしたとき、表の構造(列の対応・空欄・ヘッダ)を崩さずに読めるかの確認。PDFは、xlsxと違って行や列の情報が失われやすい形式なので、読み取りの精度差を見ておきたかった
- 内容: 見積書案の明細シートをPDF化して添付(日本語フォントの埋め込みが必須)。参照データはxlsxのまま。チェック1・2・3を1回ずつ、いずれも新しい会話で実施(計3回)
- 結果: 3回すべてで狙った異常を検知、誤検知は0
読み取り精度で見たポイントは次のとおりです。
| 見たところ | 結果 |
|---|---|
| ヘッダ(発行年月日・元工番・客先名)を1行に併記した部分 | 正しく読めた。基準日も元工番も取れた |
| 図番が空欄の行(No.8・9) | 空欄として正しく読めた。列ずれなし |
| 摘要が空欄の行(No.10・11) | 空欄として正しく読めた |
| 根拠の示し方 | 行番号ではなく、工番などの値で特定する回があった |
注釈ルール集はもともとPDFなので、パターン1〜3のすべてでPDFの読み取りも同時に確認できています。
ページ番号と文書番号・版数を根拠に挙げてきたので、PDFでも問題なさそうです。
3パターンのまとめ
| パターン | 回数 | 狙った異常の検知 | 誤検知 | 根拠の妥当性 | 付随する項目のぶれ |
|---|---|---|---|---|---|
| 1: xlsx × xlsx | 12 | 全回検知 | 0 | 妥当 | 採点対象外の行や機種判定で、回によって変わった |
| 2: xlsx × csv | 4 | 全回検知 | 0 | 行範囲の引用ずれが1件 | 材質違いの行で変わった |
| 3: pdf × xlsx | 3 | 全回検知 | 0 | 妥当(行番号の代わりに値で示す回あり) | 特になし |
パターン2と3は1〜2回ずつしか回していないので、再現性を確認できたのはパターン1だけです。
ファイル形式の違いで精度が落ちる傾向は見えませんでしたが、試行回数を増やした場合にどうなるか別途検証が必要です。
仕込んでいないのに指摘してきたこと
採点対象外だった指摘もいくつかありました。いずれも元データ上は正しい内容です。
- 材質の差異: 仕様書番号を0450に置き換えると、材質がFKMからFFKM、SUS316からSUS316Lに変わる。番号だけ直すと材質の記載が仕様書と合わなくなる、という指摘
- 訂正後の重複行: 番号を直すと、同じ番号・同じ図番の行が2行ずつ並ぶことになる。単価も違うので計上の意図を確認すべき、という指摘
- 数量の違和感: 見積数量が、過去の1回あたりの納入数のちょうど2倍になっている
- 実績のない部品符号: どの工番の納入実績にも出てこない部品符号が2つある
材質の指摘は、人がやっても見落としそうなところです。
こういう「ついでの気づき」が拾えるのは、ルールベース(あらかじめ決めた条件で機械的に判定する方式)のチェックにはない点だと思いました。
方法2: Copilot Studio の「ワークフロー(Workflows)」
手動添付で判定ロジックが成立しそうだと分かったので、次は自動化です。
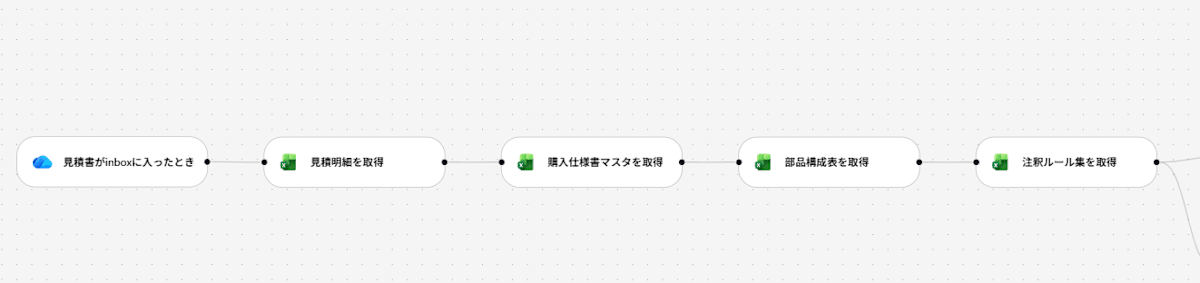
OneDrive の inbox フォルダに見積書を置いたら、勝手にチェックが走って結果が返ってくる形を目指しました。
フロー構成
[見積書がinboxに入ったとき]
        ↓
[見積書案を取得]
        ↓
[購入仕様書マスタを取得]
        ↓
[部品構成表を取得]
        ↓
[注釈ルールを取得]
        ↓
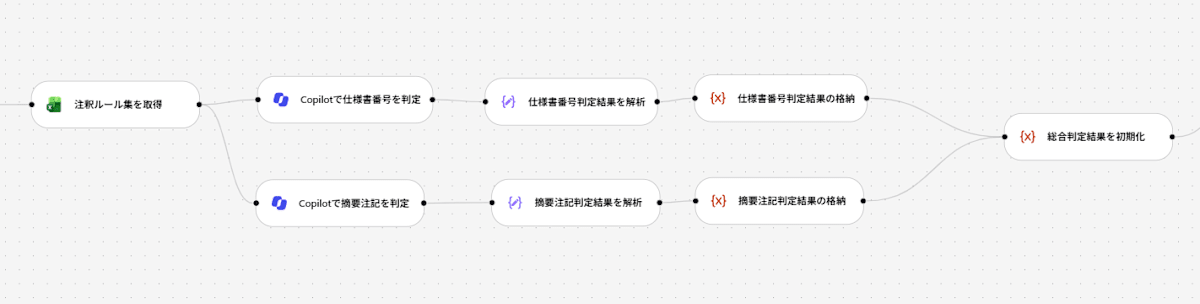
  ┌─────┴──────┐
[Copilotで仕様書番号を判定]  [Copilotで摘要注記を判定]
     ↓                        ↓
[JSON解析]                 [JSON解析]
  └─────┬──────┘
        ↓
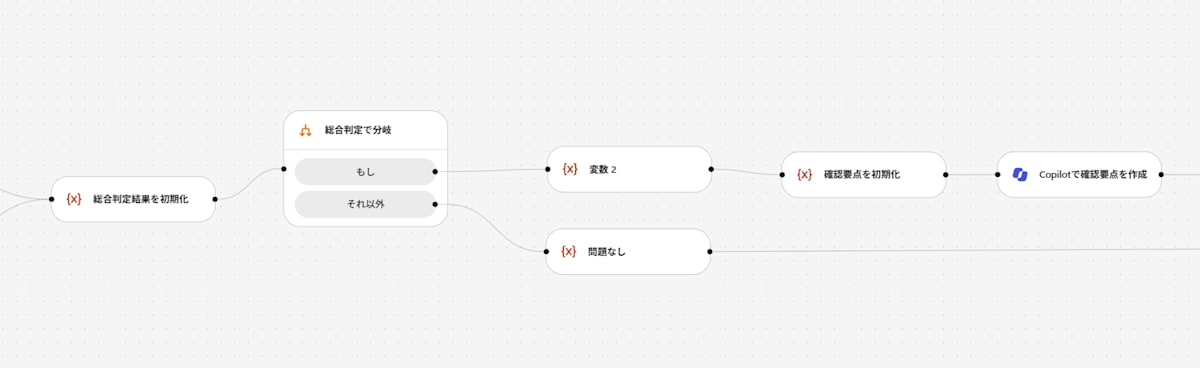
   [総合判定で分岐]
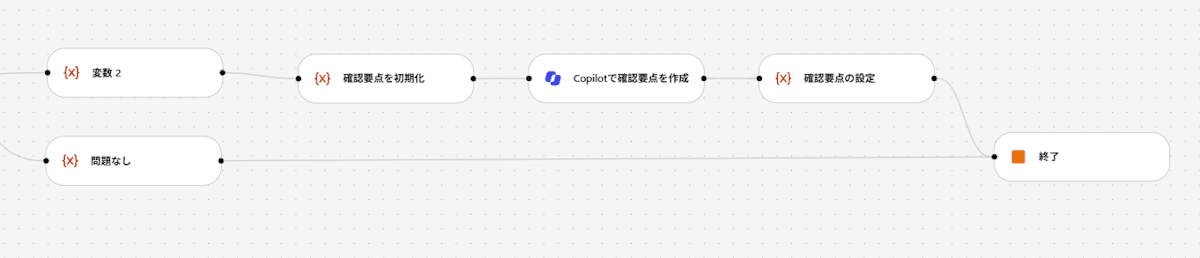
    ┌───┴────┐
  REVIEW      OK
    ↓
[Copilotで確認要点を作成]
観点を2つに分けて、どちらか一方でもREVIEW(人の確認が必要)なら全体をREVIEWにする、という総合判定です。
ANDではなくORにしました。片方だけ問題があるケースを取りこぼさないようにするためです。
詰まったところ
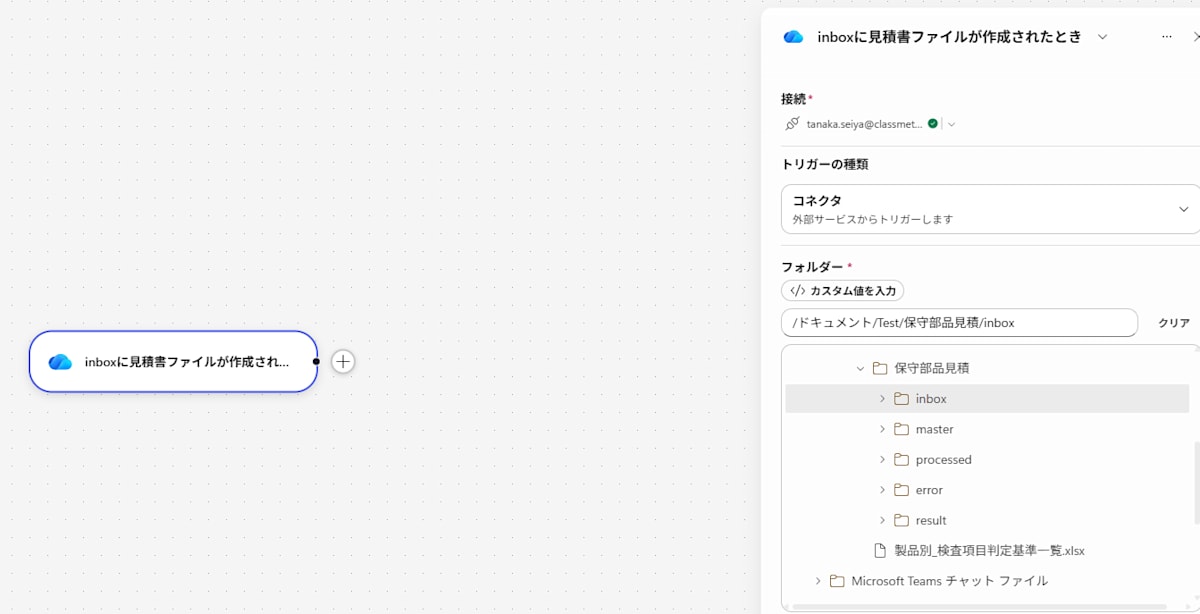
inboxにファイルを置いてもトリガーが動かない
トリガー設定画面のフォルダー欄が「Loading...」のままになっていました。
OneDrive内でファイルを移動させるのではなく、PCから新規アップロードした方が確実に起動しました。
Excelのアクションが404エラー
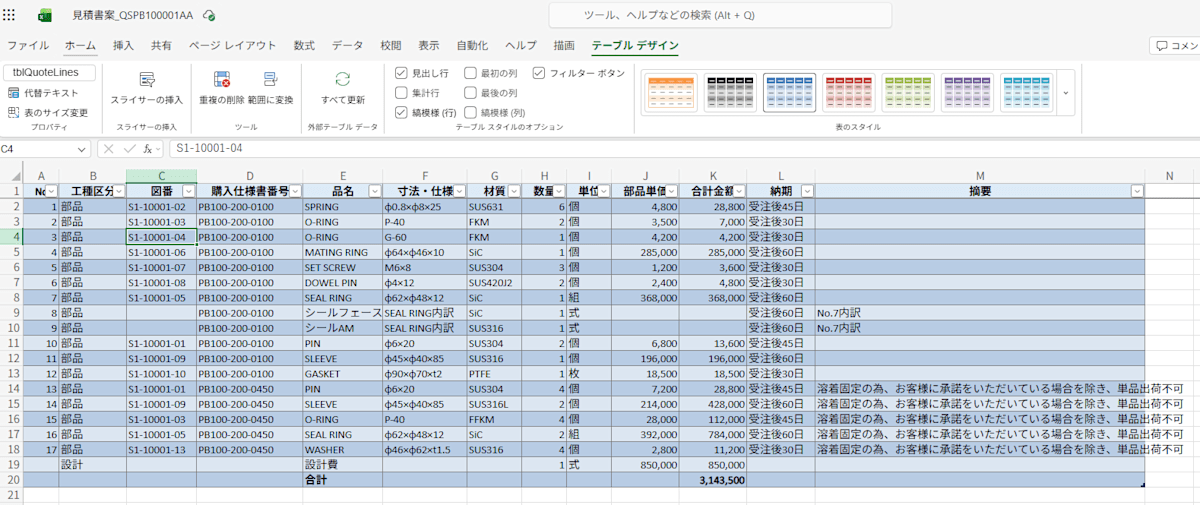
「表内に存在する行を一覧表示」が、指定したテーブルが見つからないとなりました。
原因は、見た目が表でもExcel上で正式なテーブルになっていなかったこと。ローカルのExcelで明細をテーブル化して解決です。
一致件数の誤集計
部品構成表との一致件数を数えさせたら、部品符号の一致が10件なのに材質の一致が12件、という数字が返ってきました。比較対象の行数を超えています。
原因は、図番が空欄の行を部品符号の一致件数からは除外していたのに、材質の一致件数からは除外していなかったことでした。
Copilotが材質を表全体から独立して検索して、別の部品に同じ材質があっても一致として数えていたようです。
テストケースの結果
見積書を4パターン用意して流しました。
| テストケース | 仕様書番号 | 摘要注記 | 総合判定 | 結果 |
|---|---|---|---|---|
| 正常ファイル | OK | OK | OK | 合格 |
| 仕様書番号のみNG | REVIEW | OK | REVIEW | 合格 |
| 摘要注記のみNG | OK | REVIEW | REVIEW | 合格 |
| 両方NG | REVIEW | REVIEW | REVIEW | 合格 |
REVIEWになったときは、対象の明細番号・未登録だった番号・訂正候補・一致件数・材質の差異・摘要の不足内容までを、人向けの文章で出せるようになりました。
ここまで出れば、確認する側はだいぶ楽になりそうな感じです。
摘要注記の判定だけは、意図的に広めに引っかける設定にしています。
注釈ルールの適用範囲が「部品符号 S1-10001-xx」という書き方だったので、Copilotはこれを同じ仕様書番号の全明細に対する条件として解釈しました。本来の対象は2部品だけです。
ここは見落としを防ぐことを優先して、過剰検出を許容する判断をしました。
最終的な要否は人が確認する前提なので、見落としよりましだと思いました。
2つの方法を並べて分かったこと
| 観点 | 素のCopilot | Copilot Workflow |
|---|---|---|
| 立ち上がりの速さ | 速い。ファイルを選んでプロンプトを投げるだけ | 遅い。テーブル化・トリガー・JSON解析の作り込みが要る |
| 入力データ | ファイルをそのまま添付 | Excelのテーブルから行を取得して渡す |
| 判定の安定性 | 高い。ただし付随する項目の判定は回によってぶれる | プロンプトを固めれば高い |
| 出力の扱い | 文章。人が読む前提 | JSON。後続の処理に渡せる |
| 向いている場面 | 判定ロジックが成立するかの見極め | 成立した後の運用 |
やってみて確かに感じたのは、いきなり自動化にしなくてもいんじゃないかと思いました。
手動添付で「判定そのものはできる」と分かっていたから、自動化で詰まったときに「AIに判定能力がないのでは」と疑わずに済みました。
原因がデータの渡し方とプロンプトの書き方に絞れていたので、切り分けがかなり楽でしたね。
もう一つ、AIが解析しやすい形にデータを加工しておくのが思った以上に効きます。
セル結合や空行を入れない、テーブル化しておく、判定に使わない列は渡さない。
この辺はAIの話というより、
まとめ
素のCopilotとワークフローの2つの方法で、見積書の突き合わせチェックをどこまでCopilotに任せられるか検証してみました。
判定そのものは手動添付の段階でかなり安定していて、自動化で苦労したのはAIの能力ではなくデータの渡し方とプロンプトの書き方でした。
業務でCopilot活用して効率化するときの参考になればなりよりです。