DevelopersIO 2026で「Python Lambdaにおけるテストしやすい設計とAI支援の活用」というタイトルで登壇しました

はじめに
こんにちは、クラウド事業統括本部の北野です。
2026 年 10 月 24 日に開催された「DevelopersIO 2026 Tokyo」で、「Python Lambdaにおけるテストしやすい設計とAI支援の活用」というタイトルで登壇しました。
この記事では、発表の内容をコードと図を交えて紹介します。
時間の都合で話せなかった内容も、あわせて詳しく書いています。
スライド
最初に結論
ソフトウェア設計で、人間が仕様(プログラム・テスト)を判断できる状態を保つ
AIはプログラムやテストを書いてくれますが、その仕様でよいかは決めてくれません。だから、人間がテストを読んで仕様を判断できる形にコードを分けておきます。これが発表で一番伝えたかったことです。
元ネタブログ
本記事のコードは要点を示す抜粋で、importや補助関数の定義は省略しています。
細かく知りたい方や、pytestとmotoの基本的な使い方については、こちらのブログとサンプルコードを参照してください。
発表のhandlerとdomainは、記事ではそれぞれcontrollerとserviceという名前です。発表では、Lambdaの呼び名に合わせてhandler、業務ルールの層だと名前だけで分かるようにdomainと呼んでいます。
1. こんなテスト、書いていませんか
題材: 注文を受け付けて保存するLambda
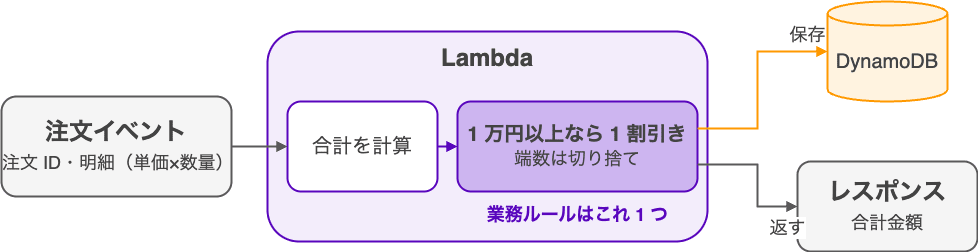
- 入力: 注文IDと明細(単価×数量)のイベント
- 業務ルール: 合計が1万円以上なら1割引き。端数は切り捨て
- 出力: DynamoDBに注文を保存し、合計金額を返す
業務ルールは割引の1つだけに絞り、これを「仕様」の代表として扱います。バリデーションや外部APIまで入れると、仕様がどこにあるかという話がぼやけるためです。
とあるLambda handler
import json
import os
import boto3

dynamodb = boto3.resource("dynamodb")
table = dynamodb.Table(os.environ["TABLE_NAME"])

def handler(event, context):
    items = event.get("items", [])
    subtotal = sum(i["price"] * i["quantity"] for i in items)
    total = subtotal * 9 // 10 if subtotal >= 10000 else subtotal
    table.put_item(Item={
        "order_id": event["order_id"],
        "items": items,
        "total": total,
    })
    return {"statusCode": 200, "body": json.dumps({"data": {"total": total}})}
短くて動くコードですが、業務ルール(合計と割引)、AWSの呼び出し(put_item)、レスポンスの組み立てが1つの関数に入っています。boto3のリソースはモジュールの先頭で初期化しています。このLambdaをテストしようとすると、どうなるでしょうか。
とあるテスト
@patch.dict("os.environ", {"TABLE_NAME": "orders"})
@patch("boto3.resource")
def test_handler(mock_resource):
    mock_table = MagicMock()
    mock_resource.return_value.Table.return_value = mock_table
    import handler as mod
    importlib.reload(mod)

    event = {"order_id": "o-1", "items": [{"price": 6000, "quantity": 2}]}
    result = mod.handler(event, {})
    body = json.loads(result["body"])

    assert body["data"]["total"] == 10800
    mock_table.put_item.assert_called_once_with(Item={
        "order_id": "o-1", "items": event["items"], "total": 10800,
    })
準備に7行、確かめたいことに2行です。環境変数と boto3.resource をpatchし、モジュール先頭で初期化しているので importlib.reload までしています。このテストが何を確かめたいのか、ぱっと見て分かるでしょうか。
このテストの何が問題か
- 業務仕様がモック設定に埋もれる
- SDKの呼び出しと業務ロジックが1つのassertに混在する
put_itemをbatch_writerに変えただけで全部のテストが落ちる- モックが正しいかを人間が確かめる必要がある
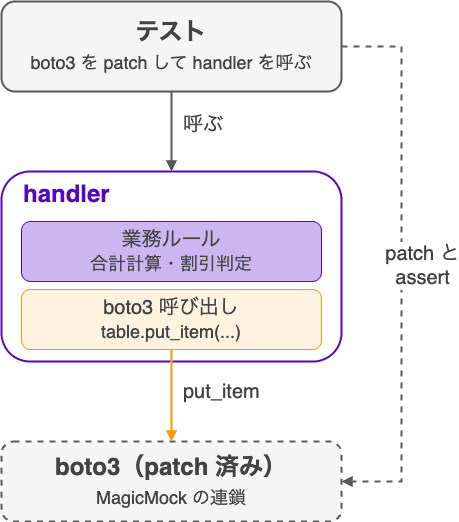
一番大きいのは1つ目です。テストには12,000円のケースしかなく、1万円ちょうどが割引対象かは分かりません。
残りの3つは、テストが「何を保存したか」ではなく「put_item をどう呼んだか」を見ていることから来ています。業務ロジックと呼び出し方が1つのassertに混ざり、batch_writer に変えるだけで落ちます。MagicMock はどんな引数でも成功するので、DynamoDBが受け付ける値かどうかも分かりません。
AIを持ち出す前に、人間がもう仕様を読めていない状態です。原因はテストの書き方ではなく設計にあります。
2. handlerを薄くし、依存を分離する
1章のテストが読みづらかったのは、業務ルールとAWSの呼び出しが同じ関数に入っていたからです。割引の計算を確かめたいだけなのに、同じ関数の中にある put_item まで一緒に動いてしまうので、テストはDynamoDBのモックから始めるしかありませんでした。
そこで、業務ルールとAWSの呼び出しを別の場所に置きます。目的は、人間が読むべき仕様を1か所に集めることです。割引のルールだけが書かれた関数があれば、その関数のテストを読むだけで仕様が分かり、「本当にその仕様でよいか」を判断できます。
handlerは入口と出口の処理だけを担当する薄い関数にし、中身を責務ごとに分けていきます。
4つの層に分ける
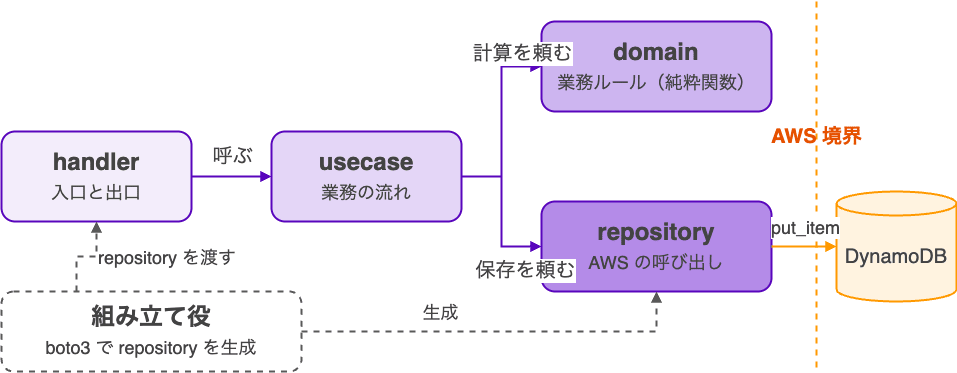
- handler: イベントを受け取りusecaseを呼ぶ。業務判断をしない
- usecase: 業務の流れを組み立てる
- domain: 業務ルールそのもの。AWSを知らない純粋関数で、仕様の置き場所になる
- repository: AWSの呼び出し。業務ルールを知らない
層の名前はClean ArchitectureやDDDなど特定の流派に従ったものではなく、責務が伝わるように付けたものです。言いたいのは「業務ルールとAWSの呼び出しを別の場所に置く」ことだけです。AWSのLambdaテストガイドでも、同じ考え方が勧められています。
Simplify your tests and Lambda functions by separating Lambda-specific code from your core business logic.
handlerは入口と出口だけ
import json

from app.dependencies import get_order_repository
from app.models.order import OrderItem
from app.usecases.order_usecase import create_order

def handler(event, context):
    order_id = event["order_id"]
    items = [OrderItem(**item) for item in event.get("items", [])]
    order = create_order(items, order_id, get_order_repository())
    return {"statusCode": 200, "body": json.dumps({"data": {"total": order.total}})}
handlerが知っているのは、Lambdaのイベントとレスポンスの形だけです。割引の判定も put_item もありません。
usecaseは流れ
# app/usecases/order_usecase.py
def create_order(items, order_id, repository: OrderRepository) -> Order:
    total = calculate_total(items)
    order = Order(order_id=order_id, items=items, total=total)
    repository.save(order)
    return order
ポイントは、create_order が repositoryを引数で受け取っている ことです。
最初のhandlerはboto3のリソースを自分で作っていたので、テストでは boto3.resource をpatchしてreloadするしかありませんでした。外から受け取る形にすれば、本番では本物を、テストではMockを渡すだけで済みます。これが依存性の注入(DI)です。
domainはルール
# app/domain/order_domain.py
def calculate_total(items: list[OrderItem]) -> int:
    """10,000円以上は10%割引"""
    subtotal = sum(item.price * item.quantity for item in items)
    if subtotal >= 10000:
        return subtotal * 9 // 10
    return subtotal
「1万円以上で1割引き、端数は切り捨て」というルールは、domainの calculate_total にしか書かれていません。
repositoryがAWSを呼ぶ
class OrderRepository:
    def __init__(self, dynamodb, table_name: str):
        self._table = dynamodb.Table(table_name)

    def save(self, order: Order) -> None:
        try:
            self._table.put_item(Item=to_item(order))
        except ClientError as e:
            raise OrderSaveError(order.order_id) from e

@cache
def get_order_repository() -> OrderRepository:
    dynamodb = boto3.resource("dynamodb")
    return OrderRepository(dynamodb, os.environ["TABLE_NAME"])
boto3を触るのは、このクラスの中だけです。to_item は注文をDynamoDBのアイテム形式に変換する関数です。dynamodbリソースを引数で受け取っているので、3章ではmotoのリソースやMagicMockを渡すだけでテストできます。boto3の ClientError は OrderSaveError に変換し、usecase以上の層がboto3の例外を知らずに済むようにしています。
get_order_repository が組み立て役で、本物のboto3リソースからrepositoryを作ってhandlerに渡します。put_item を batch_writer に変えたくなっても、変更はこのクラスの中で完結します。
分けると何が変わるか
太ったhandlerでは、1つの変更がテスト全体に波及していました。分けた後は、割引ルールを変えたときはdomainのテストだけが、DynamoDBの呼び出し方を変えたときはrepositoryのテストだけが影響を受けます。どの層が何を守るかが決まるので、テストの置き場所も決まります。
3. 3つのテスト境界を使い分ける
何をどこで守るか
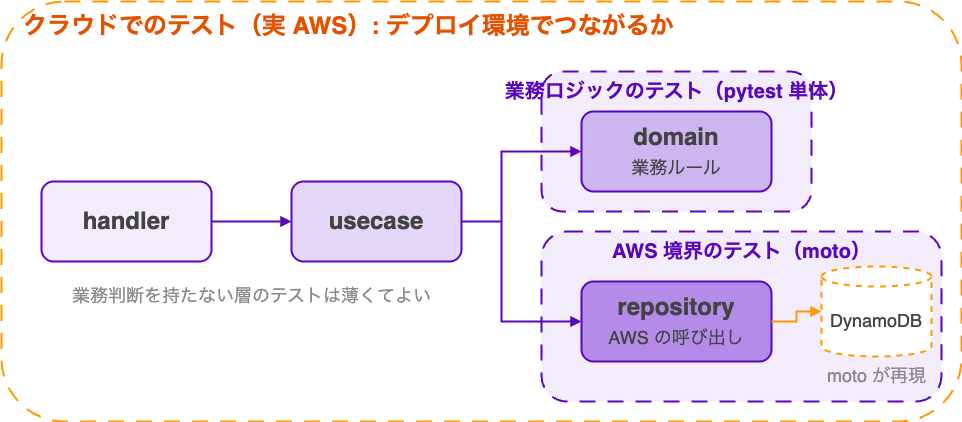
- 業務ロジック(pytest単体): 業務仕様が正しいか。人間が判断する
- AWS境界(moto): repositoryが期待どおり書き込めるか
- クラウドでのテスト(実AWS): IAMや環境変数などがつながるか
3つとも欠かせませんし、どれも人間が読んで判断する場面があります。ただ、判断する内容が違います。業務ロジックのテストでは「その仕様でよいか」を判断します。AWS境界のテストでは保存の形が意図どおりか、クラウドでのテストでは環境の設定が正しいかを確かめます。業務仕様を疑って読む場所が業務ロジックのテストに集まる、という違いです。
業務ロジックのテスト(pytest単体)
def test_no_discount():
    assert calculate_total([OrderItem(price=3000, quantity=2)]) == 6000

def test_exact_threshold():
    assert calculate_total([OrderItem(price=10000, quantity=1)]) == 9000

def test_truncation():
    """割引後の端数は切り捨て"""
    assert calculate_total([OrderItem(price=10001, quantity=1)]) == 9000
モックなしで、境界値を1行ずつ足せます。実行もミリ秒で終わります。テストを読むだけで「1万円ちょうどは割引対象」「端数は切り捨て」という仕様が分かるので、「本当にそれでいいんだっけ?」と人間が疑問を持てます。テストがそのまま仕様書になります。
AWS境界のテスト(moto)
@pytest.fixture
def dynamodb_table():
    with mock_aws():
        dynamodb = boto3.resource("dynamodb", region_name="ap-northeast-1")
        create_orders_table(dynamodb)
        yield dynamodb

def test_save(dynamodb_table):
    order = Order(order_id="o-1", items=[OrderItem(price=10000, quantity=1)], total=9000)
    repo = OrderRepository(dynamodb_table, "orders")
    repo.save(order)

    table = dynamodb_table.Table("orders")
    saved = table.get_item(Key={"order_id": "o-1"})["Item"]
    assert saved["total"] == 9000
motoは、boto3からのAWS API呼び出しをメモリ上の模擬実装で受けるライブラリです。fixtureの create_orders_table は、moto上にordersテーブルを作るヘルパー関数です。
このテストは put_item の呼び出し方ではなく、get_item で読み戻した結果を確かめています。1章のテストと違い、batch_writer に変えても同じ値が保存されていれば通ります。ただし、IAMの権限チェックや実運用の障害は再現されません。
motoで自然に起きない障害系はMagicMockで
mock_dynamodb = MagicMock()
mock_table = mock_dynamodb.Table.return_value
mock_table.put_item.side_effect = ClientError(
    {"Error": {"Code": "ProvisionedThroughputExceededException"}}, "PutItem"
)
repo = OrderRepository(mock_dynamodb, "orders")
order = Order(order_id="o-1", items=[OrderItem(price=10000, quantity=1)], total=9000)

with pytest.raises(OrderSaveError):
    repo.save(order)
スループット超過のような実運用の障害は、moto上では自然に発生しません。そこで side_effect で ClientError を起こし、repositoryが OrderSaveError に変換することを確かめます。
ここでもMagicMockを使っていますが、1章のテストとは差し込む場所が違います。1章では boto3.resource をpatchしてhandler全体を通していました。ここではrepositoryのコンストラクタに渡すだけで、テストはrepositoryの中で完結します。
クラウドでのテスト(実AWS)
AWSのテストガイドで「Testing in the cloud」と呼ばれているテストです。デプロイして初めて分かる失敗を見つけます。
-
参考:How to test serverless functions and applications - AWS Lambda
-
IAMに
PutItemの許可がない -
TABLE_NAMEが別のテーブルを指す -
依存ライブラリがパッケージにない
IAM、環境変数、デプロイパッケージの中身は、ローカルのテストでは見ていません。だから、この3つはどれもmotoでは通ってしまいます。
テストはデプロイ済みのLambdaをinvokeして、DynamoDBから get_item で読み戻すだけです。正常系で読み書きが通ることだけを少数確かめれば十分です。業務ロジックの境界値は、ここでは繰り返しません。pytestのマーカーで普段のテストと分け、デプロイ後にだけ流します。
テストピラミッド
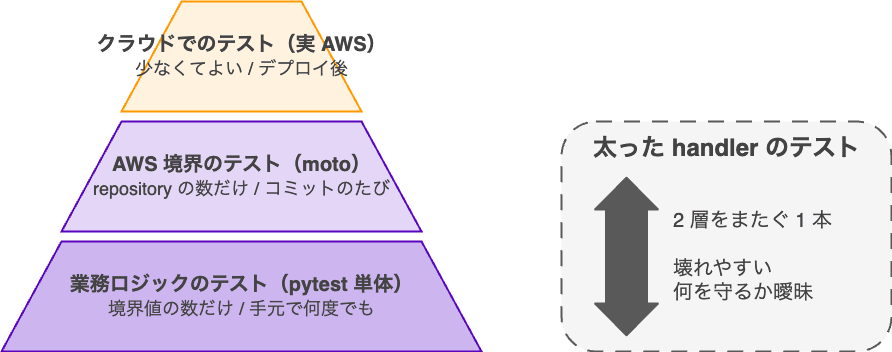
本数は業務ロジックのテストが最も多く、クラウドでのテストが最も少なくなります。テストピラミッドで大事なのは、層の名前ではなく次の考え方です。
Write lots of small and fast unit tests. Write some more coarse-grained tests and very few high-level tests that test your application from end to end.
1章の太ったhandlerのテストは、下の2段をまたいで1本に混ぜていた状態です。handlerとusecaseは業務判断を持たないので、テストは薄くて構いません。
4. AIはテストを書く。仕様の判断は人間が持つ
ここまでは、人間がテストを書く前提で話してきました。ただ、最近は「テストケースを洗い出して」「テストコードの下書きを書いて」とAIに頼む機会が増えています。
では、ここまでの設計はAIにテストを書かせるときにも意味があるのでしょうか。それとも、AIなら太ったhandlerでも読みやすいテストを書いてくれるのでしょうか。これを確かめるために実験しました。
実験: 同じ依頼を2つの設計に投げる
用意したのは2つのコードです。
- 太ったhandler: 1章と同じく、合計・割引・保存が1つの関数に入ったLambda
- 4層版: 2章のとおり、handler・usecase・domain・repositoryに分けたLambda
それぞれにClaude Code(バージョン2.1.296、モデルはclaude-opus-5-5)で同じ依頼を3回ずつ投げました。依頼は2段階です。
- src配下のコードに対して必要なテストケースを洗い出す
- 洗い出したテストケースのテストコードを書き、pytestで実行する
ただし、実験は各3回でモデルも1つと少ないので、あくまで傾向としてみてください。
moto、patch、層といった言葉は依頼文に入れていません。AIが自分でコードを読んで、どこに何のテストを書くかを決めます。結果を観点ごとにまとめたのが次の表です。
| 観点 | 太ったhandler | 4層版 |
|---|---|---|
| 境界値 | 3回とも挙がる | 同じ。差はない |
| 割引のテスト | handler経由。DBの準備付き | domainを直接呼ぶだけ |
| レビュー | フェイクの忠実さ | 層の責務に合うか |
表の1行目は、AIが書くテストの中身です。1万円ちょうどは割引か、端数はどうなるかといった境界値は、どちらの設計でも3回とも挙がり、書かれたテストは全件通りました。価値の低いテストも両方にありました。float誤差を大量のループで総当たりするテストや、dataclassの既定値を確かめるだけのテストです。良い点も悪い点も、量は同じくらいでした。テストの中身は設計で差がつかなかった、ということです。
差が出たのは表の2行目と3行目で、人間がそのテストをレビューするときの手間です。太ったhandlerでは、割引1件の期待値が仕様どおりかを判断する前に、DynamoDBの準備や再importのfixtureが正しいかを確かめる必要があります。仕様の判断とモックの検証が1本のテストに混ざるからです。4層版では、domainのテスト1行を読めば仕様だけを判断できます。次の節で詳しく見ます。
AIにテストを任せるときに起きること
太ったhandlerでは、業務ルールのテストもhandler経由になります。
面白かったのは、AIがテーブルをフェイクに差し替えるfixtureを自分で作ったことです。ソースコードで分けなかった責務を、AIがテストの中で分けようとしました。ただ、そのフェイクが正しいかは人間が確かめるしかありません。
4層版では、境界値のテストがdomainの純粋関数に1行ずつ置かれ、domainのテストは10件を超えても0.02秒で終わりました。usecaseのテストは、Mockのrepositoryを渡すだけです。AIエージェントが、設計に沿った場所にテストを置いてくれています。
一方で、仕様が未確定の挙動を期待値に固定したテストは、どちらの設計にも同じくらいありました。設計を分けてもここは変わりません。その期待値でよいかは、人間が判断するしかない部分です。
層ごとのレビュー観点
| テスト | レビューで重視すること |
|---|---|
| domain(pytest単体) | 期待値が業務仕様どおりか |
| usecase(Mock) | 処理の順番と、失敗したときの扱い |
| repository(moto) | 保存した値を読み戻せるか |
| handler | 入力と出力の形 |
表の4つは2種類に分かれます。
- domainとhandler: 値やレスポンスが それで正しいか を、人間が仕様として判断する
- usecaseとrepository: 決まった仕様どおりに動くか を確かめる。処理の順番や保存の形が意図どおりかは見るが、仕様そのものを疑う場面は少ない
人間が仕様を疑いながら時間をかけて読むのは、主にdomainとhandlerのテストです。太ったhandlerでは、1本のテストにこれらの観点が全部混ざるので、どこを疑って読めばよいかが決まりません。
実験でも差が出ています。AIが書いたテストを、テスト本体だけ読めば期待値が妥当か判断できるものと、先にfixtureの中身(テーブルの作り方やフェイクの挙動)を確かめないと判断できないものに分けてみました。前者は、1回の試行あたり太ったhandlerでは0〜1件、4層版では19〜23件でした。4層版のdomainやusecaseのテストは、引数と期待値だけで完結しているからです。
AIを主役にしない
AIにテストを書かせるために設計を分けるのではありません。人間が仕様を理解し、安心して変更・レビューできるように分けます。テストケースの列挙と実装はAIに任せ、人間は期待値と仕様の妥当性をレビューします。
設計が整っていないコードにAIを投入しても、人間が読めないテストが速く増えるだけです。設計を分けておけば、AIが書いたテストも人間が読める場所に置かれます。
まとめ
- 太ったhandlerのテストは、仕様をモックに埋もれさせる
- 層に分けて役割を固定すると、人間が読む場所が絞られる
- 業務仕様は純粋関数で、AWS境界はmotoで、環境の設定は実AWSで守る
- AIはテストを書く。仕様の妥当性は人間が判断する
いきなり4層にしなくても構いません。手始めに、handlerの中の業務ルールを純粋関数に切り出す だけで、業務仕様のテストが数行で書け、人間が読める場所に仕様が戻ってきます。
おわりに
実験では、設計が整っていなくてもAIはきちんと境界値を挙げ、動くテストを書いてきました。
差が出たのは、人間がそのテストから仕様を判断するまでの手間です。AIがテストを書く時代だからこそ、人間が読める設計の価値が上がっていると感じています。
入力バリデーションや外部APIのモックなど、発表で扱わなかった内容は元ネタの記事にまとめています。
このブログがどなたかのお役に立てれば幸いです。