DynamoDB の Zero-ETL 統合で S3 Tables に同期した Iceberg テーブルを Snowflake から参照してみた

はじめに
Amazon DynamoDB は Zero-ETL 統合により DynamoDB のテーブルをソースとして Amazon SageMaker Lakehouse にレプリケーションできます。
この際、ターゲットカタログとして S3 Tables を指定できます。これにより、DynamoDB のデータは S3 テーブルバケットに Apache Iceberg 形式のテーブルとして書き込まれます。
S3 テーブルバケットは、Iceberg REST エンドポイントを提供しており、対応するクライアントから直接クエリできます。
Snowflake は、カタログリンクデータベースという機能により、外部の Iceberg REST カタログに接続し、外部カタログの名前空間や Iceberg テーブルを自動的に検出・同期することで、Snowflake から参照できるようにします。
本記事では、Zero-ETL 統合による DynamoDB テーブルの連携を試し、S3 Tables に同期されたテーブルを Snowflake から参照するまでの手順を試してみました。
DynamoDB の Zero-ETL 統合
DynamoDB の Zero-ETL 統合は、AWS Glue を介して DynamoDB のテーブルのデータを SageMaker Lakehouse(Glue Data Catalog)のターゲットへ同期する機能です。
本機能については以下に記載があります。
主なポイントは以下のとおりです。
- 初回は全量を同期し、以降は変更データキャプチャ(CDC)で、追加・更新・削除された差分だけを同期する
- 内部では DynamoDB の PITR(ポイントインタイムリカバリ)からのエクスポートを使うため、テーブルの読み取りキャパシティを消費しない
- 更新間隔は最短15分で設定できる
DynamoDB と分析基盤を連携する手段として、よりニアリアルタイム性が求められる場合には DynamoDB Streams の利用などが必要ですが、Zero-ETL 統合は ETL パイプラインを構築・運用することなく同期を継続できる点が特徴です。
なお、本機能の検証として以下の記事もあります。あわせて参考になると思います。
前提条件
検証環境
以下の環境を使用しています。
- AWS リージョン:東京(
ap-northeast-1) - ソース:Amazon DynamoDB
- ターゲット:S3 Tables のカタログ(テーブルバケット
lab-zetl-analytics、s3tablescatalog/lab-zetl-analytics) - クエリエンジン:Amazon Athena、Snowflake
事前準備
DynamoDB のテーブルを作成
検証用に、注文データを想定したテーブルlab-ordersを作成します。パーティションキーはorder_idです。
Zero-ETL 統合では、ソースのテーブルで PITR が有効である必要があります。また、Glue がテーブルをエクスポートできるよう、テーブルにリソースポリシーを設定します。
以下の CloudFormation テンプレートで作成しました。
DynamoDB テーブルの CloudFormation テンプレート
AWSTemplateFormatVersion: "2010-09-09"
Description: Zero-ETL 検証用の DynamoDB テーブル(PITR + Glue 向けリソースポリシー)

Parameters:
  TableName:
    Type: String
    Default: lab-orders

Resources:
  OrdersTable:
    Type: AWS::DynamoDB::Table
    Properties:
      TableName: !Ref TableName
      BillingMode: PAY_PER_REQUEST
      AttributeDefinitions:
        - AttributeName: order_id
          AttributeType: S
      KeySchema:
        - AttributeName: order_id
          KeyType: HASH
      PointInTimeRecoverySpecification:
        PointInTimeRecoveryEnabled: true
      ResourcePolicy:
        PolicyDocument:
          Version: "2012-10-17"
          Statement:
            - Sid: AllowGlueZeroEtlExport
              Effect: Allow
              Principal:
                Service: glue.amazonaws.com
              Action:
                - dynamodb:ExportTableToPointInTime
                - dynamodb:DescribeTable
                - dynamodb:DescribeExport
              Resource: "*"
              Condition:
                StringEquals:
                  aws:SourceAccount: !Ref AWS::AccountId
                ArnLike:
                  aws:SourceArn: !Sub arn:aws:glue:${AWS::Region}:${AWS::AccountId}:integration:*
リソースポリシーのaws:SourceArnはこの時点では統合が存在せずわからないため、ワイルドカード(integration:*)にしています。統合作成後に、後述の手順で統合の ARN に絞ります。
サンプルデータ
サンプルデータとして、次のような属性を持つ注文データを 1,000件追加しました。
| 属性 | 型 | 内容 |
|---|---|---|
order_id |
文字列 | 注文 ID(キー) |
customer_id、category、status、prefecture、ordered_at |
文字列 | 顧客、カテゴリ、ステータスなど |
quantity、unit_price、total_amount |
数値 | 数量、単価、合計金額 |
他にも型の変換を確認するため、入れ子のマップやリスト、集合などを含む項目を 1件追加しました。
{
  "order_id":     { "S": "ORD-NESTED-0001" },
  "quantity":     { "N": "2" },
  "discount_rate": { "N": "0.15" },
  "is_gift":      { "BOOL": true },
  "gift_note":    { "NULL": true },
  "shipping": {
    "M": {
      "method":  { "S": "宅配便" },
      "fee":     { "N": "500" },
      "address": { "M": { "zip": { "S": "100-0001" }, "city": { "S": "千代田区" } } }
    }
  },
  "items": {
    "L": [
      { "M": { "sku": { "S": "BK-001" }, "qty": { "N": "1" } } },
      { "M": { "sku": { "S": "BK-002" }, "qty": { "N": "1" } } }
    ]
  },
  "mixed_list": { "L": [ { "S": "a" }, { "N": "1" } ] },
  "tags":   { "SS": ["ギフト", "急ぎ"] },
  "scores": { "NS": ["1", "2.5"] }
}
S3 テーブルバケットと IAM ロールを作成
ターゲットとなる S3 テーブルバケットlab-zetl-analyticsと、統合の実行時に Glue が S3 Tables へ書き込むために必要な IAM ロールを作成します。
S3 テーブルバケットと IAM ロールの CloudFormation テンプレート
Resources:
  AnalyticsTableBucket:
    Type: AWS::S3Tables::TableBucket
    Properties:
      TableBucketName: lab-zetl-analytics

  GlueTargetRole:
    Type: AWS::IAM::Role
    Properties:
      RoleName: lab-zetl-glue-role
      AssumeRolePolicyDocument:
        Version: "2012-10-17"
        Statement:
          - Effect: Allow
            Principal:
              Service: glue.amazonaws.com
            Action: sts:AssumeRole
            Condition:
              StringEquals:
                aws:SourceAccount: !Ref AWS::AccountId
      Policies:
        - PolicyName: s3tables-write
          PolicyDocument:
            Version: "2012-10-17"
            Statement:
              - Effect: Allow
                Action:
                  - s3tables:ListTableBuckets
                  - s3tables:GetTableBucket
                  - s3tables:GetTableBucketEncryption
                  - s3tables:GetNamespace
                  - s3tables:CreateNamespace
                  - s3tables:ListNamespaces
                  - s3tables:CreateTable
                  - s3tables:DeleteTable
                  - s3tables:GetTable
                  - s3tables:GetTableEncryption
                  - s3tables:ListTables
                  - s3tables:GetTableMetadataLocation
                  - s3tables:UpdateTableMetadataLocation
                  - s3tables:GetTableData
                  - s3tables:PutTableData
                Resource:
                  - !GetAtt AnalyticsTableBucket.TableBucketARN
                  - !Sub ${AnalyticsTableBucket.TableBucketARN}/table/*
              - Effect: Allow
                Action:
                  - cloudwatch:PutMetricData
                Resource: "*"
                Condition:
                  StringEquals:
                    cloudwatch:namespace: AWS/Glue/ZeroETL
              - Effect: Allow
                Action:
                  - logs:CreateLogGroup
                  - logs:CreateLogStream
                  - logs:PutLogEvents
                Resource: "*"
このロールの権限は、以下のドキュメントのターゲット IAM ロールの権限(s3tables の権限、CloudWatch のメトリクス、CloudWatch Logs)に合わせています。
S3 Tables の分析サービス統合を有効化
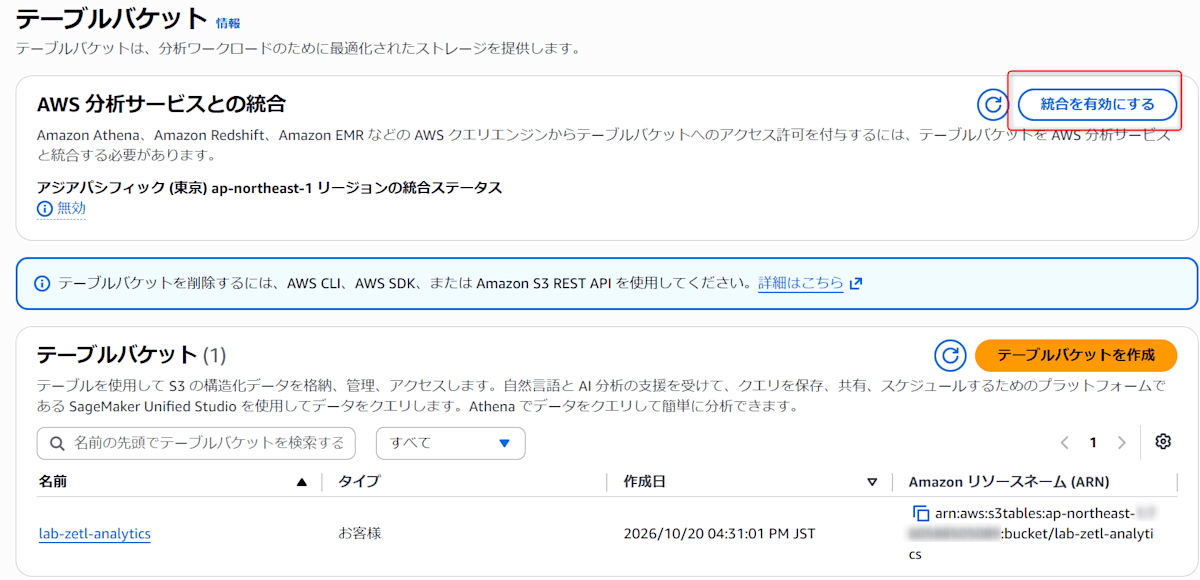
S3 テーブルバケットを Glue Data Catalog から見えるようにするため、分析サービスとの統合を有効化します。
以下によると、この設定は S3 テーブルバケットをターゲットにする場合の前提条件として案内されています。
こちらはコンソールから実施しました。S3 Tables のコンソールでテーブルバケットの画面を開き、「統合を有効にする」を選択します。
有効化後、aws glue get-catalogsでs3tablescatalogが作成されていることを確認できます。
$ aws glue get-catalogs
{
    "CatalogList": [
        {
            "CatalogId": "<アカウントID>:s3tablescatalog",
            "Name": "s3tablescatalog",
            "FederatedCatalog": {
                "Identifier": "arn:aws:s3tables:ap-northeast-1:<アカウントID>:bucket/*",
                "ConnectionName": "aws:s3tables"
            },
            ...
        }
    ]
}
s3tablescatalogは、S3 Tables を Glue Data Catalog の配下に見せるフェデレーテッドカタログです。S3 Tables のデータやメタデータを Glue にコピーしているのではなく、参照時に S3 Tables 側へ問い合わせる形になります。
この点は以下の記事が参考になります。
Zero-ETL 統合を作成
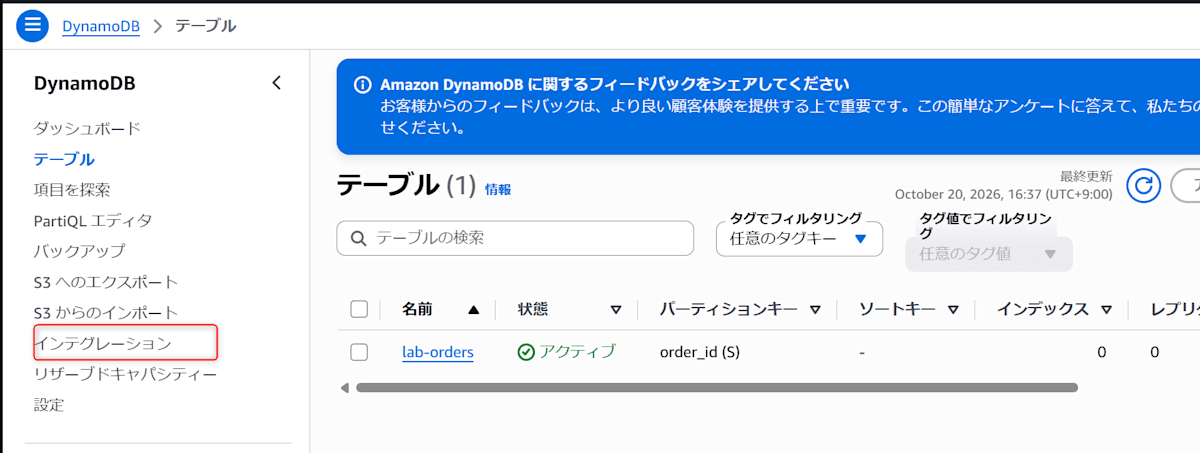
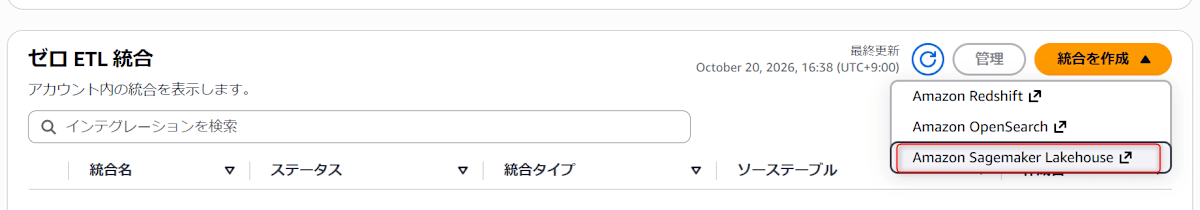
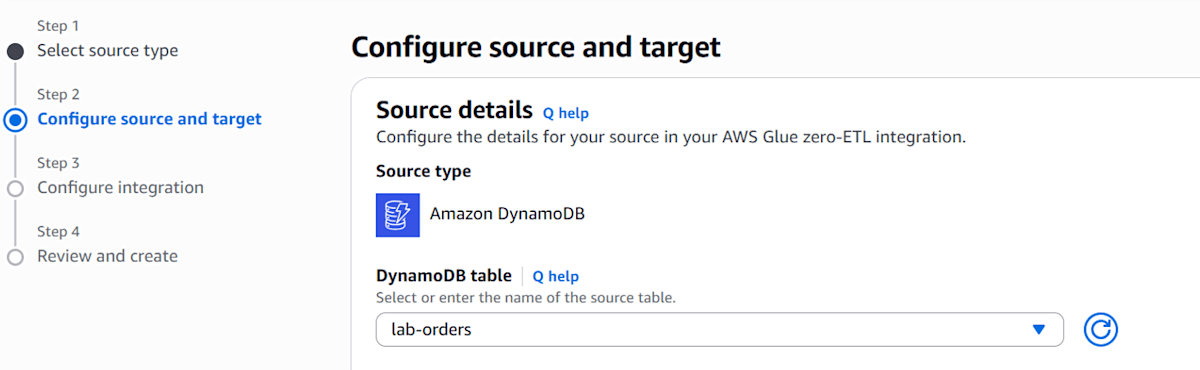
DynamoDB のコンソールで「インテグレーション > Amazon SageMaker Lakehouse」をクリックします。
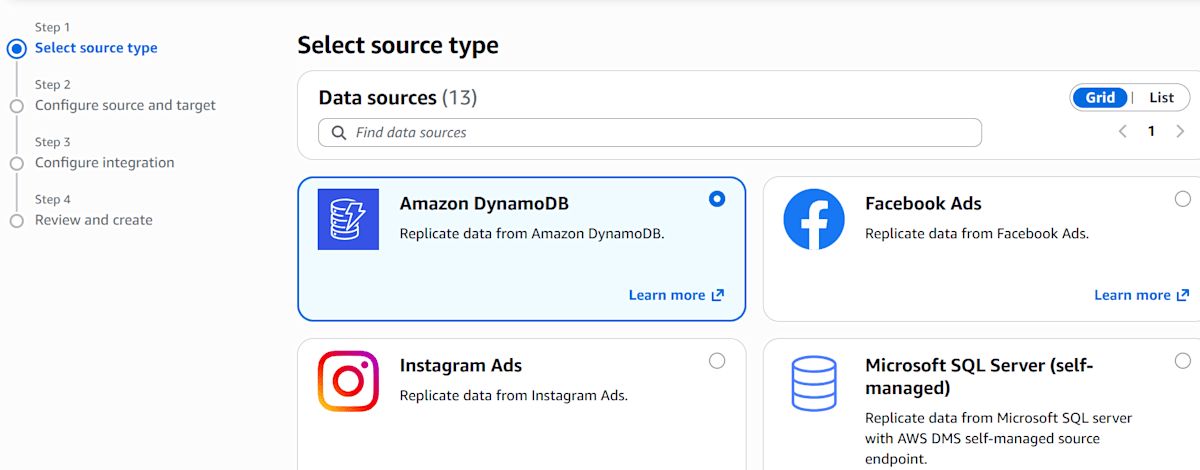
ソースとして Amazon DynamoDB を選択し、対象のテーブルを指定します。
ターゲットに関する設定を指定します。
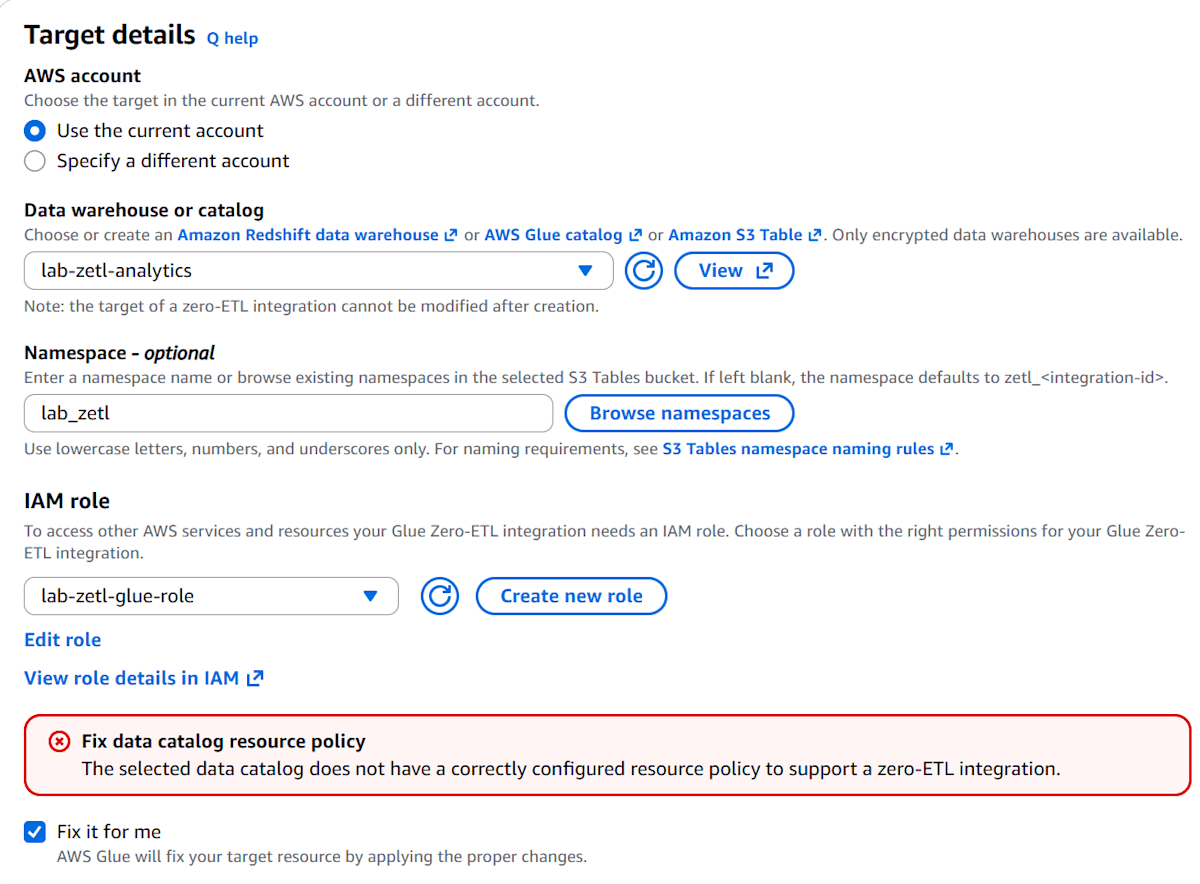
各設定の内容は以下のとおりです。
- ターゲット
- 同期先を指定します。Redshift、Glue Data Catalog、S3 Tables のカタログから選択でき、今回は S3 Tables のカタログを選択しました
- S3 Tables のカタログは Glue Data Catalog の配下に登録されたフェデレーテッドカタログ(
s3tablescatalog)として扱われます
- 処理ロール
- 統合の実行時に Glue が引き受ける IAM ロールです。S3 テーブルバケットへの書き込みなどの権限を持つロールを指定します。ここでは事前準備で作成した
lab-zetl-glue-roleを指定しました
- 統合の実行時に Glue が引き受ける IAM ロールです。S3 テーブルバケットへの書き込みなどの権限を持つロールを指定します。ここでは事前準備で作成した
- 名前空間
- データの書き込み先の名前空間(Glue のデータベースに相当)です。空欄でも作成できますが、その場合は
zetl_<統合ID>という名前で自動生成されます。ここではlab_zetlとしました
- データの書き込み先の名前空間(Glue のデータベースに相当)です。空欄でも作成できますが、その場合は
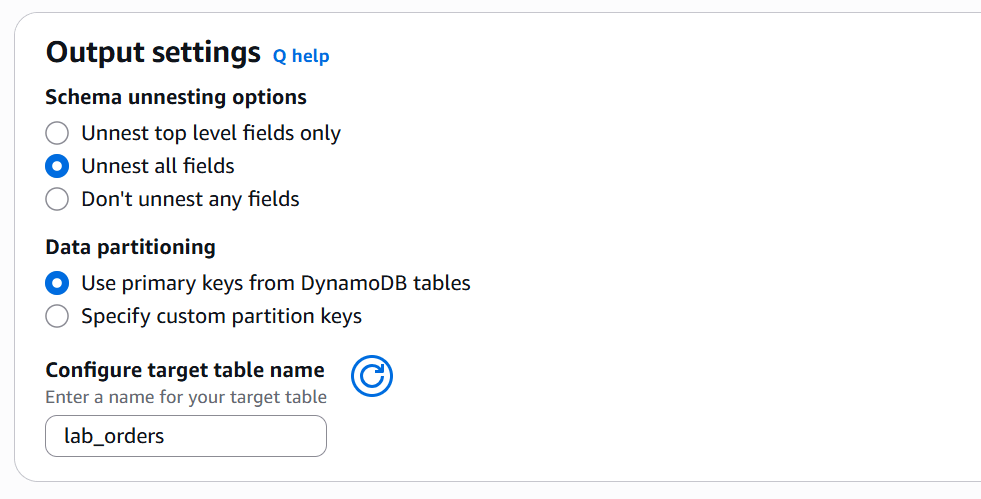
次の設定は以下のとおりです。
- Schema unnesting
- 入れ子のマップなどをどこまで列に展開するかの設定です
- 選択肢は
Unnest top level fields only(最上位の属性のみ展開)、Unnest all fields(入れ子の中身まですべて展開)、Don't unnest any fields(展開しない)の3つです - 既定の
Unnest all fieldsのまま進めました。入れ子のマップがドット区切りの名前のフラットな列に展開されます(詳細は後述)
- Data partitioning
- ターゲットのテーブルをどの列で分割して保存するかの設定です
Use primary keys from DynamoDB tables(DynamoDB のキーを使用)とSpecify custom partition keys(任意の列を指定)の 2 つです
- ターゲットのテーブル名
- ターゲットに作成されるテーブルの名前です。
lab_ordersとしました
- ターゲットに作成されるテーブルの名前です。
ターゲットの設定時に「Fix data catalog resource policy」と表示されました。ターゲットの Glue カタログに、Zero-ETL 統合を受け入れるためのリソースポリシーがない、という内容です。「Fix it for me」を選択した状態で次に進むと AWS Glue が必要なポリシーを自動で設定してくれました。
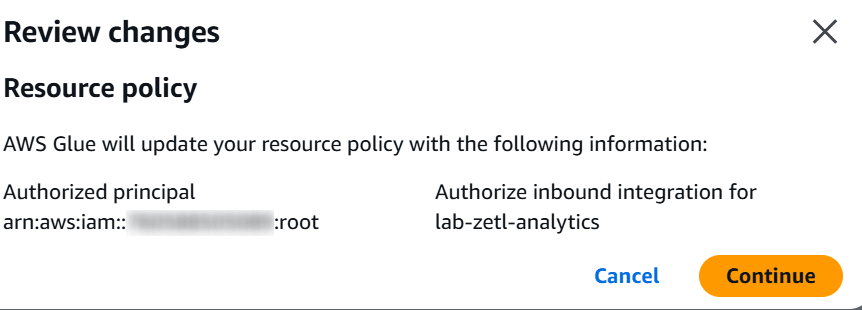
設定後にaws glue get-resource-policyで確認すると、以下のポリシーが作成されていました。
{
  "Version": "2012-10-17",
  "Statement": [
    {
      "Effect": "Allow",
      "Principal": { "AWS": "arn:aws:iam::<アカウントID>:root" },
      "Action": "glue:CreateInboundIntegration",
      "Resource": "arn:aws:glue:ap-northeast-1:<アカウントID>:catalog/s3tablescatalog/lab-zetl-analytics"
    },
    {
      "Effect": "Allow",
      "Principal": { "Service": "glue.amazonaws.com" },
      "Action": "glue:AuthorizeInboundIntegration",
      "Resource": "arn:aws:glue:ap-northeast-1:<アカウントID>:catalog/s3tablescatalog/lab-zetl-analytics"
    }
  ]
}
こちらは、統合受け入れを許可する Glue 側のリソースポリシーです。
さいごに統合に関する設定を行います。
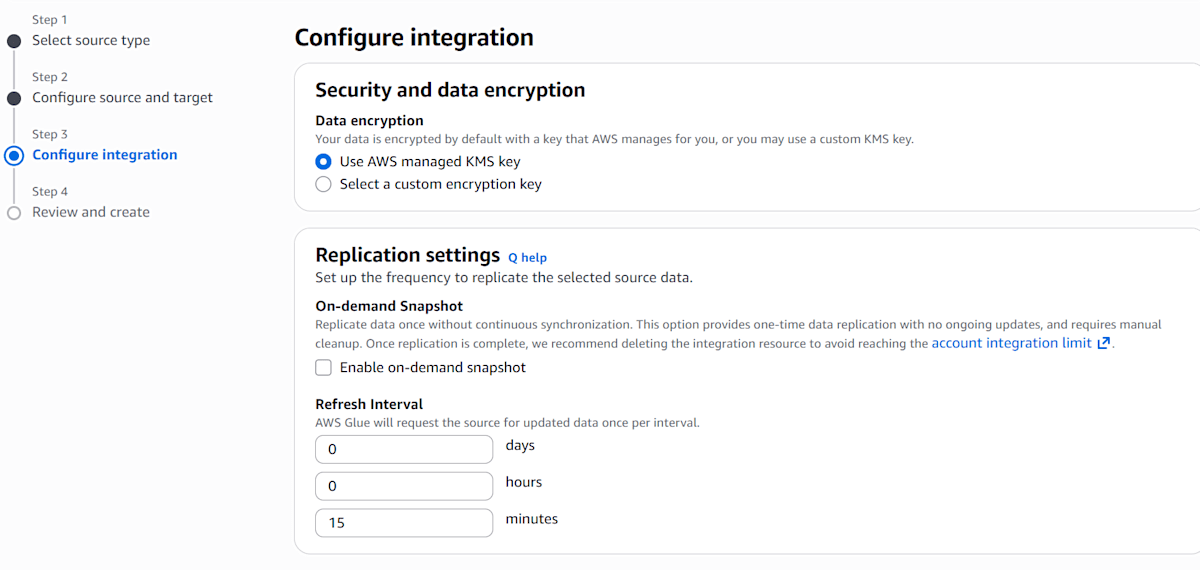
- Data encryption
- データの暗号化に使用する鍵の設定です。既定の
Use AWS managed KMS keyは AWS が管理する鍵で暗号化します Select a custom encryption keyを選ぶと、自分で作成した KMS キーを使用できます。その場合は Glue と処理ロールがそのキーを使用できる権限が必要です
- データの暗号化に使用する鍵の設定です。既定の
- On-demand snapshot
- チェックすると、全量を1回だけコピーして、以降の継続的な同期は行われません。コピーの完了後は統合を削除することが案内されています(アカウントあたりの統合の上限に達しないため)
- 差分同期を確認したいため、今回はチェックしていません
- Refresh Interval
- ソースのターゲットへの更新頻度です。日、時間、分で指定でき最短は 15分です
- ここでは最短の 15分としました
ソース側のポリシーを統合の ARN に絞る
統合の作成後、統合の ARN が分かるので DynamoDB のリソースポリシーを統合の ARN に絞ります。
aws glue describe-integrations --query 'Integrations[].IntegrationArn'
ArnLikeとintegration:*だった条件を、StringEqualsと統合の ARN に差し替えます。差し替え後のポリシー全体は以下のとおりです。
{
  "Version": "2012-10-17",
  "Statement": [
    {
      "Sid": "AllowGlueZeroEtlExport",
      "Effect": "Allow",
      "Principal": {
        "Service": "glue.amazonaws.com"
      },
      "Action": [
        "dynamodb:ExportTableToPointInTime",
        "dynamodb:DescribeTable",
        "dynamodb:DescribeExport"
      ],
      "Resource": "*",
      "Condition": {
        "StringEquals": {
          "aws:SourceAccount": "<アカウントID>",
          "aws:SourceArn": "arn:aws:glue:ap-northeast-1:<アカウントID>:integration:<統合ID>"
        }
      }
    }
  ]
}
上記を/tmp/policy.jsonとして保存し、put-resource-policyで適用しました。
aws dynamodb put-resource-policy \
  --resource-arn arn:aws:dynamodb:ap-northeast-1:<アカウントID>:table/lab-orders \
  --policy file:///tmp/policy.json
初回ロードの確認
統合の作成後、しばらくしてlab_zetlの名前空間とlab_ordersのテーブルが作成されました。名前空間には、Zero-ETL の内部テーブルである zetl_integration_table_stateも作成されます。
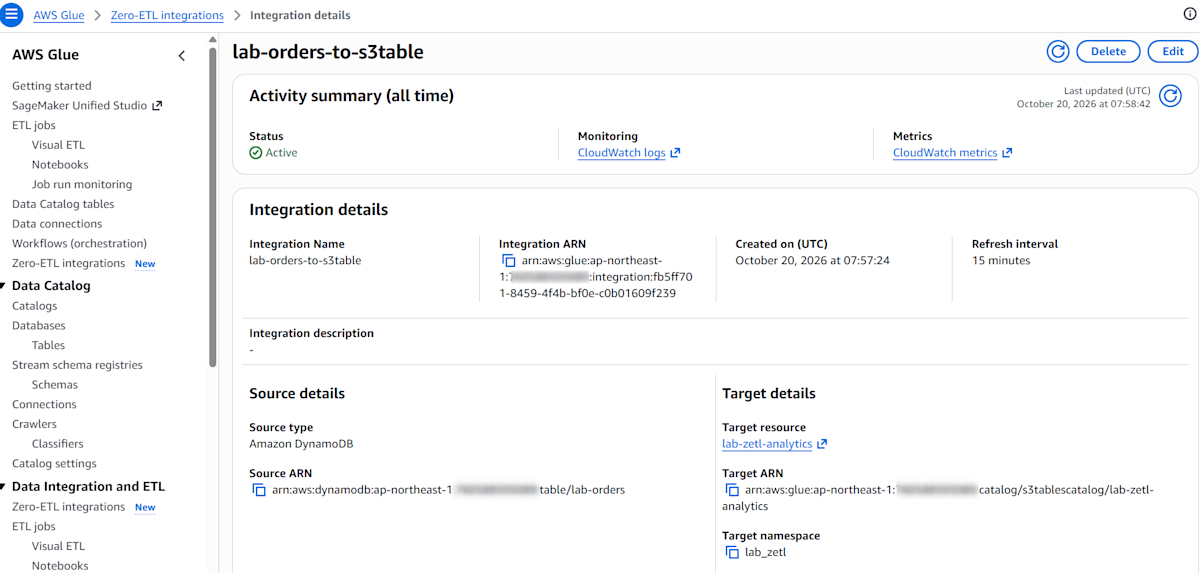
取り込みの状況は、CloudWatch Logs で確認できます。初回ロードのログの一部は以下の通りでした。
{
    "level": "VERBOSE",
    "messageType": "IngestionStarted",
    "details": { "tableName": "lab_orders", "loadType": "SEED", "message": "Successfully started ingestion" }
}
{
    "level": "INFO",
    "messageType": "IngestionTableStatistics",
    "details": { "tableName": "lab_orders", "loadType": "SEED", "insertCount": 1001, "updateCount": 0, "deleteCount": 0 }
}
{
    "level": "VERBOSE",
    "messageType": "IngestionCompleted",
    "details": {
        "tableName": "lab_orders",
        "loadType": "SEED",
        "message": "Successfully completed ingestion",
        "lastSyncedTimestamp": 1792483069544,
        "consumedResourceUnits": "5",
        "consumedDpuHours": "0.2403"
    }
}
loadTypeがSEEDで、初回の全量同期で、開始から完了まで約3分でした。件数もinsertCountが 1001 で DynamoDB の件数(通常の 1,000件と入れ子の 1件)と一致しています。
Athena でも件数を確認してみます。データソースにs3tablescatalog/lab-zetl-analytics、データベースにlab_zetlを選択して実行します。
SELECT COUNT(*) FROM "lab_zetl"."lab_orders";
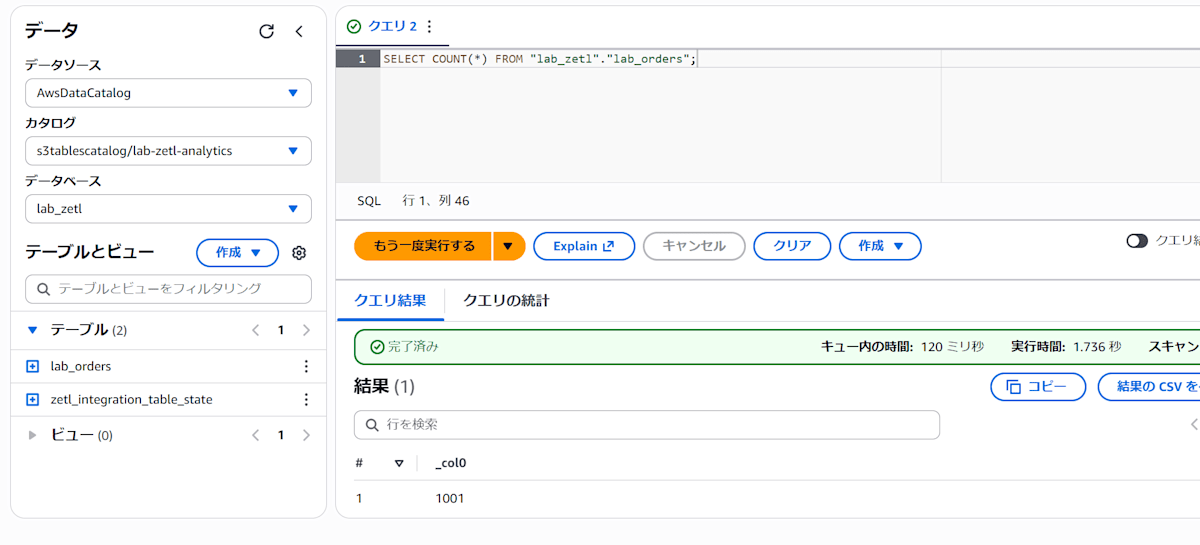
DynamoDB 側の件数と同じ 1,001件が返りました。
型の変換を確認
Athena でDESCRIBEを実行して、列の型を確認していみます。
DESCRIBE lab_zetl.lab_orders;
一部抜粋ですが、結果は以下の通りです。
quantity	double
order_id	string
is_gift	boolean
ordered_at	string
shipping.method	string
tags	array<string>
items	array<string>
shipping.fee	double
mixed_list	array<string>
shipping.address.city	string
discount_rate	double
scores	array<double>
shipping.address.zip	string
DynamoDB のデータ型と Athena・Snowflake での列型の対応は、以下の通りでした。Snowflake 側は後述の手順で確認しています。
| DynamoDB の型 | 属性 | Athena | Snowflake |
|---|---|---|---|
S |
order_id |
string |
VARCHAR(134217728) |
N(整数) |
quantity |
double |
FLOAT |
N(小数) |
discount_rate |
double |
FLOAT |
BOOL |
is_gift |
boolean |
BOOLEAN |
NULL |
gift_note |
列なし | 列なし |
M(入れ子) |
shipping |
フラットな列に展開 | フラットな列に展開 |
L(マップのリスト) |
items |
array<string> |
ARRAY(VARCHAR(134217728)) |
L(型が混在) |
mixed_list |
array<string> |
ARRAY(VARCHAR(134217728)) |
SS(文字列セット) |
tags |
array<string> |
ARRAY(VARCHAR(134217728)) |
NS(数値セット) |
scores |
array<double> |
ARRAY(FLOAT) |
S(日時形式の文字列) |
ordered_at |
string |
VARCHAR(134217728) |
主な特徴は以下の通りです。
- 数値はすべて
doubleになる - 入れ子のマップは、ドット区切りの名前のフラットな列に展開される
例として、order_id がORD-NESTED-0001のshipping(2 階層の入れ子のマップ)を見てみます。
"shipping": {
  "M": {
    "method":  { "S": "宅配便" },
    "fee":     { "N": "500" },
    "address": { "M": { "zip": { "S": "100-0001" }, "city": { "S": "千代田区" } } }
  }
}
この 1 つの属性が、以下の4つの列に展開されます。
SELECT order_id, "shipping.method", "shipping.address.city"
FROM "lab_zetl"."lab_orders"
WHERE order_id = 'ORD-NESTED-0001';
#	order_id	shipping.method	shipping.address.city
1	ORD-NESTED-0001	宅配便	千代田区
shipping のようなマップは、キーが列名の一部になり、shipping.method のように、ドットでつないだ名前の列に展開されます。列名にドットが含まれるため、クエリではダブルクォートで囲みます。
- リストの中の要素は展開されない
こちらも具体例として、マップのリスト(items)と型が混在するリスト(mixed_list)を見てみます。
"items": {
  "L": [
    { "M": { "sku": { "S": "BK-001" }, "qty": { "N": "1" } } },
    { "M": { "sku": { "S": "BK-002" }, "qty": { "N": "1" } } }
  ]
},
"mixed_list": { "L": [ { "S": "a" }, { "N": "1" } ] }
リストの中のマップは展開されず、リストの要素ごとに型記号付きの文字列({"M":{...}} や {"S":"a"})になります。
SELECT order_id,
        items,
        items[1] AS first_item,
        mixed_list
FROM "lab_zetl"."lab_orders"
WHERE order_id = 'ORD-NESTED-0001';
#	order_id	items	first_item	mixed_list
1	ORD-NESTED-0001	[{"M":{"qty":{"N":"1"},"sku":{"S":"BK-001"}}}, {"M":{"qty":{"N":"1"},"sku":{"S":"BK-002"}}}]	{"M":{"qty":{"N":"1"},"sku":{"S":"BK-001"}}}	[{"S":"a"}, {"N":"1"}]
その他集合(SS、NS)は、普通の配列になります。
更新・削除の反映を確認
初回ロード後、DynamoDB のテーブルに更新と削除を行い、差分同期(CDC)の動作を確認します。
更新と削除を実行
サンプルデータのうち、100件のステータスを「配達完了」に更新し、そのうち先頭の50件を削除しました。
同期の完了を確認
15分ほど経過した後、CloudWatch Logs を確認するとloadType が CDC の取り込みが完了していました。
{
    "messageType": "IngestionTableStatistics",
    "details": { "tableName": "lab_orders", "loadType": "CDC", "insertCount": 0, "updateCount": 34, "deleteCount": 50 }
}
{
    "messageType": "IngestionCompleted",
    "details": {
        "tableName": "lab_orders",
        "loadType": "CDC",
        "lastSyncedTimestamp": 1792485042578,
        "consumedResourceUnits": "10",
        "consumedDpuHours": "0.5750"
    }
}
deleteCountは期待どおり50でしたが、updateCount は34でした。
更新対象の 50件のうち、もとから「配達完了」だった項目は 16件ありました。50 − 16 = 34 となり、updateCountと一致するので同じ値への更新は、変更として数えられなかったためと考えられます。
Athena で確認
Athena で、件数とステータス別の件数を確認します。
SELECT COUNT(*) FROM "lab_zetl"."lab_orders";
SELECT status, COUNT(*) FROM "lab_zetl"."lab_orders" GROUP BY status;
status        count
受付          149
キャンセル    182
配達完了      250
出荷済み      202
出荷準備中    168
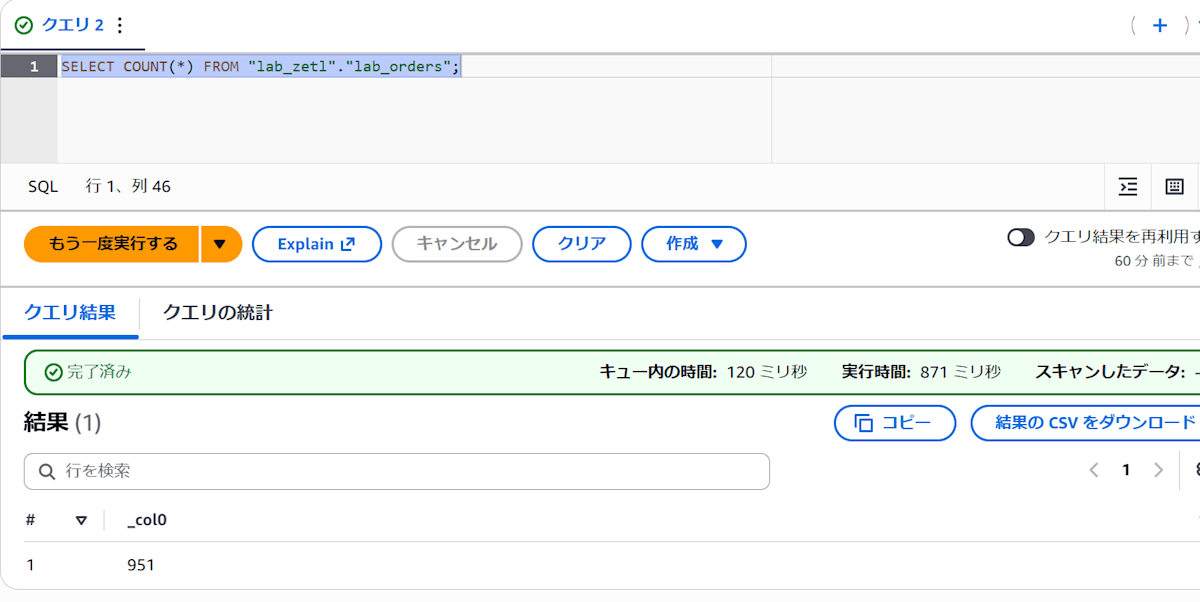
件数は 951件で、ステータス別の合計も 951件でした。
削除した項目と、更新した項目も確認します。
-- 削除した項目:0件になる
SELECT COUNT(*) FROM "lab_zetl"."lab_orders"
WHERE order_id BETWEEN 'ORD-00000000' AND 'ORD-00000049';
#	_col0
1	0
-- 更新した項目:50件、すべて「配達完了」になる
SELECT status, COUNT(*) FROM "lab_zetl"."lab_orders"
WHERE order_id BETWEEN 'ORD-00000050' AND 'ORD-00000099'
GROUP BY status;
#	status	_col1
1	配達完了	50
いずれも期待どおり反映されていることを確認できました。
挿入と新しい属性の追加を確認
続けて、挿入と後から追加した属性の扱いを確認します。DynamoDB で次の変更を実行しました。
| 操作 | 対象 | 内容 |
|---|---|---|
| 更新 | ORD-00000100 |
status を「SF確認」に変更し、新しい属性 updated_at を追加 |
| 挿入 | ORD-SF-0001 |
新しい属性 coupon_code と updated_at を持つ項目 |
| 挿入 | ORD-SF-0002 |
updated_at だけを持つ項目 |
| 削除 | ORD-00000101 |
項目を削除 |
updated_at には、書き込み時刻(UTC)を設定しました。
同期の完了後、Athena で確認します。
DESCRIBE lab_zetl.lab_orders;
一部抜粋ですが、出力は以下の通りとなり、新しい属性の列が自動で追加されました。列は末尾に追加され、型は文字列でした。
...
coupon_code	string
updated_at	string
レコードも確認します。
SELECT order_id, status, updated_at, coupon_code
FROM "lab_zetl"."lab_orders"
WHERE order_id IN ('ORD-00000100', 'ORD-00000101', 'ORD-SF-0001', 'ORD-SF-0002')
ORDER BY order_id;
order_id        status    updated_at            coupon_code
ORD-00000100    SF確認    2026-10-20T09:16:52Z
ORD-SF-0001     受付      2026-10-20T09:16:52Z  WELCOME10
ORD-SF-0002     受付      2026-10-20T09:16:52Z
上記の通り、更新(ORD-00000100 が「SF確認」)、挿入(ORD-SF-0001、ORD-SF-0002)、削除(ORD-00000101 の行がない)がすべて反映されていました。coupon_code を持たない項目はNULLになります。
Snowflake から参照
ここまでで、S3 Tables にテーブルが同期されました。同じテーブルを Snowflake からも参照できるか確認します。
2026年10時点で S3 Tables の Iceberg REST エンドポイントに Snowflake から直接接続する機能が一般提供となっているので、このエンドポイント経由で接続してみます。この方法では、Glue を経由せず、SigV4 認証と Vended credentials で S3 Tables に接続します。
IAM ロールを作成
Snowflake が S3 Tables にアクセスするための IAM ロールを作成します。Snowflake 側の IAM ユーザーの ARN と external ID は、統合作成後に更新します。
ここでは読み取りに必要な権限だけを付与しました。
{
  "Version": "2012-10-17",
  "Statement": [
    {
      "Effect": "Allow",
      "Action": [
        "s3tables:GetTableBucket",
        "s3tables:ListNamespaces",
        "s3tables:GetNamespace",
        "s3tables:ListTables",
        "s3tables:GetTable",
        "s3tables:GetTableMetadataLocation",
        "s3tables:GetTableData"
      ],
      "Resource": [
        "arn:aws:s3tables:ap-northeast-1:<アカウントID>:bucket/lab-zetl-analytics",
        "arn:aws:s3tables:ap-northeast-1:<アカウントID>:bucket/lab-zetl-analytics/table/*"
      ]
    }
  ]
}
カタログ統合を作成
Snowflake 側でカタログ統合を作成します。
USE ROLE ACCOUNTADMIN;

CREATE OR REPLACE CATALOG INTEGRATION lab_s3tables_int
  CATALOG_SOURCE = ICEBERG_REST
  TABLE_FORMAT = ICEBERG
  REST_CONFIG = (
    CATALOG_URI = 'https://s3tables.ap-northeast-1.amazonaws.com/iceberg'
    CATALOG_API_TYPE = AWS_S3TABLES
    ACCESS_DELEGATION_MODE = VENDED_CREDENTIALS
    CATALOG_NAME = 'arn:aws:s3tables:ap-northeast-1:<アカウントID>:bucket/lab-zetl-analytics'
  )
  REST_AUTHENTICATION = (
    TYPE = SIGV4
    SIGV4_IAM_ROLE = 'arn:aws:iam::<アカウントID>:role/lab-zetl-snowflake-role'
    SIGV4_SIGNING_REGION = 'ap-northeast-1'
  )
  ENABLED = TRUE;
DESCRIBE CATALOG INTEGRATIONを実行して、IAM ユーザーの ARN と external ID を確認します。
DESCRIBE CATALOG INTEGRATION lab_s3tables_int;
信頼ポリシーを差し替え
上記の手順で控えた2つの値を、IAM ロールの信頼ポリシーに設定します。
{
  "Version": "2012-10-17",
  "Statement": [
    {
      "Effect": "Allow",
      "Principal": { "AWS": "<Snowflake の IAM ユーザー ARN>" },
      "Action": "sts:AssumeRole",
      "Condition": {
        "StringEquals": { "sts:ExternalId": "<external ID>" }
      }
    }
  ]
}
カタログ連携データベースを作成
名前空間lab_zetlだけを対象に、カタログリンクデータベースを作成します。
CREATE OR REPLACE DATABASE lab_zetl_db
  LINKED_CATALOG = (
    CATALOG = 'lab_s3tables_int'
    ALLOWED_NAMESPACES = ('lab_zetl')
  );
テーブルを確認
> SHOW SCHEMAS IN DATABASE lab_zetl_db;
+-------------------------------+--------------------+------------+------------+---------------+--------------+-----------------------------------------------------------+---------+----------------+-----------------+---------------------------------+-------------------------------+------------------------+-------------------+-----------+
| created_on                    | name               | is_default | is_current | database_name | owner        | comment                                                   | options | retention_time | owner_role_type | classification_profile_database | classification_profile_schema | classification_profile | object_visibility | is_nested |
|-------------------------------+--------------------+------------+------------+---------------+--------------+-----------------------------------------------------------+---------+----------------+-----------------+---------------------------------+-------------------------------+------------------------+-------------------+-----------|
| 2026-10-20 18:09:09.943 +0900 | INFORMATION_SCHEMA | N          | N          | LAB_ZETL_DB   |              | Views describing the contents of schemas in this database |         | 7              |                 | NULL                            | NULL                          | NULL                   | NULL              | false     |
| 2026-10-20 18:09:00.958 +0900 | lab_zetl           | N          | N          | LAB_ZETL_DB   | ACCOUNTADMIN |                                                           |         | 7              | ROLE            | NULL                            | NULL                          | NULL                   | NULL              | false     |
+-------------------------------+--------------------+------------+------------+---------------+--------------+-----------------------------------------------------------+---------+----------------+-----------------+---------------------------------+-------------------------------+------------------------+-------------------+-----------+

> SHOW ICEBERG TABLES IN SCHEMA lab_zetl_db."lab_zetl";
SHOW SCHEMAS IN DATABASE lab_zetl_db;
+-------------------------------+--------------------+------------+------------+---------------+--------------+-----------------------------------------------------------+---------+----------------+-----------------+---------------------------------+-------------------------------+------------------------+-------------------+-----------+
| created_on                    | name               | is_default | is_current | database_name | owner        | comment                                                   | options | retention_time | owner_role_type | classification_profile_database | classification_profile_schema | classification_profile | object_visibility | is_nested |
|-------------------------------+--------------------+------------+------------+---------------+--------------+-----------------------------------------------------------+---------+----------------+-----------------+---------------------------------+-------------------------------+------------------------+-------------------+-----------|
| 2026-10-20 18:09:09.943 +0900 | INFORMATION_SCHEMA | N          | N          | LAB_ZETL_DB   |              | Views describing the contents of schemas in this database |         | 7              |                 | NULL                            | NULL                          | NULL                   | NULL              | false     |
| 2026-10-20 18:09:00.958 +0900 | lab_zetl           | N          | N          | LAB_ZETL_DB   | ACCOUNTADMIN |                                                           |         | 7              | ROLE            | NULL                            | NULL                          | NULL                   | NULL              | false     |
+-------------------------------+--------------------+------------+------------+---------------+--------------+-----------------------------------------------------------+---------+----------------+-----------------+---------------------------------+-------------------------------+------------------------+-------------------+-----------+

SHOW ICEBERG TABLES IN SCHEMA lab_zetl_db."lab_zetl";
+-------------------------------+------------------------------+---------------+-------------+--------------+----------------------+------------------+--------------------+------------------------------+-------------------+---------------+--------------------+---------+-----------------+--------------+-------------------+-------------------------------------------------------------------------------------------------------------------------------------------------+------------------+---------------------------+------------------------------+
| created_on                    | name                         | database_name | schema_name | owner        | external_volume_name | catalog_name     | iceberg_table_type | catalog_table_name           | catalog_namespace | base_location | can_write_metadata | comment | owner_role_type | name_mapping | catalog_sync_name | auto_refresh_status                                                                                                                             | partition_specs  | current_partition_spec_id | iceberg_table_format_version |
|-------------------------------+------------------------------+---------------+-------------+--------------+----------------------+------------------+--------------------+------------------------------+-------------------+---------------+--------------------+---------+-----------------+--------------+-------------------+-------------------------------------------------------------------------------------------------------------------------------------------------+------------------+---------------------------+------------------------------|
| 2026-10-20 18:09:02.741 +0900 | lab_orders                   | LAB_ZETL_DB   | lab_zetl    | ACCOUNTADMIN | <invalid>            | LAB_S3TABLES_INT | UNMANAGED          | lab_orders                   | lab_zetl          | NULL          | Y                  |         | ROLE            | NULL         |                   | {"currentSnapshotId":null,"lastSnapshotTime":null,"pendingSnapshotCount":0,"executionState":"RUNNING","lastUpdatedTime":"1970-01-01T00:00:00Z"} | [ {              |                         0 |                            2 |
|                               |                              |               |             |              |                      |                  |                    |                              |                   |               |                    |         |                 |              |                   |                                                                                                                                                 |   "spec-id" : 0, |                           |                              |
|                               |                              |               |             |              |                      |                  |                    |                              |                   |               |                    |         |                 |              |                   |                                                                                                                                                 |   "fields" : [ ] |                           |                              |
|                               |                              |               |             |              |                      |                  |                    |                              |                   |               |                    |         |                 |              |                   |                                                                                                                                                 | } ]              |                           |                              |
| 2026-10-20 18:09:02.741 +0900 | zetl_integration_table_state | LAB_ZETL_DB   | lab_zetl    | ACCOUNTADMIN | <invalid>            | LAB_S3TABLES_INT | UNMANAGED          | zetl_integration_table_state | lab_zetl          | NULL          | Y                  |         | ROLE            | NULL         |                   | {"currentSnapshotId":null,"lastSnapshotTime":null,"pendingSnapshotCount":0,"executionState":"RUNNING","lastUpdatedTime":"1970-01-01T00:00:00Z"} | [ {              |                         0 |                            2 |
|                               |                              |               |             |              |                      |                  |                    |                              |                   |               |                    |         |                 |              |                   |                                                                                                                                                 |   "spec-id" : 0, |                           |                              |
|                               |                              |               |             |              |                      |                  |                    |                              |                   |               |                    |         |                 |              |                   |                                                                                                                                                 |   "fields" : [ ] |                           |                              |
|                               |                              |               |             |              |                      |                  |                    |                              |                   |               |                    |         |                 |              |                   |                                                                                                                                                 | } ]              |                           |                              |
+-------------------------------+------------------------------+---------------+-------------+--------------+----------------------+------------------+--------------------+------------------------------+-------------------+---------------+--------------------+---------+-----------------+--------------+-------------------+-------------------------------------------------------------------------------------------------------------------------------------------------+------------------+---------------------------+------------------------------+
件数と、ステータス別の件数を確認してみます。
USE WAREHOUSE <ウェアハウス名>;

> SELECT COUNT(*) FROM lab_zetl_db."lab_zetl"."lab_orders";
+----------+
| COUNT(*) |
|----------|
|      951 |
+----------+

SELECT "status", COUNT(*)
FROM lab_zetl_db."lab_zetl"."lab_orders"
GROUP BY "status";
+------------+----------+
| status     | COUNT(*) |
|------------+----------|
| 出荷済み   |      202 |
| 配達完了   |      250 |
| 出荷準備中 |      168 |
| 受付       |      149 |
| キャンセル |      182 |
+------------+----------+
件数、ステータス別の件数とも、Athena の結果と一致しました。
列の型は上述の表の通りでした。
DESCRIBE TABLE lab_zetl_db."lab_zetl"."lab_orders";
参考まにitemsの要素が DynamoDB JSON の文字列のままである点も Athena と同じでした。
SELECT "order_id", "shipping.method", "shipping.address.city", "tags", "scores", "items"
FROM lab_zetl_db."lab_zetl"."lab_orders"
WHERE "order_id" = 'ORD-NESTED-0001';
+-----------------+-----------------+-----------------------+-------------+--------------------------+-----------------------------------------------------------------+
| order_id        | shipping.method | shipping.address.city | tags        | scores                   | items                                                           |
|-----------------+-----------------+-----------------------+-------------+--------------------------+-----------------------------------------------------------------|
| ORD-NESTED-0001 | 宅配便          | 千代田区              | [           | [                        | [                                                               |
|                 |                 |                       |   "ギフト", |   2.500000000000000e+00, |   "{\"M\":{\"qty\":{\"N\":\"1\"},\"sku\":{\"S\":\"BK-001\"}}}", |
|                 |                 |                       |   "急ぎ"    |   1.000000000000000e+00  |   "{\"M\":{\"qty\":{\"N\":\"1\"},\"sku\":{\"S\":\"BK-002\"}}}"  |
|                 |                 |                       | ]           | ]                        | ]                                                               |
+-----------------+-----------------+-----------------------+-------------+--------------------------+-----------------------------------------------------------------+
先の更新・挿入・削除の後、Athena と同じ時刻に Snowflake でも確認しましたが、新しい列 coupon_codeとupdated_atも追加されていました。
SELECT "order_id", "status", "updated_at", "coupon_code"
FROM lab_zetl_db."lab_zetl"."lab_orders"
WHERE "order_id" IN ('ORD-00000100', 'ORD-00000101', 'ORD-SF-0001', 'ORD-SF-0002')
ORDER BY "order_id";
+--------------+--------+----------------------+-------------+
| order_id     | status | updated_at           | coupon_code |
|--------------+--------+----------------------+-------------|
| ORD-00000100 | SF確認 | 2026-10-20T09:16:52Z | NULL        |
| ORD-SF-0001  | 受付   | 2026-10-20T09:16:52Z | WELCOME10   |
| ORD-SF-0002  | 受付   | 2026-10-20T09:16:52Z | NULL        |
+--------------+--------+----------------------+-------------+
Snowflake 側の追加も遅延は、確認した範囲では大きくありませんでした。ただし、Snowflake のカタログ統合の REFRESH_INTERVAL_SECONDS はデフォルトの30秒としてます。
さいごに
DynamoDB の Zero-ETL 統合を、S3 Tables のカタログをターゲットにして確認しました。
初回の全量同期、更新・削除・挿入の差分同期、型の変換を確認し、同じテーブルを Athena と Snowflake の両方から参照できました。15分という更新頻度が問題なければ、一つの連携手法として構築・運用不要で利用できる点は特徴と思います。
こちらの内容がどなたかの参考になれば幸いです。