[セッションレポート] 複数ドメインを一つのアプリに統合するFlutterの設計と運用
こんにちは、クラスメソッドのたじまです!
本日はFlutterKaigi2026で聴講した「複数ドメインを一つのアプリに統合するFlutterの設計と運用」というセッションについてお届けします!
セッション概要
タイトル: 複数ドメインを一つのアプリに統合するFlutterの設計と運用
登壇者: 須永 高弘さん(株式会社アサイン)
キャリア支援を行うアプリで、新卒向けと中途向けに分かれていた機能を一つのアプリに統合した事例についてのセッションでした。
セッションでは大きく以下の内容が紹介されました。
- 統合に向けた設計(変更しやすく、並行開発を止めない設計)
- 開発の進め方(トランクベース開発・フィーチャーフラグ)
- 統合後の運用(エラーの出し分け・パフォーマンス計測・離脱分析)
設計方針
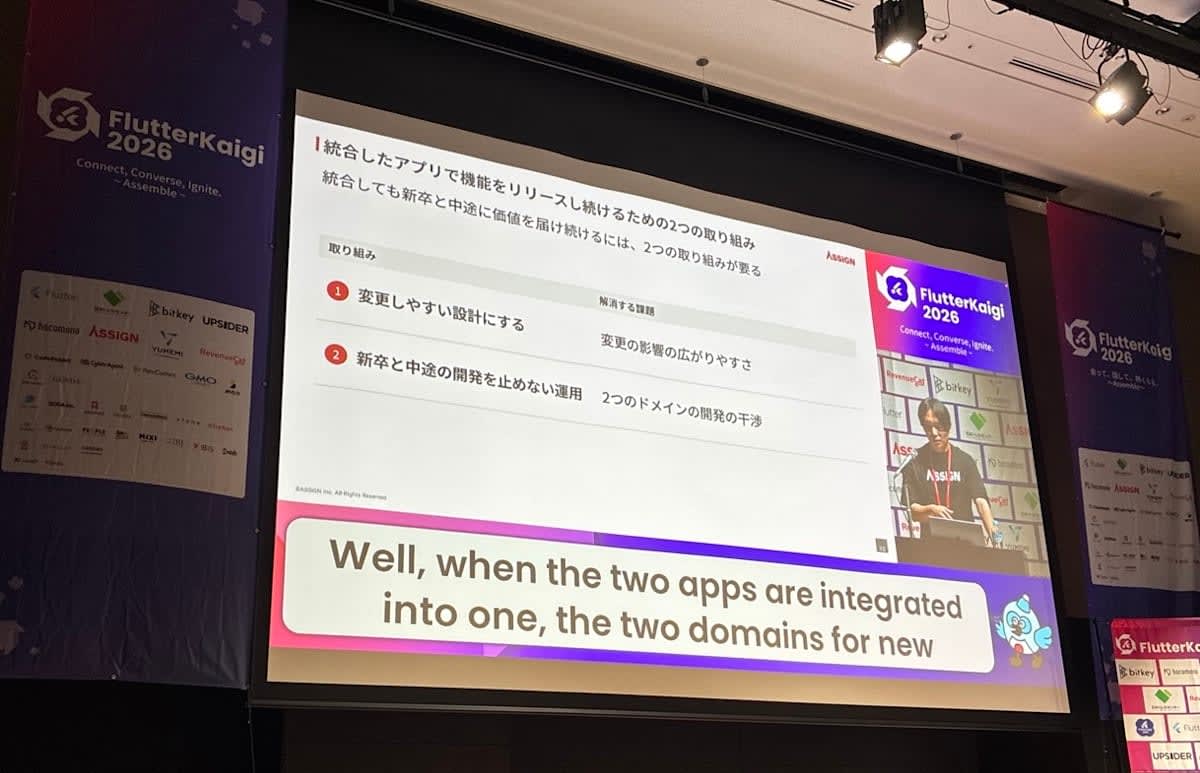
本セッションでは、統合したアプリで機能をリリースし続けるために、次の2つの取り組みが掲げられていました。
- 変更しやすい設計にする
- 新卒と中途の開発を止めない運用
既存の構成では、一箇所の変更がどこまで影響するのかが読みづらいという課題があったそうです。
MVVM から責務によるレイヤー分割へ
統合前のアプリでは MVVM で作られていましたが、ViewModel の責務が曖昧になっており、
認証や未読管理などの役割の違う処理がまとめて書かれていたため、一箇所を修正すると別の画面まで影響が出てしまう状況になってしまっていたそうです。
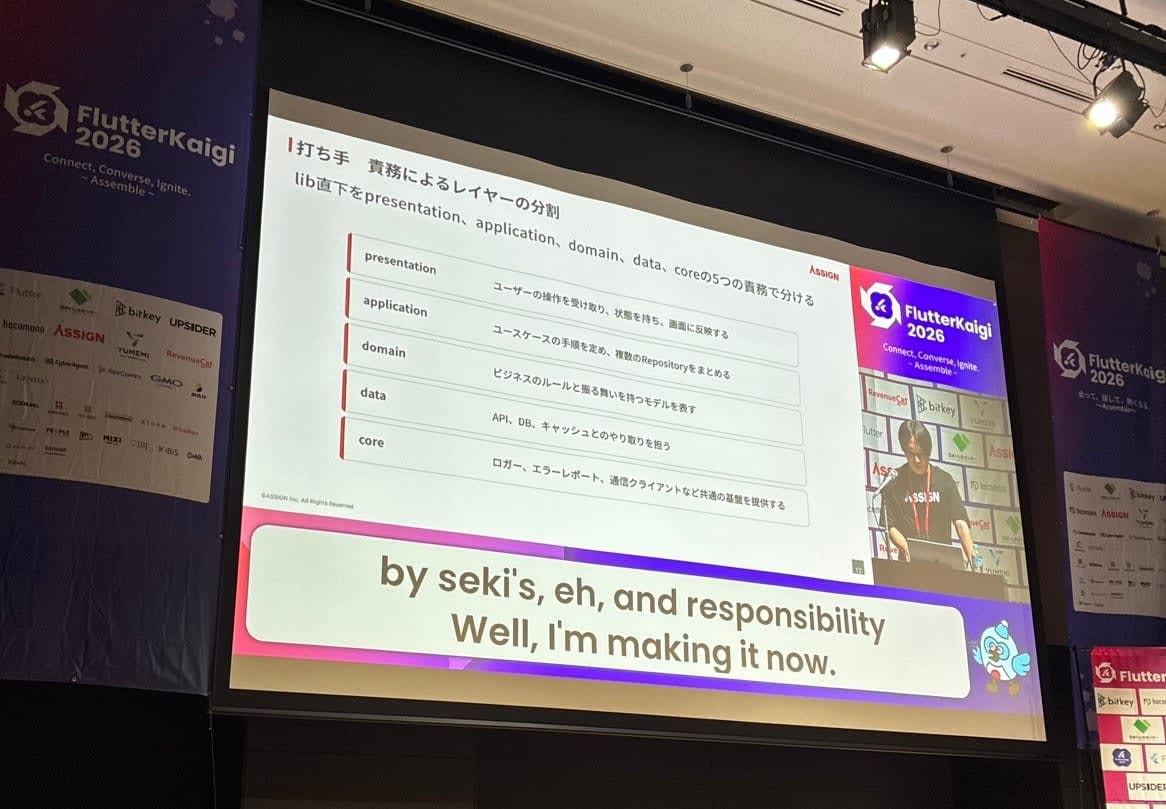
そこで DDD の考え方を取り入れ、lib 直下を次の5つの責務で分けたとのことでした。
| レイヤー | 責務 |
|---|---|
| presentation | ユーザーの操作を受け取り、状態を持ち、画面に反映する |
| application | ユースケースの手順を定め、複数の Repository をまとめる |
| domain | ビジネスのルールと振る舞いを持つモデルを表す |
| data | API、DB、キャッシュとのやり取りを担う |
| core | ロガー、エラーレポート、通信クライアントなど共通の基盤を提供する |
lint によるレイヤー境界の検査
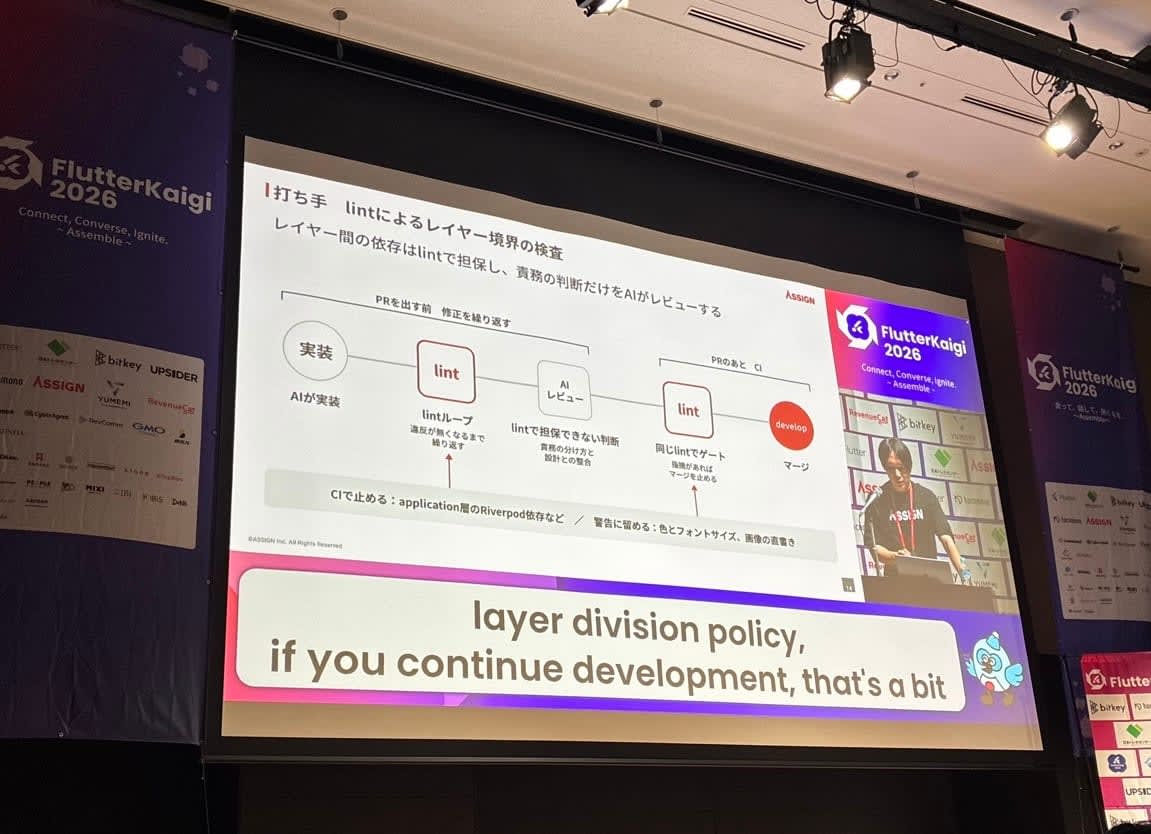
各レイヤー間の依存は lint で担保し、責務の判断だけを AI がレビューするという仕組みになっていました。
- PR を出す前:AI が実装 → lint の違反がなくなるまで修正を繰り返す → lint で担保できない判断(責務の分け方と設計との整合)を AI がレビュー
- PR のあと(CI):同じ lint でゲートし、指摘があればマージを止める
- CI で止めるもの:application 層の Riverpod 依存など
- 警告に留めるもの:色とフォントサイズ、画像の直書き
開発の進め方:トランクベース開発とフィーチャーフラグ
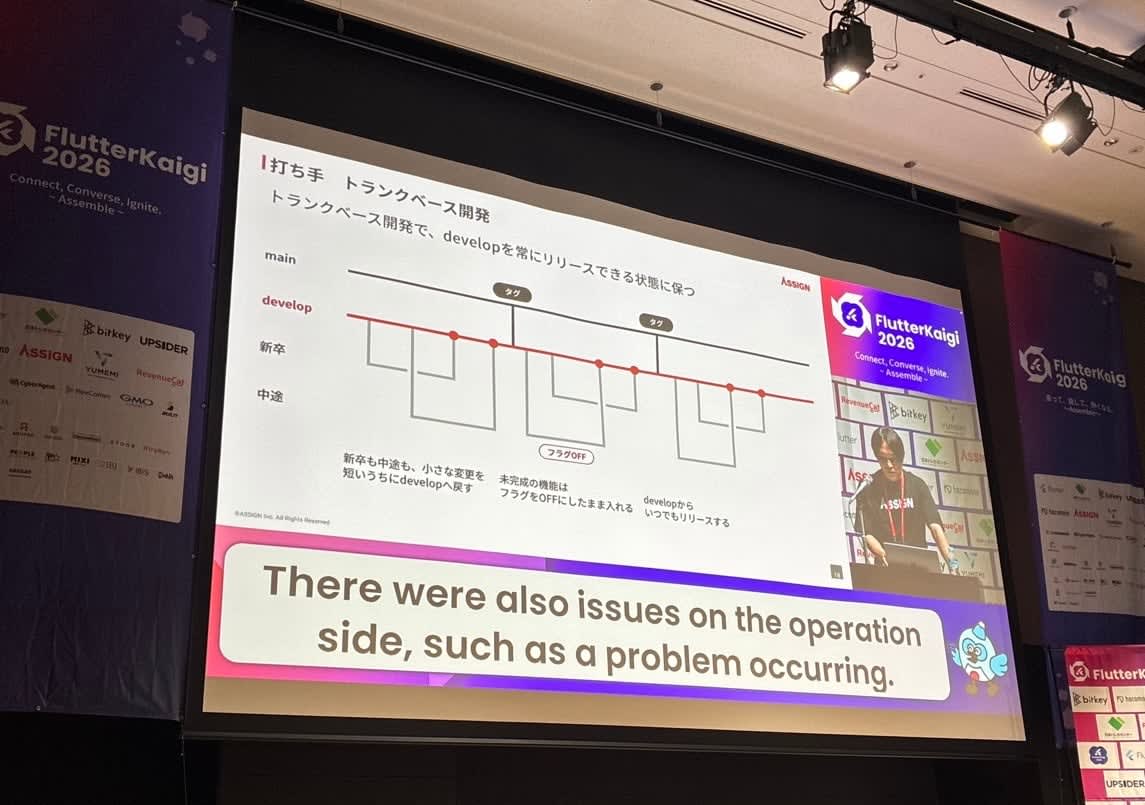
開発プロセスについては、トランクベース開発で develop を常にリリースできる状態に保っているそうです。
- 新卒も中途も、小さな変更を短いうちに develop へ戻す
- 未完成の機能はフラグを OFF にしたまま入れる
- develop からいつでもリリースする
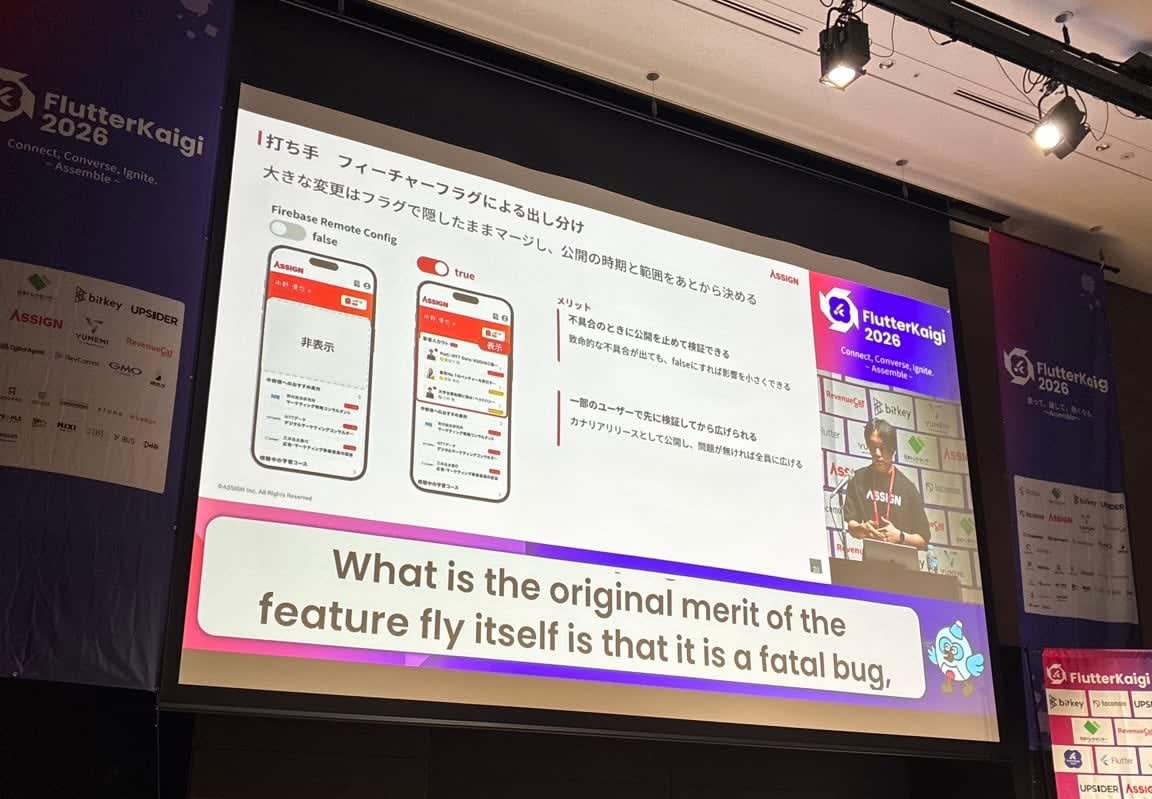
大きな変更は フィーチャーフラグ(Firebase Remote Config で管理)で隠したままマージし、公開の時期と範囲をあとから決めます。メリットとして以下が挙げられていました。
- 不具合のときに公開を止めて検証できる
- 一部のユーザーで先に検証してから広げられる
運用①:新卒・中途でエラーの出し分け
統合後の運用で難しかったのがエラーの扱いとのことです。
同じ機能でも、新卒と中途では API から返ってくるエラーが異なるため、エラーの出し分けが難しかったそうです。
これに対して以下のような対応をしていました。
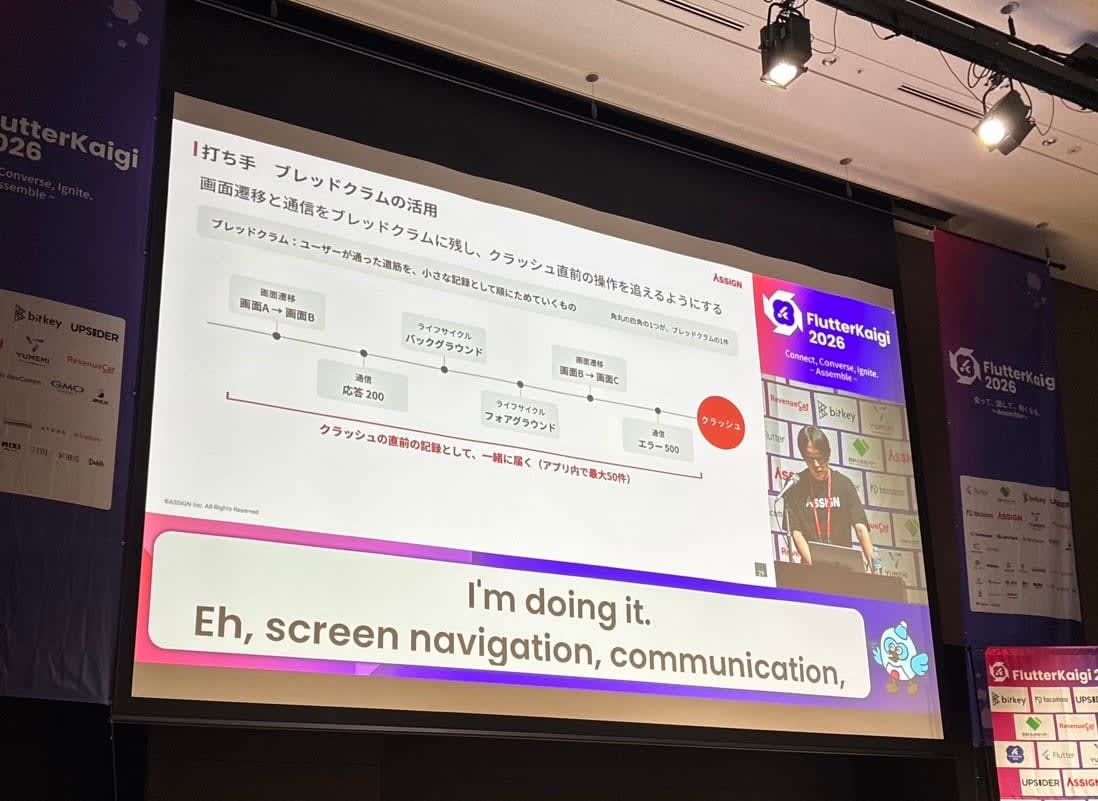
- ブレッドクラムを活用して、エラーに至るまでの経緯を追えるようにする
- エラーを3つに分類して扱う
- Firebase Analytics には、エラーをステータスコード帯(200番台 / 400番台 / 500番台)で分類して送信し、まとめて振り返れるようにする
- Firebase Crashlytics には、修正が必要なものだけを送る
- 例えば 404 は正常な応答として扱い、Crashlytics には送らない
ブレッドクラムで画面遷移・通信・ライフサイクルなどを記録し、クラッシュ直前の記録として一緒に送ることで、クラッシュ直前の操作を追えるようにしているそうです。
運用②:快適に操作できているかの検査
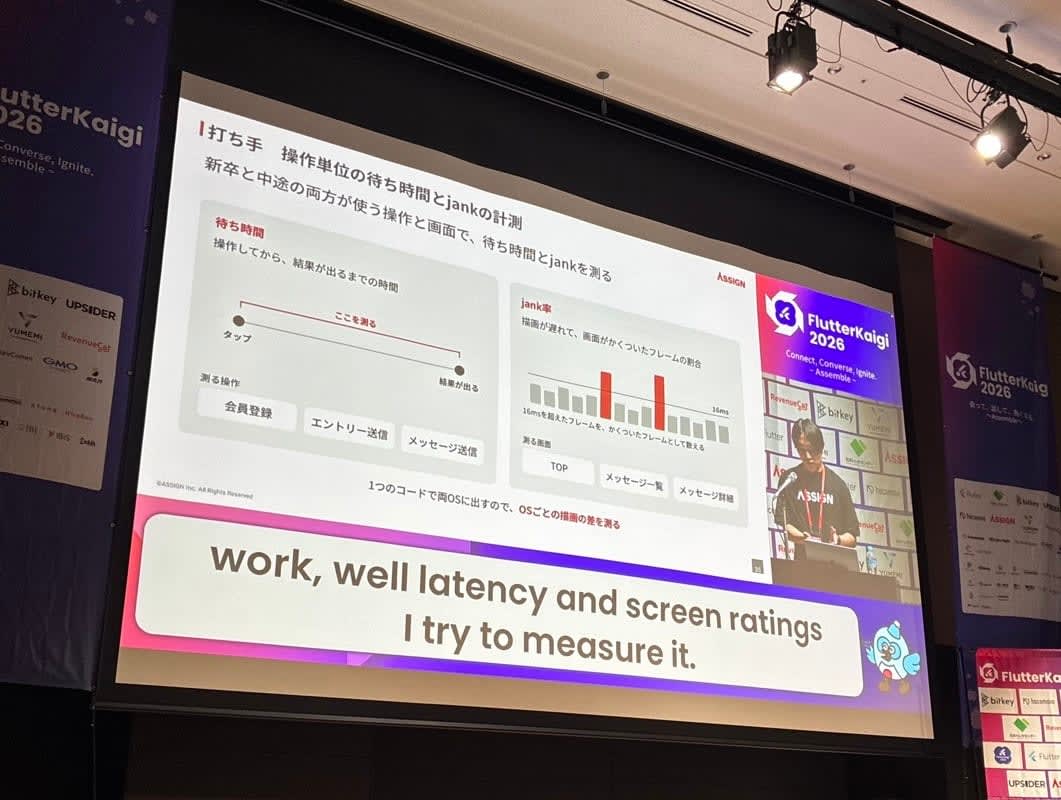
ユーザーが快適に操作できているかを確認するために、新卒と中途の両方が使う操作と画面で、待ち時間と jank(画面のカクつき)を計測していました。
- 待ち時間:タップしてから結果が出るまでの時間(会員登録、エントリー送信、メッセージ送信など)
- jank 率:フレームごとの描画時間を受け取り、16ms を超えたフレームをカクついたフレームとして数える(TOP、メッセージ一覧、メッセージ詳細など)
1つのコードで両 OS に出しているので、OS ごとの描画の差も測っているそうです。
この計測から、次の改善点が Android の jank だということが特定できたとのことです。
運用③:ユーザーが離脱した原因
同じ画面に新卒・中途の両方を実装しているため、ある画面から離脱が発生しても、どちらのユーザーがなぜ離れたのかがわからないという課題もあったそうです。
これに対しては、画面を移るたびに画面名を送り、1回の利用の中で画面が移った順を見られるようにしていました。
またレポートの画面や求人の画面などの縦に長い画面は、セクション単位でイベントを送信し、ユーザーの属性ごとに集計することで、どこまで読まれたかということを計測可能にしているとのことでした。
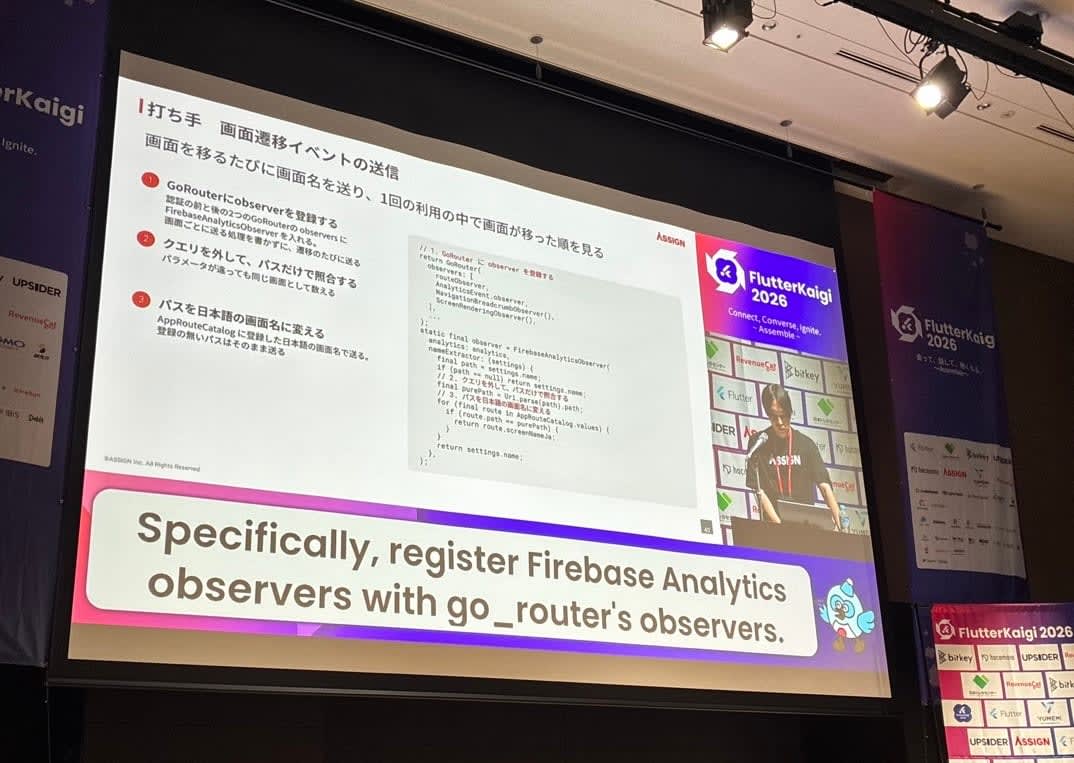
これらの計測から、ダイアログのコミュニケーションがボトルネックということが特定でき、その再設計に進むことができたとのことです。
感想
本セッションでは、「変更しやすさ」「並行開発を止めない」という方針から、アーキテクチャ・開発フロー・監視まで一貫して説明されていて、とてもわかりやすいセッションでした。
特に、レイヤー境界を lint で機械的に守り、責務の判断だけを AI にレビューさせる分担は、AI 活用が進む中で非常に勉強になりました。
また、エラーを Analytics と Crashlytics で役割分担させる話や、jank を検査する話も、統合案件に限らずどの Flutter アプリでも取り入れられそうだと感じました。