AI エージェントの並列開発で膨らんだ GitHub Actions の費用を、AWS Fargate のセルフホストランナーに移して約3割削減した話

リテールアプリ共創部のるおんです。
最近、社内のプロダクト開発を、 私1人と、クラウドで並列に動かしている Claude Code で進めています。実装・テスト・プルリクエストまでをエージェントに任せるので、 プルリクエストが人の手の何倍ものペースで出てきます 。8月は1日10本ほどだったのが、10月の上旬には、1人で 1日90本 を超えました。
開発が速くなったのはうれしいのですが、その裏で GitHub Actions の費用 が膨らみました。プルリクエストが増えるたびに CI が回り、しかもエージェントがテストを書き足していくので、1回の CI で回るテストも増えていきます。さらに、並列で進めていると、同じファイルを触るプルリクエスト同士で コンフリクト も起きがちです。そのたびに main を取り込み直して push するので、同じプルリクエストで CI がもう一度走ります。結果として、社内の GitHub の組織全体の Actions の予算を使い切り、 組織のすべてのリポジトリの CI が止まる ところまでいきました。社内の管理部門からも何度か連絡をもらいました。
そこで、開発リポジトリの CI を、GitHub がホストするランナーから、 AWS Fargate で動くセルフホストランナー に移しました。この記事では、移した仕組み(AWS CDK の構成)と、移す前と後で費用がどう変わったかを、 GitHub の請求の明細と AWS の請求の実数値 で比べてみます。
先に結論
- 費用が膨らんだ原因は、AI エージェントの並列開発によって、 プルリクエストが1日90本ほど 出るようになったことです(8月は1日10本ほど)
- CI を Fargate(ARM・2 vCPU)のセルフホストランナー に移したところ、 同じ量の CI を回す費用が、1分あたり0.0054ドル → 0.0036ドル(約3割減) になりました(AWS 側も定価で計算)
- 前後でプルリクエストの数や CI の中身(改善済み)が違うので、1日の費用(52.0ドル → 32.0ドル)をそのまま比べず、 CI 1分あたりの費用 で比べています
- クラスメソッドでは AWS の Compute Savings Plans を使っているので、Fargate に割引が効き、実質では 1分あたり0.0054ドル → 0.0024ドル(5割以上減) まで下がりました
- 実行する機械の単価だけで見ると、GitHub のホストランナーの 0.005〜0.006ドル/分 に対して、Fargate は 約0.003ドル/分 でした
- ランナーは 1つのジョブごとに Fargate のタスクを1つ立てて、終わったら捨てる 作りです。GitHub の JIT(Just-in-time)ランナー を使っています
| 項目 | 移す直前(9/30〜10/8) | 移した後(10/11〜10/22) |
|---|---|---|
| GitHub Actions の費用 | 52.0ドル/日 | 10.5ドル/日 |
| Fargate の費用(定価) | — | 20.6ドル/日 |
| 通信・パブリック IP | — | 約1.0ドル/日 |
| 合計 | 52.0ドル/日 | 約32.0ドル/日 |
| CI 1分あたりの費用 | 0.0054ドル | 0.0036ドル(−34%) |
| CI 1分あたりの費用(Savings Plans 適用後) | 0.0054ドル | 0.0024ドル(−55%) |
開発の体制:ローカルのリーダー1台と、クラウドのエージェント十数台
前提として、どういう体制でプルリクエストが1日90本も出ていたのかを書いておきます。
- ローカルに Claude Code を1台だけ立てて「リーダー」にしています 。リーダーは設計・判断・発注・レビュー・マージを受け持ち、自分では実装しません
- 実装はクラウドの Claude Code に任せています 。Claude Code の ルーチン(routines。ドキュメントでは現在、スケジュールされたタスクと呼ばれています) を十数台用意しておき、リーダーが GitHub の Issue のコメントに発注書を書いて、ルーチンを起動します。ルーチンはクラウドの中でリポジトリをチェックアウトし、実装・テスト・レビューまで回して、プルリクエストを出します
- 私がやるのは、リーダーとの相談と判断だけ です。どの機能を作るか、設計のどちらを選ぶか、を決めると、あとはリーダーがルーチンに割り振って並列に進めます
この形は、Claude Code の Projects (1つの会話の中で、Claude がクラウドのセッションを並列に配って作業を進める機能)を、ローカルのリーダーと GitHub の Issue で自前で組んだようなものです。
それでも自前の形を続けているのは、 複数のアカウントを切り替えて使う ことがあるからです。Projects の会話は claude.ai のアカウントの中にあるので、アカウントを切り替えると、リーダーの会話(それまでの判断の経緯)から離れてしまいます。ローカルのリーダーなら、会話も記憶もディスクに残り、発注書と各ルーチンの報告は GitHub の Issue に残るので、 どのアカウントのルーチンを使っても、リーダーは文脈を失わずに続けられます 。また、2026年10月時点では Projects は Team / Enterprise プランでは提供されていません。
この形にすると、 人1人でも、十数本の作業が同時に進みます 。ルーチンは私の PC の外で動くので、手元の PC が重くなることもありません。その代わり、プルリクエストが出るたびに GitHub Actions の CI が走るので、 CI の量は「人数」ではなく「並べたエージェントの数」に比例して増えていきます 。
何が起きていたか
プルリクエストが1日90本になった
対象の開発リポジトリは3つです。月ごとのプルリクエストの数はこうなっていました。
| 月 | プルリクエスト | うちマージ |
|---|---|---|
| 7月 | 13 | 13 |
| 8月 | 309 | 290 |
| 9月 | 1,076 | 1,054 |
| 10月(22日まで) | 1,675 | 1,621 |
AI エージェントを並べるほど、プルリクエストはこのペースで増えていきます。プルリクエストが出るたびに CI が走るので、 CI の量はプルリクエストの本数に比例して増えます 。しかもエージェントは実装のたびにテストを書き足すので、1回の CI で回るテストも増えていきました。並列で進めるほどプルリクエスト同士のコンフリクトも増え、main を取り込み直すたびに CI が走り直します。
1日に回った CI の分数(GitHub が課金する分数の合計)は、8月の 126分 から、10月上旬には 9,611分 になっていました。
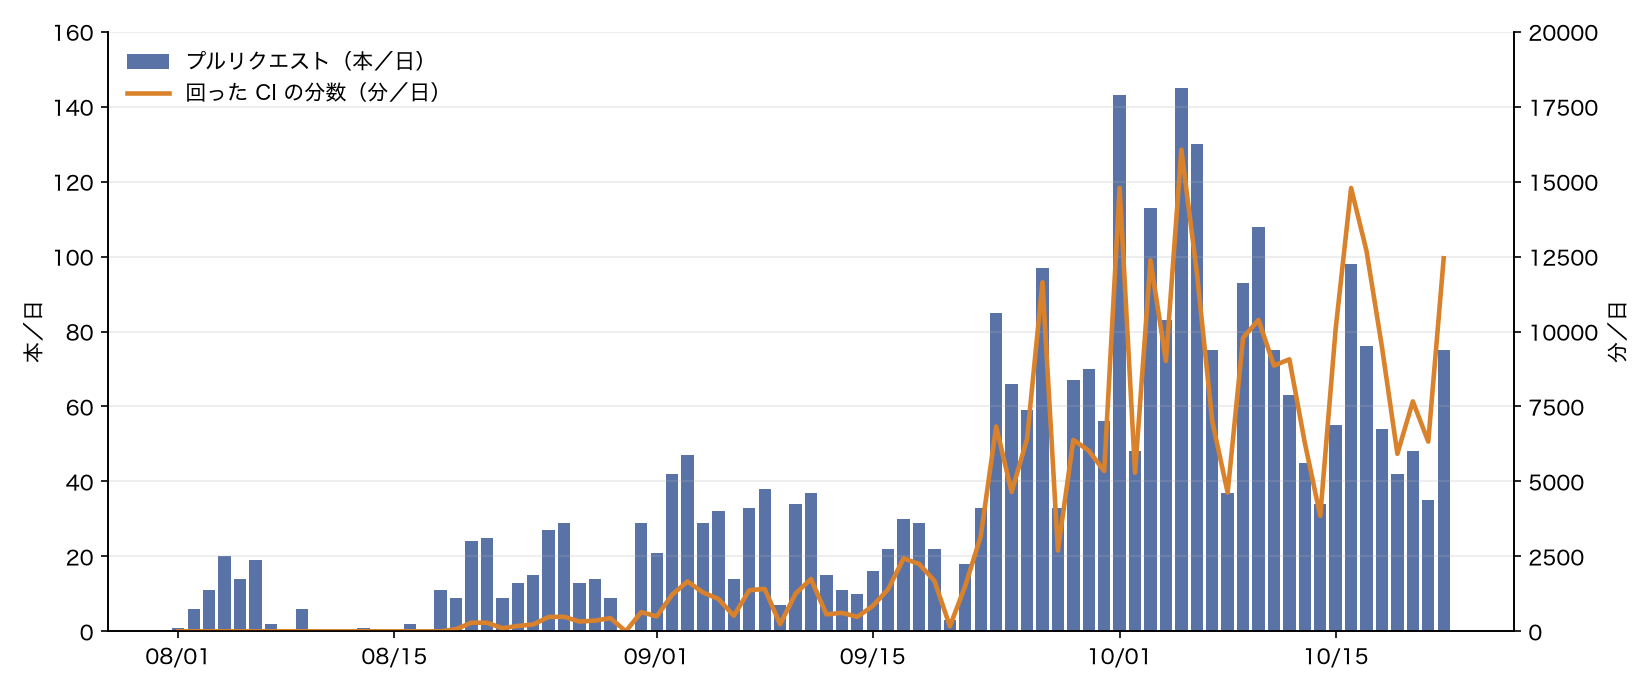
GitHub Actions の費用は、 「回った CI の分数 × 1分あたりの単価」 です。CI の分数が8月の約76倍になったので、費用もそれに合わせて膨らみました。
組織全体の予算を使い切って、CI が止まった
GitHub Actions の費用は、組織(Organization)単位で請求され、予算(上限)を設定できます。社内の GitHub の組織では月の上限が決まっていて、私たちの開発リポジトリの CI がその大半を使っていました(9月〜10月上旬で約7割、移す直前の9日間では約9割)。
9月30日の深夜2時ごろ、上限に達し、 組織のすべてのリポジトリで GitHub Actions のジョブが起動しなくなりました 。実行の画面にはこう出ていました。
The job was not started because recent account payments have failed or your spending limit needs to be increased. Please check the 'Billing & plans' section in your settings
私たちのリポジトリだけでなく、同じ組織の ほかのチームのリポジトリの CI まで止めてしまった わけです。その場は上限を上げてもらって再開しましたが、10月に入っても組織全体で1日最大100ドル近いペースで使っていて、このままでは毎月上限に当たるのが見えていました。
なぜセルフホストランナーにしたか
GitHub のホストランナーの料金は、公式の料金表では次のとおりです。
| ランナー | 1分あたり |
|---|---|
| Linux 2-core(x64) | 0.006ドル |
| Linux 2-core(arm64) | 0.005ドル |
| Linux 1-core(slim) | 0.002ドル |
CI の時間を減らす工夫(関係するテストだけ回すなど)も大事ですが、AI エージェントでプルリクエストが増え続ける以上、 1分あたりの単価そのものを下げないと追いつかない と考えました。セルフホストランナーなら、GitHub に払う分はかからず、 実行する機械(と、それを動かす AWS のサービス)の費用だけ になります(今回の明細でも、セルフホストランナーの分は0ドルでした)。
実行する機械には、すでに夜間のバッチ処理で使っていた AWS Fargate を選びました。常時起動の EC2 を置くのではなく、 ジョブが来たときだけタスクを立てて、終わったら捨てる ので、使っていない時間の費用がかかりません。
構成
ジョブが1つ走るまでの流れはこうです。
ポイントは3つです。
- webhook で起動する 。ジョブが
queuedになった瞬間に GitHub からworkflow_jobの webhook が届くので、それを合図にタスクを立てます。ポーリングはしません - JIT ランナーで、1ジョブで使い捨てる 。GitHub の API で、 1回だけ使える ランナーの設定を発行し、それでランナーを登録します。ランナーは1つのジョブを終えると GitHub から自動で消えます
- タスクも使い捨て 。1つのタスクは1つのジョブしか実行しません。前のジョブの状態が次のジョブに残らないので、ホストランナーと同じ感覚で使えます
JIT ランナーについて、GitHub のドキュメントでは次のように説明されています。
To improve runner registration security, you can use the REST API to create ephemeral, just-in-time (JIT) runners.
These self-hosted runners perform at most one job before being automatically removed from the repository, organization, or enterprise.
やってみた
ここからは、CDK とワークフローの要所を抜粋して紹介します。社内固有の名前は置き換え、説明に要らない部分は省いています。
1. ECS のクラスタとタスク定義(ARM64・タスクロールなし)
まずはランナーを動かす ECS のクラスタとタスク定義です。大きさは2種類用意して、ラベルで選べるようにしています。
| ラベル | vCPU | メモリ | 使うジョブ |
|---|---|---|---|
ci-runner |
2 | 8 GiB | ふつうのテスト・lint・ビルド |
ci-runner-large |
4 | 16 GiB | CDK の synth を含む重いテスト |
 const cluster = new ecs.CfnCluster(this, "Cluster", { clusterName: "ci-runner" });
 new ecs.CfnClusterCapacityProviderAssociations(this, "ClusterProviders", {
   cluster: cluster.ref,
   capacityProviders: ["FARGATE", "FARGATE_SPOT"],
   defaultCapacityProviderStrategy: [],
 });

 for (const [size, { cpu, memoryMiB }] of Object.entries(TASK_SIZES)) {
   const taskDef = new ecs.FargateTaskDefinition(this, `Task-${size}`, {
     family: `ci-runner-${size}`,
     cpu,
     memoryLimitMiB: memoryMiB,
     executionRole, // イメージの pull と自分のログだけ
+    runtimePlatform: {
+      cpuArchitecture: ecs.CpuArchitecture.ARM64,
+      operatingSystemFamily: ecs.OperatingSystemFamily.LINUX,
+    },
   });
   taskDef.addContainer("runner", {
     image: ecs.ContainerImage.fromEcrRepository(imageRepo, "stable"),
     logging: ecs.LogDrivers.awsLogs({ streamPrefix: size, logGroup }),
   });
+  // タスクロールを持たせない(ジョブの中から AWS の資格情報を拾えないようにする)
+  (taskDef.node.defaultChild as ecs.CfnTaskDefinition).addPropertyDeletionOverride("TaskRoleArn");
+  if (taskDef.node.tryFindChild("TaskRole")) taskDef.node.tryRemoveChild("TaskRole");
 }
ポイントは2つです。
- ARM64(Graviton)にしている 。Fargate は ARM のほうが x86 より安いので、CI のコードが ARM で動くなら ARM にしています
- タスクロールを持たせていない 。CI のジョブは、プルリクエストのコード(つまりエージェントが書いたコード)をそのまま実行します。タスクロールがあると、ジョブの中から AWS の資格情報を取れてしまうので、 そもそも渡さない ようにしています。AWS を触る必要のあるジョブ(デプロイなど)は、これまでどおり GitHub の OIDC でロールを引き受けます
ecs.Cluster(L2)を使っていないのは、VPC を省略すると自前の VPC(NAT ゲートウェイ付き)を作ってしまうためです。今回は、夜間のバッチ処理用にすでにある VPC の公開サブネットを借りて載せています。
2. セキュリティグループは外向きの 443 だけ
ランナーが通信する先は、GitHub・ECR・CloudWatch Logs だけで、どれも HTTPS(443)です。受け口は要らないので、外向きの 443 だけを開けます。
const sg = new ec2.SecurityGroup(this, "CiRunnerSg", {
  vpc,
  allowAllOutbound: false,
  description: "ci runner (outbound 443 only, no inbound)",
});
sg.addEgressRule(ec2.Peer.anyIpv4(), ec2.Port.tcp(443), "https only");
3. タスクを立てる権限は「CI のクラスタの CI のタスク定義だけ」に絞る
タスクを立てるのは Lambda(起動役)です。起動役が引き受けるロールには、 CI のクラスタで、CI のタスク定義を立てることだけ を許可し、それ以外は明示的に Deny しています。
const clusterArn = `arn:aws:ecs:${region}:${account}:cluster/ci-runner`;
const taskDefinitionArns = SIZES.map((s) => `arn:aws:ecs:${region}:${account}:task-definition/ci-runner-${s}:*`);

const statements = [
  new iam.PolicyStatement({
    actions: ["ecs:RunTask"],
    resources: taskDefinitionArns,
    conditions: { ArnEquals: { "ecs:cluster": clusterArn } },
  }),
  new iam.PolicyStatement({
    actions: ["iam:PassRole"],
    resources: [executionRoleArn], // 渡せるのは実行ロールだけ
    conditions: { StringEquals: { "iam:PassedToService": "ecs-tasks.amazonaws.com" } },
  }),
  // ここから明示の Deny(CI の外は全部閉じる)
  new iam.PolicyStatement({
    effect: iam.Effect.DENY,
    actions: ["ecs:RunTask"],
    resources: ["*"],
    conditions: { ArnNotEquals: { "ecs:cluster": clusterArn } },
  }),
  new iam.PolicyStatement({
    effect: iam.Effect.DENY,
    actions: ["ecs:RunTask"],
    resources: ["*"],
    conditions: { StringEquals: { "ecs:enable-execute-command": "true" } },
  }),
  new iam.PolicyStatement({
    effect: iam.Effect.DENY,
    actions: ["ecs:RegisterTaskDefinition", "ecs:ExecuteCommand", "ecs:StartTask", "ecs:CreateService", "ecs:UpdateService"],
    resources: ["*"],
  }),
];
Allow だけで絞るのではなく、 外側を Deny で閉じておく と、あとから誰かが Allow を足しても、CI 以外のタスクを立てたり、タスク定義を書き換えたりはできません。
4. webhook を受けて、JIT ランナーの設定を発行してタスクを立てる
起動役の Lambda は、関数 URL で GitHub の webhook を受けます。やっていることは次のとおりです。
X-Hub-Signature-256ヘッダの署名を、webhook の秘密で検める(合わなければ 401)workflow_jobのactionがqueuedで、ラベルがself-hostedとci-runner(またはci-runner-large)の ちょうど2つ で、リポジトリが登録済みのものなら、起動する- GitHub の API で、JIT ランナーの設定を発行する
- 発行した設定を、 1回だけ取り出せる 形で保存し、
ecs:RunTaskでタスクを立てる
JIT ランナーの設定を発行する API はこれです。
POST /repos/{owner}/{repo}/actions/runners/generate-jitconfig
ドキュメントにあるとおり、この API は リポジトリの admin 権限 が要ります("The authenticated user must have admin access to the repository.")。GitHub App で呼ぶ場合は、 Administration(Read and write) の権限が必要です。webhook をリポジトリに自動で張る場合は、 Webhooks(Read and write) も要ります。会社の組織に入れている App の権限を広げることになるので、管理部門に用途を説明して承認してもらいました。
タスクを立てるときの入力は、こんな形です。
await ecs.send(new RunTaskCommand({
  cluster: "ci-runner",
  taskDefinition: `ci-runner-${size}`, // ラベルで 2 vCPU か 4 vCPU を選ぶ
  count: 1, // 1 ジョブにつき 1 タスク
  capacityProviderStrategy: [{ capacityProvider: "FARGATE", weight: 1 }],
  networkConfiguration: {
    awsvpcConfiguration: { subnets, securityGroups: [sg], assignPublicIp: "ENABLED" },
  },
  overrides: {
    containerOverrides: [{
      name: "runner",
      environment: [
        { name: "JIT_URL", value: jitUrl },     // JIT の設定を受け取る口
        { name: "JIT_NONCE", value: nonce },     // 1 回限りの合言葉
      ],
    }],
  },
}));
JIT の設定そのものは、タスクの環境変数には入れていません。環境変数に入れると ECS の画面や API から見えてしまうので、タスクには「受け取り口」と「1回限りの合言葉」だけを渡し、コンテナが起動したときに取りに来させています。取り出した瞬間に保存先から消すので、同じ設定は2度と使えません。
5. コンテナの中:JIT ランナーとして1ジョブだけ走る
ランナーのイメージは、GitHub 公式の ghcr.io/actions/actions-runner に、CI で使う git・jq・AWS CLI・GitHub CLI などを足したものです。CodeBuild で毎週作り直しています(GitHub のランナーは、古い版だと登録を受け付けてもらえなくなるためです)。
コンテナの起動スクリプトは、JIT の設定を受け取って、そのまま run.sh に渡すだけです。
# JIT の設定を 1 回だけ受け取る(取り出した瞬間に保存先から消える)
JIT_CONFIG=$(curl -fsS -X POST "${JIT_URL%/}/jit" -d "{\"nonce\":\"${JIT_NONCE}\"}" | jq -r .encodedJitConfig)
unset JIT_URL JIT_NONCE

# JIT ランナーとして登録し、ジョブを 1 つだけ実行して終わる
export ACTIONS_RUNNER_INPUT_JITCONFIG="${JIT_CONFIG}"
exec ./run.sh
ジョブが終わると run.sh が終了し、タスクも止まります。ジョブを拾わないまま10分たったタスクや、60分を超えたタスクは、15分ごとの見回り(EventBridge のスケジュール+ECS のタスクの状態の変化のイベント)で止めています。
6. ワークフロー側:変数で切り替えられるようにする
ワークフローの runs-on は、リポジトリの変数で切り替えられるようにしました。
jobs:
  test:
    runs-on: ${{ (vars.CI_RUNS_ON == 'fargate' && (github.event_name != 'pull_request' || github.event.pull_request.head.repo.full_name == github.repository)) && fromJSON('["self-hosted","ci-runner"]') || 'ubuntu-24.04-arm' }}
- リポジトリの変数
CI_RUNS_ONがfargateのときだけ、セルフホストランナーに載せます。変数を消せば、すぐに GitHub のホストランナーに戻せます - フォークからのプルリクエストは、セルフホストランナーに載せません 。
head.repo.full_nameが自分のリポジトリのときだけ、という条件がそれです
フォークの条件は、GitHub のドキュメントでも強く注意されている点です。
Similarly, be cautious when using self-hosted runners on private or internal repositories, as anyone who can fork the repository and open a pull request (generally those with read access to the repository) are able to compromise the self-hosted runner environment, including gaining access to secrets and the
GITHUB_TOKEN.
念のため、ランナーの側でも、ジョブが始まる直前に動くフック(ACTIONS_RUNNER_HOOK_JOB_STARTED)で、リポジトリ・イベントの種類・フォークでないことを確かめ、外れていたらランナーごと止めるようにしています。
結果:実数値で比べる
開発リポジトリの CI の費用を、日ごとに並べるとこうなりました。
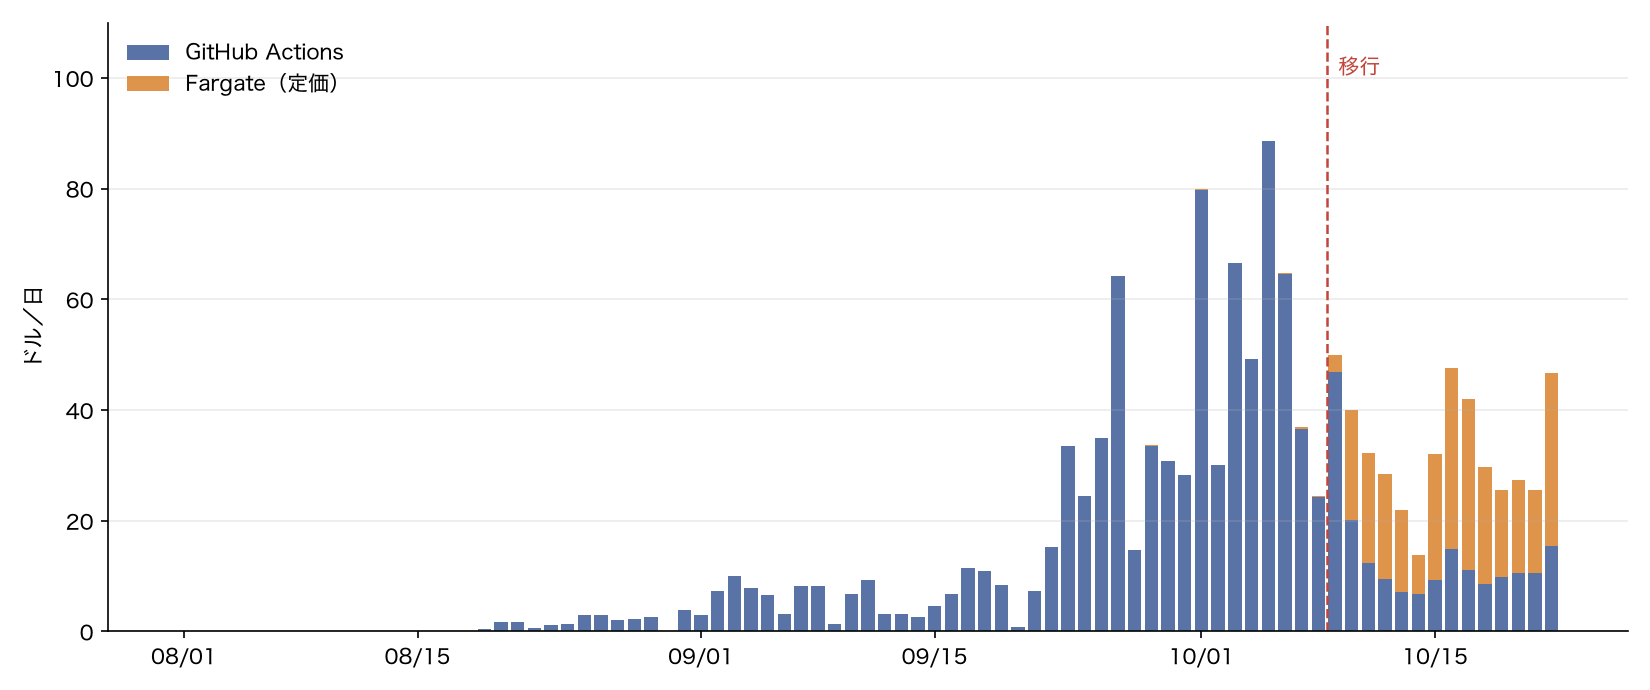
期間ごとにまとめると次のとおりです。
| 期間 | GitHub の費用(1日あたり) | Fargate の費用(1日あたり・定価) | GitHub の CI(分/日) | Fargate の CI(分/日) |
|---|---|---|---|---|
| 8月 | 0.8ドル | — | 126 | 0 |
| 9/1〜9/29 | 13.2ドル | — | 2,486 | 0 |
| 9/30〜10/8(移す直前) | 52.0ドル | — | 9,611 | 0 |
| 10/11〜10/22(移した後) | 10.5ドル | 20.6ドル+通信など約1.0ドル | 約1,950 | 約7,000 |
1日の費用は、移す直前の52.0ドルから、移した後は約32.0ドルになりました。ただし、この2つの期間は、開発の活性度がそもそも違うので、単純には比べられません。
- プルリクエストの数が違う 。移す直前は1日92本、移した後は58本でした
- CI の中身も変えている 。同じ時期に、テストの分け方を変えるなど CI 自体の改修も入れています。移行の効果だけを切り出すことはできません
そこで、 同じ量の CI を回すのにいくらかかるか (CI 1分あたりの費用)で比べます。1日に回った CI の分数は、移す直前が9,611分、移した後が8,957分で、量もほぼ同じでした。
| 移す直前 | 移した後 | |
|---|---|---|
| 1日の費用 | 52.0ドル | 約32.0ドル |
| 1日に回った CI の分数 | 9,611分 | 8,957分 |
| CI 1分あたりの費用 | 0.0054ドル | 0.0036ドル(−34%) |
同じ量の CI を回す費用は、 約3割下がりました 。
移した後も、デプロイなど一部のジョブは GitHub のホストランナーに残っているので、全体の1分あたりの費用は Fargate の単価(約0.003ドル)より高くなっています。
Savings Plans を使っていると、実際はさらに下がる
ここまでの数字は、Fargate を 定価 で計算したものです。クラスメソッドでは AWS の Compute Savings Plans を使っていて、Fargate の利用にも割引が効いています。Savings Plans を適用した実質の費用で比べると、次のとおりです。
| 移す直前 | 移した後(定価) | 移した後(Savings Plans 適用後) | |
|---|---|---|---|
| 1日の費用 | 52.0ドル | 約32.0ドル | 約21.8ドル |
| CI 1分あたりの費用 | 0.0054ドル | 0.0036ドル(−34%) | 0.0024ドル(−55%) |
Fargate の分は、定価なら1日20.6ドルのところ、実質は約10.3ドルでした。GitHub Actions 側にはこうした割引が無いので、 Savings Plans を使っている組織なら、CI 1分あたりの費用はおよそ半分 になります。
1日9,000分ほどの CI を回すとして月に直すと、移す直前の単価なら月 約1,460ドル 、移した後の単価なら月 約970ドル です。組織の上限に当たって CI が止まる心配も、ひとまずなくなりました。
注意点・Tips
- Savings Plans があると、Fargate の費用が「見えない」 。今回いちばんハマったところです。会社の AWS の組織で Compute Savings Plans を契約していると、Fargate の費用は Cost Explorer の「非ブレンドコスト」では相殺されて 0ドル に見えます。最初はそれを見て「Fargate はほぼ無料」と計算してしまいました。正しく見るには、Cost Explorer で 購入オプション(RECORD_TYPE)が
SavingsPlanCoveredUsageの行 を見るか、 償却コスト(Amortized cost) に切り替えます。この記事では、Savings Plans が無い場合の定価を主に使い、適用後の実質は別に示しています - Fargate の単価には起動と待ちの時間も乗る 。Fargate は、タスクが動いている時間(コンテナのイメージの取得も含む)で課金されます。今回の実績だと、ジョブの時間で割った単価は約0.003ドルで、2 vCPU・8 GiB(ARM)の東京リージョンの公開価格から計算した値(約0.0019ドル)の1.5倍ほどでした。4 vCPU のタスクが混ざっていることに加えて、起動とジョブを待つ時間の分が乗っています。イメージを小さくする、待ちの時間を短くする、が効いてきます
- パブリック IP と通信にも費用がかかる 。公開サブネットにタスクを置き、パブリック IP を付けています(NAT ゲートウェイを置くより安いため)。パブリック IPv4 は1つ1時間あたりの課金があるので、同時に立つタスクの数に比例して増えます
- フォークからのプルリクエストは流さない 。公開リポジトリでは、そもそもセルフホストランナーを使わないのが無難です。非公開リポジトリでも、ワークフローの条件とランナー側のフックの2段で止めています
- GitHub 側に残る CI もある 。デプロイやリリースなど、今回移していないジョブで、まだ1日10ドルほど GitHub のホストランナーを使っています。これらも移せば、さらに下がる見込みです
- CI の量を減らす工夫は別に必要 。単価を下げても、CI の量が増え続ければ、いずれ費用は増えます。変更に関係するテストだけ回すなど、時間そのものを減らす工夫と組み合わせるのが本筋だと思います
おわりに
AI エージェントを並べて開発すると、実装のスピードが上がるぶん、 CI が次のボトルネックとコストの山 になります。今回は、プルリクエストが1日90本を超えたところで、GitHub の組織全体の予算を使い切ってしまいました。
ジョブごとに Fargate のタスクを立てて捨てるセルフホストランナーに移したことで、同じ量の CI を回す費用が 約3割下がりました (CI 1分あたり0.0054ドル → 0.0036ドル)。JIT ランナーを使えば、1つのジョブで使い捨てにでき、ホストランナーに近い感覚で安全に使えます。
AI エージェントでの開発を本格的に回し始めると、GitHub Actions の費用の伸び方が変わります。同じように CI の費用で悩んでいる方は、単価を下げる手として検討してみてください。
以上、どなたかの参考になれば幸いです。
参考