AWS Glue Studioでビジュアル ETLを維持しつつ複数の文字コードが混在するファイルを処理してみました

初めに
今回CSV形式のデータのETLを組む機会がありました。
今回受け渡されるCSVデータの文字コードは基本UTF-8なのですが、データの都合上稀にとあるカラムにSHIFT_JISの文字が混入する可能性がある少しトリッキーな仕様となっています。
カラムの取り出しや形式の変換を実現できるサービスとしてAthenaを始めとして便利なサービスはAWS上に複数あるのですが、この仕様の関係で前処理をするにもほとんどのサービスが候補から外れる形となります。
こういった処理はAWS Lambdaの方が小回りが利いて便利なのですが、データ量が膨大で中間データをあまり生成したくない(S3の課金増加)、スキルセット的に可能な限りコードを書かない直感的な生成(GUIの利用等)をしたいという目的がありました。
いくつか試してみたところGlue StudioのVisual ETLであればギリギリ実現できそうではありましたので、検証した結果を備忘録として残しておきます。
後続の内容を見ていただくとわかるのですが処理自体は文字コード変換の前処理に限定できるのですがPythonの知識に加えてSparkの知識も多少必要になるのでなかなか全ては解決できないといったところになります。
なお余談ですが自分は本件で初めてSparkを触りました。
今回試すことについて
- ヘッダありでSHIFT_JISとUTF-8を設置。データ行のみ文字コードが混在
- 入力はcsvで出力はjson(Parquetにしようと思ったけど結果の閲覧が面倒)
- ここはData targetノードで特に意識せずにできるので本記事の趣旨には未関与
- データはUTF-8を基本としUTF-8でデコードできない文字が入った場合はなんらかで元も文字が特定できる状態(可逆性がある状態)で書き出す
- 今回はcodecsの
errors='backslashreplace'で元のバイナリ文字列が特定できる状態で書き出す形でフォールバックする - https://docs.python.org/ja/3.13/library/codecs.html#error-handlers
- 今回はcodecsの
入力データイメージ(実際に使うものは一部文字がSHIFT_JIS)
id,last_name,first_name
1,山田,太郎
2,鈴木,花子
3,佐藤,次郎
4,高橋,美咲
5,田中,一郎
ETL全体イメージ
ETL全体像としては以下の通りになります。
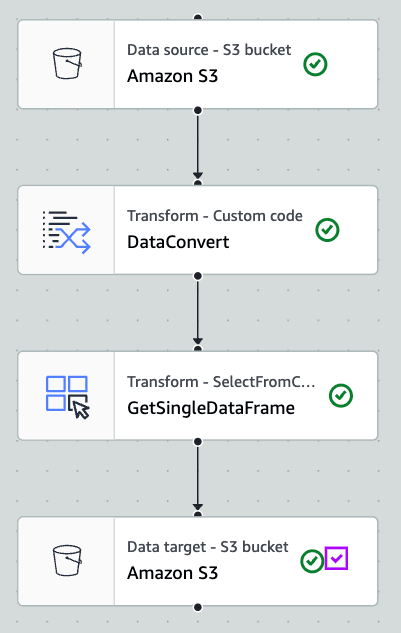
DataConvertが今回の主題となるCustom Transformノードでここで読み込んだデータのUTF-8以外の文字カラムを検出した際にbackslashreplaceにフォールバックします。それ以外は特に何もせず単純出力します。
Custom TransformはVisualモードのまま任意のPythonスクリプトを組み込めるものとなります。
Glue Studioではコード全体をユーザが自由にかけるScriptモードもあるものの、そちらに指定しまうとETL全体を自分でコードを書いて構築する形になってしまいます。
ごく部分的なコード処理であればこちらを利用することでVisualモードを維持しつつ任意のスクリプトを組み込めコードの管理を減らすことができます。
今回は特に実装しないのですがカラム抽出等を実施したい場合はこの下に変換用のノードを繋げていく形になります。
GetSingleDataFrame(SelectFromCollection)自体は特に大きな意味はなく、Custom Transformの出力がCollection型になるもののそれをAmazon S3ノードが受け付けないので結果を取り出しているだけです(配列の先頭要素の抽出イメージ)。
単純に引数のdfcを読み込むとクラッシュする
さて、Visual ETLを利用した場合のCustom Transformの関数の定義枠としてはdef MyTransform (glueContext, dfc) -> DynamicFrameCollectionが定義されますが、実際のデータについてはこのうちdtc(DynamicFrameCollection)に入っている形となります。
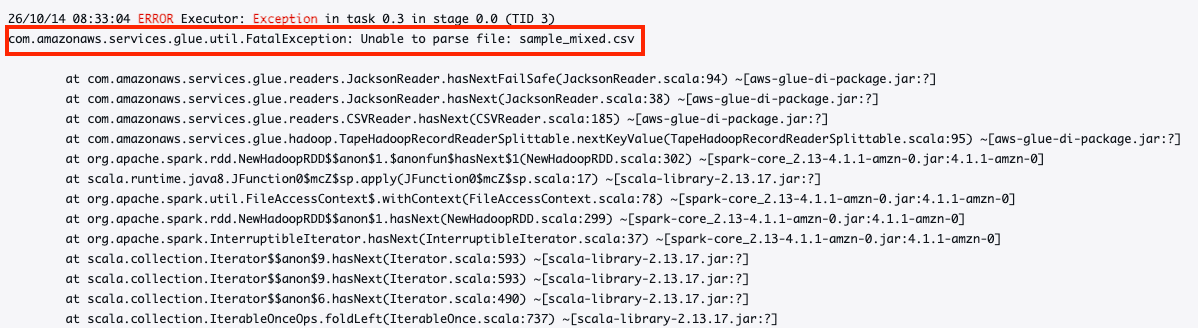
通常はこのインスタンスを元に各種内部のメソッドを呼び出すことで前ノードで読み込まれたデータを処理できるのですが、今回の場合はこれを利用するとジョブが落ちます。
https://spark.apache.org/docs/latest/rdd-programming-guide.html
All transformations in Spark are lazy, in that they do not compute their results right away. Instead, they just remember the transformations applied to some base dataset (e.g. a file).
これに関してはDynamicFrame...というよりはその元となるDataFrame側の方に記載があるのですがDataFrameは仕様として生成した時点では特にデータを読み込むことはなく遅延する評価されるオブジェクトとなっています。
S3ノードで生成されるオブジェクトは以下となっています。処理としてはDynamicFrameを生成しているだけなので、この時点では内部が評価されずに文字コードが混在していても問題なく進むようなのですが、これを具体的に処理しようと思うと落ちるので使えません。
# Script generated for node Amazon S3
AmazonS3_node1791964743022 = glueContext.create_dynamic_frame.from_options(format_options={"quoteChar": "\"", "escaper": ",", "withHeader": True, "separator": ","}, connection_type="s3", format="csv", connection_options={"paths": ["s3://j-s-general-test-bucket/glue-studio/in/"], "recurse": True}, transformation_ctx="AmazonS3_node1791964743022")
https://docs.aws.amazon.com/ja_jp/glue/latest/dg/components-key-concepts.html
AWS Glue で正常に処理するために、CSV などのテキストベースのデータは UTF-8 でエンコードする必要があります。
具体的な実装までは追えないのですが、Glueサービス全体の仕様としてUTF-8であることが前提になっているため、厳密に言えばDynamicFrame生成する際に文字コードの取り扱いをUTF-8として解釈する形になっているのだと思われます。
どうやって実現するか
そのため今回実装するCustom Transformノードでは引数で渡ってきたdfcを利用せず、新規に戻り値で渡すDynamicFrameCollectionを生成する必要があります。
...DynamicFrameCollectionがマルチバイト文字に対応できないからこうなっているのでは?というところですが、明確には記載されていないもののdfcがUTF-8前提で読み込まれており、読み取り時に変換できない文字に当たってしまうことが問題です(実際の動作ベースでの話)。
これに対する対処としてはバイナリをそのまま扱ってしまう、もしくは人間が読めるかは別としてlatin-1(ISO-8859-1)として読み込んでしまうことで対処可能です。
latin-1であれば全ての文字が1バイトかつ0x00~0xFFまで全てマッピングされているので人が読めるかはともかくとしてプログラム的には読み込むことができます。またバイナリをそのまま使うとPython的にはbyteとstrの変換が必要なのでこっちで読んでしまう方がいろいろ楽です。
また、dfcを使わないのであればソースのS3ノードは不要なのですが以下の理由より配置しています。
- ノード情報内にS3のパス情報があり、Custom Transformではこれを参照してこれを読み出し元パスを特定したい
- ジョブの実行引数等別手段での引き渡しは可能なので必須ではない(どうせ設置せざるを得ないのでついでに利用)
- そもそもCustom TransformはTransformsであり始点にすることができない
- 別の手段でパスを引き渡すのであればダミーのバケットを設定する形は可能
具体的なコード
これを踏まえると以下のようなコードで実現する形となります。
def MyTransform(glueContext, dfc) -> DynamicFrameCollection:
    import boto3
    from pyspark.sql.functions import col, udf

   ## データプレビュー時はジョブが生成されない関係で--JOB_NAMEがないのでこれを前提としてダメ元でプレビュー用に変換
    if "--JOB_NAME" not in sys.argv:
        return DynamicFrameCollection({"normalized": dfc.select(list(dfc.keys())[0])}, glueContext)

    ## AWS APIで自身のGlueのジョブ情報を取得し、入力のS3パスを特定する
    ## この辺りは実行ジョブの引数から直接受け取る形で代替可能
    job_name = getResolvedOptions(sys.argv, ["JOB_NAME"])["JOB_NAME"]
    nodes = boto3.client("glue").get_job(JobName=job_name)["Job"]["CodeGenConfigurationNodes"]
    paths = [p for n in nodes.values() if "S3CsvSource" in n for p in n["S3CsvSource"]["Paths"]]
    if not paths:
        raise ValueError("S3CsvSource のパスがジョブ定義から取得できません")

    ## ここから具体的な読み出し&変換処理
    ## NOTE: Spark側の世界にPythonで定義したユーザ定義関数を持ち込むためのデコレーターらしい(stringは戻り値の型)
    ##  https://docs.databricks.com/gcp/ja/udf/python
    @udf("string")
    def decode_utf8(s):
        return None if s is None else s.encode("ISO-8859-1").decode("utf-8", errors="backslashreplace")

    df = (glueContext.spark_session.read.option("header", "true").option("sep", ",")
          .option("encoding", "ISO-8859-1").csv(paths))
    df = df.select([decode_utf8(col(column)).alias(column) for column in df.columns])

    ## Collectionで渡す必要があるのでその形にしている。キーをresultにしてるけど識別子なのでなんでもいい
    return DynamicFrameCollection({"result": DynamicFrame.fromDF(df, glueContext, "result")}, glueContext)
--JOB_NAMEの判定が一部あるのですがこれはデータプレビュー時の際には個別のジョブが生成されない関係で自身のジョブ情報を取得できる手段がないので、ダメ元で変換をかけています。
実際に試す限りですが全行読み込まず先頭行を一部だけ読み込むプレビューでは先頭行に運よく問題になる文字コード混在行が入っていなければ処理が通りスキーマの自動推定ができるのでやるだけやっておくと設定が楽です。
失敗しても以下のようにプレビューのエラーになるだけですので、混入がごく一部であればやるだけやっておいても良さそうです(固定値を返してもいいかもしれません)。
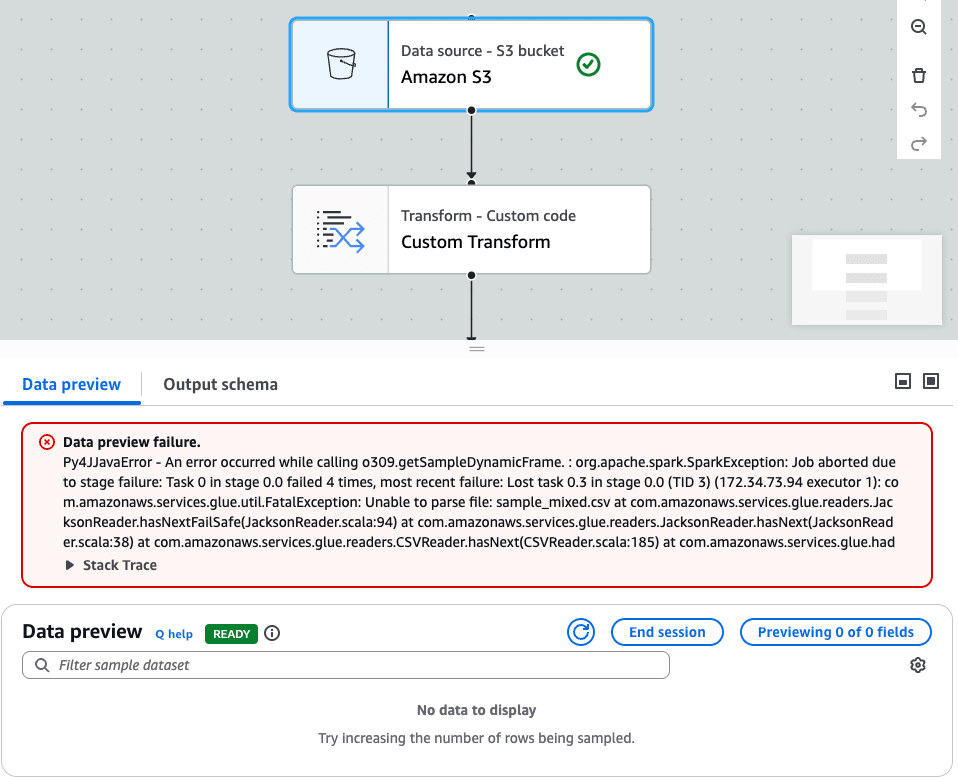
今回のケースの場合は全ての行で必ず混在が起きるわけではない(極一部)なのと、定義を列挙するのが手間だったのでこの方式にしていました。
結果
ここまできたらあとは動かしてファイルを確認するだけとなりますが...うまくいってそうですね。
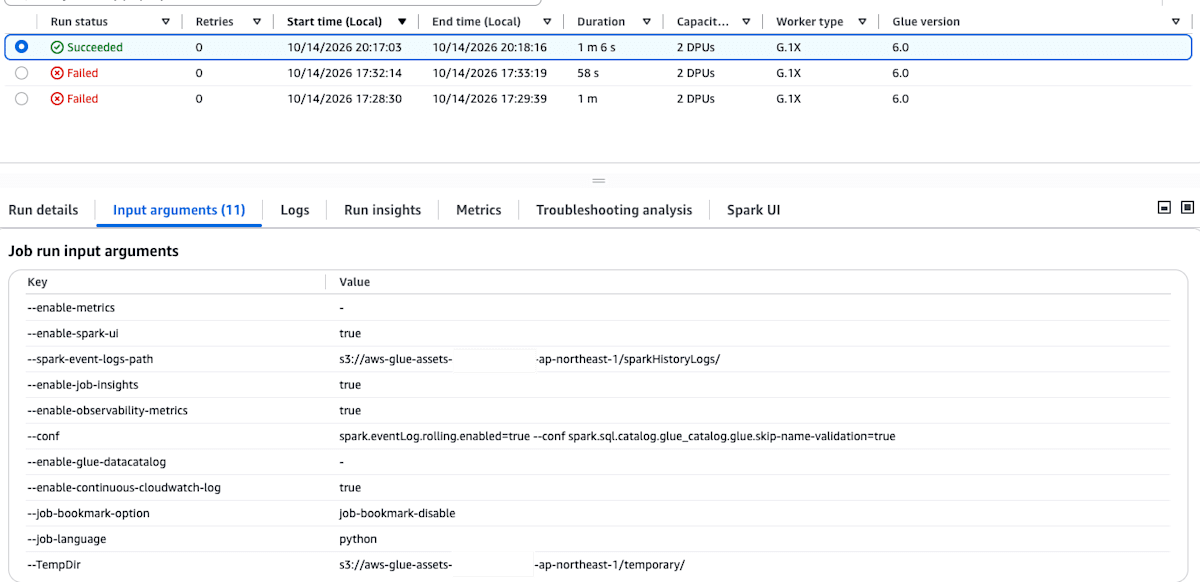
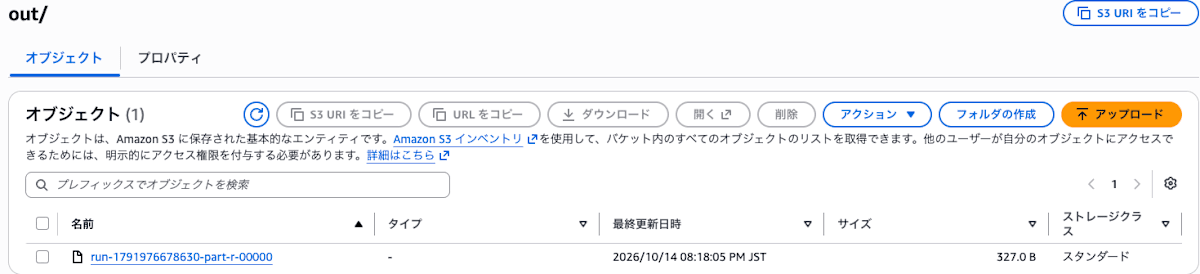
ファイルの中身も確認してみるとうまく対処されてそうです。
 % cat run-1791976678630-part-r-00000
{"id":"1","last_name":"\\x8eR\\x93c","first_name":"太郎"}
{"id":"2","last_name":"\\x97\\xe9\\x96\\xd8","first_name":"花子"}
{"id":"3","last_name":"\\x8d\\xb2\\x93\\xa1","first_name":"次郎"}
{"id":"4","last_name":"\\x8d\\x82\\x8b\\xb4","first_name":"美咲"}
{"id":"5","last_name":"\\x93c\\x92\\x86","first_name":"一郎"}
\\x8eR\\x93cはバイナリ的には0x8e 0x52 0x93 0x63ですので文字コード表を追ってみる限りでも大丈夫そうです。


終わりに
Glue StudioでVisual ETLを維持したままUTF-8以外の文字コードが混在するファイルの変換を実現してみました。
一部どうしてもコードが必要になってきますがVisual ETLを利用することで大部分のコード管理をなしとしたローコードな実現が可能でコードの管理コストを小さく収めることが実現できます。
一方で条件次第ではうまくプレビューが動かなかったり、直接管理するコードは減るもののSparkの知識が要求されるようになるなどの問題が発生する形とはなります。
(シンプルにこの文字コードへの対処だけであればSparkは過剰で、テキストファイルとしてoepn&read、decode()で十分)
取り扱うデータが巨大であったり加工的にSparkやPandasを利用した方が良い用途があればついでで使うのも良いかもしれませんが、シンプルな処理であれば知識を追加で要求されないLambdaの方に軍配が上がりますのでユースケースに応じて選択するのが良さそうではあります。