予測対象の過去データに欠損があるとChronos-2の予測はどう変わるか
Chronos-2は、Amazonが公開している時系列予測の基盤モデルです。モデル本体はHugging Face Hubで公開されており、同じamazon/chronos-2を次の3つのパッケージから使えます。
chronos-forecastingAutoGluon-TimeSeriesDarts
本記事では、過去の予測対象に欠損があるとき、3つのパッケージで予測が異なる仕組みを確認します。
データは自転車シェアリングに関するもので、予測対象は利用台数です。共変量は使いません。本データの1コマは1時間です。
- 過去:2011年1月1日 00:00から2012年12月30日 23:00までの17,520コマ
- 予測:2012年12月31日 00:00から23:00までの24コマ
結論
- 欠損(行が無い)場合
chronos-forecastingは、行を作りません。DartsとAutoGluon-TimeSeriesは、行を足してNaNにします。
- 欠損(行がある)場合
chronos-forecasting、Darts、AutoGluon-TimeSeriesは、NaNのままです。
| 日時 | 元データ 予測対象(利用台数) | chronos-forecasting(内部前処理なし) |
Darts(内部前処理あり) |
AutoGluon-TimeSeries(内部前処理あり) |
|---|---|---|---|---|
| 2011-01-03 01:00:00 | 2 | 2 | 2 | 2 |
| 2011-01-03 02:00:00 | 行なし | 行なし | NaN | NaN |
| 2011-01-03 03:00:00 | 行なし | 行なし | NaN | NaN |
| 2011-01-03 04:00:00 | 1 | 1 | 1 | 1 |
※太字は、各Pythonパッケージが内部処理で加えた前処理結果です。
検証環境
Python: 3.11
chronos-forecasting: 2.3.2
autogluon.timeseries: 1.6.3
u8darts: 0.41.0
torch: 2.10.0
transformers: 5.14.1
scikit-learn: 1.7.2
pandas: 2.3.3
matplotlib: 3.11.2
japanize-matplotlib: 1.1.3
使用するデータ
OpenMLは、機械学習用データセットの共有サービスです。今回はscikit-learnのfetch_openml()を使い、OpenMLからBike Sharing Demandを取得します。これは、自転車シェアリングサービスの利用台数と、その時点の気温などが記録されたデータセットです。
利用台数の単変量予測です。共変量は使いません。今回は過去の予測対象である利用台数を欠損させます。
前処理はこちら
取得したデータには年・月・時刻を表す列がありますが、日を表す列がありません。データが時系列順に並んでいることを利用し、hourが前の行より小さくなった箇所を日付の切り替わりとして、日を補います。もともと行がなかった165時間は、行を足しません。
import pandas as pd
from sklearn.datasets import fetch_openml

bike_sharing = fetch_openml(
    "Bike_Sharing_Demand",
    version=2,
    as_frame=True,
)

df = bike_sharing.frame.copy()
df["year_num"] = df["year"].astype(int)
df["month_num"] = df["month"].astype(int)
df["hour_num"] = df["hour"].astype(int)
df["day_num"] = (
    df.groupby(["year_num", "month_num"], sort=False)["hour_num"]
    .transform(lambda s: s.diff().lt(0).cumsum() + 1)
)
df["日時"] = pd.to_datetime(
    {
        "year": df["year_num"] + 2011,
        "month": df["month_num"],
        "day": df["day_num"],
    }
) + pd.to_timedelta(df["hour_num"], unit="h")
df = (
    df.rename(columns={"count": "利用台数"})
    .assign(時系列ID="自転車シェアリング")[["時系列ID", "日時", "利用台数"]]
    .sort_values(["時系列ID", "日時"])
    .reset_index(drop=True)
)

prediction_start = pd.Timestamp("2012-12-31 00:00:00")
context_df = df[df["日時"] < prediction_start].copy()
Chronos-2の予測に必要な、次のDataFrameを作りました。
context_df:2011年1月1日 00:00から2012年12月30日 23:00までの利用台数
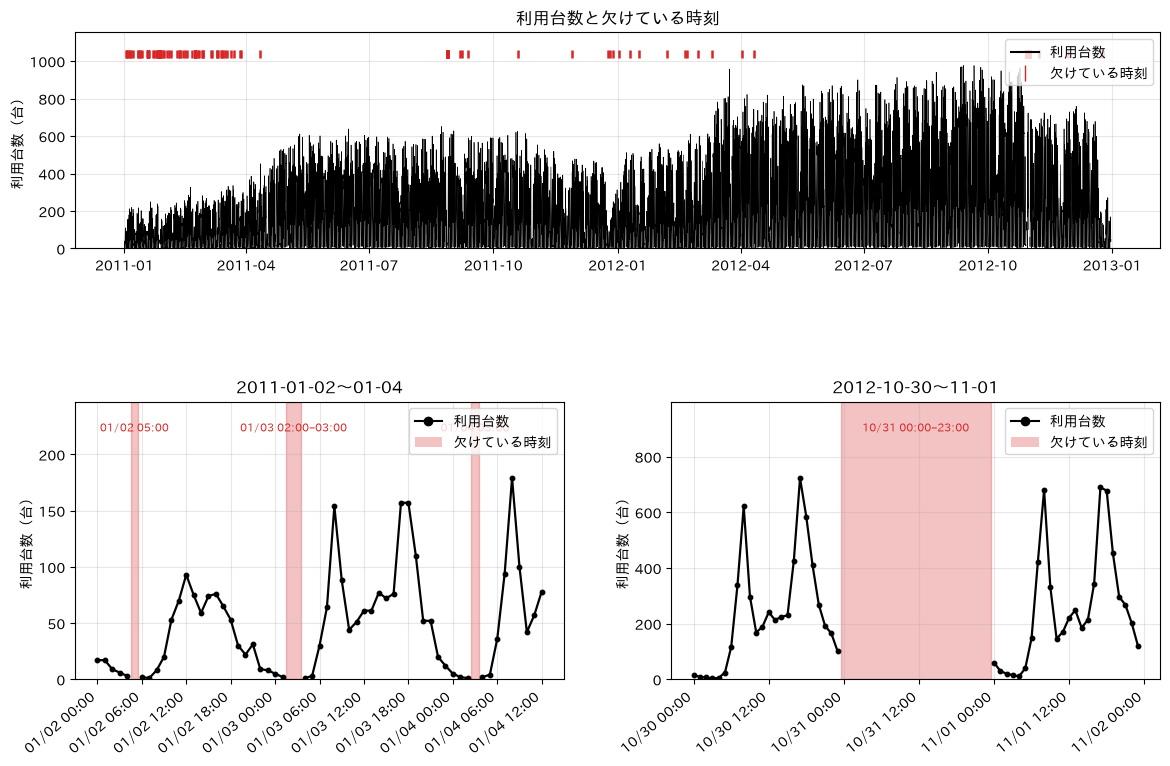
上段の赤い印が、もともと行がなかった時刻です。この165時間は行がありません。下段は2011年1月2日〜4日と、2012年10月31日の24時間を拡大しています。
欠損値処理前
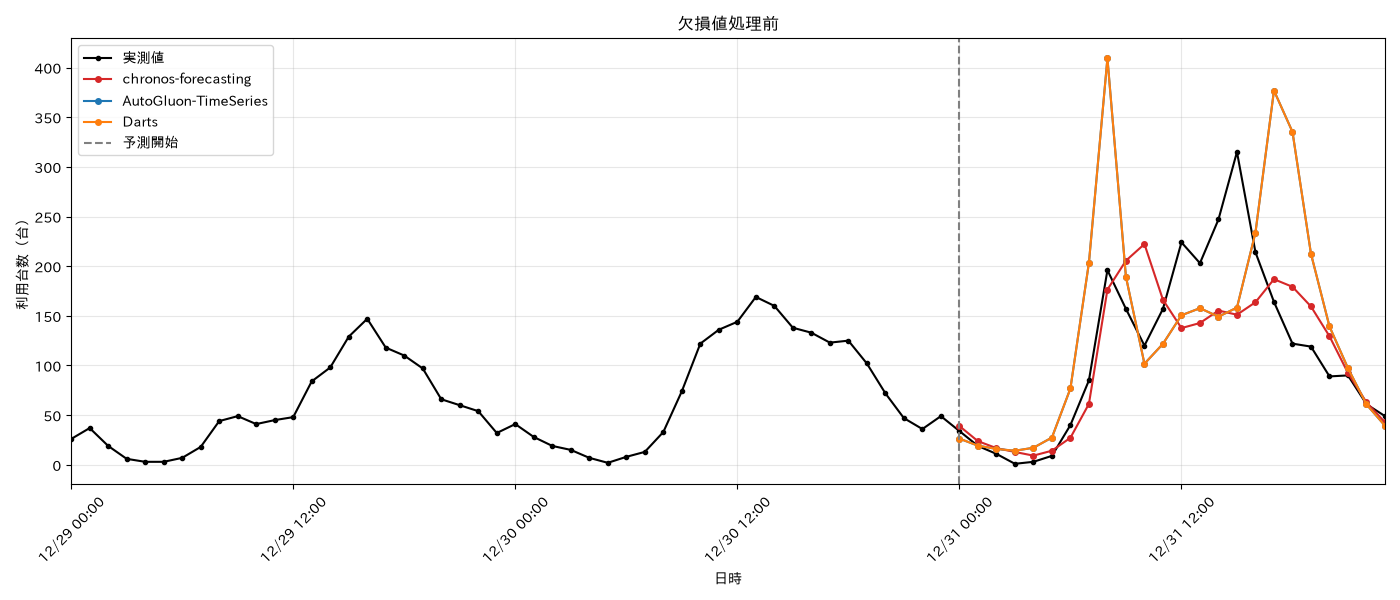
利用台数の行がないまま渡します。50%予測で比べます。誤差は12月31日の実測利用台数に対する値です。
過去は17,355行です。2011年1月3日の02:00と03:00は、行がありません。context_dfを、3つのパッケージへ渡します。
chronos-forecasting
from chronos import Chronos2Pipeline

pipeline = Chronos2Pipeline.from_pretrained(
    "amazon/chronos-2",
    device_map="cpu",
)

pred_chronos = pipeline.predict_df(
    df=context_df,
    prediction_length=24,
    quantile_levels=[0.1, 0.5, 0.9],
    id_column="時系列ID",
    timestamp_column="日時",
    target="利用台数",
    freq="h",
)
AutoGluon-TimeSeries
from autogluon.timeseries import TimeSeriesPredictor

train = context_df.rename(
    columns={"時系列ID": "item_id", "日時": "timestamp"}
)

predictor = TimeSeriesPredictor(
    prediction_length=24,
    target="利用台数",
    freq="h",
    quantile_levels=[0.1, 0.5, 0.9],
).fit(
    train_data=train,
    hyperparameters={"Chronos2": {"model_path": "amazon/chronos-2"}},
)

pred_autogluon = (
    predictor.predict(data=train)
    .reset_index()
    .rename(columns={"item_id": "時系列ID", "timestamp": "日時"})
)
Darts
from darts import TimeSeries
from darts.models import Chronos2Model
from darts.utils.likelihood_models import QuantileRegression

series = TimeSeries.from_dataframe(
    df=context_df.assign(利用台数=context_df["利用台数"].astype("float32")),
    time_col="日時",
    value_cols="利用台数",
    freq="h",
)
model = Chronos2Model(
    input_chunk_length=8192,
    output_chunk_length=24,
    likelihood=QuantileRegression(quantiles=[0.1, 0.5, 0.9]),
    hub_model_name="amazon/chronos-2",
    pl_trainer_kwargs={"accelerator": "cpu"},
)
model.fit(series=series)
forecast = model.predict(n=24, predict_likelihood_parameters=True)
pred_darts = forecast.to_dataframe().reset_index().rename(
    columns={
        "利用台数_q0.100": "0.1",
        "利用台数_q0.500": "0.5",
        "利用台数_q0.900": "0.9",
    }
)
pred_darts["時系列ID"] = "自転車シェアリング"
context_df
2011年1月3日01:00から04:00では、02:00と03:00は行がありません。利用台数です。
| 日時 | 元データ 予測対象(利用台数) | chronos-forecasting(内部前処理なし) |
Darts(内部前処理あり) |
AutoGluon-TimeSeries(内部前処理あり) |
|---|---|---|---|---|
| 2011-01-03 01:00:00 | 2 | 2 | 2 | 2 |
| 2011-01-03 02:00:00 | 行なし | 行なし | NaN | NaN |
| 2011-01-03 03:00:00 | 行なし | 行なし | NaN | NaN |
| 2011-01-03 04:00:00 | 1 | 1 | 1 | 1 |
予測結果
過去の17,355行を、行がないまま渡すと、chronos-forecastingだけ予測が異なります。
AutoGluon-TimeSeriesとDartsは一致します。
| 方法 | MAE(台) | RMSE(台) | MAPE |
|---|---|---|---|
chronos-forecasting |
36.62 | 54.12 | 86.71% |
AutoGluon-TimeSeries |
62.21 | 93.19 | 128.39% |
Darts |
62.21 | 93.19 | 128.39% |
グラフはこちら
import japanize_matplotlib
import matplotlib.dates as mdates
import matplotlib.pyplot as plt

history = context_df.tail(48)
actual_df = df[df["日時"] >= prediction_start][["時系列ID", "日時", "利用台数"]].copy()
observed = pd.concat(
    [history[["日時", "利用台数"]], actual_df[["日時", "利用台数"]]],
    ignore_index=True,
).sort_values("日時")

forecast_colors = {
    "chronos-forecasting": "#d62728",
    "AutoGluon-TimeSeries": "#1f77b4",
    "Darts": "#ff7f0e",
}
preds = [
    (pred_chronos, "chronos-forecasting"),
    (pred_autogluon, "AutoGluon-TimeSeries"),
    (pred_darts, "Darts"),
]

fig, ax = plt.subplots(figsize=(14, 6), dpi=100)
ax.plot(
    observed["日時"],
    observed["利用台数"],
    label="実測値",
    color="black",
    marker="o",
    markersize=3,
)
for pred_df, method_name in preds:
    ax.plot(
        pd.to_datetime(pred_df["日時"]),
        pred_df["0.5"],
        label=method_name,
        color=forecast_colors[method_name],
        marker="o",
        markersize=4,
    )
ax.axvline(prediction_start, color="gray", linestyle="--", label="予測開始")
ax.set_xlim(observed["日時"].min(), observed["日時"].max())
ax.set(title="欠損値処理前", xlabel="日時", ylabel="利用台数(台)")
ax.xaxis.set_major_formatter(mdates.DateFormatter("%m/%d %H:%M"))
ax.grid(alpha=0.3)
ax.legend()
plt.xticks(rotation=45)
plt.tight_layout()
fig.savefig("行がないままの24時間予測.png")
欠損値処理後
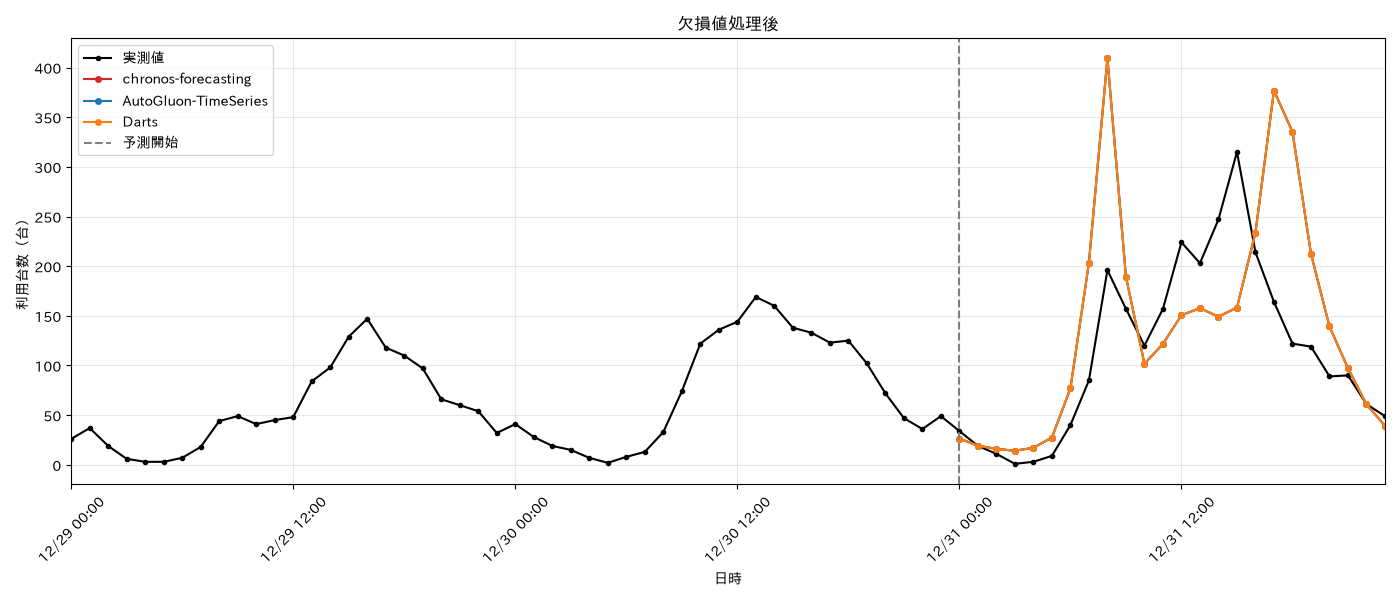
前処理は、1時間ごとの行を足すことです。過去は17,520行になり、なかった165時間の利用台数はNaNです。共変量は使いません。context_dfを、3つのパッケージへ渡します。
observed = context_df.set_index("日時")[["利用台数"]]
context_index = pd.date_range(observed.index.min(), observed.index.max(), freq="h")
hourly = observed.reindex(context_index)
context_df = (
    hourly.rename_axis("日時")
    .reset_index()
    .assign(時系列ID="自転車シェアリング")[["時系列ID", "日時", "利用台数"]]
)
chronos-forecasting
from chronos import Chronos2Pipeline

pipeline = Chronos2Pipeline.from_pretrained(
    "amazon/chronos-2",
    device_map="cpu",
)

pred_chronos = pipeline.predict_df(
    df=context_df,
    prediction_length=24,
    quantile_levels=[0.1, 0.5, 0.9],
    id_column="時系列ID",
    timestamp_column="日時",
    target="利用台数",
    freq="h",
)
AutoGluon-TimeSeries
from autogluon.timeseries import TimeSeriesPredictor

train = context_df.rename(
    columns={"時系列ID": "item_id", "日時": "timestamp"}
)

predictor = TimeSeriesPredictor(
    prediction_length=24,
    target="利用台数",
    freq="h",
    quantile_levels=[0.1, 0.5, 0.9],
).fit(
    train_data=train,
    hyperparameters={"Chronos2": {"model_path": "amazon/chronos-2"}},
)

pred_autogluon = (
    predictor.predict(data=train)
    .reset_index()
    .rename(columns={"item_id": "時系列ID", "timestamp": "日時"})
)
Darts
from darts import TimeSeries
from darts.models import Chronos2Model
from darts.utils.likelihood_models import QuantileRegression

series = TimeSeries.from_dataframe(
    df=context_df.assign(利用台数=context_df["利用台数"].astype("float32")),
    time_col="日時",
    value_cols="利用台数",
    freq="h",
)
model = Chronos2Model(
    input_chunk_length=8192,
    output_chunk_length=24,
    likelihood=QuantileRegression(quantiles=[0.1, 0.5, 0.9]),
    hub_model_name="amazon/chronos-2",
    pl_trainer_kwargs={"accelerator": "cpu"},
)
model.fit(series=series)
forecast = model.predict(n=24, predict_likelihood_parameters=True)
pred_darts = forecast.to_dataframe().reset_index().rename(
    columns={
        "利用台数_q0.100": "0.1",
        "利用台数_q0.500": "0.5",
        "利用台数_q0.900": "0.9",
    }
)
pred_darts["時系列ID"] = "自転車シェアリング"
context_df
2011年1月3日01:00から04:00では、02:00と03:00に行を足しています。利用台数はNaNのままです。
| 日時 | 元データ 予測対象(利用台数) | chronos-forecasting(内部前処理なし) |
Darts(内部前処理なし) |
AutoGluon-TimeSeries(内部前処理なし) |
|---|---|---|---|---|
| 2011-01-03 01:00:00 | 2 | 2 | 2 | 2 |
| 2011-01-03 02:00:00 | NaN | NaN | NaN | NaN |
| 2011-01-03 03:00:00 | NaN | NaN | NaN | NaN |
| 2011-01-03 04:00:00 | 1 | 1 | 1 | 1 |
予測結果
予測結果は3つのパッケージ共に小数第2位まで同じであることがわかりました。
| 方法 | MAE(台) | RMSE(台) | MAPE |
|---|---|---|---|
chronos-forecasting |
62.21 | 93.19 | 128.39% |
AutoGluon-TimeSeries |
62.21 | 93.19 | 128.39% |
Darts |
62.21 | 93.19 | 128.39% |
グラフはこちら
import japanize_matplotlib
import matplotlib.dates as mdates
import matplotlib.pyplot as plt

history = context_df.tail(48)
actual_df = df[df["日時"] >= prediction_start][["時系列ID", "日時", "利用台数"]].copy()
observed = pd.concat(
    [history[["日時", "利用台数"]], actual_df[["日時", "利用台数"]]],
    ignore_index=True,
).sort_values("日時")

forecast_colors = {
    "chronos-forecasting": "#d62728",
    "AutoGluon-TimeSeries": "#1f77b4",
    "Darts": "#ff7f0e",
}
preds = [
    (pred_chronos, "chronos-forecasting"),
    (pred_autogluon, "AutoGluon-TimeSeries"),
    (pred_darts, "Darts"),
]

fig, ax = plt.subplots(figsize=(14, 6), dpi=100)
ax.plot(
    observed["日時"],
    observed["利用台数"],
    label="実測値",
    color="black",
    marker="o",
    markersize=3,
)
for pred_df, method_name in preds:
    ax.plot(
        pd.to_datetime(pred_df["日時"]),
        pred_df["0.5"],
        label=method_name,
        color=forecast_colors[method_name],
        marker="o",
        markersize=4,
    )
ax.axvline(prediction_start, color="gray", linestyle="--", label="予測開始")
ax.set_xlim(observed["日時"].min(), observed["日時"].max())
ax.set(title="欠損値処理後", xlabel="日時", ylabel="利用台数(台)")
ax.xaxis.set_major_formatter(mdates.DateFormatter("%m/%d %H:%M"))
ax.grid(alpha=0.3)
ax.legend()
plt.xticks(rotation=45)
plt.tight_layout()
fig.savefig("予測対象が欠損した24時間予測.png")