会議室などの残響はNVIDIA RE-USEで除去して音声認識に効果があるのか試してみた

こんちには。製造ビジネステクノロジー部の中村(@nokomoro3)です。
前回の記事では、NVIDIAの音声強調モデル「NemotronLabs RE-USE」を紹介し、公式実装をNVIDIA L40Sで動かしました。
RE-USEは雑音や残響などの劣化をまとめて取り除くモデルですが、音声認識(ASR)の前処理としての効果は、条件によって分かれることがわかってきています。
speech.cppのモデルページでは、RE-USEをASRの前処理に使った評価が公開されています。
強い雑音(SNR 0dB)を加えた音声では、parakeet-tdt-0.6b-v3やreazonspeech-v2で誤りが約1割減った一方、改善の幅は1ポイント以内にとどまっています。
また、雑音を加えていない日本語のテレビ番組の音声(ReazonSpeechのデータセット)では、文字誤り率(CER)が4.69%から8.36%に悪化したと報告されています。
音楽やほかの話者の声と一緒に、短い相づちや本来の話者の声まで消えてしまう現象があったためです。
RE-USEのモデルの機能としては残響の除去もうたわれていますが、speech.cppの評価は加法性の雑音が中心で、残響(壁や天井で反射した音声自身が、遅れて重なる劣化)での評価は含まれていません。
会議の音声を文字起こしして議事録を作る場面は増えていますが、会議室の机に置いたマイクで録音した音声は、壁や天井からの反射で響きが乗りやすくなります。
この響きは、文字起こしの誤りが増える原因になります。
そこで本記事では、日本語の読み上げ音声に会議室を想定した残響を付け、RE-USEで処理した前後で、3つのASRの認識精度を比べました。
結論
- RE-USEの効果の確認(残響のある音声)
- 残響が強いほど、どのASRでもCERが悪化した(RT60 1.0秒で、Whisper large-v3は4.49%から8.05%)
- RE-USEをかけると、どの残響の強さでも、CERが元の音声に近い値まで戻った(RT60 1.0秒で、Whisper large-v3は5.07%)
- ReazonSpeech K2 v2は、RE-USEをかけるとすべての条件で元の音声より良くなった
- 副作用の確認(残響のない音声の評価)
- RE-USEをかけても、どのASRでも悪化しなかった
検証用コード
検証に使用したスクリプトと集計結果は以下のリポジトリにあります。
実験の方法
比べる条件
日本語の音声には、以前のASR比較の記事と同じく、FLEURSの日本語テストセット(ja_jp test、650件、合計約2.4時間、CC BY 4.0)を使いました。
比べたのは、次の8つの条件です。
| 条件 | 内容 |
|---|---|
| 元音声 | FLEURSの音声そのまま |
| 元音声+RE-USE | 元音声にRE-USEをかけたもの(残響がないときに悪化しないかの確認) |
| RT60 0.3秒 | 元音声に、響きの少ない会議室を想定した残響を付けたもの |
| RT60 0.6秒 | 一般的な会議室を想定した残響を付けたもの |
| RT60 1.0秒 | 響きの多い会議室を想定した残響を付けたもの |
| それぞれ+RE-USE | 残響付きの音声にRE-USEをかけたもの |
RT60は、音が止まってから60dB小さくなるまでの時間で、部屋の響きの長さを表す値です。
残響の作り方
残響は、Pythonの音響シミュレーションライブラリであるpyroomacousticsで作りました。
部屋のインパルス応答(RIR)は、部屋の中のある位置で鳴らした短いパルス音が、別の位置のマイクにどう届くかを表す波形です。
元音声にRIRを畳み込むことで、その部屋で録音したような残響付きの音声になります。
pyroomacousticsは、部屋の大きさ、壁の吸音率、音源とマイクの位置を指定すると、RIRをシミュレーションで計算してくれます。
直方体の部屋では、鏡像法(image source method)を使います。
壁で反射した音を、壁の向こう側に置いた「鏡像の音源」から直接届いた音とみなし、反射の回数ごとに鏡像を並べて足し合わせる方法です。
今回のRIRの計算は、おおむね以下の流れです。
スクリプトの全体は、リポジトリの scripts/make_reverb.py にあります。
import pyroomacoustics as pra

# RT60の設計値から、壁の吸音率と、計算する反射の最大回数を求める
# (設計値は、実測のRT60が目標に合うよう較正した値。後述)
e_absorption, max_order = pra.inverse_sabine(design_rt60, room_dim)

room = pra.ShoeBox(room_dim, fs=16000, materials=pra.Material(e_absorption), max_order=max_order)
room.add_source(source_position)
room.add_microphone(mic_position)
room.compute_rir()  # 鏡像法でRIRを計算する
rir = room.rir[0][0]

# できたRIRのRT60を、減衰の曲線から実測する
measured = pra.experimental.measure_rt60(rir, fs=16000)
部屋とマイクの配置は以下のとおりです。
- 部屋の大きさ:7×5×3m(8〜10人程度の会議室を想定)
- マイク:部屋の中央付近の机の上(高さ0.75m)
- 話者:机を囲んで座った人の口の高さ(1.2m)で、マイクから1〜3m
- RIRの本数:RT60ごとに20本(話者とマイクの位置を変えたもの)。発話ごとに、乱数の種を固定して1本を割り当てる
RE-USEは、DNS ChallengeのシミュレーションRIRを学習に使っています。
今回は別のシミュレータでRIRを作ったので、学習データと同じRIRではありません。
壁の吸音率は、目標のRT60からSabineの残響式で逆算しています。
Sabineの残響式は、部屋の体積をV(m³)、壁の面積をS(m²)、平均の吸音率をαとしたとき、RT60を次の式で近似するものです。
RT60 ≈ 0.161 × V / (S × α)
pra.inverse_sabine は、この式を逆に解いて吸音率を求めます。
ただし、その吸音率で鏡像法のシミュレーションを行うと、実際に測ったRT60は目標の約1.3〜1.6倍になりました(目標0.3、0.6、1.0秒に対して、実測0.39、0.90、1.58秒)。
Sabineの残響式は部屋の中で音が均一に拡散していることを仮定した近似なので、鏡像法で計算した直方体の部屋の減衰とはずれが出ると考えられます。
そこで、目標と実測の比で設計値を縮める操作を4回繰り返し、実測のRT60を目標に合わせました。
| 目標のRT60 | 実測のRT60(20本の中央値) | 実測の範囲 |
|---|---|---|
| 0.3秒 | 0.307秒 | 0.300〜0.319秒 |
| 0.6秒 | 0.602秒 | 0.581〜0.625秒 |
| 1.0秒 | 0.995秒 | 0.978〜1.034秒 |
時間方向の正規化として、RIRで残響を付けた音声は、RIRの直接音が届く位置で時間を合わせ、元音声と同じ長さに切りました。
振幅方向の正規化として、発話区間のRMSが元音声と同じになるように音量をそろえています。
ただし、音量をそろえると一部の音声でピークが上限を超え、クリッピングが起きてしまいます。
そのような音声は、クリッピングが起きないところまで全体の音量を下げました(そのため、元音声のほうがRMSが大きい音声もあります)。
RE-USEとASRの設定
RE-USEは前回の記事と同じく nvidia/NVIDIA-NemotronLabs-RE-USE の公式実装をFP32で動かしました(revision 31f82f2)。
前処理後のASRは、以下のASR比較の記事で精度の高かった次の3つを選びました。
| ASR | ランタイム |
|---|---|
| Whisper large-v3 | faster-whisper(CTranslate2) |
| Parakeet TDT-CTC 0.6B(日本語) | NVIDIA NeMo |
| ReazonSpeech K2 v2 | sherpa-onnx |
設定とスクリプトは、ASR比較の記事のものをそのまま使っています。
認識はバッチサイズ1、greedy decodeで、評価指標はASR比較の記事と同じ正規化CER(句読点や表記の揺れの一部をそろえてから計算した文字誤り率)です。
評価方法
あわせて、元音声と比べた音声の近さとして、PESQ(広帯域)とSTOIも計算しました。
どちらも、劣化した音声と基準の音声(今回は元音声)を比べて点数を出す指標です。
- PESQ:聞いた印象の品質を推定する指標で、ITU-Tの勧告P.862として規格化されている。今回使った広帯域版(P.862.2)の値は、約1.0〜4.6の範囲をとる
- STOI:聞き取りやすさ(了解度)を推定する指標で、0〜1の範囲をとる
どちらも、大きいほど元音声に近いことを表します。
計算には、PythonのパッケージであるpesqとpystoiをCPUで使いました。
規格と論文は以下のとおりです。
- PESQの規格:ITU-T P.862
- PESQの広帯域版(今回使用)の規格:ITU-T P.862.2
- STOIの論文:C. H. Taal et al., "An Algorithm for Intelligibility Prediction of Time–Frequency Weighted Noisy Speech," IEEE TASLP, 2011
実行環境
Brevのインスタンス
実行環境には、ASR比較の記事で使ったNVIDIA Brevのインスタンス(l40s-48gb.1x、L40S 1基)を再利用しました。
停止していたインスタンスを起動し、接続します。
brev start cm-nakamura-asr-benchmark
brev shell cm-nakamura-asr-benchmark
このインスタンスには、ASR比較の記事のときの環境がそのまま残っています。
~/workspace/asr-benchmark/work/fleurs-ja_jp-test/audio/:FLEURSの音声(650件、16kHzのWAV)~/workspace/asr-benchmark/manifests/fleurs-ja_jp-test.jsonl:音声のパスと正解の文字列を並べたマニフェスト~/workspace/asr-benchmark/work/.venv/:ASRを実行する仮想環境
今回は、このASRの環境には手を加えず、RE-USEの実行環境を別の仮想環境として追加しました。
RE-USEが使うtorchとmamba_ssmのバージョンが、ASR側の環境と衝突しないようにするためです。
RE-USEの実行環境の追加
RE-USEの実行環境は、RE-USEの紹介記事と同じ手順で作ります(scripts/gpu/setup_brev.sh)。
- uvが管理するPython 3.10で、仮想環境
work/.venv-gpuを作る - PyTorch 2.6.0(CUDA 12.4版)と、mamba_ssm 2.2.4、causal-conv1d 1.5.0.post8のビルド済みwheelを、1回の
uv pip installでまとめて入れる - RE-USEのリポジトリ一式を、revisionを固定してダウンロードする
この組み合わせにした理由(torchが意図せず新しい版に上がる問題など)は、RE-USEの紹介記事で説明しています。
今回はこれに加えて、残響の付与とPESQ、STOIの計算に使うpyroomacoustics、pesq、pystoiを同じ仮想環境に入れました。
手元とBrevのファイルのやり取り
スクリプトは手元で書き、Brevへ送って実行しました。
# 手元 → Brev:scripts/ を ~/re-use-reverb-asr に送る(中身は brev exec と brev copy)
bash scripts/host/sync_to_brev.sh
結果は、Brevが手元に作るSSHの設定を使って、rsyncで取ってきました。
接続先のホスト名が見つからないと言われた場合は、brev refresh でSSHの設定を更新します。
# Brev → 手元:集計に使う結果をまとめて取ってくる
rsync -az cm-nakamura-asr-benchmark:/home/ubuntu/re-use-reverb-asr/results/ results/
音声ファイル(残響付きの音声とRE-USEの出力)はBrev上に残し、手元には集計に必要な結果だけを持ってきています。
パイプラインの中身
残響の付与からCERの計算までは、scripts/run_pipeline.sh で通して実行しました。
brev exec cm-nakamura-asr-benchmark "cd ~/re-use-reverb-asr && bash scripts/run_pipeline.sh"
中では、次の6つの手順を順に行います。
| 手順 | 内容 | 主な出力 |
|---|---|---|
| setup | RE-USEの仮想環境を作り(初回のみ)、pyroomacoustics、pesq、pystoiを入れる | work/.venv-gpu/ |
| reverb | ASRの環境にあるFLEURSのマニフェストを読み、RT60ごとに残響付きの音声とマニフェストを作る | work/reverb/rt60_*/ |
| enhance | 元音声と3つの残響付き音声の計4条件にRE-USEをかけ、処理後の音声を指すマニフェストを作る | work/reverb/*/reuse/ |
| quality | 元音声と比べて、PESQとSTOIを計算する | results/quality/ |
| asr | 8条件それぞれについて、マニフェストだけを差し替えた設定ファイルを作り、ASR比較の記事の run_matrix.py で3つのASRを実行する |
results/asr/ |
| cer | ASR比較の記事の calculate_cer.py で、正規化CERを計算する |
results/cer/ |
ASRの実行にはASR側の仮想環境のPythonを、それ以外にはRE-USE側の仮想環境のPythonを使い分けています。
途中で止まった場合は、STEPS="asr cer" のように環境変数で手順を指定すると、その手順からやり直せます。
所要時間は、RE-USEの処理が1条件あたり約5分、ASRの認識(8条件×3構成)が約45分でした。
後片付け
実験が終わったら、インスタンスを停止します。
brev stop cm-nakamura-asr-benchmark
停止中もディスクは残るので、次に brev start で起動すれば、同じ環境のまま再開できます。
結果
正規化CER
| 条件 | Whisper large-v3 | Parakeet TDT-CTC 0.6B | ReazonSpeech K2 v2 |
|---|---|---|---|
| 元音声 | 4.49% | 5.94% | 9.40% |
| 元音声+RE-USE | 4.48% | 5.76% | 8.29% |
| RT60 0.3秒 | 4.92% | 6.03% | 9.99% |
| RT60 0.3秒+RE-USE | 4.57% | 5.71% | 8.37% |
| RT60 0.6秒 | 5.91% | 6.53% | 10.64% |
| RT60 0.6秒+RE-USE | 4.88% | 5.81% | 8.45% |
| RT60 1.0秒 | 8.05% | 7.74% | 12.69% |
| RT60 1.0秒+RE-USE | 5.07% | 6.01% | 8.65% |
元音声のCERは、ASR比較の記事の値(4.49%、5.94%、9.40%)と一致しています。
残響が強くなるほど、どのASRが後段でもCERは悪化しました。
RT60 1.0秒では、Whisper large-v3が3.6ポイント、ReazonSpeech K2 v2が3.3ポイント悪くなっています。
RE-USEをかけると、どの残響の強さでも、CERは元音声に近い値まで戻りました。
RT60 1.0秒でも、Whisper large-v3は5.07%、Parakeetは6.01%で、元音声との差は0.6ポイント以内です。
ReazonSpeech K2 v2は、RE-USEをかけるとすべての条件で元音声(9.40%)より良くなりました。
また副作用の確認として残響のない元音声にRE-USEをかけても、どのASRでも悪化しませんでした。
speech.cppの報告では、FLEURSを録音のまま使った条件で、reazonspeech-v2はわずかに改善し(6.34%→6.01%)、Qwen3-ASR 1.7Bはわずかに悪化しています(5.33%→5.48%)。
今回の結果は、このうちreazonspeech-v2の結果と一致しています。
認識結果の例
RT60 1.0秒の残響で、Whisper large-v3の誤りが大きく増え、RE-USEで元に戻った例です。
| 条件 | 認識結果 | CER |
|---|---|---|
| 元音声 | カレーはハーブやスパイスをベースに肉や野菜を煮込む料理です | 0% |
| RT60 1.0秒 | カレーはハーブやスパイスを入れすり、イカや野菜を煮込む料理です。 | 20.7% |
| RT60 1.0秒+RE-USE | カレーはハーブやスパイスをベースに肉や野菜を煮込む料理です。 | 0% |
残響で「ベースに肉や」が「入れすり、イカや」になりましたが、RE-USEをかけると元音声と同じ認識結果に戻りました。
この発話のスペクトログラムを並べたものが以下です。
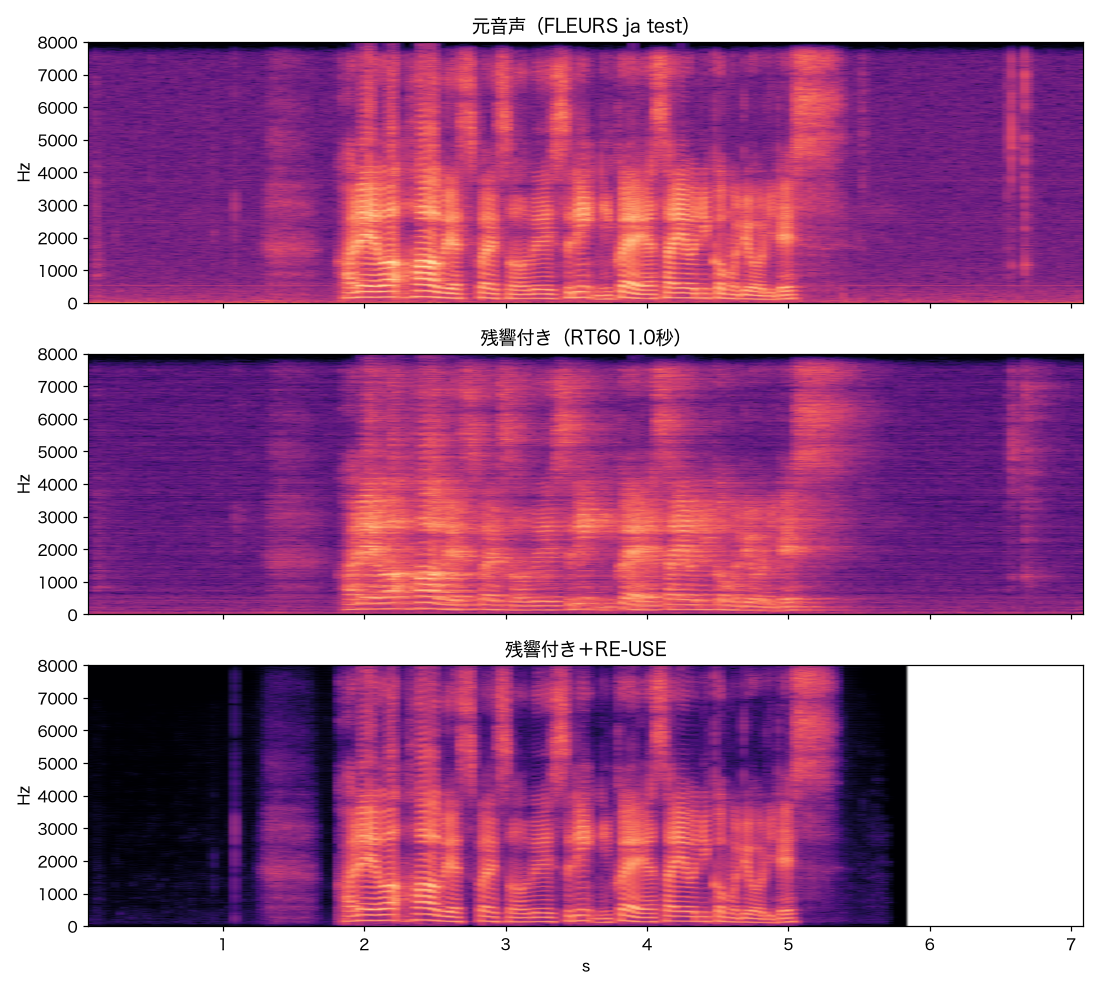
残響付きの音声では、音節のあいだや発話の終わりに響きが尾を引き、横方向ににじんでいます。
RE-USEをかけると、このにじみがなくなり、音節の区切りがはっきりしています。
PESQとSTOI
| 条件 | PESQ | STOI |
|---|---|---|
| 元音声+RE-USE | 2.16 | 0.759 |
| RT60 0.3秒 | 2.41 | 0.769 |
| RT60 0.3秒+RE-USE | 1.77 | 0.742 |
| RT60 0.6秒 | 1.82 | 0.638 |
| RT60 0.6秒+RE-USE | 1.71 | 0.728 |
| RT60 1.0秒 | 1.52 | 0.540 |
| RT60 1.0秒+RE-USE | 1.66 | 0.714 |
PESQは約1.0〜4.6、STOIは0〜1の範囲をとり、どちらも大きいほど元音声に近いことを表します。
PESQの範囲が半端なのは、内部で計算した点数を、聴取試験の5段階評価(MOS)に近づける関数で変換しているためです。
この関数の出力は1や5にちょうど届かず、広帯域版では約1.04〜4.64になります。
STOIは、残響が強いほどRE-USEで大きく改善しました。
RT60 1.0秒では0.540から0.714に上がり、「元音声+RE-USE」の0.759に近づいています。
一方でPESQは、最も強いRT60 1.0秒でだけ上がり、RT60 0.3秒と0.6秒ではRE-USEをかけると下がりました。
ただし、この2つの指標は割り引いて見る必要があります。
基準にしたFLEURSの元音声は、完全にきれいな音声ではなく、録音環境の雑音や響きを含んでいます。
RE-USEはそれらも取り除くので、残響の有無にかかわらず、出力は元音声から離れます。
残響のない元音声にRE-USEをかけても、PESQが2.16、STOIが0.759となるのはこのためです。
実際、「元音声+RE-USE」でSTOIが特に低かった65件(下位10%)は、RE-USEでCERがむしろ改善していました(Whisper large-v3で4.85%→3.68%、ReazonSpeech K2 v2で8.11%→6.44%)。
STOIが低いのは音声が壊れたからではなく、元の録音の雑音や響きが取り除かれ、基準から離れたためと考えられます。
ファイルごとの悪化と改善
一方、平均ではCERが改善してもすべてのファイルで改善するわけではありません。
RE-USEの前後で、正規化CERが5ポイント以上動いたファイルの件数を数えました(悪化/改善)。
| ASR | 元音声 | RT60 0.3秒 | RT60 0.6秒 | RT60 1.0秒 |
|---|---|---|---|---|
| Whisper large-v3 | 18/18 | 27/40 | 22/71 | 21/171 |
| Parakeet TDT-CTC 0.6B | 11/17 | 15/26 | 27/55 | 26/114 |
| ReazonSpeech K2 v2 | 19/42 | 17/69 | 22/102 | 29/196 |
どの条件でも11〜29件のファイルが悪化していますが、残響が強いほど、改善したファイルのほうがはっきり多くなります。
悪化したファイルを調べると、次のことがわかりました。
- 3つのASRで共通して悪化したファイルは、各条件で0〜1件しかない。RE-USEが特定の音声を壊しているのではなく、ASRごとのばらつきに近い
- 同じ語句を繰り返す疑いのある認識結果は、0件だった
- RT60 1.0秒では、ReazonSpeech K2 v2とParakeetで、文字の脱落(削除の誤り)が増えていた。Whisper large-v3は置換の誤りが中心
- 悪化した例には、「1つ」と「一つ」のような表記の揺れや、「章」が「ショー」になるような置換も含まれる
まとめ
日本語の読み上げ音声に会議室を想定した残響を付け、NVIDIAのRE-USEで処理した前後で、3つのASRの認識精度を比べました。
残響が強いほどCERは悪化しましたが、RE-USEをかけると、どのASRでも元の音声に近い精度まで戻りました。
残響のない音声にかけても悪化しなかったので、少なくとも響きの多い部屋で1人が話す音声に対しては、ASRの前処理として使いやすいモデルだと言えそうです。
加法性の雑音に対しては、先行結果を見る限り、改善が最大1ポイント程度にとどまるうえ、実際の音声では悪化もしていて、ASRの前処理としてのメリットは限定的です。
RE-USEをASRの前処理に使うなら、雑音よりも残響が問題になる場面が向いています。
ただし、実際の会議の録音には雑音と複数の話者も含まれるので、導入する前には、そうした音声でも確かめるのがよいと思います。
本記事がご参考になれば幸いです。