OpenJev を読んで、生成しない AI の別解を考えてみた

はじめに
こんにちは、クラスメソッド製造ビジネステクノロジー部の森茂です。
TypeSafe AI が 2026 年 9 月 15 日に発表した Jev、気になっている方も多いのではないでしょうか。チャットも文章生成もしません。あらかじめ渡した選択肢から選ぶ、基準に沿って採点する、はいかいいえかの確率を返す。この 3 つだけをプログラムから呼べる形で提供するモデルです。
発表から 3 日ほどで、GitHub と Hugging Face には OpenJev を名乗る実装がいくつも並びました。名前は同じでも、読んでみると中身がまるで違います。既存のモデルに何も足さず使い方だけを変えたものもあれば、判断のためにモデルを学習し直したものもある。この違いをもう少し丁寧に確かめたくなりました。
先日、LLM ルーターの判定役を 2 種類比べました。判定を文章として生成させる judge と、依頼文を読み込んだ時点の内部状態から振り分け先を決める NeMo Switchyard の prefill router です。そのとき、judge の弱点はどれも、文章を書かせているという 1 点から出ている、と書きました(2026-08-22 時点の記事です)。書かせるのをやめる、という発想をルーターの世界で見ていたことになります。
この記事では、Jev の紹介は短く済ませ、OpenJev が Jev の何を再現していて、何を再現していないのかを、公開されているコードと数値、それから DGX Spark での日本語の軽い実測から紹介します。エージェントやルーターの判断部分を小さく切り出したい人に刺さるといいなと思っています。
Jev が出した問いをおさらいする
Jev は、TypeSafe AI が System One Model と呼ぶ種類の最初のモデルです。使い方は普通の LLM と少し違っていて、判断の材料になる文章(state)と質問、それに選択肢や採点基準を渡すと、答えと確率が型の決まった値で返ってきます。質問の種類は次の 3 つです。
| 種類 | 返すもの | 使いどころの例 |
|---|---|---|
| Choice | 候補ごとの確率と、選ばれた候補、confidence | この問い合わせは技術と請求と営業のどれが担当か |
| Score | 言葉で定義した順序つきの段階に沿った採点 | この不具合は軽微か、中程度か、重大か |
| Noul | はいである確率を 0 から 1 で | このメッセージは返金を求めているか |
料金は入力 100 万トークン(モデルが文章を処理する単位)あたり 0.042 ドルで、出力は無料。現行の jev-1.13.0 はテキストだけを受け取り、顧客ごとのファインチューニングはありません。応答までの時間は、公式の値で 70〜500 ミリ秒です。
学習方法は RLCD(Reinforcement Learning for Calibrated Decisions)と呼ばれています。狙いは正しい候補を選ぶことに加えて、返した確率を実際の頻度に近づけることです。天気予報にたとえると分かりやすいかもしれません。降水確率 80% と言った日を集めたら、実際に 8 割くらい雨が降っている。そういう予報は数字をそのまま信じて傘を持つかどうか決められます。これを確率の校正と呼びます。
ここで混同しやすい点が 2 つあります。1 つは confidence です。これは確率の分布がどれだけ 1 つの候補に集中しているかを表す値で、その答えが正しい確率ではありません。3 択で 0.34 と 0.33 と 0.33 のように割れていれば confidence は低くなる、という種類の数字です。
もう 1 つは、ハルシネーションゼロという売り文句の読み方です。Jev が保証しているのは、返ってくる値が指定した型から外れないことです。選択肢を keep と delete の 2 つにすれば、3 つ目の操作が返ってくることはありません。ただし、残すべきものに delete を選ぶ可能性まで消えるわけではない。型は決定的でも、判断の中身は確率です。公式の制約ページも正直で、Jev は計算機ではなく数え上げや日付の比較が苦手なこと、state に紛れ込んだ指示に流されうること、Noul で調整したしきい値を Choice にそのまま持ち込めないことを明記しています。
日本語で使う場合の注意も 1 つ。公式のモデル一覧には、英語が主で、日本語を含む CJK は対応しているものの精度は落ちる、導入前に自分のデータで検証してほしい、と書かれています。
ここまでが Jev の概要です。この記事で追いかけたいのは Jev が出した問いのほうで、プログラムが欲しいのが A か B かだけなら、LLM に文章や JSON を書かせる必要はあるのか、というものです。
OpenJev の名前で、異なる実装が公開されている
最初に押さえておきたいのは、OpenJev は Jev の公式オープンソース版ではない、という点です。TypeSafe はモデルの重みも学習方法の詳細も公開していません。OpenJev は、Jev の考え方や入出力の形を、手に入るオープンモデルで試している独立したプロジェクト群の総称に近いものです。2026 年 9 月 18 日時点で確認できた主な実装を並べます。
| 実装 | やり方 | 土台のモデルと実行環境 | 追加の学習 |
|---|---|---|---|
| TheoLeeCJ/openjev | 候補に対応するトークンの点数を直接読む。共通の state を使い回す | Qwen3.5-4B、RTX 3090。ブラウザ版もある | なし |
| AlexWortega/openjev | 前提と仮説の関係を 3 つに分類するモデルへ学習し直す | Qwen3.5-4B | あり |
| ekzhang/openjev-sglang | Jev と同じ形の API サーバー。質問ごとに 1 トークンぶんだけ読む | Qwen3.6-35B-A3B の NVFP4、SGLang、B200 | なし |
| daseinlabs/open-jev | 候補の文字列のもっともらしさをまとめて採点する。Jev 互換の API つき | Gemma 3 4B、Apple Silicon の MLX | なし |
| rorshopping/jev-on-a-laptop | 文脈を 1 回読み、項目ごとに点数を直接読んで JSON を組み立てる | Qwen2.5 の 1.5B と 7B、Qwen3-8B | なし |
| vinnylarouge/jevlike | 候補を採点する小さなモデルを学習する。文章を読む部分は自作か、凍結した既存モデル | 自前の小型モデル、または Qwen2.5-0.5B | あり |
| zhihz/openjev | 質問ごとに次のトークンの分布を 1 回読む。英語と中国語の画面 | Qwen3-4B-Instruct-2507 | なし |
Jev との関係を明記している作者は、どちらも慎重です。TheoLeeCJ 版の README は、再現したのは interface pattern、つまり入出力の型であって、非公開のモデルや学習ではないと書いています。zhihz 版に至っては、この名前は Jev の公式なオープンソース版を意味しない、とまで断っています。
表を眺めると、やり方は大きく 2 つに分かれます。既存のモデルに手を加えず、読み出し方だけを変える流派。そして、判断のためにモデルを学習する流派です。この記事では、前者の代表として TheoLeeCJ 版を、後者の代表として AlexWortega 版を読んでいきます。
まずブラウザで動かして、生成しない判断を見てみる
仕組みの話に入る前に、動くものを見ておきます。TheoLeeCJ 版にはブラウザだけで動くデモがあり、登録も待機リストもありません。
モデルを 1 つ選んで読み込ませ、state と質問と選択肢を入れて実行すると、同じモデルに同じ問題を 2 通りのやり方で解かせてくれます。片方は Direct readout で、文字を 1 つも生成せずに選択肢の確率だけを読み出します。もう片方は Generation で、確率の分布を JSON として 1 トークンずつ書かせます。
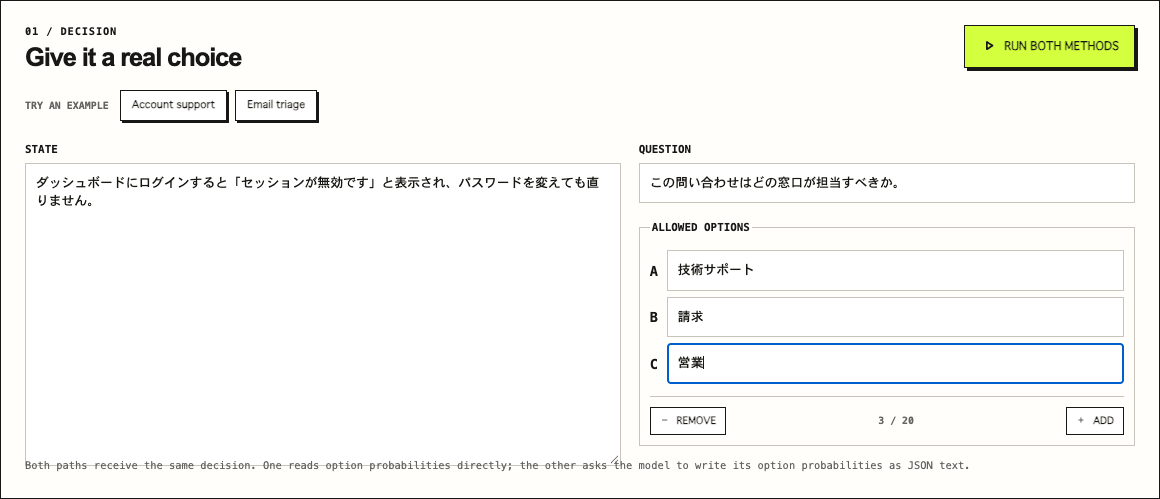
state と質問と選択肢を入れる画面。ここでは自作の日本語の問い合わせを入れた。右上の RUN BOTH METHODS で 2 つの経路が順番に走る。
デスクトップの既定は MiniCPM5 2B の量子化版で、ダウンロードは 1.56 GB です。日本語の問い合わせを入れて実行した結果がこちらです。
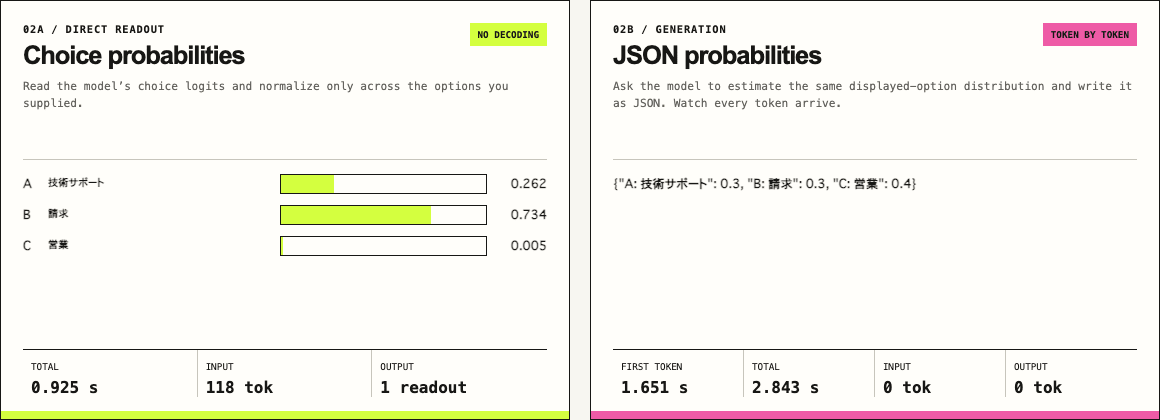
左が点数を直接読んだ結果、右が JSON を書かせた結果。この回は直接読むほうが 0.925 秒、書かせるほうが 2.843 秒で、サイトの表示は 3.07 倍だった(2026-09-18、Chrome 153、1 回の測定)。
同じモデルなのに、片方は書かずに答え、片方は書いて答える。Jev の問いが目に見える形になっています。
ログインできないという問い合わせなので、自分が付けた正解は技術サポートです。点数を直接読んだ側は請求に 0.734 を付け、JSON を書かせた側は営業に 0.4 を付けました。どちらも外していて、2 つの経路の答えも食い違っています。20 億パラメータの量子化モデルに日本語を読ませた 1 回の結果なので、これで何かを結論づけるつもりはありません。サイト自身も、表示されるスコアは並べた候補トークンだけで計算した値で校正された確信度ではないこと、どのモデルも Jev に匹敵するとは主張していないこと、量子化で品質も速度も変わることを注意書きにしています。なお、同じ問いを後の章の方法で Jev に投げると、3 回とも技術サポートを確率 1 で返しました。
生成モデルから、生成せずに判断を取り出す仕組み
TheoLeeCJ 版は何をしているのでしょうか。新しいモデルを作ったわけではありません。Qwen3.5-4B をそのまま、追加の学習なしで使っています。変えたのは読み出し方だけです。
LLM が文章を書くとき、内部では 1 トークン進むごとに、語彙に含まれるすべてのトークンに点数を付けています。次に来そうなトークンほど点数が高い。この点数を logits と呼びます。普段はこの点数表から 1 つ選んで書き足し、また点数表を作り、と繰り返して文章ができあがります。
マークシートの試験にたとえてみます。JSON を書かせるやり方は、受験者に各問の答えを順番に書き出してもらうようなものです。TheoLeeCJ 版は、受験者が問題を読み終えて A と B と C のどれを塗ろうか迷っているその瞬間の、心の中の傾き具合を覗きます。たとえば A に 14.2 点、B に 11.8 点、C に 7.1 点。それが分かれば、答えを書き出してもらう必要はありません。
実装では、選択肢を A、B、C という 1 文字のラベルに対応づけ、プロンプトの末尾でそのラベルの点数だけを取り出します。ラベルが 1 トークンに収まること、プロンプトとの境目でトークンの切れ方が変わらないことまで検証しているのが丁寧なところです。取り出した点数は、次の式で確率に直します。
速くなる理由はもう 1 つあります。同じ state に 21 個の質問をしたいとき、普通にやると同じ長文を 21 回読ませることになります。TheoLeeCJ 版は共通の state を 1 回だけ読ませ、その途中経過を保存しておいて、質問ごとの短い続きだけを並べて処理します。長い資料を 1 回読んで付箋を貼っておき、21 問にはその付箋を見ながら答えるイメージです。この付箋にあたるものが KV キャッシュです。
公開されている測定では、同じモデル、同じ state、21 個の二択、RTX 3090 という条件で、次の結果が出ています。
| 経路 | 時間 | 出力トークン | 返ってくるもの |
|---|---|---|---|
| 点数を直接読む | 1.023 秒 | 0 | 21 組の確率 |
| はいいいえの JSON 配列を生成 | 5.332 秒 | 111 | 21 個の値が並ぶ配列 |
差は 5.21 倍です。ここで作者の書き方が誠実だなと感じたのは、2 つの経路の判断が一致したのは 21 問中 18 問だった、と自分から書いている点です。同じ計算の速い版ではなく、別の読み出し方なので、答えも少し変わる。これは出力経路のコストの比較であって、意味が同じだという主張ではない、と明記されています。共通 state の使い回しも同様です。質問を並べて処理する経路では、777 個の判断が 333.1 秒から 38.8 秒に縮まる一方、選ばれる候補が 6 個入れ替わったと報告されています。
もう 1 つ、この方式の性質として覚えておきたいことがあります。返ってくる確率は、渡した候補の中での相対的な強さです。再試行すると中止するの 2 つしか渡していなければ、本当に必要な行動が情報を集め直すことであっても、その 2 つのどちらかに確率が割り振られます。候補どうしの優劣を数字にできることと、候補の集合そのものが適切であることは、別の話です。
DGX Spark で日本語の判断を読み出してみる
公開されている数字は、英語の題材を RTX 3090 で測ったものです。日本語でも同じ形になるのか、手元の DGX Spark 1 台で確かめました。モデルは TheoLeeCJ 版と同じ Qwen3.5-4B で、重みは 16 ビットの BF16 のままです。測定スクリプトも TheoLeeCJ 版のリポジトリのものを無改変で使っています。以下、このリポジトリを上流と呼びます。指示文にあたる英語のテンプレートもそのままで、日本語にしたのは state と質問と候補の説明だけです。高速化ライブラリの flash-linear-attention は入れておらず、一部の層は PyTorch の標準実装で動いています。比べる 2 つの経路はどちらも同じ条件です。
題材は 2 つ作りました。1 つは、充填機の停止報告 1 件に対する 21 個の二択です。冷却水は流れていたか、再開の承認は出ているか、といった問いで、関係のない背景記録を 4 件混ぜてあります。もう 1 つは、4 つの候補から 1 つを選ばせる問題が 36 問です。Jev でいう Choice にあたります。半分の 18 問は問い合わせの振り分けで、問い合わせ文を読んで、技術サポート、請求、営業、該当なしのどれが担当かを選びます。残りの 18 問は設備アラートへの次の対応で、再起動、部品交換、様子見、情報不足から選びます。36 問のうち 7 問は、情報が足りず決められないのが正解になるように作りました。正解ラベルは自分が手で付けたものです。
4 択の問題は、たとえば次のような形です。
記録: 先月分の請求書に、解約したはずのオプション料金が載っています。確認してください。
質問: この問い合わせはどの窓口が担当すべきか。
候補: 技術サポート、請求、営業、該当なし
正解: 請求
同じことを DGX Spark で試す方が踏みそうな点を 1 つだけ。上流が固定している torch==2.10.0 は、PyPI から入れると aarch64 では CPU 版になり、GPU が見えません。同じ版を PyTorch の CUDA 13.0 向けインデックスから入れ直すと動きました。
uv pip install --index-url https://download.pytorch.org/whl/cu130 'torch==2.10.0'
まず、点数を直接読む方式と JSON の生成を比べた結果です。英語の行は上流の題材をそのまま DGX Spark で走らせたもので、各 3 回の中央値です。
| 題材 | state の長さ | 直接読む | JSON 生成 | 倍率 | 2 経路の一致 | 直接読む方式の正解 |
|---|---|---|---|---|---|---|
| 英語(上流の 21 問) | 1,812 トークン | 1.608 秒 | 6.984 秒 | 4.34 倍 | 18/21 | — |
| 日本語(自作の 21 問) | 426 トークン | 0.961 秒 | 6.092 秒(20 個で無効) | 6.34 倍 | 判定不能 | 21/21 |
英語の 18/21 は、上流の公開値とぴったり同じでした。秒数は機体もカーネルも違うので直接は比べませんが、点数を直接読むほうが生成の数分の 1 で終わるという形は DGX Spark でも変わりません。日本語のほうが倍率が大きいのは、state が短くて読み込みにかかる時間が小さいぶん、生成の時間の比重が増えたためだと見ています。
日本語では、点数を直接読む方式が 21/21 で全問正解でした。英語の指示文に日本語の記録を挟んだ形で、背景記録にはベアリング摩耗の話を紛れ込ませてありましたが、自分が付けた正解ラベルと 21 問すべて一致しました。
思っていたより面白かったのは生成の側です。2 経路の一致が判定不能になっているのは、生成された配列が 3 回とも 20 個しかなかったからです。21 問を渡して、はいかいいえを順番に並べた JSON 配列を返すよう指示したのに、1 問ぶん足りない。JSON としては正しく、並んだ 20 個はすべて正解の並びと一致していました。それでも受け取る側は、20 個の値のどれがどの問いの答えなのかを信用できません。上流のスクリプトもこの出力を無効と判定しています。書かせるから、数え間違える。点数を直接読む方式には、この壊れ方がそもそも存在しません。問いごとに決まった場所の点数を読むだけだからです。
次に、4 択の 36 問の結果です。
| 指標 | 値 |
|---|---|
| 正解(そのままの順) | 33/36 |
| 正解(候補を逆順にした場合) | 35/36 |
| 逆順で選択が変わった問題 | 2/36 |
| 決められないのが正解の 7 問で、ほかの候補を 0.8 超で選んだ問題 | 0 |
| 選んだ候補の確率の平均 | 0.916 |
36 問中 33 問の正解は、40 億パラメータのモデルを学習なしで使った結果としては悪くありません。よろしくお願いします、だけの問い合わせや、F-02 で異常、だけのアラートには、きちんと該当なしや情報不足を選んでいます。
外した 3 問の中身に、この方式の性格が出ていました。2 問は、正解ではなく情報不足を 0.472 と 0.587 という低い確率で選んだもので、候補の順番を逆にするとどちらも正解に変わりました。確率が低い問題は、順番のような意味のない違いで答えが動く。逆に言えば、確率が低い問題を自動処理に回さず人に渡す、という設計が効きそうな場所です。
残りの 1 問は、クレジットカードの有効期限を設定画面のどこから変更できるか、という問い合わせを、0.900 の確率で技術サポートに振りました。自分のラベルは請求です。設定画面のどこから、という聞き方に引っ張られたのでしょう。順番を逆にしても答えは変わりません。自分のラベルが唯一の正解だと言い切れる問いでもありませんが、窓口を分けている会社にとっては、高い確率で、安定して、期待と違う側に倒れる例です。確率が高いことと、業務上正しいことは別だという話が、36 問の小さな題材でも顔を出しました。
共通 state の使い回しの効果も、別の測定で見ています。最初の表の 0.961 秒は、state を使い回す経路を一度空回しして温めてから 3 回測った値でした。こちらは温めずに 1 回ずつ測っていて、21 問を 1 問ずつ読ませると合計 4.159 秒、state を 1 回読んで 21 問を並べると 1.642 秒です。判断が入れ替わった問いは 0/21 でした。
同じ題材を Jev にも渡してみる
ここまで来ると、同じ題材を本家に投げたらどうなるのかが気になります。Jev は 2026 年 9 月 18 日から OpenRouter でも呼べるようになっていたので、同じ題材をそのまま投げてみました。
chat completions のエンドポイントには断られ、decisions 用の専用エンドポイントを案内されます。渡す形は TypeSafe の API と同じ state と questions でした。候補のキーは Qwen3.5-4B のときと条件を揃えて、並び順で割り当てた A から D の文字にしています。
| 題材 | Jev(OpenRouter 経由) | Qwen3.5-4B(点数を直接読む) |
|---|---|---|
| 設備停止報告の 21 問 | 21/21 | 21/21 |
| 4 択の 36 問、そのままの順 | 34/36 | 33/36 |
| 4 択の 36 問、逆順 | 34/36 | 35/36 |
| 逆順で選択が変わった問題 | 0/36 | 2/36 |
| そのままの順で外した問題のうち、確率が 0.7 以上のもの | 0 | 1 |
正解数はほぼ並びました。公式は日本語を含む CJK で精度が落ちると書いていますが、この小さな題材では崩れていません。差が出たのは安定性と外し方です。Jev は候補を逆順にしても 1 問も選択が変わりませんでした。
外した 2 問も見ておきます。1 問は Qwen3.5-4B が外したのと同じカードの有効期限の問い合わせで、Jev も技術サポートに振りました。ただし確率は 0.66 で、Qwen3.5-4B の 0.900 よりずっと控えめです。もう 1 問は、上位プランに切り替えて SSO を使いたいという問い合わせを、0.47 で技術サポートに振ったものでした。そのままの順では、Jev が外した 2 問はどちらも確率 0.7 未満で、正解なのに 0.7 未満だったのは 1 問だけです。ただし、これは外したときのスコアを眺めた観察です。確率が実際の正解の頻度に合っているかという校正は、この題材では測っていません。
しかも、逆順にするとカードの問い合わせの確率は 0.76 まで上がります。しきい値を 1 本引けば片付く、と 36 問から言うことはできません。2 つのモデルが同じ問題を同じ側に外したことは、自分のラベルのほうを疑う材料でもあります。
速さも並べておきます。21 問を Noul 21 個として 1 リクエストにまとめると、手元から OpenRouter までの往復で 0.245〜0.327 秒でした。回線と中継を含んだ時間なので、DGX Spark の 0.961 秒とは測っているものが違います。Jev の秒数は OpenRouter 経由のもので、TypeSafe の API を直接呼んだ値ではありません。3 つの題材と繰り返しを合わせた費用は、全部で約 0.002 ドルでした。
小さな題材での結果なので、日本語で Jev の代わりになると言うつもりはありません。分かったのは、点数を直接読むという読み出し方は日本語の記録でも成り立つこと、そして公開値が示していた性質、つまり速さと、生成との食い違いと、確率の低い問題の不安定さが、手元でも同じ形で出たことです。
判断のために学習し直すという別解
AlexWortega 版は、同じ OpenJev の名前でも方向が違います。こちらは Qwen3.5-4B を、判断のためのモデルへ学習し直しています。
使っている枠組みは NLI(自然言語推論)です。前提と仮説という 2 つの文を読ませて、前提が仮説を支持する(entailment)、矛盾する(contradiction)、前提だけでは決められない(neutral)の 3 つに分類します。この前提から、この仮説は言えるか、という三択問題だと思ってください。
前提: 監視ログには、外部 API への接続タイムアウトが記録されている。
仮説: 外部 API との通信で問題が発生している。
→ entailment(支持する)
この三択を万能の判断器として使うのが AlexWortega 版の発想です。回答の候補を並べ替えたいなら、候補ごとに仮説を作って、支持される確率が一番高いものを選ぶ。回答を採点したいなら、正解を前提に入れて、回答が支持されるかを見る。モデルカードには、Doom や Flappy Bird をリアルタイムに遊ばせる例まで載っています。
学習の中身は、公開されているコードから確認できます。SNLI と MNLI という英語の NLI データセットから 12 万件を使い、1 エポック、文章を処理するモデル本体ごと更新する full fine-tune で、損失は 3 クラスの普通のクロスエントロピーです。モデルカードにある zero-shot という言葉は、この学習済みの NLI モデルを、Doom のような下流のタスクに追加の学習なしで当てる、という意味で読むのがよさそうです。モデルを何も学習していないわけではありません。そして Jev の RLCD を再現したものでもありません。確率の校正を目的にした学習ではなく、正解のラベルを当てる学習です。
TheoLeeCJ 版とは、返ってくる確率の意味も違います。TheoLeeCJ 版の確率は、候補のラベルに付いた点数を、渡した候補全体で合計が 1 になるように割り振り直した値でした。A に高い値が付いても、A が業務上もっともよい選択である確率を保証するものではありません。AlexWortega 版は、候補ごとに別々に、支持されるか、矛盾するか、決められないかを出します。
AlexWortega 版の値は候補ごとに独立していて、候補の間で合計 1 を分け合いません。そのため、複数の候補が同時に支持されることも、どれも支持されないことも表現できます。その代わり、ある記述が支持されることは、それが次に取るべき最適な行動であることを意味しません。
公開されている評価に、この性質がよく出ている数字があります。大学院レベルの 4 択問題集である GPQA-diamond を使った 2 つの測定です。
| 測り方 | モデルに渡すもの | 正解率 |
|---|---|---|
| 候補の中から正解を選ばせる | 問題文と 4 つの候補 | 27.3% |
| 正解を見せたうえで、各候補が正解かを採点させる | 問題文と正解文と 1 つの候補 | 96.8% |
正解なしで選ばせた 27.3% は、4 択ではほぼ当てずっぽうの水準です。正解文を渡して採点させた側は 96.8% でした。前者は問題ごと、後者は候補ごとに数えた値で、同じ物差しの上がり下がりではありません。作者もレポートでこの 2 つを分けて書いています。答えを導く力と、与えられた根拠や正解に照らして候補を評価する力は別のもので、このモデルが持っているのは後者だということです。
これは弱点というより、使いどころの指定だと受け取りました。RAG で拾ってきた根拠と回答が食い違っていないかの確認や、エージェントの出力が仕様を満たしているかの照合。そういう、材料は手元にあって照らし合わせるだけの判断には合いそうです。ただ、GPQA の採点で高い成績が出たことと、RAG の根拠確認で使えることは別なので、その用途での精度は自分で確かめる必要があります。自分が判断用のモデルに求めているのが、答えを出すことなのか、照らし合わせることなのか。導入の前にそこを決めておくと、選ぶ実装が変わってきます。
Jev と何が同じで、何が違うのか
ここまでを踏まえて、本家と比べてみます。再現できたかできていないかの一言で片付けず、入出力、推論の方法、学習、校正、判断の質に分けて見ます。
| 比較項目 | Jev | TheoLeeCJ 版 | AlexWortega 版 |
|---|---|---|---|
| 入出力の形 | 実行時に質問と候補を渡し、型つきの確率を受け取る | ほぼ同じ形 | 前提と仮説の形に変換して使う |
| 生成しない推論 | 専用のアーキテクチャと並列サンプラー | 既存モデルの点数を直接読む | 分類ヘッドの出力を読む |
| 学習 | 非公開のモデルに RLCD | 追加の学習なし | NLI の教師あり学習 |
| 確率の校正 | 学習の目標として掲げている | 校正していないと明記 | 校正の議論はなし |
| 判断の質 | 公開データの一部 102 判断で、参照との一致 88.3% | 同じ 102 判断で 84.5% | GPQA では正解文つきの採点が高成績 |
一番下の行の 84.5% と 88.3% は、見出しにしたくなる数字です。40 億パラメータのオープンモデルが、本家に 3.8 ポイント差まで迫っているように見えます。ただ、これは慎重に読みたいところです。比べているのは TypeSafe の公開データ 711 判断のうち、対応づけができた 102 判断だけ。Jev の値は公開された記録から読んだもので、作者が API を叩いて測ったわけではありません。作者自身が、これは Jev に近い能力を示すものではないと書いています。参照の確率分布からどれだけ離れているかを測る別の指標では、TheoLeeCJ 版が 0.177、Jev が 0.127 でした。小さいほど参照に近い値なので、まだ差があります。
さらに言えば、この評価の正解は人間が確定させたものではありません。TypeSafe の公開評価の参照ラベルは、GPT-6 Astra と Claude Fable 5.1 の回答の平均から作られていて、公式も、コードが正しいと仮定して現時点で最も賢い大型モデルに対して測っている、と断っています。つまりここでの一致率は、現実の正解に対する精度ではなく、大型モデルの判断にどれだけ似ているかです。
頑健性のデータも公開されています。TheoLeeCJ 版では、意味を変えずに選択肢の順番を逆にしただけで、36 件中 10 件の判断が変わりました。情報が足りないはずのケースで、0.8 を超えるスコアを付けて答えてしまった例も報告されています。だからこのスコアを Jev のような運用上の校正として扱うことはできない、というのが作者の結論です。
では本家なら確率をそのまま信じていいのか、というと、そこも単純ではありません。先ほど触れたとおり、公式の制約ページは、Noul のしきい値を Choice に持ち込めないこと、別々に尋ねた質問の確率が足して 1 になるとは限らないことを認めています。公式のドキュメントも、しきい値は 1 つの数字ではなく、間違えたときの影響の大きさに応じて操作ごとに変えるものだと説明しています。
整理すると、本家は校正された判断を製品の能力として掲げています。今回読んだ OpenJev の資料では、それに相当する運用上の校正は確認できませんでした。その代わり、中身を自分で確かめて直せます。そしてどちらを選んでも、自分の業務データでの評価は省けません。本家は信頼できて OpenJev は信頼できない、という二分法にはならない、というのが読んでみての実感です。
Jev について書かれた記事の中に、質問ごとに 1 トークンだけ読めば Jev の速さと一貫性と並列性の大半は手に入る、技術的な堀は厚くないのでは、という評がありました。
OpenJev の公開測定は、JSON を書かせる経路より短い時間で判断を取り出せることを、発表から 3 日で示しました。Jev と同じ速さや処理能力まで再現できたかは、条件を揃えて測られていません。堀があるとすれば、速さの側よりも、確率をどこまで信じてよいかの側ではないかと考えています。
判断する力をどこに持たせるか
3 つを並べてみると、競合というより、同じ問題への別々の答えに見えてきます。判断する力を、システムのどこに持たせるか、という問題です。
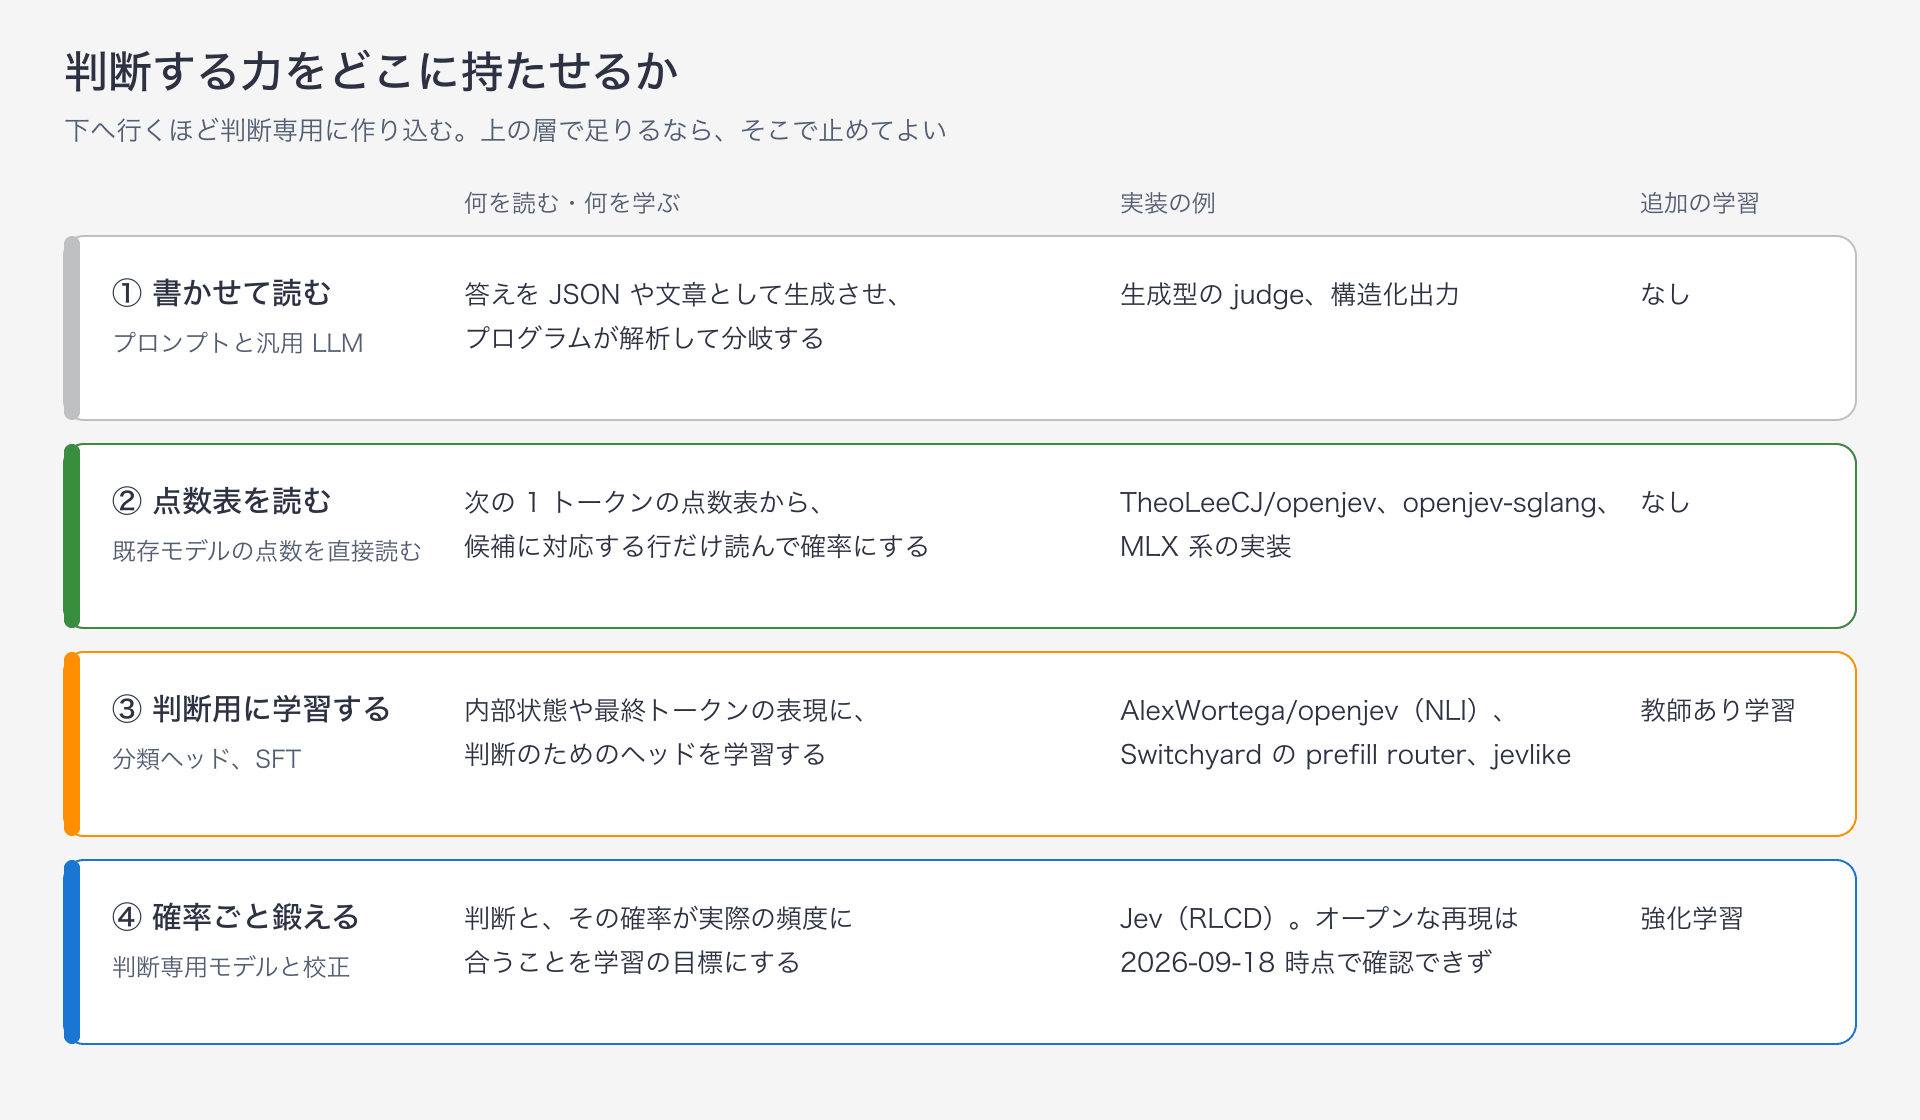
下へ行くほど判断専用に作り込む。TheoLeeCJ 版は 2 層目、AlexWortega 版と prefill router は 3 層目、Jev は 4 層目にあたる。4 層目のオープンな再現は 2026-09-18 時点で確認できなかった。
1 層目は、汎用の LLM に JSON を書かせて読む、いま一番普通のやり方です。2 層目が TheoLeeCJ 版で、モデルはそのまま、読み出し方だけを変えます。3 層目は判断のために何かを学習する層で、AlexWortega 版のようにモデルごと学習し直すやり方もあれば、モデルは凍結して小さなヘッドだけを学習するやり方もあります。4 層目が Jev で、確率の校正まで含めて学習の目標にしています。RLCD をオープンに再現したと確認できる実装は、探した範囲では見つかりませんでした。
冒頭で触れた prefill router は、この地図の 3 層目に入ります。LLM が依頼文を読み込んだ時点の内部状態を特徴量にして、小さなニューラルネットで、どのモデルならこの依頼を解けるかの確率を出すルーターです。8 月に手元で作って生成型の judge と比べたときは、学習に使ったデータと似た依頼では judge と並ぶ精度が出ました。ところが日常的に流している単発の依頼 47 問に当てると、難しい順に並べる力は残っているのに、確率が 0.4 から 0.6 の狭い帯に縮んでしまい、設定していたしきい値 0.80 では全問が性能の高いモデル側に回りました。学習に使ったデータと似た依頼で精度が出ていても、別の依頼に同じしきい値を持ち出せるとは限らない、と受け取りました。OpenJev の作者たちが、校正されていないと繰り返し断っているのと同じ壁に、自分も 1 か月前に当たっていたわけです。
この地図の使い方は、上から順に試すことだと考えています。まず 2 層目で、追加の学習なしにどこまで判断を切り出せるかを測る。精度や安定性が足りないところだけ 3 層目に進んで学習する。確率そのものを自動処理のしきい値に使いたくなったら、そこで初めて 4 層目の能力、つまり Jev を使うか、自分で校正に取り組むかを考える。全部をモデルに学習させる必要も、全部をプロンプトに押し込む必要もありません。
実際に判断を切り出すとどうなるかは、TypeSafe 自身の例が参考になります。エージェントの Hermes が持つ 182 個のスキルから、いまの依頼に必要なものを選ぶ場面です。1 回目の呼び出しで全スキルを順位づけしつつ、そもそもスキルが要る依頼なのかを判定し、2 回目で上位 3 件の詳しい説明を読み直して 1 つに絞る。該当なしという答えも返せます。公開されている例は、Claude Haiku 4.5 を使うエージェントに Jev 1.12 のスキル提案を足して、足さない場合と 488 件の依頼で比べたものです。間違ったスキルを読み込む割合が 16.8% から 7.3% に、不要な読み込みが 9.8% から 4.0% に減ったそうです。直っていたものを壊した例もある、と添えてあるのが好感の持てるところでした。
Hermes Agent 本体の側も、Jev の組み込みを検討する Issue で、Jev をセッションのチャットモデルにはしない、助言的な判断に限る、と線を引いています。判断用のモデルは最終決定権を持つ存在ではなく、コードが条件と権限としきい値を握ったまま使う部品だ、という扱いです。
ここしばらく、モデルの開発は大きく複雑に、という方向ばかりを見ていた気がします。Jev と OpenJev が見せてくれたのは逆向きの視点でした。出力の型が決まっていて、プログラムの if 文にそのまま差し込める、小さな部品としての AI です。必要な場所に必要な能力だけを置く、という考え方と相性がよく、巨大な生成モデルに毎回 JSON を書かせなくても済む判断は、思っているより多いのかもしれません。
まとめ
OpenJev は Jev のコピーではありませんでした。Jev が出した、判断だけが欲しいなら生成は要るのか、という問いに対して、TheoLeeCJ 版は既存のモデルの点数表を読むだけでいいと答え、AlexWortega 版は判断のために学習し直せばいいと答えています。名前は同じでも、答え方が違う。そこが読んでいて一番面白かったところです。
ただ、書かせずに答えを取り出せたからといって、その答えをそのまま自動処理に使えるわけではありません。Qwen3.5-4B は 0.900 という高い確率で振り分けを外しましたし、Jev の公式も、しきい値は 1 つの数字ではなく、間違えたときの影響に応じて操作ごとに決めるものだと書いています。選択肢に何を並べるか、返ってきた確率をどこまで信じるか、自分の業務のデータでどれくらい当たるか。この 3 つは、どの OpenJev を選んでも、本家を選んでも、使う側に残る仕事です。OpenJev のよいところは、コードも測り方も公開されていて、そこを自分の手で確かめられることだと感じました。
参考リンク
- Introducing System One Models & Jev - TypeSafe AI Blog(2026-09-15 発表)
- System One - TypeSafe AI Docs
- Models - TypeSafe AI Docs — 版、料金、言語の注意
- Confidence - TypeSafe AI Docs — confidence の定義としきい値の考え方
- Jev 1.13 jaggedness - TypeSafe AI Docs — 公式の制約一覧
- TypeSafe Workflow Evals — 公開評価と参照ラベルの作り方
- Skill suggestion - TypeSafe AI Cookbook
- Jev 1.13 - OpenRouter(2026-09-18 掲載)
- TheoLeeCJ/openjev — 点数を直接読む実装。
docs/RESULTS.mdに再現できたものとできていないものの一覧 - OpenJev in your browser
- AlexWortega/openjev - Hugging Face — NLI に学習し直した実装
- ekzhang/openjev-sglang
- daseinlabs/open-jev
- rorshopping/jev-on-a-laptop
- vinnylarouge/jevlike
- zhihz/openjev
- Jev means structured output is interesting again - Sean Goedecke(2026-09-16)
- Implement Jev (TypeSafe) in Hermes - NousResearch/hermes-agent Issue #113837
- LLM Router: Rethinking Routing with Prefill Activations — prefill router の論文