専用API vs 生成AI|感情分析どっちを使うべき?Comprehend と Bedrock を検証比較
はじめに
こんにちは。
AI事業本部の吉田です。
今回は、Amazon Comprehend と Bedrock(Claude Sonnet / Nova)を使った感情分析の比較検証を行いましたので、その結果を記事にしました。
近年、レビュー分析やコールセンターなどの問い合わせ対応において、問い合わせ内容のテキストや会話の感情を自動で判定し、業務改善をしていくニーズが高まっています。[1]
自然言語処理専門のAPIであるAmazon Comprehendと、Bedrockで用いることができる生成AI(Claude Sonnet, Nova)を比較することで、どのようなユースケースにどちらが適しているかを検証しました。
本記事では省略して以降、Bedrock(Claude Sonnet)をClaude SonnetもしくはSonnet、Bedrock(Nova)をNovaと記載しています。
この記事で分かること
- Amazon Comprehend と Claude Sonnet、Nova による感情分析の違い
- それぞれの精度・速度・再現性
- ユースケース別の使い分け
両サービスの概要
Amazon Comprehend とは

Amazon Comprehend は、機械学習 (ML) を使用してテキストから洞察を見つける自然言語処理 (NLP) サービスです。Amazon Comprehend は、Custom Entity Recognition、カスタム分類、キーフレーズ抽出、感情分析、エンティティ認識などの API を使用することにより、お使いのアプリケーションに NLP を簡単に統合できます。Amazon Comprehend API をお使いのアプリケーションに読み込むだけで、ソースとなるドキュメントやテキストの場所がわかります。API は、エンティティ、キーフレーズ、感情、言語を、アプリケーションで使用できる JSON 形式で出力します。[2]
全体の機能としては、
- Custom Entity Recognition(カスタムエンティティ認識)
- 独自の固有名や用語を認識するためのカスタムモデルを作成できます。
- カスタム分類(Custom Classification)
- 独自のカテゴリにテキストを分類するためのカスタムモデルを作成できます。
- エンティティ認識(DetectEntities / BatchDetectEntities)
- 指定されたテキストから、固有名詞や日付、場所などのエンティティを抽出します。
- 感情分析(DetectSentiment / BatchDetectSentiment)
- 指定されたテキストから、全体的な感情(ポジティブ、ネガティブ、ニュートラル、混在)を分析します。
他にもPII 識別や構文解析など、その他の機能も提供されています。
今回は、感情分析(DetectSentiment / BatchDetectSentiment)に絞って比較検証を行います。
感情分析とは
感情分析は、テキストの全体的な感情
- 肯定的[positive]
- 否定的[negative]
- 中立的[neutral]
- 混在[mixed]
を返します。
サンプルテキスト:
私が注文したのはS です。それがぴったり合うと思っていたのですが、M-L のようにやや大きめでした。品質は素晴らしいものでした。写真よりも明るい茶色ですが、かなり近い色です。内側に綿やウールの裏地が付いていれば 10 倍も良いものになるでしょう。
| 感情 | ラベル | スコア |
|---|---|---|
| 混在 | mixed | 0.89 |
| 肯定的 | positive | 0.09 |
| 否定的 | negative | 0.01 |
| 中立的 | neutral | 0.00 |
このサンプルテキスト[3]では、感情分析の結果「混在」というラベルがつけられました。
このようにテキストの全体的な感情を分類することができるのが、感情分析の特徴です。また、日本語の感情分析もサポートされています。
Amazon Bedrock とは
Amazon Bedrock は、高性能基盤モデル (FM) と、エージェントをデプロイおよび運用するための幅広いツールを提供するフルマネージドサービスです。
現時点(2026年8月時点)では、Anthropic 社の Claude 系モデル(Claude Sonnet / Opus / Haiku)、Amazon 系モデル(Nova / Titan)などを Bedrock 経由で利用できます。
Claude Sonnet とは
Claude Sonnet(クロード・ソネット)は、AI企業 Anthropic(アンソロピック)が開発する大規模言語モデル(LLM)です。Claudeシリーズの中でも、性能とコスト・速度のバランスに優れた中核モデルとして位置づけられており、Claude最新モデルが提供されています。
| モデル | 特徴 | |
|---|---|---|
| Claude Opus | 最も高性能で複雑なタスク向け | |
| Claude Sonnet | 性能と速度・コストのバランス型 | 検証するモデル |
| Claude Haiku | 軽量・高速で応答性を重視 |
今回は、Claude Sonnet を Bedrock 経由で利用し、Comprehend と比較検証を行います。
Amazon Nova とは
Amazon Nova(アマゾン・ノヴァ)は、Amazonが2024年末に発表した基盤モデル(Foundation Model)群です。Amazon Bedrock 上で提供されており、テキスト・画像・動画など複数の入力に対応するマルチモーダルモデルとして展開されています。[4]
Amazon Nova の特徴
Nova は、AWS のエコシステムとの親和性とコスト効率を重視して設計されている点が特徴です。用途に応じて複数のモデルが用意されています。
| モデル | 特徴 | |
|---|---|---|
| Nova Micro | テキスト特化・最軽量で低コスト・高速 | |
| Nova Lite | マルチモーダル対応の低コストモデル | (検証するモデル) |
| Nova Pro | 高精度と速度・コストのバランス型 |
比較の観点
比較をするにあたって、以下の観点で検証をしていきます。
- 精度
- レイテンシ(速度)
- 再現性
- 信頼度
検証環境・準備
前提条件
今回の検証は以下の環境で行いました。
| 項目 | 内容 |
|---|---|
| リージョン | 東京(ap-northeast-1) |
| 言語 / SDK | Python 3.12 / boto3 1.35.90 |
| Comprehend | 追加設定不要(API を有効化するだけで利用可能) |
| Bedrock モデル | Claude Sonnet 4.6 / Amazon Nova Lite |
| 認証 | 通常の AWS 認証情報チェーン(環境変数 / ~/.aws / IAM ロール) |
モデルによってはリージョン単体ではなくクロスリージョン推論プロファイル経由での呼び出しになります。利用可能なモデル ID / 推論プロファイル ID はリージョンによって異なるため、事前に確認しておくとスムーズです。
- JP クロスリージョン推論:
jp.anthropic.claude-sonnet-4-6(今回の検証で使用)
IAM 権限
実行するロール/ユーザーには、少なくとも以下のアクションを許可しておきます。
{
  "Version": "2012-10-17",
  "Statement": [
    {
      "Effect": "Allow",
      "Action": [
        "comprehend:DetectSentiment",
        "comprehend:BatchDetectSentiment",
        "bedrock:InvokeModel",
        "bedrock:ListFoundationModels",
        "bedrock:ListInferenceProfiles"
      ],
      "Resource": "*"
    }
  ]
}
Converse API を使う場合も必要な権限は bedrock:InvokeModel です。本番運用では Resource を対象モデルの ARN に絞ることを推奨します。
実装コード
今回は Python(boto3)でそれぞれのプロバイダを実装しました。
リージョンやモデル ID は環境変数で切り替えられるようにしていますが、記事では読みやすさのため主要部分のみを抜粋しています。
Amazon Comprehend
Comprehend は detect_sentiment を 1 回呼ぶだけです。返ってくる感情ラベル(大文字)を正規化し、予測ラベルのスコアを confidence として扱います。レイテンシ比較のため呼び出し前後で時間も計測しています。
import time
import boto3

comprehend = boto3.client("comprehend", region_name="ap-northeast-1")

# Comprehend の出力(大文字)→ 正規化ラベル
_SENTIMENT_MAP = {
    "POSITIVE": "positive",
    "NEGATIVE": "negative",
    "NEUTRAL": "neutral",
    "MIXED": "mixed",
}

def detect_single(text: str, language_code: str = "ja") -> dict:
    start = time.perf_counter()
    resp = comprehend.detect_sentiment(Text=text, LanguageCode=language_code)
    latency_ms = (time.perf_counter() - start) * 1000

    sentiment = _SENTIMENT_MAP.get(resp.get("Sentiment", ""))
    scores = resp.get("SentimentScore", {})
    # 予測ラベルのスコアを confidence とする(例: "Positive")
    confidence = scores.get(resp.get("Sentiment", "").capitalize())

    return {
        "sentiment": sentiment,
        "confidence": confidence,
        "latency_ms": latency_ms,
        "char_count": len(text),
    }
なお、大量処理する場合は最大 25 件をまとめて送れる batch_detect_sentiment も利用できます。
Amazon Bedrock(Claude Sonnet / Nova)
Bedrock は Converse API[5](bedrock-runtime.converse)を利用しました。Converse API はモデル間で入出力の形式が統一されているため、modelId を差し替えるだけで Claude Sonnet でも Nova でも同じコードで呼び出せるのが利点です。
感情のラベル・確信度・判断理由を JSON で返すよう system プロンプトで指示し、出力をパースしています。
import json
import re
import time
import boto3

bedrock = boto3.client("bedrock-runtime", region_name="ap-northeast-1")

# Claude Sonnet。Nova を使うときは modelId を差し替えるだけ
MODEL_ID = "jp.anthropic.claude-sonnet-4-6"

_VALID_SENTIMENTS = {"positive", "negative", "neutral", "mixed"}

_SYSTEM_PROMPT = (
    "あなたは日本語テキストの感情分析器です。"
    "入力テキストの感情を positive / negative / neutral / mixed のいずれか 1 つに分類してください。"
    "皮肉・敬語・婉曲表現の真意を汲み取って判定してください。"
    "必ず次の JSON のみを出力してください(前後に説明文を付けない):\n"
    '{"sentiment": "<positive|negative|neutral|mixed>", '
    '"confidence": <0.0-1.0 の数値>, "reason": "<日本語で判断理由を一文>"}'
)

def _parse_json(text: str) -> dict:
    """モデル出力から最初の JSON オブジェクトを抽出してパースする。"""
    fenced = re.search(r"```(?:json)?\s*(\{.*?\})\s*```", text, re.DOTALL)
    candidate = fenced.group(1) if fenced else text
    match = re.search(r"\{.*\}", candidate, re.DOTALL)
    if not match:
        raise ValueError(f"JSON が見つかりません: {text[:120]}")
    return json.loads(match.group(0))

def detect_single(text: str, model_id: str = MODEL_ID) -> dict:
    start = time.perf_counter()
    resp = bedrock.converse(
        modelId=model_id,
        system=[{"text": _SYSTEM_PROMPT}],
        messages=[{"role": "user", "content": [{"text": text}]}],
        inferenceConfig={"maxTokens": 1024},
    )
    latency_ms = (time.perf_counter() - start) * 1000

    out_text = "".join(
        block.get("text", "") for block in resp["output"]["message"]["content"]
    )
    usage = resp.get("usage", {})

    result = {
        "sentiment": None,
        "confidence": None,
        "reason": None,
        "latency_ms": latency_ms,
        "input_tokens": usage.get("inputTokens"),
        "output_tokens": usage.get("outputTokens"),
        "char_count": len(text),
    }
    try:
        parsed = _parse_json(out_text)
        sentiment = str(parsed.get("sentiment", "")).lower().strip()
        result["sentiment"] = sentiment if sentiment in _VALID_SENTIMENTS else None
        conf = parsed.get("confidence")
        result["confidence"] = float(conf) if conf is not None else None
        result["reason"] = parsed.get("reason")
    except (ValueError, json.JSONDecodeError, TypeError) as exc:
        result["error"] = f"parse error: {exc}"
    return result
Converse API は usage にトークン使用量(inputTokens / outputTokens)を返してくれるため、レスポンス取得と同時にトークン数も記録できます。
判定結果を見比べるための自作WebApp
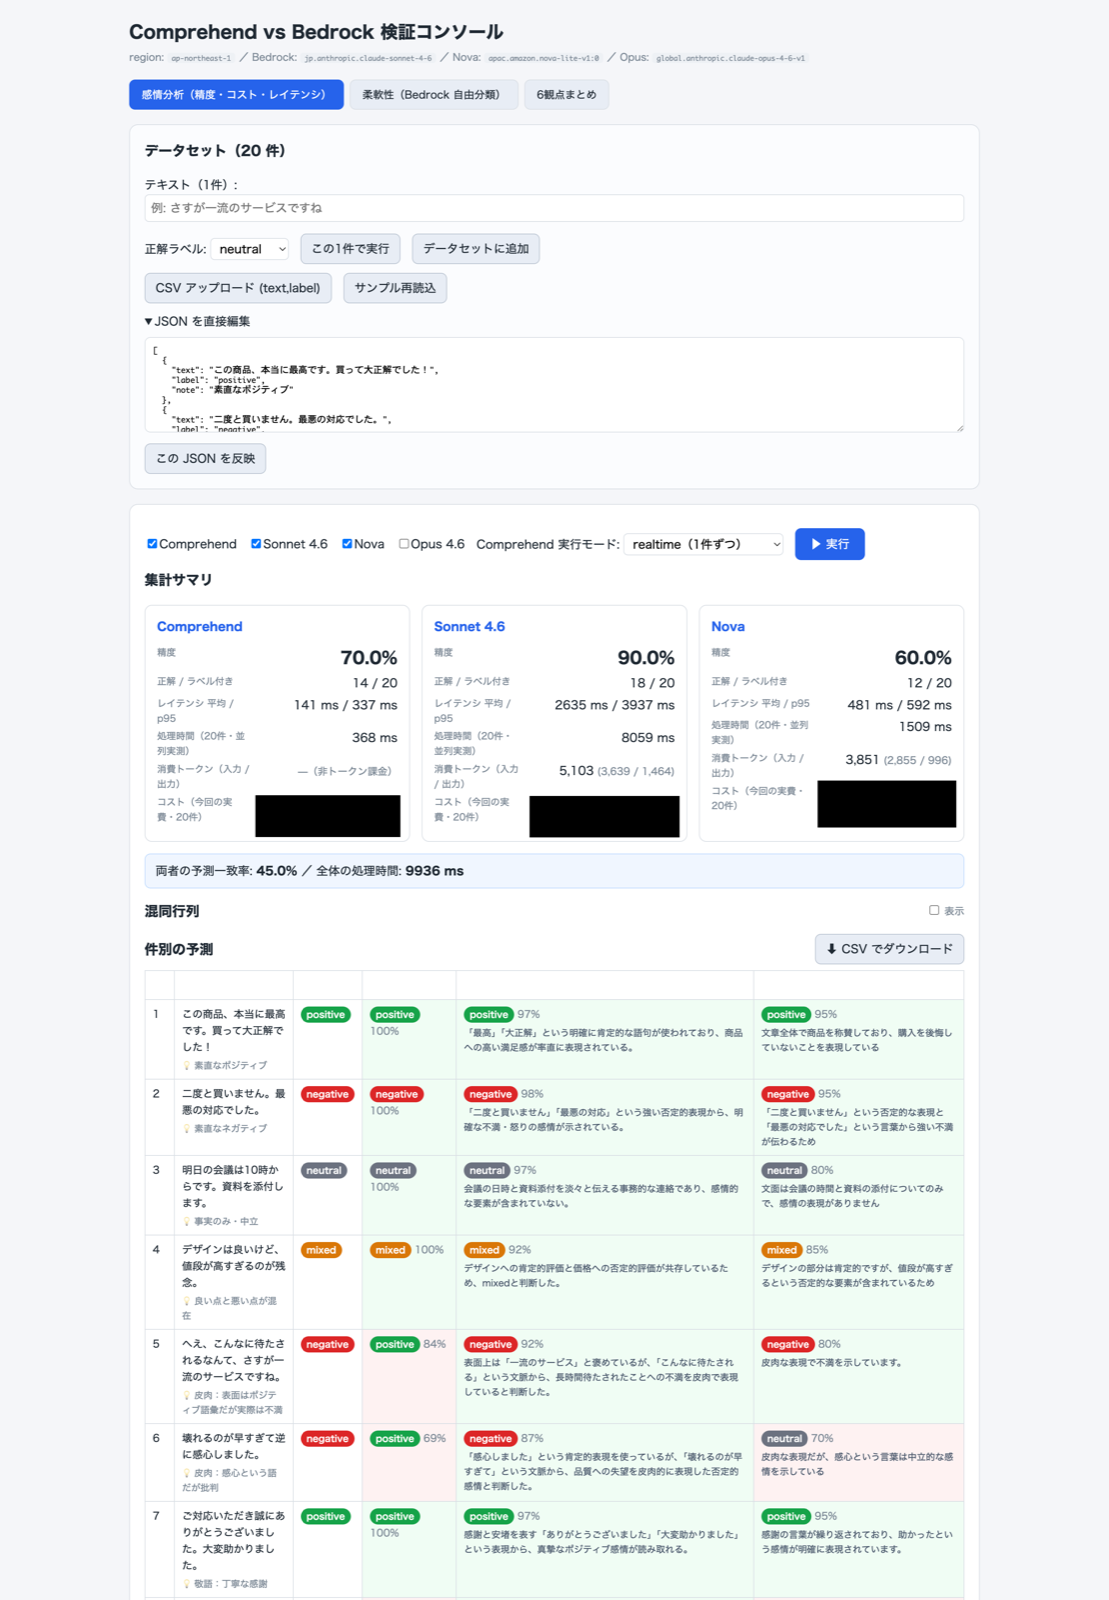
各検証で出力したCSV(sentiment_results.csv)をそのまま見比べるのは大変なので、簡単なWebAppを自作しました。CSVを読み込むと、テキスト・正解ラベル・3サービスの判定結果(ラベル/信頼度/判定理由)を1行に並べて表示し、正解と一致しない行は赤く色付けされるので、どこで・どう間違えているかが一目でわかります。
検証の全体像
今回は3つの検証を通して、3モデルの実力を多角的に見ていきます。
| 検証 | 内容 | データ | 主に見るもの |
|---|---|---|---|
| 1 | 創作レビュー1000件での一括比較 | Claude Code(Fable 5)で生成した、正解ラベル付きの創作レビュー1,000件 | 精度・レイテンシ・信頼度 |
| 2 | 判定の再現性(ブレ)検証 | 同一テキストを複数回判定 | 出力の一貫性(再現性) |
| 3 | 実データでの精度検証 | Amazon レビュー(実データ)を筆者が手ラベル付け | 実運用に近い精度 |
検証1は大規模データで全体傾向・分布・レイテンシ、検証2は「同じ入力に同じ答えを返すか」という再現性、検証3 は人手で正解を付けた実データでの精度と役割を分けて検証して行きます。
検証1: 創作レビュー1000件での比較(精度・レイテンシ・信頼度)
まずは規模の大きなデータで全体傾向を把握します。
データセットはClaude Code(Fable 5)で生成した創作レビュー1,000件で、
生成時に正解ラベルもあわせて付与しています。
| 正解ラベル | 件数 |
|---|---|
| negative | 280 |
| positive | 270 |
| mixed | 250 |
| neutral | 200 |
まず定性的に見る(代表的なケース)
集計に入る前に、感情分析で判定が割れやすい代表的なケースをいくつか見てみます。
なお表中の「合計トークン / IN / OUT」は Bedrock の Converse API から取得できる参考情報として記録しています。
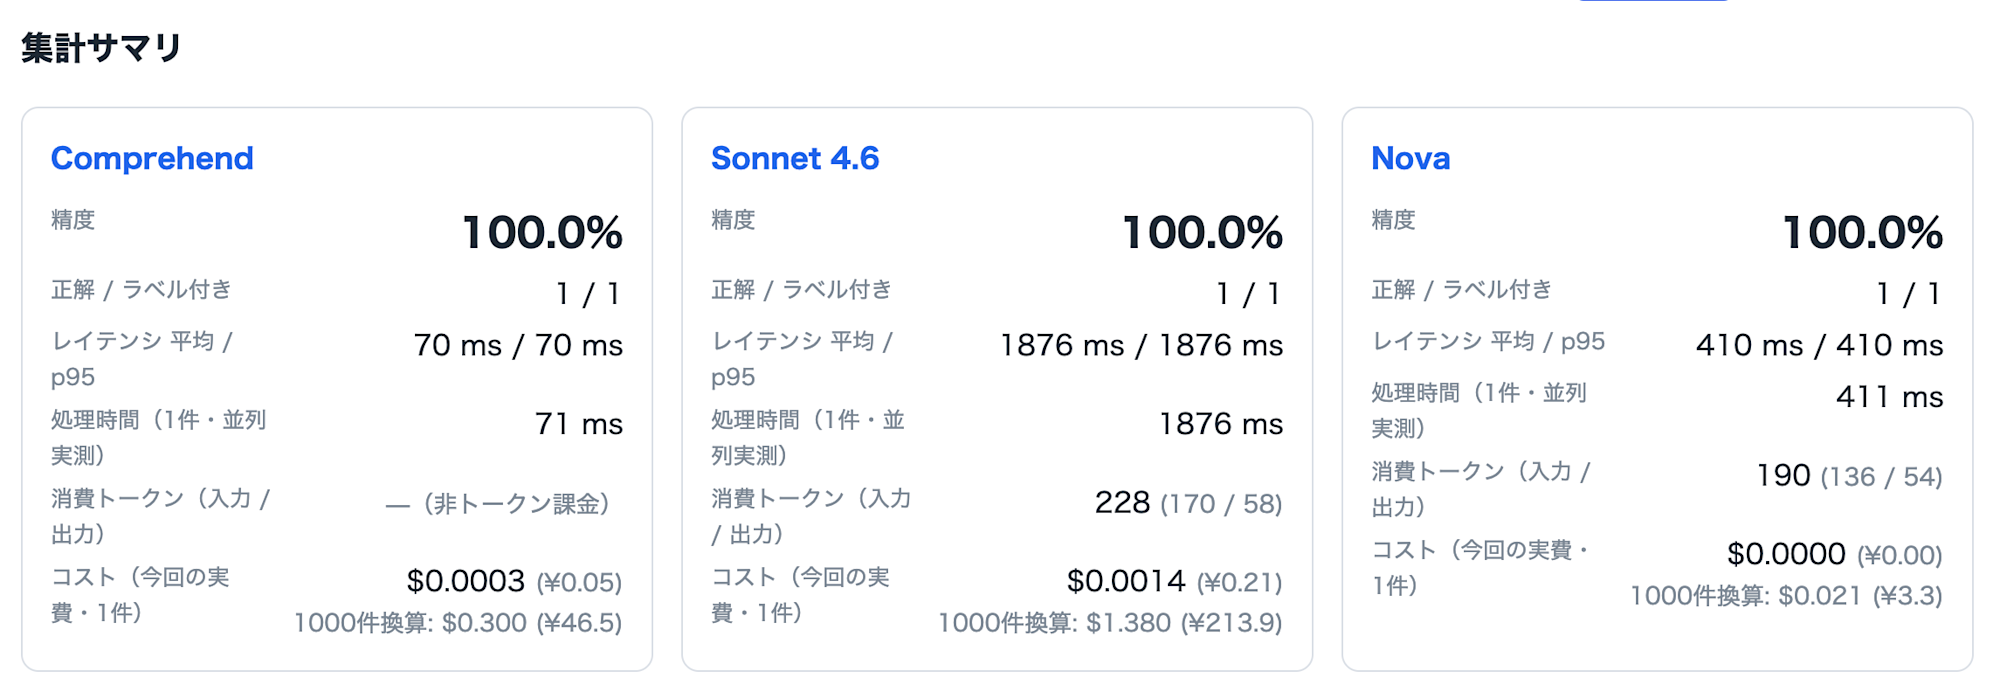
「ケース1: 単純なポジティブ文 (positive)」
この商品最高です!大満足!
| モデル | 判定 | レイテンシ | 合計トークン / IN / OUT | 自己申告信頼度 | 理由 |
|---|---|---|---|---|---|
| Comprehend | positive | 71ms | - | 100% | - |
| Sonnet 4.6 | positive | 1876ms | 228 / 170 / 58 | 97% | 「最高」「大満足」という強い肯定表現が使われており、明らかに高い満足感を示している。 |
| Nova Lite | positive | 411ms | 190 / 136 / 54 | 95% | 「最高です!」「大満足!」という言葉は明らかに肯定的な感情を示しています。 |
全てのモデルが正しく positive と判定しました。
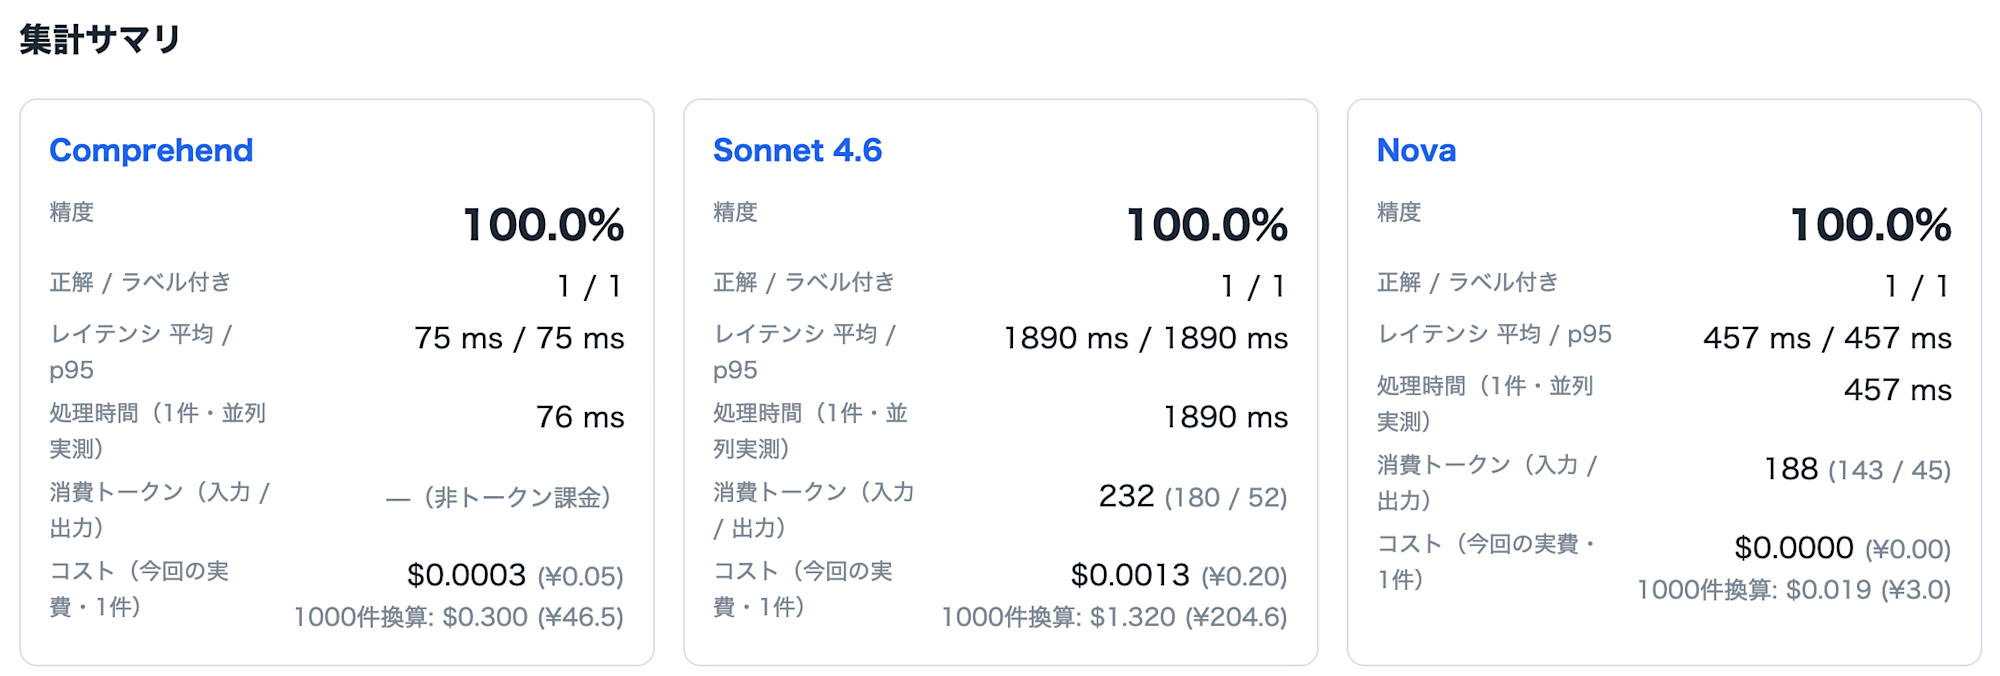
「ケース2: 混在した感情 (mixed)」
配送は遅いけど、商品自体はすごく良かった
| モデル | 判定 | レイテンシ | 合計トークン / IN / OUT | 自己申告信頼度 | 理由 |
|---|---|---|---|---|---|
| Comprehend | mixed | 76ms | - | 100% | - |
| Sonnet 4.6 | mixed | 1890ms | 232 / 180 / 52 | 92% | 配送への不満(negative)と商品への満足(positive)が共存しているため、mixedと判定した。 |
| Nova Lite | mixed | 457ms | 188 / 143 / 45 | 80% | 配送の遅さを指摘しつつも、商品自体は好意的な評価をしているため |
全てのモデルが正しく mixed と判定しました。
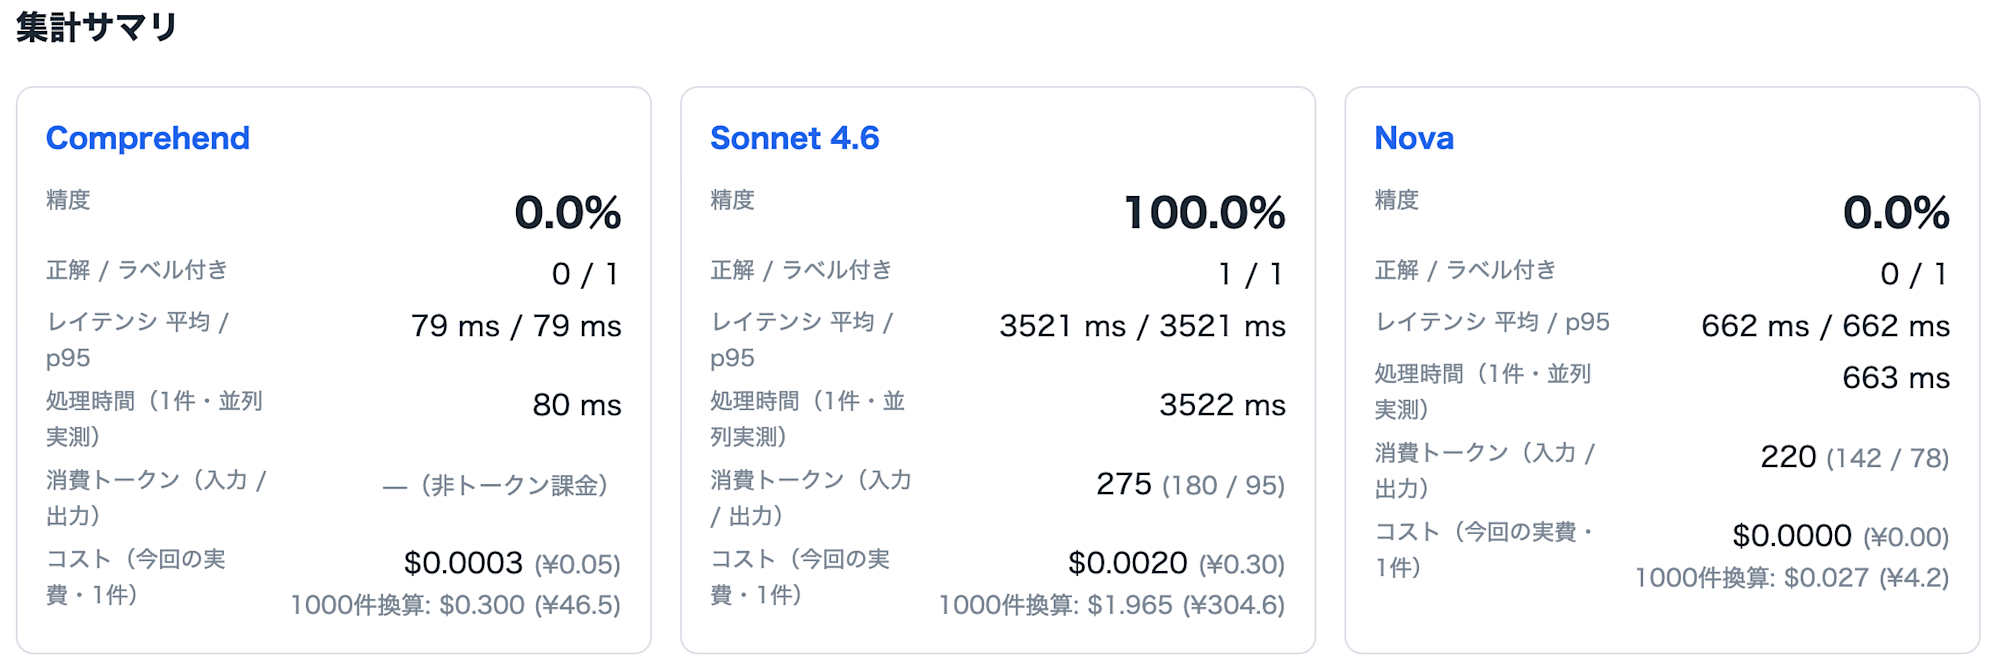
「ケース3: 皮肉 (negative)」
壊れて届きました。最高の気分だよ(笑)
| モデル | 判定 | レイテンシ | 合計トークン / IN / OUT | 自己申告信頼度 | 理由 |
|---|---|---|---|---|---|
| Comprehend | positive | 80ms | - | 98% | - |
| Sonnet 4.6 | negative | 3522ms | 275 / 180 / 95 | 95% | 「壊れて届いた」という明確なネガティブ事象に対し、「最高の気分だよ(笑)」は怒りや失望を皮肉で表現したものであり、実際の感情は強い不満・失望である。 |
| Nova Lite | neutral | 663ms | 220 / 142 / 78 | 75% | 文面は皮肉を込めて書かれており、表面上は否定的な表現ですが、括弧内の「笑」が示すように、実は肯定的な感情を隠している |
Comprehend は「最高の気分」を字面どおり受け取り、Nova Lite は「皮肉である」と認識しながら結論を neutral にしてしまっています。理由文を読むと「実は肯定的な感情を隠している」と書かれており、皮肉の検出自体はできても最終ラベルに反映できていないようです。ただしこれは 1 件の結果なので、傾向として言えるかは次の集計で確認します。
「ケース4: 中立 (neutral)」
普通でした
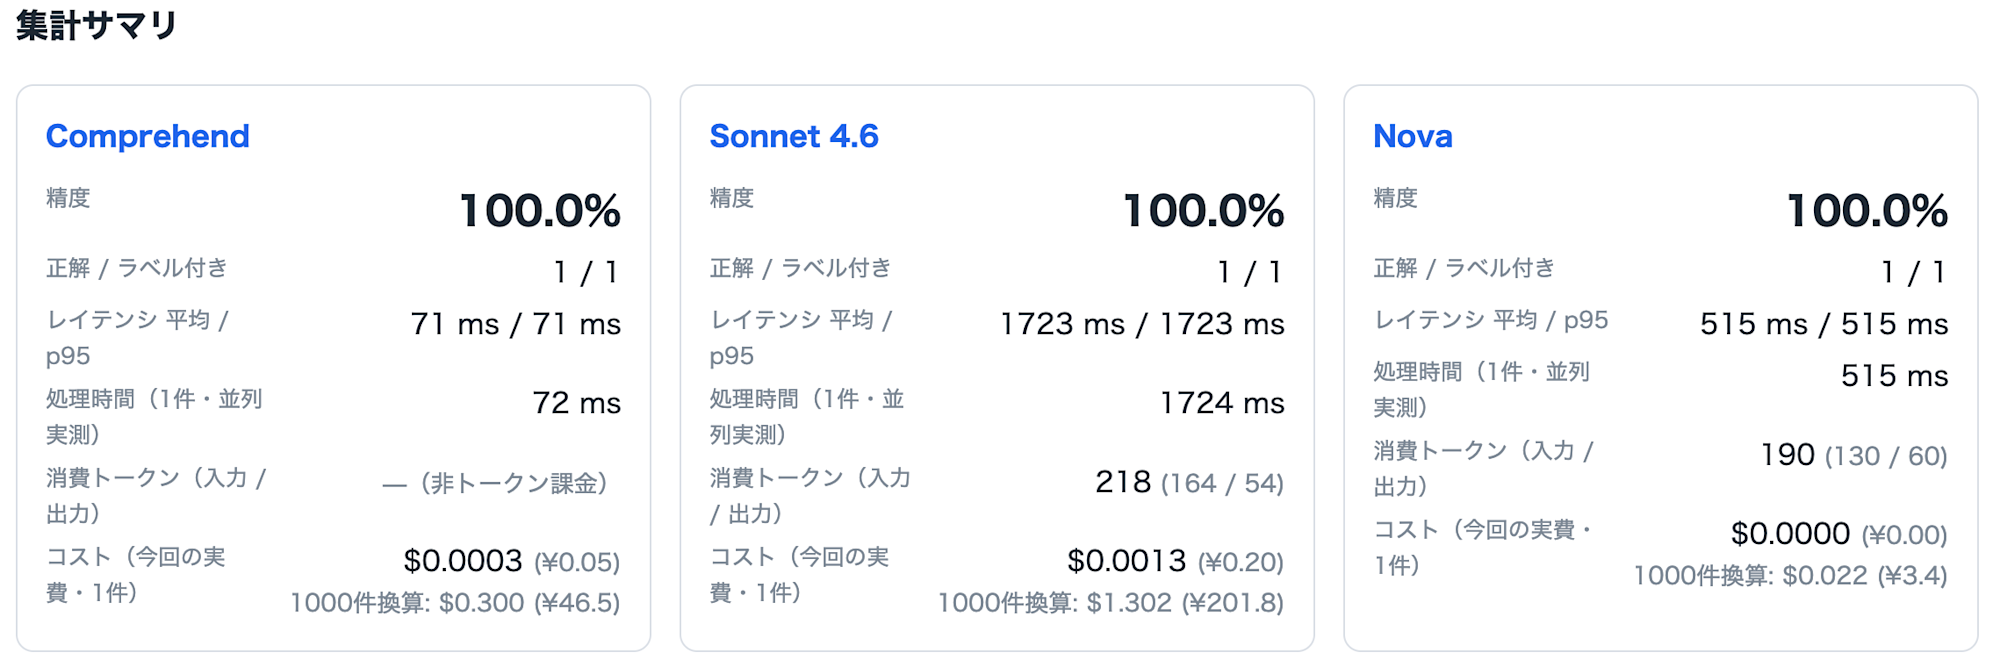
| モデル | 判定 | レイテンシ | 合計トークン / IN / OUT | 自己申告信頼度 | 理由 |
|---|---|---|---|---|---|
| Comprehend | neutral | 71ms | - | 99% | - |
| Sonnet 4.6 | neutral | 1724ms | 218 / 164 / 54 | 85% | 「普通でした」は特に良くも悪くもない中立的な評価を示す表現であるため。 |
| Nova Lite | neutral | 515ms | 190 / 130 / 60 | 85% | 文章は「普通でした」と述べており、肯定的でも否定的でもない中立的な表現です。 |
全てのモデルが正しく中立と判定しました。
集計結果(1000件)
続いて、上記のような文も含む全 1,000件を 3 モデルに一括判定させ、精度・レイテンシ・信頼度を集計しました。
サマリ
| 指標 | Comprehend | Sonnet 4.6 | Nova Lite |
|---|---|---|---|
| 全体正解率(エラー=不正解) | 82.8% | 97.8% | 84.0% |
| API エラー件数 | 0 | 0 | 10(スロットリング等) |
| レイテンシ 中央値 / 平均 / p95 | 22 / 74 / 299 ms | 1,970 / 2,035 / 2,813 ms | 414 / 697 / 1,957 ms |
| レイテンシ最大 | 3,192 ms | 4,273 ms | 12,708 ms |
| 平均信頼度(自己申告) | 0.886 | 0.911 | 0.835 |
精度は Sonnet 4.6 が最も高く、速度は Comprehend が最も速く、Nova Lite はその中間に位置しました。Comprehend と Nova Lite の全体正解率は 82.8% と 84.0% でほぼ並んでいますが、後述するラベル別の内訳では間違え方がまったく違います。
正解率の比較
| 正解ラベル | 件数 | Comprehend | Sonnet 4.6 | Nova Lite |
|---|---|---|---|---|
| - | 1000 | 82.8% | 97.8% | 84.0% |
| positive | 270 | 87.8% | 97.0% | 98.9% |
| negative | 280 | 74.3% | 98.9% | 88.6% |
| neutral | 200 | 92.5% | 95.5% | 95.5% |
| mixed | 250 | 79.2% | 99.2% | 53.6% |
ラベル別に見ると弱点がはっきり出ました。Comprehend は negative が最も弱く、Nova Lite は mixed が突出して弱いという結果です。一方で Sonnet 4.6 は全ラベルで95%以上と弱点がなく、特に negative は280件中277件を正解できています。皮肉・婉曲表現を含むネガティブや、賛否混在の判定に強いようです。
レイテンシと信頼度
Comprehend は中央値 22ms と圧倒的に高速ですが、外れ値として最大 3.2 秒のスパイク[6]があります。Nova Lite は中央値 414ms に対し最大 12.7 秒と裾が重く、リトライやスロットリングの影響がうかがえます。Sonnet 4.6 は遅いものの分布は最も安定しており、中央値 2.0 秒・最大 4.3 秒に収まりました。SLO[7] を設計するなら平均ではなく p95/p99 で見るべきデータです。
判定1件ごとの分布と信頼度キャリブレーション
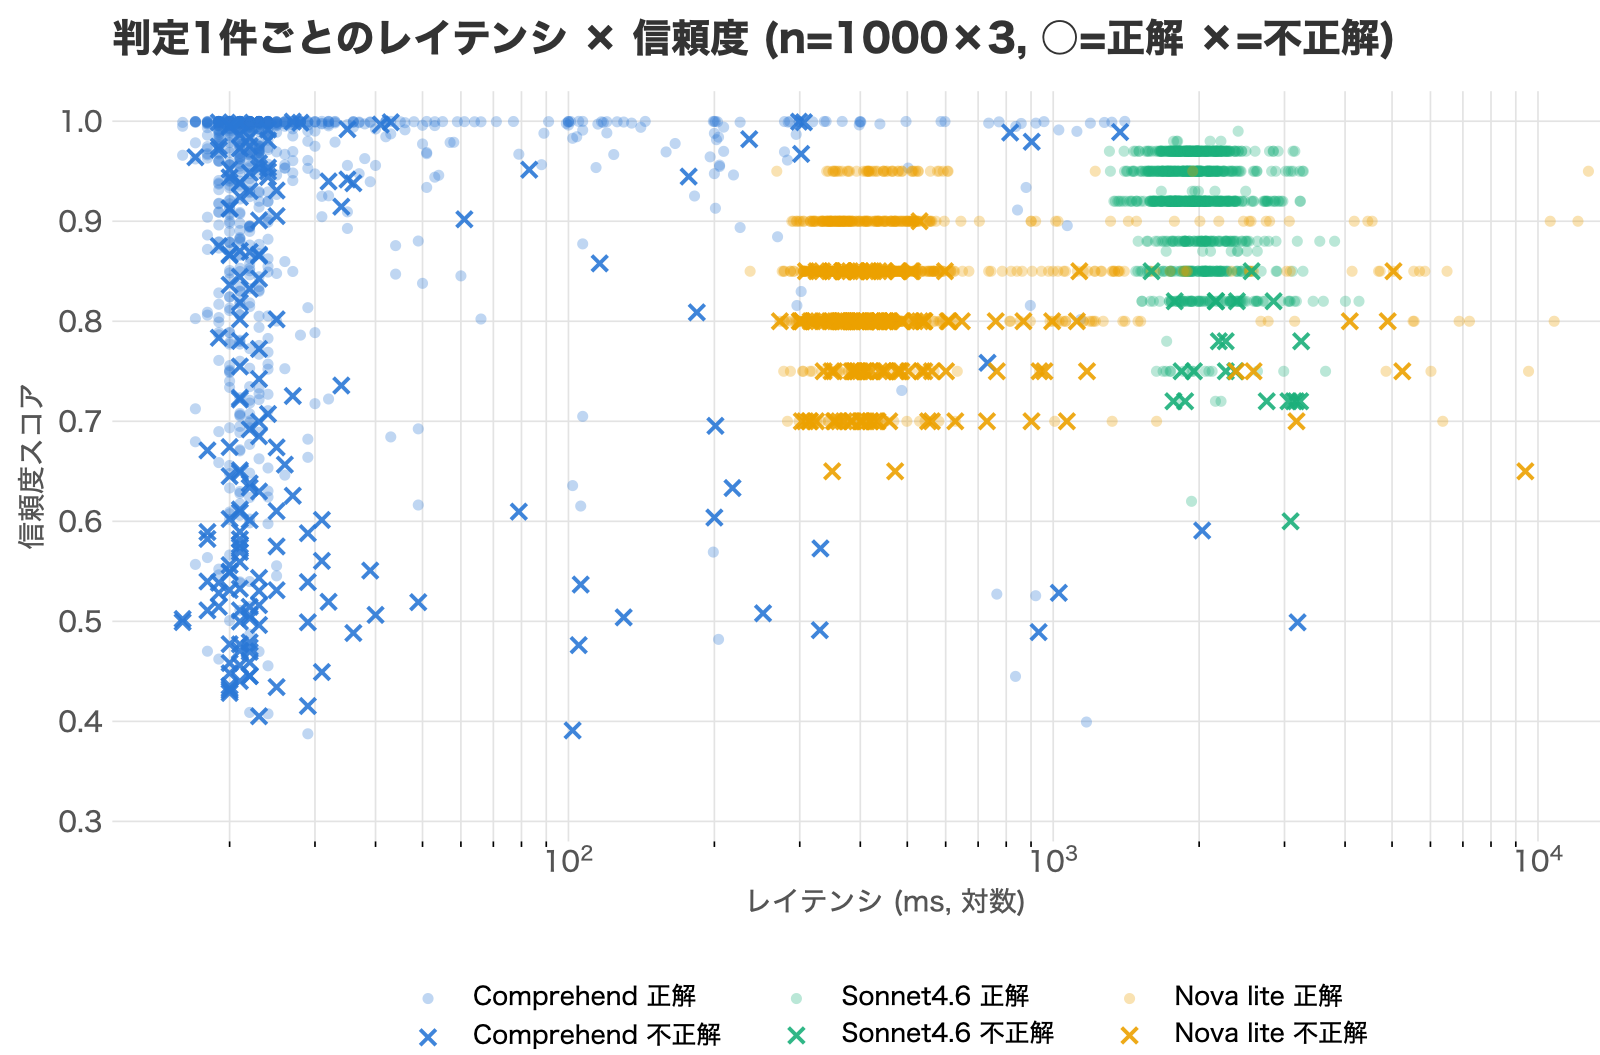
信頼度帯ごとの正解率を集計すると、3 モデルとも「信頼度が低いほど正解率が下がる」傾向が見られました。
| 信頼度帯 | Comprehend | Sonnet 4.6 | Nova Lite |
|---|---|---|---|
| < 0.7 | 41%(n=162) | 50%(n=2) | 52%(n=62) |
| 0.7–0.8 | 82%(n=60) | 56%(n=32) | 71%(n=322) |
| 0.8–0.9 | 85%(n=107) | 98%(n=282) | 95%(n=554) |
| 0.9以上 | 93%(n=671) | 100%(n=684) | 100%(n=52) |
特に Sonnet 4.6 は信頼度 0.9 以上ならほぼ確実に正解しており、誤答22件のうち15件が信頼度0.8未満に集中しています。この34件を人手に回すだけで、実効精度をほぼ100%まで引き上げられる計算です。Comprehend も同様に、0.7未満の帯だけ人手に回せば実効精度を大きく引き上げられます。
【検証1でつまずいたこと】
Comprehend の中央値 22ms は、最初は計測ミスだと思いました。
time.perf_counter()を挟む位置を疑って書き直し、件数を変えて何度か回しましたが数字は変わらず、素直にこれが実力でした。
検証2: 判定の再現性(ブレ)検証
検証1では「1回の判定」の精度を見ました。しかし実運用では、同じ文を投げたら毎回同じ結果が返ってくるかも重要です。日次バッチで同じデータを再処理したときに結果が変わってしまうと、集計値がぶれたり、前回との差分が「実際の変化」なのか「判定の揺れ」なのか区別できなくなります。特に LLM(Bedrock / Nova)は生成のたびに出力が揺れる可能性があります。そこで、同一テキストを複数回判定させ、判定のブレ(再現性)を検証しました。
手法
検証1と同様に創作レビュー1,000件を対象に、各モデルへ同一テキストを5回ずつ投げ、5回の判定ラベルがどれだけ一致するかを見ます。指標は次の2つです。
- 揺れ件数:5回の判定で一度でもラベルが変動した件数(1件でも違えば「揺れあり」とカウント)
- 不一致率:5回のうち任意の2回を比べたときにラベルが一致しなかった割合(10ペアの平均。「同じ文を2回投げたら何%の確率で違う答えになるか」の目安)
なお LLM 側はいずれも既定の推論設定(temperature 等を明示指定しない)で呼び出しています。
結果
| 指標 | Comprehend | Sonnet 4.6 | Nova Lite |
|---|---|---|---|
| 揺れ件数(5回で1度でも変動) | 0 / 1000件(0%) | 8 / 1000件(0.8%) | 145 / 1000件(14.5%) |
| 不一致率(2回比較・10ペア平均) | 0% | 0.42%(各ペア 0.2〜0.6%) | 7.4%(各ペア 6.4〜8.8%) |
揺れた件について、その割れ方(5回のうち何回が少数派か)を分けると次のとおりです。
| 割れ方 | Sonnet 4.6 | Nova Lite |
|---|---|---|
| 1回だけ別判定(4対1) | 3件 | 73件 |
| ほぼ半々に割れる(3対2) | 5件 | 64件 |
| 3方向に割れる(2対2対1など) | 0件 | 8件 |
揺れ件数は 0 件 / 8 件 / 145 件と、3 モデルで大きく差が出ました。
| モデル | 揺れ件数 | 結果 |
|---|---|---|
| Comprehend | 0件 | 1,000件すべてで5回とも同一ラベルを返し、揺れは1件もありません。従来型のML分類器らしく、同じ入力には必ず同じ出力を返します。 |
| Sonnet 4.6 | 8件 | 安定して出力しており、揺れたのはわずか8件(0.8%)のみ。判断が割れやすい境界的な文(mixed か neutral か、など)に限られていました。 |
| Nova Lite | 145件 | 揺れが目立つ結果で、145件(14.5%)でラベルが変動しました。しかも揺れたラベルの4割以上(64件)は「3対2」とほぼ半々に割れており、多数決を取っても信頼しづらい状態です。1回だけの判定結果を鵜呑みにすると、実行のたびに集計が数%単位で動く可能性があります。 |
検証3: 実データ(Amazon レビュー)での精度検証
検証1は正解ラベルが確実な創作データでした。最後に、実際のレビューデータで精度を確かめます。難例に寄せた創作データと比べて、実運用に近いデータで正解率がどう変わるかを見るのが狙いです。
手法
- データ出典: SetFit/amazon_reviews_multi_ja(Hugging Face)[8]
- 手法: test split から100件を抽出し、筆者(人間)が正解ラベルを付与 → 3 モデルで判定して突き合わせ
- ラベル分布: negative 36 / mixed 31 / positive 30 / neutral 3
(実レビューらしく「良い点も悪い点も書く」mixed が多く、neutral は少ない構成) - テキスト長: 中央値 69文字・最大 757文字(検証1より長文を含む)
⚠️ neutral は3件しかないため、neutral のラベル別正解率は参考値程度です。
また、ラベル付けは筆者が行ったため、絶対的な正解ではなく「筆者の主観での正解」となります。あくまで参考値としてご覧ください。
集計結果(100件)
サマリ
| 指標 | Comprehend | Sonnet 4.6 | Nova Lite |
|---|---|---|---|
| 全体正解率 | 79% | 90% | 64% |
| API エラー件数 | 0 | 0 | 1(パース失敗) |
| レイテンシ 中央値 / 平均 / p95 | 23 / 47 / 282 ms | 2,420 / 2,537 / 3,219 ms | 452 / 456 / 591 ms |
| レイテンシ最大 | 336 ms | 7,074 ms | 652 ms |
| 平均信頼度(自己申告) | 0.936 | 0.892 | 0.854 |
実データでは速度の序列は検証1と同じでしたが、精度は Comprehend と Nova Lite の順位が入れ替わりました。
【精度】Sonnet 4.6 > Comprehend > Nova Lite
【速度】Comprehend > Nova Lite > Sonnet 4.6
でした(検証1の精度は Sonnet 4.6 > Nova Lite > Comprehend)。今回は mixed が31%を占める構成のため、mixed に弱い Nova Lite の全体正解率が 64% まで下がっています。レイテンシ分布は 3 モデルとも安定しており、検証1(1,000件)で見られた Nova Lite の最大 12.7 秒のようなスパイクは再現しませんでした。Comprehend も検証1では最大 3.2 秒のスパイクがありましたが、今回は最大 336ms に収まっています。
正解率の比較
| 正解ラベル | 件数 | Comprehend | Sonnet 4.6 | Nova Lite |
|---|---|---|---|---|
| positive | 30 | 90% | 97% | 83% |
| negative | 36 | 92% | 86% | 92% |
| neutral | 3 | 0%(0/3) | 33%(1/3) | 33%(1/3) |
| mixed | 31 | 61% | 94% | 16% |
正解率(Recall)だけでは、間違えた分がどのラベルに流れたのかまではわかりません。そこで実データ100件について、3モデルそれぞれの混同行列(行: 正解ラベル、列: 予測ラベル、対角線が正解)を集計しました。
Comprehend
| 正解 \ 予測 | positive | negative | neutral | mixed | 件数 |
|---|---|---|---|---|---|
| positive | 27 | 3 | 0 | 0 | 30 |
| negative | 1 | 33 | 0 | 2 | 36 |
| neutral | 0 | 2 | 0 | 1 | 3 |
| mixed | 6 | 6 | 0 | 19 | 31 |
Sonnet 4.6
| 正解 \ 予測 | positive | negative | neutral | mixed | 件数 |
|---|---|---|---|---|---|
| positive | 29 | 0 | 0 | 1 | 30 |
| negative | 0 | 31 | 0 | 5 | 36 |
| neutral | 0 | 1 | 1 | 1 | 3 |
| mixed | 1 | 1 | 0 | 29 | 31 |
Nova Lite
| 正解 \ 予測 | positive | negative | neutral | mixed | 件数 |
|---|---|---|---|---|---|
| positive | 25 | 0 | 4 | 0 | 29※ |
| negative | 0 | 33 | 2 | 1 | 36 |
| neutral | 0 | 2 | 1 | 0 | 3 |
| mixed | 0 | 5 | 21 | 5 | 31 |
このデータセットの結果は、mixed(31件)の扱いでほぼ決まっています。Sonnet 4.6 は mixed 31 件のうち 29 件を正解した一方で、negative は 36 件中 31 件(86%)と検証1(99%)より下がりました。混同行列を見ると negative 5 件を mixed と判定しており、mixed 側に寄せる傾向が出ています。検証1では mixed を取りこぼす誤りが中心だったので、データセットによって間違え方の向きが変わったことになります。
Nova Lite は mixed 31 件のうち 21 件を neutral と判定し、正解率 16% まで落ち込みました。検証1でも mixed が 54% と最も弱かったので、判断に迷ったときに neutral を選ぶ傾向がより強く出た形です。
Comprehend は 100 件を通して一度も neutral を出力せず、mixed を positive / negative のどちらかに振り分けていました。
レイテンシと信頼度
Nova Lite はスパイクがなく、最大 652ms に収まりました。Sonnet 4.6 は中央値 2.4 秒・最大 7.1 秒で、検証1(中央値 2.0 秒)よりやや遅くなっています。テキスト長の中央値が 69 文字・最大 757 文字と検証1より長文を含むため、その影響と考えられます。
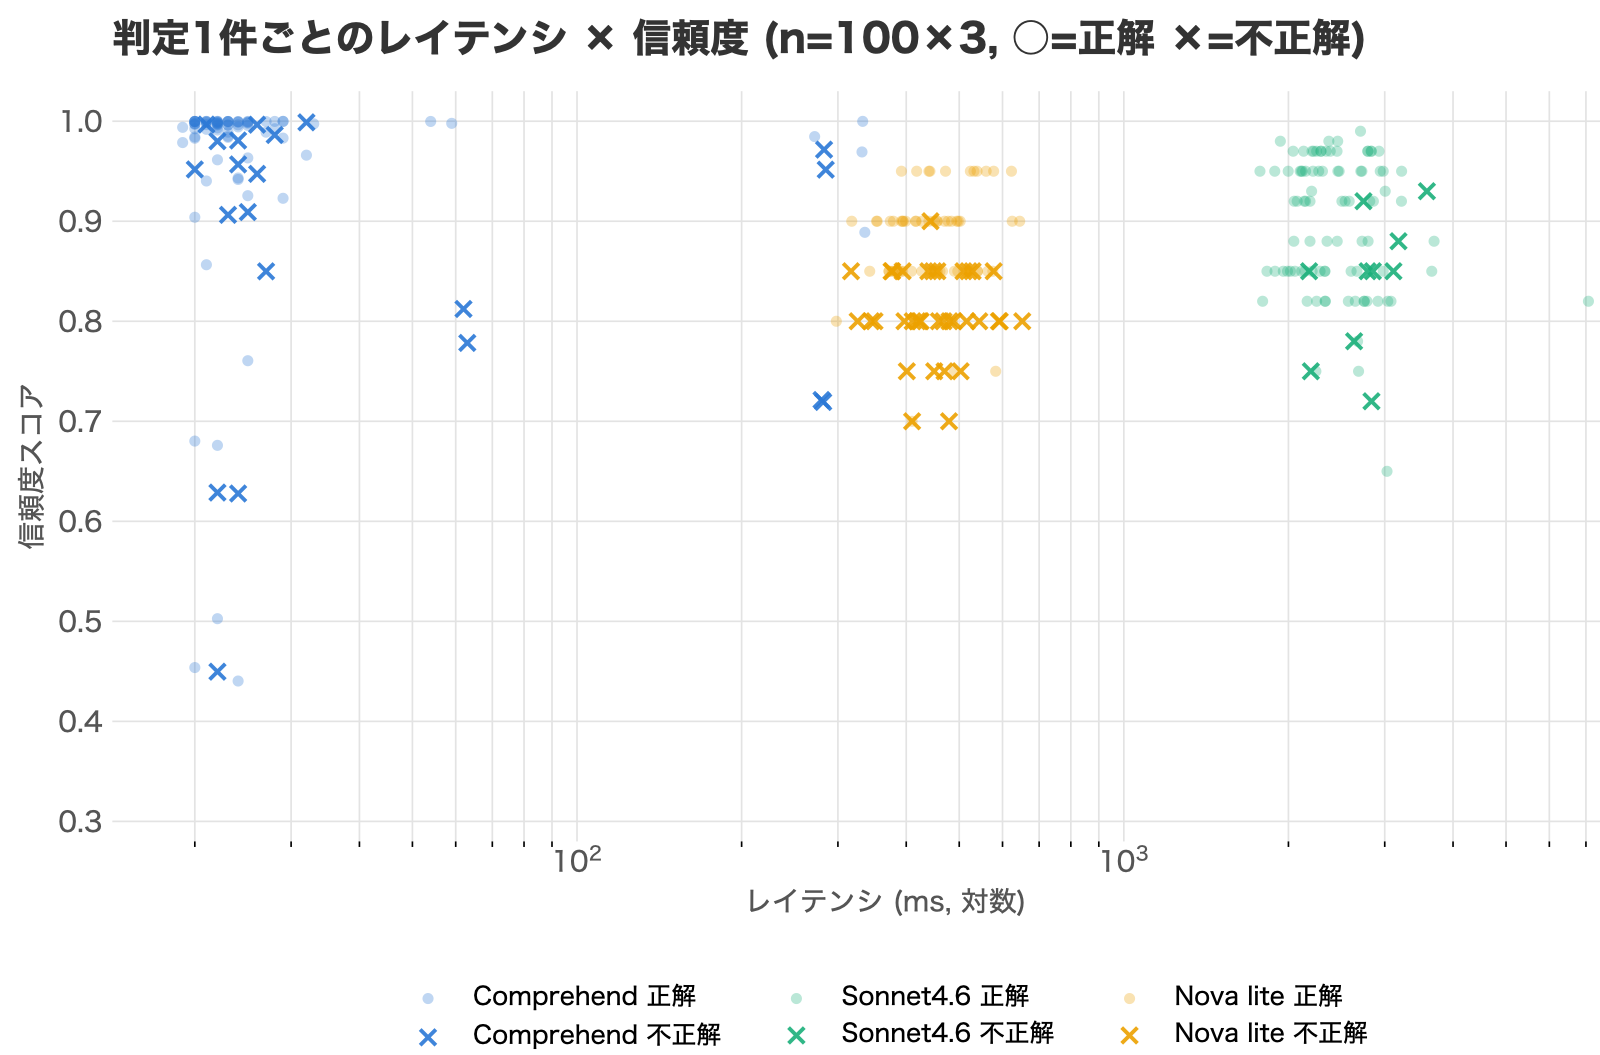
判定1件ごとの分布と信頼度キャリブレーション
| 信頼度帯 | Comprehend | Sonnet 4.6 | Nova Lite |
|---|---|---|---|
| < 0.7 | 62%(n=8) | 100%(n=1) | 33%(n=3) |
| 0.7–0.8 | 25%(n=4) | 50%(n=6) | 16%(n=25) |
| 0.8–0.9 | 50%(n=4) | 88%(n=42) | 80%(n=60) |
| 0.9以上 | 85%(n=84) | 96%(n=51) | 100%(n=11) |
検証1と同様、Comprehend は信頼度0.7未満、Sonnet 4.6・Nova Lite は信頼度0.8未満で正解率が大きく落ちる傾向が実データでも見られました。ただし Nova Lite は全体の約1/4がこの0.7台の帯に落ちており、低信頼帯の母数が多いこと自体がこのデータセットへの適性の低さを表しています。低信頼だけ人手に回す運用でカバーするには、Nova Lite は向いていない結果となりました。
まとめ
Comprehend が向いているケース
- 1 日数十万件といった規模のテキストを、低レイテンシで捌きたい
- ポジ / ネガのざっくりした傾向を時系列で追いたい(絶対精度より一貫性が重要)
- 同じデータを再処理しても必ず同じ結果になる必要がある(日次バッチの再実行など)
- 判定理由は不要で、ラベルとスコアだけあればよい
Sonnet 4.6 が向いているケース
- 皮肉や婉曲表現、賛否が混在した文を正しく扱いたい
- 判定理由を人間がレビューする前提の運用にしたい
- positive / negative / neutral / mixed 以外の独自カテゴリで分類したい
(プロンプトを書き換えるだけで済み、モデルの再学習が不要)
Nova Lite が向いているケース
- Bedrock の中でも軽量なモデルを使いたく、mixed の精度は割り切れる(明確な positive / negative の
仕分けが目的、など)
今回の検証まとめ
Amazon Comprehend / Claude Sonnet 4.6 / Amazon Nova Lite の 3 つで、日本語テキストの感情分析を3つの検証で比較しました。
- 精度は Sonnet 4.6 が最も高く(検証1: 97.8% / 検証3: 90%)、
特に mixed と皮肉表現で差がつきました - 速度と再現性は Comprehend が優位で、中央値 22ms・揺れ 0% でした
- Nova Lite は Comprehend と近い正解率でしたが、mixed の精度と再現性に課題がありました
どれか 1 つが常に正解というより、要件のどこを優先するかで変わります。そのうえで今回試して一番やってみたくなったのは、両者の併用です。検証1・検証3 とも「Comprehend の信頼度が低い(0.7未満)ケースほど誤りやすい」という傾向が出たので、Comprehend で全件を一次判定し、信頼度0.7未満のものだけ Sonnet 4.6 に回せば、精度を上げられるはずです。
今回できなかったこととして、以下が残っています。
- Claude Sonnet 5/Fable 5 での検証
- Nova Pro / Nova Micro との比較
- 上記ハイブリッド構成の実装とコスト・精度の実測
実レビューデータのラベル付けを筆者ひとりで行っている点や、検証3がn=100である点など、
数字の精度としては粗い検証です。同じ比較を検討している方の出発点として使っていただければと思います。
株式会社 JAPANNEXT 様の AWS 生成 AI 事例「Amazon Connect と Amazon Bedrock で営業業務とカスタマーサポート業務を刷新。対応件数を 15% 増加、引き継ぎ工数ゼロを実現」のご紹介 ↩︎
スパイクとは: Comprehend は 1,000件中 3件が 1 秒以上のスパイクを記録しました。Nova Lite は 10件がスロットリング等でエラーとなり、再試行で最大 12.7 秒まで延びました。Sonnet 4.6 は最大でも 4.3 秒に収まりました。 ↩︎
SLO(Service Level Objective)とは、性能や可用性について自分たちで定める目標値のこと(例:「95%のリクエストを500ms以内に返す」)。契約上の約束であるSLA、実測値であるSLIとあわせて使われる。参考: Service Level Objectives - Google SRE Book ↩︎
SetFit/amazon_reviews_multi_ja · Datasets at Hugging Face ↩︎